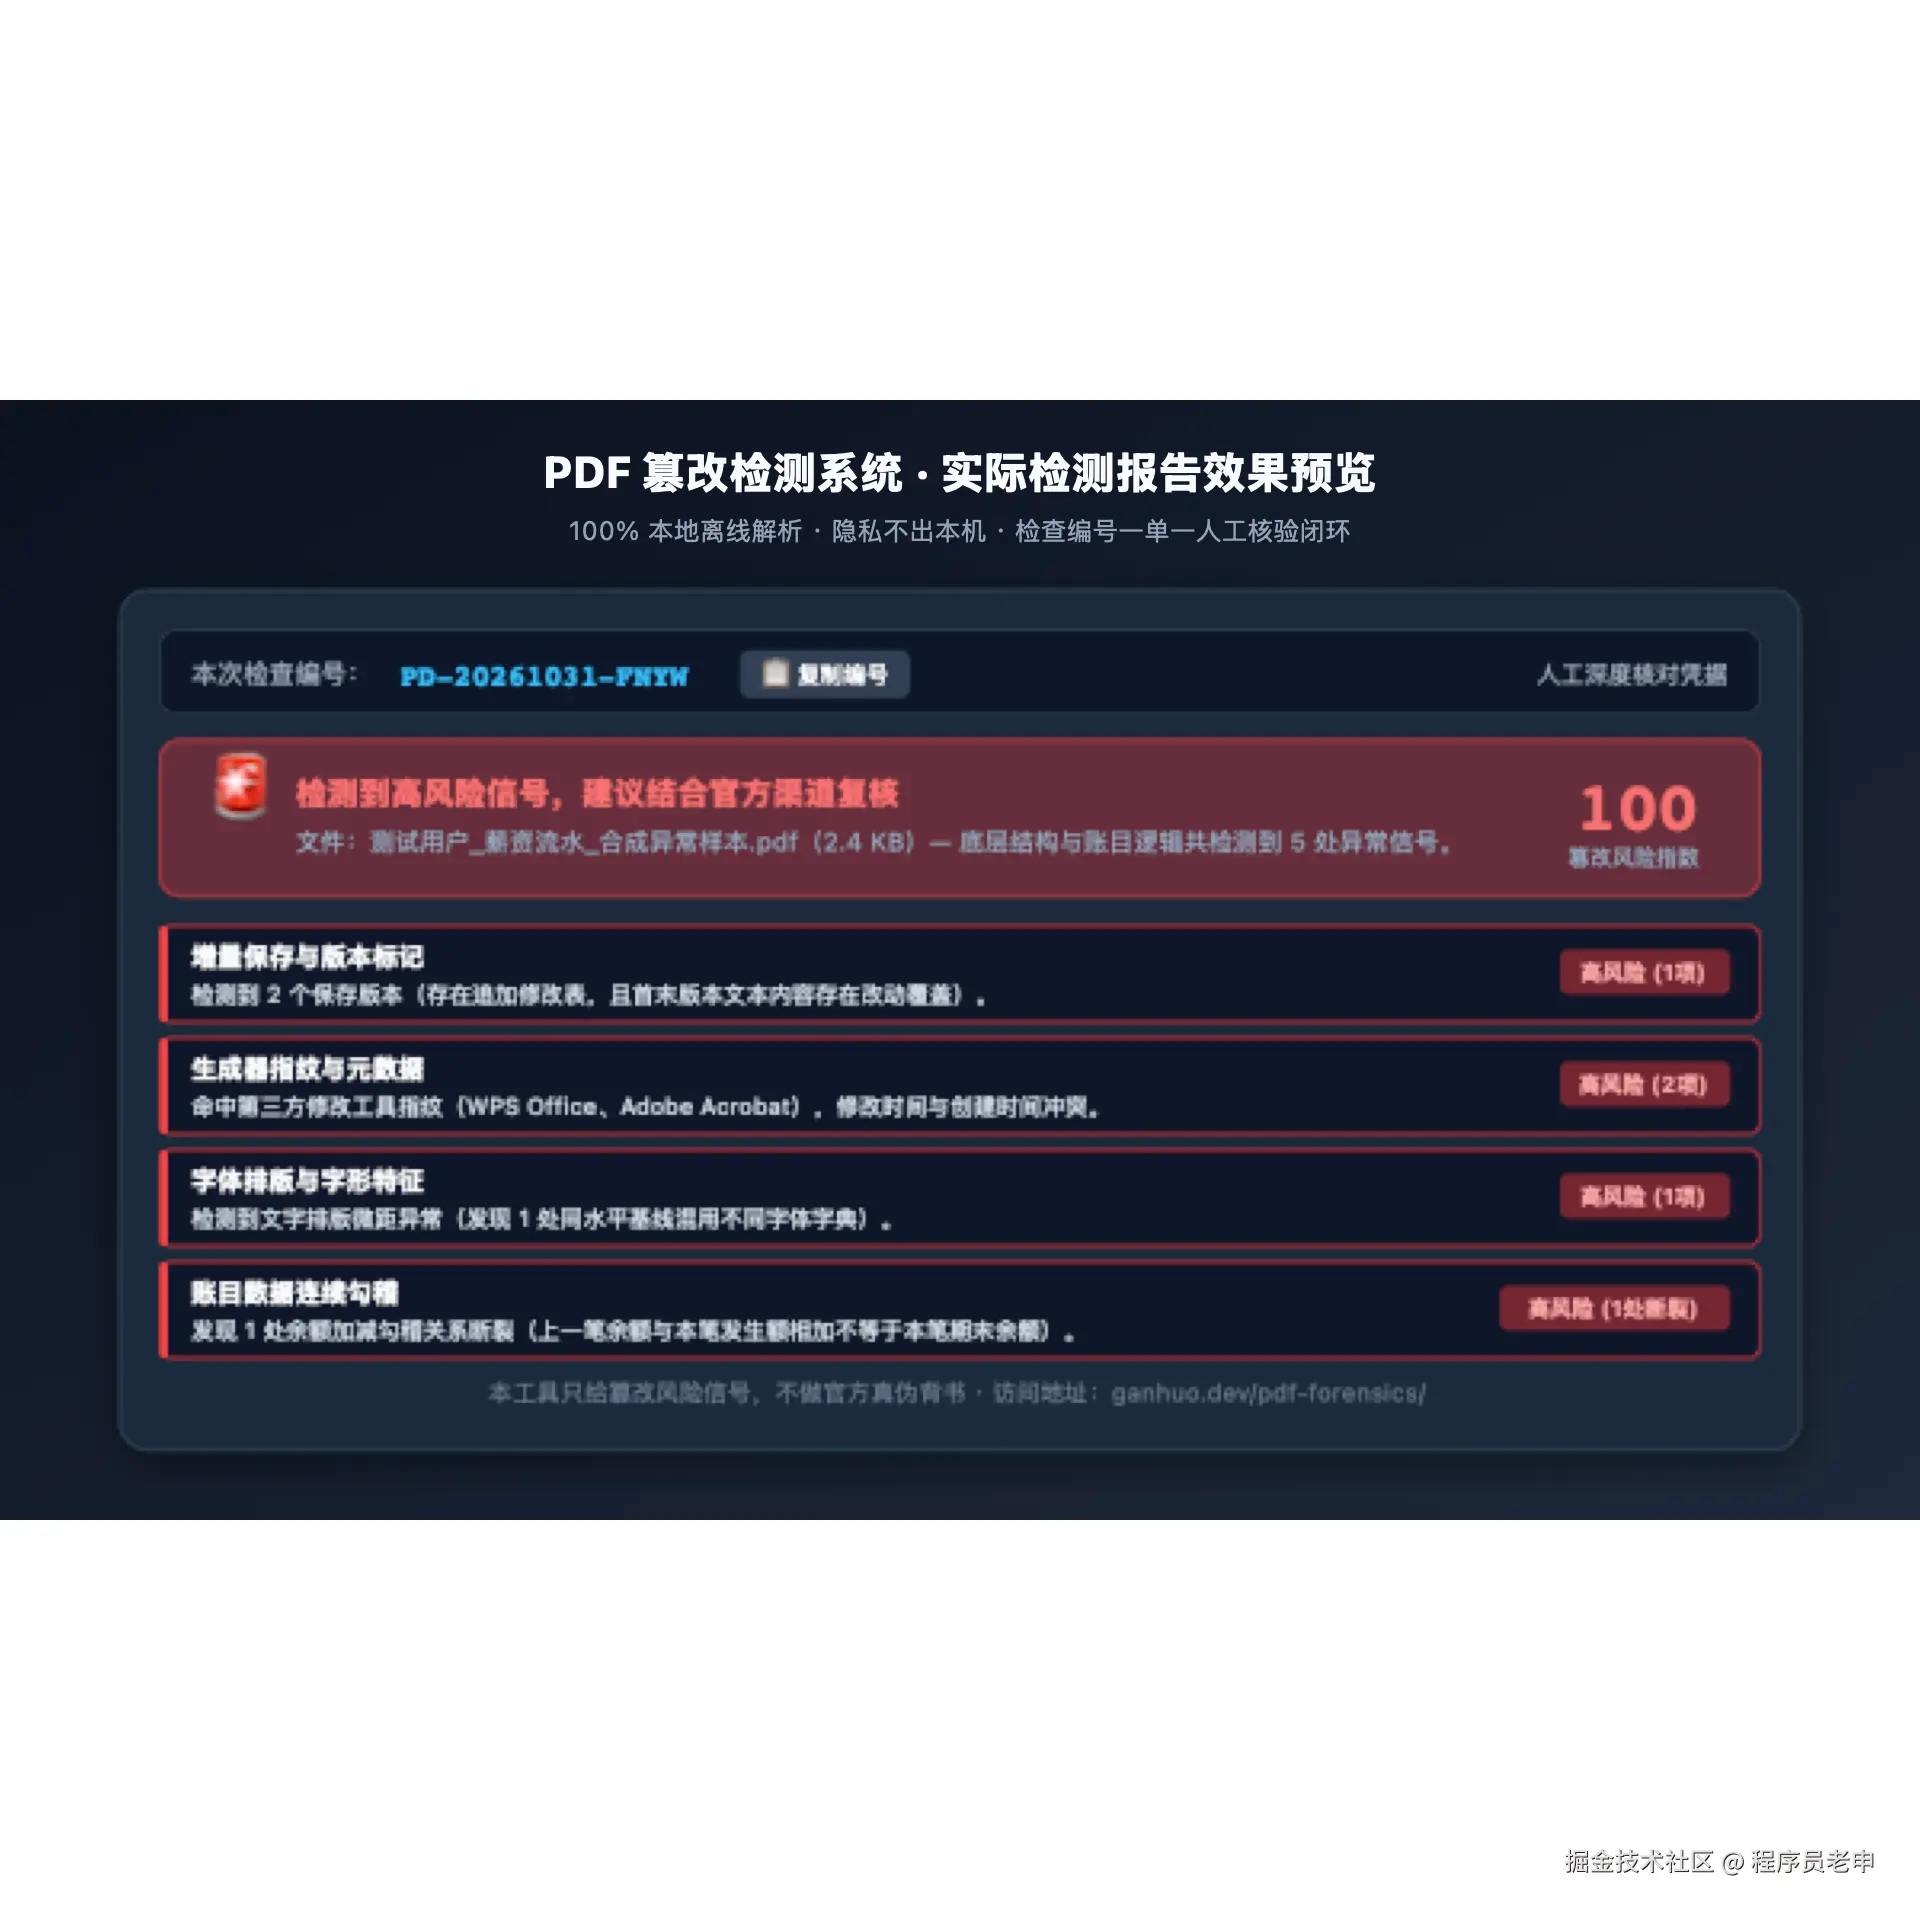
 在技术圈谈到「PDF 逆向」或「文档防伪」,很多同学第一反应是搞深度学习做图像篡改定位,或者跑大模型 OCR 去比对。
但在真正的工程落地和金融风控一线,最管用、速度最快、误报率最低的反而是基于 ISO 32000-1 规范的底层二进制结构尸检与纯数学勾稽。
今天结合一个合成的银行流水样本,从底层二进制视角拆解:一份号称银行直接导出的流水,究竟是怎么穿帮的?
一、PDF 增量保存机制(Incremental Updates)
很多人以为用编辑器修改 PDF 就像在文本编辑器里按 Ctrl+S,其实不是。
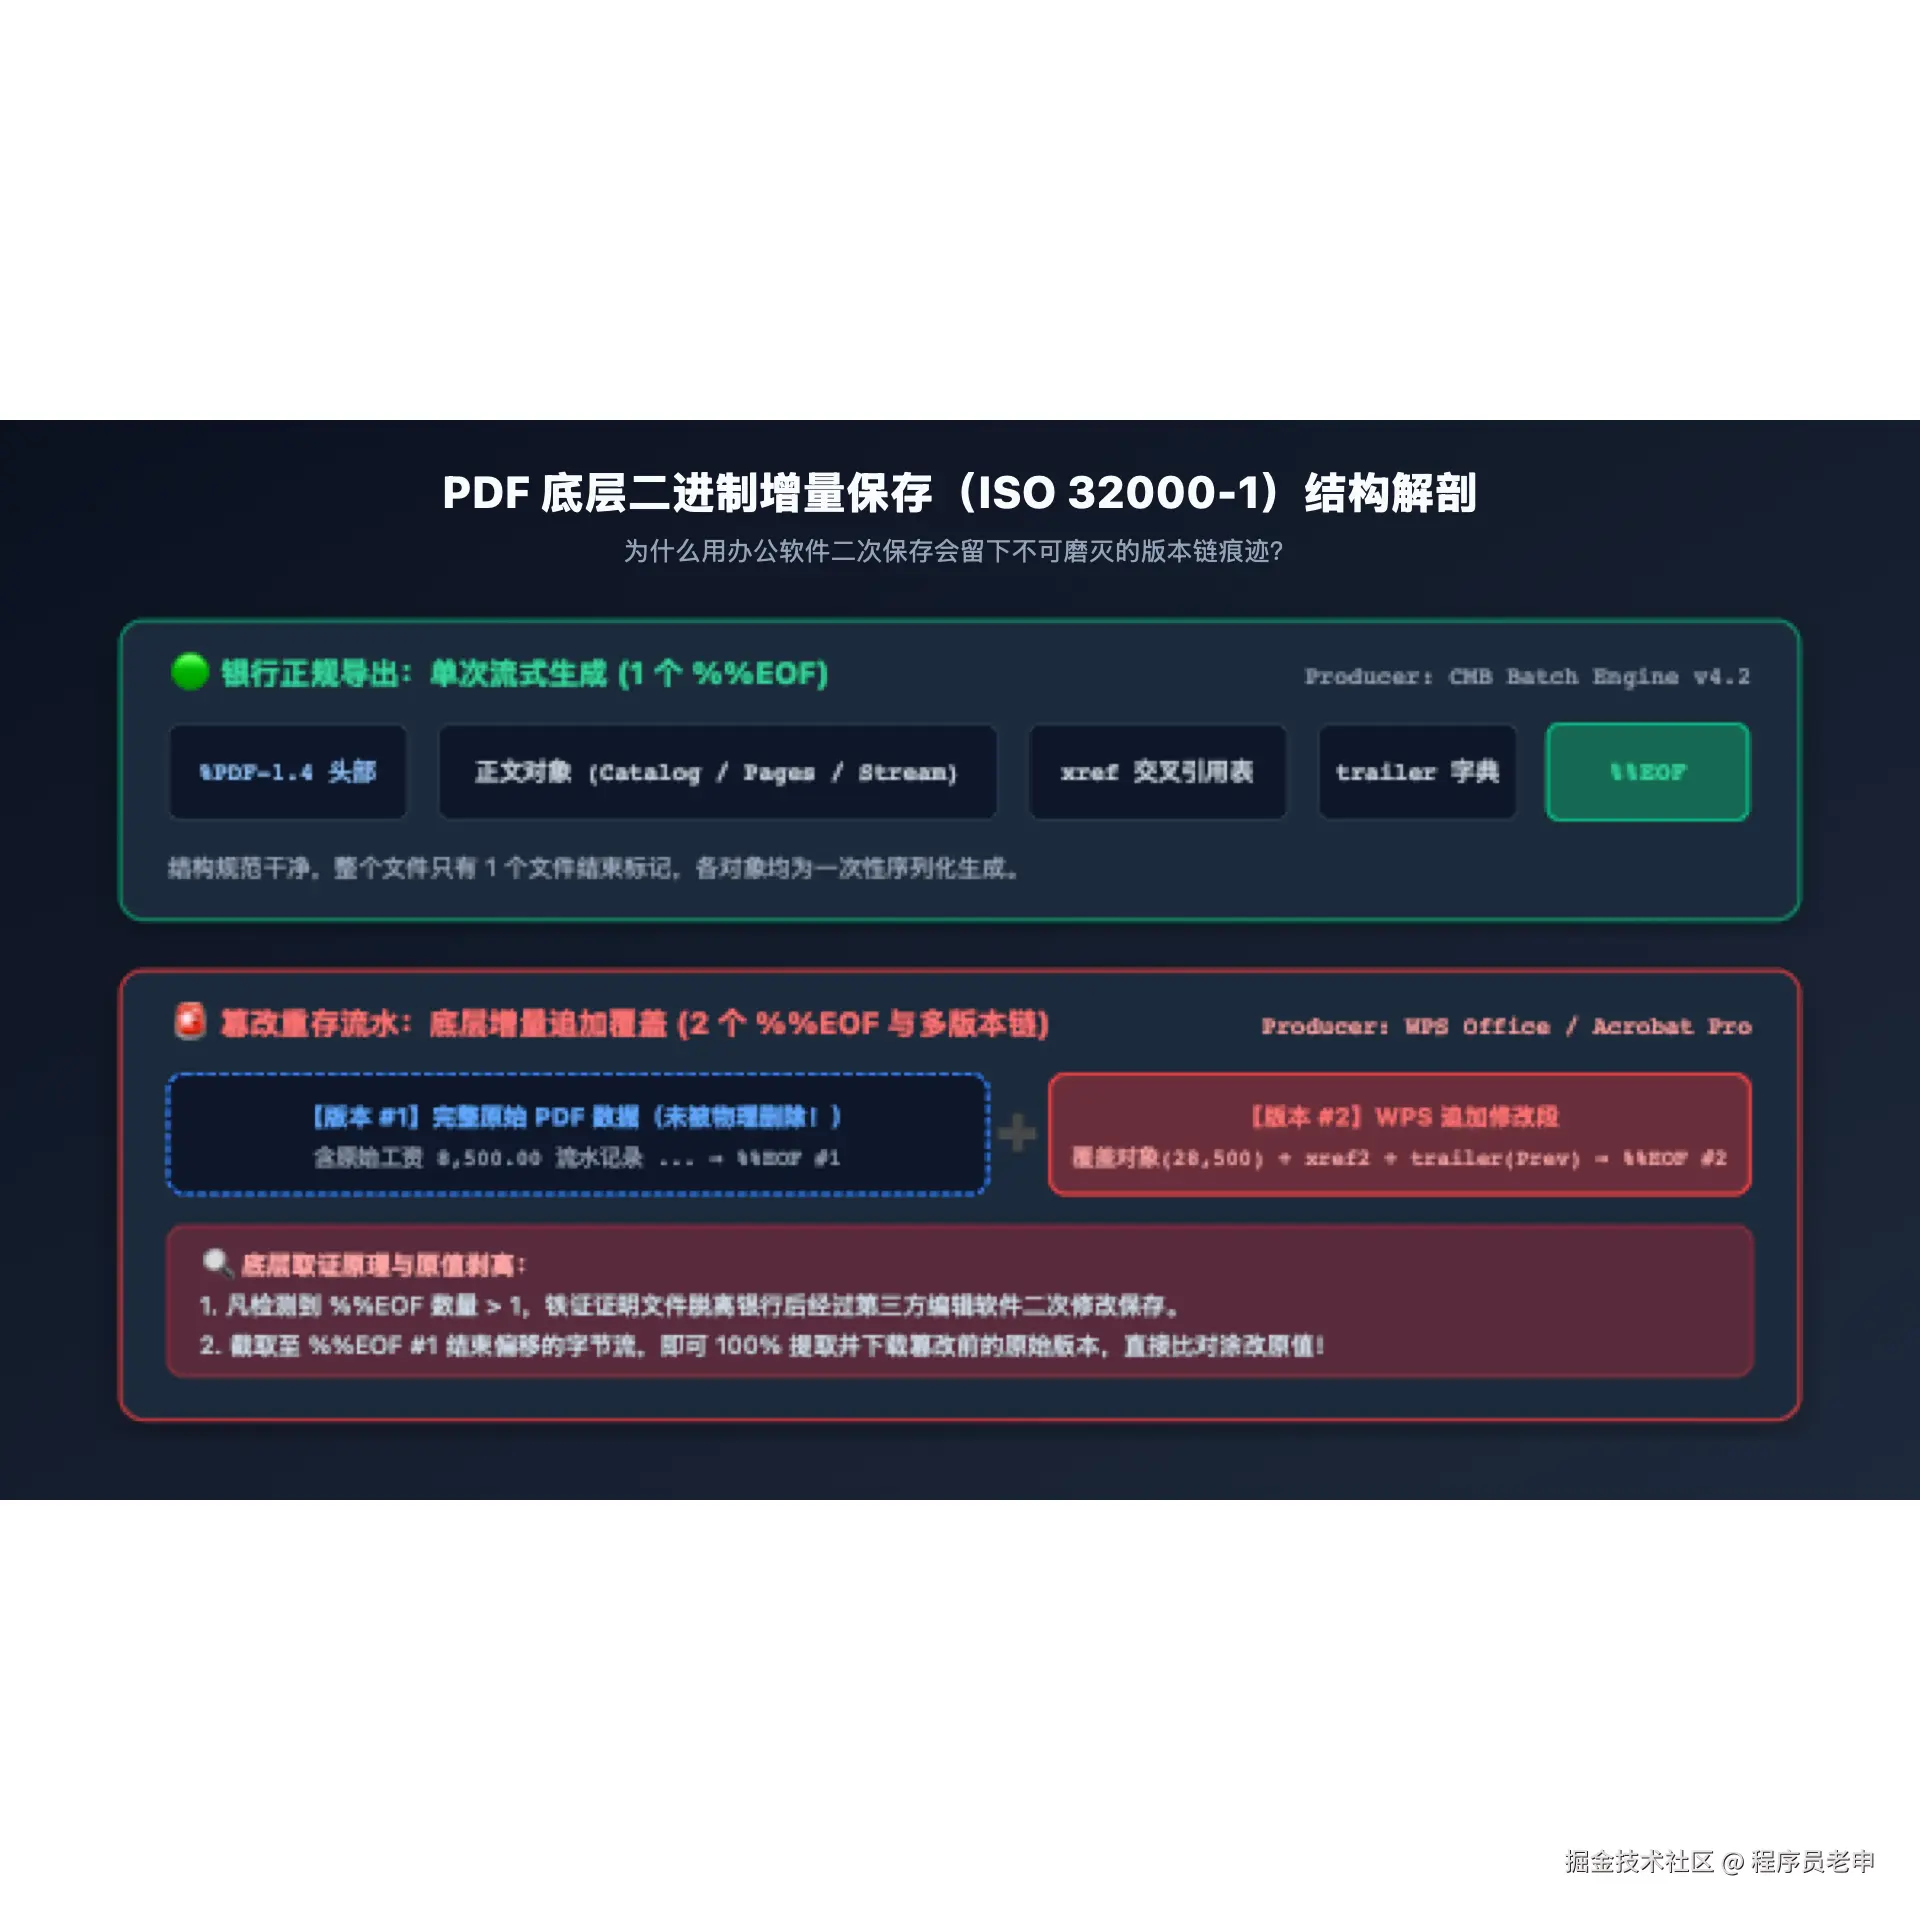
PDF 规范为了支持在几百兆的大文件上秒级追加签名或修改,设计了增量更新链:
- 原文件写入若干个 Object(如
1 0 obj ... endobj),最后是xref表和%%EOF。 - 当你在 WPS 或 Acrobat 里打开文件,双击把数字从 8500 改为 28500 并点击保存时,编辑器默认不会重建整棵对象树,而是在原文件的
%%EOF之后追加修改过的流,再追加一个局部的xref片段,并以新的%%EOF封尾。
为什么这是铁证?
银行或官方核心系统的电子回单服务,均为一次性批处理流式输出(%%EOF 数量严格等于 1)。
只要你在文件中用简单的字符串检索或正则表达式数出了 2 个或更多的 %%EOF:
ini
const eofMatches = rawText.match(/%%EOF/g) || [];
const isMultiVersion = eofMatches.length > 1;
这就客观证明了:文件在生成后,被二次打开并追加写入过。
更残酷的是:既然旧版本的内容根本没有被覆盖,只要截取到第一个 %%EOF 为止的字节流:
ini
const originalPdfBytes = fullBytes.slice(0, firstEofOffset);这个切片本身就是一个完好无损的合法 PDF,能直接在阅读器里打开,把修改前的原值原原本本呈现出来。
二、流水余额链的相邻连续勾稽
改数字容易,平账难。
银行系统的内部账本逻辑必然符合恒等式: 期初余额 + 本期借方发生额 - 本期贷方发生额 = 期末余额
假设造假者只改了其中一笔收入:
- 行 1:期初余额
15,200.00 - 行 2:工资入账涂改为
+28,500.00,账面写43,700.00(原值是+8,500.00/ 余额23,700.00) - 行 3:房租支出
-3,200.00,但造假者漏改了当笔余额,页面依然显示20,500.00
此时对文本流解析出的每笔交易数组跑一遍校验:
ini
for (let i = 1; i < rows.length; i++) {
const prevBal = rows[i - 1].balance;
const curAmt = rows[i].amount;
const expected = Math.round((prevBal + curAmt) * 100) / 100;
if (Math.abs(expected - rows[i].balance) > 0.01) {
console.warn(`第 ${i} 行算术断裂!应为 ${expected},实为 ${rows[i].balance}`);
}
}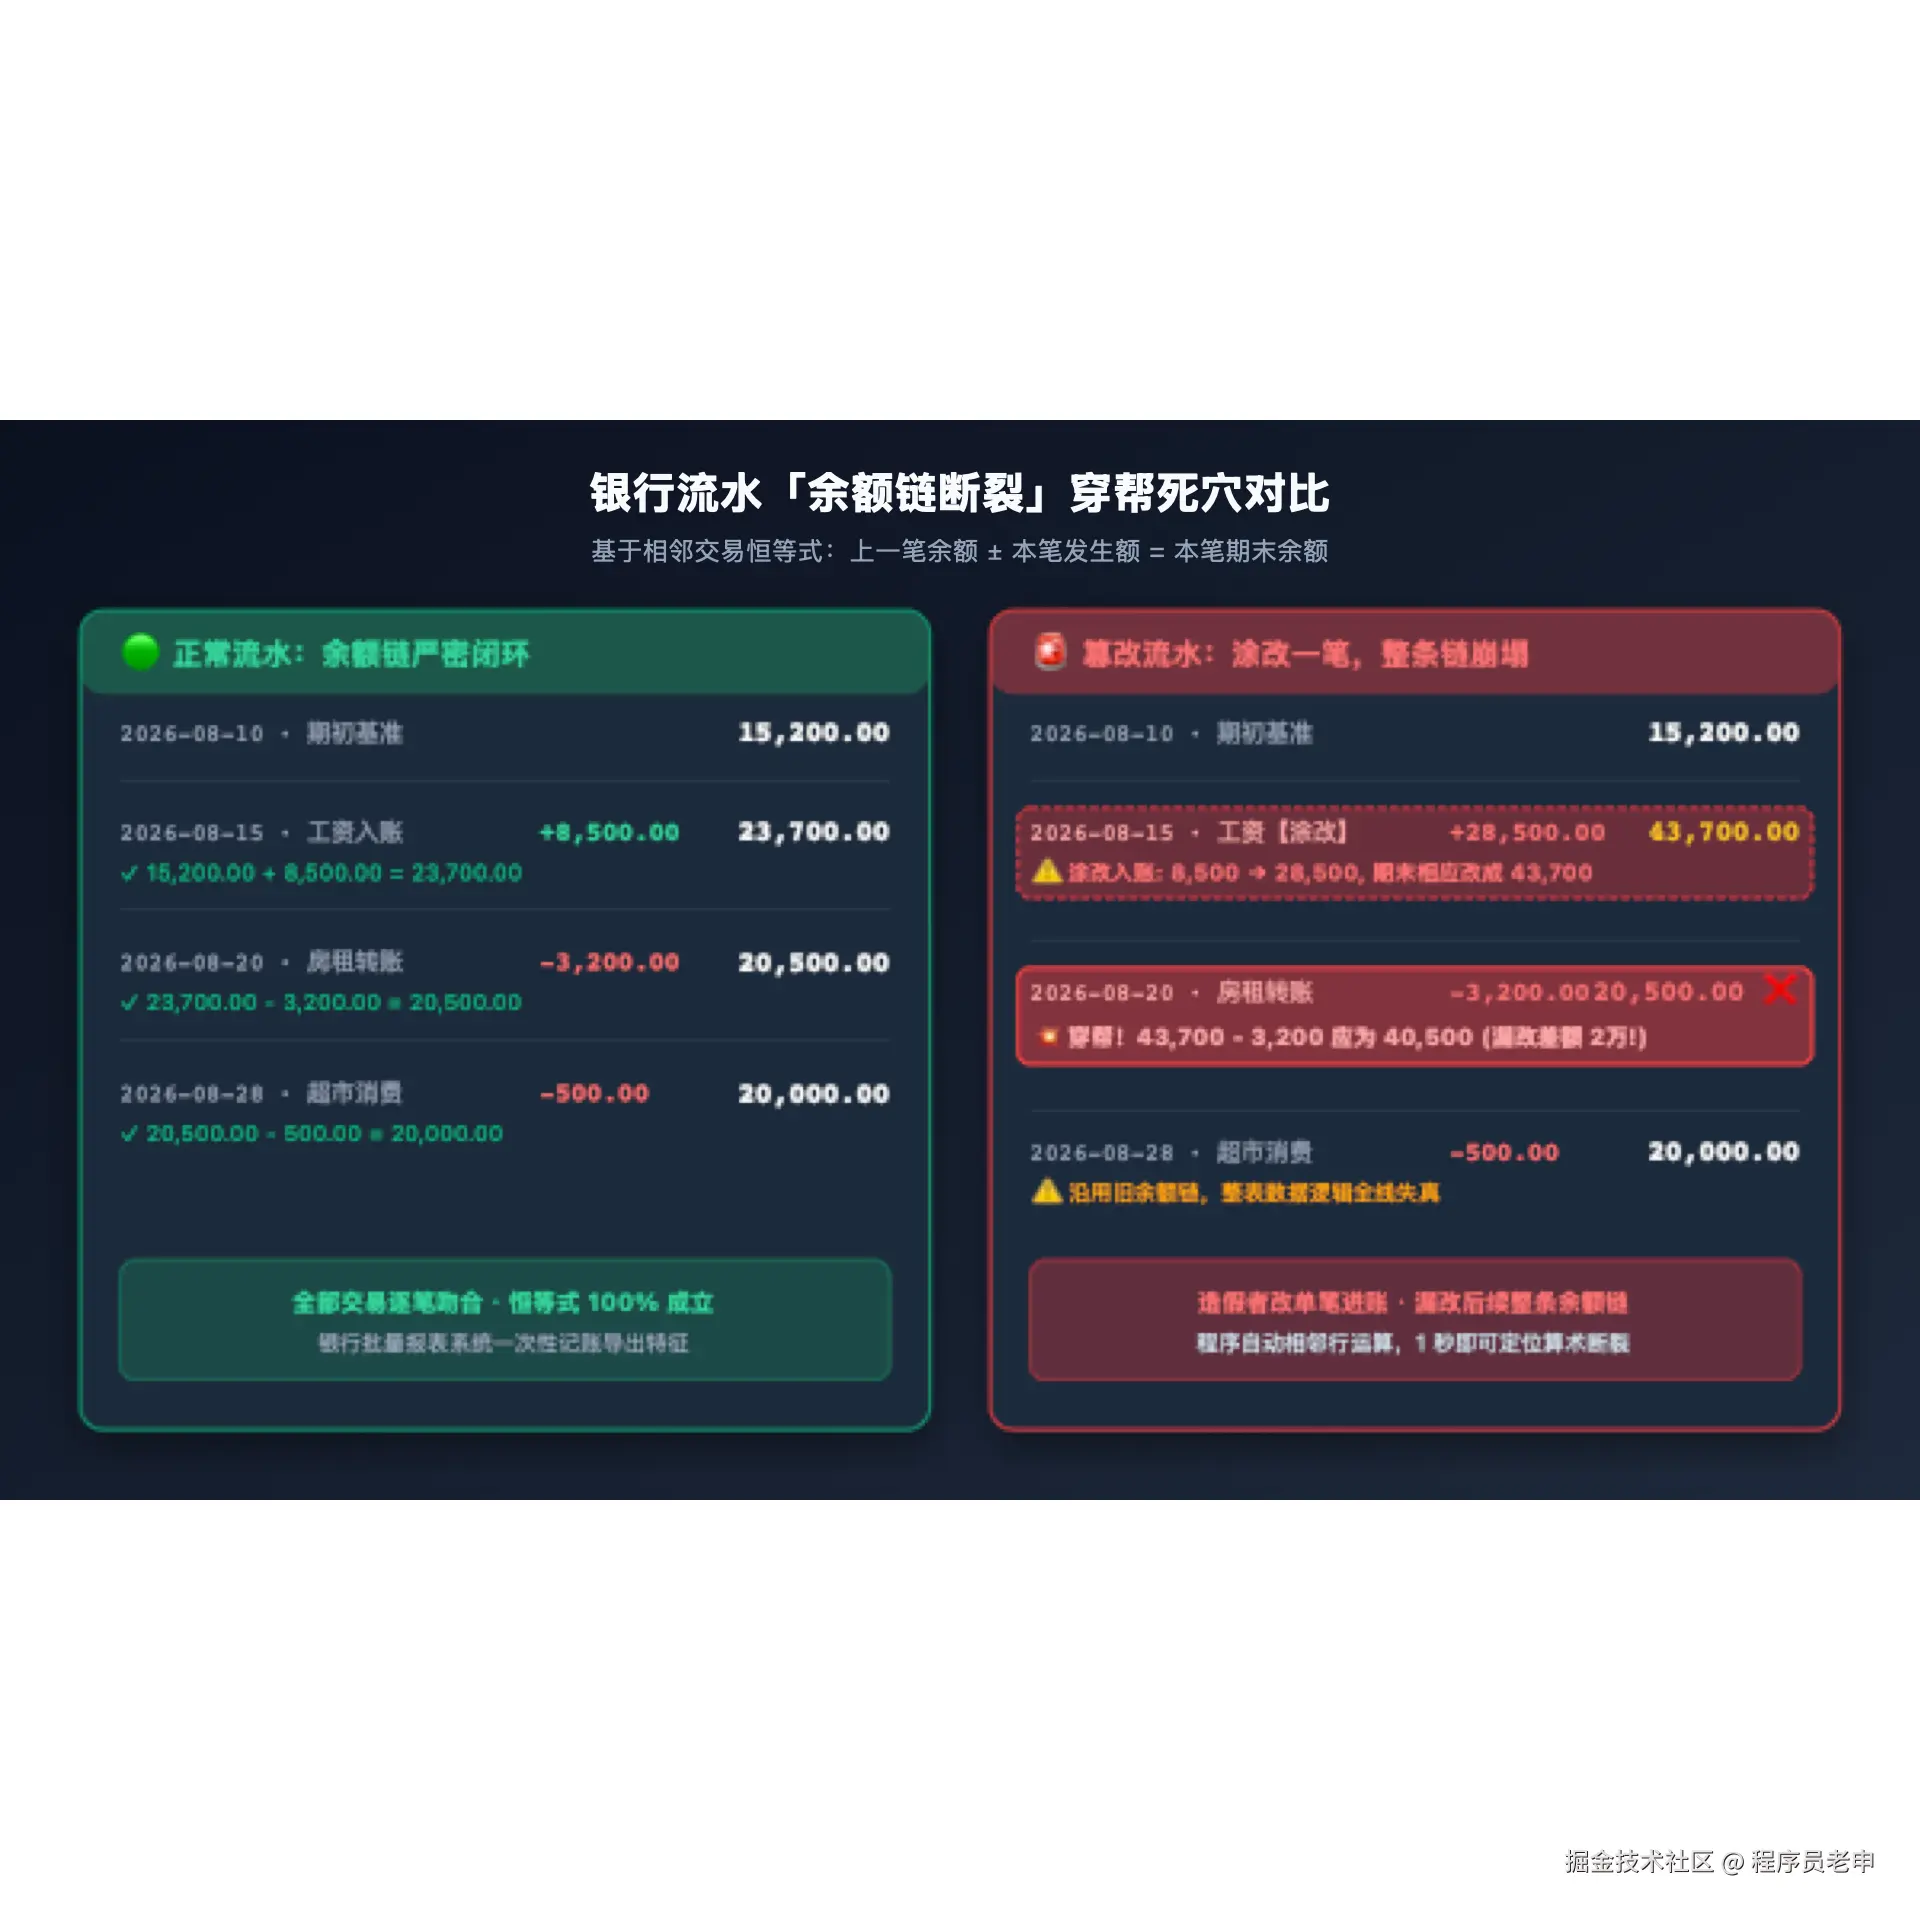 此时行 3 期望余额为
43,700 - 3,200 = 40,500,与标明的 20,500 差额整整 2 万元。这种数值逻辑断裂,骗得过肉眼,骗不过加减法。
三、字体排版微距与 BaseFont 字典
PDF 排版文字时,通过 Tf 指令指定字体字典,通过 Tm 或 Td 确定坐标基准。
在正规报表生成器中,一个表格列使用统一的字体定义。若造假者用修改器局部补字,往往会引发两个特征:
- 同基线混排异体字 :在同一个 Y 轴坐标基准线上,前面的文字声明的是
/F1 11 Tf,被涂改的数字突然切换成了/F2 11 Tf。 - 多重子集前缀 :为了瘦身,PDF 字体多为子集嵌入,名字形如
ABCDEF+SimSun。如果文档里同时出现了ABCDEF+SimSun和XYZUVW+SimSun,说明同一字体被独立内嵌了两次,属于后期擦除补字的典型痕迹。
四、工程审慎性:为什么单个信号不能定性?
在工程设计中,严谨至关重要:
- 真实场景中,正常用户加盖审批章或企业流转盖章,也会造成
%%EOF > 1。 - 部分服务端开源报表组件(如
openhtmltopdf),多页或加粗时确实可能对同名字体拆分内嵌多个子集。 - 文本层由于 CID 自定义映射的存在,若未做 CMap 转换,通用正则可能抓不到明文字符。
因此在工具架构设计上,我们将结果定义为「风险信号」,严禁用程序直接给文件定性「实锤造假」。
五、离线纯前端实现与体验
为了让核验过程完全不触碰用户敏感的薪资与财务隐私,我们将全套 ISO 32000-1 二进制解析做成了一个纯单机静态页面:
- 0 外部依赖,0 外部 API 请求(无 fetch / XMLHttpRequest / WebSocket)
- 使用浏览器原生
DecompressionStream离线解压FlateDecode流 - 断网亦可完整运行