Redis Set 生产实践:命令、编码、场景与避坑
导语 :Redis Set 是无序、唯一、支持交并差的字符串集合。它的价值不在"存",而在"判断存在"和"算关系"。Set 的边界不在"能不能做",而在"做的代价":
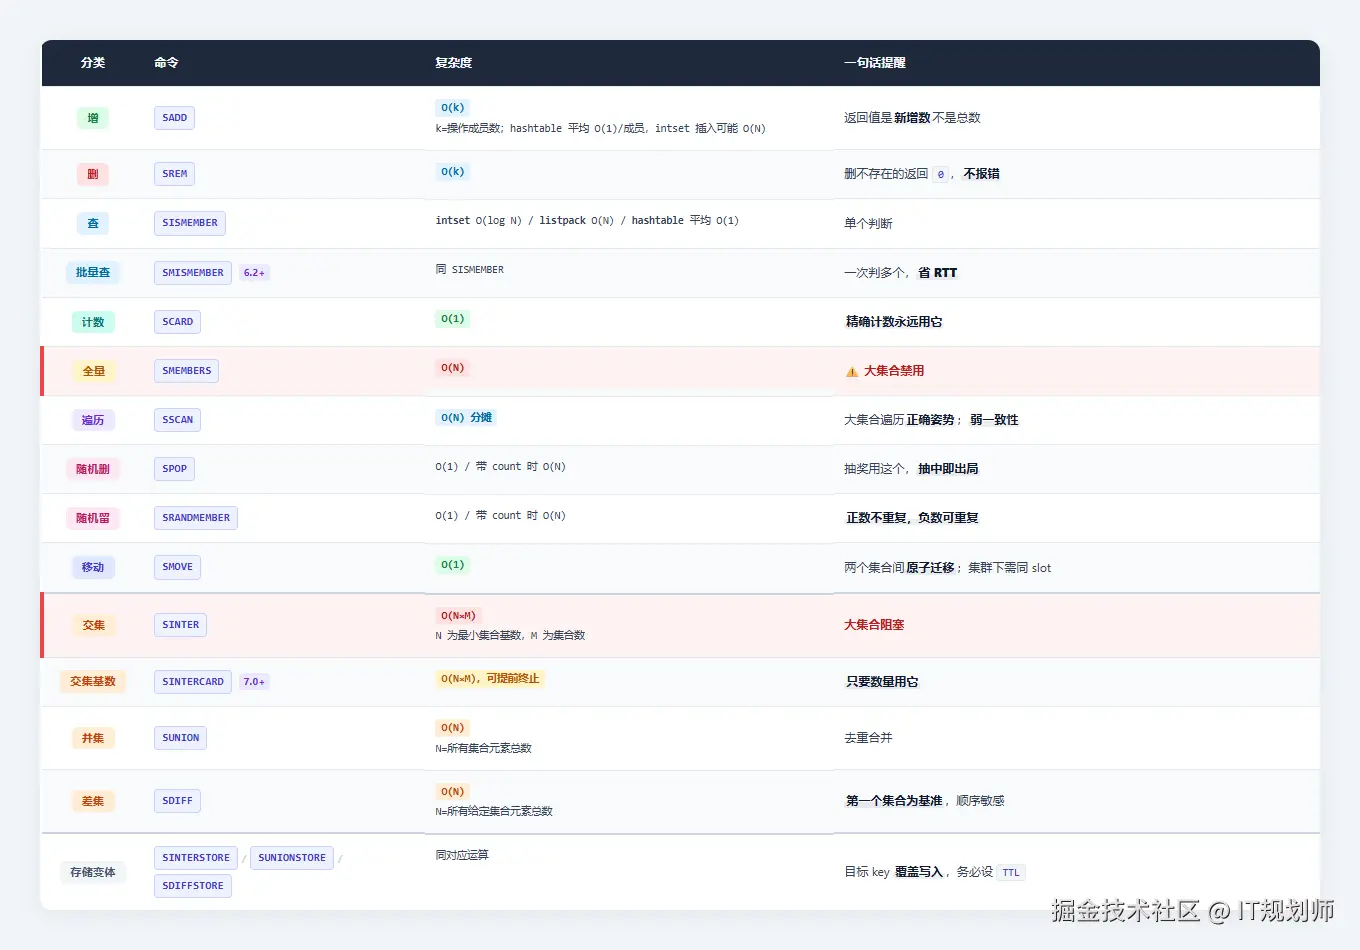
SCARD严格 O(1);SADD/SREM/SISMEMBER在 hashtable 下平均 O(1),在 intset/listpack 下按编码为 O(log N)/O(N);SINTER是 O(N×M);SUNION/SDIFF官方口径是 O(N);SMEMBERS是输出全集的 O(N) 操作。分不清这些代价,Set 就会变成慢查询和内存膨胀的源头。
生产上最容易翻车的三类问题:编码被污染后不可逆、SMEMBERS/大集合运算阻塞主线程、集群跨 Slot 集合运算报 CROSSSLOT。后文分别在编码章、场景章和避坑清单中展开。
三条铁律:
- "查存在、改一个成员"日常可高频用;"算关系、拿全量"先问集合多大。
- 计数永远用
SCARD;遍历大集合用SSCAN,不要SMEMBERS。 - 抽奖用
SPOP,随机展示用SRANDMEMBER;抽奖还要配"每人限一次"的业务去重。
一、Set 定位与复杂度分层
1.1 Set 的定位与边界
Set 只负责"谁在集合里"和"集合之间怎么交并差"。需要顺序、排名、分页、字段级读写、成员级过期时,不应选 Set。
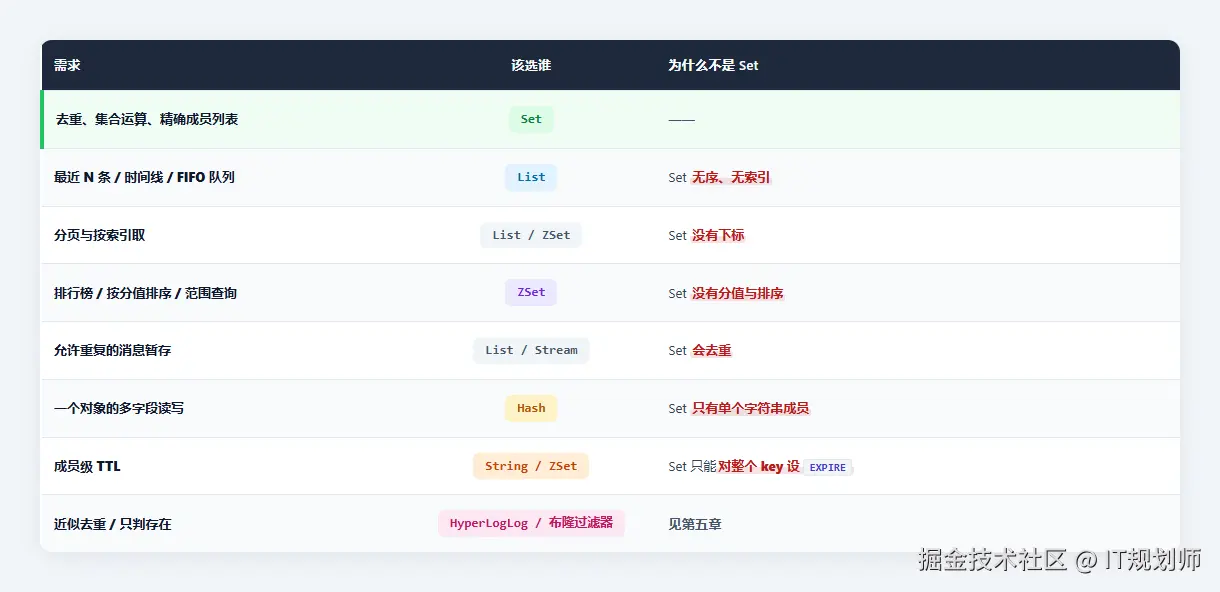
如果对已存 Hash 的 key 执行 SADD,Redis 返回 WRONGTYPE Operation against a key holding the wrong kind of value,不会覆盖。排查用 TYPE key。
1.2 三档复杂度:一眼判断安不安全
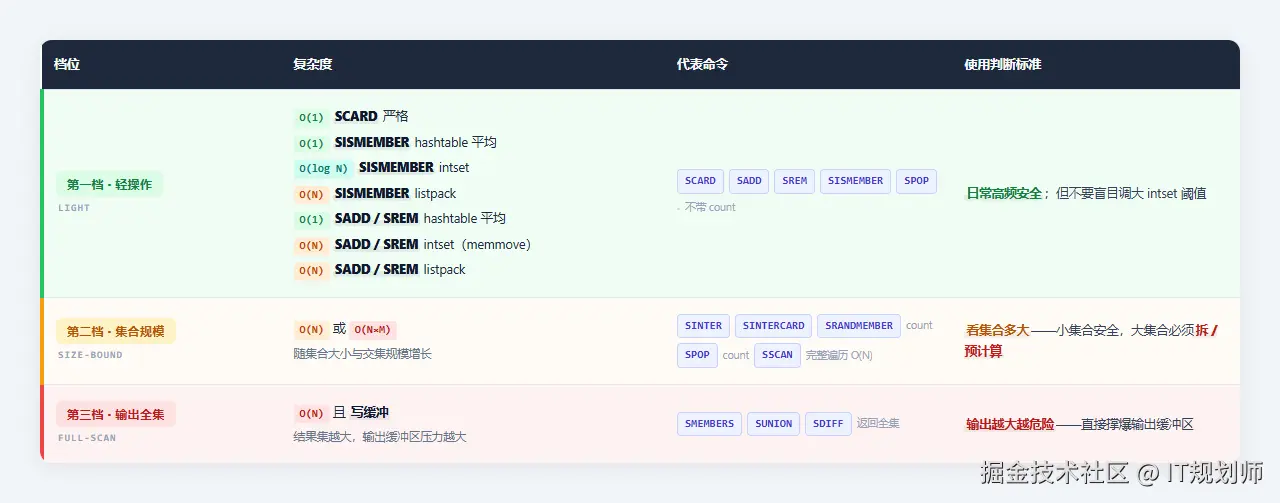
一句话:
SINTER虽然是"读",但它是 O(N×M) 的读,比很多"写"还贵。
1.3 命令复杂度速查
二、核心命令语义与 API
本章只讲命令语义、返回值、复杂度和 API 对照;编码机制见第三章,坑点规避见第六章。
2.1 基础增删查
redis
# SADD:添加一个或多个成员,返回本次真正新增的成员个数(重复成员不计入)
SADD user:1001:tags "Java" "Redis" "分布式"
# SREM:删除一个或多个成员,返回实际删除个数;成员不存在返回 0,不报错
SREM user:1001:tags "Redis"
# SISMEMBER:判断单个成员是否存在,返回 1 存在 / 0 不存在
SISMEMBER user:1001:tags "Java"
# SMISMEMBER(Redis 6.2+):一次判断多个成员,返回与请求顺序对应的 0/1 数组
SMISMEMBER user:1001:tags "Java" "Go" "Redis"
# SCARD:集合基数(成员总数),O(1),直接读内部维护的 count,不遍历
SCARD user:1001:tags
# SMEMBERS:返回全部成员,O(N) 一次性输出;大集合慎用(改用 SSCAN)
SMEMBERS user:1001:tags
必须记住:
SADD返回"新加入的个数",不是操作是否成功。重复添加返回 0。SREM返回实际移除的个数,成员不存在返回 0,不报错。SISMEMBER的复杂度取决于编码:intset 二分 O(log N),listpack 线性 O(N),hashtable 平均 O(1)。SMISMEMBER(6.2+) :一次判断多个成员,替代循环SISMEMBER,省 RTT。SCARD是 O(1) 且精确 :读内部维护的 count。计数永远用它,不要SMEMBERS后取长度。SMEMBERS是 O(N) 且一次性返回全集 :大 Set 会同时打爆服务端输出缓冲区和客户端内存。统计用SCARD,遍历用SSCAN。- Set 成员不支持独立 TTL ,只能对整个 key 设
EXPIRE。
csharp
// SADD 多值重载:返回 long = 本次真正新增的成员个数(StackExchange.Redis 2.x / 3.x 一致)
long addedCount = await db.SetAddAsync("user:1001:tags",
    new RedisValue[] { "Java", "Redis", "分布式" });
// SREM 单值重载:返回 bool = 是否删除成功(成员不存在返回 false)
// 注意:单值删除返回 bool;要拿"实际删除个数"需用数组重载 SetRemoveAsync(key, RedisValue[])
bool removed = await db.SetRemoveAsync("user:1001:tags", "Redis");
// SISMEMBER:返回 bool,成员是否存在
bool exists = await db.SetContainsAsync("user:1001:tags", "Java");
// SCARD:返回 long,O(1) 且精确
long card = await db.SetLengthAsync("user:1001:tags");
// SMEMBERS:返回 RedisValue[],O(N) 无分页;⚠️ 大集合改用 SetScanAsync
RedisValue[] members = await db.SetMembersAsync("user:1001:tags");
2.2 随机与移动
redis
# SPOP:随机弹出 1 个成员并删除(抽中即出局)
SPOP lottery:act1
# SPOP 带 count(3.2+):随机弹出最多 3 个;集合不够时返回数量可能少于 count
SPOP lottery:act1 3
# SRANDMEMBER:随机返回 1 个成员,不删除
SRANDMEMBER lottery:act1
# SRANDMEMBER 带正 count:返回最多 3 个不重复成员
SRANDMEMBER lottery:act1 3
# SRANDMEMBER 带负 count:返回 3 个成员,允许重复(有放回抽样)
SRANDMEMBER lottery:act1 -3
# SMOVE:把成员从 source 原子移动到 destination;成员不在 source 返回 0,目标集合不存在则创建
SMOVE user:1001:following user:1001:blocked "u2002"
关键差异:
SPOP会删除成员,SRANDMEMBER不会 。抽奖"抽中即出局"用SPOP,展示候选或随机推荐用SRANDMEMBER。SRANDMEMBER的 count 符号决定行为:正数返回不重复成员;负数允许重复(有放回抽样)。SPOP带 count 时返回数量可能少于 count,不会报错。SMOVE是原子的单命令 ,适合"关注 → 拉黑"这类两个集合间的迁移;成员不在源集合时返回 0。集群下 source 和 destination 必须在同一 slot,否则报CROSSSLOT。- 复杂度 :
SPOP不带 count 是 O(1),带 count 是 O(N),N 为 count 值;SRANDMEMBER不带 count 是 O(1),带 count 是 O(N),N 为 count 绝对值。
csharp
// SPOP 单值:随机弹出并删除,返回被弹出的成员;集合为空返回 RedisValue.Null
RedisValue winner = await db.SetPopAsync("lottery:act1");
// SPOP 带 count:随机弹出最多 3 个并删除,返回被弹出的成员数组
RedisValue[] winners = await db.SetPopAsync("lottery:act1", 3);
// SRANDMEMBER 带 count:返回最多 5 个不重复成员,不删除
RedisValue[] randomList = await db.SetRandomMembersAsync("recommend:1001", 5);
// SMOVE:原子迁移,返回 bool 表示是否移动成功
bool moved = await db.SetMoveAsync("user:1001:following", "user:1001:blocked", "u2002");
2.3 集合运算
redis
# SINTER:交集,返回同时在所有给定集合中的成员
SINTER tag:java tag:spring
# SUNION:并集,返回去重后的全部成员
SUNION tag:java tag:spring
# SDIFF:差集,第一个集合减去后面所有集合的并集(顺序敏感)
SDIFF tag:java tag:spring
# SINTERCARD(7.0+):只返回交集基数;LIMIT 达到即提前返回,省略 LIMIT 则算到底
SINTERCARD 2 tag:java tag:spring LIMIT 100
# SINTERSTORE:交集写入 dest,覆盖 dest 原有内容;务必为 dest 设置 TTL
SINTERSTORE dest tag:java tag:spring
# SUNIONSTORE:并集写入 dest,覆盖 dest 原有内容
SUNIONSTORE dest tag:java tag:spring
# SDIFFSTORE:差集写入 dest,覆盖 dest 原有内容
SDIFFSTORE dest tag:java tag:spring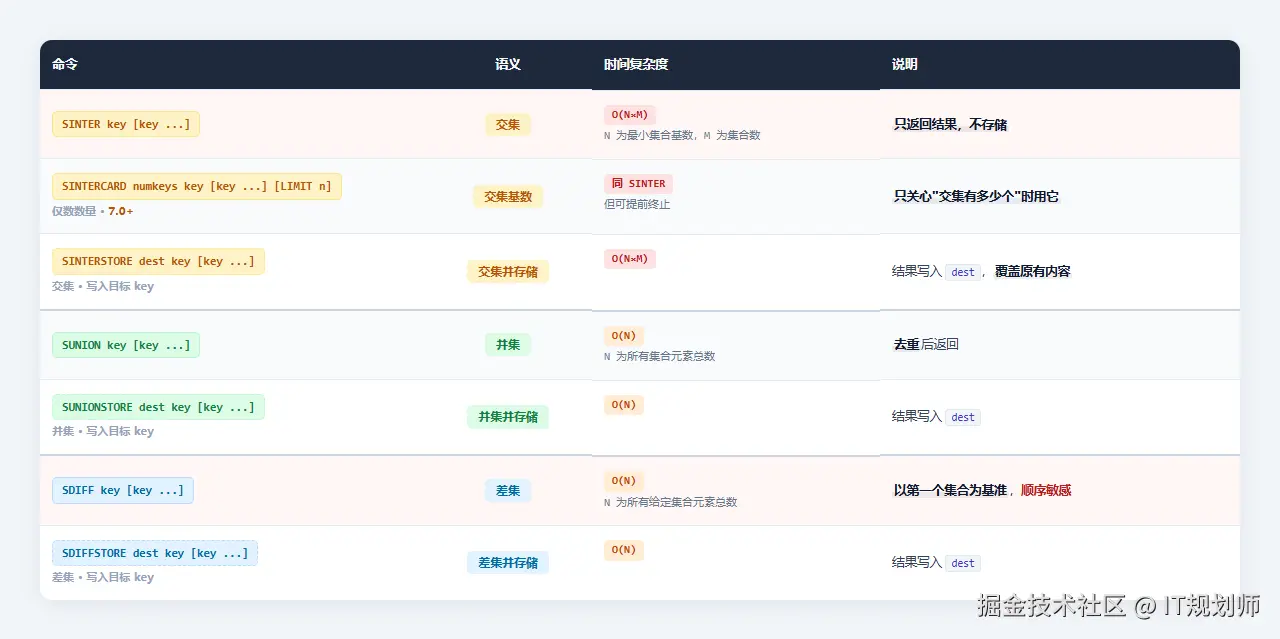
必须记住:
SINTER是 O(N×M),不是 O(N)------它要对最小集合的每个元素去其余集合里逐个探测。两个 50 万的集合求交集,就是上千万次探测,全部压在主线程上。SINTERCARD是 7.0 新增的关键命令 。只返回交集基数,带LIMIT:交集数量达到LIMIT就提前返回(LIMIT 0表示不限制)。但它不改变 O(N×M) 的计算复杂度。SDIFF的语义是"第一个 key 减去后面所有 key 的并集",后面的 key 顺序不影响"并集"本身,但第一个 key 必须是你想保留基准的那个。写反了会得到完全不同的结果,且不报错。- 带
STORE的版本会覆盖目标 key ,不是追加。SINTERSTORE本身是原子的。目标 key 务必设置 TTL。 - 不存在
SUNIONCARD/SDIFFCARD。并集/差集的数量要么用SUNION/SDIFF后取长度,要么用SUNIONSTORE/SDIFFSTORE再SCARD。
csharp
// SINTER:交集,返回 RedisValue[](在 Redis 服务端完成,不拉全量到客户端)
RedisValue[] inter = await db.SetCombineAsync(
    SetOperation.Intersect, new RedisKey[] { "user:1001:friends", "user:2002:friends" });
// SDIFF:差集,顺序敏感,返回 RedisValue[]
RedisValue[] diff = await db.SetCombineAsync(
    SetOperation.Difference, new RedisKey[] { "user:1001:friends", "user:2002:friends" });
// SINTERSTORE / SUNIONSTORE / SDIFFSTORE:结果写入目标 key(覆盖原有内容)
await db.SetCombineAndStoreAsync(
    SetOperation.Union, "feed",
    new RedisKey[] { "user:1001:friends", "user:2002:friends" });
// SINTERCARD(7.0+):只返回交集基数;第 1 个参数 2 是参与运算的集合数
long interCard = (long)await db.ExecuteAsync(
    "SINTERCARD", 2, "user:1001:friends", "user:2002:friends");
2.4 大集合遍历
SSCAN key cursor [MATCH pattern] [COUNT count]:以游标方式增量遍历集合,一次只返回少量元素 + 下一个游标,直到游标回到 0。这是遍历大集合的正确姿势。
redis
# SSCAN:游标遍历,从 0 开始,返回少量元素 + 下一个游标;游标回到 0 表示遍历完成
SSCAN tags:1001 0 MATCH "促*" COUNT 100
SSCAN的COUNT只是"每次尝试返回的提示数量",不保证精确,也不保证一轮遍历完;遍历期间如果有元素增删,可能出现重复或遗漏。做精确全量导出时,业务上要能容忍这种"弱一致性",并允许重跑。
csharp
// SetScanAsync 返回 IAsyncEnumerable<RedisValue>,内部自动推进游标分批拉取
await foreach (var member in db.SetScanAsync("tags:1001", pattern: "*", pageSize: 100))
{
    // 逐条处理,内存友好(不会一次性加载全集)
}
2.5 .NET API 对照与三个坑
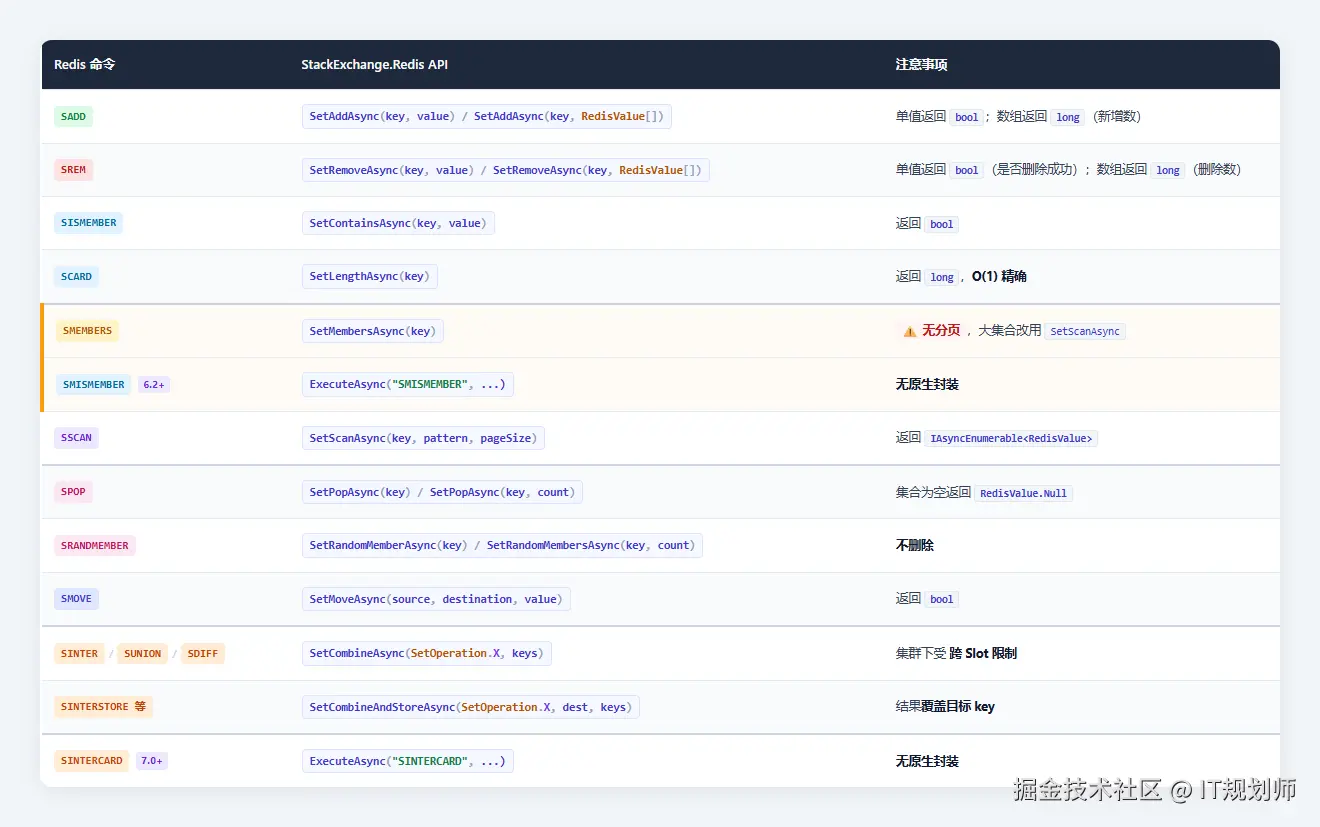
三个坑:
SetAddAsync的返回值 :单值重载返回bool(是否新增),数组重载返回long(新增数)。做"幂等新增"时bool恰好够用。SetRandomMembersAsync(key, count)对应SRANDMEMBER,不会删除 ------想"抽奖"必须用SetPopAsync。SetCombineAsync在集群下同样受跨 Slot 限制 ------key 不在同一 slot 时照样抛CROSSSLOT。
三、编码机制与内存估算
本章把"编码是什么、何时升级、内存怎么估"放在一起;编码坑的规避动作见第六章速查表。
3.1 三种编码
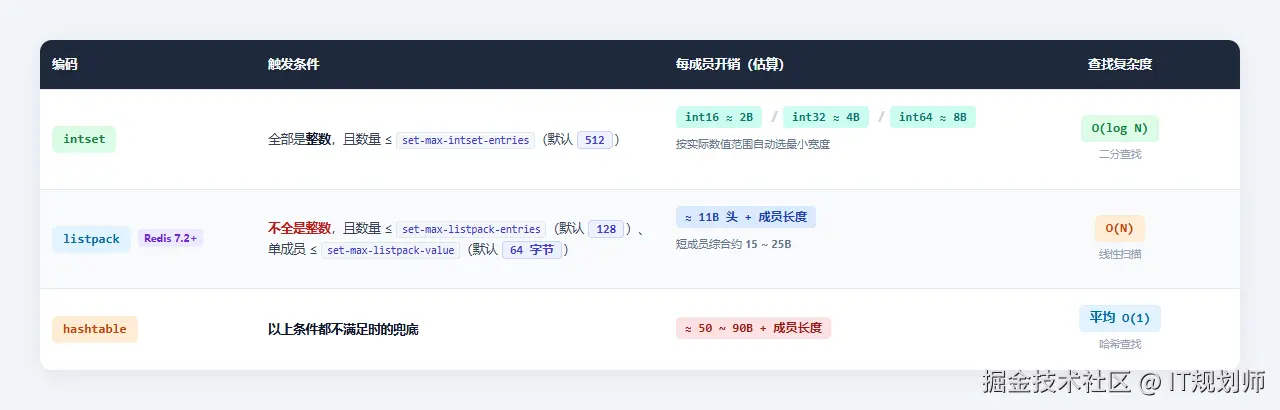
查看当前编码:
redis
# OBJECT ENCODING:查看指定 key 当前使用的编码(intset / listpack / hashtable)
OBJECT ENCODING key
版本事实 :网上不少文章说"Redis 7.0 起 Set 用 listpack",这是错的。7.0 把 listpack 用在了 hash 和 zset 上;Set 的 listpack 编码是 7.2 才引入的 。7.0/7.1 的 Set 只有
intset和hashtable两种。
3.2 intset:最省内存,但只认整数
- 触发条件:集合内全部是十进制整数,且数量 ≤ 512。
- 是什么:一个有序的整数数组。头部记录每个元素用几字节存(int16/int32/int64)和元素个数,后面紧跟连续排列的整数。
- 查找:二分查找 O(log N)。
- 业务收益:内存最省------没有指针、没有哈希桶。
- 业务风险 :
- 只认纯整数 。
"1001"可以,"u_1001"不行,"1001 "(带空格)也不行------混进任何一个非整数成员,整个集合立刻升级。 - 升级后不会降级。
- 插入是 O(N) :intset 要保持有序,插入新元素要
memmove搬移后面所有元素。不要把set-max-intset-entries调得过大。 - 内部宽度还会悄悄升级:int16 → int32 → int64,每次跨边界都会触发一次 O(N) 全量重分配。
- 只认纯整数 。
redis
# 纯整数成员(数量 ≤512)→ 走 intset 编码
SADD nums 1 2 3 100 9999
# 查看编码,应显示 "intset"
OBJECT ENCODING nums
3.3 listpack 与 hashtable
listpack(7.2+):
- 触发条件:元素不全是整数,但数量 ≤ 128 且单个成员 ≤ 64 字节。
- 是什么:一块连续内存,元素紧凑排列,每个元素自己记录长度。
- 业务收益:小集合里存短字符串非常省内存。
- 业务风险:查找是线性扫描 O(N),只适合极小集合。
redis
# 纯字符串成员的小集合(7.2+)→ 走 listpack 编码
SADD str x y z
# 查看编码:7.2+ 显示 "listpack";7.0/7.1 显示 "hashtable"
OBJECT ENCODING strhashtable:
- 触发条件:元素数量超阈值,或单个成员超过 64 字节,或元素含非整数且数量 > 128。
- 是什么:哈希表,查找插入删除平均 O(1)。
- 业务收益:性能最稳。
- 业务风险:内存最贵------每个元素要付出 dictEntry 指针 + 成员 SDS 头 + 哈希桶数组开销。
redis
# 单个成员超过 64 字节 → 直接走 hashtable 编码
SADD big "a_very_long_member_string_over_64_bytes_..........................."
# 查看编码,应显示 "hashtable"
OBJECT ENCODING big
3.4 编码转换边界:单向、不可逆
text
写入成员
   ↓
全部是整数 且 数量 ≤ 512 ? ── 是 ──→ intset(最省)
   ↓ 否
不全是整数 且 数量 ≤ 128 且 单元素 ≤ 64B ? ── 是 ──→ listpack(7.2+,较省)
   ↓ 否
hashtable(最稳,但最费内存)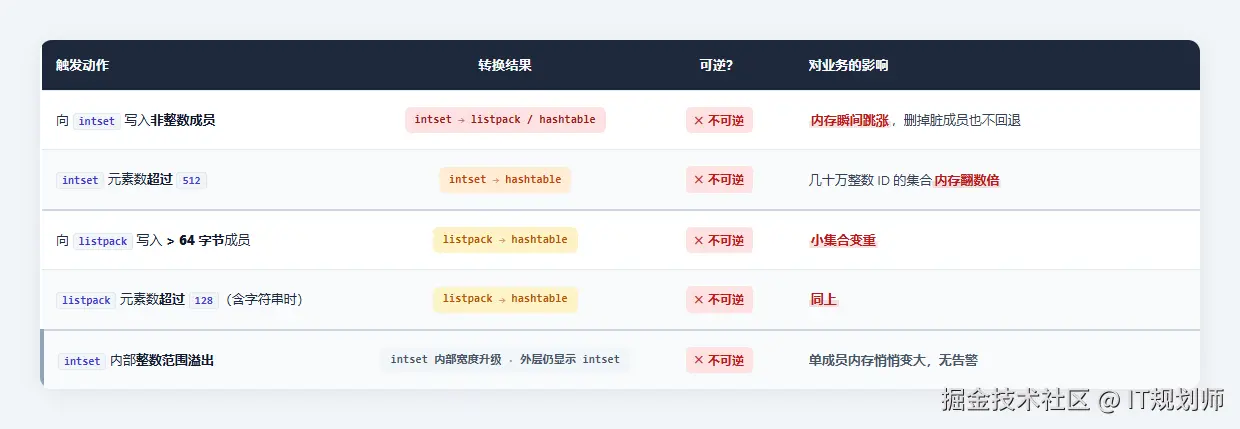
关键业务结论:
- 编码只能单向升级,永远不会自动降级 。想恢复最省编码,只能读出成员、
DELkey、再重新SADD。 - 改配置阈值不会让已有 key 自动重编码------只有新建的 key 才按新阈值判断。
- 一个"脏"成员能毁掉整个集合的省内存收益------写入前做类型校验比事后调优重要。
配置默认值:
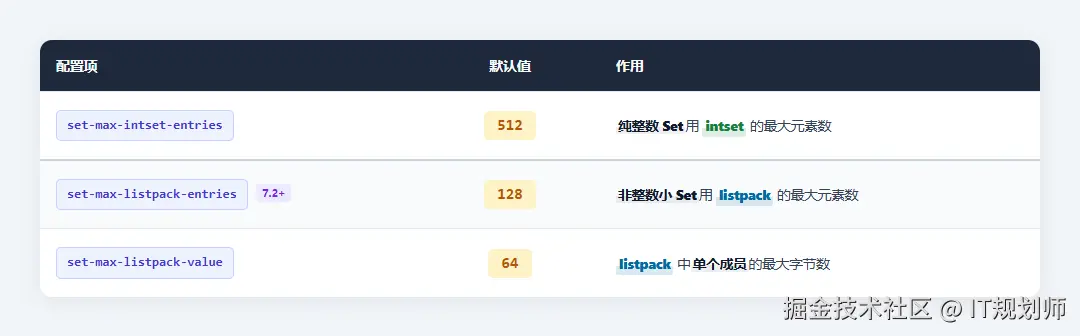
常见错误:把 set-max-listpack-entries 的 128 当成 intset 的阈值,或把 512 当成所有 Set 的通用阈值。intset 和 listpack 是两个不同的编码,阈值不同,触发条件也不同。
3.5 亲手验证编码
redis
# 清空测试 key,避免残留影响结果
DEL demo:set
# 纯整数小集合 → intset
SADD demo:set 1 2 3 100 9999
# 查看编码:intset
OBJECT ENCODING demo:set
# 混入一个字符串成员 → 编码立刻升级
SADD demo:set "abc"
# 查看编码:升级后为 "hashtable"(或 listpack,取决于数量与版本)
OBJECT ENCODING demo:set
# 删掉刚才的字符串成员,验证编码是否会回退
SREM demo:set "abc"
# 查看编码:仍是 "hashtable" ------ 编码不可逆,删成员也不会回退
OBJECT ENCODING demo:set
# 清空字符串测试 key
DEL demo:str
# 纯字符串小集合
SADD demo:str x y z
# 查看编码:listpack(7.2+)
OBJECT ENCODING demo:str
# 查看 intset 最大元素数阈值(默认 512)
CONFIG GET set-max-intset-entries
# 查看 listpack 最大元素数阈值(默认 128,7.2+)
CONFIG GET set-max-listpack-entries
# 查看 listpack 单个成员字节上限(默认 64,7.2+)
CONFIG GET set-max-listpack-value
# 查看单 key 内存估算(不含 jemalloc 对齐,数值偏低,仅参考)
MEMORY USAGE demo:set
3.6 intset 内部还会"悄悄变胖"
intset 会根据成员最大值,在 int16 / int32 / int64 三种整数宽度之间切换:
- 所有成员都在 int16 范围(−32768 ~ 32767)→ 每个元素 2 字节;
- 出现一个超过 int16 的值(如 40000)→ 整个数组升级为 int32,所有元素重新分配、拷贝一次,O(N);
- 再出现超过 int32 范围的值 → 升级为 int64。
redis
# 清空测试 key
DEL demo:width
# 小整数成员 → intset(内部按 int16 存储,每元素 2 字节)
SADD demo:width 1 2 3
# 查看编码:intset
OBJECT ENCODING demo:width
# 写入超过 int16 范围的值(100000)→ 内部升级 int32
SADD demo:width 100000
# 查看编码:编码名仍是 intset,但每个元素已占 4 字节
OBJECT ENCODING demo:width
# 写入超过 int32 范围的值 → 内部升级 int64
SADD demo:width 99999999999
# 查看编码:编码名仍是 intset,每个元素已占 8 字节
OBJECT ENCODING demo:width
影响:
OBJECT ENCODING只告诉你"是 intset",不会告诉你内部是 int16 还是 int32/64。两个都显示intset的集合,内存可能差 4 倍。当业务 ID 从 0 缓慢增长时,会在某天跨过 int16/int32 边界,触发一次 O(N) 全量重分配------频率很低,但大集合上那一刻会偶发延迟毛刺。规避:如果确定 ID 会很大,别指望 intset 省那点内存------直接按 int64 量级估算,或考虑 Bitmap(连续非负整数场景)。
3.7 内存占用估算
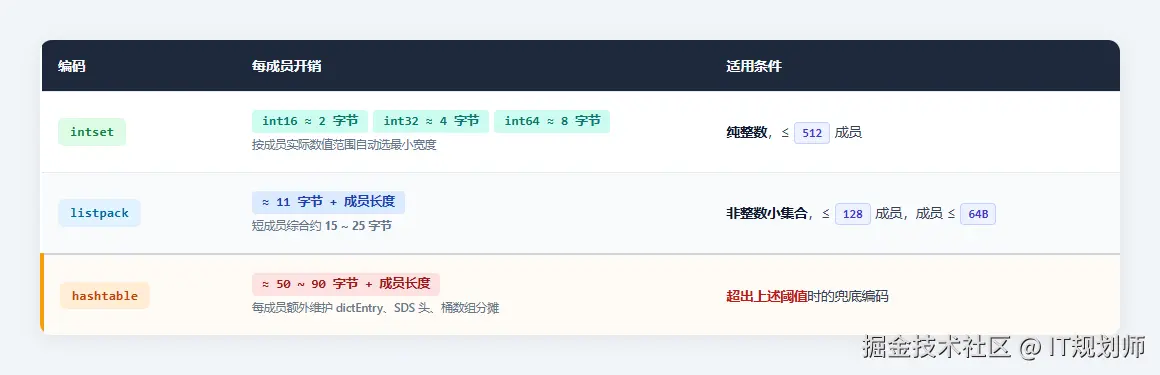
粗略公式(64 位、jemalloc):
text
intset:    单 Set ≈ 16 + N × 8              (按 int64 估;实际可能 2/4/8)
listpack:  单 Set ≈ 70 + N × (11 + 平均成员长度)
hashtable: 单 Set ≈ 120 + N × (80 + 平均成员长度)
快速心算口诀(仅适用于 hashtable 编码):按"每个成员约 60 字节"估。10 万成员 ≈ 6 MB,100 万成员 ≈ 60 MB。intset 按 2/4/8 字节/成员估,listpack 按 11B + 成员长度估------不要拿 60 字节套到 intset 上 。口径说明:心算取 60 字节/成员,保守演算取 80 字节/成员(区间 50~90,取偏保守);容量评估建议按 80 预留余量。
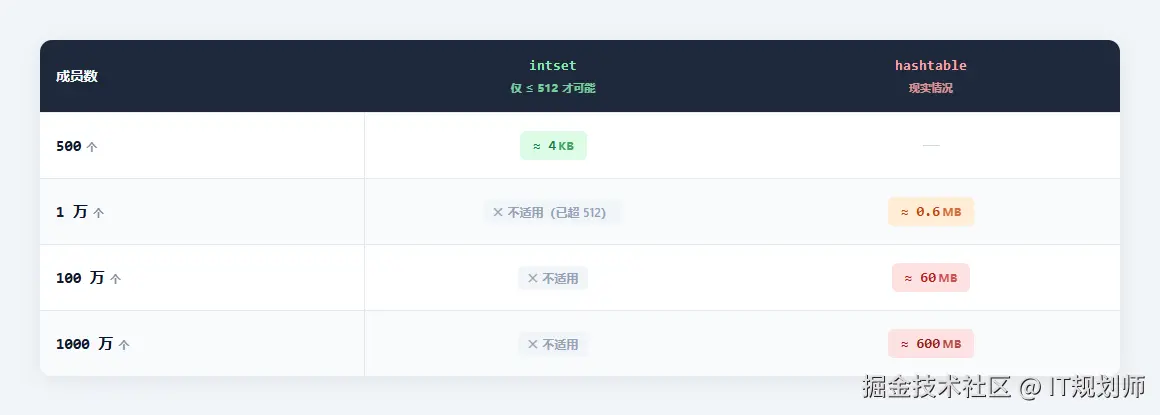
关键认知:intset 只在 ≤512 个整数时生效。一旦集合超过 512 个整数,就升级 hashtable------所以"100 万个整数 ID 的 Set"根本无法停在最省内存的 intset 上,它一定是 hashtable,单元素开销从 8 字节跳到数十字节。
text
100 万个整数 ID 的 Set(hashtable):
  每个元素 ≈ dictEntry(24) + 成员 SDS 头(16) + 桶指针(8) + jemalloc 对齐 → 约 50~90 字节
  100 万 × 60 字节 ≈ 60 MB
  + 键与对象头开销
  → 单个 key 约 60~80 MB 量级
完整演算示例:
text
10 万个 Set,每个 500 个整数成员:
  每 Set ≈ 16 + 500×8 = 4,016 B
  10 万 × 4,016 B ≈ 383 MB(intset)

同样 10 万个 Set,如果因为一个字符串成员全部转成 hashtable:
  每 Set ≈ 120 + 500×(80+0) ≈ 40,120 B
  10 万 × 40KB ≈ 3.8 GB

100 万整数 ID 的单个 Set:
  intset 只在 ≤512 时生效,100 万必然走 hashtable:
  100 万 × 80B ≈ 80 MB
MEMORY USAGE只是估算:它不含 jemalloc 内存对齐的浪费、不含哈希桶数组的冗余。做容量规划时,以INFO memory的used_memory前后增量为准更可靠。
3.8 编码业务结论
- 纯整数 ID 集合:守住 intset 的"纯度",不要混入字符串、带空格数字或 UUID。
- 小字符串集合(≤128 个、单成员 ≤64B):7.2+ 会走 listpack,内存很省;但查找是 O(N),只适合极小集合。
- 一旦进入 hashtable:性能稳定 O(1),但每成员内存最贵;删成员不会退回紧凑编码,只能 DEL 重建。
- intset 内部宽度升级 :
OBJECT ENCODING看不出来,容量评估按 int64 更稳。
四、业务场景实战
本章每个场景按"数据模型 / 命令选择 / 代码 / 边界"组织;典型故障以"案例"嵌入,完整复盘见第六章。
4.1 场景一:去重与幂等
需求:判断"这个用户是否已经参加过""这个设备是否已经上报过",要求低延迟、允许 Set 规模可控。
redis
# SADD 首次添加:返回 1 表示"新加入"(幂等判断的核心)
SADD processed:2026-11-01 "order:1001"
# SISMEMBER 判断是否已处理:返回 1/0
SISMEMBER processed:2026-11-01 "order:1001"
# SADD 再次添加同一成员:返回 0,重复被忽略(Set 天然去重)
SADD processed:2026-11-01 "order:1001"
csharp
// 去重提交:SADD 单值重载返回 bool,天然表达"是否首次添加"
public async Task<bool> TrySubmitAsync(string bizKey, long userId)
{
    // 返回 true = 首次提交;false = 已提交过(幂等命中)
    return await db.SetAddAsync($"idemp:{bizKey}", userId);
}
为什么用 Set:SADD 在 hashtable 下平均 O(1),返回值天然告诉你"是否首次添加"。
边界:
- Set 规模要可控 。按天/按批次分 key,配合
EXPIRE。 - 去重不是"永久"的:Set 成员没有 TTL,过期只能靠整个 key 过期。
- 千万级以上去重:评估布隆过滤器或 HyperLogLog,而不是硬扩 Set。
- 黑名单场景 :定期异步
SSCAN清理过期条目;不要DEL直接删大 Set,用UNLINK。 - 导出类需求不要
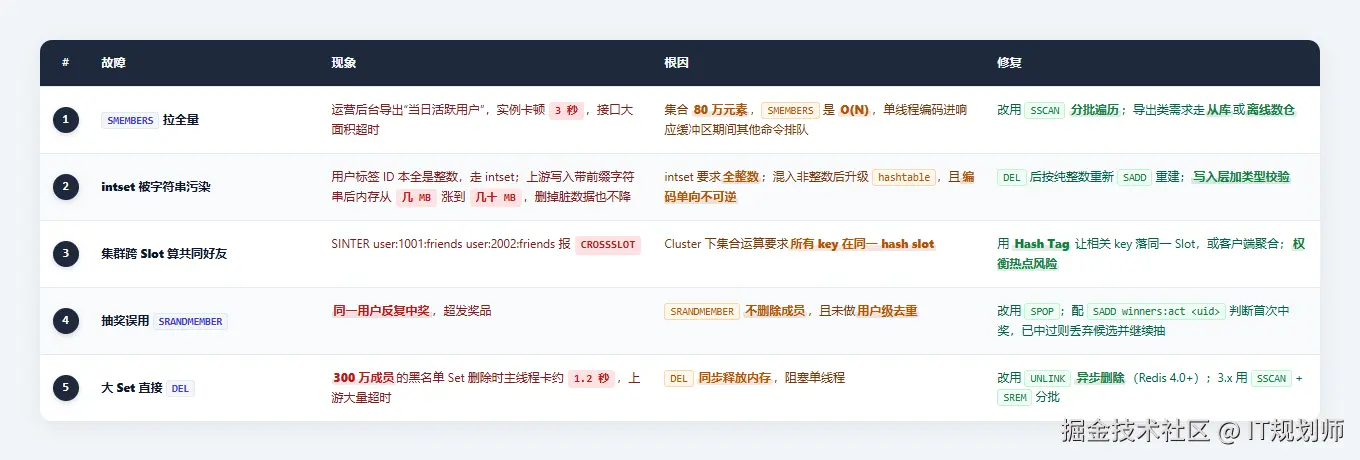
SMEMBERS:大 Set 上SMEMBERS是 O(N) 且一次性写输出缓冲区。案例见 6.1 故障 1。
4.2 场景二:标签系统------SINTER 的双刃剑
数据模型:倒排索引------每个标签一个 Set,成员是内容 ID 或用户 ID。
redis
# 正向索引:记录"这篇文章打了哪些标签"
SADD tags:article:1001 "redis" "backend"
# 反向索引:记录"这个标签下有哪篇文章"(检索核心)
SADD tag:redis:articles 1001 1002
# 反向索引:另一个标签的文章集合
SADD tag:backend:articles 1002 1003
# 多标签筛选:同时命中多个标签的文章(交集)
SINTER tag:redis:articles tag:backend:articles
# 只关心交集数量(7.0+):比 SINTER 更省,可提前终止
SINTERCARD 2 tag:redis:articles tag:backend:articles LIMIT 20
# 高频组合预计算:交集结果写入缓存 key(覆盖原内容)
SINTERSTORE cache:tag:redis_backend tag:redis:articles tag:backend:articles
# 为缓存 key 设置 TTL,避免僵尸 key 长期占用内存
EXPIRE cache:tag:redis_backend 3600
csharp
// 打标签:正向 + 反向索引双写
public async Task TagArticleAsync(long aid, params string[] tags)
{
    // SelectMany 把每个标签的两次写入任务摊平,Task.WhenAll 统一等待
    await Task.WhenAll(tags.SelectMany(t => new[]
    {
        // 正向索引:文章 → 标签
        db.SetAddAsync($"tags:article:{aid}", t),
        // 反向索引:标签 → 文章(检索用)
        db.SetAddAsync($"tag:{t}:articles", aid)
    }));
}

// 多标签筛选:交集(StackExchange.Redis 无 SetIntersectAsync,用 SetCombineAsync)
public async Task<List<long>> FindCommonArticlesAsync(string tag1, string tag2)
{
    // SINTER:返回交集成员,再转成 long 列表返回
    var r = await db.SetCombineAsync(
        SetOperation.Intersect,
        $"tag:{tag1}:articles", $"tag:{tag2}:articles");
    return r.Select(x => (long)x).ToList();
}
为什么用 Set:把"关系判断"下推到 Redis,避免把两个标签的全量成员拉到客户端做嵌套循环。
结构性风险:大标签的交集代价。 如果一个通用标签覆盖 300 万内容,它和小众标签做 SINTER 时,如果通用标签是"最小集合"(例如另一个集合更大),遍历成本就由它决定;如果最小集合是小众标签,遍历次数看似小,但交集结果可能很大,输出和存储成本仍要评估。压测中 4 个平均 20 万成员的 Set 做 SINTER,P99 可达 120ms+,而且 SINTER 没有超时控制。
生产级做法:预计算 + TTL 缓存 。高频组合的筛选结果离线或事件触发预计算成新 Set,设 TTL;请求只读 cache:*。标签变更时主动 DEL 缓存,下次重建。
另一个优化:只关心"有没有交集"时用 SINTERCARD。7.0+ 只返回交集基数,减少网络传输和客户端解析开销;但它不改变 O(N×M) 的计算复杂度。
标签系统的额外边界:
SDIFF做排除时要小心顺序 :SDIFF tag:java tag:ai是"Java 减去 AI",反过来结果不同。多级排除需要先SINTERSTORE构建基准,再链式SDIFF。- 不要用
SMEMBERS拉全量标签再在客户端筛选 。用SSCAN或预计算。 - 正反向索引双写的一致性 :严格原子时用 Lua 脚本把两次
SADD包在一起;允许最终一致时用 Pipeline/WhenAll,并在业务侧补偿。 - 集群环境 :多个
tag:*必须落在同一 Slot,可用 Hash Tag。
4.3 场景三:共同好友 / 共同关注------SINTER 的正确打开方式
redis
# 用户 1001 的好友集合
SADD friends:1001 2001 2002 2003
# 用户 1002 的好友集合
SADD friends:1002 2002 2003 2004
# 共同好友(交集):2002、2003
SINTER friends:1001 friends:1002
# 差集一:1001 关注但 1002 没关注 → 2001
SDIFF friends:1001 friends:1002
# 差集二:反过来算 → 2004(顺序敏感,结果不同)
SDIFF friends:1002 friends:1001
# 只要共同好友数量(7.0+):更轻,不返回具体成员
SINTERCARD 2 friends:1001 friends:1002
csharp
// 共同好友:本质就是求交集
public async Task<List<long>> CommonFriendsAsync(long a, long b)
{
    // SINTER:在 Redis 服务端完成交集,避免把两个好友列表拉到客户端
    var r = await db.SetCombineAsync(
        SetOperation.Intersect, $"friends:{a}", $"friends:{b}");
    return r.Select(x => (long)x).ToList();
}
为什么用 Set:共同好友本质就是交集,SINTER 在服务端完成,不需要把两个用户的好友列表拉到客户端。只展示"共同好友数"而不需要具体是谁时,用 SINTERCARD 更轻。
边界与坑点:
- 好友数很大的用户 :
SINTER的复杂度由最小集合决定,所以和一个好友数很少的用户算交集通常很快;但两个"大 V"互相算共同好友,代价就是大集合的规模。对超大好友列表,考虑分片或预计算热门关系。 - 二度人脉:暴力实现在大 V 场景下是灾难。生产上通常预计算、限制深度、只展示 Top N,或交给图数据库。
- 集群环境下
SINTER的所有 key 必须在同一 slot ,否则报CROSSSLOT。用 hash tag 把需要一起运算的 key 绑到同一槽,但要注意热点风险。案例见 6.1 故障 3。 - 好友关系变更后,预计算的共同好友缓存要及时失效。
SUNIONSTORE/SINTERSTORE产生的中间 key 务必设 TTL。
4.4 场景四:随机抽样与抽奖------SRANDMEMBER / SPOP
redis
# 奖池初始化:写入 5 个候选用户
SADD lottery:2026-11-02 1001 1002 1003 1004 1005
# 预览候选:随机返回 3 个,不删除(展示用)
SRANDMEMBER lottery:2026-11-02 3
# 正式开奖:随机弹出 3 个并删除(抽中即出局)
SPOP lottery:2026-11-02 3
# 有放回抽样:负 count 允许重复(如转盘连转 3 次)
SRANDMEMBER wheel:prizes -3
csharp
// 抽奖:SPOP 弹出即删除,抽中即出局
public async Task<List<long>> DrawAsync(string activity, int count)
{
    var winners = new List<long>();
    for (int i = 0; i < count; i++)
    {
        // SetPopAsync 原子弹出 1 个;集合为空时返回 RedisValue.Null(不抛异常)
        var w = await db.SetPopAsync(activity);
        if (w.IsNull) break;
        winners.Add((long)w);
    }
    return winners;
}
权重抽奖的正确做法 :Set 不能靠重复成员提高概率,因为 SADD 会去重。正确方案有三种:
- ZSet 存权重,业务侧按总权重随机;
- List 允许重复成员做简单权重池 ,但随机弹出需要额外设计,不推荐直接用
SPOP; - 应用层加权随机,Redis 只存候选和权重。
ZSet 示例:
redis
# ZSet 存权重:prizeA 权重 3,prizeB / prizeC 权重 1
ZADD lottery:weights 3 prizeA 1 prizeB 1 prizeC
csharp
// 权重抽奖(ZSet 方案):生产可缓存权重,此处演示按总权重随机
var entries = await db.SortedSetRangeByRankWithScoresAsync("lottery:weights");
// 总权重 = 所有成员的分数之和
var total = entries.Sum(e => e.Score);
// 随机数落在 [0, 总权重) 区间,保证按权重分布
var r = Random.Shared.NextDouble() * total;
// 沿权重区间逐个扣减,落到哪个成员就选中哪个
foreach (var e in entries)
{
    r -= e.Score;
    if (r <= 0) return e.Element;
}
// 浮点兜底:理论上走不到这里,返回最后一个成员
return entries[^1].Element;
防"同一用户重复中奖"的流程 :SPOP 只保证"池内不重复",不保证"用户级不重复"。生产做法是 SPOP 抽出一个候选后,再 SADD winners:act <uid> 判断返回值:1 表示首次中奖,0 表示已中过。注意:候选已经被 SPOP 弹出;如果 SADD winners 返回 0,说明该用户已中过,应丢弃该候选并继续抽,而不是把它放回池子。 同时要限制重试次数,并检查池是否耗尽,防止死循环。
csharp
// 防重复中奖:SPOP 弹出候选 → SADD winners 判断是否首次中奖
// 已中过的候选已被弹出,直接丢弃继续抽;限制重试次数、检查池耗尽
public async Task<List<long>> DrawUniqueAsync(string activity, int count, int maxAttempts = 100)
{
    var winners = new List<long>();
    for (int attempt = 0; attempt < maxAttempts && winners.Count < count; attempt++)
    {
        // SPOP:原子弹出 1 个候选;集合为空返回 RedisValue.Null(池耗尽)
        var w = await db.SetPopAsync(activity);
        if (w.IsNull) break;
        // SADD winners:返回 true = 首次中奖,记入结果;false = 已中过,丢弃继续
        if (await db.SetAddAsync($"winners:{activity}", w))
            winners.Add((long)w);
    }
    return winners;
}
边界:
SPOP是"弹出即删除" ,如果抽奖后业务处理失败,奖品不会自动回到池子。需要"抽奖 + 记录"的原子性时,用 Lua 脚本把SPOP和状态写入包在一起,或改用SRANDMEMBER+ 业务侧SREM做幂等控制。SPOP只保证池内不重复,不保证用户级不重复 ,必须配winnersSet。SRANDMEMBER带负 count 允许重复,适合有放回抽样;正 count 不重复,但集合不够大时返回数量可能少于请求数。- 大 Set 上带大 count 的随机操作可能退化为 O(N),不要用
SRANDMEMBER key 100000做全量随机排序。 - 高并发抽奖不要用
SRANDMEMBER+SREM组合 ,两者之间存在竞态窗口,优先用SPOP。案例见 6.1 故障 4。
4.5 场景五:精确去重统计(点赞、幂等、精确 UV)
redis
# 点赞:写入用户 ID,返回新增数(重复点赞不新增)
SADD article:1:likes "1001" "1002" "1003"
# 再次点赞同一用户:返回 0(已点赞,幂等)
SADD article:1:likes "1002"
# 点赞总数:SCARD,O(1) 且精确
SCARD article:1:likes
# 判断某用户是否已点赞
SISMEMBER article:1:likes "1001"
# 取消点赞:返回实际删除个数
SREM article:1:likes "1003"
csharp
// 点赞:重复点赞返回 false(幂等,Set 天然去重)
var firstTime = await db.SetAddAsync("article:1:likes", userId);
// 点赞数:SCARD,O(1) 且精确
var likeCount = await db.SetLengthAsync("article:1:likes");

// SMISMEMBER 批量判断(Redis 6.2+):一次判断多个用户是否已点赞
// 注意:ExecuteAsync 的 params 会把 object[] 当参数列表展开,
// 必须把 key 与 uids 拼成一个数组整体传入,否则只会收到一个数组参数
var args = new object[] { "article:1:likes" }
    .Concat(uids.Cast<object>())
    .ToArray();
// 返回与请求顺序一一对应的 0/1 数组(1 = 已点赞)
var flags = (RedisValue[])await db.ExecuteAsync("SMISMEMBER", args);
边界:
- 内存随用户数线性增长------百万级点赞/UV 会吃掉几十 MB,这时应改用 Bitmap(若 ID 是连续非负整数)或 HyperLogLog(若只关心数量、不需枚举)。
- 需要反查具体是谁时,Set 是唯一选择;只求计数且允许误差,HyperLogLog 更省。
- 别用 List 做点赞去重。List 允许重复,点赞数虚高且无法判断"我点没点过"。
4.6 场景→命令速查
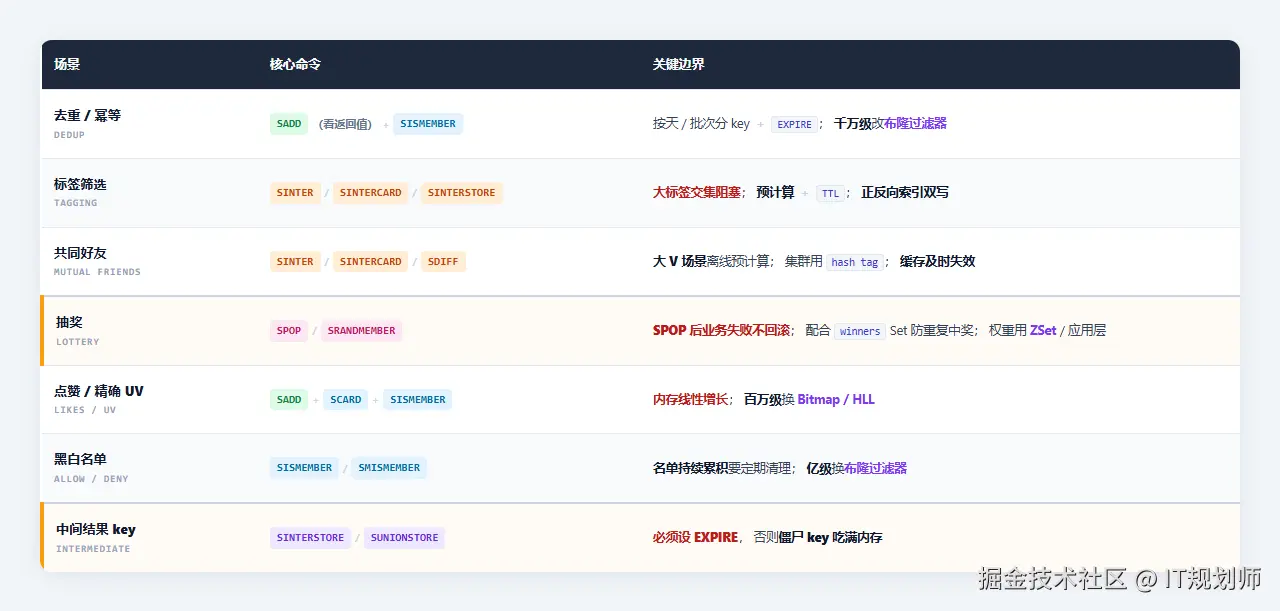
五、去重方案选型:Set vs Bitmap vs HyperLogLog vs 布隆过滤器
5.1 五方案多维对比
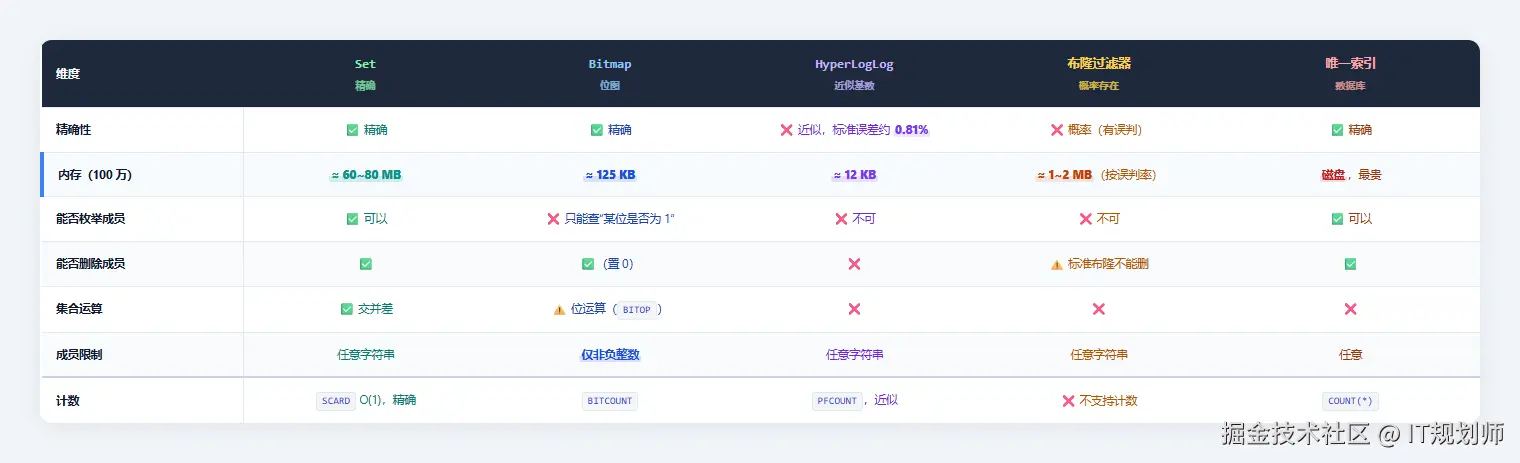
一句话选型:要枚举成员 / 要做集合运算 / 要精确删除 → 用 Set(前提是量不大,或接受内存);成员是连续非负整数、只要精确计数且要省内存 → 用 Bitmap;只要一个近似数量、不需要枚举、追求极致内存 → 用 HyperLogLog;只要判断"存在与否"、能接受误判、量极大 → 用布隆过滤器。
5.2 布隆过滤器要点
布隆过滤器内部是一个位数组 + 几个独立哈希函数,不存元素本身,只存"指纹位"。
text
添加元素 x:用 k 个哈希函数算出 k 个位置,把这 k 个位都置为 1
查询元素 x:用同样 k 个哈希算出 k 个位置
   ├─ 只要有 1 个位是 0 → 元素一定不存在(100% 确定)
   └─ k 个位全是 1 → 元素"可能存在"(可能误判)
关键结论:
- 布隆过滤器有假阳性,但零假阴性。适合"缓存穿透防护"------宁可多放行几个不存在的请求,也绝不会把真实存在的数据挡在门外。
- 标准布隆过滤器不能删除元素。一个位可能被多个元素共享,清零会顺带抹掉其他元素的指纹,造成假阴性。要支持删除,得用 Counting Bloom,代价是内存成倍增长。
- 误判率由"位数组长度 m / 元素个数 n"和哈希函数个数 k 共同决定。位/元素比越高,误判率越低;调低误判率 = 多花内存。完整实战见 S11。
5.3 决策路径
text
你需要"枚举出每一个成员"吗?
├─ 需要 ──→ Set(可枚举 + 精确 + 集合运算;HLL/布隆不支持枚举)
└─ 不需要(只要数量或"是否存在")
   ├─ 只要"数量"
   │  ├─ 要精确 + 成员是连续非负整数 → Bitmap(BITCOUNT)
   │  ├─ 要精确 + 成员随意 → Set 的 SCARD
   │  └─ 可近似 → HyperLogLog(PFCOUNT)
   └─ 只要"是否存在"
      ├─ 要精确 → Set 的 SISMEMBER
      └─ 可接受误判 → 布隆过滤器(见 S11)
5.4 分层组合:不是二选一,而是叠罗汉
常见组合:布隆过滤器挡在最前面 (拦掉绝大多数"肯定不存在"的请求,省内存),Set 放在后面 做小规模精确集合(如某个活动的实际参与名单),数据库最终真相。
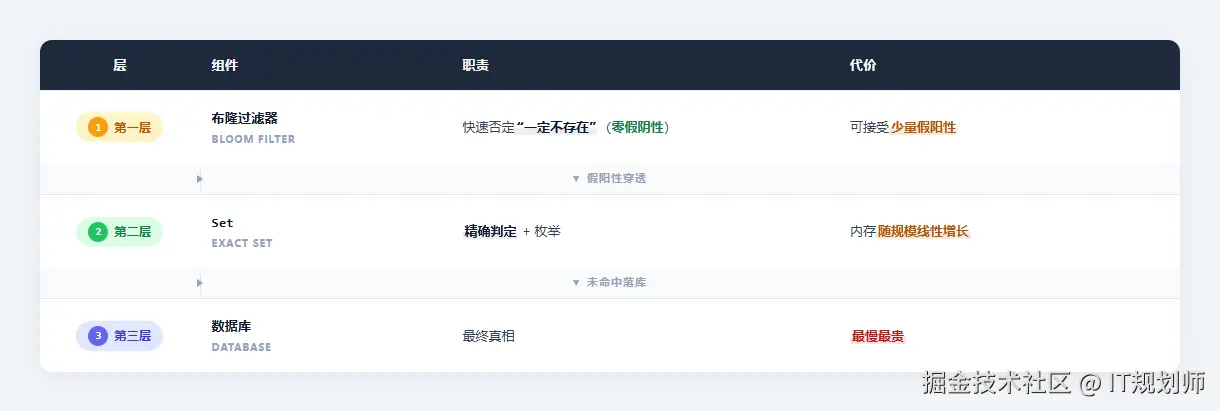
一句话记住分工:布隆过滤器负责"挡",Set 负责"准",数据库负责"终"。
六、故障复盘与避坑清单
6.1 典型故障复盘
6.2 一页速查表:命令 / 编码 / 架构坑
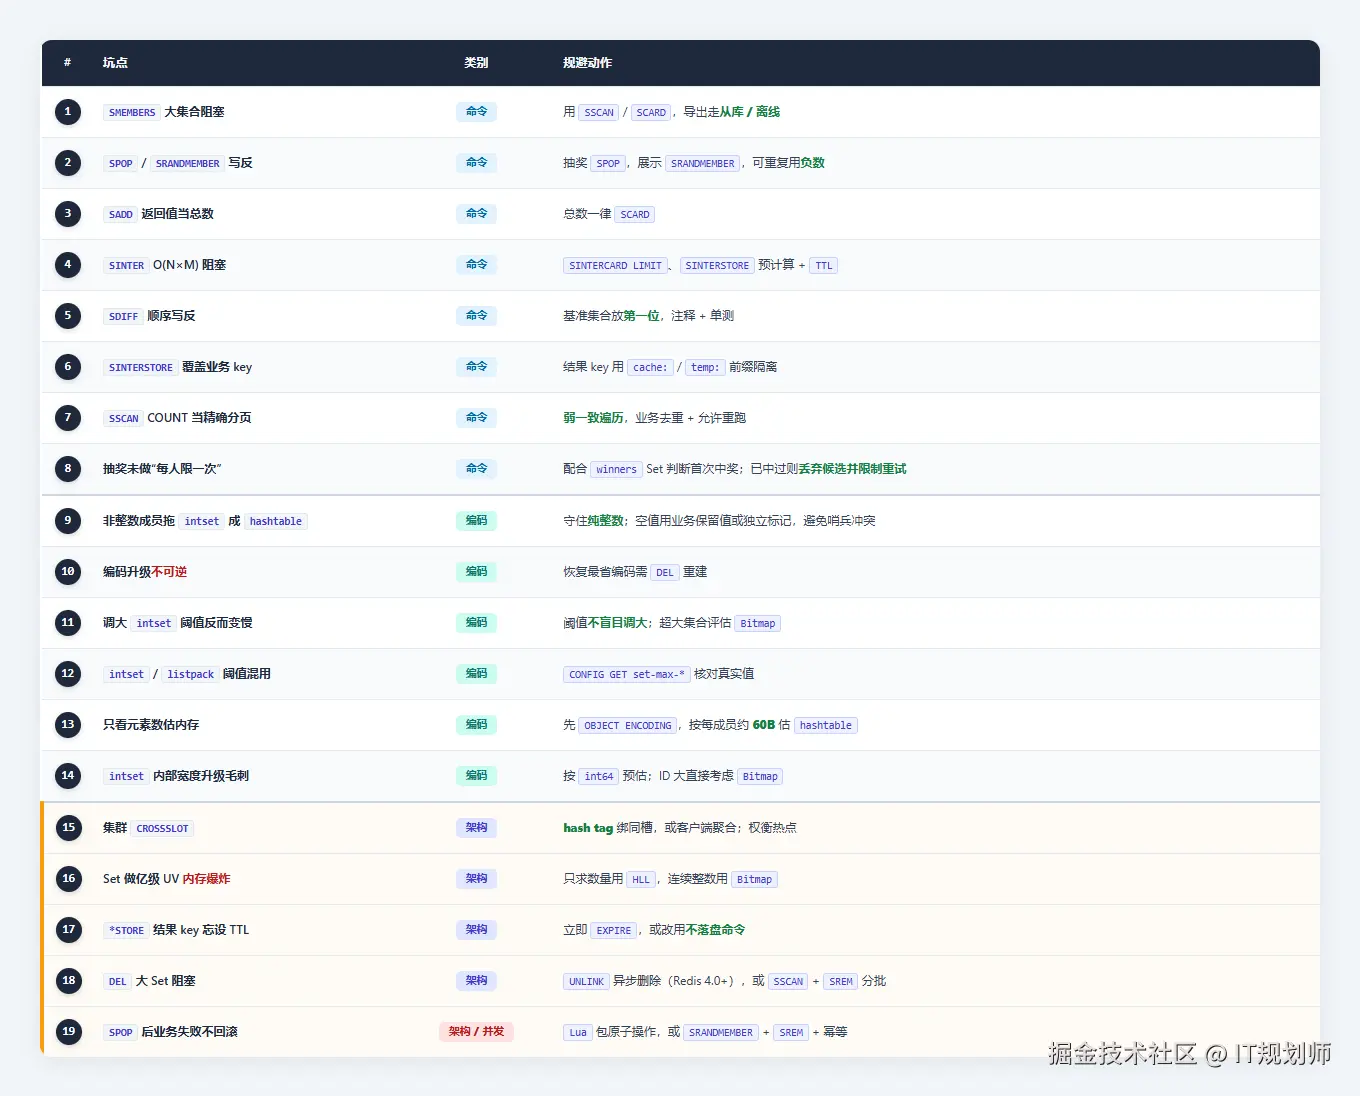
七、小结:10 条决策清单
- 复杂度分层要记牢。
SCARD严格 O(1);SISMEMBER在 hashtable 平均 O(1)、intset O(log N)、listpack O(N);SADD/SREM在 hashtable 平均 O(1)、intset O(N)(memmove 搬移)、listpack O(N);SINTER/SINTERCARD是 O(N×M),N 是最小集合的绝对规模;SUNION/SDIFF官方口径是 O(N),N 为所有给定集合元素总数;SMEMBERS也是 O(N)。 - 大集合读用
SSCAN,计数用SCARD。SMEMBERS大集合禁用;导出类需求走从库或离线。 - 抽奖用
SPOP,随机展示用SRANDMEMBER。 两者绝不能写反;抽奖还要配"每人限一次"的业务去重,并处理候选已弹出、池耗尽、重试上限。 - 编码边界要分清。 纯整数 ≤512 走
intset(约 2/4/8B/成员);非整数 ≤128 且成员 ≤64B 走listpack(7.2+ 才有,约 11B + 成员长度);超出后走hashtable(约 50~90B + 成员长度)。编码单向升级、不可逆。 - 守住纯整数集合的纯度。 一个脏成员能毁掉整集合的省内存收益;intset 内部还会在 int16/32/64 之间悄悄变胖,
OBJECT ENCODING看不出来。容量评估按 int64 更稳。 - 去重五选一有明确边界。 要枚举/集合运算 → Set;连续非负整数要精确 → Bitmap;只要近似数量 → HyperLogLog;只要判存在、能接受误判 → 布隆过滤器;要强一致最终真相 → 数据库唯一索引。不要用 Set 做亿级 UV。
- 标签和共同好友不要在请求路径上实时
SINTER大集合。 高频组合用SINTERSTORE预计算 + TTL;只关心数量用SINTERCARD ... LIMIT;SDIFF顺序敏感,基准集合放第一位。 *STORE结果 key 必须设EXPIRE。 否则tmp:*/cache:*中间结果会吃满内存;能不用落盘命令就不用。- 大 Set 删除用
UNLINK或分批。 不要DEL几十万/几百万元素的 Set;Redis 3.x 用SSCAN+SREM分批。 - 集群下集合运算受 Slot 限制。
SINTER/SUNION/SDIFF/SMOVE/SINTERSTORE/SUNIONSTORE/SDIFFSTORE要求所有 key 在同一 hash slot,否则报CROSSSLOT;用 hash tag 绑同槽或客户端聚合,但要权衡热点风险。