我最近让 AI 检查了一遍自己的文档站:仓库已经到了 0.6.3,线上首页的结构化数据却还写着 0.6.0。页面能正常打开,canonical、多语言标签、sitemap 这些基础检查也都过了。
我在这轮检查里翻了 Claude SEO 的官网和源码。它把网站审计整理成了一套 Claude Code 工作流,挺适合已经会写代码、却不想从头拼 SEO 检查清单的人。
这轮没有安装或运行 Claude SEO。文中的安装方式来自官方说明,自己的站点案例用的是现有脚本和线上页面对照,没有插件带来的流量增长数据。
Claude SEO 能帮忙查什么
Claude SEO 是一个 MIT 开源项目,装在 Claude Code 里使用。仓库里既有技能说明,也有分工不同的代理和配套脚本。
它能检查页面是否方便抓取、canonical 有没有指错、sitemap 是否完整,也会分析内容、结构化数据、多语言配置和面向 AI 搜索的内容表达。更复杂的需求,还可以接 Search Console 等数据源。
它把检查范围和报告要求写进了文件,你能看见它准备查什么,也能针对一项问题继续问。
比如多语言页指错了,可以继续追到生成标签的配置;报告说正文太薄,就让它指出到底哪个问题没回答。模型仍然可能判断错,结论还得拿页面和数据来核对。
安装以后,先选一页
按项目目前的安装说明,需要配置好的 Claude Code、Git 和 Python 3.11 到 3.14。插件安装方式要求 Claude Code 1.0.33 或更新版本。
下面这些命令在 Claude Code 会话里执行,不是在普通 shell 里运行:
bash
/plugin marketplace add AgriciDaniel/claude-seo
/plugin install claude-seo@agricidaniel-claude-seo
/seo setup
/seo doctor
/seo setup 会准备隔离的 Python 环境和浏览器运行时,涉及下载和本地写入;/seo doctor 用于只读检查环境是否就绪。
这里有个安装前要看的细节:默认流程会准备无头 Chromium,SPA 渲染和截图会用到浏览器。如果公司环境不允许无头浏览器,先看清楚安装与运行方式。改用现成 Chrome 需要调整流程,不能假定原装插件已经支持你的限制。
第一次我会选首页,或者最影响用户安装、购买的一页:
bash
/seo page https://example.com/先看一份报告的证据是否充分,比一上来把整个站和所有扩展都跑一遍省心。对报告里的结论不放心,就让它补原始标签、问题 URL 和验证步骤。没有数据的部分可以先保留,别急着变成改动。
还可以加一段自己的要求:
text
这轮先只读检查,不改源码、不部署、不提交索引。
请列出问题 URL、页面证据、建议和验收方式。
区分已经确认的问题与需要 Search Console 数据才能判断的问题。
这是给代理的任务约束,执行时仍应查看它请求的权限。
这些命令不用一起跑
官网列了很多入口。做产品官网或文档站,先记住与当前问题相关的几条就够了:
| 想查什么 | 命令 |
|---|---|
| 一页内容与页面配置 | /seo page <url> |
| 抓取、索引信号和技术配置 | /seo technical <url> |
| 多语言互指 | /seo hreflang <url> |
| 结构化数据 | /seo schema <url> |
| AI 搜索相关的内容和访问条件 | /seo geo <url> |
| 整站检查与任务排序 | /seo audit <url> |
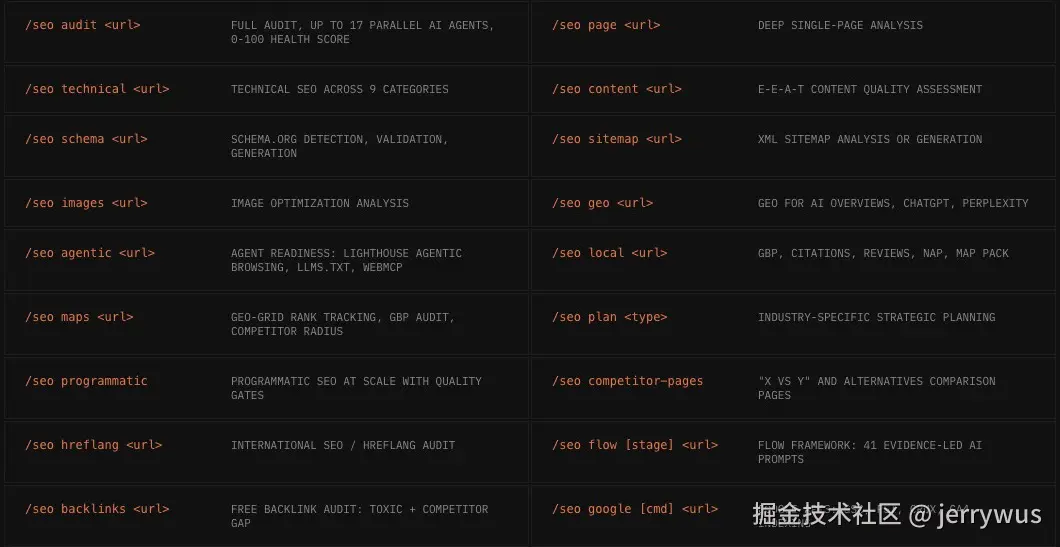
比如网页源码里几乎没有正文,就先查技术和渲染;中英日三个版本互相跳错,就查 hreflang。已经确认页面能被读取,再花时间看内容是否回答了用户的问题。
完整审计会调动多个专门代理,模型调用也更多。它适合需要整体梳理的时候,没有必要每改一个标题都跑一遍。
我觉得它方便的地方
检查清单可以复用。项目把技能和脚本放在仓库里,团队不用每次临时写一段"帮我看看 SEO"的提示词。遇到不适用的规则,还能读源码、调整它,再用于下一次检查。
专项入口也方便控制范围。技术配置和内容编辑本来就需要看不同的东西,拆开检查后,可以把某个问题交给对应的人处理。自己维护小项目时,也不必一次消化整份报告。
我比较看重它对建议的要求:要说明观察依据、处理顺序,以及怎么判断修复有没有生效。这更接近开发任务。比如"提升内容权威性"很难直接开工,"这段支持范围没有版本依据,补源码出处并同步三种语言"就具体多了。
它也给后续接数据留了位置。基础检查不用先配一排第三方 API;需要看真实收录和查询表现时,再接自己有权限的 Search Console。外链、SERP 或 AI 引用跟踪涉及的服务,按需要另外配置。
自己的文档站给了我什么提醒
拿 Sessions Viewer 文档站做对照时,已有的技术配置其实不少。2026-11-02 这轮检查采样了 21 个英、中、日页面,常规元数据和语言互指通过,87 条 sitemap 也能与源页面对应。
除了开头提到的旧版本信息,线上还缺少仓库已经加入的 OpenCode v2 文档内容,新合成样本的下载地址返回 404。进一步看源码,Codex 已经支持压缩历史和数据库展示记录,部分文档却仍在讲旧版目录限制。
后续改动主要是同步三语说明,补齐数据能否继续会话的条件,并加了一条生产验收命令:
bash
npm run docs:check-production这是我项目新增的脚本,不是 Claude SEO 的内置命令。它只发 GET,检查线上版本、兼容页和公开样本,不会替我部署。
本地验证通过以后,再跑生产检查,旧版信息仍然被报出来。这次没有自动发布,也还不能说线上问题已经修好。
GEO 能做什么,别承诺什么
GEO 通常指面向生成式搜索的优化,关注内容能否被 AI 搜索理解、选用和引用。对一个文档站来说,先把"支持什么、需要什么条件、哪里有依据"写清楚,就有不少事情可以做。
Google 对 AI Overviews 和 AI Mode 的官方说明提到:页面需要已被收录,并且有资格在搜索里展示摘要;没有额外的技术门槛,原有 SEO 基础仍然适用。
所以别急着把文章切成某个固定字数,也别以为放一个 llms.txt 就能换来引用。正文是否在原始 HTML 里、结论是否说清适用条件、来源能不能核对,都值得先检查。
爬虫名字也别混用。按 OpenAI 的说明,OAI-SearchBot 用于 ChatGPT 搜索,GPTBot 用于模型训练,两者的权限可以分别设置。把训练爬虫挡住,不能直接推导为 ChatGPT 搜索一定看不到这个站。
Claude SEO 的 GEO 评分可以作为检查提示,不能当成 AI 平台对你网站的评价。最后有没有被引用,还要看真实结果。
免费之外,还要考虑什么
核心项目是 MIT 开源的,没有插件本身的按站收费,但模型额度仍然要算。完整审计涉及多个代理,耗用通常比单页检查大;可选的付费数据服务也不会因为装了插件就免费。
"报告存在本机"也不等于"分析完全离线"。README 明确说明,页面和资料会进入 Claude Code 会话,并发送给所用的模型服务。连接扩展后,相应服务还会收到域名、URL 或查询等数据。公司内网、未公开页面和客户材料,先确认能不能这样处理。
还有些结论必须等数据。没有 Search Console 权限,就不能把页面允许索引写成"Google 已经收录";拿到实验室测速,也不能假装拿到了所有真实用户的访问体验。
如果需要大规模抓取、完整外链库或长期关键词跟踪,仍然要看专门工具和数据服务。Claude SEO 可以参与这套工作,但不会替你省掉获取和核实数据的成本。
我会推荐谁先试
独立开发者、自己维护官网的小团队,以及已经用 Claude Code 做日常开发的人,比较容易把它接进现有工作。你能读源码、能改页面,也能判断一条建议是否符合产品实际情况。
判断 /seo page 的第一份报告值不值得继续用,我会看能否从中挑出一两项有证据的问题,修完再核对线上结果。等这套流程顺手了,再决定要不要接更多数据源、跑整站审计。