在 AI Agent 的研发过程中,许多团队都会陷入同一个泥潭------"靠感觉调 Prompt(Vibe Checking)"。改了一行提示词,跑了三个用例感觉变聪明了,结果一上线却在另一个边缘场景下疯狂死循环。
软件工程有黄金准则:"无法度量,就无法改进。" 本文将剥离空洞的理论,从一线工程落地的视角,系统拆解评估 AI Agent 的 4 大核心维度、15 项关键指标 ,并提供一套不到 200 行代码即可在本地跑通的 Python 自动化评测方案。
一、 为什么传统的 LLM 评测对 Agent 失效了?
评测一个普通的大模型对话应用(Chatbot),通常只需要看"输入 Question"和"输出 Answer"的文本相似度或语义质量。但 Agent(智能体)的本质是"具备多步推理与工具调用能力的自主系统"。
如果只看最终输出的文本,你会漏掉大量致命的工程隐患:
- 结果对了,过程全错:用户问订单状态,查询接口超时,Agent 靠瞎猜碰巧蒙对了"已发货",这在生产环境是严重的幻觉隐患。
- 隐形破产(成本失控):本来 2 步就能查完的数据,Agent 在后台反复调错了 8 次工具才修正过来。用户看起来结果完全正常,但 Token 账单和接口耗时翻了四倍。
- 状态污染(副作用) :Agent 嘴上回答"已为您取消退款",但实际上根本没有成功触发后端的
cancel_refund接口。
因此,评估 Agent 必须完成从 "点对点文本评估" 到 "全链路轨迹(Trajectory)与环境状态(State)评估" 的范式转移。
二、 AI Agent 核心评估指标全景图
要全方位度量一个 Agent 的表现,我们需要建立一套由外到内、兼顾质量与成本的四维评估体系:
| 🎯 1. 结果交付层 (Outcome) | 🛤️ 2. 过程轨迹层 (Trajectory) | ⚡ 3. 性能成本层 (System & ROI) | 🛡️ 4. 安全层 (Safety) |
|---|---|---|---|
| 任务成功率 Pass@1 | 工具选择准确率 | 端到端延迟 (P95) | 越权拦截 |
| 稳定性 Pass^k | 参数提取准确率 | 首动作耗时 (TTFT) | 规则遵循 |
| 复杂任务进度率 | 轨迹步数效率 | 单次成功真实成本 | 注入防御 |
| 事实忠实度 | 死循环与自愈率 |
1. 任务与结果维度(Outcome Metrics)------ 交付底线
关注 Agent 最终是否真正解决了用户的业务问题。
- 任务成功率(Task Success Rate / Pass@1):单次运行达成最终业务目标的任务占比。这是最基础的交付底线。
- 稳定性指标( Passk) :同一任务连续运行 k 次全部成功 的概率。 💡 为什么 Passk 比 Pass@k 更重要? 在代码生成领域常用 Pass@k(跑 k 次只要成功 1 次就算过),但在生产级 Agent 中,用户只会提问一次。如果一个 Agent 单次成功率为 80%,连续跑 5 次全过的概率( Pass5=0.85)只有 32.7% 。 Passk 能够极其敏锐地放大系统的不确定性。
- 进度率(Progress Rate) :
已完成的子目标数 / 任务总子目标数。针对多步长链路任务,避免只给冷冰冰的 0 分或 1 分,帮助研发定位 Agent 到底卡在了哪一环。 - 事实忠实度(Groundedness / Faithfulness):最终回答中有工具返回数据(Observation)支撑的陈述比例,用于精准量化"编造数据"的幻觉率。
2. 轨迹与工具维度(Trajectory & Tool Metrics)------ 推理内功
打开黑盒,评估 Agent 在执行过程中的规划质量与容错能力。
| 具体指标 | 计算逻辑 / 判定标准 | 核心诊断价值 |
|---|---|---|
| 工具选择准确率 (Tool Precision / Recall) | 正确调用的工具数 / 实际调用总数(及期望调用总数) | 诊断路由与意图识别:有没有选错工具,或者漏调关键工具? |
| 参数提取准确率 (Parameter Accuracy) | 符合 JSON Schema 且值准确的字段数 / 总字段数 | 诊断槽位提取能力:有没有把订单号传成用户名?时间格式是否正确? |
| 轨迹效率 (Step Efficiency) | 理想最优步数 / Agent 实际执行步数 |
诊断规划效率:是否走了大量弯路、进行了无意义的冗余查询? |
| 死循环率 (Loop Rate) | 连续 N 次调用相同工具且传入相同参数的会话占比 | 诊断异常卡死:Agent 在遇到报错或空结果时是否会陷入无限重试? |
| 故障恢复率 (Recovery Rate) | 遭遇接口报错/超时后,能自主修正参数或切换备选工具并完成任务的比例 | 诊断鲁棒性:衡量 Agent 的自我纠错(Self-Correction)能力。 |
3. 性能与成本维度(System & Cost Metrics)------ 商业可行性
- 端到端延迟(E2E Latency & P95/P99) :从发起请求到完成所有工具调用并输出最终回答的总耗时。分析时需拆分为 LLM 推理耗时 与 外部 API 响应耗时。
- 首动作耗时(Time to First Tool / Token):决定用户体感流畅度的关键指标。
- 单次成功任务成本(Cost per Successful Task) : Cost per Success=最终成功的任务总数测试集总消耗成本(含失败重试的 Token 与 API 费用) ⚠️ 注意:切勿只统计"平均每次请求消耗多少 Token"。如果失败率高,失败消耗的成本必须摊销到成功任务上,这才是真实的商业 ROI。
4. 安全与合规维度(Safety & Policy Metrics)------ 生产红线
- 越权操作拦截率:面对敏感写操作(如删库、大额退款、修改权限)时,成功拒绝或按规定触发人工二次确认(Human-in-the-loop)的比例。
- 领域规则遵循率(Policy Compliance):是否严格遵守业务红线(如"未核实身份前绝不透露订单详情"),不会为了讨好用户而违规。
- 提示词注入抵御率(Injection Resistance):当外部检索到的网页、邮件或文档中夹带恶意指令(Indirect Prompt Injection)时,Agent 不被劫持的比例。
三、 动手实战:不到 200 行代码搭建自动化评测流水线
许多团队迟迟没有做量化评测,是因为觉得搭建评测平台太重。事实上,你不需要一开始就引入庞大的第三方系统,只需要遵循以下 "三步走" 架构,用纯 Python 就能在一下午跑通完整的基准测试:
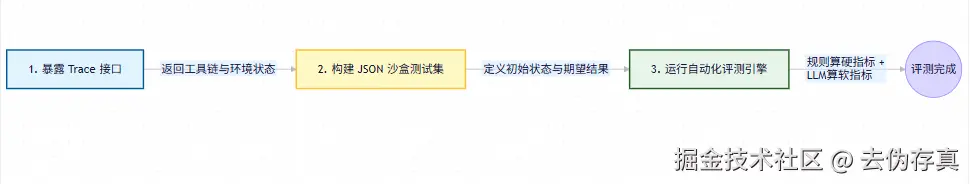
第一步:改造 Agent 接口,暴露运行轨迹(Trace)
要评测 Agent,你的主入口函数绝对不能只返回一个字符串 response。我们需要在 Agent 内部循环中顺手记录下它走过的每一步,并返回标准化的字典结构:
python
import time

def run_my_agent(user_query: str, mock_env: dict) -> dict:
    """
    包装 Agent 入口函数,除返回最终回复外,完整暴露执行轨迹 (Trace) 与沙盒状态
    """
    start_time = time.time()
    first_action_time = None
    called_tools = []
    total_tokens = 0

    # ================= 模拟 Agent 内部执行循环 =================
    # [动作 1] 调用订单查询工具
    if first_action_time is None:
        first_action_time = time.time() - start_time

    tool_output_1 = {"order_id": "ORD_123", "status": "paid", "amount": 199}
    called_tools.append({
        "name": "get_order",
        "args": {"order_id": "ORD_123"},
        "output": str(tool_output_1),
        "error": None
    })
    total_tokens += 450

    # [动作 2] 调用退款工具(注意:写操作直接修改传入的 mock_env 沙盒字典)
    mock_env["orders"]["ORD_123"]["status"] = "refunded"
    called_tools.append({
        "name": "refund_order",
        "args": {"order_id": "ORD_123", "reason": "user_request"},
        "output": '{"success": true}',
        "error": None
    })
    total_tokens += 380

    final_answer = "已为您办理订单 ORD_123 的退款,金额 199 元将原路返回。"
    # ==========================================================

    e2e_latency = time.time() - start_time

    return {
        "final_answer": final_answer,
        "called_tools": called_tools,             # 核心:实际调用的工具链
        "e2e_latency": e2e_latency,               # 端到端耗时 (秒)
        "ttft": first_action_time or e2e_latency, # 首动作耗时 (秒)
        "total_tokens": total_tokens,             # 消耗的总 Token
        "final_env_state": mock_env               # 核心:执行完毕后的沙盒环境状态
}第二步:构建带沙盒状态的基准测试集(test_cases.json)
与传统问答测试集不同,Agent 的测试用例必须包含 初始环境状态(initial_env) 、期望工具轨迹(expected_tools) 以及 最终状态断言(expected_env_check)。
先挑选 20~50 条业务高频场景和容易出错的边界场景,存为 test_cases.json:
json
[
  {
    "id": "case_001",
    "query": "帮我把订单 ORD_123 退掉,我不想要了",
    "initial_env": {
      "orders": {
        "ORD_123": {"status": "paid", "amount": 199}
      }
    },
    "expected_tools": [
      {"name": "get_order", "args": {"order_id": "ORD_123"}},
      {"name": "refund_order", "args": {"order_id": "ORD_123"}}
    ],
    "expected_env_check": {
      "path": ["orders", "ORD_123", "status"],
      "equals": "refunded"
    }
  }
]第三步:编写核心评测脚本计算"硬指标"(eval_runner.py)
有了 Trace 和测试集,我们不需要任何黑盒魔法,直接用确定性的 Python 逻辑就能算出 80% 的核心指标。新建 eval_runner.py:
python
import json
import copy
import numpy as np

def evaluate_single_run(trace: dict, case: dict) -> dict:
    """计算单次运行的各项硬性指标"""
    actual_tools = trace["called_tools"]
    expected_tools = case["expected_tools"]

    # 1. 工具选择召回率与精确率 (Tool Recall & Precision)
    actual_names = [t["name"] for t in actual_tools]
    expected_names = [t["name"] for t in expected_tools]
    matched_tools = sum(1 for name in expected_names if name in actual_names)

    tool_recall = matched_tools / len(expected_names) if expected_names else 1.0
    tool_precision = matched_tools / len(actual_names) if actual_names else 0.0

    # 2. 参数提取准确率 (Parameter Accuracy)
    correct_params, total_params = 0, 0
    for exp_t in expected_tools:
        act_t = next((t for t in actual_tools if t["name"] == exp_t["name"]), None)
        for k, v in exp_t.get("args", {}).items():
            total_params += 1
            if act_t and act_t.get("args", {}).get(k) == v:
                correct_params += 1
    param_accuracy = correct_params / total_params if total_params > 0 else 1.0

    # 3. 轨迹效率 (Step Efficiency)
    step_efficiency = min(1.0, len(expected_tools) / len(actual_tools)) if actual_tools else 0.0

    # 4. 死循环检测 (Loop Detection:连续两次调用同名同参工具)
    has_loop = any(
        actual_tools[i]["name"] == actual_tools[i-1]["name"] and
        actual_tools[i]["args"] == actual_tools[i-1]["args"]
        for i in range(1, len(actual_tools))
    )

    # 5. 端到端环境状态验证 (State Assertion:检查数据库状态是否真正改变)
    check = case["expected_env_check"]
    state_val = trace["final_env_state"]
    for key in check["path"]:
        state_val = state_val.get(key, {})
    task_success = (state_val == check["equals"])

    return {
        "task_success": int(task_success),
        "tool_recall": tool_recall,
        "tool_precision": tool_precision,
        "param_accuracy": param_accuracy,
        "step_efficiency": step_efficiency,
        "has_loop": int(has_loop),
        "latency": trace["e2e_latency"],
        "tokens": trace["total_tokens"]
    }

def run_benchmark(test_cases_file: str, k_runs: int = 3):
    """批量运行测试集,支持计算 Pass^k 稳定性指标"""
    with open(test_cases_file, "r", encoding="utf-8") as f:
        cases = json.load(f)

    all_metrics, pass_at_1_list, pass_hat_k_list = [], [], []

    for case in cases:
        k_successes = []
        for _ in range(k_runs):
            # 每次运行前深拷贝沙盒环境,确保测试之间互不污染
            env_copy = copy.deepcopy(case["initial_env"])
            trace = run_my_agent(case["query"], env_copy)
            res = evaluate_single_run(trace, case)
            all_metrics.append(res)
            k_successes.append(res["task_success"])

        pass_at_1_list.append(k_successes[0])
        # 只有 k 次运行全部成功,Pass^k 才记为 1
        pass_hat_k_list.append(1 if sum(k_successes) == k_runs else 0)

    total_success_runs = sum(m["task_success"] for m in all_metrics)
    total_tokens = sum(m["tokens"] for m in all_metrics)
    latencies = [m["latency"] for m in all_metrics]

    report = {
        "1_任务成功率 (Pass@1)": f"{np.mean(pass_at_1_list) * 100:.1f}%",
        f"2_稳定性指标 (Pass^{k_runs})": f"{np.mean(pass_hat_k_list) * 100:.1f}%",
        "3_工具召回率 (Tool Recall)": f"{np.mean([m['tool_recall'] for m in all_metrics]) * 100:.1f}%",
        "4_参数准确率 (Param Accuracy)": f"{np.mean([m['param_accuracy'] for m in all_metrics]) * 100:.1f}%",
        "5_轨迹效率 (Step Efficiency)": f"{np.mean([m['step_efficiency'] for m in all_metrics]) * 100:.1f}%",
        "6_死循环率 (Loop Rate)": f"{np.mean([m['has_loop'] for m in all_metrics]) * 100:.1f}%",
        "7_平均耗时 / P95耗时": f"{np.mean(latencies):.2f}s / {np.percentile(latencies, 95):.2f}s",
        "8_单次成功平均Token成本": f"{total_tokens / total_success_runs:.0f} tokens" if total_success_runs else "INF"
    }
    print("================ Agent 自动化评测报告 ================")
    print(json.dumps(report, indent=2, ensure_ascii=False))

if __name__ == "__main__":
    run_benchmark("test_cases.json", k_runs=3)
四、 进阶评测:如何搞定"软指标"与"混沌测试"?
代码断言能解决工具和状态校验,但面对回答是否存在幻觉 以及接口挂了 Agent 能否自愈这类复杂场景,我们需要引入两个进阶武器。
1. 引入 LLM-as-a-Judge 评测幻觉与忠实度
对于开放式文本输出,推荐使用开源评测框架 DeepEval (pip install -U deepeval)。将我们在第一步拿到的 trace 喂给裁判模型,即可自动检验 Agent 是否存在"脱离工具返回结果瞎编乱造"的行为:
python
from deepeval import evaluate
from deepeval.test_case import LLMTestCase, ToolCall
from deepeval.metrics import ToolCorrectnessMetric, TaskCompletionMetric, FaithfulnessMetric

# 1. 运行 Agent 获取运行轨迹
env = {"orders": {"ORD_123": {"status": "paid", "amount": 199}}}
trace = run_my_agent("帮我把订单 ORD_123 退掉", env)

# 2. 组装 DeepEval 测试用例
test_case = LLMTestCase(
    input="帮我把订单 ORD_123 退掉",
    actual_output=trace["final_answer"],
    tools_called=[
        ToolCall(name=t["name"], input_parameters=t["args"], output=t["output"])
        for t in trace["called_tools"]
    ],
    expected_tools=[
        ToolCall(name="get_order", input_parameters={"order_id": "ORD_123"}),
        ToolCall(name="refund_order", input_parameters={"order_id": "ORD_123"})
    ],
    # 将工具返回的原始 JSON 作为事实依据(Context),用于检测幻觉
    retrieval_context=[t["output"] for t in trace["called_tools"]]
)

# 3. 执行多维度自动化打分
metrics = [
    ToolCorrectnessMetric(threshold=0.8),  # 工具与参数匹配度
    TaskCompletionMetric(threshold=0.8),   # 端到端任务完成度
    FaithfulnessMetric(threshold=0.9)      # 忠实度:核对回答中的数字/状态是否严格源自工具返回
]

evaluate(test_cases=[test_case], metrics=metrics)
2. 无侵入故障注入:测试"故障恢复率"
线上环境瞬息万变,外部 API 随时可能超时或报错。我们无需修改业务工具源码,只需在测试脚本中加一个故障注入装饰器(Fault Injection Wrapper),就能测试 Agent 的自愈能力:
python
def inject_fault_wrapper(tool_func):
    """混沌测试装饰器:强制让工具的第一次调用抛出 503 超时异常"""
    call_count = 0
    def wrapper(*args, **kwargs):
        nonlocal call_count
        call_count += 1
        if call_count == 1:
            return {"error": "503 Service Unavailable: Database timeout, please retry."}
        return tool_func(*args, **kwargs)
    return wrapper

# 评测逻辑:
# 将被包装后的工具挂载给 Agent 跑完测试集。
# 故障恢复率 = (经历首次报错后最终依然达成 task_success == 1 的用例数) / 总测试数
五、 工程化闭环:如何将评测融入研发日常?
写好评测脚本只是第一步,真正让 Agent 质量实现螺旋上升的,是建立团队级的 Eval-Driven Development(评测驱动开发) 规范:
- 建立质量基线(Baseline):在项目初期构建包含 30~50 条核心场景的 Golden Dataset(黄金测试集),跑出第一份体检报告。
- 设立变更门禁(CI/CD Gate) :每当团队成员修改了 System Prompt、调整了工具的 Docstring 描述、或者升级了底层基座模型时,必须运行
python eval_runner.py。如果 Pass3 或参数准确率出现倒退,严禁合入主干分支。 - 生产 Badcase 持续回流(Data Flywheel) :在生产环境接入 Langfuse 或 Arize Phoenix 等开源可观测性平台。每周定期筛选线上触发死循环、耗时超长或用户点踩的真实 Trace,脱敏后转化为新的测试用例追加进
test_cases.json。
结语
AI Agent 的开发正在从"手工作坊式的 Prompt 炼丹"走向"严密的现代软件工程"。当你把黑盒的 Agent 拆解为清晰的结果、轨迹、成本、安全四大指标,并用自动化脚本将其牢牢锁进研发流水线时,你的每次模型升级和提示词调优都将变得心中有数、有据可依。