本系列讨论 AI-SDLC:让 Coding Agent 参与软件项目的整个周期,从需求理解、方案评审到开发、联调测试和交付,而不只停留在写代码这一环。
系列会讲清两件事:
- 怎样把这条链路做成能跑完、能在中断后恢复、能证明结果正确的工程体系;
- 每一处设计具体落在 Claude Code 和 Codex 的哪个机制上,包括 hooks、subagents、skills、MCP、权限与配置。
本篇是总纲,回答三个问题:
- AI-SDLC 是什么;
- 为什么要做,为什么是现在;
- 要做成什么样。
AI-SDLC 是什么:让 Coding Agent 参与整个项目周期
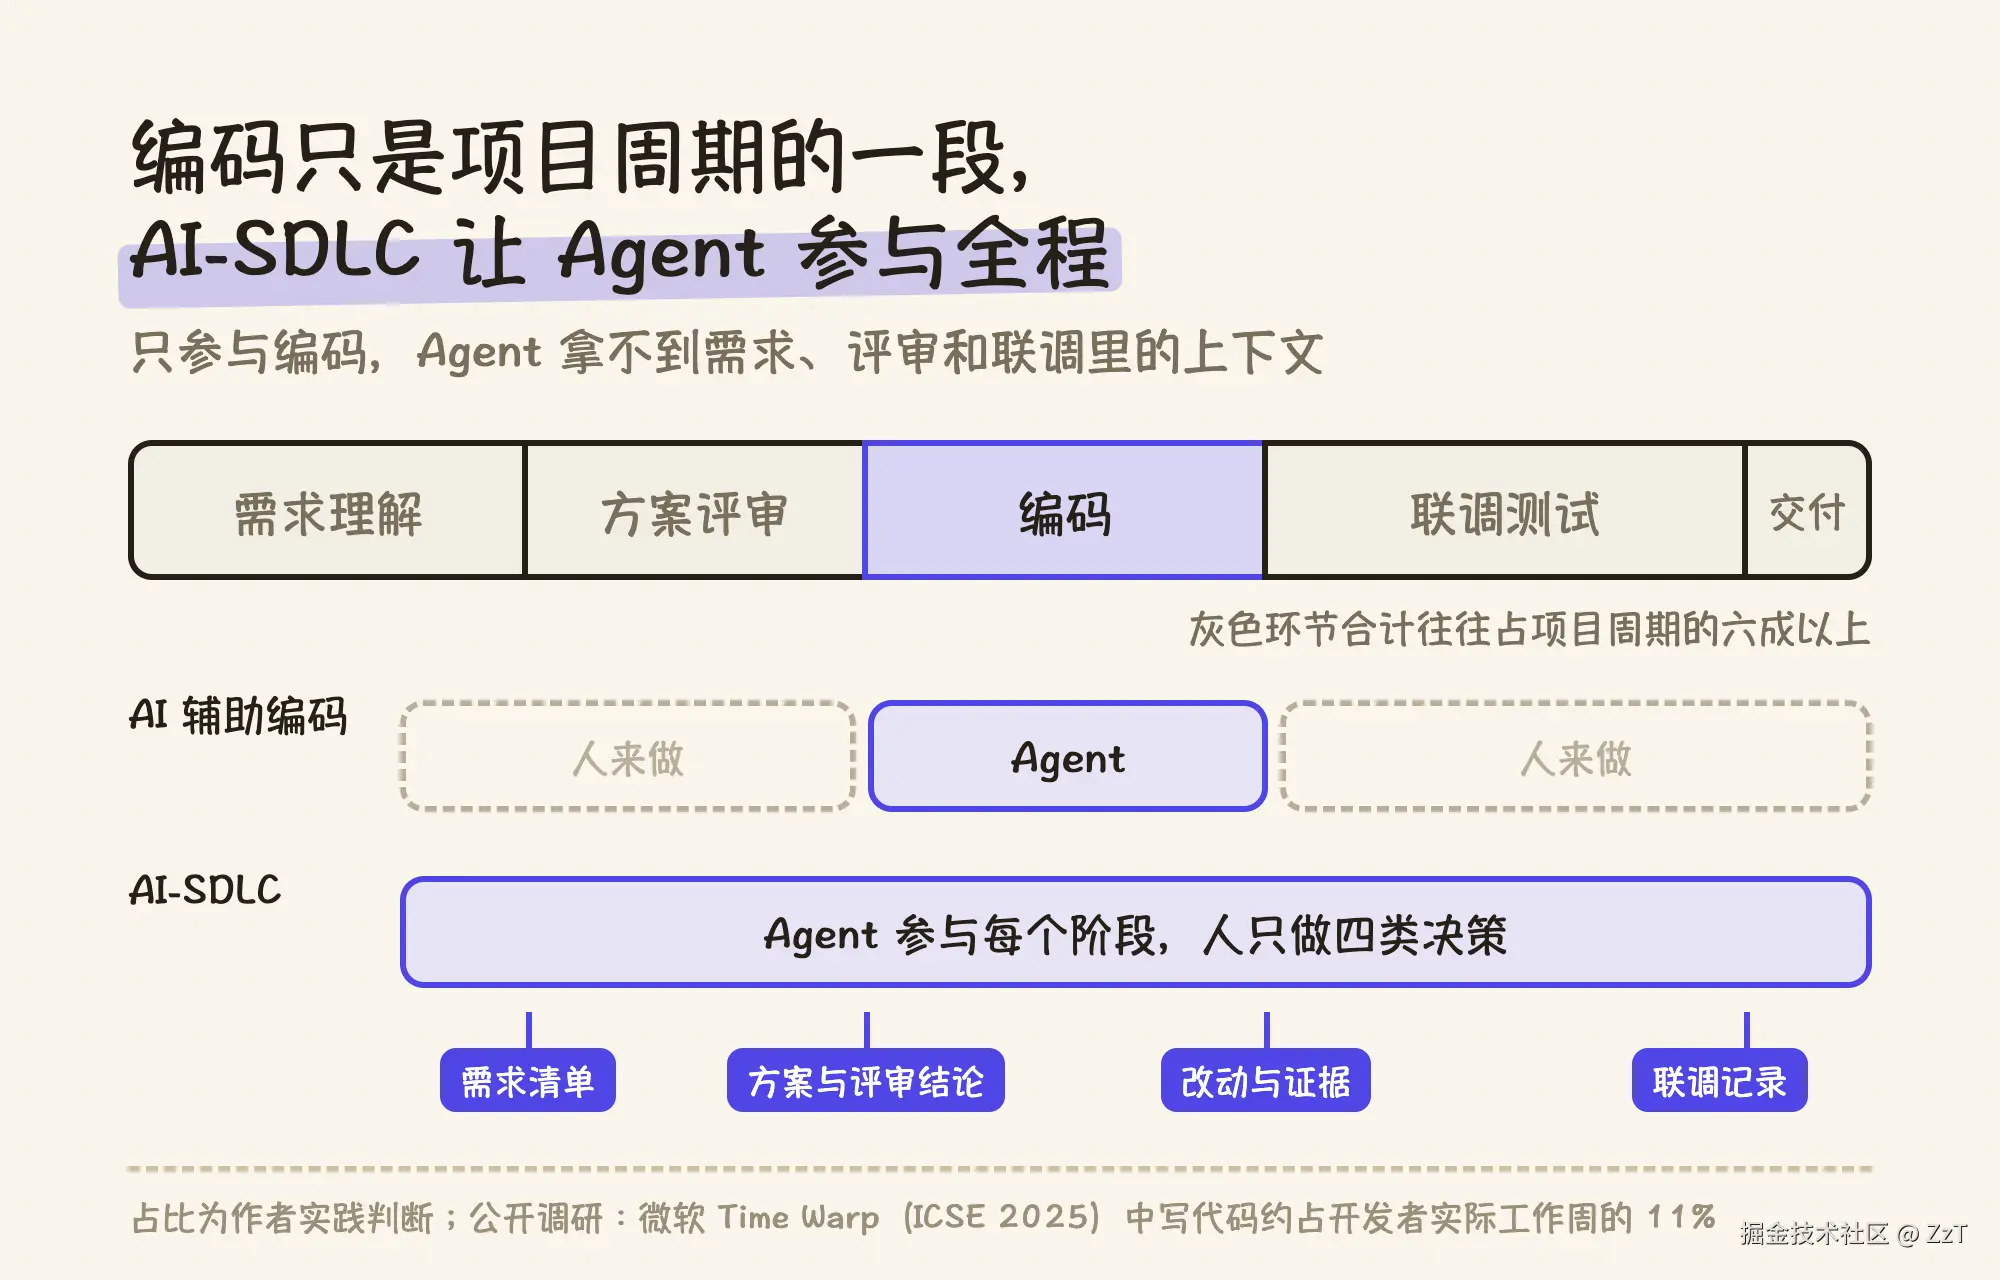
SDLC(Software Development Life Cycle)指一个需求从提出到上线所经历的全部环节。
当前 Coding Agent 的提效集中在编码这一环:代码补全、对话式修改、按描述生成一个函数或一个页面。需求由谁理解、方案由谁评审、联调中暴露的问题由谁收口,仍然由人逐项完成。
问题在于,成熟的大型系统里,编码只是其中一环,而且不是最长的一环。前期的需求理解、方案评审,后期的联调测试,往往能占到一个项目周期的六成甚至更多。
公开调研的方向与此一致:微软 2024 年对 484 名开发者的调查(ICSE 2025 论文 Time Warp)显示,实际工作周里写代码的时间约占 11%;即使让开发者按理想状态分配,写代码也只占约 20%。
只在编码环节使用 AI,有两个局限。
第一个是效率有上限。被压缩的只是周期里不到一半的部分,需求理解多花的一周、联调多返工的一轮,编码再快也补不回来。
第二个局限更隐蔽,是上下文不足造成的质量问题。只参与编码的 Agent 拿到的是「改这段代码」的局部信息:
- 它不知道需求为什么这样定;
- 不知道方案评审时否掉了哪种做法、原因是什么;
- 也不知道联调暴露了哪些接口约束。
在这种条件下,它写出的代码可以通过编译和单测,放进项目里却不对。
AI-SDLC 针对的正是这两个局限:让 Coding Agent 全流程参与项目开发,在每个阶段获取上下文,也把本阶段形成的上下文沉淀下来,以此提升交付质量。
需求清单与排除范围、技术方案与评审结论、改动与验证证据、联调记录与遗留问题,依次传给下一个阶段。人的工作集中到四类决策上:目标与范围、边界与授权、验收标准、外部动作。
这里真正的变化不在于 AI 做得多还是少,而在于阶段之间靠什么衔接。
AI 辅助编码时,衔接靠人:人读需求,人记住评审结论,人判断代码是否写完。AI-SDLC 里,衔接由落盘的产物承担,下一阶段和下一个 Agent 读的是产物,不是某个人对需求的理解。
所以 AI-SDLC 是工程问题,不是工具选型问题:必须定义每个阶段读什么、写什么、写完怎么检查。
它和我之前那篇《谈谈 AI-Ready 和 AI-SDLC》讨论的 AI-Ready 是上下层关系:AI-Ready 解决「AI 能不能看懂这个工程」,AI-SDLC 解决「AI 能不能参与并做完一次交付」。
为什么要做:编码提速之后的三个变化
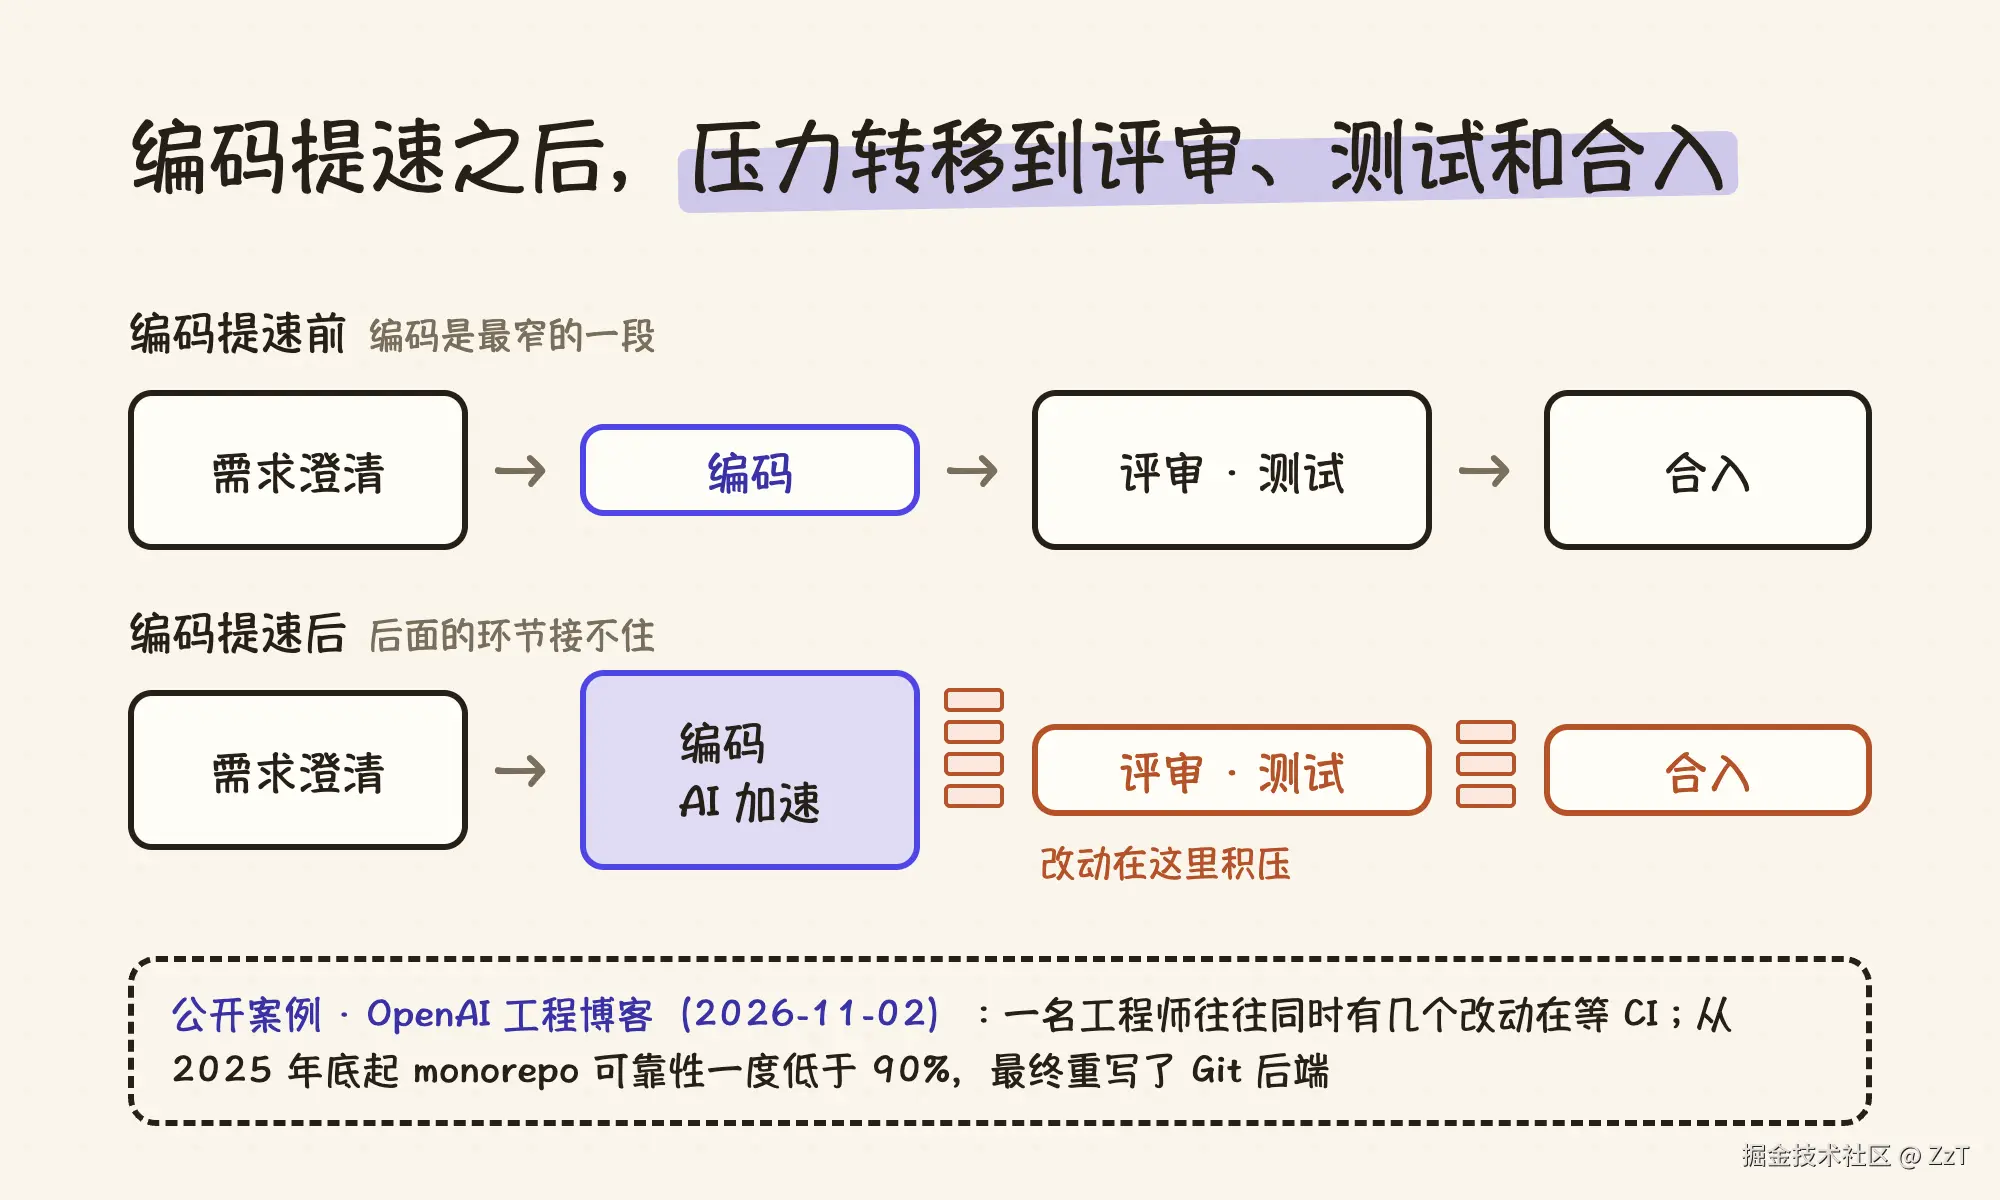
第一个变化是压力转移到编码前后的环节。 编码越快,单位时间里进入评审、测试和合入的改动越多,这些环节原有的容量很快不够用。
OpenAI 在 2026 年 11 月 2 日的工程博客里给出了一个公开案例。Codex 让工程师可以并行推进更多工作,一名工程师往往同时有几个改动在等 CI,每次 push 又会触发多个任务拉取同一个提交。
从 2025 年底开始,承载其 monorepo 的系统跟不上这种负载,可靠性一度低于 90%,最终他们重写了 Git 后端。
源码管理这种过去不被视为瓶颈的环节,在编码提速之后成了瓶颈。前后环节不跟着改造,编码节省下来的时间会被积压吃掉。
第二个变化是个人用法的差异被放大。 每个人使用 AI 的方式不同:有人先让它出方案,有人直接让它写代码;有人逐行审查,有人看到测试通过就合入。
同一个需求交给两个人,过程和质量都不一样。好的做法停留在个人习惯里,出了问题也定位不到是哪一步出的错。把交付过程写成明确的阶段、产物和检查之后,做法才能在团队内共享,结果才能度量,改进才有对象。
第三个变化是问题从「AI 能不能写」变成「能不能放手让它做」。 Agent 一次运行可以持续很长时间,中途还会派出多个子 agent,人不可能逐步盯着。
此时决定能否放手的不是模型能力,而是有没有机制保证四件事:
- 中断后能接着做;
- 失败后不会原地重试;
- 报告完成时确实完成;
- 每一处改动都有证据。
这些保证不会随着模型升级自动出现。
至于为什么是现在:构件已经齐了。 Claude Code 和 Codex 都提供了 subagent(隔离上下文、并行执行)、skill(按需加载的方法)、hook(在固定时机触发的脚本)、MCP(连接外部系统)和细粒度的权限配置。
缺的是组装方法:哪件事交给哪个机制,用到什么程度,哪里不能用。本系列每一篇都会专门讨论这一部分。
要做成什么样:可靠执行与正确交付两个目标
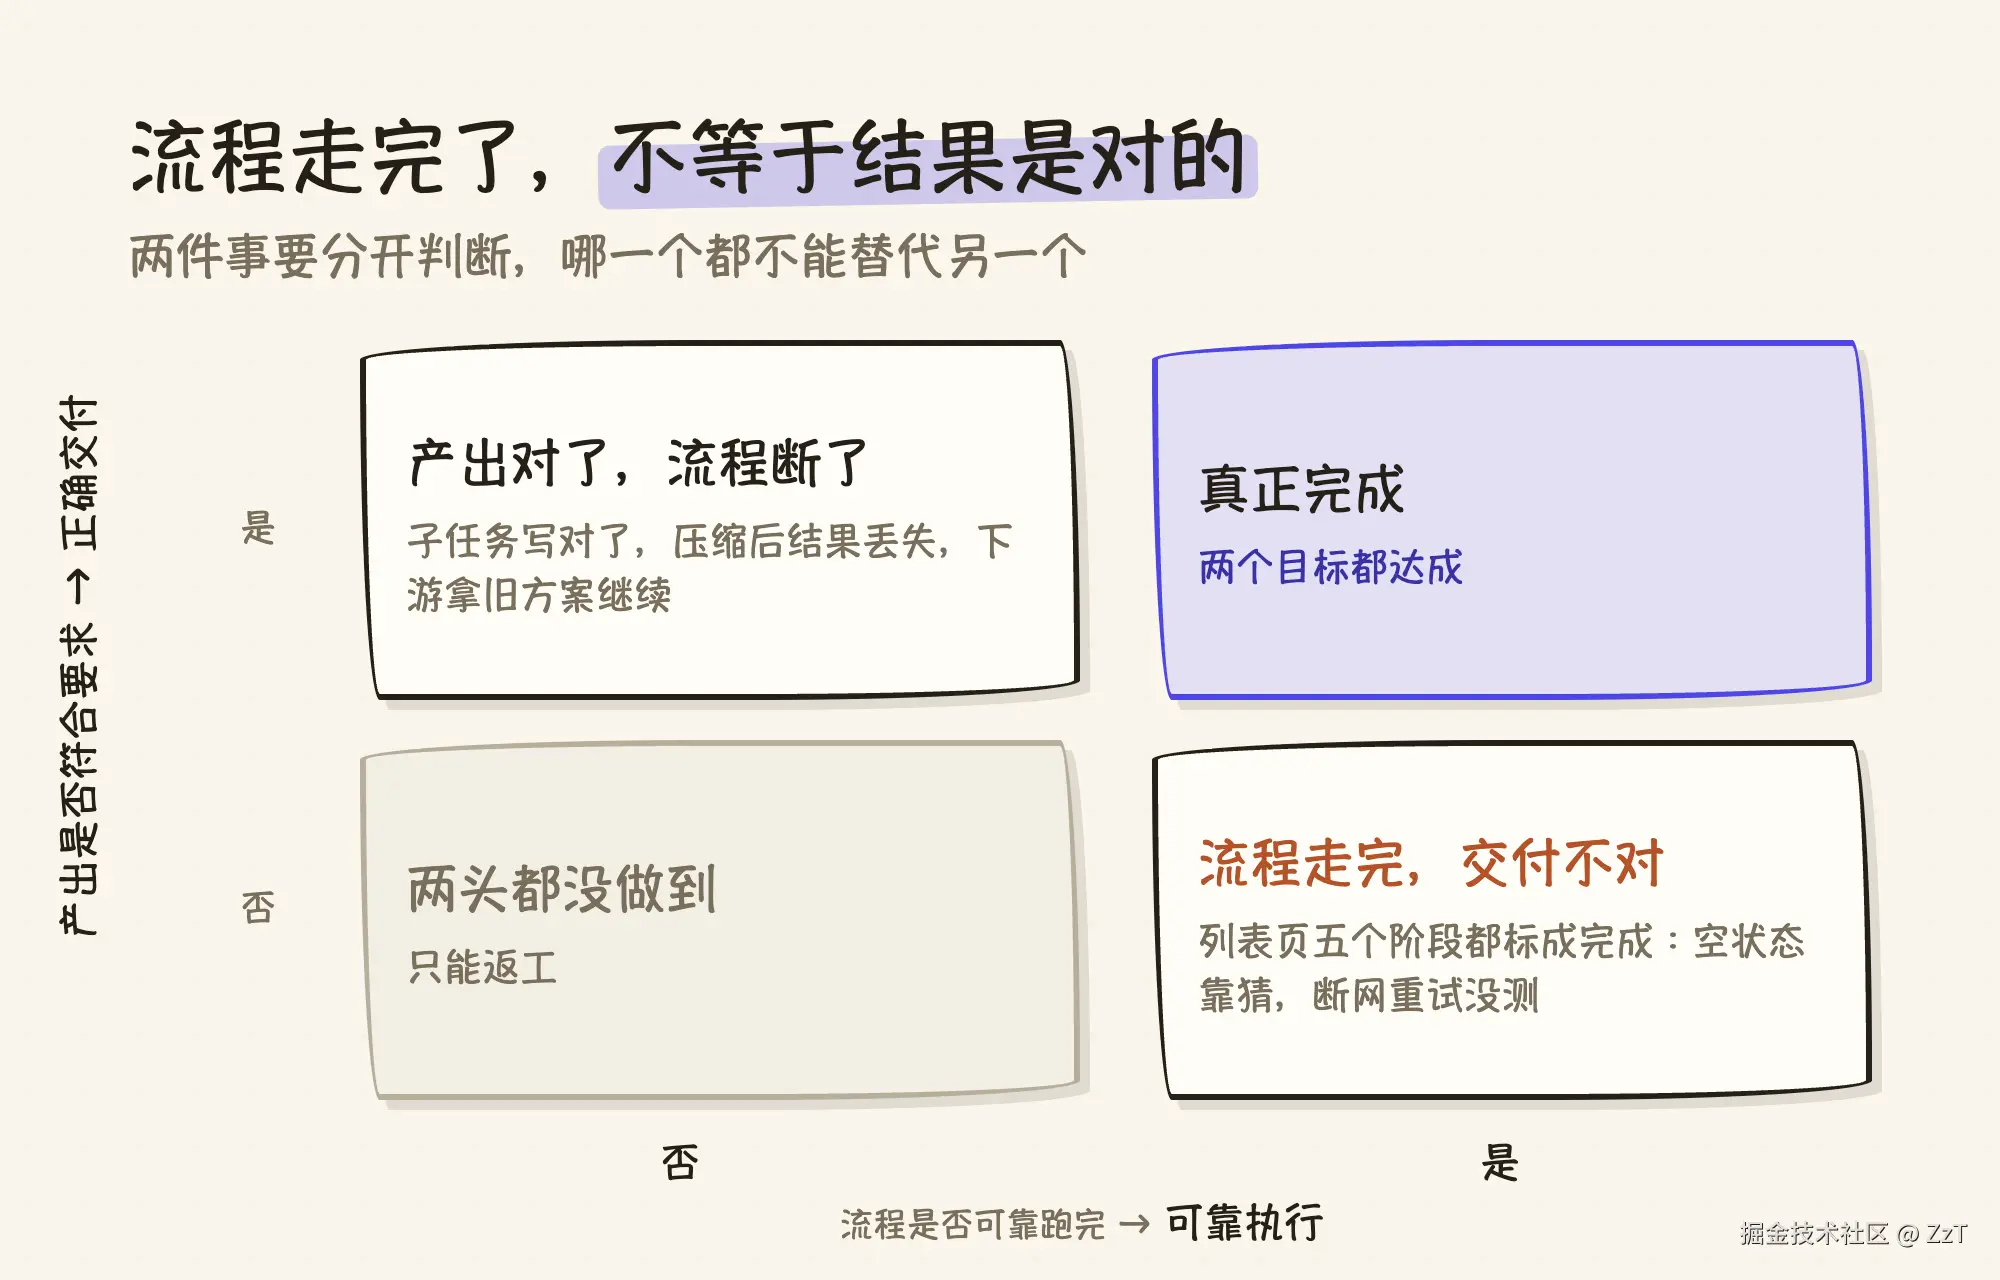
Agent 说「全部完成」,其实要分开看两件事:流程是不是走到了最后,产出是不是符合要求。这两件事经常不一致。
举一个典型的工作流:需求是给 App 新增一个列表页,五个阶段都标成了完成,编译和单测全部通过。但问题有两处:
- 设计稿只画了有数据时的样子,没画列表为空、加载失败时怎么显示,Agent 没有问,自己猜了一个样式;
- 验收标准里写了「网络断开时提示用户重试」,却没有任何测试覆盖这一条。
从流程上看,每个阶段都走完了;从交付上看,有两处不符合要求。
反方向的情况同样存在:某个子任务的代码写对了,但对话太长被自动压缩之后,负责调度的主 Agent 忘了这个子任务的结果存在哪里,后面的阶段拿着旧方案继续往下做,最终交付出错。
前一种失败出在正确性,后一种出在执行,两者的修复手段几乎没有交集。补再多测试,也找不回一份丢失的结果;状态管理做得再严密,也拦不住一个被猜出来的界面。
因此 AI-SDLC 要同时达成两个目标,二者互不替代:任务可靠地跑完,结果确实是对的。 每个目标下各有五个必须解决的问题。
可靠执行:每一步有依据,中断能恢复
| 问题 | 解决办法 |
|---|---|
| 对话太长,Agent 记不清做到了哪一步 | 阶段状态、产物和验证记录写进任务目录,不只存在对话里 |
| 不同类型的任务,流程不一样 | 用流程定义规定有哪些阶段、先后依赖;每个阶段写明输入、执行、输出和检查 |
| 多个 Agent 协作时信息丢失 | 派任务时写明目标、必要资料和允许修改的范围;交回时给出可核对的产物,而不是一句「完成了」 |
| 出错后反复重试,却没有进展 | 先判断问题出在哪一环(需求、设计、实现、环境、授权),退回对应阶段处理,每条通道限定次数 |
| 只做完一部分,却报告全部完成 | 按实际走到的阶段、必需产物、检查结果和未解决的问题计算完成状态,不以 Agent 的自述为准 |
这一侧最容易被低估的是上下文压缩。长任务里压缩是常态,阶段状态和产物路径只要存在于对话中,就会在某次压缩时丢失。所以它们全部写进任务目录,恢复时读文件,不读模型对前文的印象。
正确交付:每个判断能对照事实核验
| 问题 | 解决办法 |
|---|---|
| 用通用经验代替这条业务的规则 | 读取当前业务的规则,确认规则的适用范围和来源 |
| 设计稿不完整,Agent 自己猜界面 | 回到设计源头取设计,逐个核对组件状态和视觉规范,缺的就问 |
| 编造不存在的 API,或重复造已有的组件 | 动手前先查当前代码、已有组件和接口定义 |
| 把一个平台的写法照搬到另一个平台 | 复用业务行为,同时分别遵守各平台自己的架构和编码约束 |
| 测试通过了,但没覆盖真正的需求 | 按验收标准逐条安排验证,没覆盖的条目明确列出来 |
这五个问题有一个共同的失败模式:用通用经验代替具体事实。推测替代设计源,记忆中的 API 替代当前的接口定义,测试通过替代验收覆盖。
这也呼应了第一节:Agent 参与的环节越多,能拿到的事实越多,需要靠经验去猜的地方就越少。
两个目标的共同原则
两张表里的解决办法背后是同一条原则:判断依据落盘的事实,不依据聊天记忆,也不依据模型的自述。
两个目标在「完成」的判定上交汇:验证通过不等于已提交,已提交不等于已上线,没有获得授权的外部动作要明确写成未执行。第 07 篇会展开这套判定。
架构分层:Coding Agent 宿主、CLI 与 Agent
既然 Claude Code、Codex 这类 Coding Agent 宿主已经提供了这么多机制,一个自然的想法是把整套流程直接写进去:状态机写成一个 skill,门禁写成一个 hook。这两种做法都有结构性问题。
skill 的正文由模型理解后执行。同一段「先检查 A 再推进到 B」的说明,在不同的工作流里执行结果并不一致,模型会跳步,会在上下文压力下省略检查。
hook 的问题在另一侧:它是否运行,取决于宿主版本、用户配置和信任设置,同一份配置在不同机器上不保证都会执行。
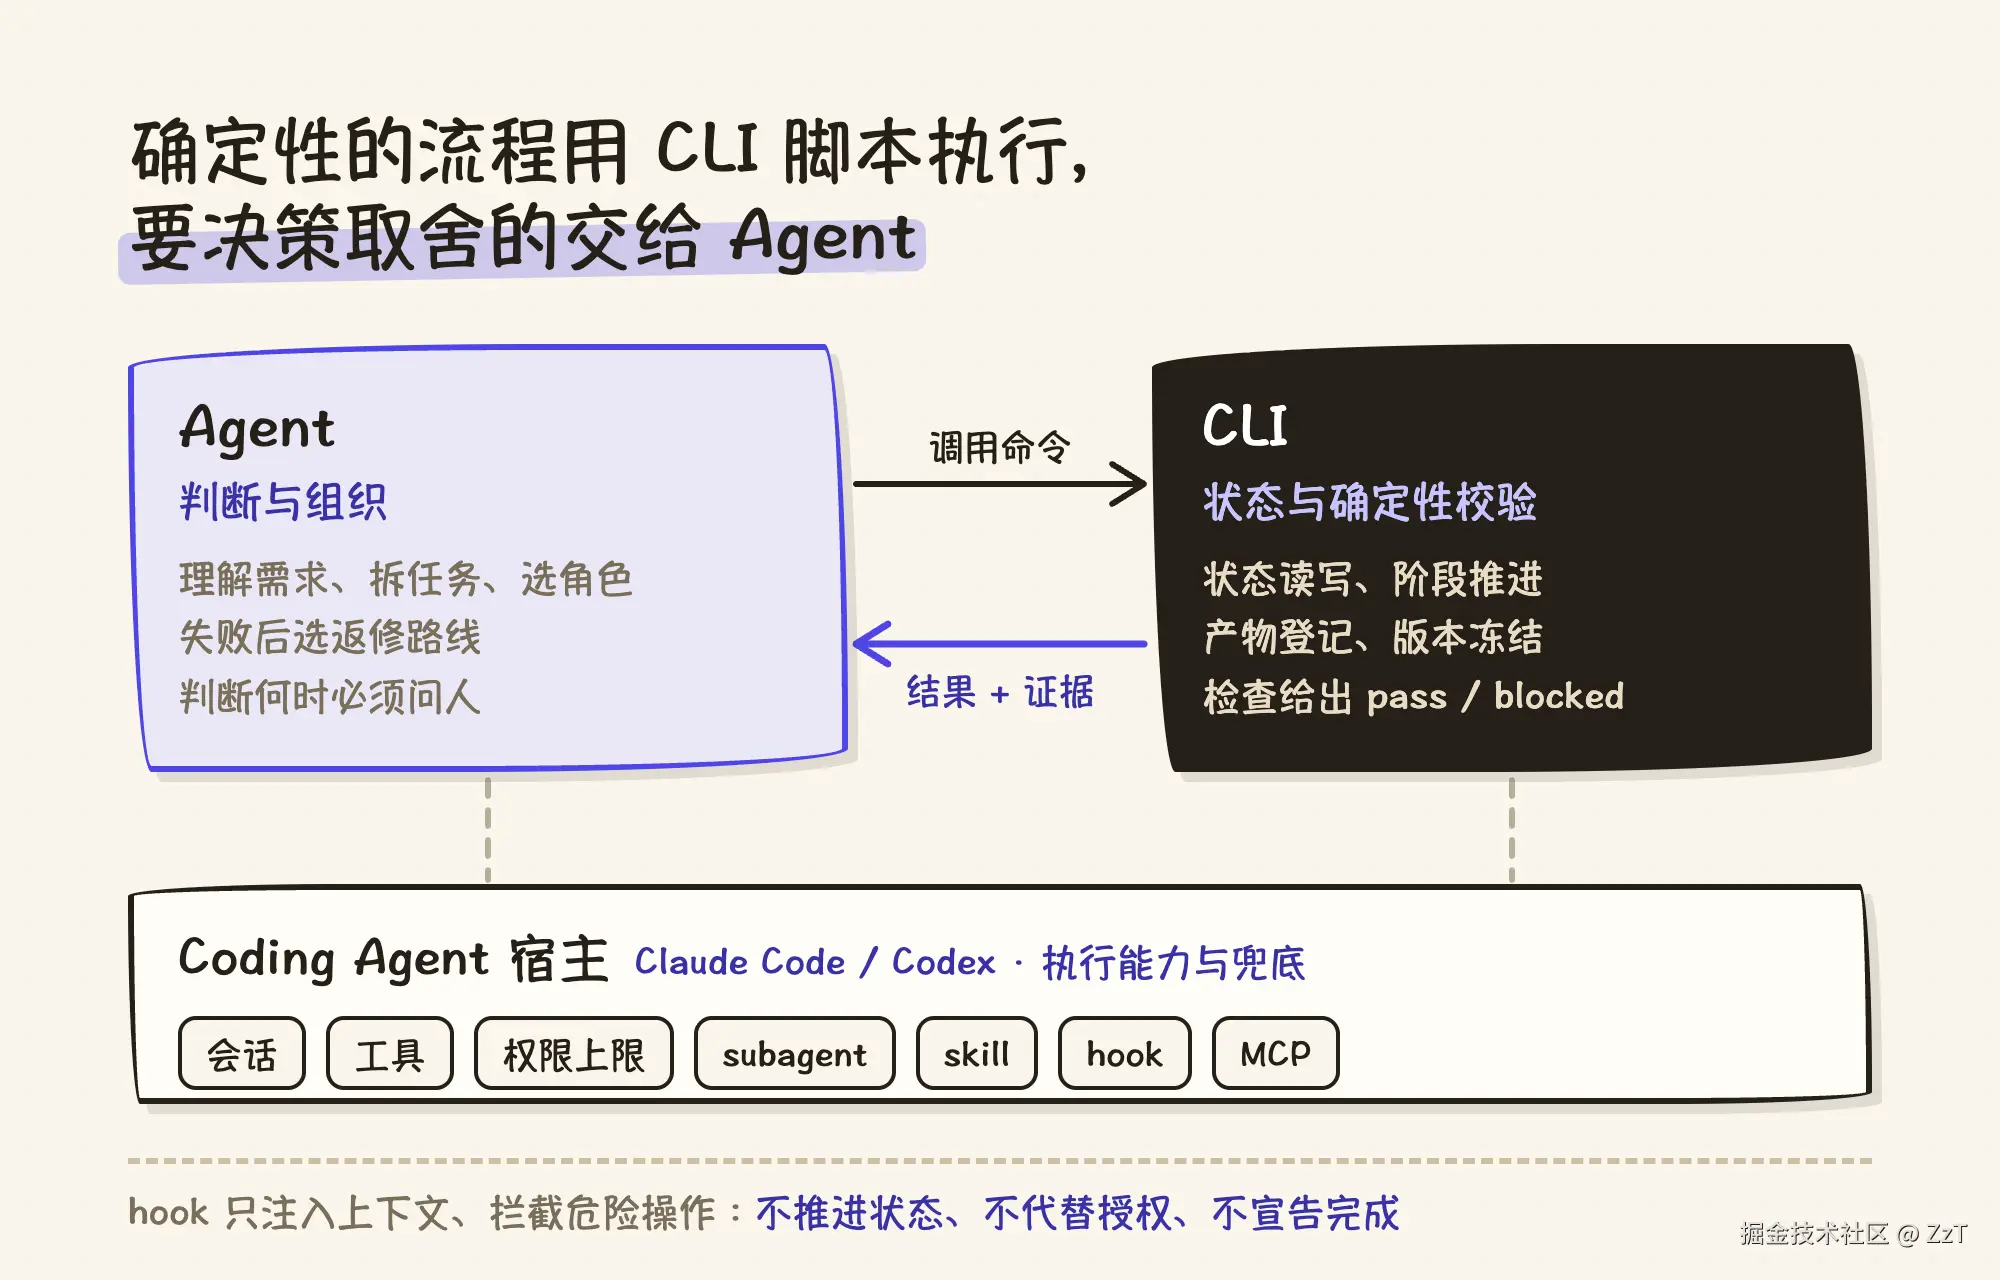
所以分成三层,各层的职责按「是否需要每次结果一致」来划:
- Coding Agent 宿主负责执行能力与兜底。 会话、工具、权限上限、子 agent 的生命周期和外部连接由宿主提供;hook 在启动、压缩恢复等时机注入最小上下文,拦截明确的危险操作,但不推进状态,不代替用户授权,也不凭一条提示宣告任务完成。
- CLI 负责状态与确定性校验。 运行状态的读写、阶段推进、产物登记和各类检查都是普通命令,相同输入得到相同输出,版本随一次运行冻结。
- Agent 负责判断与组织。 理解需求、拆分任务、选择角色、失败后决定返修路线、判断什么时候必须问人,这些需要理解和取舍。
每种宿主机制在这套体系里具体管什么、Claude Code 和 Codex 两边的配置和行为有哪些差异,第 01 篇用一张对照表逐项说明。
衡量 AI-SDLC 自动化程度的四级阶梯
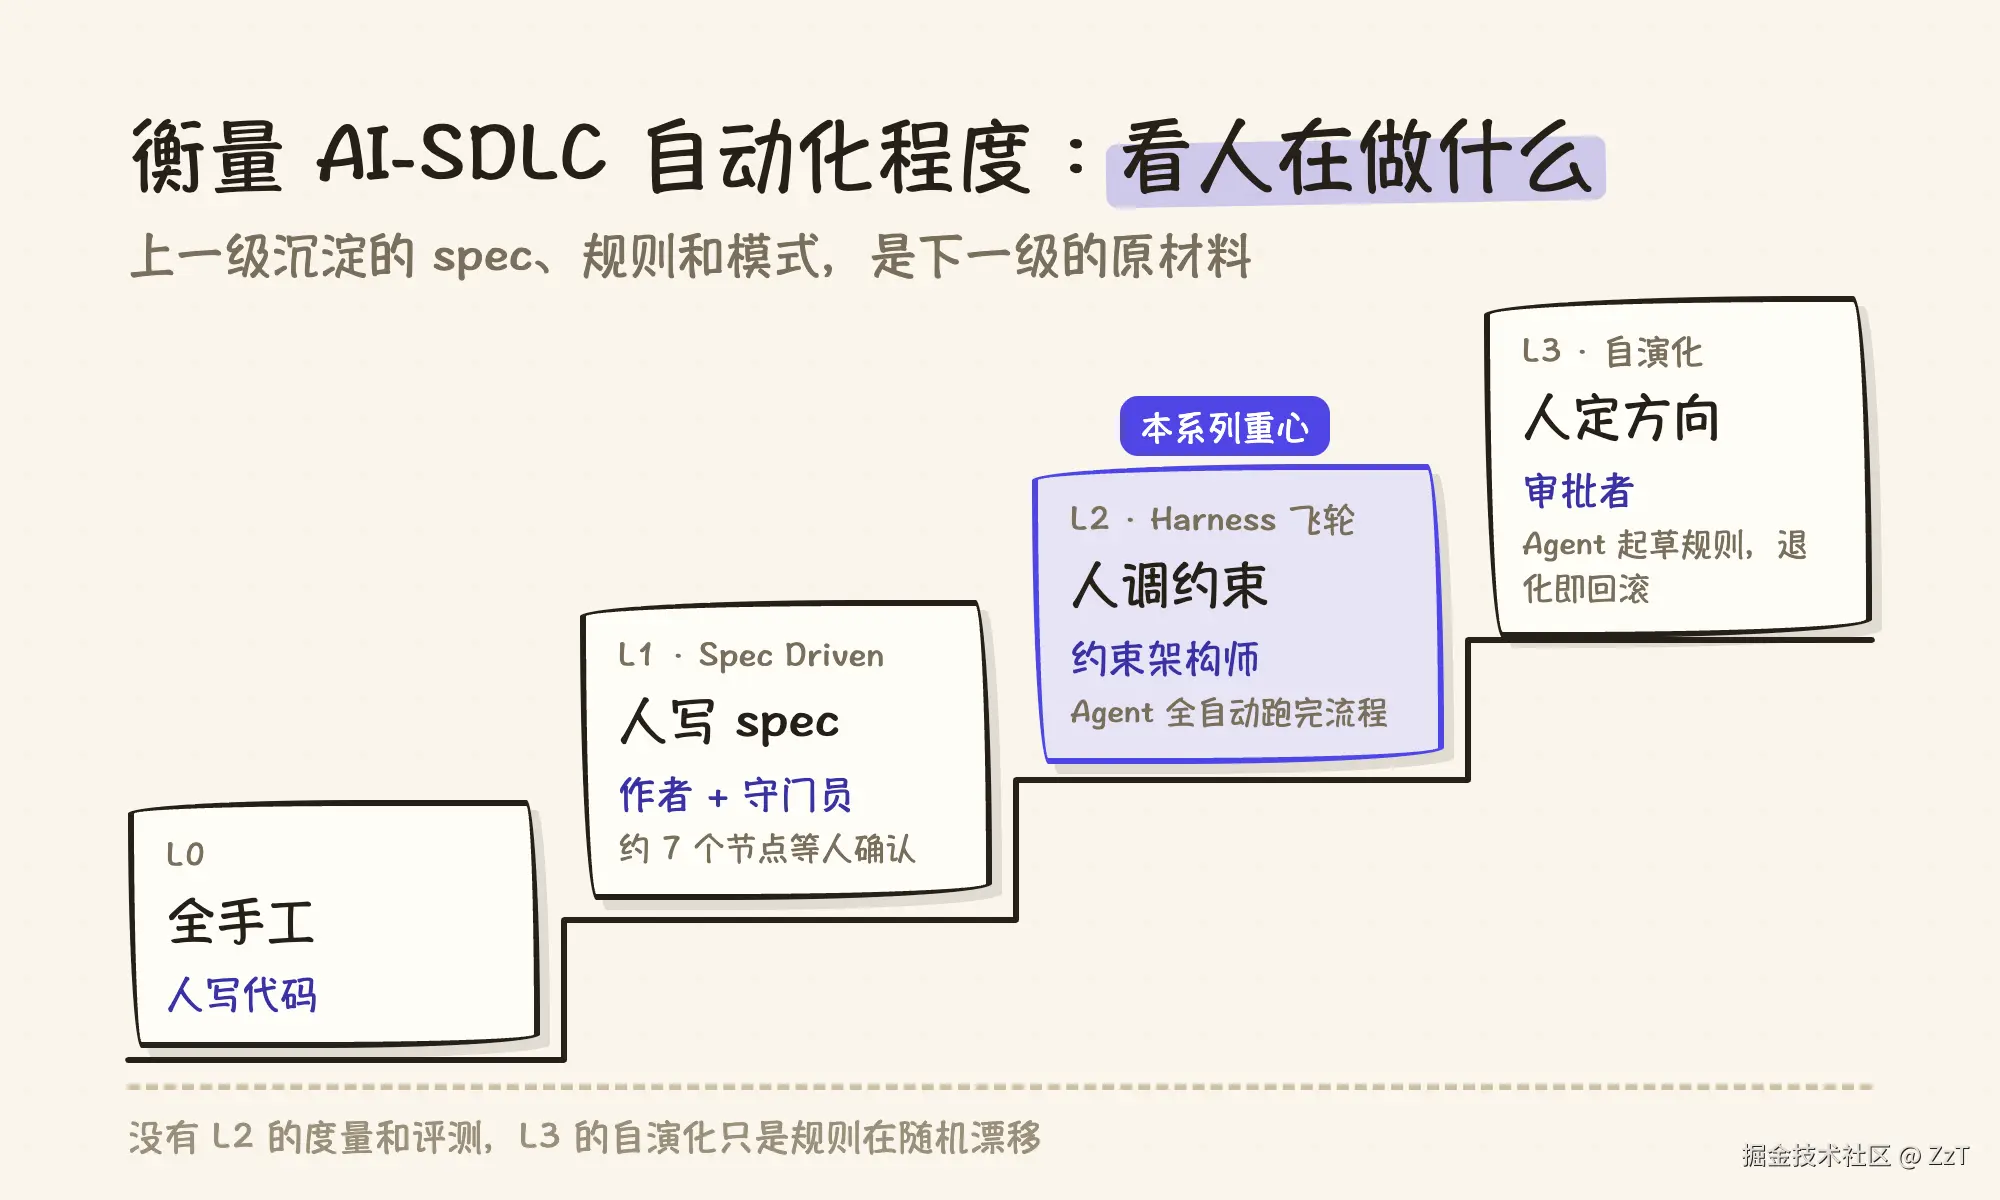
衡量 AI-SDLC 的自动化程度,看的是人在做什么。按这个标准可以分为四级:
- L0 全手工:人写代码。
- L1 Spec Driven Development:人写 spec 并充当守门员,一条标准流程里人要在七个左右的节点上确认,Agent 才能继续。
- L2 Harness 飞轮:人只调整约束本身(规则、skill、角色、hook),Agent 在约束内全自动跑完整条流程,运行轨迹和评测结果回流给人。
- L3 自演化:Agent 从失败轨迹里起草新规则,人审批后升级,指标退化就回滚。
上一级沉淀的 spec、规则和模式是下一级的原材料,四级之间是沉淀关系,不是替代关系。
多数团队目前处在 L1,最容易被跳过的是 L2。自演化的前提是能判断一次修改是否让结果变好,这需要稳定的度量、可重放的评测和单一变量的对照;没有这些,所谓自演化只是规则在随机漂移。
本系列的重心因此放在 L2 需要的工程设施上。
系列篇介绍
系列按交付阶段展开,底座和横切能力单独成篇。
每个阶段篇回答同一组问题:Agent 在这个阶段拿到什么上下文,做什么,产出什么,人在哪里决策,怎么检查,落到 Claude Code 和 Codex 的哪个机制上。
| 篇 | 主题 |
|---|---|
| 00 | 总纲:AI-SDLC 是什么、为什么要做 |
| 01 | 机制地图:六种机制各管什么,一套资产怎么跑在两个宿主上 |
| 02 | 流程底座:阶段合同、状态机与恢复 |
| 03 | 需求理解:把需求文档、设计稿和仓库事实收敛成唯一规格 |
| 04 | 方案设计与评审:把方案变成可执行的任务图 |
| 05 | 开发:多 Agent 按任务图并行 |
| 06 | 验证与联调测试:在冻结的候选版本上收口 |
| 07 | 交付:逐动作授权,部分完成不报完成 |
| 08 | 知识:分层读取,随交付回写 |
| 09 | 度量与评测:怎么证明这套流程变好了 |
| 10 | 插件化:一套流程服务多个团队 |
| 11 | 飞轮:把每次交付的问题沉淀回 Harness |
机制本身的基础知识(hook 有哪些事件、skill 怎么写)在之前的 Harness Engineering 系列里讲过,本系列直接引用,只讨论这些机制如何组合成一条交付流水线。
下一篇画机制地图:Agent、Skill、Hook、MCP、入口文件与配置、Checker 六种机制各管什么,以及一套资产如何同时跑在 Claude Code 和 Codex 上。