关键词:Embedding、词向量、余弦相似度、测地线距离、PCA、Plotly、jina-embeddings-v4
我们常说 "两个词的向量很接近",但这个 "接近" 到底长什么样?大多数教程会用 PCA 或 t-SNE 把向量压成二维散点图,然后说:你看,猫和狗靠得很近。
这种画法有一个容易被忽略的问题:主流 Embedding 模型输出的向量是归一化的,它们本来就住在一个超球面上,而不是整个空间里。 用平面散点图去看球面上的点,几何关系天然会被扭曲。
这篇文章用不到 200 行 Python,把一组词向量投影到一个 3D 地球仪上,并用大圆弧(great-circle arc)把它们连起来。你可以用鼠标转动这个 "词语地球仪",直接看到哪些词是邻居,哪些词相隔甚远。
完整代码就一个文件:[embedding_spherical.py](https://github.com/liu-xiao-guo/elastic_multimodal_search/blob/main/embedding_spherical.py "embedding_spherical.py")。
一、为什么是球面?
1. 归一化向量住在球面上
调用 Embedding 模型时,如果指定 normalize_embeddings=True,每个向量的 L2 范数都是 1:
ini
`embeddings = model.encode(WORDS, task="retrieval", normalize_embeddings=True)` AI代码解释单位长度的向量,终点都落在单位超球面上。此时向量的"长度"不再携带信息,唯一有意义的是方向。
2. 余弦相似度 = 夹角
对单位向量来说,余弦相似度就是点积,而点积的反余弦正好是两个向量的夹角,也就是它们在球面上的测地线距离:
ini
`

1.  cos_sim = np.clip(embeddings @ embeddings.T, -1.0, 1.0)
2.  ang_dist = np.arccos(cos_sim)  # 弧度

`AI代码解释
这里的 np.clip 是为了防止浮点误差让数值略微超出 -1, 1,导致 arccos 返回 nan。
所以,"相似度高"与"球面上距离近"是同一件事的两种说法。既然如此,直接在球面上画图,比在平面上画图要诚实得多。
二、整体思路
整个脚本只做五件事:
- 用
sentence-transformers加载模型,得到每个词的高维向量; - 在原始高维空间中计算两两之间的夹角(这是"真值");
- 用 PCA 把向量降到 3 维;
- 把 3 维坐标再次归一化,推到单位球面上;
- 用 Plotly 画出球体、经纬网格、词语标记和大圆弧,输出一个可交互的 HTML。
下面逐步拆解。
三、准备数据:词表与分 类 着色
ini
`

1.  WORDS = ["cat", "dog", "kitten", "Puppy", "king", "queen",
2.           "猫", "狗", "table", "chair", "pizza", "pasta", "asymptomatic"]
3.  MODEL_NAME = "jinaai/jina-embeddings-v4"

`AI代码解释
词表是刻意设计的,包含几类"对照组":
| 类别 | 词语 | 想验证什么 |
|---|---|---|
| 动物 | cat、dog、kitten、Puppy、猫、狗 | 同义词、幼崽、跨语言能否聚在一起 |
| 皇室 | king、queen | 语义相关但不属于动物 |
| 家具 | table、chair | 同类名词 |
| 食物 | pizza、pasta | 同类名词 |
| 医学 | asymptomatic | 作为"离群点",看它会落在哪里 |
我选用 jina-embeddings-v4,因为它是多 语言模型 ,可以顺便观察"猫"和 "cat" 是否真的靠在一起。
颜色由类别决定:
ini
`COLORS = [CATEGORY_COLORS[WORD_CATEGORIES.get(w, "other")] for w in WORDS]` AI代码解释没有登记类别的词会自动落到 "other"(灰色),所以以后往词表里加词不会报错。
四、降维:PCA 到 3D,再推回球面
ini
`

1.  pca3 = PCA(n_components=3)
2.  coords3 = pca3.fit_transform(embeddings)
3.  exp3 = pca3.explained_variance_ratio_ * 100

5.  norms = np.linalg.norm(coords3, axis=1, keepdims=True)
6.  sphere = coords3 / np.where(norms == 0, 1, norms)

`AI代码解释
这里有两个细节值得说一下。
第一,PCA 会先做中心化。 原始向量往往挤在球面的某一小块区域里(同一个模型产出的向量有共同的"偏置方向"),中心化之后,点会围绕原点散开,再归一化就能均匀地铺在球面上,画面更好看,也更容易区分。
第二,降到 3 维必然损失信息。 脚本会把前三个主成分保留的方差比例打印出来,并显示在图标题里。13 个词的向量维度很高,3 个主成分只能解释其中一部分,所以这张图是一个示意,不是原空间的完整复制。
为了让大家知道"图上看到的"和"真实的"差多少,脚本同时保存了两套距离:
ini
`

1.  # 原始高维空间的真实夹角
2.  ang_dist = np.arccos(cos_sim)

4.  # 降到 3D 球面之后,你实际看到的夹角
5.  shown_dist = np.arccos(np.clip(sphere @ sphere.T, -1.0, 1.0))

`AI代码解释
鼠标悬停到任意一条弧线上,这两个数会同时显示,你可以直接对比降维带来的失真。
五、核心:用球面线性插值画大圆弧
球面上两点之间的最短路径是大圆弧,而不是直线。要在 3D 里把它画出来,需要球面线性插值(slerp):
python
`

1.  def slerp(a, b, n=40):
2.      """Points along the great-circle arc (shortest path) from a to b."""
3.      omega = np.arccos(np.clip(np.dot(a, b), -1.0, 1.0))
4.      t = np.linspace(0, 1, n)[:, None]
5.      if omega < 1e-8:
6.          return np.repeat(a[None, :], n, axis=0)
7.      return (np.sin((1 - t) * omega) * a + np.sin(t * omega) * b) / np.sin(omega)

`AI代码解释
公式是:
slerp(a,b,t)=sin((1−t)ω)sinω a+sin(tω)sinω b,ω=arccos(a⋅b)slerp(a,b,t)=sinωsin((1−t)ω)a+sinωsin(tω)b,ω=arccos(a⋅b)
当 t 从 0 走到 1,插值点就沿着球面从 a 滑到 b,并且始终保持在单位球面上。代码里 omega < 1e-8 的分支处理的是两点几乎重合的退化情况,避免除以接近 0 的 sin(omega)。
六、画一个 "半透明地球仪"
1. 球体与经纬网格
球体用 go.Surface 画得非常淡(opacity=0.12),再叠一层经纬线,立刻有了地球仪的感觉:
ini
`

1.  fig.add_trace(go.Surface(
2.      x=sx, y=sy, z=sz, showscale=False, opacity=0.12,
3.      colorscale=[[0, "#cfd8e6"], [1, "#cfd8e6"]],
4.      hoverinfo="skip", showlegend=False,
5.      lighting=dict(ambient=1.0, diffuse=0.0),
6.  ))

`AI代码解释
lighting=dict(ambient=1.0, diffuse=0.0) 去掉了明暗变化,让球体像一层均匀的薄雾,不会抢走词语的注意力。
经纬线则合并成一条 折线 trace,用 None 分隔不同线段:
scss
`xs += list(r * np.cos(t)) + [None]` AI代码解释这是 Plotly 里的一个小技巧:几十条线只占一个 trace,渲染更快、图例也不会被撑爆。
2. 词语标记
每个词是一个独立的 Scatter3d trace,这样图例里可以单独点击显示或隐藏某个词,悬停时还能看到它的 (x, y, z) 坐标。
3. 弧线要"浮"在球面上
css
`arc = slerp(sphere[i], sphere[j]) * 1.004` AI代码解释注意那个 1.004。弧线如果恰好贴在半径为 1 的球面上,会被半透明球体"吃掉"一部分,出现断断续续的视觉问题。把弧线半径放大 0.4%,它就微微浮在球面上方,肉眼看不出偏差,却再也不会被遮挡。后面高亮线用的是 1.006,让它压在普通弧线之上。
七、最近邻高亮:让重点自己跳出来
13 个词两两连线有 78 条弧,全画出来会很乱。所以脚本为每个词找到它的最近邻,用深色粗线单独高亮,并在弧线中点标出角度:
scss
`

1.  nn_pairs = set()
2.  for i in range(len(WORDS)):
3.      d = ang_dist[i].copy()
4.      d[i] = np.inf          # 排除自己
5.      j = int(np.argmin(d))
6.      nn_pairs.add((min(i, j), max(i, j)))

`AI代码解释
用 (min(i, j), max(i, j)) 作为键放进集合,可以自动去重:如果 A 的最近邻是 B,B 的最近邻也是 A,只会画一条线。
注意这里用的是 ang_dist,也就是高维空间里的真实距离,而不是 3D 投影后的距离。这样高亮出来的最近邻是"真"的最近邻,不会被降维误导。
八、交互按钮
图左上角有五个按钮,通过 Plotly 的 restyle 批量修改 trace 属性:
| 按钮 | 作用 |
|---|---|
| Show / Hide Labels | 切换词语文字标签 |
| All Arcs | 显示所有弧线 |
| Nearest Only | 只保留最近邻高亮 |
| Hide Arcs | 隐藏全部弧线 |
实现上只需要事先记录每类 trace 的下标(label_traces、arc_traces、nn_traces),按钮就知道该改谁:
ini
`

1.  dict(label="Nearest Only", method="restyle",
2.       args=[{"visible": False}, arc_idx])

`AI代码解释
这是纯前端交互,输出的 HTML 文件不依赖 Python 运行环境,可以直接发给别人打开。
九、运行与输出
安装依赖:
go
`pip install numpy scikit-learn plotly sentence-transformers` AI代码解释运行:
go
`python embedding_spherical.py` AI代码解释脚本会:
- 在终端打印 Embedding 形状、前三个主成分的方差占比,以及每个词到其最近邻的角度;
- 把交互图保存为临时目录下的
word_embeddings_spherical.html; - 自动用浏览器打开。
提示:
jina-embeddings-v4体积较大,首次运行需要下载模型,请耐心等待;加载时需要trust_remote_code=True。
十、怎么读这张图
建议你转动球体,重点观察几件事:
- 同类词是否聚成团? 比如动物类(cat、dog、kitten、Puppy)是否彼此相邻;
- 跨语言是否对齐? "猫"与 cat、"狗"与 dog 的弧线是否很短;
- 离群点在哪里? asymptomatic 这类医学词汇与其他词的距离;
- 失真有多大? 悬停在弧线上,对比"embedding 测地线"和"球面弧长"两个角度,差距越大,说明 3D 投影丢失的信息越多。
具体的结果取决于你本机运行的模型和版本,我建议以你自己看到的图和终端输出为准。
十一、几个值得注意的坑
- 图是示意,不是真值。 3 维只保留了部分方差,任何结论都应以高维空间里的夹角(
ang_dist)为准。 - "距离近"不一定"语义同义"。 Embedding 捕捉的是共现和用法上的相似,反义词、同一话题下的词也可能靠得很近。
task参数会影响结果。 jina-embeddings-v4 对不同任务(如retrieval)有不同的适配,换任务类型,球面上的布局可能随之变化。- 词太多会显得拥挤。 弧线数量按 N² 增长,词表超过二三十个时,建议默认只显示最近邻。
十二、可以继续玩的方向
- 换成别的模型(BGE、E5、OpenAI 等),比较不同模型的 "词语地球仪";
- 把词换成句子,看主题如何在球面上聚类;
- 把 PCA 换成 UMAP,对比哪种降维更能保持原空间的邻近关系;
- 增加一个量化指标,例如统计 3D 最近邻与高维最近邻一致的比例,用数字衡量失真。
十三、展示
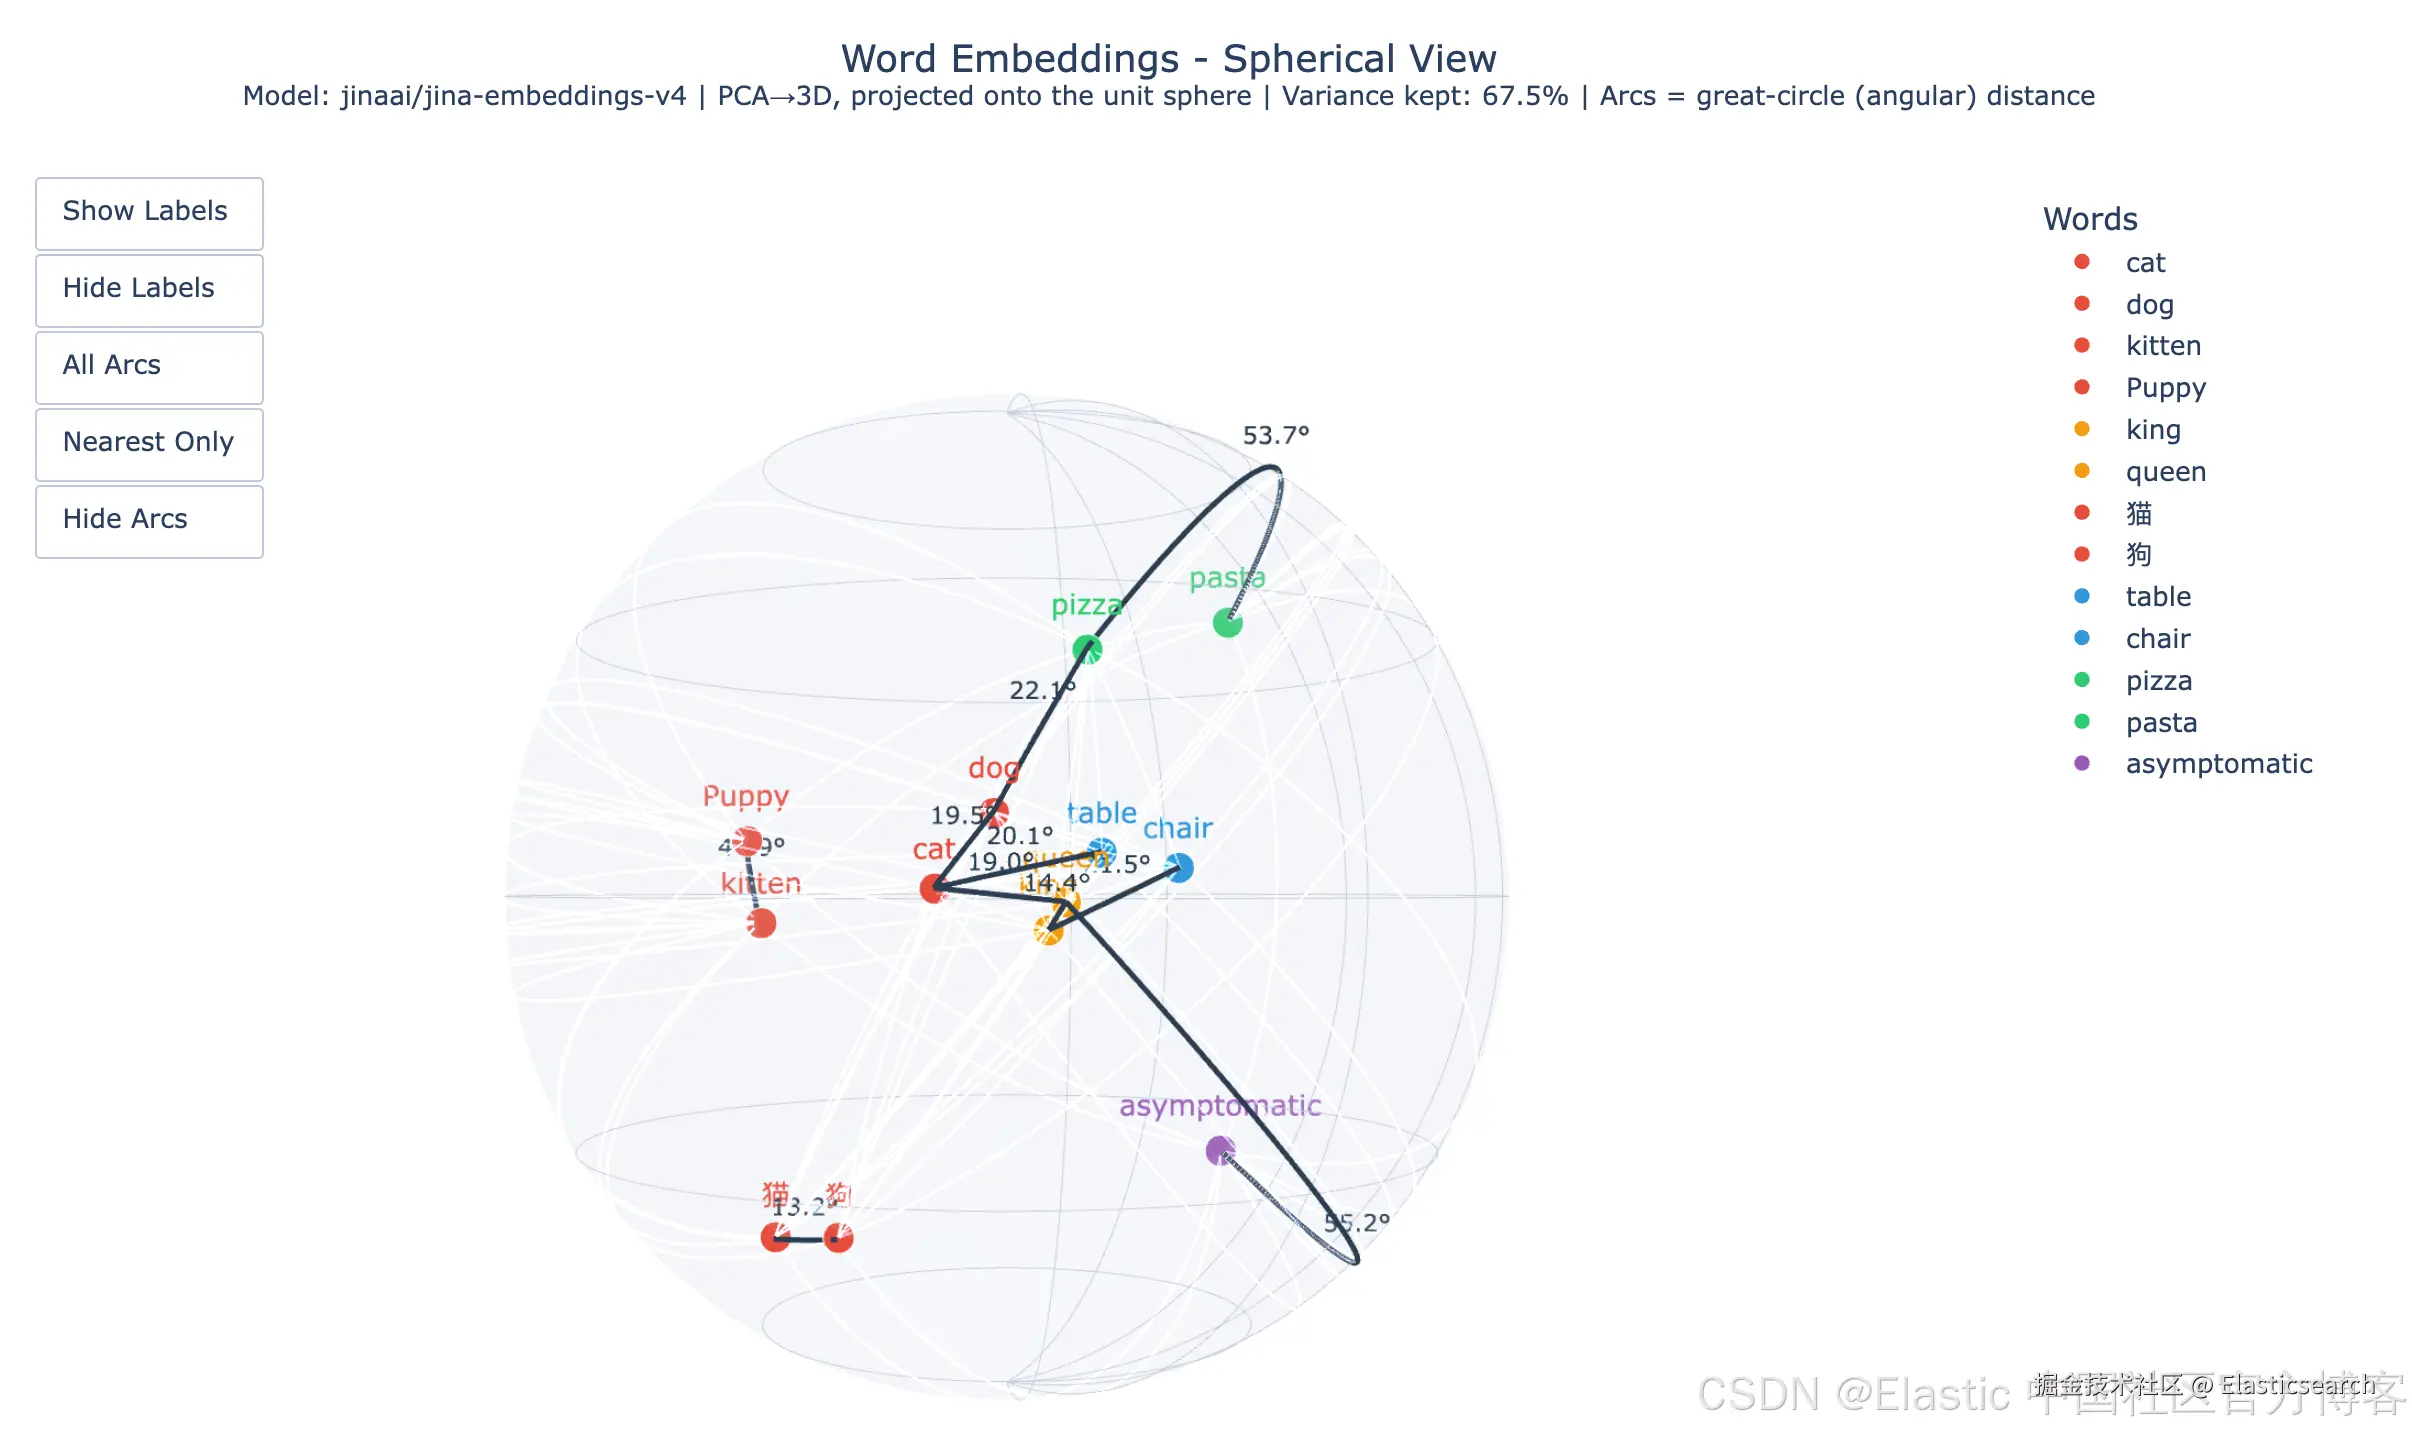
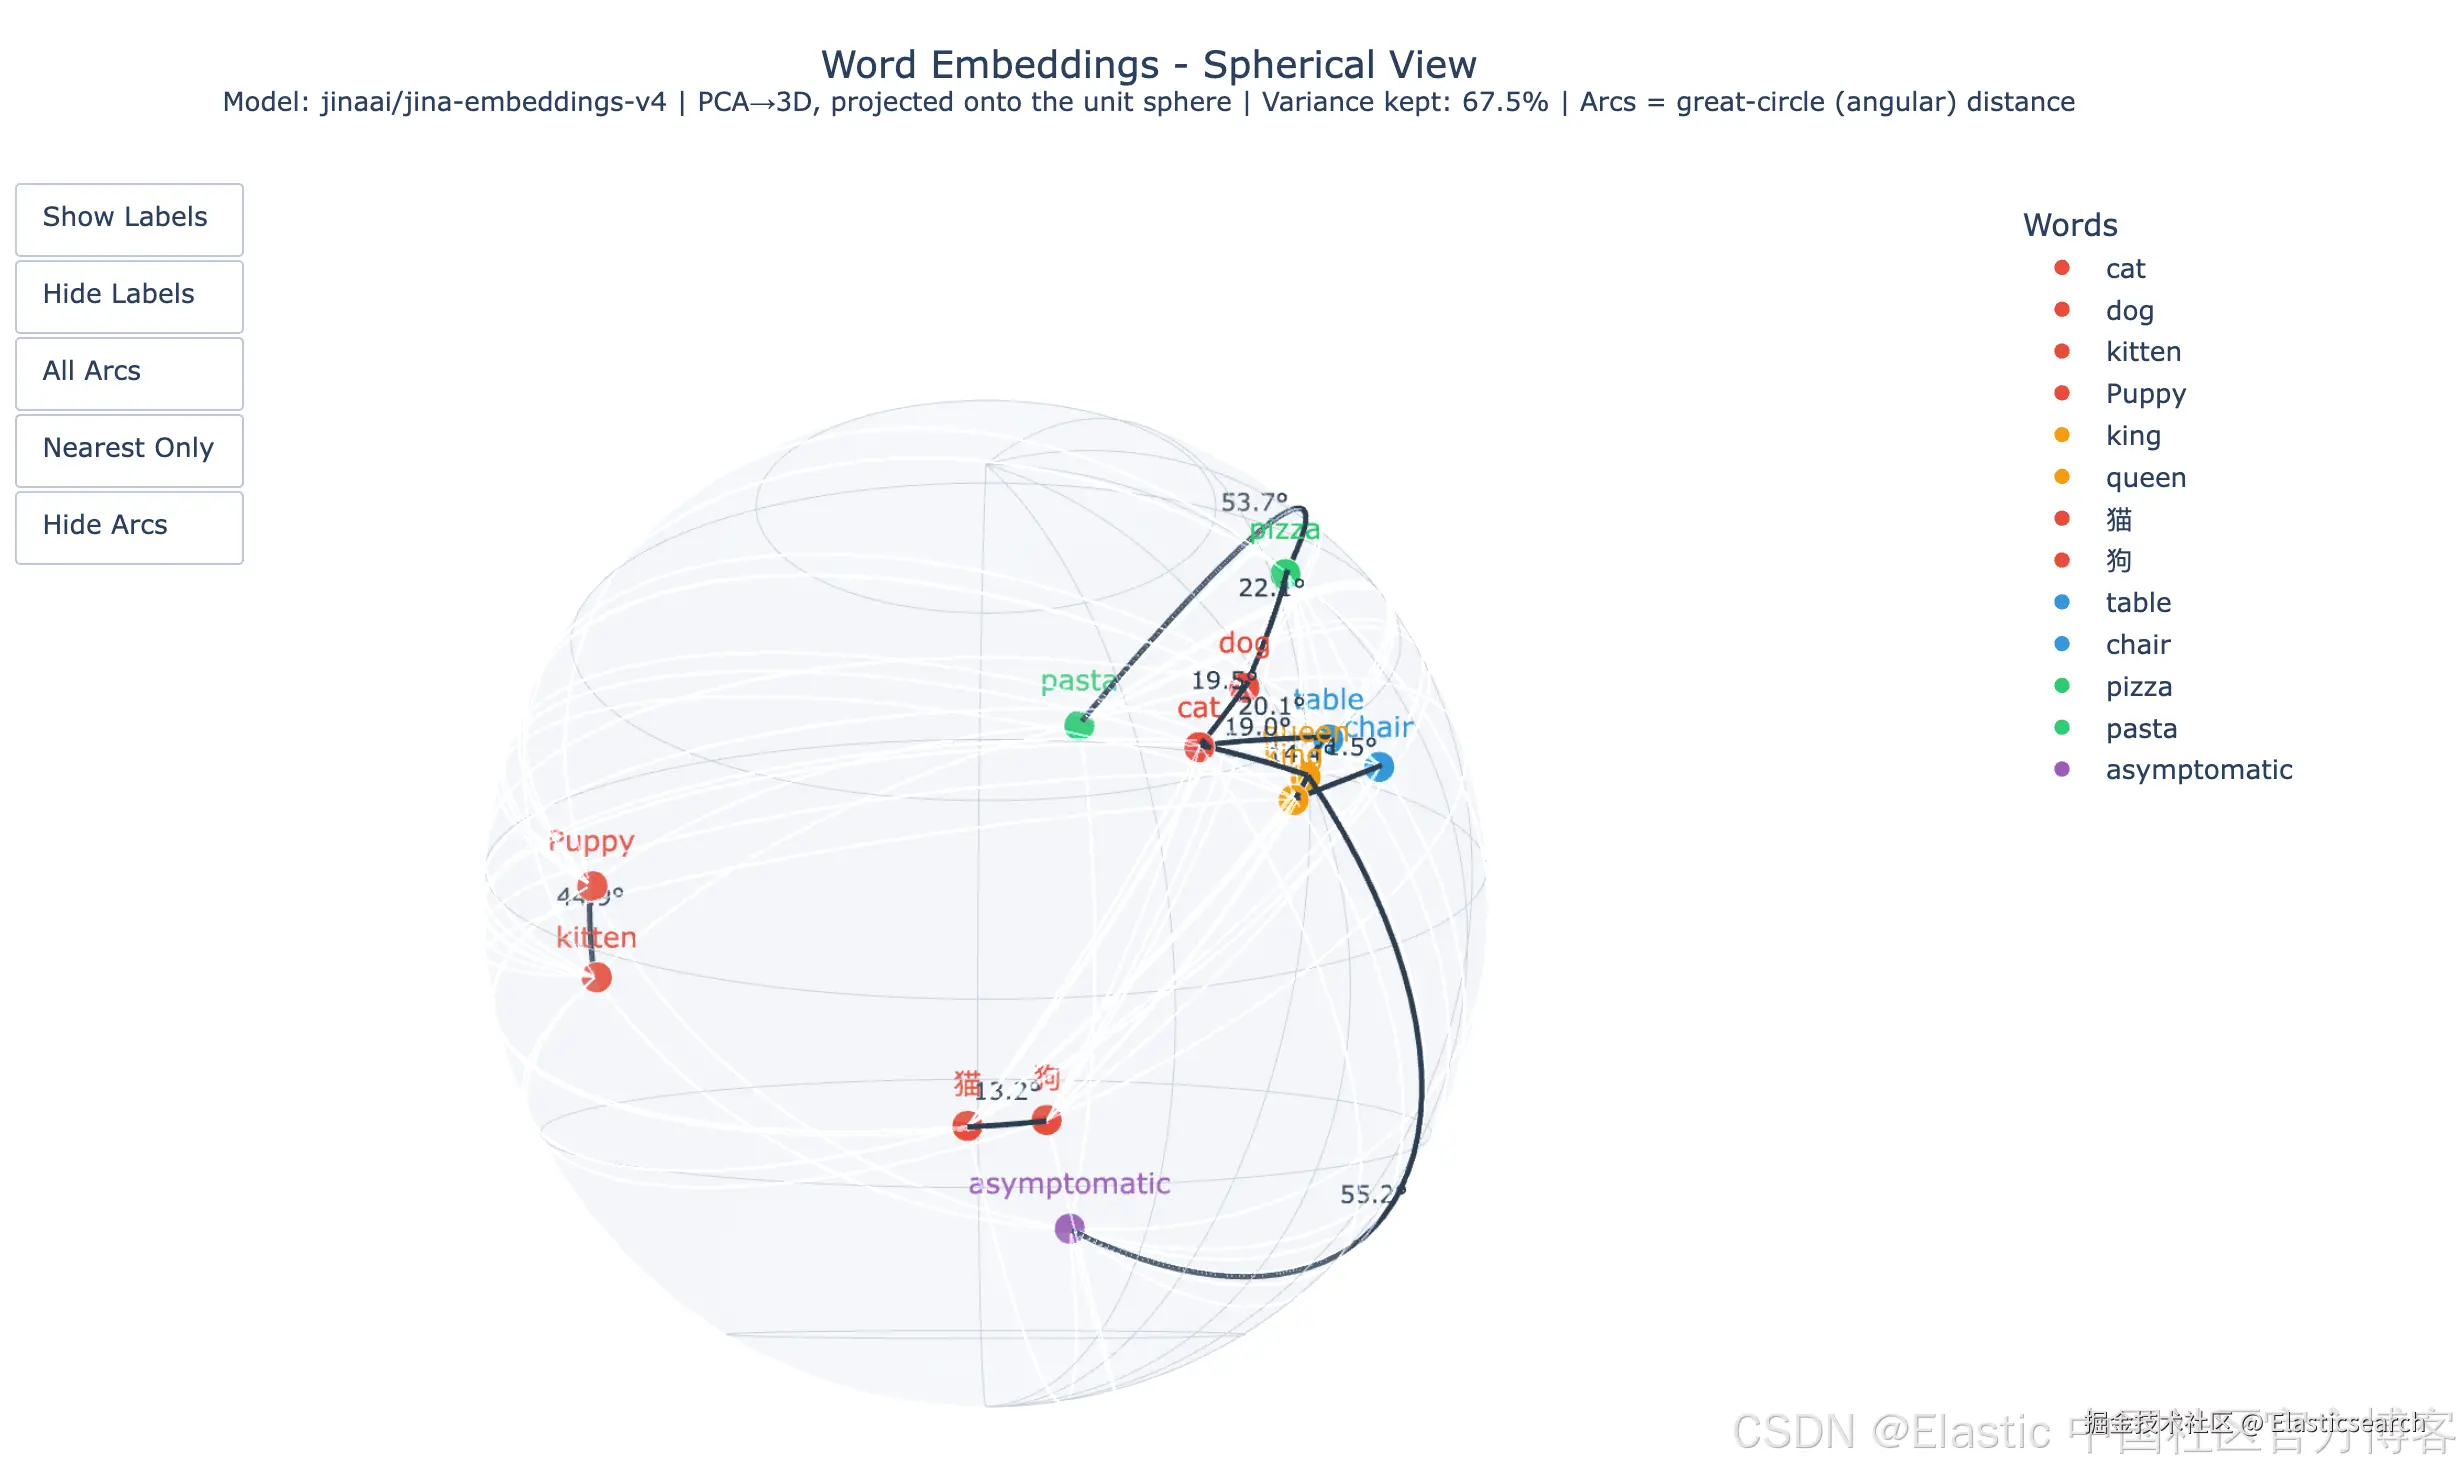
"猫" 和 "狗" 很近,"king" 和 "queen" 很近。"table" 和 "chair" 很近。
总结
- 归一化的 Embedding 本来就在球面上,用球面视角看它比平面散点图更自然;
- 余弦相似度与球面测地线距离是一回事,
arccos(cos_sim)就是夹角; - slerp 可以画出球面上的最短路径,弧线略微放大半径可避免被球体遮挡;
- 同时保留"高维真值"和"3D 所见"两套距离,才能知道这张图有多可信。
希望这个小工具能让你对"向量相近"有更直观的体会。如果你有更好玩的词表,欢迎留言分享。