为什么90%的BI项目难见实效?------开发者视角下的结构性症结
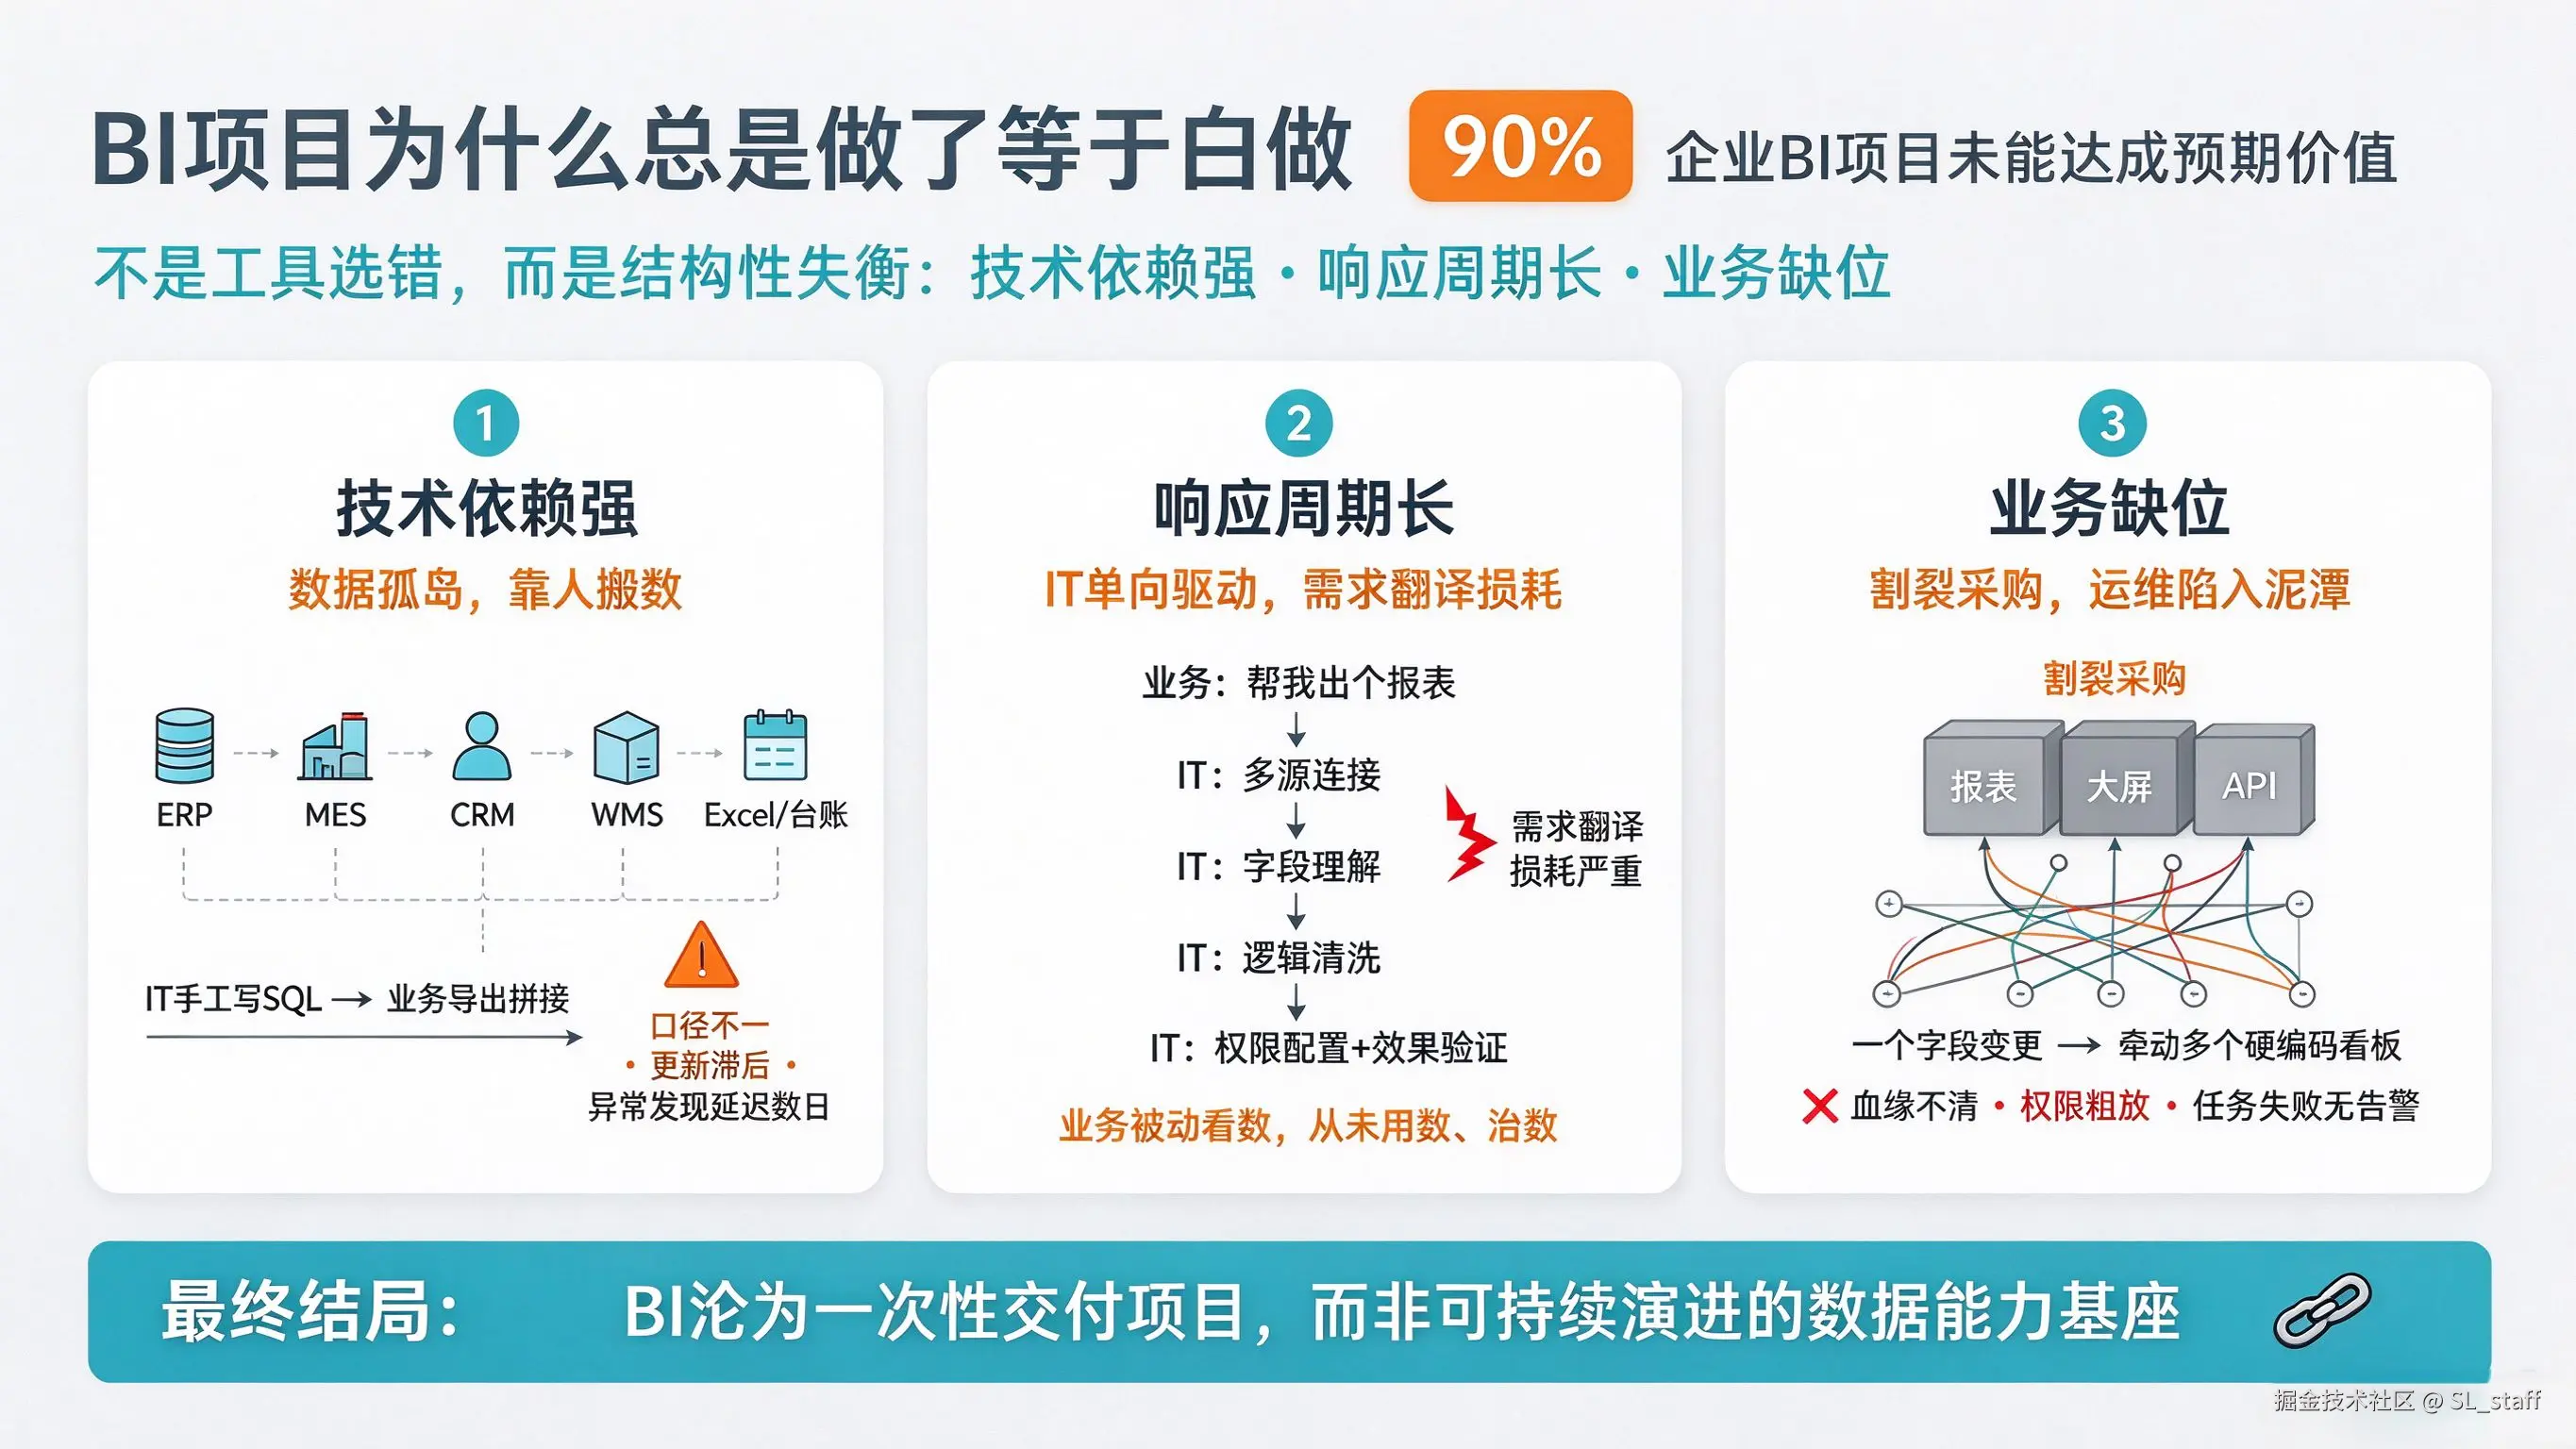
在制造业等典型场景中,ERP、MES、CRM、WMS等系统并存,数据散落于Oracle/MySQL/Doris/达梦等异构数据库、REST API、Excel甚至纸质台账。结果是:
- 数据接入层:IT需手工写SQL或业务反复导出拼接,口径不一、更新滞后、异常发现延迟数日;
- 需求交付链路:业务一句'帮我出个报表',需经历多源连接、字段语义对齐、逻辑清洗、权限配置、效果验证等冗长环节,翻译损耗严重;
- 运维治理困境:报表、大屏、API能力割裂采购,字段变更牵动多个硬编码看板,血缘不清、权限粗放、任务失败无告警。
本质问题不是工具选型,而是架构未解耦、流程未闭环、权责未下沉------BI沦为一次性交付项目,而非可持续演进的数据能力基座。
破局思路:面向落地的三阶数据驱动闭环
跳出'先建平台再推应用'的瀑布式范式,我们主张构建可逐层验证、持续收敛的技术实践路径:
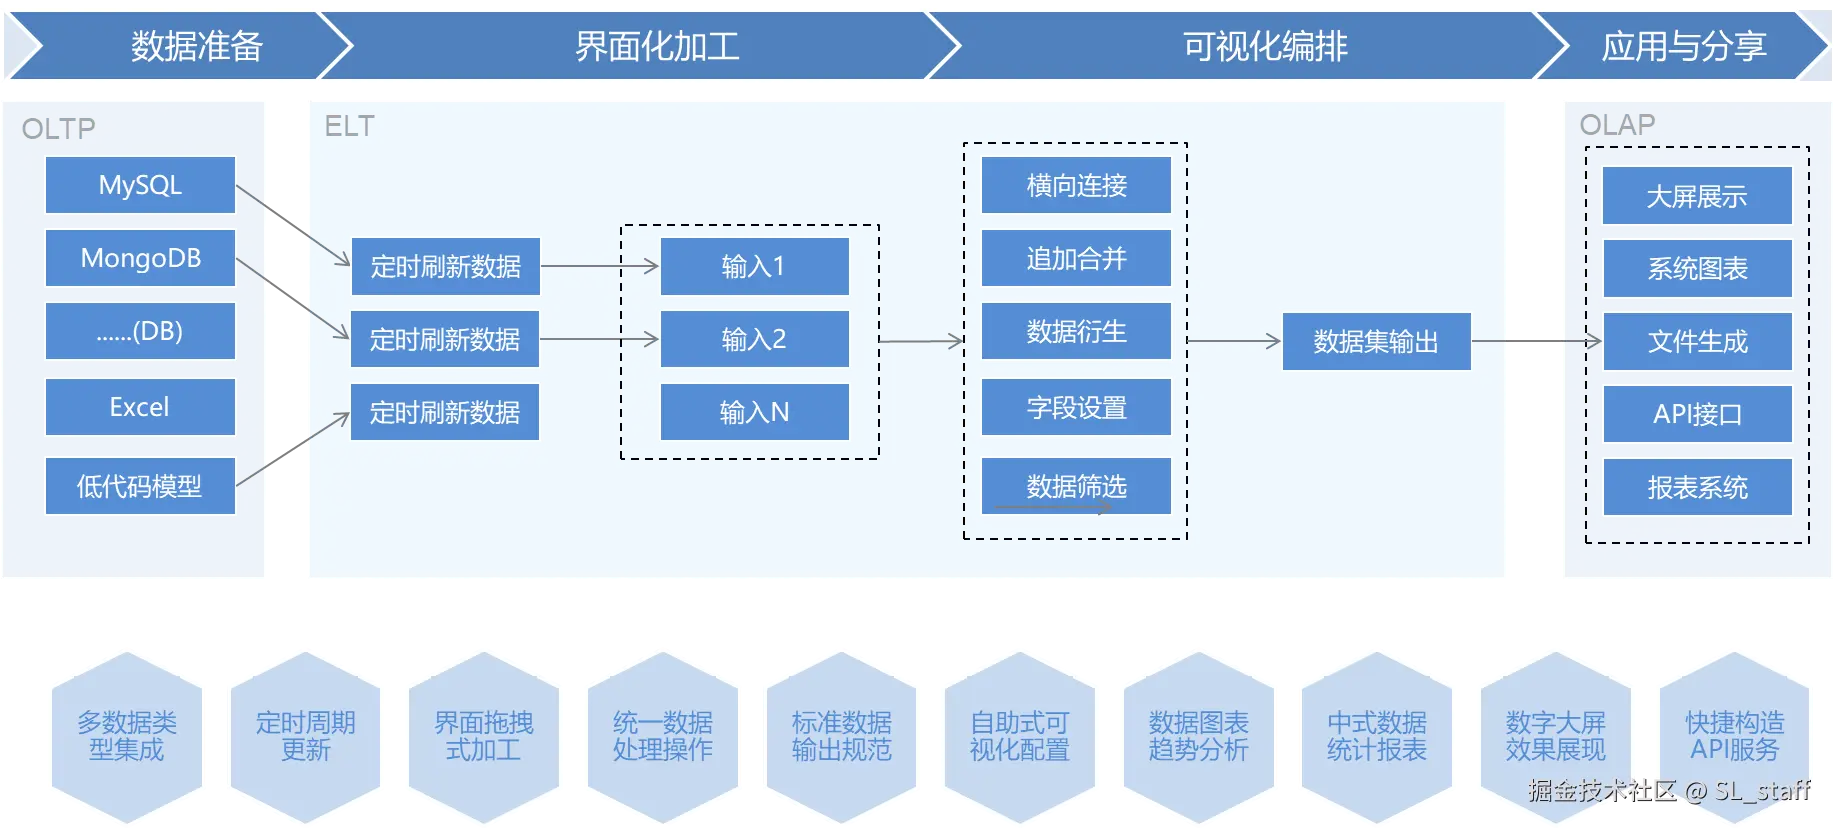
- 第一阶:低成本打通------不强求数据迁移或统一数仓,通过标准化JDBC、Excel解析、HTTP API拉取、IoT消息订阅,兼容Oracle、MySQL、Doris、达梦及主流国产数据库,屏蔽底层差异,让分散数据'能进来';
- 第二阶:低代码赋能------以可视化ELT替代SQL开发:拖拽完成字段选择、条件筛选、分组汇总、同环比计算与实时预览;指标口径在数据集层面统一定义、沉淀复用,降低需求翻译损耗;
- 第三阶:跨系统活用------分析成果不止于展示:图表可嵌入门户/低代码页面,数据集可一键发布为RESTful API,供OA、审批流、生产调度等系统调用。三阶形成闭环:数据进来 → 加工沉淀 → 应用展示 → 服务反哺 → 反馈优化。
六类高频场景闭环验证(含技术实现要点)
该三阶路径已在以下场景完成工程化落地验证:
- 集团经营驾驶舱:融合财务系统(MySQL)、销售平台(API)、项目管理模块(PostgreSQL)与Excel预算表,基于Doris实时物化视图自动计算收入/回款/人效,支持下钻至区域/客户/项目维度;
- 制造生产看板:关联ERP订单(Oracle)、MES工单(JDBC)、WMS库存(API)与设备IoT(MQTT订阅),动态计算OEE、交付风险指数、缺陷率趋势;
- 财务分析报表:统一科目/期间/部门维度,支持交叉报表生成、公式计算(如毛利率=(收入-成本)/收入)、细粒度行级权限控制;
- 园区政务大屏:基于模板化组件与交互配置(非重开发),招商/能耗/办件指标变更仅需调整JSON Schema与数据源映射;
- 低代码应用增强:直连JVS低代码元数据模型,自动生成业务表单统计图表并嵌入流程节点页面,实现'办业务'与'析业务'一体化;
- 数据服务中台轻量化建设:将加工后的标准数据集封装为REST API(OpenAPI 3.0规范),供多个业务系统调用,规避重复取数与口径分歧。
可持续演进:私有化底座 + 开放生态 = 长期可控
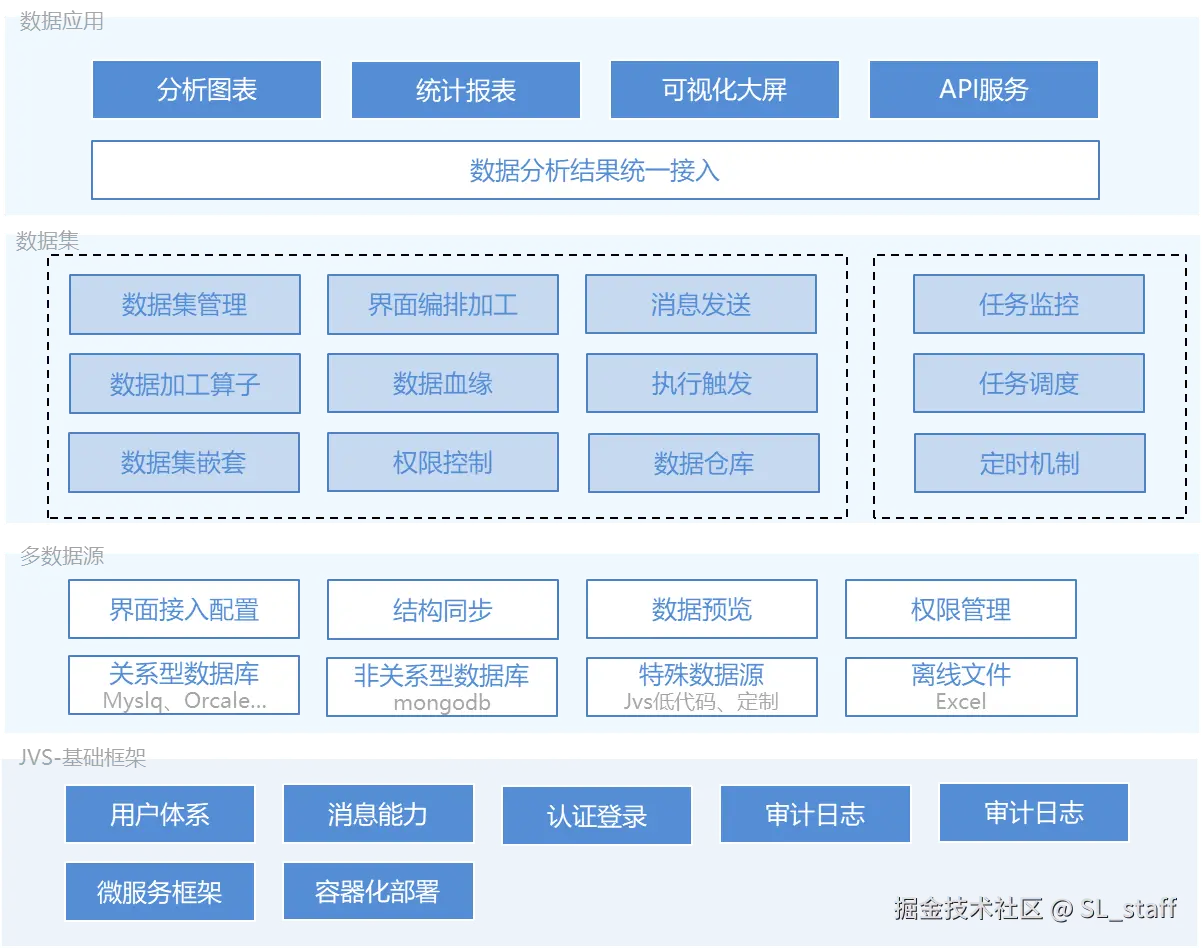
JVS-BI采用私有化部署+开放生态双轨设计:
- 底层基于Doris分布式数仓独立运行,不侵扰生产系统性能,满足政企/制造/能源客户'敏感数据不出域'要求;
- 全栈微服务架构(Spring Cloud Alibaba)+ 源码开放机制,支撑合作伙伴深度二开与行业模板快速交付;
- 天然融合JVS低代码门户、统一认证(OAuth2.0)、RBAC权限体系及业务模型,显著降低集成复杂度;
- 开箱即用治理能力:数据目录(Apache Atlas兼容)、指标口径管理(YAML定义)、自动化血缘追踪(基于SQL解析)、任务日志审计(ELK集成)------为后续自然语言问数、异常智能洞察等AI能力提供可信、可控、可溯的数据根基。
可持续演进,取决于架构底座是否匹配企业数字化节奏。JVS-BI采用私有化部署+开放生态双轨设计:底层基于Doris分布式数仓独立运行,不侵扰生产系统性能,满足政企、制造、能源等客户'敏感数据不出域'的刚性要求;全栈微服务架构与源码开放机制,赋予合作伙伴深度二开能力,支撑行业模板快速交付。更重要的是,其与JVS低代码门户、统一认证、权限体系及业务模型天然融合,显著降低集成复杂度。当前已内置数据目录、指标口径管理、自动化血缘追踪与任务日志审计等治理能力------这些并非未来规划,而是开箱即用的基础模块,为自然语言问数、异常智能洞察等AI能力演进提供了可信、可控、可溯的数据根基。