先说结论:DeepSeek Harness 能用,而且是我这两周试过的本地 agent 里,装完到跑通路径最短的一个。
但它的坑不在功能上,在环境上。我用一台干净的 Ubuntu 22.04 从零装了一遍,踩了两个坑,其中一个会让你以为"软件装坏了"。
下面是从装到用的完整过程。所有数字都是真跑出来的,截图是我在服务器上实际操作时截的。
一、它是个什么东西
一句话:DeepSeek Harness 不是模型,是跑模型的壳。
模型(DeepSeek-V4.1-Flash 之类)负责思考,Harness 负责把这些事接起来:读写文件、执行命令、维护任务计划、管理会话、管权限、管插件。
你可以把它理解成 IDE 里的"驾驶舱":模型是发动机,Harness 是方向盘、油门和仪表盘。换个发动机还能继续开。
几个关键事实:
| 项 | 值 |
|---|---|
| 出处 | DeepSeek AI 官方开源 |
| 协议 | MIT |
| 语言 | TypeScript |
| 版本 | 0.2.1-rc.5(预览版,官方明确说会有破坏性变更) |
| 架构 | everything-is-a-plugin,底层是 Cordis |
| 关注度 | 27 万 star 左右 |
那个"everything is a plugin"不是宣传语。它的模型提供商、工具、终端、UI 面板、甚至定时任务,全都是插件。这也是为什么它的插件页看起来像应用商店,而不是一个开关列表。
二、装之前:Node 版本这关必须过
官方 README 只写了一句"Install Node.js"。这句话害人。
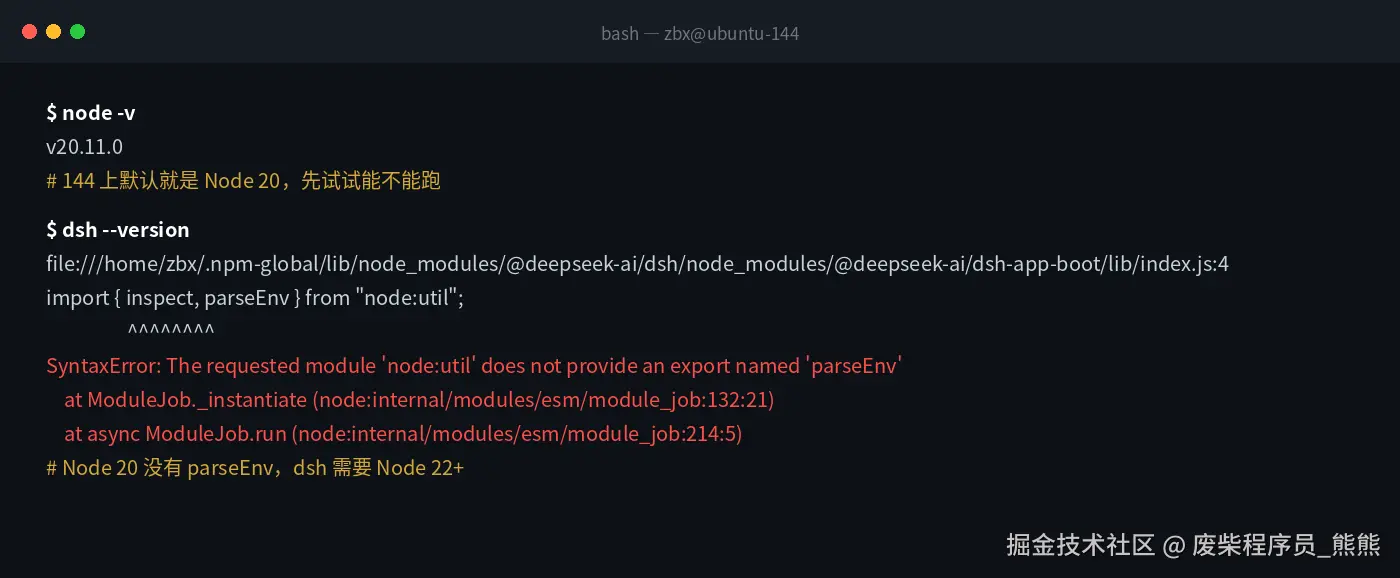
我用的机器上 node -v 是 v20.11.0,看着挺新,直接跑就炸:
javascript
SyntaxError: The requested module 'node:util' does not provide an export named 'parseEnv'node:util 的 parseEnv 是 Node 22 才有的。所以:
dsh 需要 Node 22 或更高。Node 20 会装得上、但一跑就报错,报错信息还完全看不出来是版本问题。
这一步我用 nvm 切到 24 就好了。如果你的机器上还挂着别的项目,建议别改全局 node,用 nvm 按目录切:
bash
nvm install 24
nvm use 24
node -v          # v24.18.0
三、装:两种方式
方式 A:直接 npx(想先试试)
bash
npx @deepseek-ai/dsh web不落地、不污染全局,适合"我就看看长什么样"。
方式 B:全局装(要长期用)
bash
npm install -g @deepseek-ai/dsh@0.2.1-rc.5但我第一次这么装完,少了编译产物。原因是 npm 11 改了默认策略:安装脚本(install script)默认被拦截,只打一行 warning 就继续装完了。
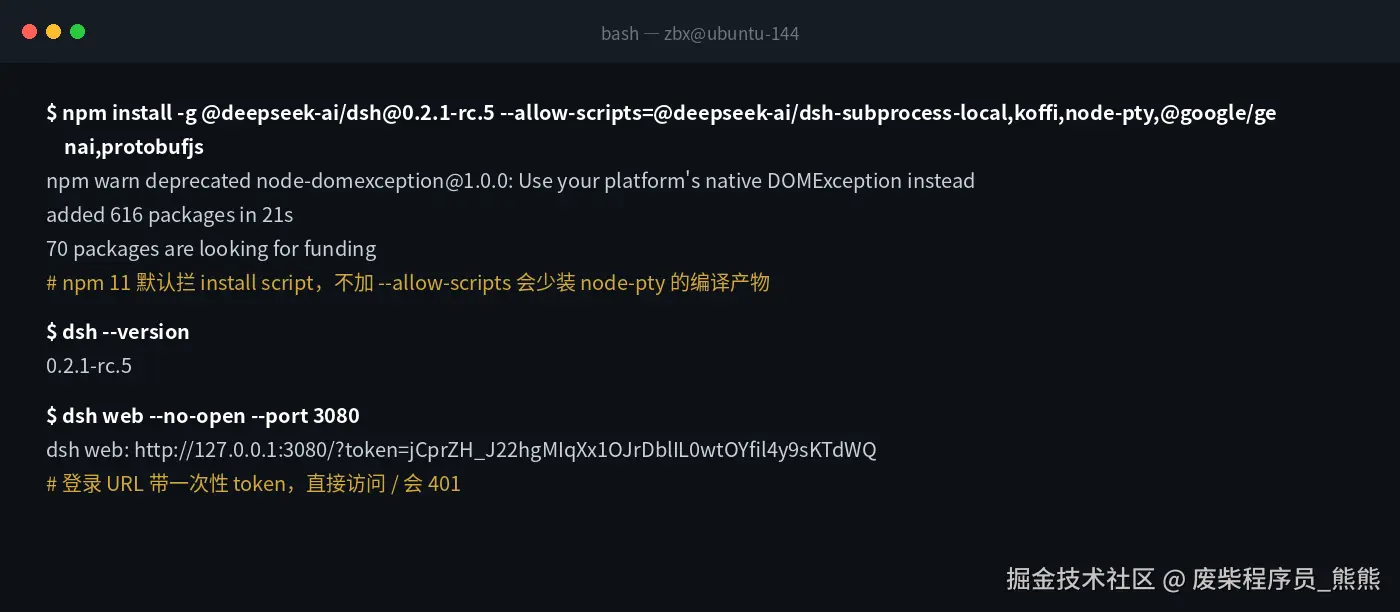
被拦的里面有 node-pty(终端模拟)、koffi(本机调用)这类要编译原生模块的包。表现就是:软件"装好了",但终端功能是空的。
正确的装法是把这几个包显式放行:
bash
npm install -g @deepseek-ai/dsh@0.2.1-rc.5 \
  --allow-scripts=@deepseek-ai/dsh-subprocess-local,koffi,node-pty,@google/genai,protobufjs
装完 616 个包,21 秒。确认版本:
bash
dsh --version # 0.2.1-rc.5这两个坑(Node 版本、install script)都属于"装得上但跑不对",而且都不在 README 里。记一下能省一小时。
四、启动:那个 token 不是多余的
bash
dsh web --no-open --port 3080启动只输出一行:
ini
dsh web: http://127.0.0.1:3080/?token=jCprZH_J22hgMIqXx1OJrDblIL0wtOYfil4y9sKTdWQ--no-open 是给服务器用的(没有浏览器可开)。默认会尝试打开本机浏览器。
这个 token 别跳过。 我实测了三种访问方式:
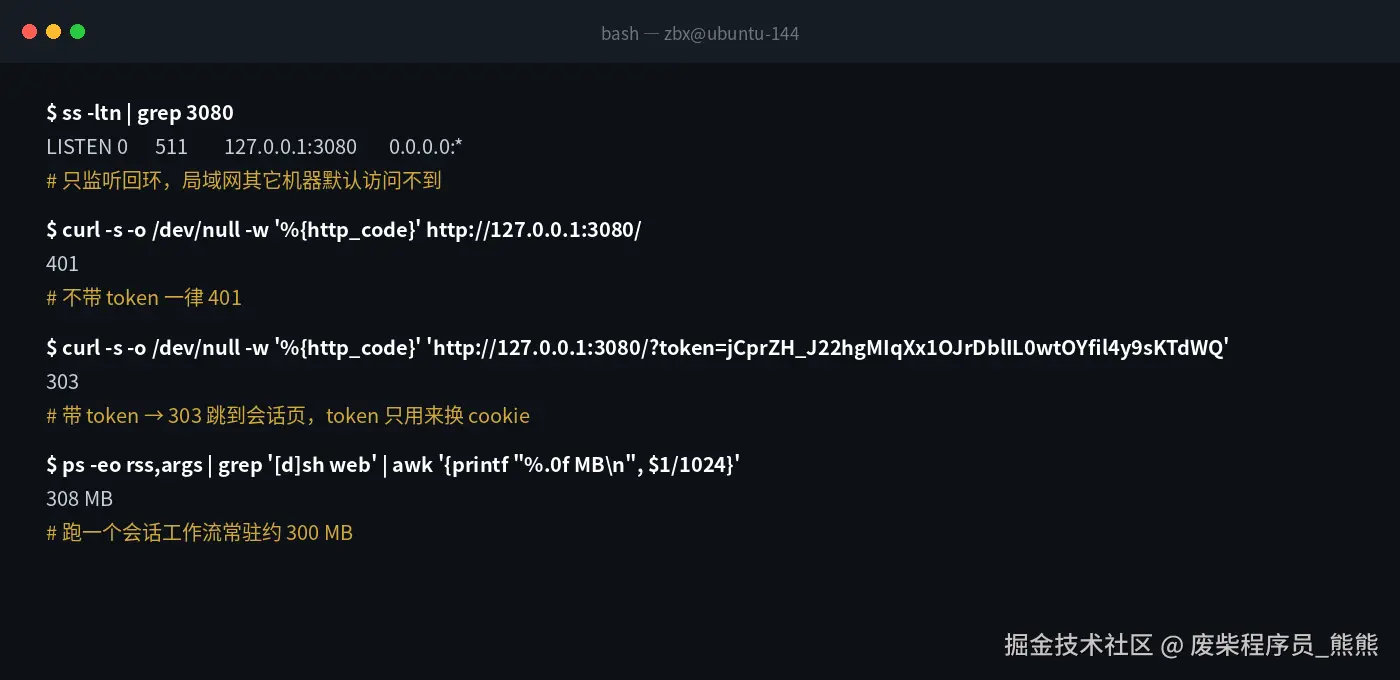
| 请求 | 结果 |
|---|---|
直接访问 127.0.0.1:3080/ |
401 |
带上 ?token=... |
303 跳转到会话页 |
| 端口监听范围 | 只有 127.0.0.1:3080 |
两层防护:只监听回环地址(局域网其他机器访问不到),再加上一次性 token 换 cookie。
所以如果你打算在服务器上用它、然后从自己电脑访问,正确姿势是 SSH 端口转发,不是把服务开到 0.0.0.0:
bash
ssh -N -L 3080:127.0.0.1:3080 user@your-server
# 然后本机浏览器打开服务器打出来的那个带 token 的地址
这点比很多同类工具做得好。我见过默认 0.0.0.0:8080 且无鉴权的 agent 面板,那才是真危险。
常驻内存实测:308 MB。
五、配模型:Key 是只写的
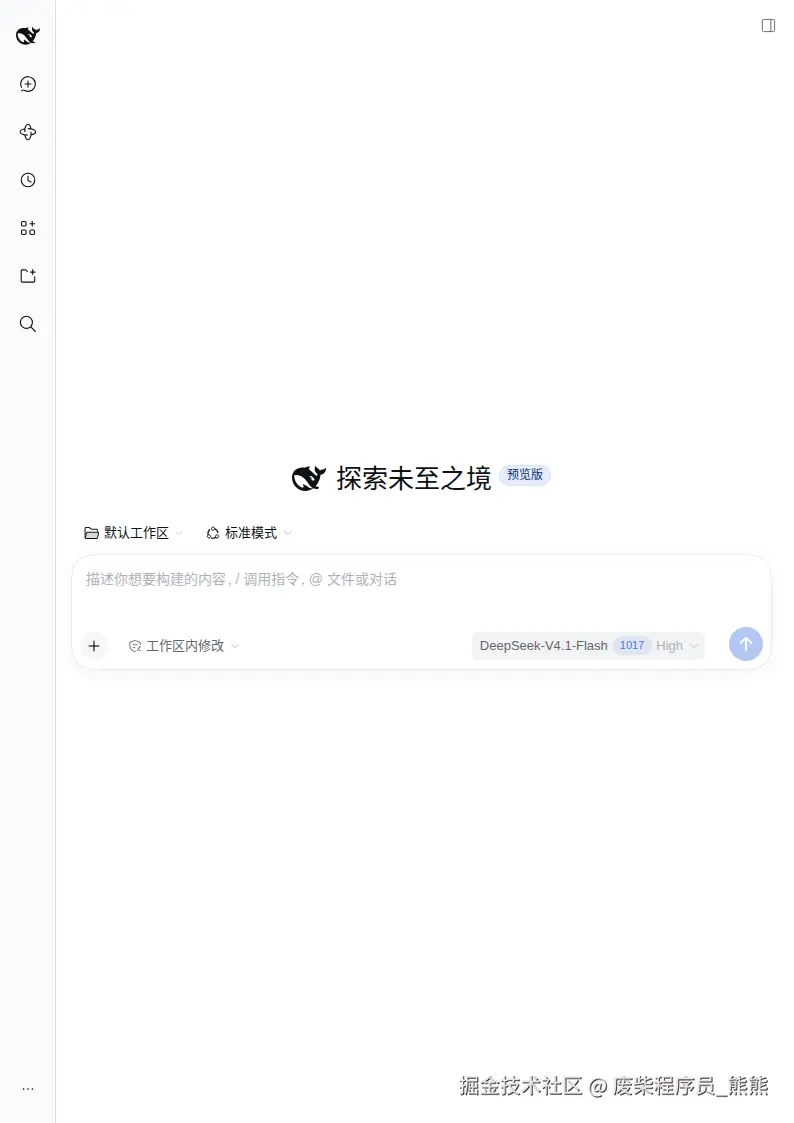
打开那个带 token 的地址,第一次进来会让你选模型。有两种入口:
- 登录 DeepSeek 账号
- 填 API Key(我选的这个)
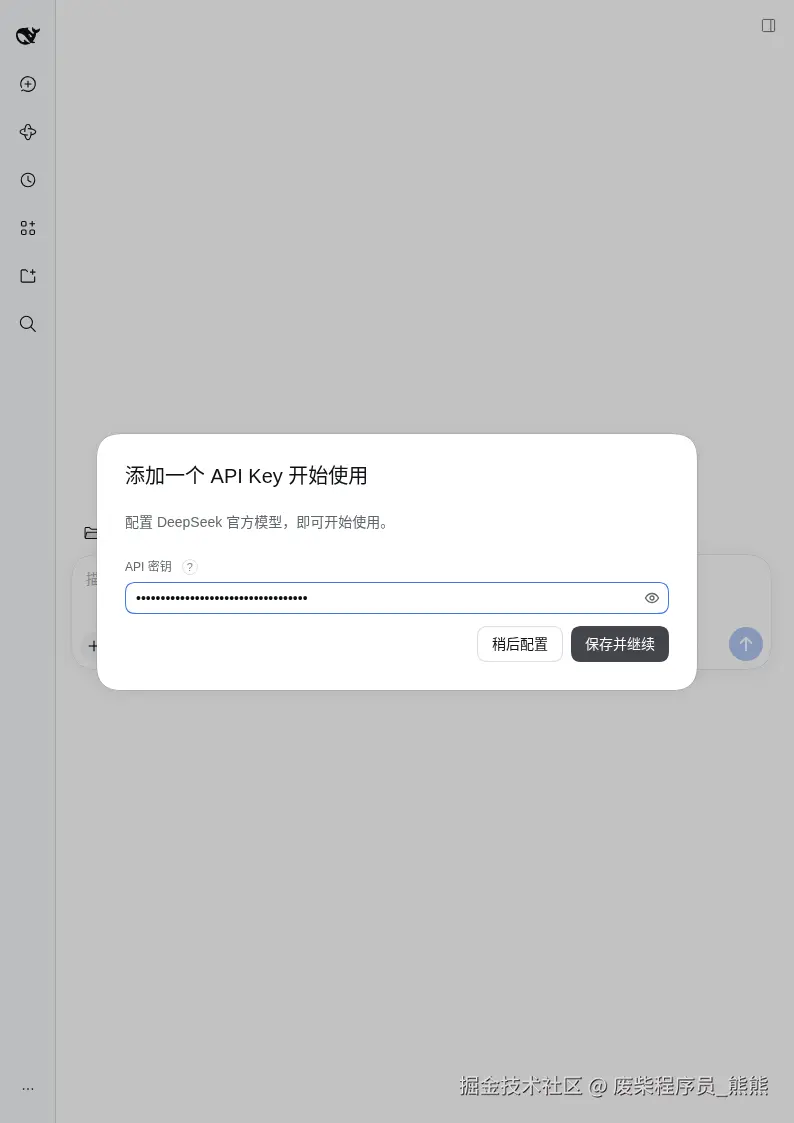
填完保存,模型选择器里直接出现 DeepSeek-V4.1-Flash,不需要重启服务。
有个细节值得单独说:Key 是只写的。保存之后,设置页再打开这个输入框是空的,只显示"留空使用已保存凭据"。页面自始至终拿不到明文 Key。
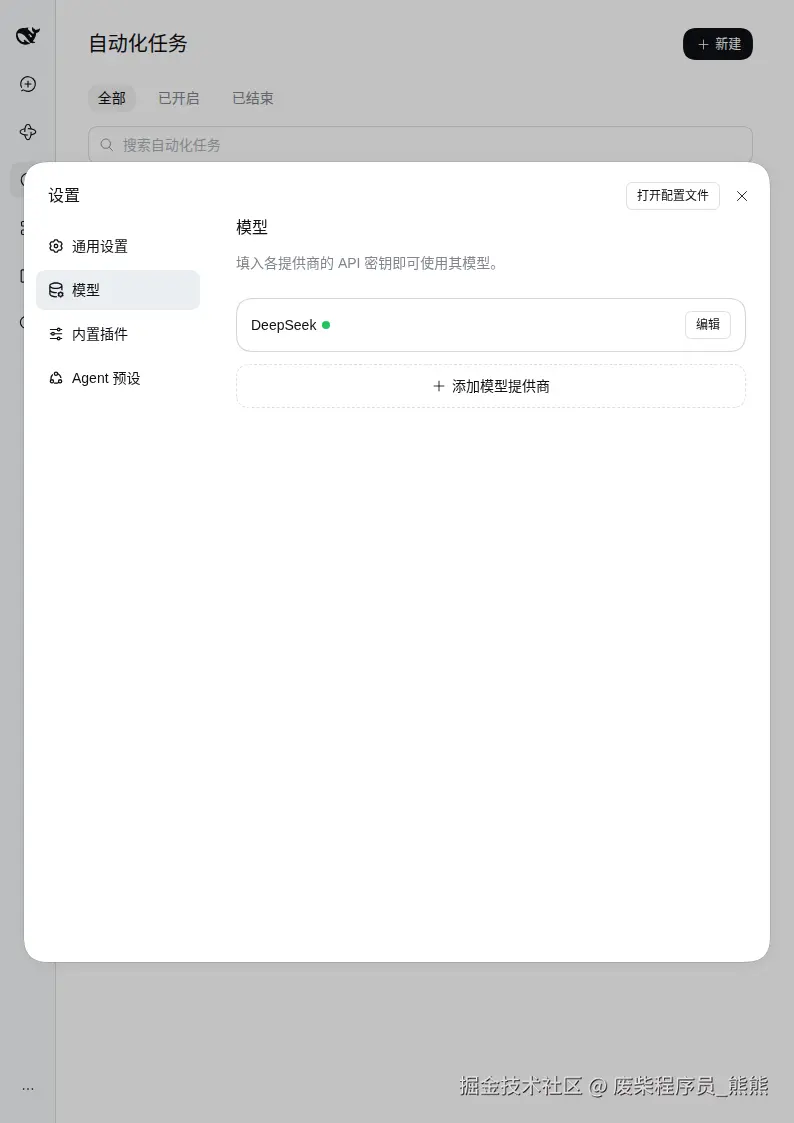
Key 实际落在 $DSH_HOME/.credentials.yaml(权限 600),设置文件里只存一个引用。这个设计比"把 Key 明文写进 config.json 再回显给前端"要正经得多。
要接第三方(OpenAI 兼容网关、公司内部网关、自建 vLLM)就走 添加模型提供商 → 自定义模型 API:填 Provider ID、base URL、协议(OpenAI Chat Completions / Responses / Anthropic Messages 三选一)、Key,然后可以"获取可用模型列表"让端点自己报。Provider ID 建完不能改,注意别手滑。
六、工作区:它到底在哪个目录里干活
这一步容易懵。
dsh 的默认工作区不是"启动它的目录",而是:
javascript
~/Documents/deepseek-harness/default-workspace我第一次让它写代码,写完在 ~/dsh-demo 里找了半天没找到,find 才发现文件全在 Documents 下面。
想换目录:点输入框上方的「默认工作区」→ 添加工作区 → 选目录。之后所有会话都可以指到这个目录。
这个设计其实合理:工作区是一个独立概念,跟服务从哪启动无关,多项目时更清楚。只是第一次用要适应。
七、先认识三个视图,再派活
在给它派活之前,界面上有三个东西值得先认识,它们决定了这套工具好不好用:
① 轨迹视图。 会话页顶部有「对话 / 轨迹」两个标签。对话看的是人话,轨迹看的是每一步工具调用的原始参数和返回。排查「它到底把这个文件改成什么样了」时,轨迹比对话有用得多。
② 本轮改动。 回答下面会列出这次会话改了哪些文件,点开就是 diff,带增删行数。我那次跑完显示「已编辑 5 个文件 +678」,每个文件都能单独看。
③ 分支。 每条回答下面有「在新对话中分支」------从这句话往回把上下文复制成一个新会话,你可以换一种问法重来,不污染原来那轮的记录。
这三个合起来解决一个老问题:agent 干完活,你怎么确认它没干坏事。 光靠它自己说「已完成」是不够的。
八、实战:让它写一个真工具
我不喜欢用"写个贪吃蛇"来演示 agent。所以给了一个有验收标准的活:
在这个工作区写一个把 Markdown 表格转成 CSV 的命令行工具,要有参数校验和 3 个测试用例,跑通给我看结果。
它跑起来是这样的
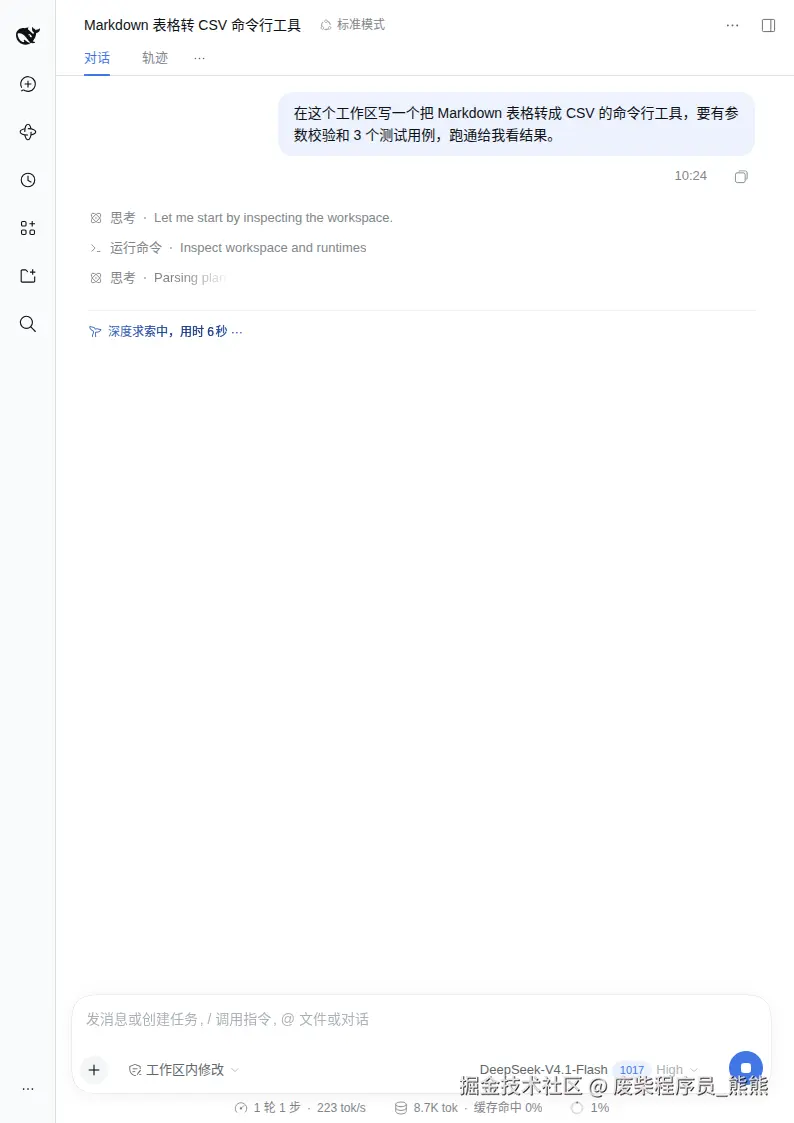
界面把过程拆成"思考 / 运行命令 / 写入 / 编辑"几类步骤,可以点开看每一次工具调用的参数和结果。这点很关键:你能看见它为什么这么做,而不是只看最后一句"完成了"。
中间有一段自问自答值得抄下来:
Bug: normalize rows uses width from selected0 only. If multiple tables with different widths, using first table's width would truncate/pad all tables incorrectly. Better compute width per table... Fix: for each table, width = table.header.length.
它写完第一版,自己发现"多个表格宽度不同时会用错宽度",然后回头改了。这个 bug 是真的:它自己写的 selected[0] 假设只有一个表。
结果
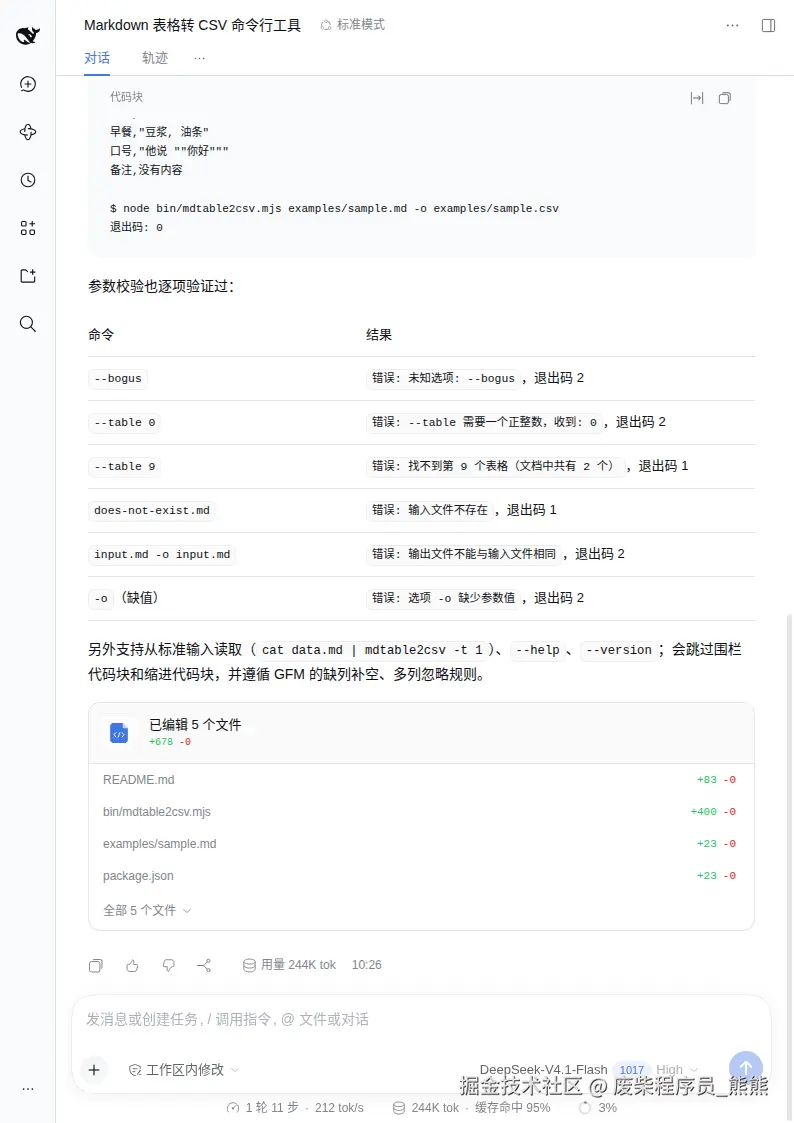
| 指标 | 实测 |
|---|---|
| 轮次 / 步数 | 1 轮 11 步 |
| 产出文件 | 5 个 |
| 代码变更 | +678 行 |
| 消耗 | 244K token ,缓存命中 95% |
| 速度 | 212 tok/s |
产出的东西是能跑的,我单独验证过:
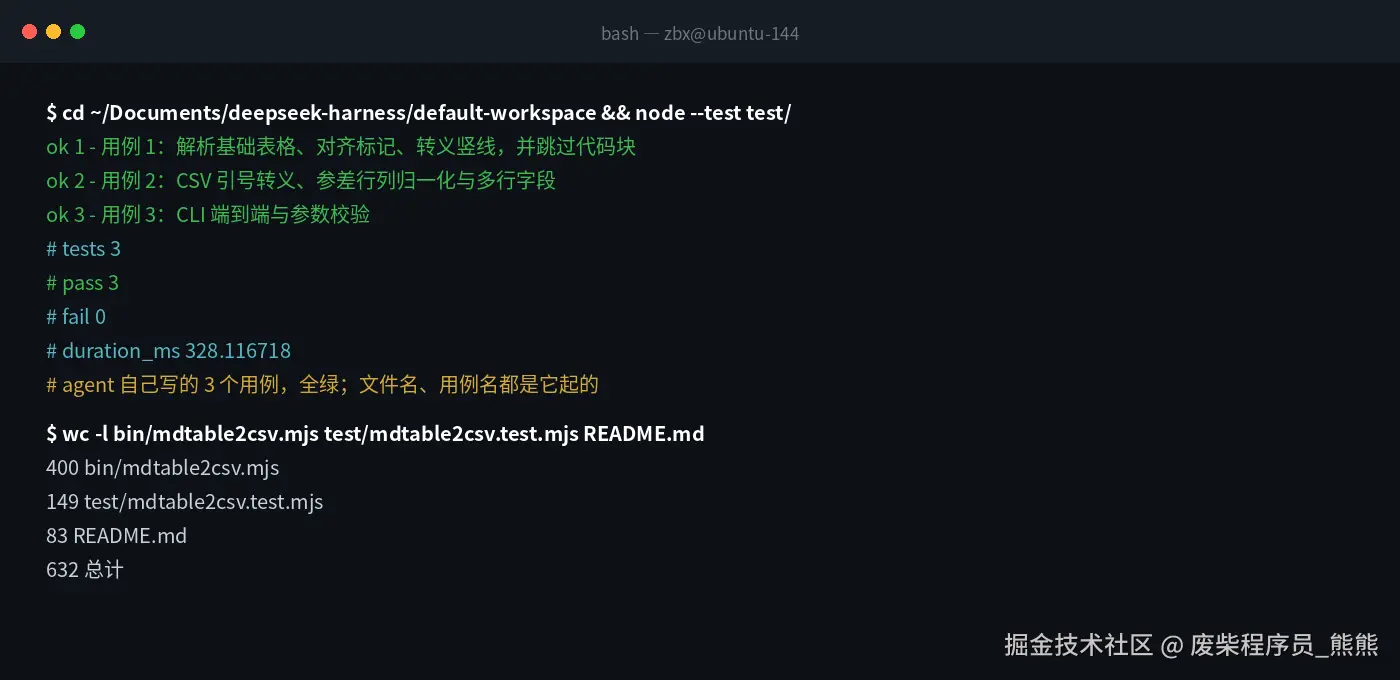
bin/mdtable2csv.mjs:400 行,零依赖test/mdtable2csv.test.mjs:149 行,3 个用例README.md:83 行- 合计 632 行,测试耗时 328 ms
它还自己做了参数校验矩阵:
| 输入 | 它的处理 |
|---|---|
--bogus |
未知选项: --bogus,退出码 2 |
--table 0 |
--table 需要一个正整数,退出码 2 |
--table 9 |
找不到第 9 个表格(文档中共有 2 个),退出码 1 |
does-not-exist.md |
输入文件不存在,退出码 1 |
input.md -o input.md |
输出文件不能与输入文件相同,退出码 2 |
CSV 转义也是对的:
csv
姓名,年龄,城市
张三,30,北京
李四 | 小李,25,上海
项目,说明
早餐,"豆浆, 油条"
口号,"他说 ""你好"""
含逗号的字段加引号,含引号的用双写转义。这些是 GFM 表格转 CSV 最容易写错的地方,它没漏。
一句话评价:这活儿相当于给一个中级工程师两小时,它用了不到两分钟,产出质量相当。
九、权限:默认不让你出圈
输入框左下角有个「访问模式」,默认是 工作区内修改。
这个默认值很关键。意思是:它读写文件、跑命令,都限制在当前工作区里,动系统目录会要求你确认。
三种常见模式的区别:
| 模式 | 行为 | 什么时候用 |
|---|---|---|
| 只读 | 只能看,不能改 | 读代码、做分析 |
| 工作区内修改(默认) | 工作区内自由改,出圈要批准 | 日常开发 |
| 完全放行 | 不拦 | 只在你完全信任任务边界时 |
我在一台一次性机器上跑,也保留了默认设置。建议你也不要在有生产凭据的机器上开完全放行,agent 的一次误删比你想的容易。
十、插件系统:这才是它跟别人不一样的地方
插件页分成两块:内置插件配置 + 实验性插件。
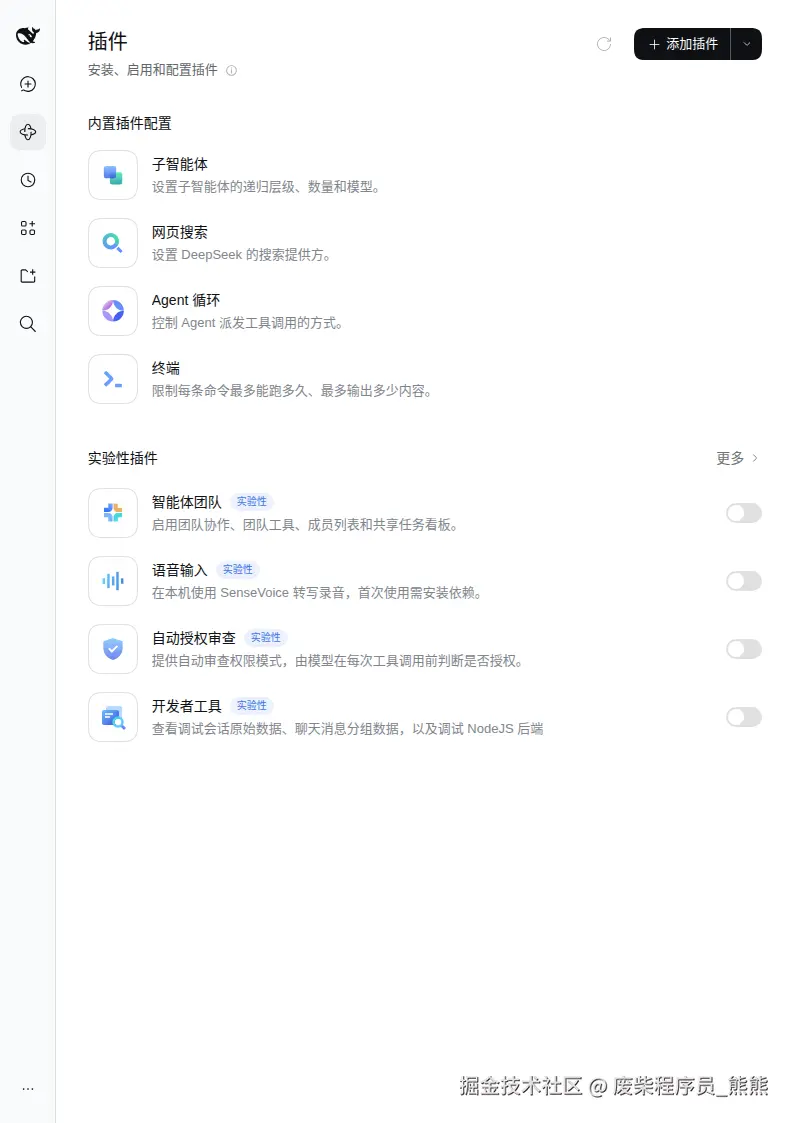
内置可配的四个:
- 子智能体:递归层级、数量上限、每个子智能体用哪个模型
- 网页搜索:配 DeepSeek 的搜索提供方
- Agent 循环:控制 Agent 怎么派发工具调用
- 终端 :单条命令最长跑多久、最多输出多少(防止
cat一个 10 G 日志把会话撑爆)
实验性的四个:
| 插件 | 作用 |
|---|---|
| 智能体团队 | 团队协作、成员列表、共享任务看板 |
| 语音输入 | 本机 SenseVoice 转写,首次要装依赖 |
| 自动授权审查 | 每次工具调用前让模型判断该不该授权 |
| 开发者工具 | 看调试会话原始数据、消息分组、调试 Node 后端 |
第三方插件走 npm 或 Git,装完就是新的工具/面板/模型提供商。这也意味着装插件等于给 agent 加权限,来源要看清楚。
MCP 也支持,走 --patch 挂一个 overlay:
bash
dsh web --patch ./mcp-memory.yml挂上来的工具在会话里叫 mcp__<服务名>__<工具名>。官方给了三个记忆系统的现成配置(Memorix、MCP Reference Memory、Engram),都是默认关闭的。
十一、定时任务:不用另装 cron
这是我没想到的功能。它在 Agent 里直接提供了四个工具:schedule_create / schedule_list / schedule_view / schedule_edit。
意思是你直接跟它说:
每天早上 9 点提醒我看昨天的部署结果
它会建一个带 RFC 5545 重复规则的任务,到点把指令投递到一个会话里(可以复用同一个会话,也可以每次新建一个)。
任务页能看到下次运行时间、频率、每次投递的记录,也能手动 Run now、暂停、删除。
注意一个限制:每次投递之间至少间隔 1 分钟(每次新建会话的那种任务,按 Host 的最小运行间隔算,默认 1 分钟)。所以别指望用它做秒级轮询。
比 crontab 好在哪:投递的是"自然语言指令",不是 shell 命令;失败能看见会话里的完整过程,不用去翻日志。
十二、数据在哪,怎么备份
所有东西都在 $DSH_HOME,默认 ~/.dsh:
bash
~/.dsh/
├── .credentials.yaml        # API Key(600)
├── .anonymous-user-id
├── profiles/                # 每个 profile 的配置层
│   └── web/cordis.patch.yml # 你在设置里改的东西最终落这里
├── sessions/                # 会话记录
└── storages/                # 会话产物
装完 + 跑完一个会话,整个目录 187 KB。备份就是复制这个目录,迁移就是拷到新机器的同名路径。
要改配置又不想点 UI?直接编 ~/.dsh/profiles/web/cordis.patch.yml,改完下一次请求就生效,不用重启。
配置文件长这样(省略)------本质是一个有序的插件补丁层列表,你的覆盖在最后。这也是为什么它能做到"改一行配置换模型提供商"。
十三、CLI 模式:headless 4 秒干完一件事
Web UI 只是其中一个 profile。命令行还有:
bash
dsh web                                  # Web UI(默认)
dsh tui                                  # 终端 UI
dsh headless "run the tests"             # 跑一个任务,打印结果就退出
dsh --profile web --help                 # 看当前 profile 支持的所有参数
dsh --dump-config                        # 打印合成后的完整配置树
dsh --patch ./extra.yml                  # 叠加一个补丁层(可重复)
dsh headless 是里面最实用的:塞进 CI 里,一句 prompt 干一件事,退出。不起服务、不开浏览器。
我拿它跑了一次真实任务:
bash
dsh headless "统计当前工作区每个文件的行数,按行数从多到少排序,只输出结果"结果------先报了一个错:
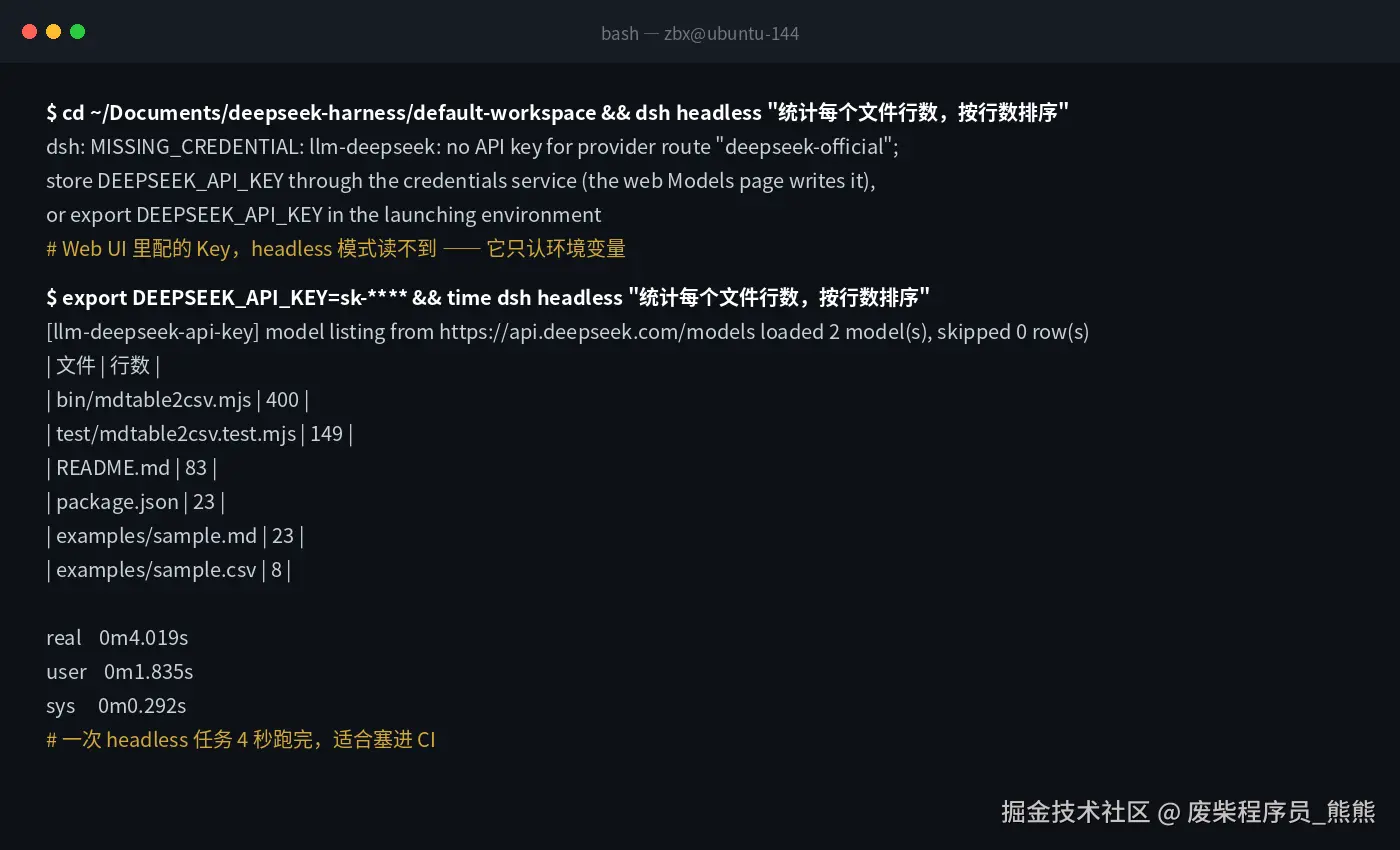
vbnet
dsh: MISSING_CREDENTIAL: llm-deepseek: no API key for provider route "deepseek-official";
store DEEPSEEK_API_KEY through the credentials service (the web Models page writes it),
or export DEEPSEEK_API_KEY in the launching environment这是这篇最值得记的坑:你在 Web UI 里配好的 Key,headless 模式读不到。
两个入口存的位置不一样:Web 界面写的是 ~/.dsh/.credentials.yaml,headless 只认启动环境里的 DEEPSEEK_API_KEY。同一个工具、同一个配置目录,凭据这条路却没打通。
所以脚本里要这么写:
bash
export DEEPSEEK_API_KEY="sk-..."
dsh headless "统计每个文件行数,按行数排序"
补上环境变量之后,同一个任务 4.019 秒跑完,输出直接是结果表:
bash
| 文件 | 行数 |
| bin/mdtable2csv.mjs | 400 |
| test/mdtable2csv.test.mjs | 149 |
| README.md | 83 |
| package.json | 23 |
| examples/sample.md | 23 |
| examples/sample.csv | 8 |
4 秒里包含了读文件、跑命令、生成答案、退出全过程。这个速度适合做成 Git pre-commit 的一步,或者 CI 里的一个校验环节。
提醒一句:脚本里别硬编码 Key。用 CI 的 secret,或者
pass/ 1Password CLI 注入。
--dump-config 也值得记:配置不生效时先看它到底合成了什么,比翻文档猜快得多。
十四、三个进阶配置,值得提前知道
① 子智能体:把活儿分出去
插件页第一项就是「子智能体」,能配三样:递归层级 、数量上限 、每个子智能体用哪个模型。
这是省钱的关键。一个典型配法:
| 角色 | 模型 | 理由 |
|---|---|---|
| 主 Agent | 强推理模型 | 拆任务、做决策 |
| 子智能体 | 便宜快的模型 | 读文件、跑命令、批量重命名这类活 |
主 Agent 派一个子智能体去"把这个目录下 200 个文件的头部注释抽出来",这种活不需要强模型。层级别开太深,两层够用;开三层以上你会看到 token 消耗呈指数级上去,因为每层都要带上下文。
② MCP:挂第三方能力
MCP 不用装插件,用 --patch 挂一个 overlay 文件:
bash
dsh web --patch ./my-mcp.cordis.yml挂上来的工具在会话里叫 mcp__<服务名>__<工具名>,模型自己能看见、能调用。
官方仓库里给了三个现成的记忆系统配置(Memorix、MCP Reference Memory、Engram),默认全是关的------因为这三个都是第三方服务,官方明确说"提供只是互操作性示例,不代表推荐或支持"。这句话要当真:挂 MCP 等于把数据交给那个服务。
想长期生效,别每次带 --patch,把 overlay 里那一段并进 ~/.dsh/profiles/web/cordis.patch.yml。注意是合并不是覆盖------那个文件里可能已经有你自己改的东西。
③ 自定义模型提供商:接自己公司的网关
设置 → 模型 → 添加模型提供商 → 自定义模型 API。要填:
- Provider ID(小写,建完不能改,请求、会话记录、凭据引用都用它)
- Display name(可改)
- Base URL
- API 协议:OpenAI Chat Completions / OpenAI Responses / Anthropic Messages,三选一
- API Key
- 至少一个模型
协议这点要注意:一个 provider 只能说一种协议。如果你的网关同时支持 OpenAI 和 Anthropic 两种格式,得建两个 provider,不能在一个里面混。
填完可以点「获取可用模型」让端点自己上报模型列表。不过官方文档自己也说了,这只是"便利功能",不是保证------很多网关的 /models 返回格式不标准,抓不到就手填,效果一样。
十五、该不该用:我的判断
适合你的情况:
- 想要一个本地跑、数据不出机器的 agent(会话、文件、Key 全在本地)
- 手上已有 DeepSeek API Key,不想再买订阅
- 喜欢看"它为什么这么做",而不是只要最终答案
- 需要定时任务、子智能体、MCP 这些能力,但不想自己拼
不太适合:
- 生产环境。它自己标了预览版,官方明确说会有破坏性变更。 用来干活可以,用来托付关键流程不行
- 团队协作刚需。多人权限、审计这些还没成型
- 完全不想碰命令行的人。装和配都还是要敲命令的
跟同类比,它的差异点不在模型(模型大家都能接),在插件化的彻底程度 和权限默认值。前者决定了它半年后能长成什么样,后者决定了你今天敢不敢让它碰你的目录。
十六、六个坑速查
| 现象 | 原因 | 解法 |
|---|---|---|
一跑就 parseEnv 报错 |
Node < 22 | nvm install 24 && nvm use 24 |
| 装完终端功能是空的 | npm 11 拦了 install script | 加 --allow-scripts=... |
| 直接访问 3080 是 401 | 缺 token | 用启动输出里那条带 ?token= 的完整 URL |
| 找不到它写的文件 | 默认工作区在 ~/Documents/deepseek-harness/default-workspace |
换工作区,或去那找 |
| 改了配置没生效 | 改错了文件 | 先 dsh --dump-config 看合成结果 |
headless 报 MISSING_CREDENTIAL |
Web UI 的 Key 不给命令行用 | export DEEPSEEK_API_KEY=... |
最后一个问题
我用它做的那个 Markdown 转 CSV 工具,11 步、244K token、缓存命中 95%。其中缓存命中率这个数字最值得琢磨:它说明大部分 token 是重复读取的上下文,而不是新生成的。
那么问题来了:如果你把同一个仓库连续交给 agent 干十件事,第二次之后的成本是不是几乎只剩下增量?
我还没在这个方向上做完整测试。你如果跑过类似的连续任务,评论区说说你的 token 曲线,我把数据合进来做一期横评。
相关阅读(同专栏):
- AI Agent 崩了,我用一份快照 20 分钟救回来
- 10 分钟用 Docker 搭一套私有 Gitea:HTTPS、SSH、CI、备份一次配齐