🚀 欢迎来到「不用框架,手搓 AI Agent」系列第七篇。这一篇我们聊聊工具报错后怎么处理:让 Agent 学会先查原因、换个路子再试;要是反复尝试都没用,或者碰到权限拒绝,就及时停手。代码接着第六篇的 Plan Mode 往下写,新增的文件和要替换的代码都在正文里,你直接在上一版工程里一步步接进去就行。
🚀 本节配套源码:powercode 👈 点它
跟着敲代码时要是卡住了,可以直接对照源码排查。后面的章节还会持续更新,如果这个项目对你有帮助,欢迎顺手点个 Star ⭐
不知道你平时用 AI Agent 改代码时,有没有遇到过这种让人抓狂的场面:
我们知道,Agent 之所以能自己干活,是因为外层程序给它配了一组 Tool(工具函数)------比如读文件的 read_file、改文件的 edit_file、跑命令的 bash。模型只管决定下一步调哪个函数、传什么参数,程序执行完再把结果塞回给它。
但只要工具函数一报错,麻烦就来了。比如模型调 edit_file 改代码时,传进来的旧文本没匹配上,它往往不会老老实实先调 read_file 看一眼文件现在长什么样,而是对着上下文里的旧内容硬猜------加个空格再调一次,换个换行又调一次。连着试了好几轮全在报错,活儿一点没往前推,Token 和 API 调用次数倒是蹭蹭往上涨。
碰到这种原地打转的情况,我们肯定希望外层程序能多做两件事:一是工具报错时,顺带给模型塞一条靠谱的排查提示,引导它先去查原因;二是万一它还不听劝、继续做无用功,程序得能及时踩刹车,把运行暂停下来。这一篇,我们就来给 Agent 加上这两道保险。
先看运行效果:编辑失败后怎么恢复?
我们先拿一个具体的场景看看改造后的效果。假设有个 demo.txt,中途被你手动改过,或者被其他 Agent 改成了 status=pending。但大模型本身是没有记忆的,它只能看当前 Agent 上下文里的历史消息------而上下文里留着的还是更早之前读到的 status=todo。于是模型拿着这个过时的值去调 edit_file,结果当然是因为找不到旧文本而报错。
为了让你直观看到内部是怎么流转的,我们先用一段离线验证脚本来模拟这个过程(脚本会按固定顺序调用真实的文件工具和恢复管理器,并把错误详情、恢复提示、读取结果和文件核验一步步打印出来;平时正常跑终端时不会打得这么细,这里是为了方便观察,也没有接真实大模型):
text
✗ edit_file:edit_mismatch
工具执行失败:没有找到 old_text,请先重新读取文件。
[Harness 恢复提示] 类型:edit_mismatch
先 read_file 读取最新内容,再提取准确的 old_text;不要原样重复编辑。
同一调用失败 1/3 次;本次累计失败 1/6 次。

✓ read_file 执行完成
读取结果:status=pending
✓ edit_file 执行完成
已修改文件:demo.txt
文件核验:status=done
你看,第一次改文件失败后,程序除了返回原本的报错,还在下面附上了一条恢复提示,提醒它"先调 read_file 读取最新内容"。顺着这个提示,下一步先读出文件里真实的 status=pending,再重新发起修改、核验文件内容,就能顺利改成 status=done 了。
那要是遇到头铁的情况,非要跟同一个错误死磕到底呢?
只要同一组错误调用一直没成功过,哪怕中间穿插了别的成功操作,程序也会一直记着这笔账。我们再看另一个从头计数的例子:第一次改文件失败后,虽然中间成功调了一次 read_file,但紧接着又把刚才一模一样的错误修改提交了两次。等到第三次报错时,返回的内容就变了:
text
同一调用失败 3/3 次;本次累计失败 3/6 次。
已暂停本次运行,未验证的 TODO 不能标为完成。
stop=true
看到最后的 stop=true 了吗?这就是验证脚本打出来的批次执行结果,代表恢复机制踩下了急刹车。等后面接进 Agent 主循环,主循环一看到 stop 为 true 就会立刻结束当前这轮运行(需要注意,暂停前已经改成功的文件会保留在磁盘上,不会自动回滚)。
为什么一次报错会变成反复重试?
为什么一次小小的匹配报错,会让模型陷入死胡同呢?我们先来看看编辑工具 edit_file 是怎么干活的。
调用 edit_file 时,必须传三个参数:文件路径 path、旧文本 old_text 和新文本 new_text。它会在文件里做精确的字符串匹配------只要找不到这段 old_text,或者同一段 old_text 在文件里出现了不止一次,它就会拒绝替换并直接报错。
假如 Agent 之前读过一次文件,但后来这个文件被你手动改过,或者被其他 Agent、外部命令改了,当前 Agent 上下文里留着的还是旧的文件内容。这时候模型照着上下文里的 status=todo 去改当前文件,就会像下面这样碰壁:
| 操作 | 结果 |
|---|---|
用 old_text: 'status=todo' 替换成 status=done |
匹配不到,失败 |
把旧文本改成 ' status=todo' 再试 |
仍然不存在,失败 |
先 read_file,再用 status=pending 作为旧文本 |
匹配成功,才能替换 |
根源很简单:文件里的内容早就从 todo 变成 pending 了。这时候模型往 old_text 前面塞空格根本不管用;更何况代码里的空格和缩进往往带有语法意义,工具本身也绝不能随便忽略空白字符。唯一正确的路子,就是先重新调一次 read_file,看清文件现在到底写的是什么,再去改下一次的参数。
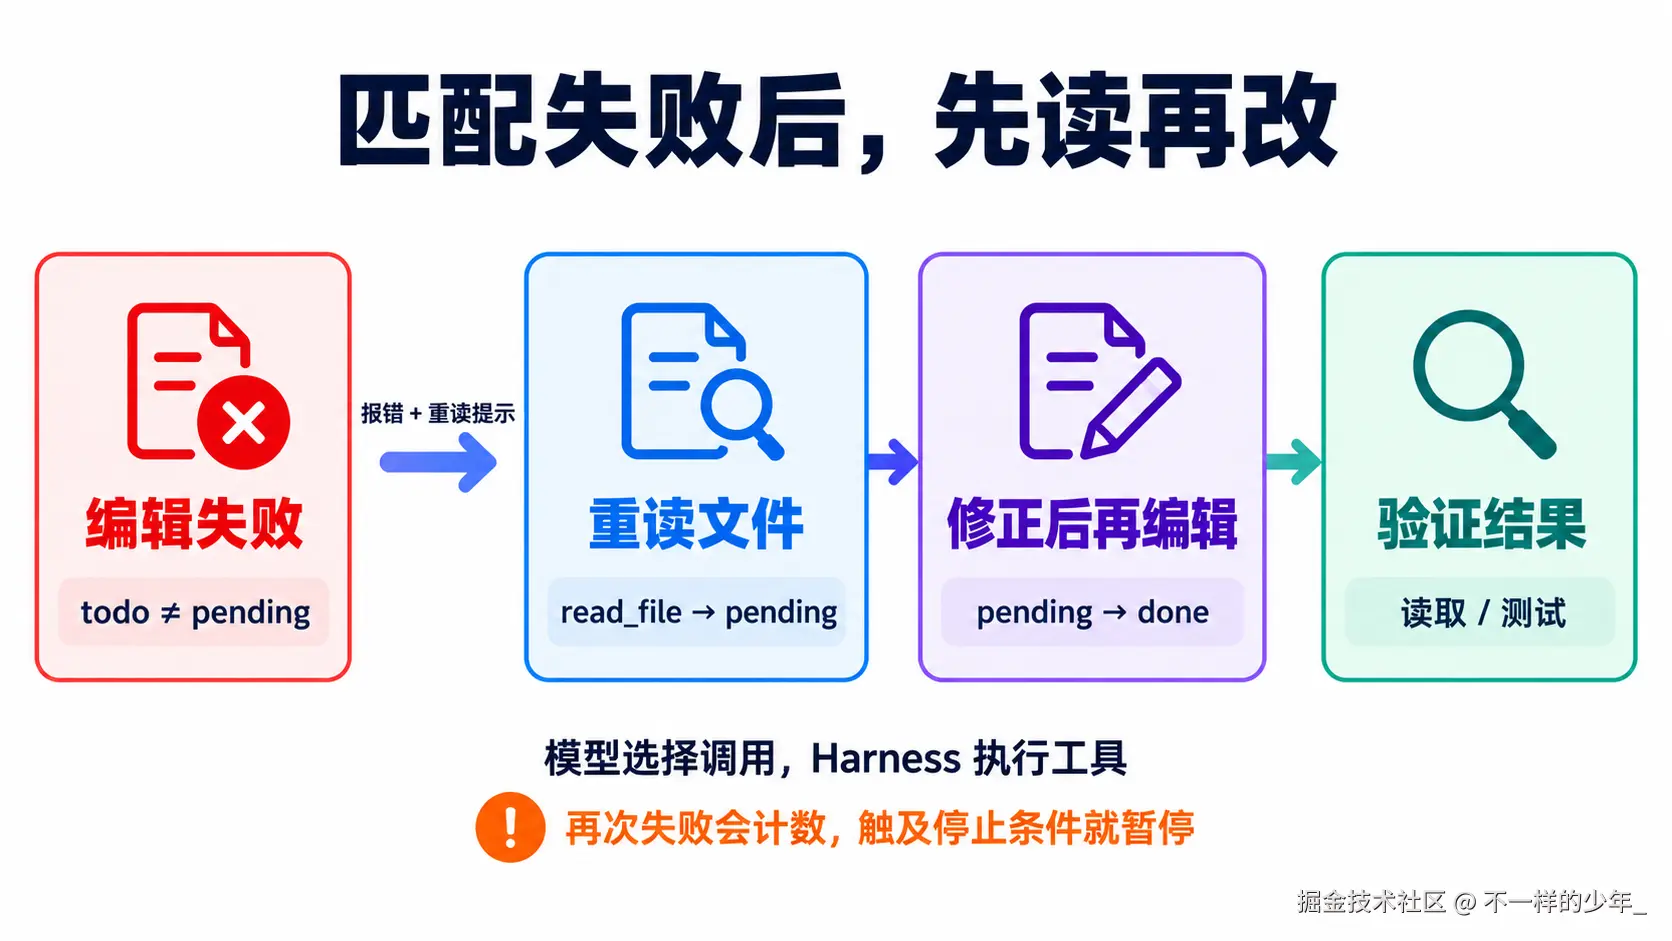
图:先重读得到真实的 pending,再修正旧文本;模型选择调用,Harness 执行工具,是否完成要看验证结果。
问题是,当模型只收到一句干巴巴的原始报错时,它有时候能反应过来去重读文件,有时候就会开始瞎猜参数。我们当然可以在报错结果里拼上更具体的恢复提示,提醒它先去检查现场;但说到底,提示词终归只是"建议",谁也没法打包票模型每次都乖乖听话。所以除了给建议,我们还得让外层程序把失败次数记下来,一旦触及上限就直接拉闸暂停。
那在代码里,这两件事分别归谁管?分工其实很明确:大模型只管提出"我想调什么工具";而外层的控制程序------也就是我们常说的 Harness------负责检查规则、真正执行工具、记录失败次数,最后再把组装好的结果交回给模型。
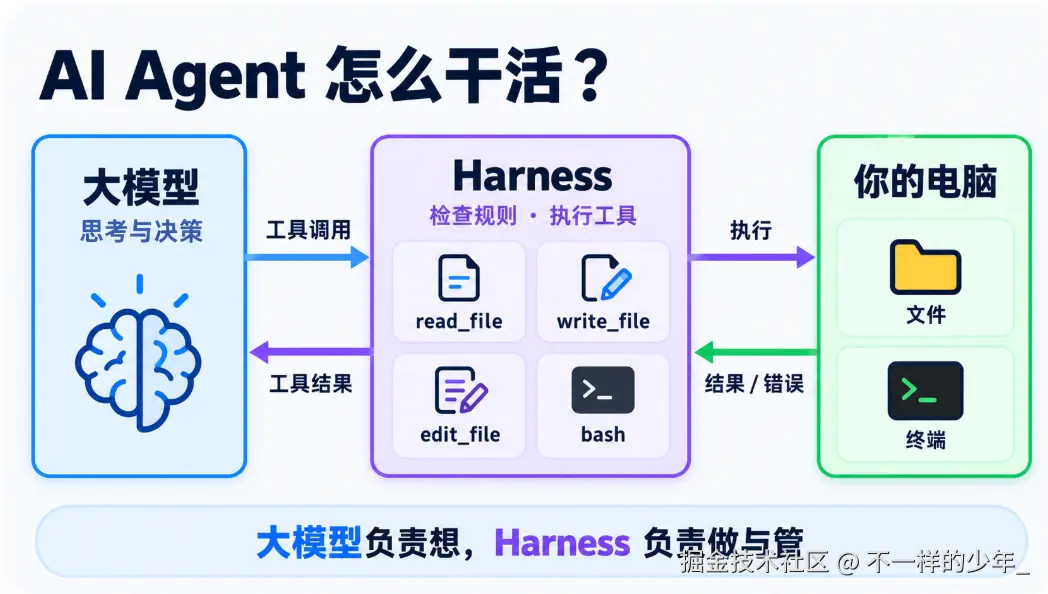
图:模型决定申请什么工具,Harness 执行工具并处理结果。
搞清楚分工之后,我们就可以动手改代码了。
这里我们只专注解决**"工具调不通时怎么自救和刹车"**(像网络断连、API Key 填错这类请求接口本身的报错,不在这个范围内)。代码直接接着上一篇的工程往下写------就算你没读过前几篇也完全不影响,只需要知道现在的 Agent 已经能正常对话、调工具、做计划了。
这次改造非常轻量,不用装任何新依赖,一共就动 4 个地方(改已有文件时,只替换文中贴出的同名方法就行,其他代码不用动):
| 位置 | 操作 |
|---|---|
src/context/recovery.ts |
新建:错误分类、恢复提示和失败计数 |
src/tools/bash.ts |
增加导入,替换构造函数和 execute() |
src/tool-runner.ts |
新建:顺序执行,暂停后跳过剩余调用 |
src/agent.ts |
增加导入和提示词,替换 run() |
1. 先让执行器分得清成功和失败
要让程序在工具报错后启动自救机制,第一步其实很朴素:外层执行器得先分得清工具到底是执行成功了,还是执行失败了。
工具跑完之后,最终肯定要把一段文字结果传回给模型。但如果一个工具出错时,只是在函数里 return 了一句错误说明,外层执行器能知道它失败了吗?我们可以对比一下下面这两个函数:
js
async function toolA() {
  return '执行失败';
}
async function toolB() {
  throw new Error('没有找到 old_text');
}
在 JavaScript 里,await toolA() 会顺顺当当地拿到返回的字符串,程序接着往下走成功分支;只有像 toolB() 这样用 throw 抛出异常,执行流程才会跳进 catch。因为外层执行器看的是 Promise 的完成状态,它可不会去读你返回的字符串里有没有写着"失败"两个字。
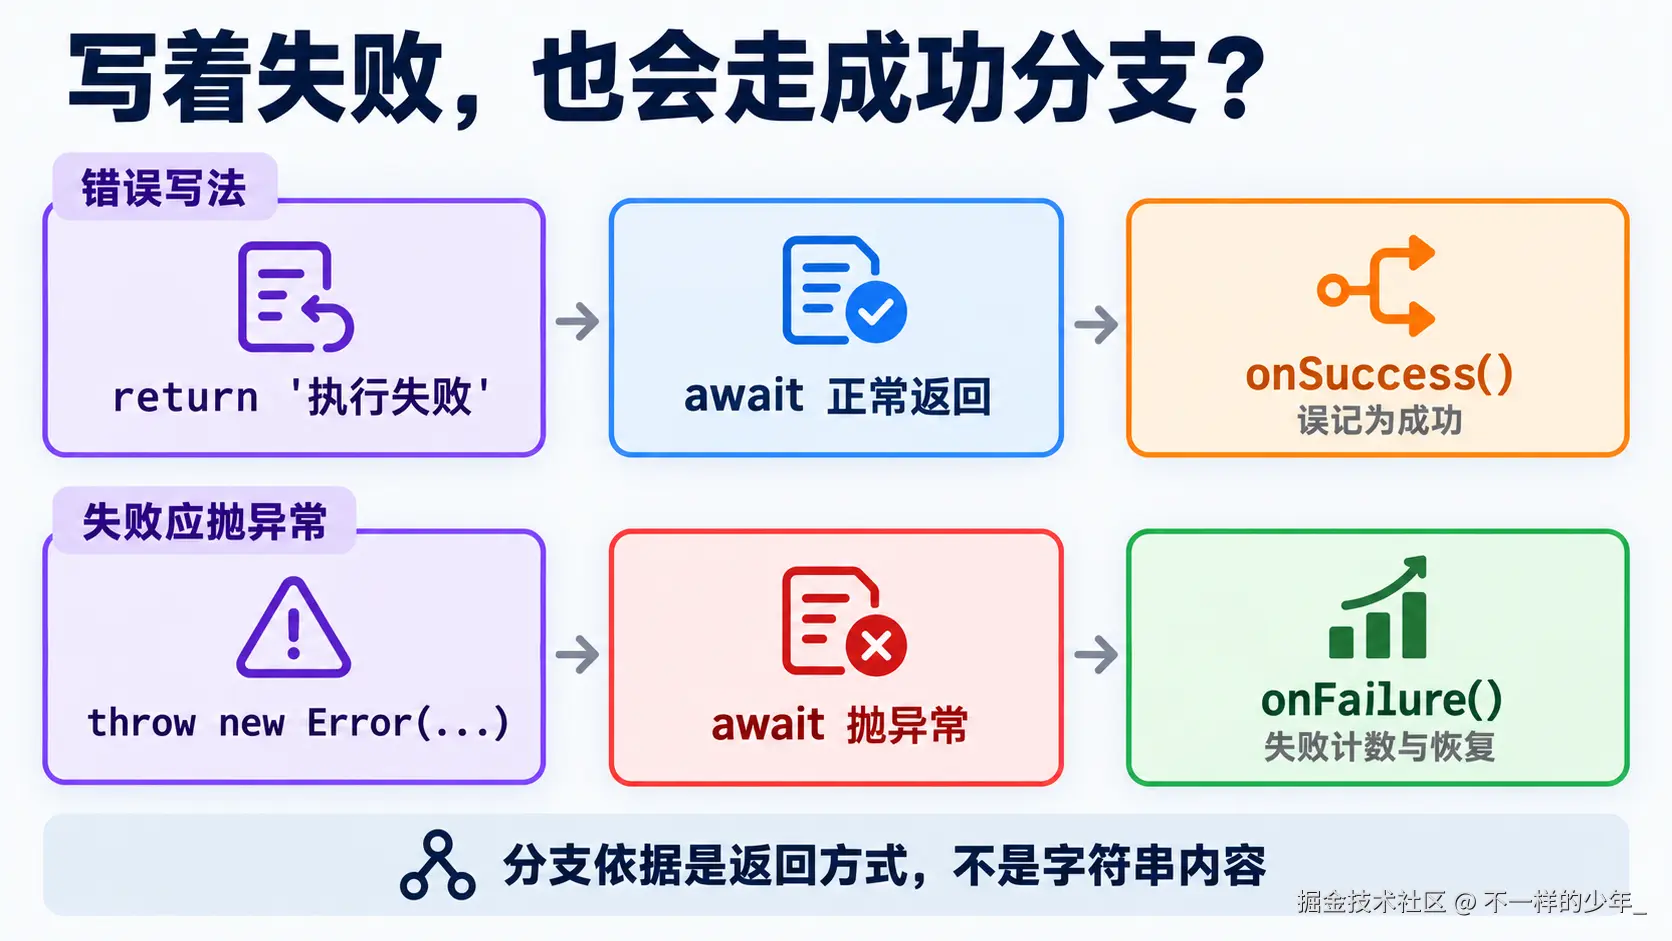
图:失败应抛异常,才能进入失败计数与恢复分支。
所以,我们先给所有工具立一条硬规矩:执行成功就 return 字符串,执行失败就必须 throw 抛异常(当然,不抛异常只代表工具执行没报错,至于代码改得对不对,后面还得靠跑测试来验收)。
之前写好的读文件、改文件工具,在找不到文件或匹配不上时本来就会抛异常。那外层程序抓到异常之后,该怎么判断下一步做什么呢?我们先来把"错误分类"和"失败记账"写好,后面再去把 bash 工具的报错日志补全。
2. 错误分类要能指向下一步
抓到异常之后,光知道"出错了"还不够,我们得搞清楚到底出了哪种错,因为不同的错误,下一步的排查动作完全不一样。哪怕同样是 edit_file 编辑失败,"找不到旧文本"和"旧文本命中多处"的解法也截然不同:
| 类型 | 下一步 |
|---|---|
edit_mismatch:旧文本不存在 |
重读文件,提取准确内容 |
edit_ambiguous:旧文本命中多处 |
增加相邻上下文,保证唯一 |
not_found:路径不存在 |
list_files、search_files 确认路径 |
permission:权限拒绝 |
保留限制,暂停说明 |
timeout:等待超时 |
查进程、部分结果,再缩小范围 |
output_limit:输出超限 |
查副作用,再减少输出 |
command_failed:命令失败 |
根据退出状态、日志排查 |
unknown:未识别原因 |
保留错误,先只读调查 |
你可能会问:为什么连 edit_file 的报错都要掰成 edit_mismatch(找不到旧文本)和 edit_ambiguous(旧文本命中多处)两类?
我们看个很常见的例子。假设配置文件 config.ini 里同时有开发环境和生产环境两段配置:
ini
[dev]
debug=true

[prod]
debug=true
假如模型现在想把生产环境的 debug 关掉,但它图省事只传了 old_text: 'debug=true',一下就会在文件里命中两处。如果工具随便替它改掉第一处,那就把 [dev] 给改错了;正确的做法是提示它把上一行的 [prod] 也一起带上(传 '[prod]\ndebug=true'),这样才能精准锁定生产环境的那一行。你看,同样是编辑报错,找不到旧文本得去重读文件 ,而命中多处则得补齐上下文,提示方向完全不同。
那程序在 catch 到异常后,怎么自动识别出上面这 8 种错误呢?思路其实很直接:
- Bash 工具的错误 :待会儿我们会让
bash工具在抛错时,直接带上自己识别好的类型(超时timeout、输出超限output_limit或命令失败command_failed)。 - 其他工具的错误 :按系统错误码和报错文字来认------比如遇到
EACCES、EPERM或越界提示就归为permission(权限拒绝),遇到ENOENT就归为not_found(文件不存在),遇到edit_file的匹配报错就归为对应的两类编辑错误;都不沾边的就归为unknown。
识别出错误类型后,程序就会把 "原始报错 + 错误类型 + 对应的排查建议" 拼在一起,作为这次工具调用的结果(tool 消息)追加到对话上下文中,让模型在下一轮看到。这里我们还顺手用 slice(0, 4000) 截断了超长的原始报错,免得一段几万行的错误日志直接把上下文撑爆。
3. 用两本账限制无效尝试
之前我们已经用 MAX_STEPS = 30 限制了你每发一句话后,Agent 最多能自己连续跑 30 轮工具调用。但那个数字只管总轮数------总不能等模型在同一个坑里连摔 30 次才停下来吧?
为了尽早揪出反复报错的行为,让 Agent 及时停下来把控制权交还给你------等你排查完或补充提示、再次发消息时,就会开启新一轮 run(),无论是 MAX_STEPS 的 30 轮步数,还是失败次数,都会重新从 0 开始计算。为此,我们需要在每次 run() 里专门记两本账:
failures(单调用账本):拿工具名和调用参数算出一个"调用指纹",专门记录从本次运行开始、或者从这个指纹上一次成功之后算起,它又失败了几次。只有当同一个指纹的调用真正执行成功时,才会把它自己的失败记录清零;中间穿插的其他调用不管是成功还是失败,都不会替它销账。totalFailures(总预算账本):记录本次run()启动以来的累计失败总次数。这本账只增不减,后续任何调用成功都不会抵扣这个数字------哪怕是之前失败过的同一个调用后来成功了,已经记上的累计失败次数也不会退回来。
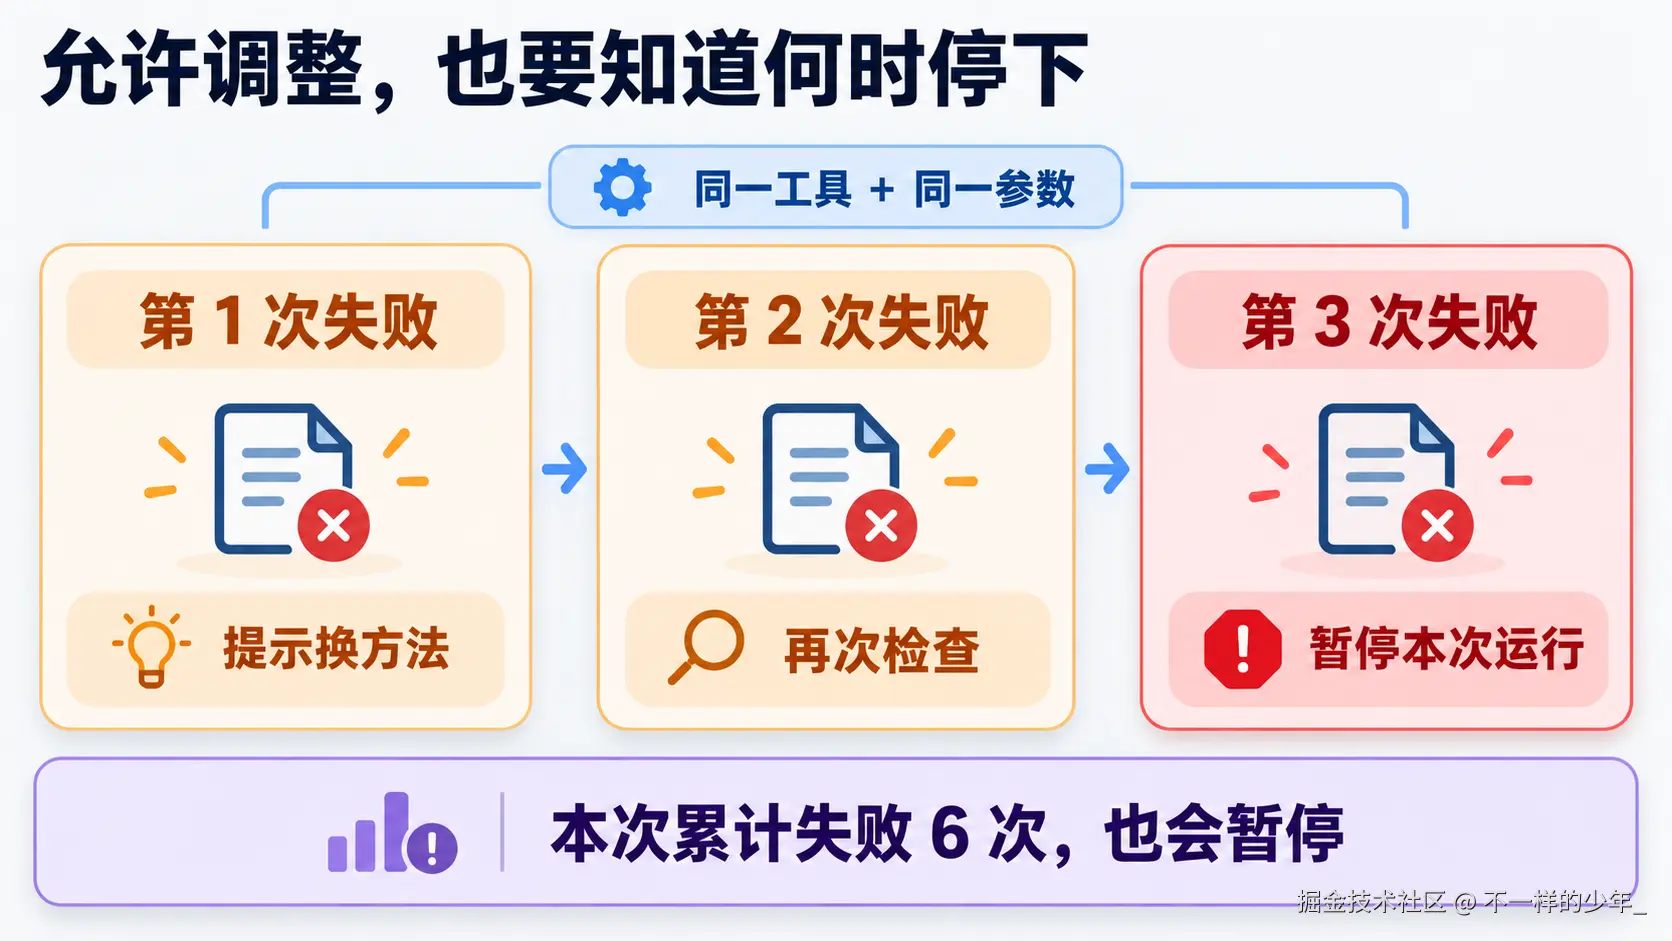
图:3 次、6 次是演示阈值;前两次的检查提示需要由模型决定是否执行。
为什么要费劲同时记两本账呢?我们还是拿前面那个用 old_text: 'status=todo' 去改 demo.txt 的错误调用来举例,把这组调用记为 A:
| 同一次运行中的顺序 | A 的失败次数 | 累计失败 | 暂停? |
|---|---|---|---|
| A 编辑失败 | 1 | 1 | 否 |
read_file 成功 |
1 | 1 | 否 |
| A 再失败 | 2 | 2 | 否 |
| A 第三次执行仍失败 | 3 | 3 | 是 |
你看,中间那次 read_file 虽然成功了,但它跟 A 不是同一个调用,不会替 A 销账。也就是说,"三次失败"不要求紧挨着发生,只要 A 在成功之前累计报错满 3 次,就会当场触发暂停。
那如果模型学"聪明"了,每次都稍微改一点点参数呢?比如它就是不去读文件,而是往 old_text 里随便加个空格,或者把命令换个写法再试,导致每次算出来的调用指纹都不一样,单调用账本根本攒不够 3 次。这时候,第二本账 totalFailures 就派上用场了:哪怕六个不同的调用各自只失败了 1 次,只要本次运行累计失败满 6 次,照样会被拦下来(代码里的 3 次和 6 次都是方便演示定的阈值,实际用时可以根据任务复杂度自己调)。
💡 延伸思考:像 Codex、Pi 也是这么限制失败次数的吗? 它们的"报错分类 + 恢复提示 + 权限拦截"思路和我们完全一致,但默认不会把"总失败次数"卡得这么死------因为正常修复杂 Bug、跑测试时,来回报错七八次很常见,前沿大模型靠着精准报错往往自己就能拐弯。而我们在这个 Demo 里把
3 次 / 6 次的账本完整实现出来,一方面是为了让大家亲手跑通"调用指纹 + 熔断刹车"的底层原理,另一方面当你接入能力稍弱的模型练手时,它也能实打实地防止死循环烧光你的 Token。
弄明白账本规则后,现在请在工程里新建 src/context/recovery.ts,把下面这段代码完整复制进去。错误分类、恢复提示和这两本账的逻辑,全都收在这个文件里了:
ts
import { createHash } from 'node:crypto';

export type FailureKind =
  | 'edit_mismatch'
  | 'edit_ambiguous'
  | 'not_found'
  | 'permission'
  | 'timeout'
  | 'output_limit'
  | 'command_failed'
  | 'unknown';

export class ToolExecutionError extends Error {
  constructor(
    readonly kind: FailureKind,
    message: string,
  ) {
    super(message);
    this.name = 'ToolExecutionError';
  }
}

const HINTS: Record<FailureKind, string> = {
  edit_mismatch:
    '先 read_file 读取最新内容,再提取准确的 old_text;不要原样重复编辑。',
  edit_ambiguous:
    'old_text 命中多处;读取文件并补充相邻上下文,确认唯一后再编辑。',
  not_found: '先 list_files 或 search_files 确认真实路径,不要连续猜文件名。',
  permission:
    '保留当前权限限制,向用户说明被拒绝的操作;不要换工具绕过,也不要自行提权。',
  timeout:
    '先确认命令是否仍有进程或部分写入,再缩小验证范围;不要直接重跑或改成后台运行。',
  output_limit:
    '输出超过缓冲区上限;先确认副作用,再缩小检查范围或改用摘要输出。',
  command_failed:
    '根据退出状态和日志定位原因;检查脚本、依赖和语法后再决定是否重试。',
  unknown: '原因尚未识别;保留原始错误,先做只读检查,无法确认时说明阻塞点。',
};

export function classifyFailure(name: string, error: unknown): FailureKind {
  if (error instanceof ToolExecutionError) return error.kind;
  const message = error instanceof Error ? error.message : String(error);
  const code = (error as { code?: unknown } | null)?.code;
  if (
    code === 'EACCES' ||
    code === 'EPERM' ||
    /当前模式不允许|只能操作当前项目|permission denied/i.test(message)
  )
    return 'permission';
  if (code === 'ENOENT') return 'not_found';
  if (name === 'edit_file' && /没有找到 old_text/.test(message))
    return 'edit_mismatch';
  if (name === 'edit_file' && /old_text 出现了/.test(message))
    return 'edit_ambiguous';
  return 'unknown';
}

// 只排序 JSON 对象键,不改字符串、数组顺序或 shell 命令。
function canonical(value: unknown): unknown {
  if (Array.isArray(value)) return value.map(canonical);
  if (value !== null && typeof value === 'object') {
    return Object.fromEntries(
      Object.entries(value)
        .sort(([a], [b]) => (a < b ? -1 : a > b ? 1 : 0))
        .map(([key, item]) => [key, canonical(item)]),
    );
  }
  return value;
}

export function callKey(name: string, args: string): string {
  let normalized = args;
  try {
    normalized = JSON.stringify(canonical(JSON.parse(args)));
  } catch {}
  return createHash('sha256')
    .update(JSON.stringify([name, normalized]))
    .digest('hex');
}

export class RecoveryManager {
  private readonly failures = new Map<string, number>();
  private totalFailures = 0;

  onSuccess(name: string, args: string): void {
    this.failures.delete(callKey(name, args));
  }

  onFailure(name: string, args: string, error: unknown) {
    const kind = classifyFailure(name, error);
    const key = callKey(name, args);
    const count = (this.failures.get(key) ?? 0) + 1;
    this.failures.set(key, count);
    this.totalFailures += 1;
    const stop = kind === 'permission' || count >= 3 || this.totalFailures >= 6;
    const raw = error instanceof Error ? error.message : String(error);
    const output = [
      `工具执行失败:${raw.slice(0, 4000)}`,
      `[Harness 恢复提示] 类型:${kind}`,
      HINTS[kind],
      `同一调用失败 ${count}/3 次;本次累计失败 ${this.totalFailures}/6 次。`,
      stop
        ? '已暂停本次运行,未验证的 TODO 不能标为完成。'
        : '请先检查原因,再决定下一步。',
    ].join('\n');
    return { kind, count, totalFailures: this.totalFailures, stop, output };
  }
}
这段代码一共 100 行出头,从上往下其实就是四个模块。我们一块一块拆开看:
第一块:定义错误类型与排查提示表(FailureKind、ToolExecutionError、HINTS)
ts
export class ToolExecutionError extends Error {
  constructor(
    readonly kind: FailureKind,
    message: string,
  ) {
    super(message);
    this.name = 'ToolExecutionError';
  }
}
文件开头先用 FailureKind 列出了前面表格里的 8 种错误类型,紧接着用 HINTS 字典给每种类型配了一句具体的行动建议。这里额外定义了一个继承自 Error 的 ToolExecutionError:有些工具(比如下一节要改的 bash 工具)在抛错的那一刻就已经知道自己是超时还是输出超限了,直接 throw new ToolExecutionError('timeout', ...) 把 kind 带出来,外层就不用再去猜了。
第二块:把普通异常归类的分类函数(classifyFailure)
ts
export function classifyFailure(name: string, error: unknown): FailureKind {
  if (error instanceof ToolExecutionError) return error.kind;
  const message = error instanceof Error ? error.message : String(error);
  const code = (error as { code?: unknown } | null)?.code;
  if (
    code === 'EACCES' ||
    code === 'EPERM' ||
    /当前模式不允许|只能操作当前项目|permission denied/i.test(message)
  )
    return 'permission';
  if (code === 'ENOENT') return 'not_found';
  if (name === 'edit_file' && /没有找到 old_text/.test(message))
    return 'edit_mismatch';
  if (name === 'edit_file' && /old_text 出现了/.test(message))
    return 'edit_ambiguous';
  return 'unknown';
}当工具抛出异常时,classifyFailure 会按优先级依次判断:
- 如果已经是
ToolExecutionError,直接取它自带的error.kind; - 如果是普通
Error,先看系统错误码(EACCES、EPERM)或权限拦截文案,命中就归为permission; - 再看是不是文件不存在(
ENOENT→not_found),或者edit_file的两类匹配报错(注意正则里的old_text匹配的就是edit-file.ts报错原话"没有找到 old_text..."里的固定字符,不是变量,效果等同于message.includes('没有找到 old_text')); - 上面都没命中,统一由
'unknown'兜底。
第三块:给工具调用算"唯一指纹"(canonical 与 callKey)
ts
function canonical(value: unknown): unknown {
  if (Array.isArray(value)) return value.map(canonical);
  if (value !== null && typeof value === 'object') {
    return Object.fromEntries(
      Object.entries(value)
        .sort(([a], [b]) => (a < b ? -1 : a > b ? 1 : 0))
        .map(([key, item]) => [key, canonical(item)]),
    );
  }
  return value;
}

export function callKey(name: string, args: string): string {
  let normalized = args;
  try {
    normalized = JSON.stringify(canonical(JSON.parse(args)));
  } catch {}
  return createHash('sha256')
    .update(JSON.stringify([name, normalized]))
    .digest('hex');
}
要判断模型是不是在"拿同一组参数反复撞墙",我们得用 工具名 name + 参数字符串 args 算出一个 SHA-256 哈希指纹。
但这里有个小坑:模型第一次可能传 {"path":"a","old_text":"x"},第二次可能传 {"old_text":"x","path":"a"}------虽然字段顺序颠倒了,但它们其实是完全相同的调用。所以 canonical() 会先把 JSON 对象里的键名按字母排个序(数组顺序和字符串内容保持原样;万一遇到非法 JSON 就保留原字符串),排好序再算哈希,就能保证算出来的是同一个指纹。当然,哈希只认字面结构、不懂路径语义------比如 demo.txt 和 ./demo.txt 算出来的指纹还是不一样,这也再次说明了为什么一定要有总预算来兜底。
第四块:管账与踩刹车的恢复管理器(RecoveryManager)
ts
export class RecoveryManager {
  private readonly failures = new Map<string, number>();
  private totalFailures = 0;

  onSuccess(name: string, args: string): void {
    this.failures.delete(callKey(name, args));
  }

  onFailure(name: string, args: string, error: unknown) {
    // ...分类、记账、判断是否暂停、拼装反馈文本
    const stop = kind === 'permission' || count >= 3 || this.totalFailures >= 6;
    // ...
  }
}
RecoveryManager 内部就维护了我们前面说的两本账:failures(Map,按指纹记单调用失败次数)和 totalFailures(累计失败总次数):
- 调用成功时调
onSuccess():只把当前指纹从failures里删掉销账,totalFailures保持不变; - 调用失败时调
onFailure():把单调用计数count和总计数totalFailures同时加 1,接着看一眼刹车条件kind === 'permission' || count >= 3 || this.totalFailures >= 6------只要满足其中任意一条,stop就变成true。最后把原始报错(截断前 4,000 个字符)、错误类型、排查建议、当前失败进度(x/3、y/6)以及是否暂停拼成一段完整的文本,交回给上层。
4. 让 Bash 错误带上现场
错误分类和失败计数都就位了,接下来我们去改造 BashTool。平时在终端里跑命令报错,光知道一句"命令失败了"是没法修 bug 的,必须把当时的退出状态和已经打出来的终端日志保留下来,模型才有足够的线索去排查。
先补充个小常识:终端命令跑完退出时,都会向系统返回一个退出码(Exit Code) 。按惯例,0 代表执行成功;只要是非零值就代表出错了,比如单测没跑过通常返回 1,找不到命令会返回 127。
我们的 BashTool 底层用的是 Node.js 的 promisify(execFile):当命令以 0 退出时,它会正常返回结果;一旦命令以非零状态退出,或者因为超时、超出缓冲区被强行杀掉,它就会抛出异常。好在 Node.js 抛出的这个异常对象上,顺带挂着命令退出前已经捕获到的标准输出 stdout 和标准错误输出 stderr(具体细节可以参考 Node.js 文档)。
现在我们来改 src/tools/bash.ts。先在文件最上面加一行导入(ToolExecutionError 和 FailureKind 就是我们在第 3 节刚写好的,文件里原有的其他导入、参数解析和工具定义都不用动):
ts
import { ToolExecutionError, type FailureKind } from '../context/recovery.ts';接着,把 BashTool 的构造函数和整个 execute() 方法替换成下面这段代码。这里依然沿用上一版定义好的 execFileAsync、TIMEOUT_MS = 30_000 和 MAX_BUFFER = 8_000;我们只在构造函数里顺手加了一个带默认值的 timeoutMs 可选参数,方便后面写快进测试,原来 new BashTool(workDir) 的调用方式完全不受影响:
ts
constructor(
  private readonly workDir: string,
  private readonly timeoutMs = TIMEOUT_MS,
) {}

/**
 *  执行工具
 * @param argumentsJson  工具参数 JSON 字符串
 * @returns              工具执行结果
 */
async execute(argumentsJson: string): Promise<string> {
  const command = parseCommand(argumentsJson);

  try {
    const { stdout, stderr } = await execFileAsync("bash", ["-c", command], {
      cwd: this.workDir,
      timeout: this.timeoutMs,
      maxBuffer: MAX_BUFFER,
    });
    return [stdout, stderr].filter(Boolean).join("\n").trim()
      || "命令执行成功,没有终端输出。";
  } catch (error) {
    const e = error as Error & {
      code?: string | number; killed?: boolean; signal?: string;
      stdout?: string; stderr?: string;
    };
    let kind: FailureKind = "command_failed";
    if (e.code === "ERR_CHILD_PROCESS_STDIO_MAXBUFFER") {
      kind = "output_limit";
    } else if (e.killed) {
      kind = "timeout";
    }
    const detail = [
      `code=${e.code ?? "unknown"}; signal=${e.signal ?? "none"}`,
      e.message, e.stdout, e.stderr,
    ].filter(Boolean).join("\n");
    throw new ToolExecutionError(kind, detail);
  }
}
我们把这段代码拆开,重点看里面最关键的三处逻辑,以及它们背后容易踩坑的运行边界:
第一处: try 块里的正常返回语句
ts
return (
  [stdout, stderr].filter(Boolean).join('\n').trim() ||
  '命令执行成功,没有终端输出。'
);
你可能会好奇:为什么命令成功了,还要把 stderr 也拼进去返回?因为在命令行工具里, stderr 有输出可不等于命令执行失败 。像很多编译器、npm 或者测试框架,习惯把警告信息(Warning)和进度提示往 stderr 里打;只要最终退出码是 0,程序照样走成功分支。把 stdout 和 stderr 一块儿返回去,模型才不会漏看这些重要警告。
第二处: catch 块里细分错误类型的判断语句
ts
let kind: FailureKind = 'command_failed';
if (e.code === 'ERR_CHILD_PROCESS_STDIO_MAXBUFFER') {
  kind = 'output_limit';
} else if (e.killed) {
  kind = 'timeout';
}
这几行代码把 Bash 报错分成了三类:
- 输出超限(
output_limit) :命令打印的日志超过了MAX_BUFFER(8,000 字节),Node.js 会抛出ERR_CHILD_PROCESS_STDIO_MAXBUFFER并直接杀掉子进程 (注意这和read_file截断字符串正常返回不同,这里是进程被强行中断了)。 - 执行超时(
timeout) :排除输出超限后,如果e.killed为true,说明命令跑超了 30 秒被系统杀掉(因为咱们工程里还没有"手动取消"功能,所以这里直接用e.killed代表超时)。 - 普通报错(
command_failed):其他非零退出的情况统一归到这里。
这里有个很容易忽略的坑:进程被半路杀掉,不代表它干了一半的活会自动撤回 。比如执行 echo "started" >> progress.log && sleep 60,后半句虽然超时被杀了,但前半句已经把内容写进了文件;而且杀掉外层 bash 也不保证它派生出的子进程跟着退出,子进程可能还留在后台占着端口(详见 进程终止说明)。所以遇到超时或输出超限时,恢复提示会专门叮嘱模型:先检查文件和进程现状,别闭着眼直接重跑。
💡 这里把
MAX_BUFFER设成8_000字节,是为了演示时更容易触发output_limit,方便观察模型怎么用--silent、tail、grep缩小输出范围。放到实际项目里,你可以把本地进程缓冲和发给模型的上下文拆开管:让maxBuffer容纳几十 MB 保证命令能跑完,最后只截取头尾几 KB 的关键日志发给模型。
第三处:打包终端日志并抛出 ToolExecutionError
ts
const detail = [
  `code=${e.code ?? 'unknown'}; signal=${e.signal ?? 'none'}`,
  e.message,
  e.stdout,
  e.stderr,
]
  .filter(Boolean)
  .join('\n');
throw new ToolExecutionError(kind, detail);
命令为什么失败,线索往往就藏在它临退出前打印出来的 stdout 或 stderr 里。所以这里我们把退出码、信号以及已经捕获到的输出日志全都装进 ToolExecutionError,一块儿交给恢复管理器(发回给模型前依然会截取前 4,000 个字符)。
回过头再把 BashTool 和第 3 节的 classifyFailure() 放在一起看,还有两个很有意思的实现边界:
边界 1:编辑错误是靠"报错文字对暗号"识别的
在 edit-file.ts 里,找不到 old_text 时我们抛出的是一句写死的中文:
ts
throw new Error('没有找到 old_text,请先重新读取文件。');而 classifyFailure() 是靠正则去匹配这句话里的字:
ts
if (name === 'edit_file' && /没有找到 old_text/.test(message))
return 'edit_mismatch';- 所以两边是对暗号。以后如果你把
edit_file的报错改成"匹配失败:文件里不存在这段旧文本",上面这条正则就对不上了,最后只会归成unknown。改报错措辞时,分类规则也要一起改。
边界 2: bash 日志里出现 Permission denied,也不会被判成 permission
看 classifyFailure() 的判断顺序:
ts
export function classifyFailure(name: string, error: unknown): FailureKind {
  // 第一关:ToolExecutionError 直接返回自带的 kind,不再往下走
  if (error instanceof ToolExecutionError) return error.kind;

  // 第二关:只有普通 Error 才会继续检查权限码和报错文字
  const message = error instanceof Error ? error.message : String(error);
  const code = (error as { code?: unknown } | null)?.code;
  if (
    code === 'EACCES' ||
    code === 'EPERM' ||
    /当前模式不允许|只能操作当前项目|permission denied/i.test(message)
  )
    return 'permission';
  // ...
}
对比两个例子就明白了:
- 例子 A(会触发
permission,当场暂停) :模型调edit_file去改工作区外面的../other-project/config.js,或者在只读的 Plan Mode 下硬调write_file。这时抛出的是普通Error,会跳过第一关、走进第二关,被判成permission并立刻暂停。 - 例子 B(只会是
command_failed,不会当场暂停) :模型用bash跑./build.sh,脚本没加可执行权限,终端日志里出现了bash: ./build.sh: Permission denied。但按照刚才的改造,BashTool会先把它包装成new ToolExecutionError("command_failed", detail)。传到classifyFailure()时,第一关就直接返回"command_failed",根本不会走到第二关去扫日志里的"permission denied"。
所以这里的 permission,主要是拦 Agent 越界改文件、违反 Plan Mode 工具限制这类 Harness 规则;不要把它当成能识别所有 Shell 内部权限错误的通用检测器。
5. 权限被拒,为什么后面的工具还会跑?
大模型在一次回复里,往往不只调一个工具,而是会打包返回一串调用清单(tool_calls 数组)------比如"先改配置文件,再紧接着跑一条命令":
text
call_1: edit_file({
  path: '../other-project/config.js',
  old_text: 'debug=true',
  new_text: 'debug=false'
})
call_2: bash({ command: 'echo batch-continued' })
按理说,第一条 call_1 试图去改工作区外面的文件,属于越界操作,当场就会触发 permission 暂停,后面的 call_2 根本不该再跑。
但在上一版代码里,我们只是用一个普通的 for 循环挨个执行 tool_calls:call_1 报错进了 catch、记下错误信息后,循环压根没停 ,转头就把后面的 call_2 也给执行了,终端里照样会打出 batch-continued。要知道,这时候模型根本还没看到 call_1 的报错,纯粹是我们的 for 循环没踩刹车,顺着刚才收到的清单继续往下莽。
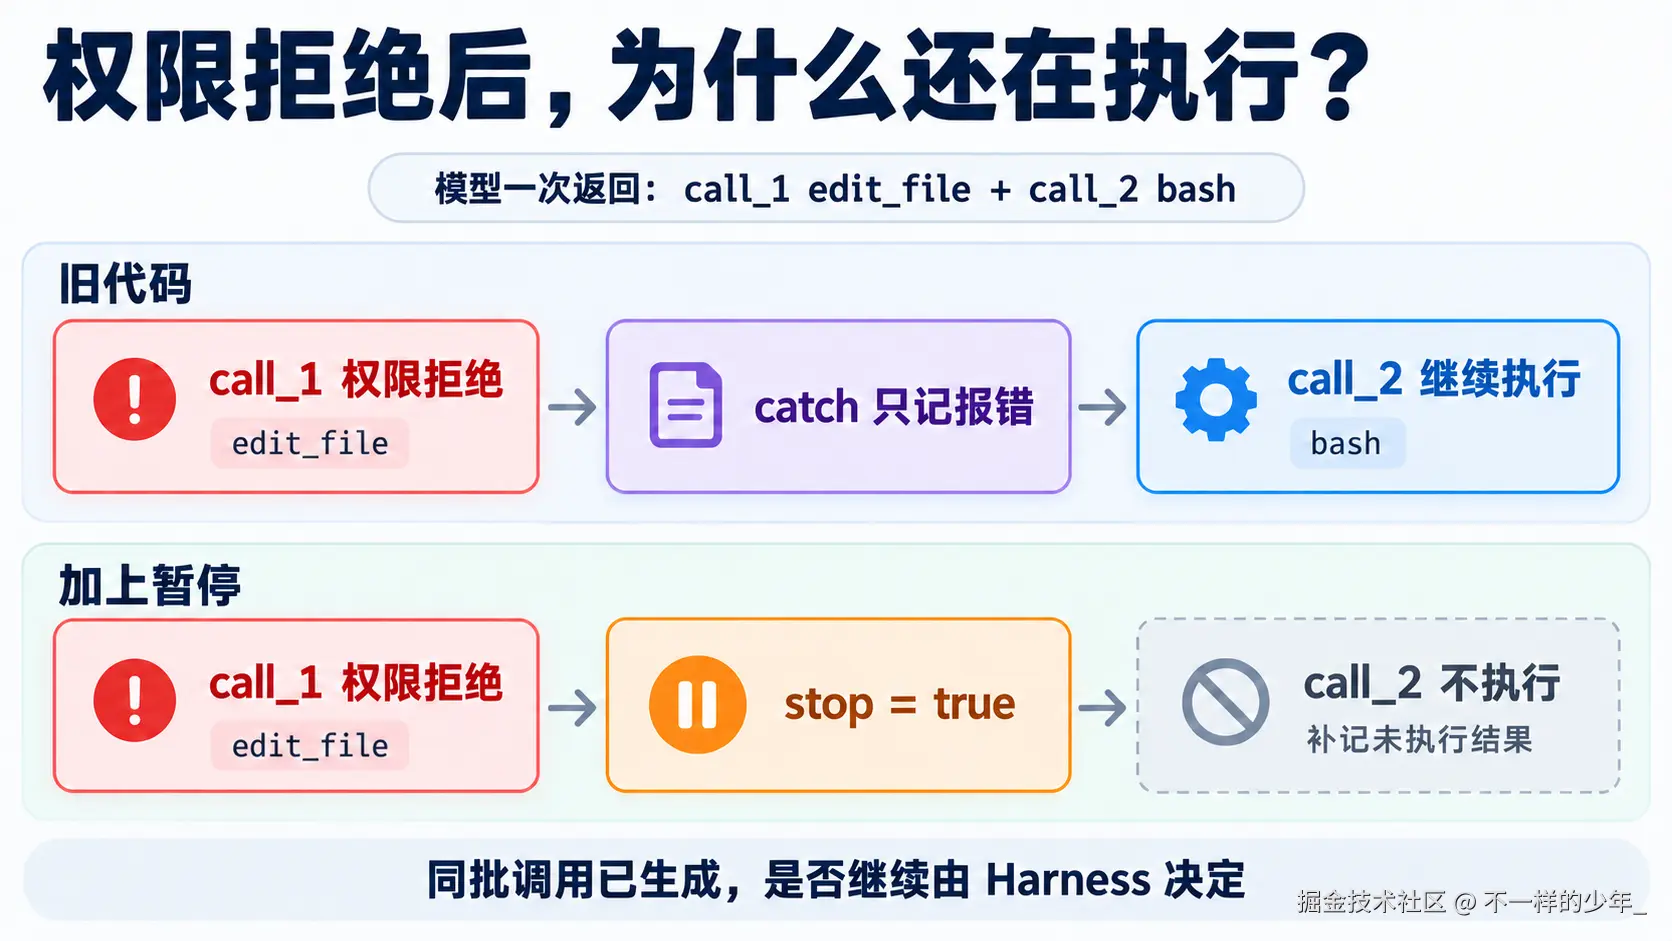
图:拒绝后是否继续,由 Harness 的停止分支决定。
如果你还有印象,在前几篇的 src/agent.ts 里,我们的 run() 方法其实是两层循环套在一起:
- 外层循环 (
for (let step = 1; step <= MAX_STEPS; step++)):负责一轮接一轮地请求大模型; - 内层循环 (
for (const toolCall of toolCalls)):负责把模型在单轮回复里给出的一批工具挨个执行完。
之前那层内层循环写得非常简陋,报错了也只是把错误字符串塞回历史,接着跑下一个工具:
ts
// 之前直接塞在 agent.ts 里的内层循环:报错后不会停,继续跑同批的下一个工具
for (const toolCall of toolCalls) {
  let result: string;
  try {
    result = await this.registry.execute(name, args, allowedToolNames);
  } catch (error) {
    result = `工具执行失败:${error.message}`;
  }
  this.session.append({ role: 'tool', tool_call_id: toolCall.id, content: result });
}现在,我们要把这层内层工具循环 从 agent.ts 里单独拎出来,放进新建的 src/tool-runner.ts(取名 runToolBatch),给它加上 RecoveryManager 记账和 stop 急刹车。完整复制下面的代码:
ts
import type OpenAI from 'openai';
import type { Registry } from './tools/registry.ts';
import type { RecoveryManager } from './context/recovery.ts';

export async function runToolBatch(
  calls: OpenAI.Chat.Completions.ChatCompletionMessageToolCall[],
  registry: Registry,
  allowedNames: ReadonlySet<string>,
  recovery: RecoveryManager,
) {
  // 先检查整批类型,避免已执行一半才发现无法配对的调用。
  for (const call of calls) {
    if (call.type !== 'function')
      throw new Error(`暂时不支持工具类型:${call.type}`);
  }
  const messages: OpenAI.Chat.Completions.ChatCompletionToolMessageParam[] = [];
  let stop = false;
  let stopReason = '';
  for (const call of calls) {
    if (call.type !== 'function') continue;
    const { name, arguments: args } = call.function;
    let output: string;
    if (stop) {
      output = '本次运行已暂停,此工具调用未执行。';
    } else {
      try {
        output = await registry.execute(name, args, allowedNames);
        recovery.onSuccess(name, args);
        console.log(`✓ ${name} 执行完成`);
      } catch (error) {
        const decision = recovery.onFailure(name, args, error);
        output = decision.output;
        stop = decision.stop;
        if (stop) stopReason = output;
        console.log(`✗ ${name}:${decision.kind}`);
      }
    }
    messages.push({ role: 'tool', tool_call_id: call.id, content: output });
  }
  return { messages, stop, stopReason };
}
我们顺着 runToolBatch 的代码,看看它是怎么把这批调用管起来的:
一上来,它先把整批调用遍历一遍,检查类型是不是都是 'function'------这叫先小人后君子,免得前面几个工具都已经改完文件了,执行到一半才发现后面混着不支持的调用类型。接着,它用 for...of 一个接一个地顺序执行 :这样一旦前面的调用触发了 stop = true,后面的调用还没启动,直接走 if (stop) 分支跳过就行。要是图快直接用 Promise.all() 把整批调用并发跑起来,那前面报错的时候,后面的命令早就已经在跑了,根本拦不住。
还有一个很关键的细节:当 call_1 触发暂停后,call_2 虽然被跳过了没执行,但程序还是会老老实实给它塞一条带对应 tool_call_id 的 tool 消息,内容写明 "本次运行已暂停,此工具调用未执行。"。为什么要补这条占位消息?因为模型接口有严格的消息配对要求:历史记录里只要有一条包含 tool_calls 的 assistant 消息,后面就必须跟上每一个 tool_call_id 对应的 tool 结果,少一个下次发请求就会报错。当然,这条占位消息只是为了凑齐格式,并不代表 call_2 执行成功了。
有了批次执行器,接下来就把它接进主循环里。打开 src/agent.ts,先在文件顶部加上这两行导入:
ts
import { RecoveryManager } from './context/recovery.ts';
import { runToolBatch } from './tool-runner.ts';
然后在已有的 CORE_SYSTEM_PROMPT 模板字符串结束反引号之前,保留原来的所有提示词,在末尾追加下面这三行规则:
text
工具失败后,结合原始日志和 Harness 恢复提示调整策略。
超时、输出溢出或写入报错后,先检查进程和文件现状,不能假定操作完全没有生效。
验证未通过时,不得把对应 TODO 标为完成;不能通过删除测试或绕过权限消除报错。
最后,把 Agent 类里的整个 run() 方法替换成下面的代码。类里的构造函数、buildSystemPrompt()、getAllowedToolNames() 以及类外的 MAX_STEPS = 30 都沿用第六篇,不用改动:
ts
async run(prompt: string): Promise<string> {
  if (this.state.getStatus() === "waiting_for_approval") {
    throw new Error("当前计划正在等待审批。");
  }

  this.session.append({
    role: "user",
    content: prompt,
  });

  // 每次 run 使用独立计数;上下文压缩不会清空本次计数。
  const recovery = new RecoveryManager();

  for (let step = 1; step <= MAX_STEPS; step += 1) {
    const memory = await this.compactor.buildWorkingMemory(this.session);
    const messages: OpenAI.Chat.Completions.ChatCompletionMessageParam[] = [
      {
        role: "system",
        content: this.buildSystemPrompt(),
      },
      ...memory,
    ];

    const allowedToolNames = this.getAllowedToolNames();
    const completion = await this.client.completeWithUsage(
      messages,
      this.registry.getDefinitions(allowedToolNames),
    );
    const message = completion.message;

    if (!message) {
      throw new Error("模型没有返回消息。");
    }

    // 拒绝不支持的调用前,不把无法配对的 assistant 消息写入历史。
    const toolCalls = message.tool_calls ?? [];
    for (const call of toolCalls) {
      if (call.type !== 'function') {
        throw new Error(`暂时不支持工具类型:${call.type}`);
      }
    }

    this.session.append(message);

    if (completion.totalTokens !== undefined && completion.totalTokens > 0) {
      this.session.saveUsage(completion.totalTokens);
    }

    if (toolCalls.length === 0) {
      this.state.finishExecution();

      return message.content ?? "模型没有返回文本内容。";
    }

    const batch = await runToolBatch(
      toolCalls, this.registry, allowedToolNames, recovery,
    );
    this.session.append(...batch.messages);
    if (batch.stop) {
      // 不调用 finishExecution:暂停不等于计划已完成。
      return `本次运行已暂停。\n${batch.stopReason}\n请检查当前文件和未完成 TODO 后再继续。`;
    }

    if (this.state.getStatus() === "waiting_for_approval") {
      const plan = this.state.getPendingPlan();

      if (!plan) {
        throw new Error("计划状态异常。");
      }

      return formatPlan(plan);
    }
  }

  throw new Error(`执行超过 ${MAX_STEPS} 轮,已停止。`);
}
别看 run() 贴出来有七八十行,其实对比上一篇,真正改动的地方就两处:
第一处:在 for 循环外面创建账本 RecoveryManager
ts
const recovery = new RecoveryManager();

for (let step = 1; step <= MAX_STEPS; step += 1) {
  // ...
注意它一定要放在 for 循环外面 (千万别手滑写进循环里,不然每跑一步账本就清零了)。这样在这 30 轮循环里,它能一直记着失败次数;等触发暂停退回终端、你输入下一句话再次调 run() 时,才会新建一个账本从 0 重新记账。
第二处:用 runToolBatch() 替换原来的内层循环,并在 batch.stop 时踩刹车
ts
const batch = await runToolBatch(
  toolCalls, this.registry, allowedToolNames, recovery,
);
this.session.append(...batch.messages);
if (batch.stop) {
  // 不调用 finishExecution:暂停不等于计划已完成。
  return `本次运行已暂停。\n${batch.stopReason}\n请检查当前文件和未完成 TODO 后再继续。`;
}
每跑完一批工具,先把所有工具结果写进 Session,紧接着看一眼 batch.stop:只要是 true,就立刻 return 跳出循环,把暂停原因打印到终端,控制权交回给你(至于入口文件 src/main.ts 一行都不用改,直接沿用上一版就行)。
6. 暂停不等于完成,也不等于回滚
为什么上面 if (batch.stop) 分支里,我们特意写了一句注释"不调用 finishExecution"?
设想一下,你的计划已经执行到了中途,刚改完文件,在跑测试时因为失败次数达到上限而暂停:
markdown
- [x] 修改 demo.txt 中的状态
- [ ] 运行测试并确认通过
- [ ] 整理修改结果
如果这时候顺手调了 this.state.finishExecution(),它会把状态从 executing 改回 idle,并把内存里的 approvedPlan 清空。这样一来,哪怕磁盘上的 PLAN.md 文件还在,下一轮调用 buildSystemPrompt() 时,系统提示词里也不会再自动带上那份已批准的计划了。
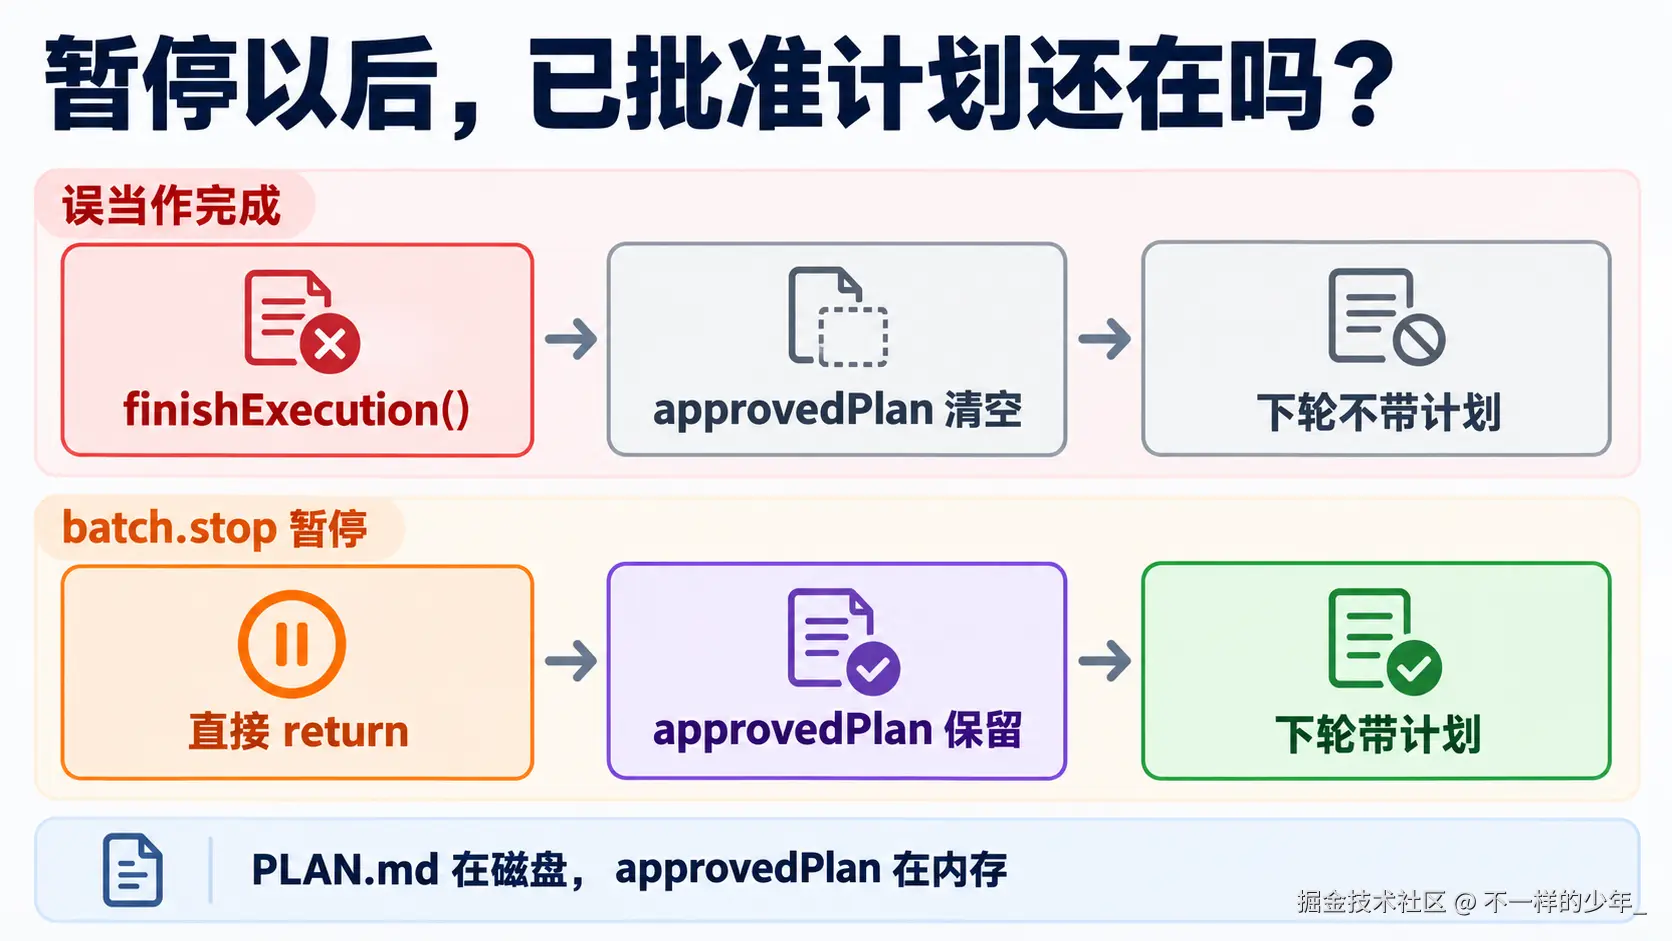
图: batch.stop 直接返回,保留内存中的批准计划,便于继续验证未完成项。
除此之外,暂停时还有两个细节要心里有数:
- 暂停不会自动回滚文件 :暂停前已经改过的文件(比如前面第一项改完的
demo.txt)会保留在磁盘上,不会自动撤回;继续之前,最好先瞄一眼工作区现状。 TODO.md打勾目前靠自觉 :执行计划时,把- [ ]改成- [x]是 Agent 自己调edit_file改的。我们在提示词里规定了"验证通过才能打勾",但程序目前还没有强制检查TODO.md有没有真做完。
动手验证
配套仓库 powercode 的根目录 src/ 下已经放好了上面改造完的最新代码和演示脚本 src/demo-recovery.ts(前 1~6 篇的归档代码放在 demos/ 目录下)。你直接在仓库根目录下执行:
bash
npm install
npm run demo
终端就会自动完成编译并跑完这两组恢复与熔断验证,输出如下:
text
> powercode@1.0.0 demo
> npm run build && node dist/demo-recovery.js

> powercode@1.0.0 build
> tsc

✗ edit_file:edit_mismatch
工具执行失败:没有找到 old_text,请先重新读取文件。
[Harness 恢复提示] 类型:edit_mismatch
先 read_file 读取最新内容,再提取准确的 old_text;不要原样重复编辑。
同一调用失败 1/3 次;本次累计失败 1/6 次。

✓ read_file 执行完成
读取结果:status=pending
✓ edit_file 执行完成
已修改文件:demo.txt
文件核验:status=done

同一调用失败 3/3 次;本次累计失败 3/6 次。
已暂停本次运行,未验证的 TODO 不能标为完成。
stop=true
总结与下一篇预告
回顾一下,这一篇我们给 powercode 补上了三道防线:
- 错误分类与恢复提示:不再只扔回冷冰冰的原始报错,而是告诉模型出了哪种错、下一步该调什么工具排查;
- 双重失败账本与批次刹车:同一调用失败满 3 次、单次运行累计失败满 6 次,或遇到权限越界时立刻暂停,并跳过同批次剩余工具;
- 保留暂停现场:暂停时不清空内存里的已批准计划,等你排查完输入新指令时还能接着往下干。
下一篇是本系列的大结局,我们会给 Agent 配上只读的 Explorer 子 Agent (让子 Agent 专门负责翻代码找线索,不污染主会话上下文),并加上完整的执行轨迹(Trace)与 Token 成本统计,敬请期待!