作者:阿里云计算平台AI搜索产品负责人 汤祯捷
2026 年云栖大会,成为过去十年最为火爆的科技盛会。而在 AI 搜索分论坛上,一个共识被反复提及:AI大模型解决了"理解与生成",但没有解决"在正确的时刻搜索到正确的信息"。
当 Agent 从单轮问答走向长任务执行,搜索的角色发生了根本变化------它不再是一个供人浏览的结果页,而是 Agent 上下文工程的供给系统。上下文是否准确、完整、可溯源,直接决定 Agent 后续的推理与行动质量。
围绕这一变化,阿里云 AI Search 产品线在本届云栖大会集中发布两条主线产品能力:
| 主线 | 产品 | 一句话定位 |
|---|---|---|
| 新引擎 | 阿里云 Elasticsearch | 成为 AI 时代 Agent 上下文的搜索基础设施 |
| 新范式 | 阿里云 OpenSearch-AgenticSearch | 定义 AI 搜索时代的信息检索新范式 |
两者一底一顶:阿里云Elasticsearch 可提供可承载亿级租户、千亿向量的上下文存储与检索底座;阿里云OpenSearch - AgenticSearch 在其上构建可运行、可记忆、可治理、可持续进化的AI搜索智能体生态。
为什么 Agent 需要一套新的搜索基础设施
在 Agentic Coding、企业知识问答、Agent 记忆等场景中,检索的目标不是"塞入更多代码或文档",而是在有限 Token 预算内找到完成任务所需的最小充分上下文。这给搜索引擎带来了三个与传统企业搜索完全不同的约束:
约束一:租户规模从"千级索引"跃升到"亿级业务空间"。 一个 AI Coding 平台要为数百万代码库分别提供隔离检索;一个企业知识库产品要为数百万 Agent 分别维护记忆空间。传统"一个租户一个索引"的建模方式在此彻底失效。
约束二:数据冷热分布极端化。 活跃工作区需要持续、低延迟地获取上下文;海量低频代码库与沉睡 Agent 记忆则需要低成本长期保存,并在再次访问时及时响应。为冷数据长期占用高性能介质,在商业上不可持续。
约束三:成本与延迟同时敏感。 检索会贯穿一次开发任务的多轮交互,单次查询的延迟与成本会被交互轮次放大,直接影响整体体验与服务毛利。
阿里云 Elasticsearch 本届云栖发布的 ES Agent 引擎版,以及围绕它的自研内核、存算分离、湖上检索、日志全链路四项引擎能力,正是对上述三个约束的系统性回答。
ES Agent 引擎版产品发布:面向 Agent 的下一代搜索引擎
产品定位
面向 RAG检索增强、AI Coding、Agent 记忆与多租户搜索 场景的云原生搜索引擎。基于对象存储的无状态多租户搜索方案,支持全文与向量混合检索,可扩展至亿级租户、千亿级向量,成本只与活跃数据线性相关,并完全兼容 Elasticsearch 生态。
核心架构:云原生存算分离 + 读写分离
引擎将索引数据、写入日志与集群状态统一保存在对象存储(OpenStore)中,持久性不低于 11 个 9,计算节点无本地持久状态。计算层拆分为两类可独立扩缩的节点:
| 节点类型 | 职责 | 独立扩缩价值 |
|---|---|---|
| Index 节点 | 文档写入、Translog 持久化、索引构建、后台合并 | 写入洪峰不影响在线查询 |
| Search 节点 | 全文/向量/过滤/聚合查询,本地磁盘作缓存 | 查询扩容无需搬迁数据 |
由此带来三项工程收益:写入与查询资源互不干扰地独立扩展 ;节点故障秒级恢复 ------新节点直接从对象存储恢复,无需完整数据搬迁;按需缓存------热数据本地缓存毫秒级响应,冷数据按需从对象存储加载,非活跃数据不再产生计算成本。
Collection / Slice:亿级业务空间的统一抽象
这是 Agent 引擎版最关键的建模创新:
-
Collection(集合):应用访问数据的统一入口,角色类似传统 ES 的 Index Name。
-
Slice(切片):Collection 内的逻辑数据空间,每个 Slice 代表一个独立业务单元------一个知识库、一个代码仓库、一个 Agent,或一个租户。
读写时指定 Collection 名称并通过 Slice 标识业务空间,底层索引与分片由平台自动管理,应用无需维护底层索引名称。其带来的直接效果是:
-
全局规模不成为单次查询负担------查询限定在目标 Slice 内,只触达当前业务空间的数据;
-
成本天然隔离------单租户查询成本仅取决于其自身活跃数据量,沉睡租户不消耗计算与缓存资源,仅产生对象存储费用;
-
亿级 Slice 统一管理------应用无需为每个租户单独创建索引或维护表结构。
DiskBBQ:基于磁盘原生向量索引
Agent 引擎版采用 DiskBBQ 作为向量检索算法,通过分层 K-means 聚簇 + BBQ 量化,实现 IO 可预测的 kNN 查询:
-
内存友好:不要求向量常驻内存,天然适配 SSD 缓存与对象存储分层;
-
构建更快:相比 HNSW,索引构建速度提升约一个数量级;
-
退化平滑:在内存受限时性能平滑退化,而非断崖式下跌------这是大规模多租户场景下可用性的关键。
售卖形态与兼容性
完整兼容 Elasticsearch 生态:REST API、Query DSL、kNN、过滤与聚合,支持官方 Python / Java / Go / JS 客户端及 Kibana。计费采用Elasticsearch PaaS 模式,计算与存储解耦:
| 计费项 | 方式 |
|---|---|
| 计算 | Search 节点 + Index 节点 + 缓存盘,按实例规格与节点数量计费 |
| 存储 | 对象存储(OpenStore)按量付费,0.15 元/GB/月,无需预配容量 |
适用应用场景
| 场景 | 建议的 Slice 划分 | 核心价值 |
|---|---|---|
| 企业知识库与 RAG | 每个知识库一个 Slice | 一个 Collection 统一管理亿级知识库;活跃库毫秒响应,沉睡库仅产生存储费 |
| AI Coding 与代码搜索 | 每个代码仓库/项目一个 Slice | 代码提交后秒级可搜索;开发者实时检索不受批量写入影响 |
| Agent 记忆 | 按租户、Agent 或记忆空间划分 Slice | 实时写入即可查;大量沉睡 Agent 记忆不消耗计算与缓存 |
| 多租户搜索服务 | 每个租户一个 Slice | 平台管理底层索引,租户数据物理聚簇,成本按租户自洽 |
该产品尤其适合企业客户AI应用场景:法律、金融、医疗等垂域头部知识库,AI Coding 代码检索,超大型企业内部文档检索------数据量足够大、租户数量足够多、数据天然带冷热的场景,是 Agent 引擎版价值最大化的区间。
FalconSeek 2.0:自研 C++ Native 全栈检索内核,性能提升 600+%
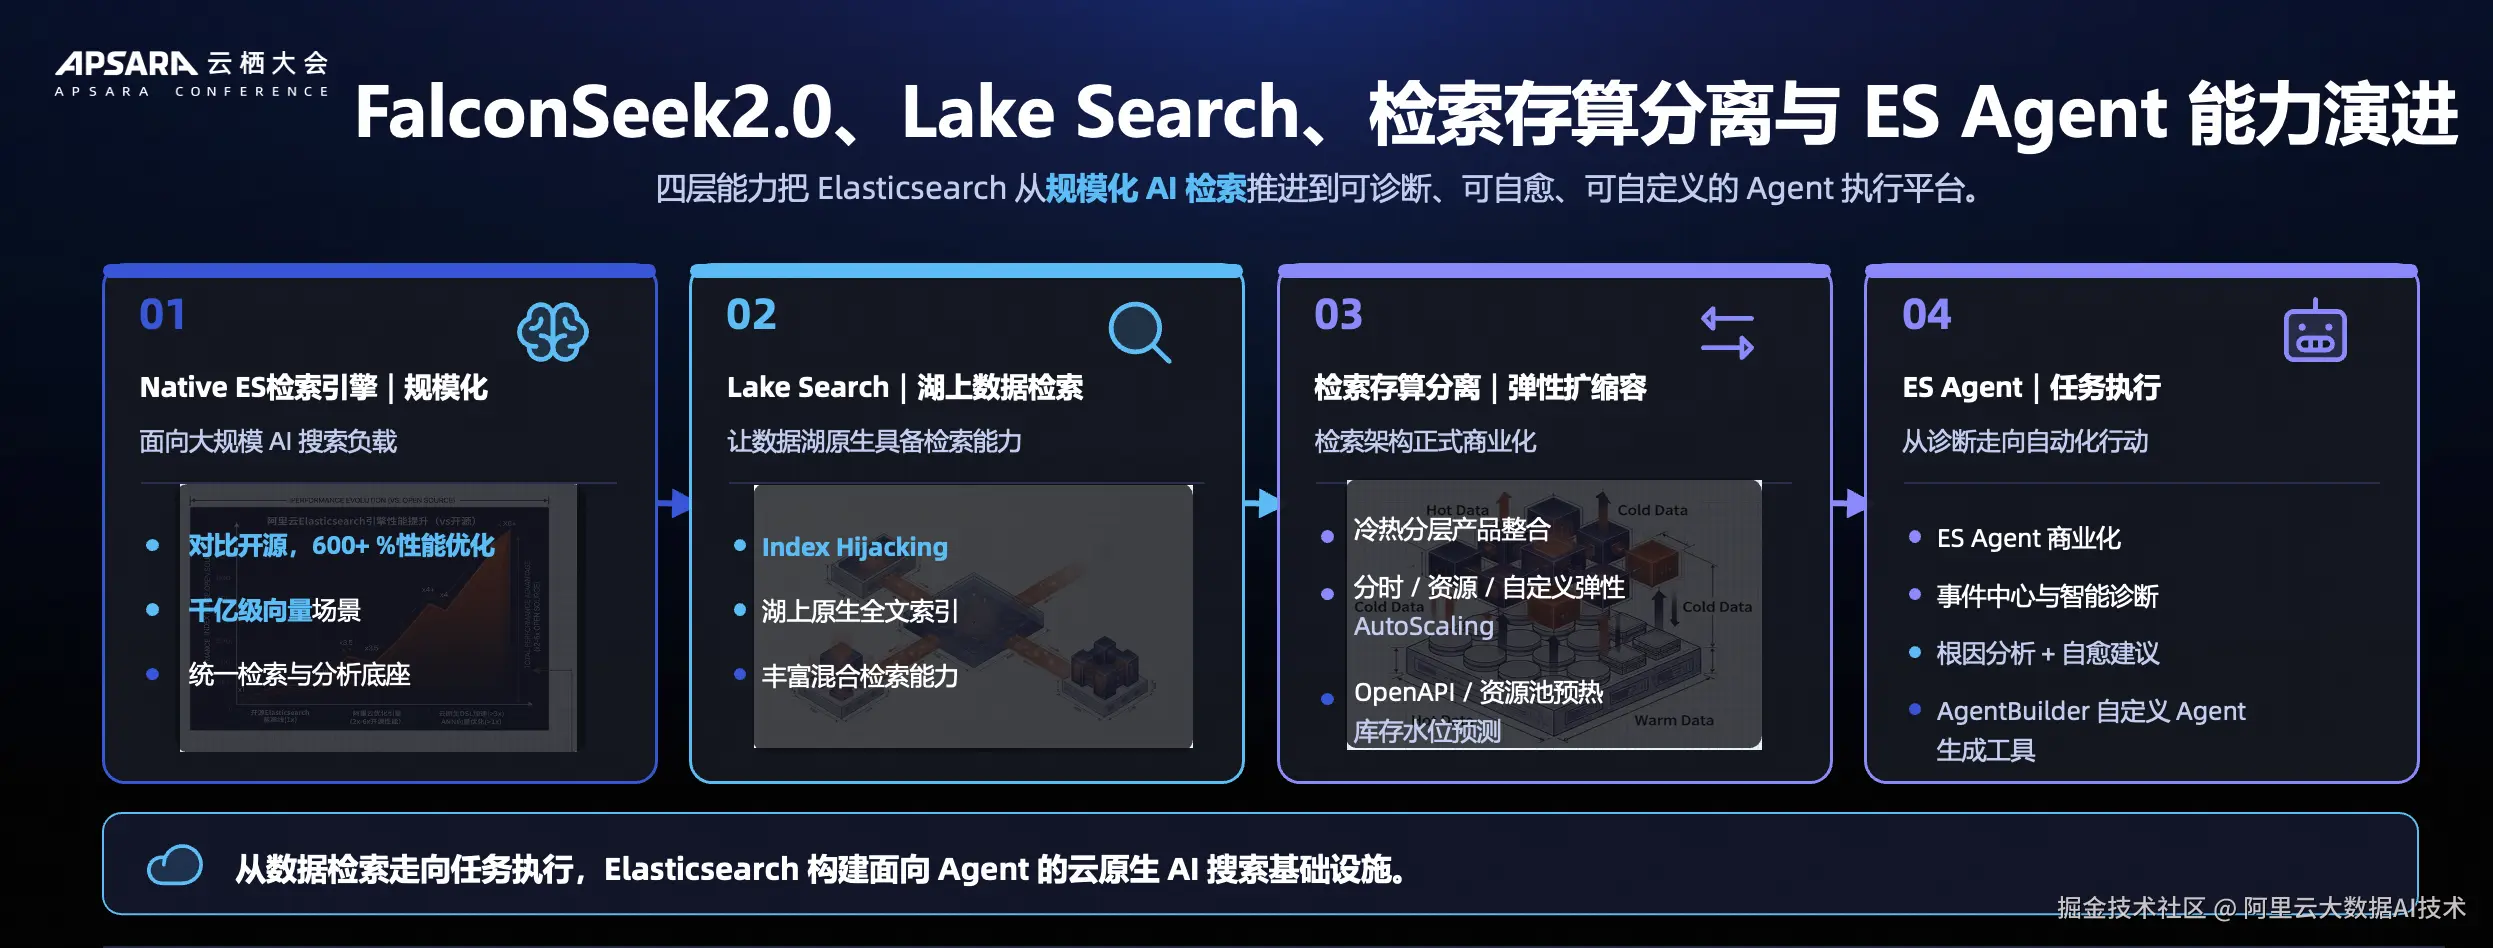
问题背景
当数据规模飙升至千亿级、并发达到高 QPS 时,传统Java JVM 查询链路的执行开销会不断放大,逐渐成为系统性能瓶颈。FalconSeek 通过 C++ Native 内核接管查询执行、重构公共热路径,精准攻克这一瓶颈。
设计思路:不替换 ES,而是下沉热路径
FalconSeek 是专为加速查询与千亿向量检索而生的云原生C++引擎内核。它的核心思路不是替换 Elasticsearch,而是 在完整保留 ES 兼容入口的前提下,将查询热路径下沉到阿里自研的高性能 C Native 检索内核 ------包括倒排遍历、列式读取、排序聚合与向量召回。
这一设计选择的意义在于:客户无需重写查询、无需更换客户端、无需重构生态,即可获得数量级的性能跃迁。
产品优势
-
极速检索性能:查询执行大幅提速,直接缩短响应时间并提升吞吐量;
-
极致降本:单位请求消耗的 CPU 与临时内存开销显著减少,释放巨大规格优化空间;
-
极高稳定性:查询线程占用、GC 干扰及长尾抖动(P99)全面下降,高峰期服务稳如磐石。
这些优化不仅缩短延迟,更直接转化为降本红利:在满足相同 QPS 目标下,集群可缩减节点数量或降低规格;在资源不变时,则可承载数倍并发。
适用应用场景
| 场景 | 典型负载 | 优化效果 |
|---|---|---|
| 高频轻量过滤 | Term / Filter / Count | 节省大量 CPU 算力,降低高 QPS 下的耗时 |
| 在线复杂检索 | Range / 排序 / 分页 | 极速扫描,消除高并发下的查询排队 |
| 高基数聚合 | Terms / Composite | 批量读取 DocValues,极大减轻 JVM 压力 |
| 超大规模向量检索 | kNN 召回 | Native 索引配合聚类选路,加速千亿向量召回 |
标杆案例:头部大模型平台应用ES - 900 亿向量全量查询,QPS 3000+,单查询秒级返回,支持 10 万聚类的分类查询。
Lake Search on DLF湖仓搜索:ES × Paimon 在离线一体湖上检索
问题背景
当图片、视频、文本和向量在 Apache Paimon 中增长到 PB 级,传统"同步到湖外再建索引"的方式会让搜索面临三重困境:数据就绪慢、事实数据成本高、版本治理复杂。
产品方案
阿里云 Elasticsearch 9.4 Lake Search 直接挂载与 Paimon 表版本关联的 Global Index ,在不复制事实数据 的前提下,提供 BM25、kNN、结构化过滤、排序与聚合能力,实现高性价比的 Paimon × Elasticsearch 湖仓检索------从"原始数据共享"进化到"索引共享"。
该方案已与 EMR Spark → Paimon → Elasticsearch 的完整链路打通并提供端到端 Demo,性能对比对象为 主流开源方案, Paimon Vector + StarRocks 以及 Milvus等。
OpenStore 存算分离 + Serverless 弹性:变更更快、迁移更稳、资源更省
从存算一体到存算分离,阿里云 Elasticsearch 采用同一套存储架构 OpenStore,针对日志与检索场景分别以 OSS / DFS 作为底层支持。结合智能多级缓存,实现资源池化、Serverless 弹性与存算分离。
本届云栖发布 Serverless 弹性扩缩容能力,包含两种形态:
-
分时弹性扩缩容:按可预期的业务波峰波谷定时扩缩,适合有明确潮汐规律的检索与日志业务;
-
自动弹性扩缩容:按实时负载自动扩缩,适合流量不可预测的在线业务。
产品优势 :资源池化、Serverless 弹性、存算分离后,结合 FalconSeek 实现相比用户自建 30% 以上的资源节约。
标杆案例 :DFS 场景互联网头部客户应用,变更速度提升 100 倍,存储降本 40%。
日志检索端到端解决方案:面向 Agent 的可观测建设
阿里云 Elasticsearch 新版本推出日志采集与加工服务,将多源接入、流量缓冲、数据加工与可靠投递整合为云上托管能力,并与已有的写入优化、低成本存储、高性能查询能力形成完整链路。
端到端方案覆盖三段:
-
采集:OTel 标准化采集,多源统一接入;
-
引擎:高性价比读写存算分离引擎,承载海量日志的写入与检索;
-
消费 :面向 Agent 的可观测建设------让日志与可观测数据成为 Agent 可检索、可推理的上下文来源,而非仅供人查看的仪表盘。
第三段是本届发布的重点方向:使用ES Agent 可智能运维完成告警根因定位、容量规划与慢查询优化时,可观测数据的检索质量直接决定诊断质量。
ES AI 新特性发布
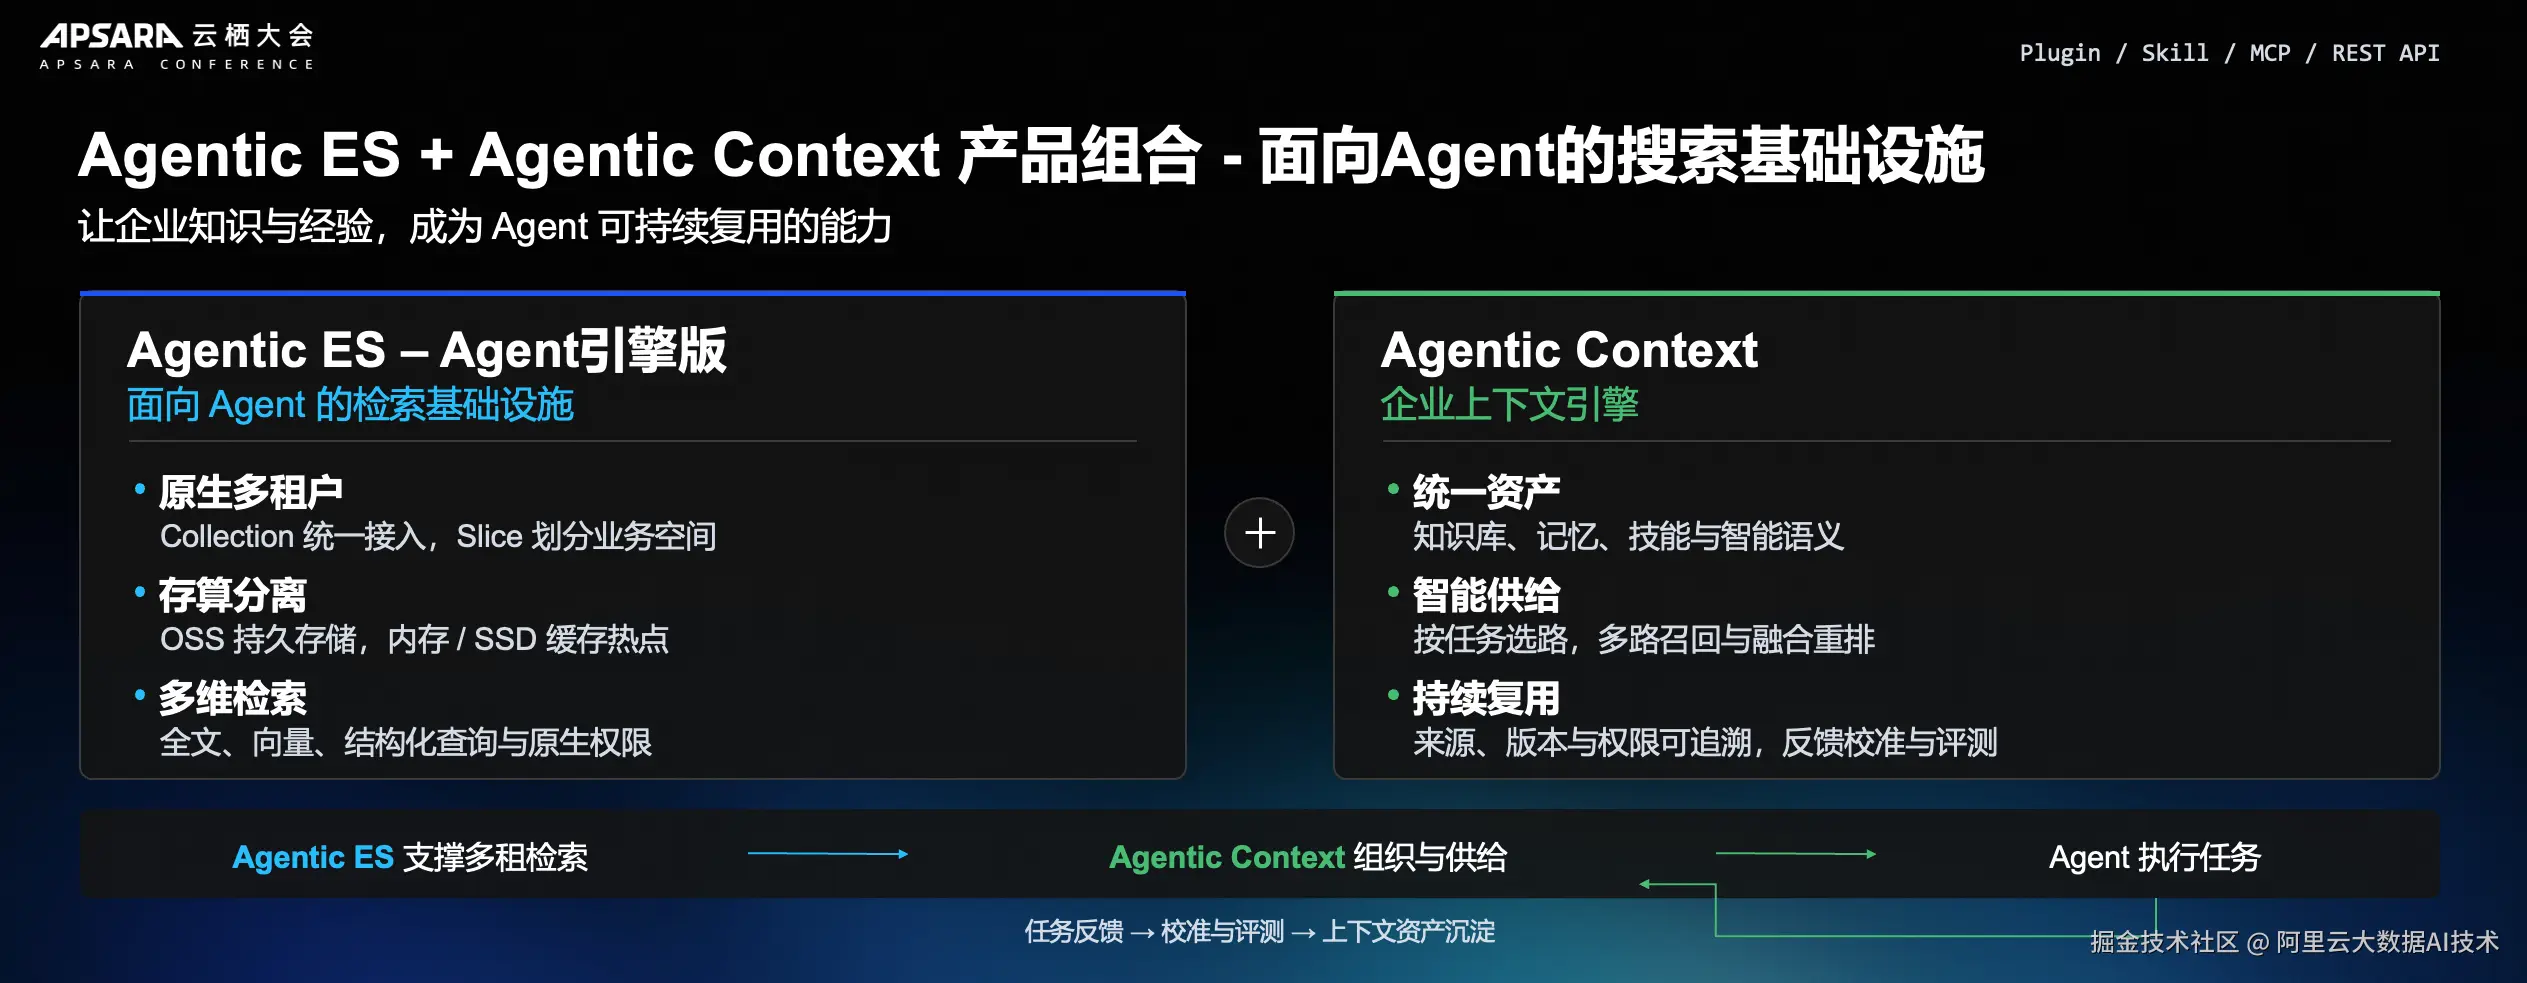
ES AI领域 首先全新发布 Agentic ES + Agentic Context 产品组合,我们希望让企业知识与经验,成为 Agent 可持续复用的能力。企业已经积累了大量文档、数据和工作方法,但要让 Agent在真实业务中持续使用这些资产,还需要把可扩展的检索基础设施,与上下文的组织、维护和供给连接起来。
Agentic ES 是 Agent引擎版的产品扩展形态,面向 Agent 提供检索基础设施,通过 Collection 统一接入,使用 Slice 划分业务空间;在存算分离架构下,用 OSS 做持久存储,用内存和 SSD 缓存热点。同时,全文、向量和结构化查询,以及原生权限,为上层按业务需要获取信息提供支撑。这里介绍的是能力分工,不把某个客户案例的性能或成本结果扩展为所有场景的承诺。
AgenticContext是基于Elasticsearch企业上下文引擎。它统一组织知识库、记忆、技能和智能语义,根据当前任务选路,通过多路召回和融合重排供给上下文。记忆沉淀事实、偏好与经历,技能沉淀可复用的行动方法,两类资产承担不同职责。来源、版本与权限帮助使用者核对依据,并在授权范围内复用企业经验。
Agentic ES 检索底座可支撑海量Agent上下文的获取,Context上下文引擎组织与供给信息,Agent 在任务中使用,并将反馈带回校准、评测和资产维护。通过 Plugin、Skill、MCP 或 REST API接入,这个组合把一次任务的知识使用,与后续任务的经验复用连接起来。
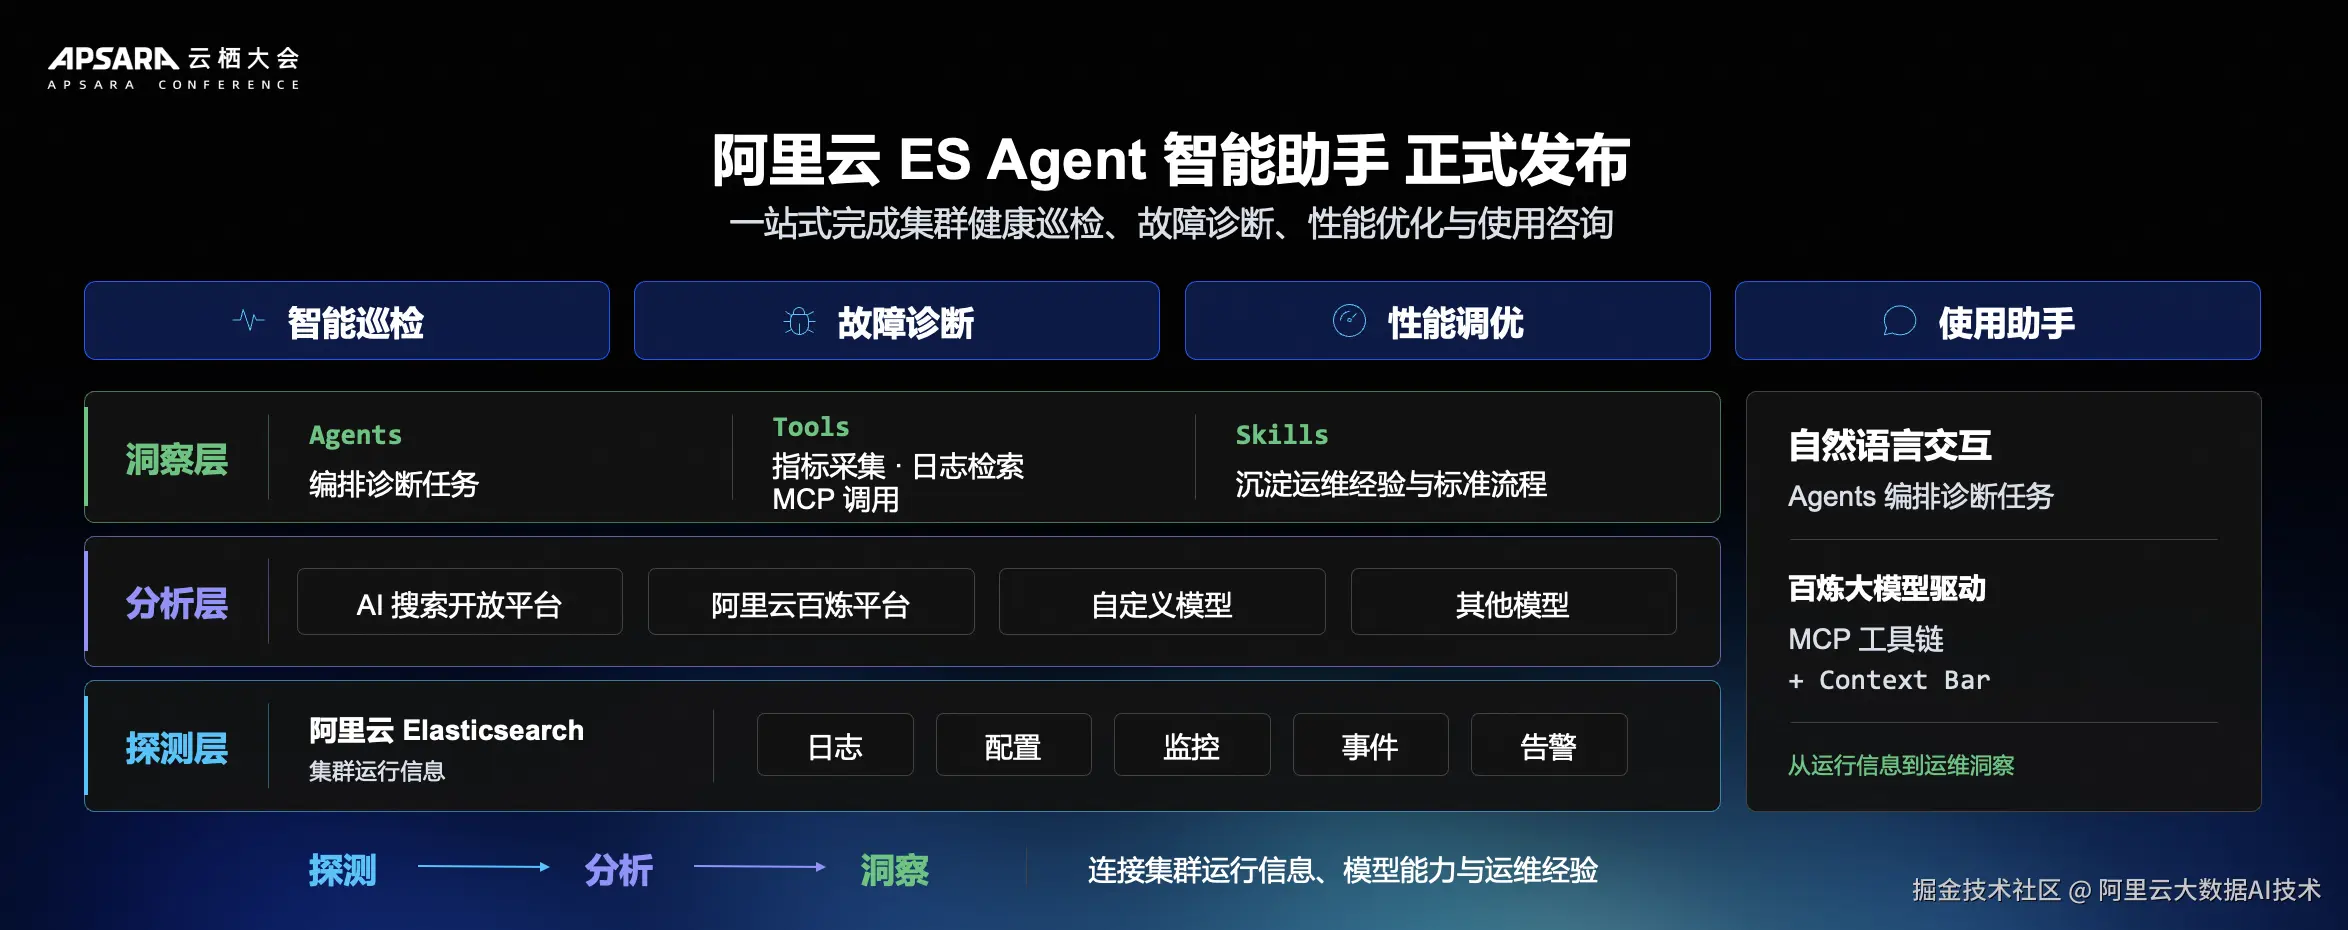
ES AI领域的另一个发布是阿里云 ES Agent智能助手,把集群健康巡检、故障诊断、性能优化和使用咨询放到统一的自然语言交互入口中。可以应用于四个场景对应用户最常见的运维需求,这些能力如何由集群信息、模型分析和运维经验共同支撑。
从底部的探测层向上看。Elasticsearch Agent 支持获取日志、配置、监控、事件和告警构成分析所需的运行信息。分析层连接 AI 搜索开放平台、阿里云百炼平台以及自定义和其他模型,为诊断提供分析能力。既包含平台,也包含模型,分别承担接入与分析支撑的角色。洞察层进一步把分析组织成诊断任务。Agents负责任务编排,Tools 提供指标采集、日志检索和 MCP 调用,Skills则承载沉淀下来的运维经验与标准流程。三者结合,使诊断过程能够围绕具体问题调用工具,并参考已有的方法与经验,而不是只给出一段通用解释。
生产级落地实践:Qoder × 阿里云 Elasticsearch 深度应用
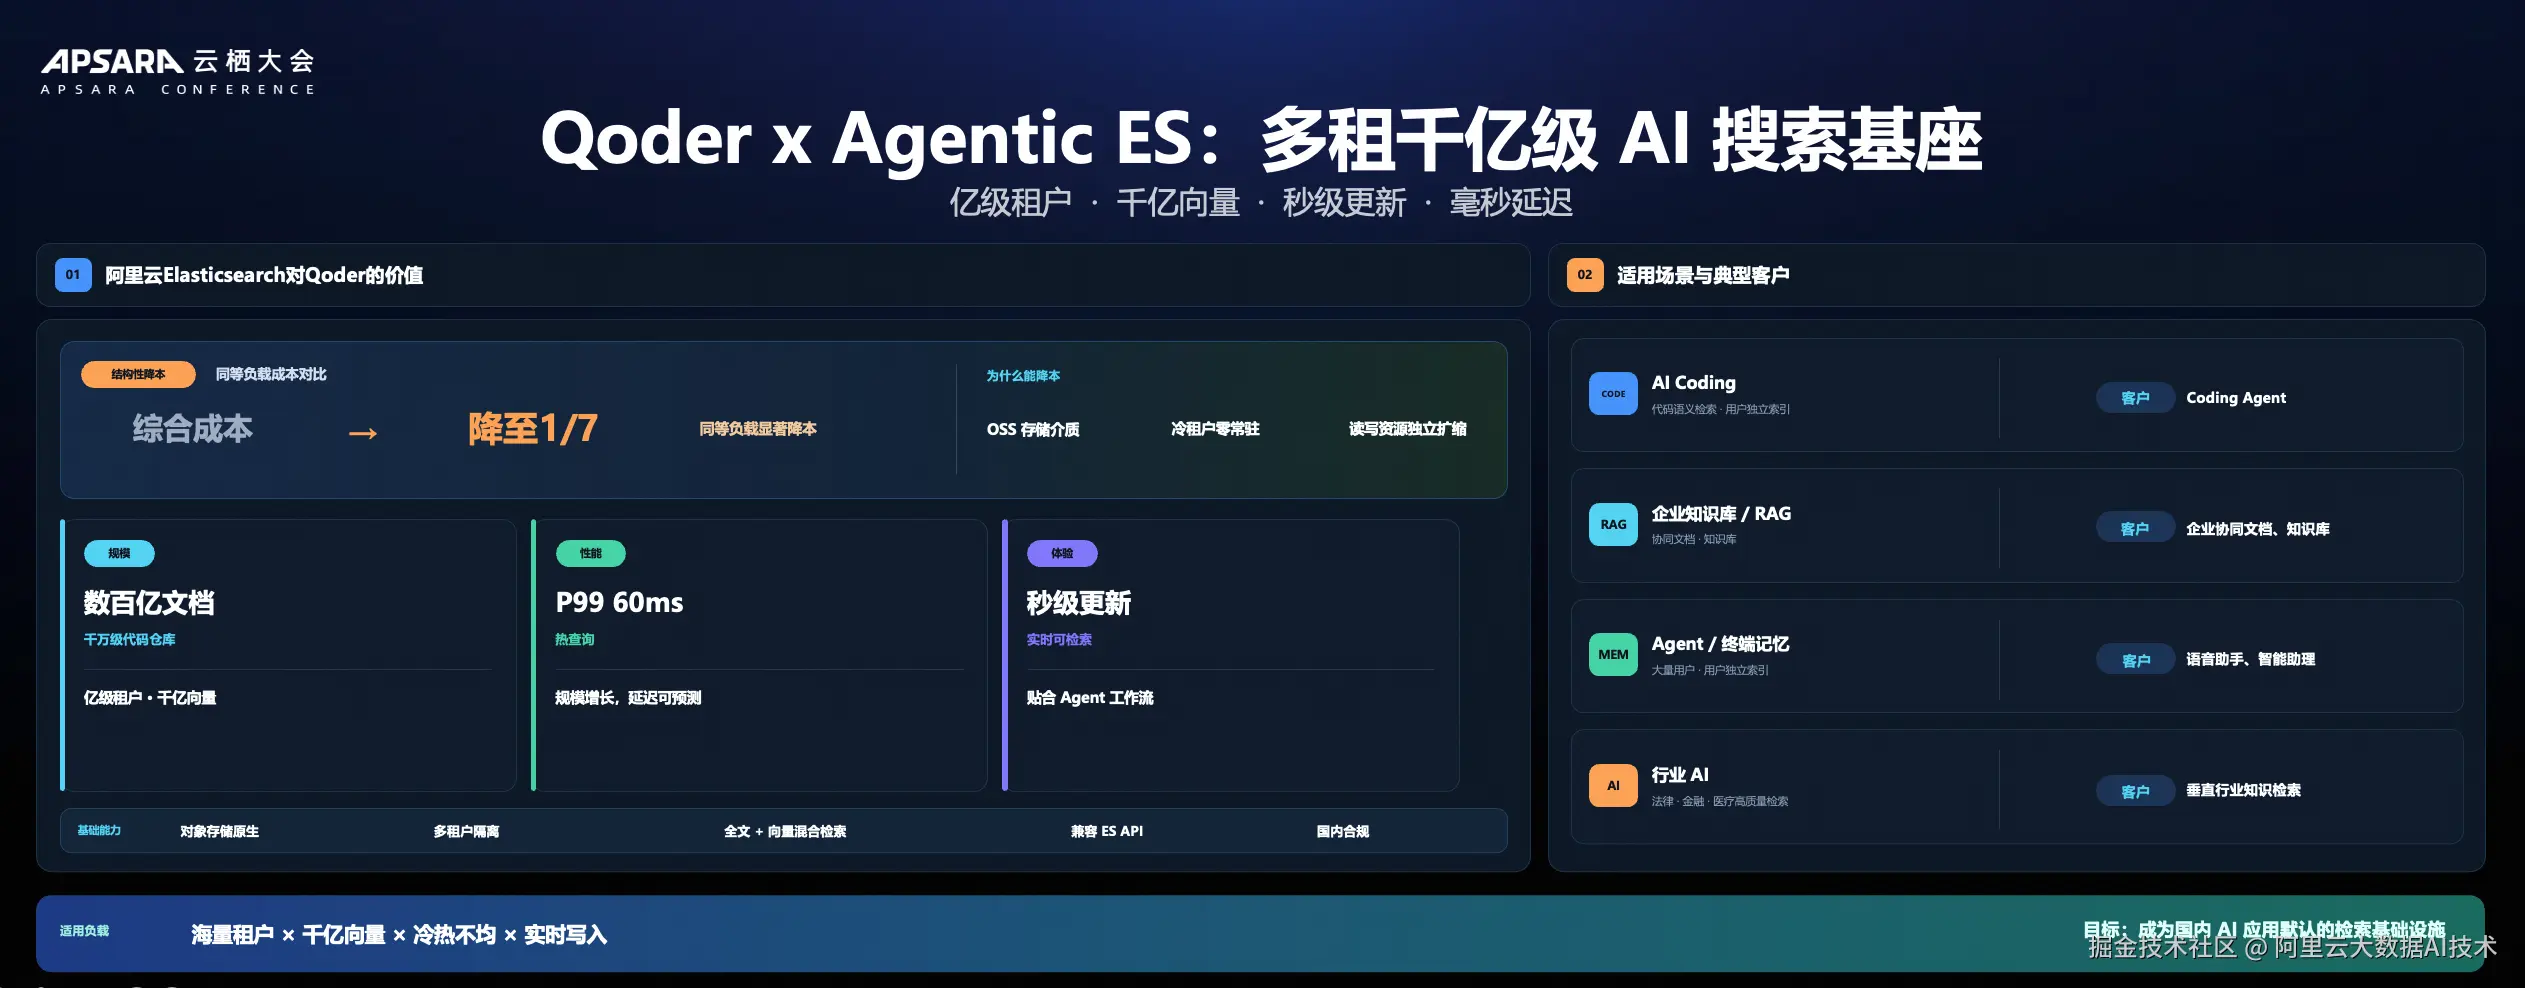
云栖大会分享 Qoder × Elasticsearch 的最佳实践。Agentic ES 作为面向代码检索、企业知识库与智能体记忆,构建多租户 AI 搜索底座。依托 OSS 存储、冷租户零常驻和读写独立扩缩容,承载亿级租户、千亿向量,支持秒级更新、全文与向量混合检索,兼容 ES API。按图示同等负载口径,综合成本降至对比方案的 1/7,热查询 P99 为 60ms,兼顾大规模检索的成本、性能与实时性。
阿里云AI搜索产品Elasticsearch云栖发布
| 时间 | 产品分类 | 核心能力 | 版本支持 | 官网文档材料 |
|---|---|---|---|---|
| 新引擎 | 阿里云 Elasticsearch | ES Agent 引擎版 | Agent 引擎版 9.x 版本 | * ES Agent 引擎版 · 功能概述 * ES Agent 引擎版 · 使用指南 |
| FalconSeek 2.0 全栈自研引擎 | 9.4 / 8.17 | * 使用 FalconSeek 云原生内核加速 Elasticsearch 查询 * FalconSeek 向量索引使用指南 | ||
| OpenStore存算分离+弹性扩缩容 | 9.4 / 8.17 | * OpenStore存算分离 * 弹性扩缩容 | ||
| Lake Search湖仓搜索 | 9.4 | 使用 Elasticsearch 查询 Paimon 湖表数据(Lake Search) | ||
| 日志检索端到端解决方案 | 全系列 | 日志采集与加工服务 | ||
| ES + AI:ES Agent智能助手 | 全系列 | ES Agent智能助手 | ||
| ES + AI:ES 知识引擎/上下文引擎 | 9.4 / 8.17 | 企业知识引擎 | ||
| ES + AI:ES 多模态搜索 | 9.4 / 8.17 | ES多模态搜索 | ||
| AWS OpenSearch迁移至阿里云Elasticsearch | 全系列 | 从 AWS OpenSearch 迁移索引至阿里云 Elasticsearch | ||
| 阿里云 Elasticsearch 行业最佳实践 | Qoder x Elasticsearch 最佳实践 | Agent 引擎版 9.x 版本 | 云栖实录|从代码上下文到千亿级文档:Qoder × 阿里云 Elasticsearch 落地生产级Agent向量检索 | |
| ES AgentBuilder - RAG检索增强 / 知识库构建 | 9.4 / 8.17 | AI Search × ES Agent Builder 最佳实践:企业智能助手落地指南 |