导语 :Redis ZSet 是"最像业务中间件"的类型:排行榜、延迟队列、滑动窗口限流、热搜榜、时间线、多维交集运算都能用它撑。很多人把它当成"带分数的 Set",结果在延迟队列里轮询打满 CPU,在排行榜里被
ZRANGE 0 -1拖垮主线程,在滑动窗口里因为非原子的ZCARD + ZADD超发请求。
它和 List 的根本区别:List 的序是插入顺序,ZSet 的序是分值顺序 。这一字之差,决定了 List 只能做队列和时间线,而 ZSet 能做排行榜、延迟队列、限流窗口、优先级调度------因为只有 ZSet 允许你"给每个元素打一个可以随时改的分数,并让集合自动按这个分数重排"。但能力越大,藏的东西越多:ZADD 覆盖分数会把历史最高分刷成最新分;毫秒时间戳乘系数拼随机数会逼近 double 精度上限;ZCARD + ZADD 两步非原子会超发;ZRANGE 0 -1 会把实例拉爆。
0.1 ZSet 在 Redis 体系中的定位
Redis 的 ZSet 是**唯一一个"同时按分值有序、又支持按成员 O(1) 定位"**的类型。一个 key 最多可装 2³² − 1 个成员,每个成员关联一个双精度浮点 score。把基础数据结构按"使用频率"和"不可替代性"排序,ZSet 稳居前三:String 能缓存、Hash 能存对象、List 能排队,但"既要元素唯一、又要按一个可变的分数自动排序、还要能 O(log N) 取下标"------这个组合能力,Redis 里只有 ZSet 有。
它的核心价值不在"存",而在**"用 score 表达业务语义"**:
- score 是分数/权重 → 排行榜、热搜;
- score 是时间戳 → 延迟队列、时间线;
- score 是请求时间 → 滑动窗口限流、热点监测;
- score 是优先级 → 优先级队列;
- score 是热度衰减值 → 热度榜、推荐排序;
- score 统一为 0,成员按字典序排列 → 自动补全、前缀搜索。
ZSet 的"有序"不是附带特性,而是整个类型的设计中心。需要无序去重用 Set,需要字段级读写用 Hash,需要简单队列用 List,需要"某个东西按某个维度排序"时,ZSet 才是正解。但它也是最"贵"的基础类型:内部同时维护跳表 + 字典两套结构,一个成员要占两份内存。
0.2 复杂度分层:三档代价
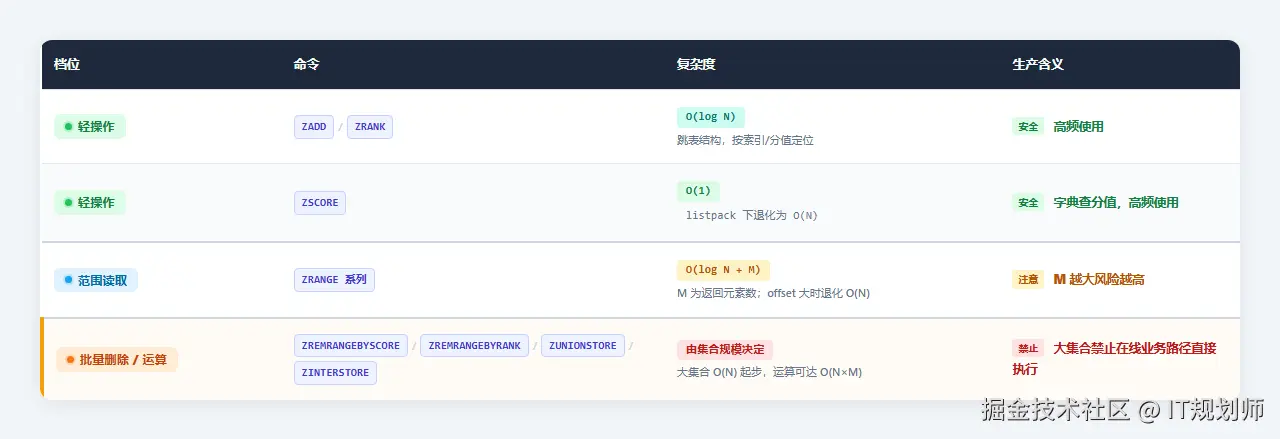
一句话:ZSCORE 是 O(1)(字典),但 ZRANK 是 O(log N)(跳表数跨度)------"我的排名"接口比"我的分数"接口贵得多。
0.3 三个把"用个 ZSet 而已"变成线上故障的现象
- 延迟队列轮询打满 CPU :消费者
while(true)疯狂ZRANGEBYSCORE,无 sleep,低峰看不出,大促把 Redis QPS 推到 8 万。 - 排行榜
ZRANGE 0 -1拖垮实例:50 万成员一次全量返回,单线程序列化期间其他命令排队。 - 滑动窗口限流超发 :
ZCARD判断 +ZADD记录两步非原子,两个并发请求同时读到 99 都放行,窗口内变 101。
这三个现象指向同一件事:ZSet 的坑不在"用不用",而在"轮询有没有退避、范围读取有没有限界、多步操作有没有原子性"。
0.4 开发者最反直觉的三条认知
- ZSet 不只有 skiplist 一种编码。 成员少且短时走
listpack(7.0+),此时ZSCORE/ZRANGE可能是 O(N) 线性扫描,不是 O(log N)。误以为"ZSet 永远 O(log N)",在阈值被调大的实例上会得到意外延迟。 ZRANGE key 0 -1是排名范围,不是分值范围。 按分值查要用ZRANGE ... BYSCORE。写错会返回意料之外的结果。- 分值是 double,精确整数上限约 2^53。 毫秒时间戳安全,但"毫秒时间戳 × 系数 + 随机数"的复合值一旦超过 2^53,相邻分值会被舍入成同一个 double,
ZRANGEBYSCORE漏任务,跑几个月才暴露。
一、核心命令语义与 API
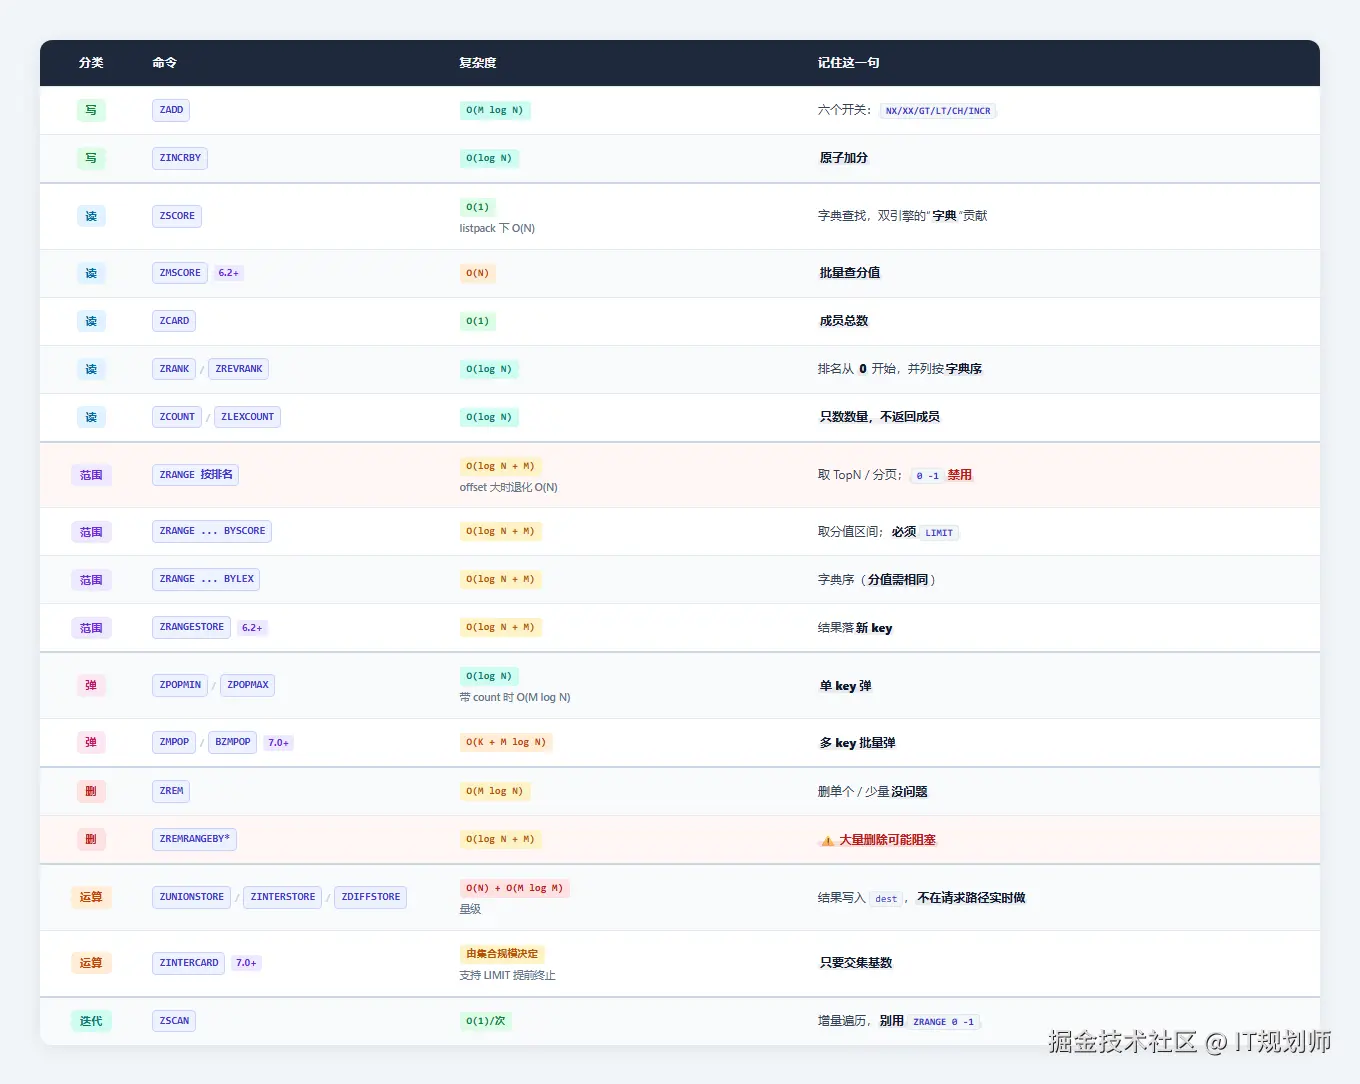
ZSet 命令可分成四类:写入更新 (ZADD/ZINCRBY)、读取查询 (ZSCORE/ZRANK/ZRANGE)、删除弹出 (ZREM/ZREMRANGE*/ZPOPMIN/ZMPOP)、集合运算与遍历 (ZUNIONSTORE/ZINTERSTORE/ZINTERCARD/ZSCAN)。
1.1 写入与更新:ZADD 的六个开关 / ZINCRBY
text
ZADD key [NX | XX] [GT | LT] [CH] [INCR] score member [score member ...]六个可选开关,两两配合能表达一整套条件写入语义:
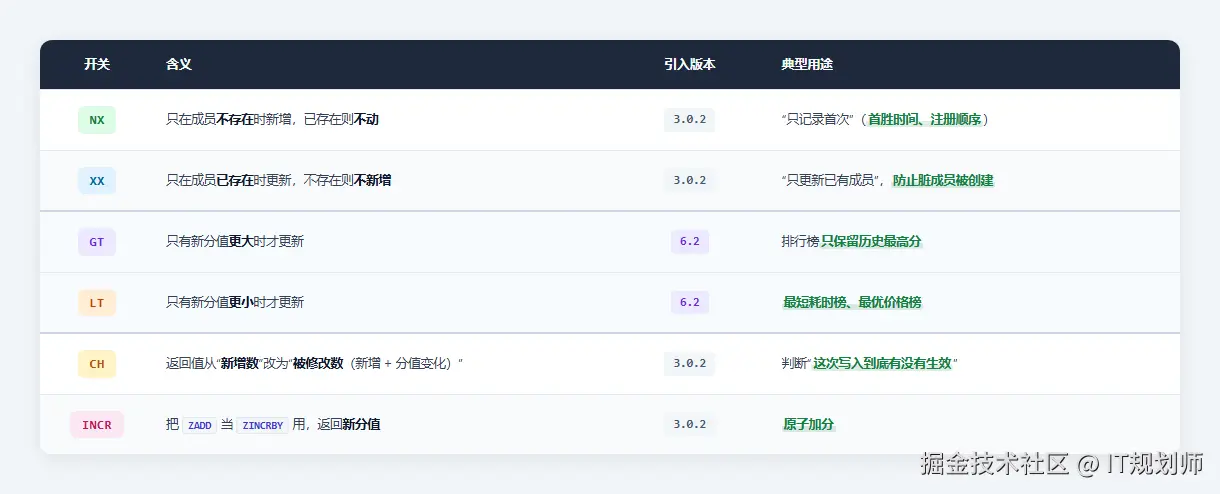
必须记牢:
NX与GT/LT互斥,同时出现直接报错。GT/LT在成员不存在时,仍然会新增 。它只约束"已存在成员的更新条件",不约束"新增"。要"只更新不新增"用XX GT。- 分值相等不算"更大"或"更小" ,
GT/LT都不会触发更新。 - 默认返回值是"新增成员数" ,不是"修改成员数"。改了分数但没新增时返回
0,容易被误判成"没写进去"------需要判断生效情况就加CH。
ZINCRBY key increment member:对 score 做原子增减,返回新 score。它和 ZADD INCR 等价,但不支持 NX/XX/GT/LT,适合纯粹的计数器场景。
redis
# 排行榜:只保留历史最高分(GT 把"读-比-写"压缩成一条原子命令)
# player:1 不存在 → 新增
ZADD game:rank GT 1200 player:1
# 900 < 1200 → 不更新(返回 0)
ZADD game:rank GT 900  player:1
# 1500 > 1200 → 更新
ZADD game:rank GT 1500 player:1

# 最短耗时榜:只记录更小值(LT)
# 只保留更快的那次
ZADD api:latency LT 88  api:/order

# 只更新已有成员,且要更大的分(XX + GT)
# 返回 1(CH 下返回被修改数)
ZADD game:rank XX GT CH 1600 player:1

# 原子加分:ZADD ... INCR 等价于 ZINCRBY
# 返回新分值
ZADD counter:score INCR 5 player:1
csharp
using StackExchange.Redis;

// redis 为 ConnectionMultiplexer 实例(连接池),db 取其默认数据库句柄
var db = redis.GetDatabase();

// ZADD 单值:返回 bool,true = 新增了成员,false = 成员已存在
bool added = await db.SortedSetAddAsync("ranking", "u1", 100);

// ZADD 多值:返回 long = 本次新增的成员个数
long addedCount = await db.SortedSetAddAsync("ranking", new SortedSetEntry[]
{
    new("u1", 100),
    new("u2", 200)
});

// ZADD NX / XX 有枚举对应
// NX:仅在成员不存在时新增
await db.SortedSetAddAsync("ranking", "u1", 300, When.NotExists);
// XX:仅在成员已存在时更新
await db.SortedSetAddAsync("ranking", "u1", 300, When.Exists);

// ZADD GT / LT 无枚举封装,用 ExecuteAsync 走原始命令
await db.ExecuteAsync("ZADD", "game:rank", "GT", "CH", "1200", "player:1");

// 原子加分:ZINCRBY
double newScore = await db.SortedSetIncrementAsync("ranking", "u3", 10);
💡
GT是排行榜的"防倒退"神器 。不用它,你得先ZSCORE读旧分、应用层比较、再ZADD写回------三步之间用户的高分可能被别的请求覆盖。GT把这三步变成一条原子命令,去掉竞态窗口和一次网络往返。
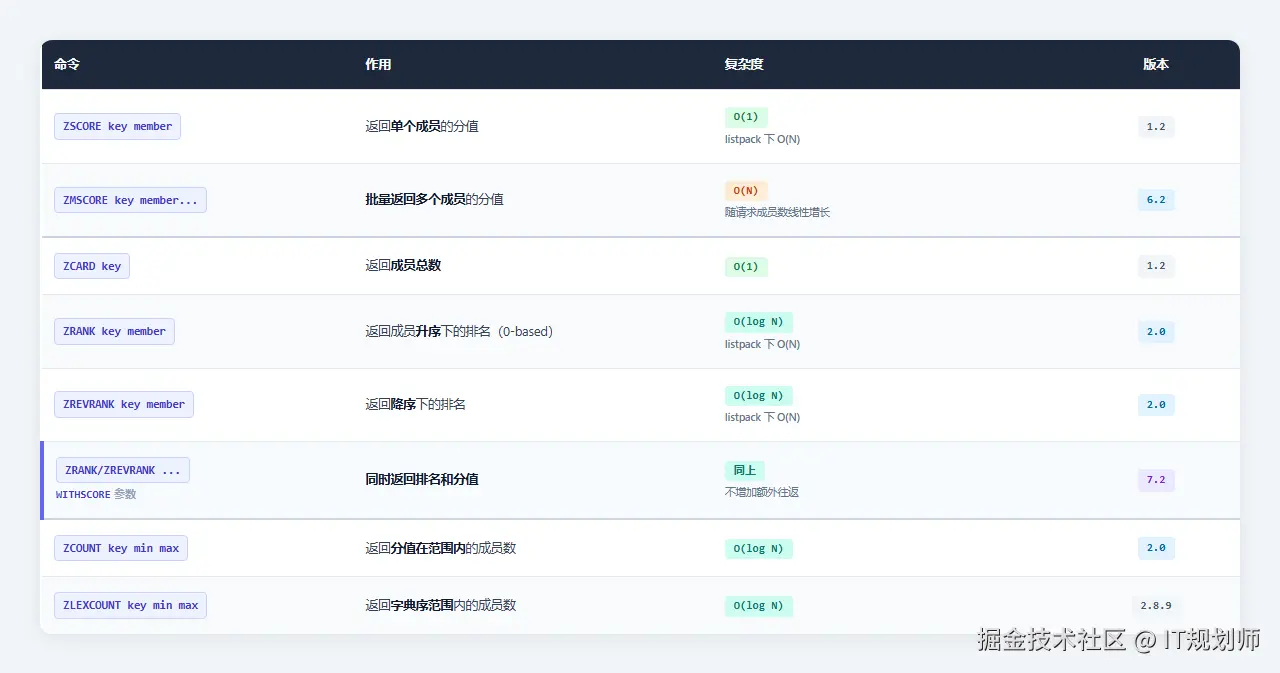
1.2 读取:ZSCORE / ZCARD / ZRANK / ZREVRANK / ZCOUNT / ZMSCORE
redis
# "我的排名":排行榜里每个用户最关心的就是这两个数
# 降序排名(第几名)
ZREVRANK game:rank player:1
# 分值
ZSCORE   game:rank player:1

# 7.2+ 一条命令同时拿到排名和分数
ZREVRANK game:rank player:1 WITHSCORE

# 批量查多个用户的分数(避免 N 次往返)
ZMSCORE game:rank player:1 player:2 player:3
csharp
// 查降序排名(成员不存在返回 null,别当 0)
long? rank = await db.SortedSetRankAsync("ranking", "u1", Order.Descending);
// 查分值(成员不存在返回 null)
double? score = await db.SortedSetScoreAsync("ranking", "u1");
// 查成员总数
long card = await db.SortedSetLengthAsync("ranking");

// 7.2+ 一条命令同时拿排名和分数(旧版 SDK 未封装,走原始命令)
var res = await db.ExecuteAsync("ZREVRANK", "game:rank", "player:1", "WITHSCORE");
关键语义:
ZSCORE在 skiplist + dict 编码下是 O(1) (字典贡献);listpack编码下是线性扫描 O(N)。ZRANK必须走跳表数跨度,O(log N)。ZRANK/ZREVRANK返回的是排名(从 0 开始),不是 score。并列 score 的排名由成员字典序决定,不是"并列名次"。需要"并列排名"要在应用层处理。ZRANK返回long?------成员不存在时返回nil,映射到 C# 是null。很多"我的排名"接口 bug 出在这里:忘了判空,把null当0,结果"没上榜的用户"显示成"第 0 名"。ZCOUNT是 O(log N) ,只数数量不返回成员;既要数量又要成员用ZRANGEBYSCORE ... WITHSCORES,注意 M 的大小。
1.3 范围读取:ZRANGE 家族的三种模式
ZRANGE 在 6.2 之后统一了所有范围查询 (ZRANGEBYSCORE/ZREVRANGEBYSCORE/ZRANGEBYLEX/ZREVRANGEBYLEX 的功能全部并入 ZRANGE):
text
ZRANGE key start stop [BYSCORE | BYLEX] [REV] [LIMIT offset count] [WITHSCORES]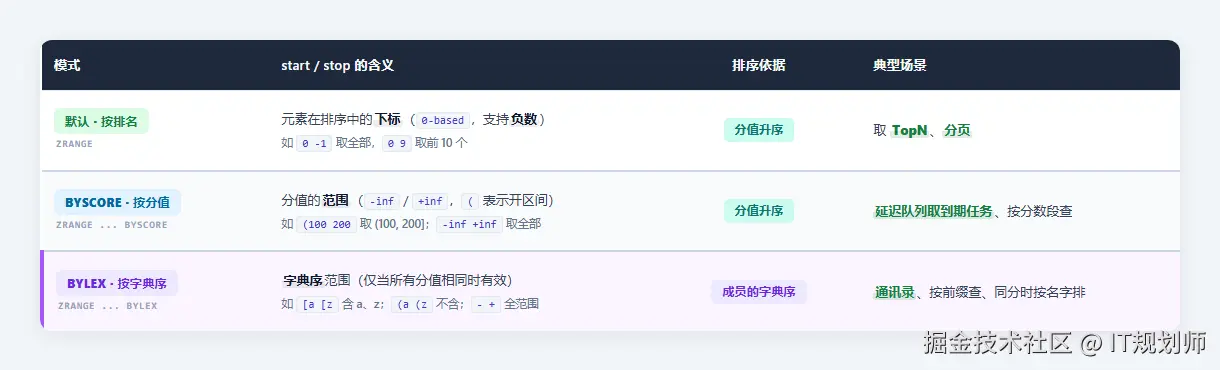
redis
# ① 按排名:取分数最高的前 10 名(降序)
ZRANGE game:rank 0 9 REV WITHSCORES

# ② 按分值:取所有分值在 [1000, 2000] 的成员(含边界)
ZRANGE game:rank 1000 2000 BYSCORE WITHSCORES

# ③ 开区间:(1000 (2000 表示 1000 < score < 2000
ZRANGE game:rank (1000 (2000 BYSCORE

# ④ 延迟队列:取所有"已到期"的任务(score ≤ 当前时间戳)
ZRANGE delay:queue -inf 1735689600 BYSCORE LIMIT 0 100

# ⑤ 字典序:分值全相同时,按成员名范围取(- / + 表示最小/最大)
ZRANGE contacts [alice [bob BYLEX

# ⑥ 结果存到新 key(6.2+,常用于预计算)
ZRANGESTORE top100 game:rank 0 99 REV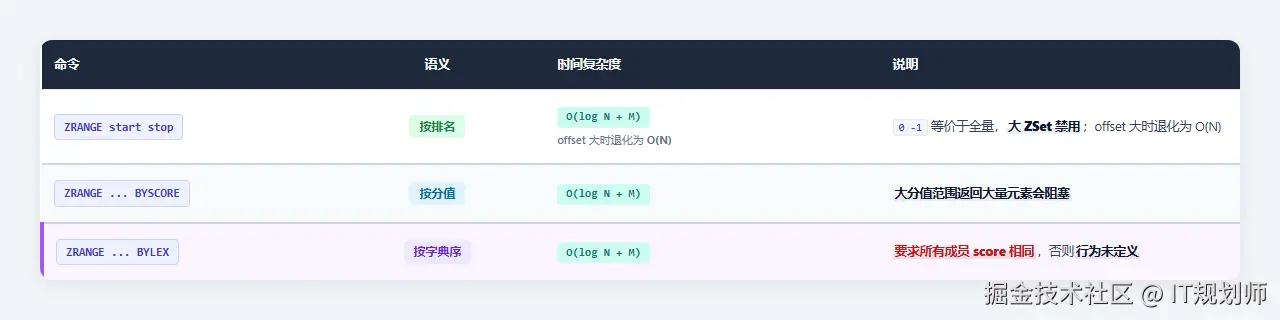
⚠️
ZRANGE 0 -1和ZRANGEBYSCORE -inf +inf是 ZSet 里最危险的两条读命令 。它们一次性返回全部成员,M 等于 ZSet 大小;Redis 单线程在序列化和网络传输期间无法处理其他命令。大 ZSet 分页必须用LIMIT offset count,未知大小的 ZSet 禁止全量范围读取。
⚠️BYLEX的前提 :只有所有成员分值相同时,字典序才有意义。分值不同时,ZRANGEBYLEX先按分值排、再按字典序排,范围比较只作用于分值相同的连续段。用BYLEX前通常把 score 统一设为0(通讯录实现的常见做法)。
📌LIMIT只能在BYSCORE/BYLEX模式下用 ,不支持默认按排名模式。按排名分页直接用start stop下标。
csharp
// 按排名取 Top10(降序)
var top10 = await db.SortedSetRangeByRankWithScoresAsync("game:rank", 0, 9, Order.Descending);
// 按分值取闭区间 [1000, 2000]
var mid = await db.SortedSetRangeByScoreAsync("game:rank", 1000, 2000);
// 开区间 (1000 (2000:Exclude 是位标志,用 | 合并两端
var open = await db.SortedSetRangeByScoreAsync("game:rank", 1000, 2000,
    Exclude.Start | Exclude.Stop);
// 字典序范围(score 需全相同)
var lex = await db.SortedSetRangeByValueAsync("contacts", "alice", "bob");
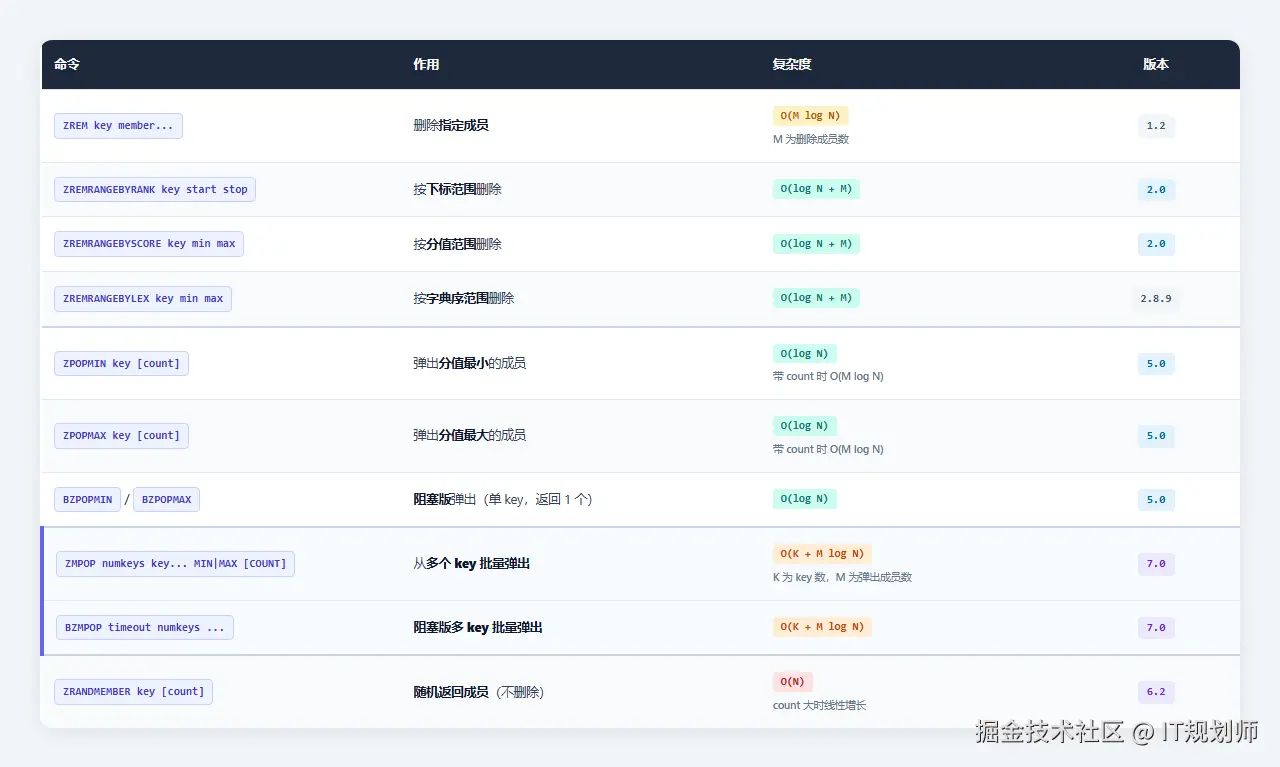
1.4 删除与弹出:ZREM / ZREMRANGE* / ZPOPMIN / ZPOPMAX / ZMPOP
redis
# 清掉 24 小时前的旧数据
ZREMRANGEBYSCORE game:rank -inf 1735603200

# 弹出一个分值最高的("出队 Top1")
ZPOPMAX game:rank

# 从多个队列里,弹出分值最小的(优先级调度,7.0+)
ZMPOP 2 task:high task:low MIN COUNT 10
csharp
// 删除单个成员
await db.SortedSetRemoveAsync("game:rank", "player:1");
// 按分值范围删除(清掉 24 小时前的旧数据)
await db.SortedSetRemoveRangeByScoreAsync("game:rank", double.NegativeInfinity, 1735603200);
// 多 key 批量弹出最小分值(优先级调度,7.0+,旧版 SDK 未封装走 ExecuteAsync)
await db.ExecuteAsync("ZMPOP", 2, "task:high", "task:low", "MIN", "COUNT", 10);
关键边界:
ZREMRANGEBYSCORE删除大量成员时可能阻塞 。一次删几十万元素,释放内存和调整跳表结构都在主线程完成。大 ZSet 批量删除要么UNLINK删整个 key,要么ZREMRANGEBYRANK分批删(如每次 1000 个),要么ZPOPMIN循环。ZPOPMIN/ZPOPMAX不带 count 是 O(log N),带大 count 是 O(M log N),不要一次弹出几十万个。ZMPOP(7.0+)能从多个 key 批量弹出 ,是延迟队列消费、优先级调度的正解;BZPOPMIN虽能等多个 key 但一次只返回一个元素。ZRANDMEMBER是"随机取、不删除" ,和抽奖的SPOP不同。ZSet 没有"随机弹出"命令,ZSet 抽奖要自己ZRANDMEMBER+ZREM(两条命令,并发下需 Lua 原子化)。
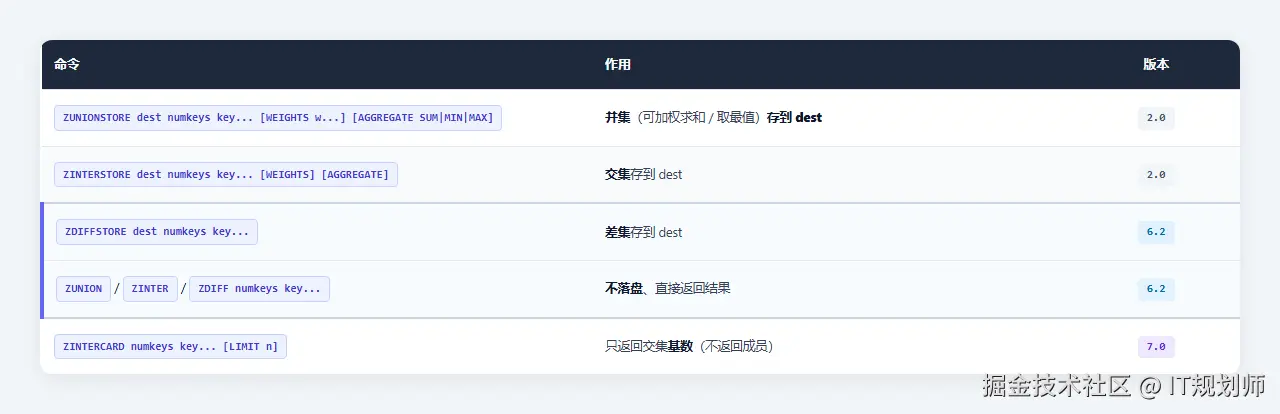
1.5 集合运算:ZUNIONSTORE / ZINTERSTORE / ZDIFFSTORE / ZINTERCARD
redis
# 综合榜单:热度权重 0.7,质量权重 0.3,同名成员分值相加
ZUNIONSTORE rank:overall 2 rank:hot rank:quality WEIGHTS 0.7 0.3 AGGREGATE SUM

# 取同名成员里分值更大的那个(取最优)
ZUNIONSTORE rank:best 2 rank:a rank:b AGGREGATE MAX

# 只想知道两个榜单有多少共同成员(7.0+,不返回具体成员,更快)
ZINTERCARD 2 rank:a rank:b
复杂度与边界:
ZUNIONSTORE/ZINTERSTORE的代价由参与运算的集合总规模和结果集规模共同决定 (约O(N) + O(M log M),N 为输入总元素数,M 为结果集大小),并且结果要写入dest;dest很大时写入本身也是一次 O(M) 操作。- 不要在请求路径上对大 ZSet 实时做
ZUNIONSTORE,高频结果应该预计算。 - 聚合语义 :默认
AGGREGATE SUM------同一成员在多集合出现时 score 相加;MIN/MAX取最小/最大。WEIGHTS在聚合前对每个集合 score 做乘法。 ZINTERCARD(7.0+)只返回交集基数 ,支持LIMIT提前终止。它只告诉你有多少个共同成员,不告诉你是哪些成员。- 集群下要求所有参与运算的 key 落在同一 Slot ,否则报
CROSSSLOT。跨 Slot 用 Hash Tag 或客户端聚合(见 S9)。
1.6 遍历:ZSCAN
ZSCAN key cursor [MATCH pattern] [COUNT count]:以游标方式增量遍历 ZSet,一次只返回少量成员 + 下一个游标。这是遍历大 ZSet 的唯一正确姿势 ------不会像 ZRANGE 0 -1 那样一次性把整个集合塞进响应。
redis
# 增量遍历:游标 0 开始,MATCH 模式,COUNT 100(COUNT 是提示量,不精确)
ZSCAN ranking 0 MATCH * COUNT 100
# → 1) "17"(下一个游标)  2) 匹配到的成员列表
⚠️
ZSCAN的COUNT只是"每次尝试返回的提示数量",不保证精确;遍历期间如果有元素增删,可能出现重复或遗漏(Redis 游标的固有特性)。做精确全量导出时,业务上要能容忍这种"弱一致性",并允许重跑。
csharp
// 异步游标遍历 ZSet(每批 100 个成员,天然适合大集合)
await foreach (var entry in db.SortedSetScanAsync(
    "ranking",
    pattern: "*",
    pageSize: 100))
{
    // 逐条取成员和分值
    // entry.Element, entry.Score
}
1.7 命令速查总表
1.8 .NET API 对照
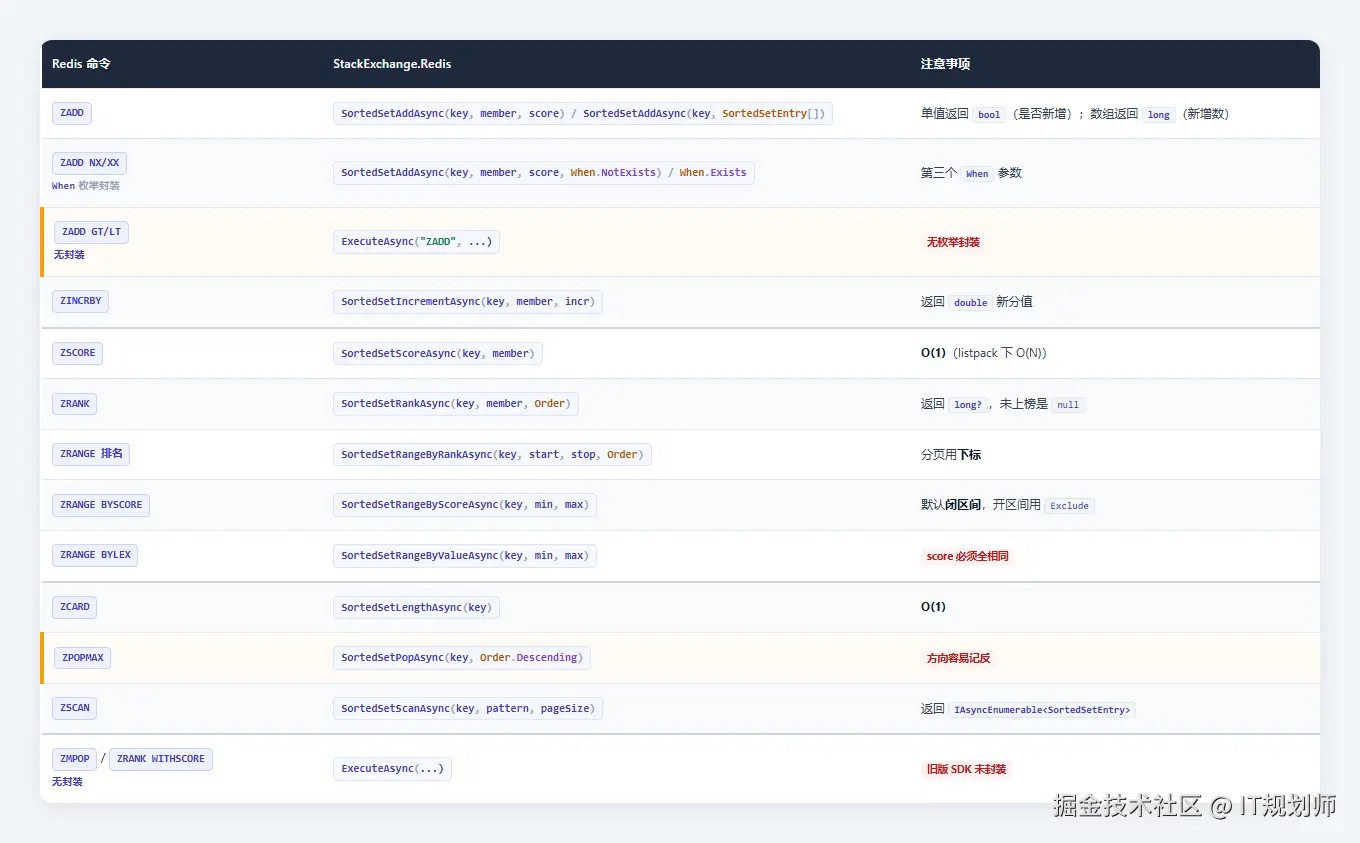
API 层面的三个坑(
SortedSetPopAsync方向、SortedSetRangeByScoreAsync闭区间、long转double精度)分别见 6.2 坑 6、坑 8、6.3 坑 15,本章不重复展开。
二、编码、双引擎与内存估算
2.1 一句话说清双结构
ZSet 对外是"带分值的集合",内部同时挂了两套结构:
- 一个字典(dict) :
member → score,支持 O(1) 按成员查分值 (ZSCORE); - 一个跳表(skiplist) :按
score排序的多层链表,支持 O(log N) 按分值范围查询与排名 (ZRANGE、ZRANK)。
两套结构指向同一个成员 (共享 member 字符串,不重复存两份数据),所以 ZSet 内存开销 ≈ 跳表节点 + 字典条目两份索引。
对你的影响 :skiplist 编码、成员长度相近的百万级场景下,同样是 100 万成员,Set 大约 60 MB,ZSet 要 100~150 MB ------多出来的是跳表那套索引。"不需要排序就别用 ZSet" 的根子在这里。
2.2 双引擎:为什么"有序"和"O(1) 查分值"能同时成立
skiplist 编码的 ZSet 不是"只有跳表",而是跳表 + 字典的组合:
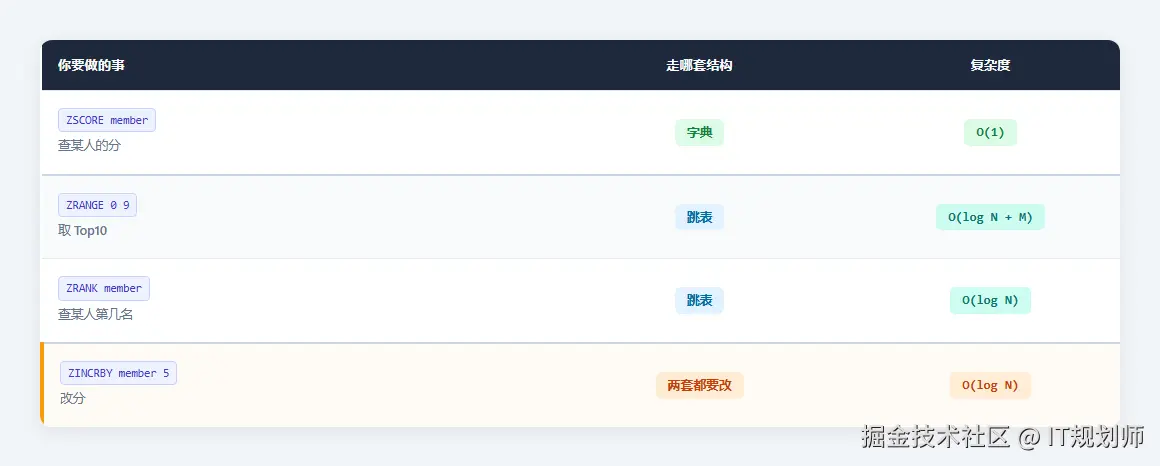
注意最后一行 :改分值是"双写"------跳表要重新定位(O(log N)),字典要更新分值(O(1))。所以 ZSet 的写比 Set 慢(Set 只写一套结构)。高频更新计分场景要留意。
💡 一个反直觉但重要的推论 :
ZSCORE是 O(1),但ZRANK是 O(log N) 。因为"查分值"走字典,"查排名"必须走跳表数跨度。所以"我的排名"接口比"我的分数"接口贵得多------高频刷新的排行榜,别把ZRANK放在每次请求都走的路径上。
2.3 跳表是什么(业务视角)
- 它在普通有序链表上加了几层"索引",查找时从最高层往下跳,把 O(N) 线性查找降到 O(log N)。
- 每个节点平均 1.33 层索引(层数随机生成,概率递减:Level 1 必然存在,Level 2 有 25% 概率,Level 3 有 6.25% 概率......最高 32 层)。
- 额外指针就是额外内存------每多一层就多两个指针(forward + span)。这是 ZSet 比 Set 贵的直接原因。
- 即使有 1 亿成员,跳表最高层也只会到 log₄(10⁸) ≈ 13 层,查找仍是 O(log N) ≈ O(13),现实中不会变慢,只会变占内存。
📌 为什么不用红黑树/B+ 树? 跳表实现比平衡树简单,且天然支持范围查询和排名(数
span就能算下标)。
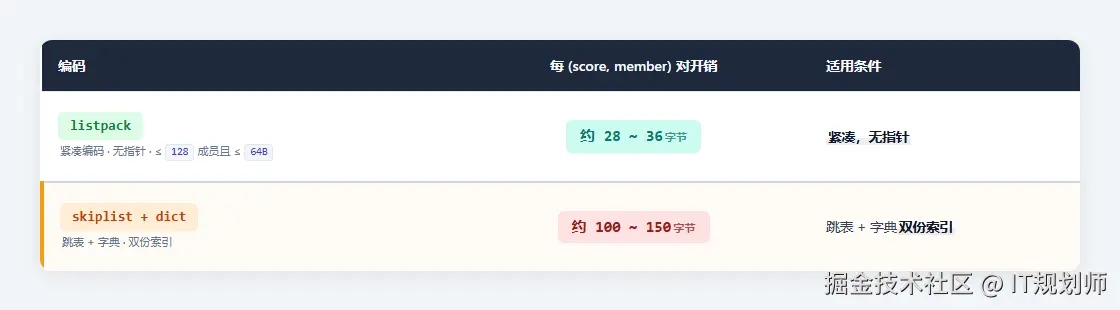
2.4 两种编码:listpack 与 skiplist+dict
调用方无法指定,Redis 自动选:
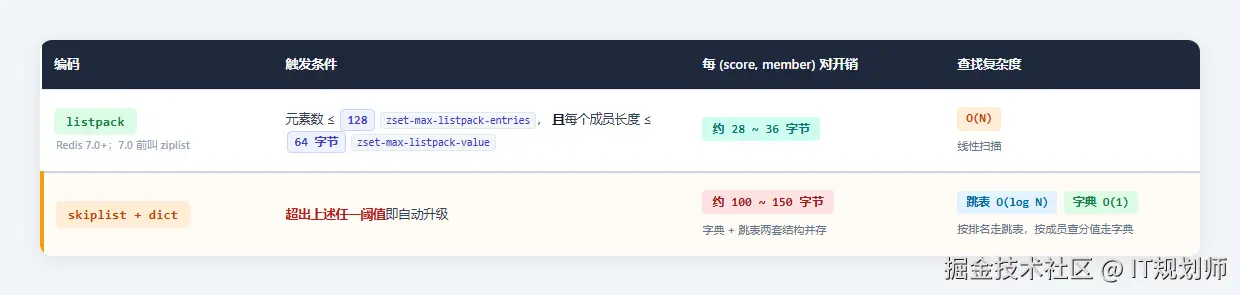
redis
# 查看 key 当前编码
OBJECT ENCODING key
# 7.0+ 返回 "listpack" 或 "skiplist";7.0 之前返回 "ziplist" 或 "skiplist"
对你的影响 :小 ZSet 用 listpack 可以比 skiplist 省约 3 倍内存。但这个红利只在"成员少且短"时成立;一旦成员数超过 128 或单个成员超过 64 字节,编码升级为 skiplist,每元素开销从约 30 字节跳到 100+ 字节,且不可逆。
⚠️ 小 ZSet 的
ZSCORE是 O(N) 线性扫描 (listpack),不是 O(1)。虽然 N≤128 通常很快,但在把阈值调大(比如 512)的实例上,ZSCORE的延迟会比预期高。
2.5 编码转换边界:单向、不可逆
text
写入成员
   ↓
ZSet 为空 → 建立 listpack
   ↓
元素数 ≤ 128 且 成员长度 ≤ 64 字节? → 是 → 保持 listpack
   ↓ 否(任一条件被打破)
升级为 skiplist(+ 字典)→ 不可逆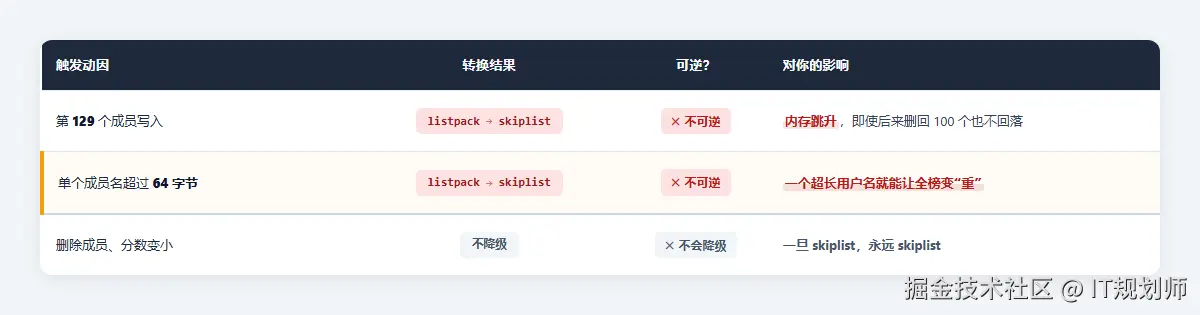
关键业务结论:
- 编码升级不可逆 。想恢复 listpack,只能
DEL后重建。 - 调大
zset-max-listpack-entries不会让存量 key 自动重编码,只影响新建 key。 - 一个"脏"成员能毁掉整个 ZSet 的省内存收益------写入前做成员长度校验,比事后调优重要得多。
⚠️ 真实踩坑场景 :某游戏排行榜本只有几十人(listpack,内存极小),一次运营活动批量导入 500 个测试账号,编码当场升成 skiplist;活动结束删到只剩 30 人,内存却没降回来。修复只能
DEL后重建。
2.6 score 的底层精度限制
ZSet 的 score 使用 IEEE-754 double 双精度浮点数:
- 整数安全上限:2^53(约 9×10^15)。超过该值的整数会丢失低位精度;
- 秒时间戳(~1e9)、毫秒时间戳(~1e12)本身安全;
- 纳秒时间戳(~1e18)严禁直接作为 score,会严重精度错乱;
- 一旦超过 2^53,相邻两个不同分值会被舍入成同一个 double。
对你的影响:延迟队列用毫秒时间戳当 score 是安全的;但如果你为了"同一毫秒内排序"再乘系数,很容易越过 2^53。延迟队列的具体 score 设计见 3.3;分值坑点索引见 6.3。
2.7 配置默认值与版本事实
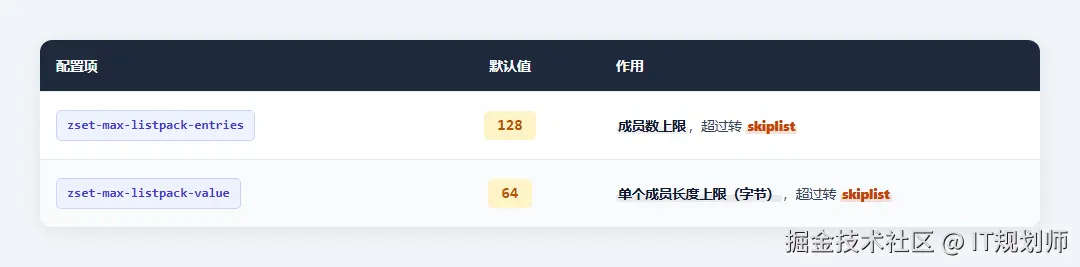
📌 必须澄清的版本事实 :ZSet 的 listpack 编码是 7.0 引入的(同版本把 Hash 也从 ziplist 换成 listpack);7.2 引入 listpack 的是 Set,不是 ZSet。配置项容易混:
- ZSet:
zset-max-listpack-entries= 128 、zset-max-listpack-value= 64 (7.0 前叫zset-max-ziplist-*)- Set:
set-max-listpack-entries= 128 、set-max-listpack-value= 64(7.2+)- Hash:
hash-max-listpack-entries= 512 、hash-max-listpack-value= 64看到"128 是 ZSet 默认值"是对的,但别把它安到 Hash 头上 (Hash 是 512)。ZSet 是 128,Hash 是 512------这是两个类型最容易被记混的默认值。
2.8 亲手验证编码
bash
# 1) 小集合 → listpack
DEL z
ZADD z 1 a 2 b 3 c
OBJECT ENCODING z
# → "listpack"

# 2) 灌入超过 128 个成员 → 升级 skiplist
for i in $(seq 1 200); do redis-cli ZADD z $i "member:$i" > /dev/null; done
OBJECT ENCODING z
# → "skiplist"

# 3) 删到只剩 10 个,编码不降级
ZREMRANGEBYRANK z 10 -1
OBJECT ENCODING z
# → "skiplist"(仍然是)

# 4) 一个超长成员也能触发升级
DEL z2
ZADD z2 1 "$(printf 'x%.0s' {1..100})"
OBJECT ENCODING z2
# → "skiplist"

# 5) 看当前阈值
# 成员数阈值(默认 128)
CONFIG GET zset-max-listpack-entries
# 单个成员长度阈值(默认 64 字节)
CONFIG GET zset-max-listpack-value
csharp
// 查 key 的编码(OBJECT ENCODING)
var enc = await db.ExecuteAsync("OBJECT", "ENCODING", "z");
// 输出:"listpack" 或 "skiplist"
Console.WriteLine(enc);
2.9 内存占用估算
一个 ZSet 的内存 = 跳表节点(若不超阈值则是 listpack) + 字典条目 + 成员字符串 + 固定开销:
text
skiplist 编码下,单个成员 ≈
    跳表节点:backward(8) + score(8) + member指针(8) + level[](平均 1.33 层 × 16 ≈ 21)≈ 45 字节
  + 字典条目:dictEntry(24) + 桶数组摊销(≈8)                                        ≈ 32 字节
  + 成员字符串:SDS 头部 + 内容(按成员长度)
  ≈ 77 字节 + 成员字符串
经验值:skiplist 编码下,每个成员约 100~150 字节(含跳表 + 字典双份索引 + 成员字符串)。
估算公式(64 位、jemalloc):
text
listpack:  单 ZSet ≈ 70  + N × (29  + 平均成员长度)
skiplist:  单 ZSet ≈ 160 + N × (136 + 平均成员长度)
快速心算口诀:
- listpack 小榜:整个 ZSet 通常就几 KB;
- skiplist 大榜 :按"每个成员 120 字节 "估。10 万成员 ≈ 12 MB ,100 万成员 ≈ 120 MB。
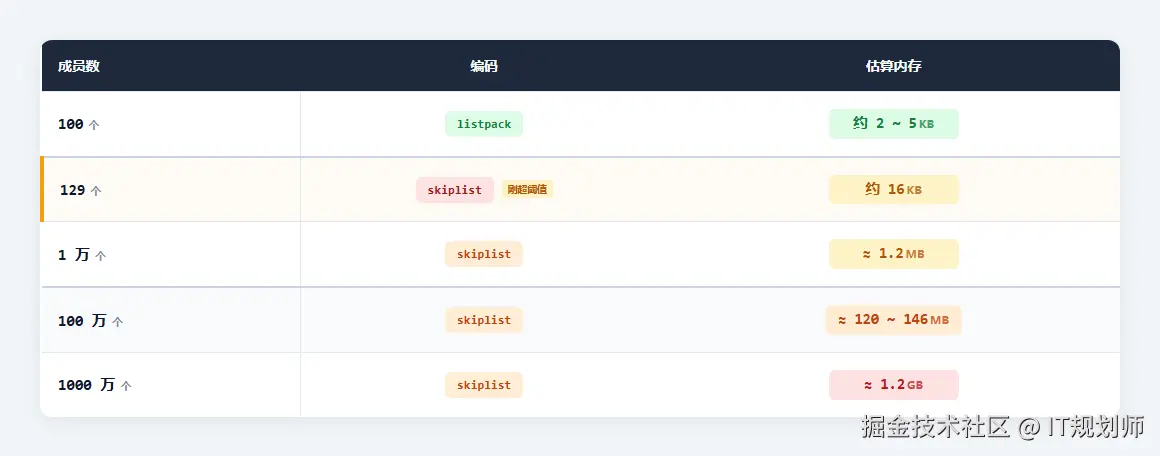
完整演算:
text
演算一:100 万成员的排行榜(member 平均 10 字节)
skiplist 编码(必然,因为 N > 128):
每成员 ≈ 136 + 10 ≈ 146 B
100 万 × 146 B ≈ 146 MB

演算二:100 个成员的小 ZSet(member 平均 20 字节)
listpack 编码:
每成员 ≈ 29 + 20 ≈ 49 B
100 × 49 B ≈ 4.9 KB结论:ZSet 的内存由"编码 + 成员规模"决定。百万级 ZSet 必然走 skiplist,每成员 100+ 字节;小 ZSet 用 listpack 省约 3 倍内存,但一旦超过 128 成员或 64 字节成员长度,红利消失且不可逆。
⚠️ 和 Set 对照:同样 100 万成员,Set ≈ 60 MB,ZSet ≈ 120 MB------ZSet 大约是 Set 的两倍,因为多了一套跳表索引。
实操命令与提醒:
redis
# 先看编码(listpack / skiplist)
OBJECT ENCODING game:rank
# 单 key 内存估算(偏低,不含对齐浪费)
MEMORY USAGE game:rank
# 成员数
ZCARD game:rank
# 看 used_memory 真实增量(容量规划更可靠)
INFO memory
⚠️
MEMORY USAGE只估算:不含 jemalloc 内存对齐浪费、不含桶数组冗余。容量规划以INFO memory的used_memory前后增量为准更可靠。
三、7 类高阶玩法
3.1 玩法一:实时排行榜(ZADD + GT + ZREVRANGE + ZRANK)
需求:游戏积分榜 / 销量榜 / 热搜榜,实时更新、随时取 TopN、查询某个用户的排名和分数。
方案 :成员是被排名的对象 ID,分值是排名依据;用 GT 只保留历史最高分,用 ZREVRANGE 降序取 TopN,用 ZRANK 查个人排名。
redis
# 写入三条玩家分数(GT 只保留历史更高分)
ZADD game:rank GT 1200 player:1
ZADD game:rank GT 950  player:2
ZADD game:rank GT 1800 player:3

# 取 Top10(降序)
ZREVRANGE game:rank 0 9 WITHSCORES
# 查玩家 1 的降序排名
ZREVRANK game:rank player:1
# 查玩家 1 的分值
ZSCORE   game:rank player:1
csharp
// 更新玩家分数:GT 只保留历史更高分("读-比-写"压成一条原子命令,防并发倒退)
public async Task UpdateScoreAsync(string playerId, double score)
{
    // ExecuteAsync 走原始 ZADD,传 GT 开关
    await db.ExecuteAsync("ZADD", "game:rank", "GT", score, playerId);
}

// 取 TopN(降序),返回 成员+分值 列表
public async Task<List<(string Member, double Score)>> GetTopAsync(int n)
{
    // 按排名取 [0, n-1],降序
    var entries = await db.SortedSetRangeByRankWithScoresAsync(
        "game:rank", 0, n - 1, Order.Descending);
    // RedisValue.Element 转 string,e.Score 即分值
    return entries.Select(e => ((string)e.Element, e.Score)).ToList();
}

// 查"我"的排名和分值
public async Task<(long? Rank, double? Score)> GetMyRankAsync(string playerId)
{
    // 降序排名;rank 为 null 表示未上榜,别当 0
    var rank = await db.SortedSetRankAsync("game:rank", playerId, Order.Descending);
    // 分值;未上榜为 null
    var score = await db.SortedSetScoreAsync("game:rank", playerId);
    return (rank, score);
}同分排序难题:ZSet 同分时按 member 字典序排,不是"先到达的排前面"。游戏排行榜"同分先达者排名靠前"是常见需求。
解决方案:复合分数(Composite Score) :业务分数放高位(乘以大因子),时间序号放低位。业务分数不同时按业务分数排;业务分数相同时,tieBreaker 大的(即时间戳更早的)排前面。tieBreaker 与时间戳成反比:now 越小,999_999 - now % 1_000_000 越大。
⚠️ 适用边界先说清楚 :这个方案要求
bizScore不超过约 90 亿 (因为bizScore × 1_000_000 + tieBreaker < 2^53)。如果你的业务分数可能超过 90 亿(例如累计积分、累计销量),这个"6 位十进制低位"的复合方案不适用,需要缩小低位位数(如只留 3~4 位),或改用"多集合 + 应用层排序"。
csharp
public async Task UpdateScoreAsync(string gameId, string playerId, long bizScore)
{
    var db = _redis.GetDatabase();
    var key = $"leaderboard:game:{gameId}";
    var seqKey = $"leaderboard:game:{gameId}:seq";

    // 复合分数:高位业务分数 + 低位"反到达序号"。
    // 到达序号 seq 用 INCR 单调递增:先到达者 seq 小 → 低位 999_999 - (seq % 1e6) 大 → 降序查询时排前面。
    // 约束:bizScore 非负,且 bizScore * 1_000_000 + tieBreaker < 2^53(约 9.007e15)。
    // 生产环境应校验 bizScore <= 9_000_000_000,否则本方案精度不足。
    // 低位容量 6 位十进制:seq 每约 100 万次写入回绕一次;同分竞争远小于该量级时可忽略。
    long seq = (long)await db.StringIncrementAsync(seqKey);
    long tieBreaker = 999_999 - (seq % 1_000_000);
    long compositeScore = bizScore * 1_000_000L + tieBreaker;

    await db.SortedSetAddAsync(key, new SortedSetEntry[] { new SortedSetEntry(playerId, compositeScore) });
}

// 取 TopN 并把复合分数还原为原始业务分数
public async Task<List<(string Player, double Score)>> GetTopNAsync(string gameId, int n)
{
    var db = _redis.GetDatabase();
    var key = $"leaderboard:game:{gameId}";
    // 按排名取 [0, n-1],降序
    var results = await db.SortedSetRangeByRankWithScoresAsync(
        key, 0, n - 1, Order.Descending);

    // 逐条还原:除以 1_000_000 取整,抹掉低位到达序号,得到业务分数
    return results.Select(r => (
        Player: r.Element.ToString(),
        Score: Math.Floor(r.Score / 1_000_000)
    )).ToList();
}
复合分数的边界 :
bizScore * 1_000_000L + tieBreaker必须小于 2^53(约 9×10^15),因此bizScore的安全上限约为 9×10^9;超过这个量级就要缩小低位预留位数,或改用"多集合 + 应用层排序"。低位预留 6 位十进制(0~999999)意味着同一业务分数下最多区分约 100 万个到达序号,超出后同分先后会再次退化为字典序。
边界:
ZREVRANGE 0 -1是排行榜最危险的写法 。50 万成员的榜单一次全量返回,主线程阻塞、网络打满。TopN 的 N 必须有限(100/1000),全量导出走离线或ZSCAN分批。- 热榜成员数要有上限 :C 端排行榜通常只关心前几百名,可用
ZREMRANGEBYRANK key 500 -1定期裁掉后面的(但注意------裁掉后用户ZRANK查不到自己的名次,要么接受"未上榜",要么另存全量)。 - 分值必须是"可比"的:多个维度混在一个分值时(如热度 = 浏览 + 点赞 × 2),权重要写在计分逻辑里,而不是靠 ZSet 自己做。
- 超大规模榜单要分片(见第五章)。
- "我第几名"要处理
null:SortedSetRankAsync返回long?,未上榜是null,别当0。 - 并列 score 的排名不并列 :两个 100 分的成员,
ZRANK返回的是按字典序决定的不同名次。需要并列排名时,应用层按 score 分组处理。
3.2 玩法二:排行榜分页与"我的排名"
需求:排行榜前端要分页;用户要看到"我第几名、多少分"。
方案 :分页用 ZREVRANGE (page-1)*size page*size-1;"我的排名"用 ZREVRANK(7.2+ 带 WITHSCORE 一次拿两个数)。
redis
# 第 3 页(每页 20 条):下标 40~59
ZREVRANGE game:rank 40 59 WITHSCORES

# "我"的排名和分数(7.2+)
ZREVRANK game:rank player:1 WITHSCORE
csharp
// 查"我"的排名和分值(排行榜"我的排名"接口)
public async Task<(long? Rank, double? Score)> GetMyRankAsync(string playerId)
{
    // 降序排名;rank 为 null 表示未上榜,别当 0
    var rank = await db.SortedSetRankAsync("game:rank", playerId, Order.Descending);
    // 分值;未上榜为 null
    var score = await db.SortedSetScoreAsync("game:rank", playerId);
    return (rank, score);
}
边界:
- 分页越深越慢 :
ZREVRANGE 40000 40020的复杂度官方标准写O(log N + M),但 offset 很大时实际退化为O(N)------Redis 仍要跳着数过前面所有节点。产品上第 2000 名没人看,所以深分页的"成本"主要不是算法复杂度,而是业务价值不对等。产品上一般是"Top100 + 我的排名"两段式,而不是真分页。 ZRANK是 O(log N) ,别在高频接口里对每个用户都算一次全榜排名------大榜单下它比ZSCORE贵得多。
3.3 玩法三:延迟队列(score = 到期时间戳)
需求:订单 30 分钟未支付自动取消、会议前 15 分钟提醒------"到点才执行"的任务。
方案 :成员是任务 ID,分值是到期时间戳 。生产者 ZADD,消费者用 ZRANGEBYSCORE ... -inf now 拉到期任务,再用 Lua 原子地"取 + 删"(两步非原子会重复消费)。
redis
# 生产:任务在 30 分钟后到期
ZADD delay:orders 1735691400 order:1001

# 消费(普通写法,有竞态,仅示范)
ZRANGEBYSCORE delay:orders -inf 1735689600 LIMIT 0 10
ZREM delay:orders order:1001
正确写法:Lua 原子"取 + 删"
lua
-- KEYS[1] = 队列 key;ARGV[1] = 当前时间戳;ARGV[2] = 批量大小
local unpack_fn = unpack or table.unpack
local tasks = redis.call('ZRANGEBYSCORE', KEYS[1], '-inf', ARGV[1], 'LIMIT', 0, ARGV[2])
if #tasks > 0 then
  redis.call('ZREM', KEYS[1], unpack_fn(tasks))
end
return tasks
csharp
// Lua 脚本:原子"取到期任务 + 删除",避免并发重复消费。
// KEYS[1] = 队列 key;ARGV[1] = 当前时间戳;ARGV[2] = 批量大小
private const string PopDueScript = @"
local unpack_fn = unpack or table.unpack
local tasks = redis.call('ZRANGEBYSCORE', KEYS[1], '-inf', ARGV[1], 'LIMIT', 0, ARGV[2])
if #tasks > 0 then redis.call('ZREM', KEYS[1], unpack_fn(tasks)) end
return tasks";

// 消费到期任务:nowUnix 为当前秒级时间戳,batch 为每批最大条数
public async Task<RedisResult> PopDueAsync(long nowUnix, int batch)
{
    // 传入队列 key 与参数,一次脚本调用完成"取 + 删"(原子)
    return await db.ScriptEvaluateAsync(PopDueScript,
        new RedisKey[] { "delay:orders" },
        new RedisValue[] { nowUnix, batch });
}
Lua
unpack兼容性 :Redis 固定 Lua 5.1,table.unpack实际不可用,只有全局unpack可用。上面的local unpack_fn = unpack or table.unpack是防御性写法。批量大小控制在几百以内,这是 Lua 运行时栈的工程建议,不是 Redis 命令本身的限制(Lua 参数栈上限通常几千到 8000,几百是留足余量的工程值)。
score 设计:秒级时间戳优先,复合值必须 < 2^53
- 秒级时间戳 (约 1.7×10^9):离上限很远,安全。
- 毫秒时间戳 (约 1.7×10^12):也安全,但如果你在分值里再乘 1000 或拼随机数,就会逼近甚至超过 2^53。
- 一旦超过 2^53 ,相邻的两个整数会被舍入成同一个 double,
ZRANGEBYSCORE会漏掉一部分到期任务------而且这种 bug 跑几个月才暴露,非常难排查。
✅ 安全做法:用秒级时间戳做分值(除非真的需要毫秒精度)。如果必须毫秒 + 同毫秒顺序,就把分值设计成"高位放时间、低位放序号",且整体不超过 2^53。例如毫秒时间戳左移 10 位再补 10 位序号(10 位序号对应 0~1023 个同毫秒任务):
textscore = (毫秒时间戳 << 10) | 序号 # 需确保这个值 < 2^53
其他边界:
- 消费必须"查 + 删"原子 。先
ZRANGEBYSCORE拿任务再逐个ZREM,两个消费者可能拿到同一批任务,导致重复执行。 - 轮询必须退避 。
while(true) { ZRANGEBYSCORE ... }没有 sleep,队列为空时会打满 CPU 和 Redis QPS。正确轮询是"有任务时连续消费,无任务时 sleep 一个短间隔(如 100ms~1s)",或用BLPOP的信号机制减少空轮询。 - 大 ZSet 的删除代价 :到期任务一次积压几十万个,
ZREMRANGEBYSCORE一次性删除可能阻塞。任务按分值全局有序且不需要时间窗口时,ZPOPMIN循环分批弹出更简单;需要按到期时间范围批量消费时,用上面的 LuaZRANGEBYSCORE + ZREM方案,或ZREMRANGEBYRANK每次删固定数量。 - ZSet 延迟队列没有 ACK 。消费者
ZREM后崩溃,任务就丢了。需要"至少一次"语义时,要么用 Lua 把"弹出 + 写入 processing 队列"包起来,要么直接用 Stream 的 Pending 机制。ZSet 延迟队列适合"允许少量丢失、可人工补偿"的轻量场景。 - 任务失败要能重入队 :消费后执行失败,别直接丢。要么把任务先挪到一个"处理中"的备份结构(如
delay:processing),要么重算下次到期时间再ZADD回去。 unpack批量控制 :Redis 用 Lua 5.1,unpack可用;批量过大(上千成员)一次性unpack会撑大脚本,建议LIMIT控制在几百以内。
ZSet 延迟队列的精度是秒级,适合订单超时、定时通知这类"秒级容忍"的场景。毫秒级、高频短延迟(如实时风控的 1~60 秒超时判定)用时间轮更合适。
3.4 玩法四:滑动窗口限流(ZREMRANGEBYSCORE + ZCARD + ZADD)
需求:限制"任意 60 秒内最多 100 次请求"(比固定窗口更平滑,避免窗口切换时的双倍流量突刺)。
方案 :成员是请求唯一标识 (UUID 或"时间戳+随机数"),分值是请求时间戳 。每次请求:先用 ZREMRANGEBYSCORE 清掉窗口外的旧记录,再 ZCARD 数窗口内的请求数、判断是否放行。
redis
# 一次请求:窗口 60000ms、上限 100、当前时间戳 1735689600000
# 清掉 60 秒前的旧记录
ZREMRANGEBYSCORE rate:user:1 0 1735689540000
# 数窗口内的请求次数
ZCARD rate:user:1
# 记下这次请求
ZADD rate:user:1 1735689600000 req_uuid_abc
# 兜底过期,防内存泄漏
EXPIRE rate:user:1 120
正确写法:Lua 保证三步原子
高并发下,"清 + 数 + 加"三步分开会被插队(两个请求同时读到 99 次、都放行,实际变成 101 次)。必须用 Lua:
lua
-- KEYS[1] = 限流 key;ARGV[1] = 窗口毫秒;ARGV[2] = 上限;ARGV[3] = 当前毫秒;ARGV[4] = 请求唯一 ID
local key = KEYS[1]
local window = tonumber(ARGV[1])
local limit  = tonumber(ARGV[2])
local now    = tonumber(ARGV[3])
-- 先清掉窗口外的旧记录
redis.call('ZREMRANGEBYSCORE', key, 0, now - window)
-- 数窗口内的请求数
local count = redis.call('ZCARD', key)
if count >= limit then
  -- 拒绝路径也刷新 TTL,防止"一直拒绝导致 key 提前过期、限流状态丢失"
  redis.call('PEXPIRE', key, window)
  -- 拒绝
  return 0
end
-- 记下本次请求
redis.call('ZADD', key, now, ARGV[4])
-- 兜底过期,防内存泄漏
redis.call('PEXPIRE', key, window)
-- 放行
return 1
csharp
// Lua 脚本:滑动窗口限流"清 + 数 + 加"三步原子,防并发超发。
// KEYS[1] = 限流 key;ARGV[1] = 窗口毫秒;ARGV[2] = 上限;ARGV[3] = 当前毫秒;ARGV[4] = 请求唯一 ID
private const string RateLimitScript = @"
local key = KEYS[1]
local window = tonumber(ARGV[1])
local limit  = tonumber(ARGV[2])
local now    = tonumber(ARGV[3])
redis.call('ZREMRANGEBYSCORE', key, 0, now - window)
local count = redis.call('ZCARD', key)
if count >= limit then redis.call('PEXPIRE', key, window) return 0 end
redis.call('ZADD', key, now, ARGV[4])
redis.call('PEXPIRE', key, window)
return 1";

// 判断本次请求是否放行:返回 true 放行,false 拒绝
public async Task<bool> AllowAsync(string userId, long windowMs, int limit)
{
    // 取当前毫秒时间戳
    var now = DateTimeOffset.UtcNow.ToUnixTimeMilliseconds();
    // 传入限流 key、参数与本次请求唯一 ID(UUID 防同毫秒覆盖)
    var result = await db.ScriptEvaluateAsync(RateLimitScript,
        new RedisKey[] { $"rate:{userId}" },
        new RedisValue[] { windowMs, limit, now, Guid.NewGuid().ToString("N") });
    // 脚本返回 1 表示放行
    return (long)result == 1;
}
边界语义选择 :
ZREMRANGEBYSCORE key 0 (now - window是开区间,恰好window毫秒前的请求会保留;上面的 Lua 用闭区间now - window,表示窗口恰好window毫秒前的请求也被清掉。两种写法都常见,关键是全链路(清理、计数、判断)使用同一个边界语义。
边界:
- member 必须唯一。如果用"时间戳"做 member,同一毫秒的多个请求会互相覆盖,导致计数偏小、限流失效。用 UUID 或"时间戳 + 随机数"。
EXPIRE不能忘 。没有 TTL 的限流 key 会永久存在,冷用户积累后内存持续上涨。Lua 里用PEXPIRE随写入一起设置。拒绝路径也应刷新一次 TTL,否则"窗口内一直有请求但全部被拒绝"时 key 可能提前过期,限流状态丢失;若业务接受这种弱化语义,则必须在应用层用定时清理兜底。ZREMRANGEBYSCORE的区间要写对 :左闭右闭。要"严格大于窗口起点"就用(now-window。- ZSet 滑动窗口是"精确日志",内存随窗口内请求数线性增长。如果限流阈值是"每秒 10 万请求",窗口内 60 万个 member,单个 key 的内存会很大。高阈值、大规模场景更适合令牌桶或固定窗口计数器。
- 窗口边界脉冲:滑动窗口在窗口边界处可能出现"双倍流量"。这是滑动窗口的固有特性,如果需要严格限流需要考虑"令牌桶"或"漏桶"算法。
3.5 玩法五:周期榜与时间线(按周期分 key + 游标分页)
需求:日榜 / 周榜 / 月榜并存,还要能查"昨天谁是第一";或用户动态、新闻资讯,只展示"最新 N 条",需要游标分页。
方案 A:周期榜------按周期分 key + 到期归档
redis
# 日榜:每天一个 key
ZINCRBY rank:daily:20261102 1 video:1001
ZINCRBY rank:daily:20261102 1 video:1002

# 把日榜加权合并成周榜
ZUNIONSTORE rank:weekly:2026W44 7 \
  rank:daily:20261102 rank:daily:20261103 ... rank:daily:20261108

# 归档:日榜保留 35 天后过期
EXPIRE rank:daily:20261102 3024000
csharp
await db.SortedSetIncrementAsync($"rank:daily:{DateTime.Now:yyyyMMdd}", videoId, 1);

var weekKeys = Enumerable.Range(0, 7)
    .Select(i => $"rank:daily:{DateTime.Now.AddDays(-i):yyyyMMdd}")
    .ToArray();
// 周次用 .NET 自带 System.Globalization.ISOWeek.GetWeekOfYear 计算(ISO 8601)
var weekOfYear = System.Globalization.ISOWeek.GetWeekOfYear(DateTime.Now);
await db.ExecuteAsync("ZUNIONSTORE", $"rank:weekly:{weekOfYear}",
    7, weekKeys.Cast<object>().ToArray());
方案 B:时间线------score = 事件时间,游标分页
redis
# 发布动态
ZADD timeline:user:1001 1762100000 "post:88"
ZADD timeline:user:1001 1762100123 "post:89"

# 第一页:最新 20 条(按排名降序)
ZREVRANGE timeline:user:1001 0 19 WITHSCORES

# 游标分页:上一页最小 score = 1762100000,取更早的数据(开区间)
ZRANGEBYSCORE timeline:user:1001 -inf (1762100000 LIMIT 0 20

# 清理历史数据(保留最近 30 天)
ZREMRANGEBYSCORE timeline:user:1001 -inf 1730563200
边界:
ZUNIONSTORE会一次性消耗两份内存(源 key + 结果 key),大榜单合并别在主库高峰做,放从库或离线。- 周榜/月榜的 key 要有 TTL,否则历史榜越积越多------除非你确实要"永久历史榜",那就该落 DB/数仓,而不是留在 Redis。
- 跨 Slot :
ZUNIONSTORE要求所有 key 同一 Slot,集群下用 Hash Tag(rank:{2026W44}:daily:01)。 - 分页用 rank 游标或 score 游标,别用
0 -1全量拉 。ZREVRANGE的start/stop是排名偏移量,深分页会慢;ZRANGEBYSCORE ... LIMIT基于分值范围,性能稳定。 - 大 V 时间线按时间分片 key (
timeline:uid:2026-11-02),配合EXPIRE,避免一个 ZSet 无限增长。 - 成员数量要有上限 :不做
ZREMRANGEBYSCORE清理的 ZSet 会无限增长,内存和迁移都是负担。
3.6 玩法六:多维排序与复合权重
需求:"先按热度排,热度相同再按发布时间排"------两个维度。
方案 A:多集合加权交集/并集
redis
# 标签加权筛选:同时满足 tech 和 backend 标签,分数取较大值
ZINTERSTORE tag:tech_backend 2 tag:tech tag:backend WEIGHTS 1 1 AGGREGATE MAX

# 综合榜单:热度权重 0.7,质量权重 0.3,同名成员分值相加
ZUNIONSTORE rank:overall 2 rank:hot rank:quality WEIGHTS 0.7 0.3 AGGREGATE SUM

# 只想知道两个榜单有多少共同成员(7.0+,不返回具体成员,更快)
ZINTERCARD 2 rank:a rank:b
方案 B:复合分值编码多维排序
redis
# 主维度:热度(0~999999);次维度:时间(越小越新,映射为 0~999)
# 编码:score = 热度 × 1000 + (999 - 秒内序号)
ZADD rank:feed 850995 item:1001
ZADD rank:feed 850990 item:1002

ZREVRANGE rank:feed 0 9 WITHSCORES
csharp
double Encode(double primary, double secondary)
{
    // 把 secondary 归一化到 [0, 0.999]
    return primary + secondary / 1000.0;
}
边界:
ZUNIONSTORE/ZINTERSTORE会一次性消耗两份内存(源 key + 结果 key),大榜单合并别在主库高峰做,放从库或离线。- 结果 key 必须有 TTL ,否则
tmp:*/cache:*中间结果越积越多。 - 跨 Slot :
ZUNIONSTORE/ZINTERSTORE要求所有 key 同一 Slot,集群下用 Hash Tag。 - double 只有 52 位尾数 + 1 位隐含前导 1------主维度和次维度加起来不能超过 2^53 的精确整数范围,否则低位会被舍掉,次维度排序失效。
- 别用"时间戳"做复合维度:毫秒时间戳本身就是 13 位数字,再乘个权重就爆精度了(这正是延迟队列的坑,见 3.3)。
- 能用
ZUNIONSTORE加权就不用复合编码 :如果两个维度可以"各自算分再加权合并",ZUNIONSTORE ... WEIGHTS更清晰。
3.7 玩法七:优先级队列 / 加权推荐
需求:任务按优先级调度(重要任务先出);或"带权重的随机推荐"。
方案 :分值 = 优先级(或负优先级,让高优先级排前面)。消费端用 ZMPOP(7.0+)从多个队列批量弹出最优先的任务。
redis
# 优先级队列:优先级越高,分值越小(先出)
ZADD task:queue 1 task:urgent_1
ZADD task:queue 5 task:normal_1
ZADD task:queue 9 task:low_1

# 弹出最高优先级任务
ZPOPMIN task:queue

# 从多个队列批量弹出(先试高优先级队列,空则试低优先级)
ZMPOP 2 task:high task:low MIN COUNT 10
csharp
// ZMPOP 从多个队列批量弹出最优先任务(7.0+,旧版 SDK 未封装走 ExecuteAsync)
var popped = await db.ExecuteAsync("ZMPOP", 2, "task:high", "task:low", "MIN", "COUNT", 10);
原子化优先级任务处理 Lua(含重试与死信):
lua
-- KEYS[1]: queue key
-- ARGV[1]: max retry count
-- 返回: 任务ID 或 nil
local key = KEYS[1]
local max_retry = tonumber(ARGV[1])

-- 弹出分值最小的任务(ZPOPMIN key 1 返回扁平数组 {member, score})
local task = redis.call('ZPOPMIN', key, 1)
if #task > 0 then
    -- 取任务 ID(数组第 1 个元素)
    local task_id = task[1]
    -- 用独立 key 记录该任务的重试次数
    local retry_key = "retry:" .. task_id
    -- 读取当前重试次数,没有则视为 0
    local retry_count = tonumber(redis.call('GET', retry_key) or "0")

    if retry_count >= max_retry then
        -- 超重试上限 → 进死信队列
        -- 死信队列的 score 用 os.time() 记录"进入死信的时间",与业务优先级无关
        redis.call('ZADD', 'queue:dead', os.time(), task_id)
        -- 清掉重试计数
        redis.call('DEL', retry_key)
    else
        -- 未超上限 → 重试次数 +1
        redis.call('INCR', retry_key)
        -- 重试计数 24 小时过期,防 key 堆积
        redis.call('EXPIRE', retry_key, 86400)
    end
    -- 返回任务 ID 给业务处理
    return task_id
end
-- 队列为空,返回 nil
return nil
边界:
- 优先级"饿死"问题:低优先级任务永远排在高优先级后面,可能长期得不到执行。解法是"老化"------定期抬高老任务的优先级,或按时间窗口轮转。
ZMPOPvsZPOPMIN:ZMPOP能从多个 key 批量弹(适合"多优先级队列"),ZPOPMIN只能操作单 key。BZMPOP的timeout必须是整数秒 (BZMPOP 0.5 ...会报错),且timeout = 0表示无限阻塞------生产环境慎用,可能被中间代理断连。ZPOPMIN是原子删除 :弹出后任务从队列消失。如果业务处理失败,需要主动重新ZADD入队;生产上建议用 Lua 把"弹出 + 处理 + 失败重入"包成原子操作。
3.8 7 个补充变体
ZSet 的玩法边界,本质上只受"你怎么设计 score"限制。下面 7 个变体只讲"score 怎么设计 + 关键命令 + 一句话边界",不展开完整代码。
变体一:自动补全 / 前缀搜索。 所有成员 score 统一设为 0,让 ZSet 退化成"按字典序排列"的集合,再用 BYLEX 做前缀扫描。
redis
# 所有成员 score 统一设为 0,让 ZSet 退化成"按字典序排列"
ZADD autocomplete 0 "apple" 0 "application" 0 "apply" 0 "banana"
# 取前缀 "app" 的候选词([ 闭区间,\xff 表示字典序最大后续字符)
ZRANGE autocomplete "[app" "[app\xff" BYLEX LIMIT 0 10- 关键点 :
ZRANGE key "[app" "(apq" BYLEX取app*前缀段([闭、(开);+/-表示最大 / 最小。 - 边界 :所有 score 必须相同,否则
BYLEX结果不可预期。前缀很短时匹配候选可能很多,LIMIT分页是必须的。成员长度超过 64 字节会触发 skiplist 升级。真要做生产级搜索,考虑 RediSearch。
变体二:热搜榜 + 热度衰减。 score = 热度值,定时任务按衰减公式回写(如每分钟 ZINCRBY key -衰减量 member,或整体 ZUNIONSTORE 重算)。
redis
# 多窗口加权合并:1h 权重 0.5,24h 权重 0.3,7d 权重 0.2
ZUNIONSTORE hot:ranking 3 hot:1h hot:24h hot:7d WEIGHTS 0.5 0.3 0.2 AGGREGATE SUM
EXPIRE hot:ranking 3600

# 整体衰减:每天所有内容热度打 9 折
ZUNIONSTORE hot:news:decay 1 hot:news WEIGHTS 0.9- 关键点 :衰减可以"读时算"(
score - k × 经过时长)或"定时回写";定时回写更省读开销,但要控制批量大小。 - 边界 :衰减回写是写操作,大热榜高频回写会成为新的写入压力源,建议只对 TopN 做衰减。
AGGREGATE SUM会把同一内容在多窗口分数相加;要"取最大窗口"用MAX。热搜榜通常需要"去重"和"多样性",应用层要在 TopN 结果上做二次过滤。
变体三:定时轮询 / 最小堆式调度。 score = 下次执行时间戳,调度器用 ZPOPMIN 取最早任务。
redis
# score = 下次执行时间戳,调度器取最早任务
ZADD scheduler 1730004000 "task:1"
ZADD scheduler 1730004060 "task:2"
# 弹出最早任务(注意:ZPOPMIN 不检查是否到期,见下方关键点)
ZPOPMIN scheduler- 关键点 :
ZPOPMIN不检查"是否到期"。正确做法是:先ZRANGE scheduler 0 0 WITHSCORES查看最早任务,未到期就 sleep 到到期时间;已到期再ZPOPMIN。高并发调度器要用 Lua 把"查最早 + 判断到期 + 弹出"包起来。 - 边界 :多个调度器实例会争抢任务,
ZPOPMIN原子但不保证"消费确认",弹出后实例崩溃任务就丢了。调度器空转要 sleep 或用通知唤醒。
变体四:热点监测------滑动窗口统计访问频次。 score = 访问时间戳,member = 请求 ID。
redis
# 记录两次访问(score = 访问时间戳,member = 请求 ID)
ZADD hot:product:1001 1730004000 "req:abc"
ZADD hot:product:1001 1730004001 "req:def"

# 滑动窗口计数(Lua 原子:删除过期 + ZCARD)
# 清掉窗口外的旧记录
ZREMRANGEBYSCORE hot:product:1001 -inf 1730003990
# 数窗口内次数
ZCARD hot:product:1001- 关键点 :
ZREMRANGEBYSCORE清窗口外旧记录,ZCARD数窗口内次数。 - 边界 :每个 key 一个 ZSet 会制造大量小 key;高 QPS 下 ZSet 会很大,必须配合清理和
EXPIRE;热点监测的 ZSet 本身可能成为热点,生产上按 key 分片或采样写入。
变体五:范围统计与分数分布。 score = 业务分值,member = 对象 ID。
redis
# 统计不及格人数
ZCOUNT stats:exam 0 59
# 统计中等人数
ZCOUNT stats:exam 60 79
# 总人数
ZCARD stats:exam- 关键点 :统计优先用
ZCOUNT(O(log N),只计数不返回成员),而不是ZRANGEBYSCORE拉出来数个数。 - 边界 :
ZCOUNT key -inf +inf等价于ZCARD,但贵得多------别用它算总数。高频统计建议定时预计算后存 Hash / String。
变体六:排名变化追踪。 排行榜(ZSet)+ 排名快照(Hash)。每轮取当前 TopN 排名,与上一轮快照对比,有变化就推送。
- 关键点 :快照用
HSET rank:snapshot:{周期} member 上一轮名次;对比"当前ZREVRANKvs 快照值",差值正负即升降。 - 边界:快照与 ZSet 之间没有事务保证,是"最终一致",不适用于强一致的排名结算场景。
变体七:签到统计与连续行为追踪。 score = 签到时间戳,member = 日期字符串。
redis
# NX 只记录首次签到,天然去重(score = 签到时间戳,member = 日期字符串)
ZADD checkin:uid:202611 NX 1762100000 "2026-11-02"- 关键点 :
NX天然去重;连续天数在应用层算(把成员按日期排序后从今天往前数连续性)。 - 边界:签到不是 ZSet 的最优解------如果只需要"某天有没有签",Bitmap(第 6 篇)一个 bit 一天、一年只需 46 字节,比 ZSet 省两个数量级。ZSet 的优势是"既要去重、又要保留时间明细"时才成立。
💡 一句话总结:ZSet 的玩法 = score 语义的映射。score 映射成什么(分数、时间、请求时间、优先级、热度、0),ZSet 就变成什么工具。设计 score,就是设计业务。
四、选型与边界
本章只做"需要有序 / 需要队列 / 需要去重"这一组的局部对比。不涉及完整类型级选型决策树(见第 12 篇),也不涉及 Stream 消费者组完整方案(见第 10/11 篇)。
4.1 四维对比
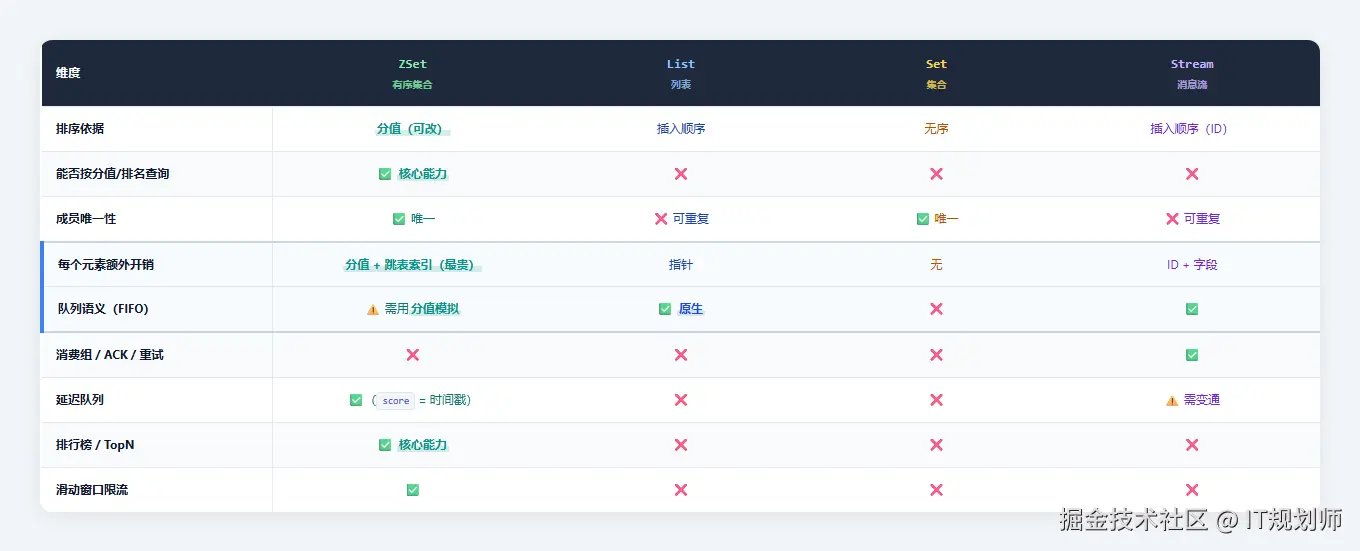
✅ 一句话落地结论 :要"按分值排序 / 排名 / 范围取值" → 用 ZSet;要"先进先出、允许重复、还要消费组和 ACK" → 用 Stream;只要"先进先出、不需要可靠投递" → 用 List;只要"去重、不要顺序" → 用 Set(别用 ZSet 浪费分值)。
4.2 常见需求选型速查
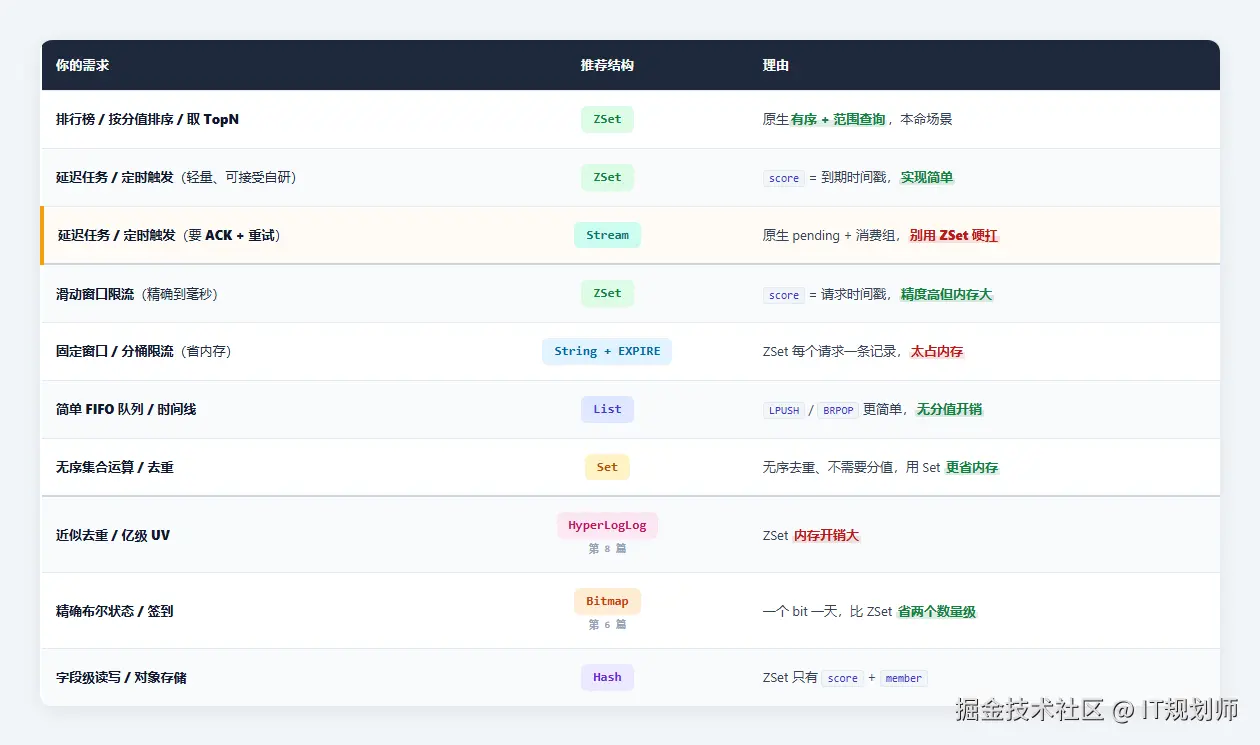
说明:ZSet 只出现在"需要排序或按分值 / 时间窗口取值"的场景;一旦需求退化为"只要去重""只要计数",就该换更省内存的类型。不要用 ZSet 做亿级 UV,也不要用它替代专业消息队列。
4.3 决策路径
text
你的元素需要"排序"吗?
├─ 不需要
│  ├─ 只要去重 ──────────────→ Set
│  └─ 只要先进先出 ──────────→ List(不需要可靠投递) / Stream(需要 ACK)
└─ 需要排序
   ├─ 排序依据是"我自己定的分值" ─→ ZSet
   │  ├─ 取 TopN / 排名 ────────→ ZSet(本命场景)
   │  ├─ 按分值当"到期时间" ────→ ZSet 延迟队列(注意 double 精度)
   │  └─ 按时间戳当"请求时间" ──→ ZSet 滑动窗口限流
   └─ 排序依据是"插入的先后" ────→ List / Stream
4.4 与 Stream 的边界
延迟队列这件事,ZSet 和 Stream 都能做,选谁?
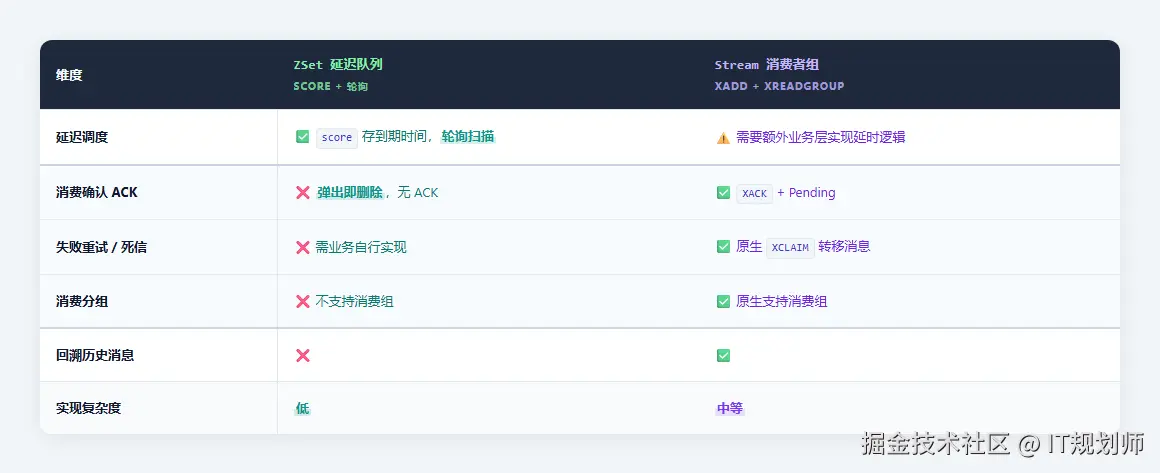
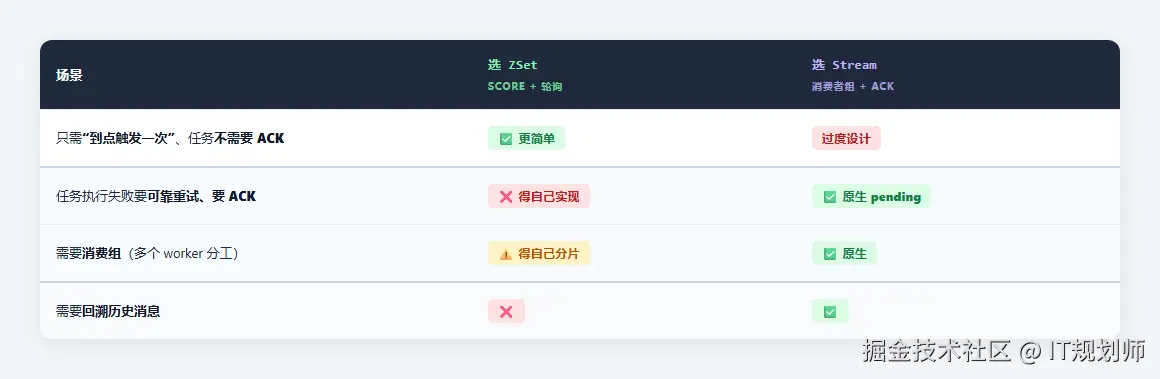
💡 一句话 :"定时触发"用 ZSet,"可靠消息"用 Stream。ZSet 延迟队列适合"允许少量数据丢失、秒级定时、轻量任务";需要"至少一次"投递语义、消费组、失败恢复时,优先选择 Stream。完整对比见第 11 篇。
4.5 ZSet 做不了的事
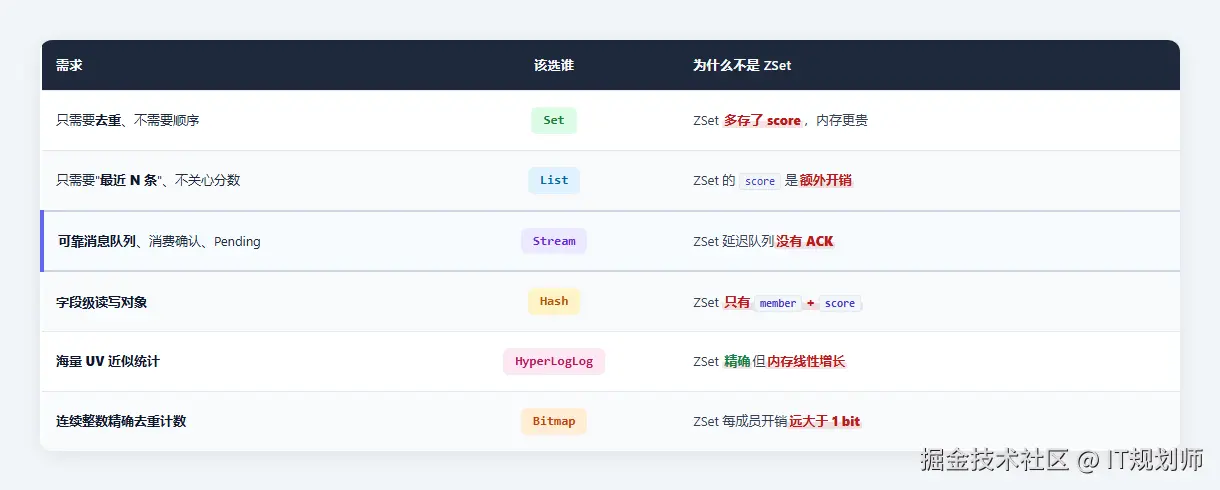
ZSet 只按一个维度的分值排序。所以它做不了这些:
- 多字段排序:不能同时"按热度降序、按时间升序"。要变通只能把两个维度编码进一个 double(见 3.6),或把结果拉回应用层再排。
- 非数值排序 :分值必须是数字。想"按字符串排",得先把字符串映射成数字(或利用
BYLEX的字典序,但前提是分值全相同)。 - 真正的"按时间排序":ZSet 的"时间序"是把时间戳当分值算出来的,不是它自己带的。
五、大榜治理与运维巡检
本章只讲 ZSet 这个类型自身的容量治理与巡检(分片、归档、裁剪、删除)。全局内存淘汰、碎片整理、慢查询定位的通用方法见 S7 / S13。坑点规避见第六章,本章不重复解释"为什么"。
5.1 先判断"这个榜算不算大"
- 成员数 > 1 万 或 单 key > 1 MB → 进入观察名单;
- 成员数 > 10 万 或 单 key > 10 MB → 必须治理;
- 成员数 > 100 万 →
ZRANGE 0 -1已经是阻塞源。
redis
# 全库扫描找大 key(别在高峰跑)
redis-cli --bigkeys
# 单 key 内存估算
MEMORY USAGE game:rank
# 成员数
ZCARD game:rank
# 编码(listpack / skiplist)
OBJECT ENCODING game:rank
5.2 治理手段
① 裁剪(Cap):只保留前 N 名,定期裁掉尾部。
redis
# 只留前 1 万名,裁掉尾部
ZREMRANGEBYRANK game:rank 10000 -1
② 分片(Sharding):大榜按维度拆成多个小榜,再合并取 TopN。
redis
# 按渠道分片,各渠道各一个榜
ZADD rank:channel:ios  1000 item:1
ZADD rank:channel:android 2000 item:2
# 合并取全站 TopN 时,ZUNIONSTORE 到临时 key 再取(注意 TTL)
③ 归档 :历史榜到期 EXPIRE,或导出到 DB/数仓后删除。
④ 冷热分离:Redis 只留"当前有效榜单",历史榜单落对象存储。
5.3 删除大 ZSet
redis
# 用 UNLINK 不用 DEL:异步回收大 key,避免阻塞主线程
UNLINK game:rank
csharp
// UNLINK 异步回收大 key,避免阻塞主线程(旧版 SDK 无专用封装,走 ExecuteAsync)
await db.ExecuteAsync("UNLINK", "game:rank");
5.4 巡检清单
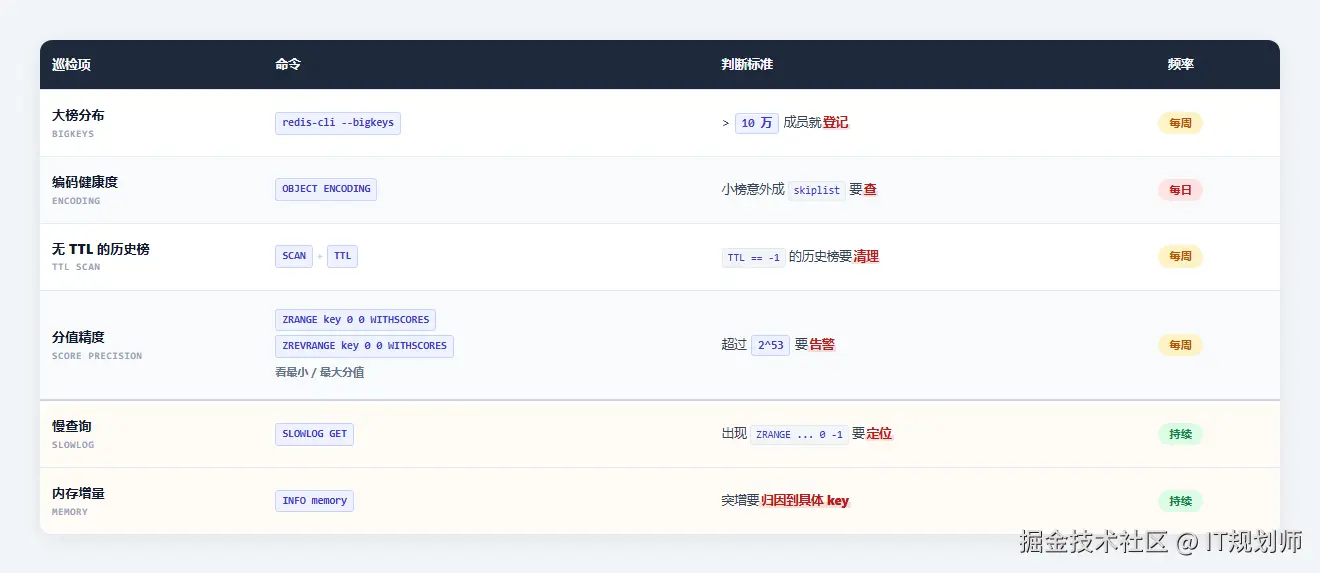
六、故障案例与坑点速查
6.1 典型故障案例
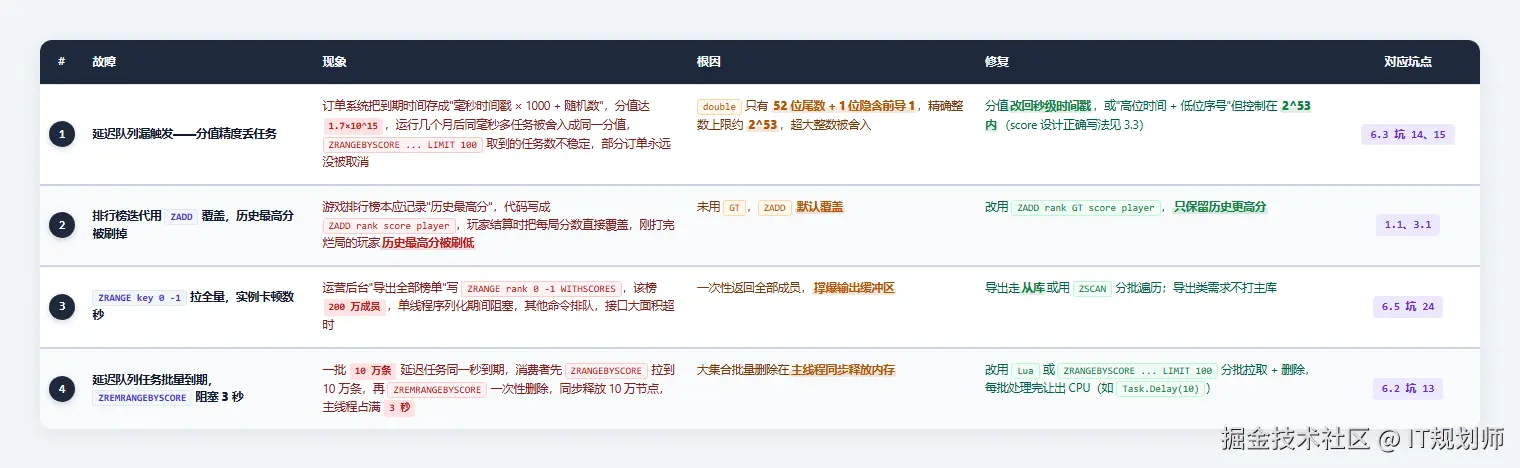
其余故障(
ZUNIONSTORE合并周榜内存翻倍、ZRANK未判空显示"第 0 名"、zset-max-listpack-entries误调大导致ZADD毛刺、滑动窗口忘记EXPIRE导致内存泄漏)的根因与规避。
6.2 命令坑
1. ZADD 默认返回"新增数"而非"修改数"
- 现象:改了分数却返回 0,误判"没写进去"。
- 根因:默认只统计新增成员。
- 规避 :需要判断生效就加
CH。返回 0 也可能是"分值未变"或"条件不满足",不一定是命令没生效------要确认是否真的写进去,结合CH或后续ZSCORE验证。
2. NX 与 GT/LT 混用报错
- 现象:命令直接报错。
- 根因 :
NX(只新增)与GT/LT(条件更新)语义互斥。 - 规避:二选一,复杂条件语义改用 Lua 或 WATCH。
3. 误以为 GT "只更新不新增"
- 现象:以为不会创建新成员,结果新成员被写进去了。
- 根因 :
GT/LT只约束"已存在成员的更新",不约束"新增"。 - 规避 :要"只更新不新增"用
XX GT。
4. ZRANGEBYLEX 在多分值下结果错乱
- 现象:字典序范围查出来的结果"不对"。
- 根因 :
BYLEX只在分值相同的连续段内按字典序比较。 - 规避 :用
BYLEX前把分值统一设成0。
5. LIMIT 用在了按排名模式
- 现象:命令报语法错误。
- 根因 :
LIMIT只支持BYSCORE/BYLEX。 - 规避 :按排名分页直接用
start stop下标。
6. ZPOPMIN 与 ZPOPMAX 方向记反
- 现象:想弹出最大值却弹出了最小值。
- 根因 :
ZPOPMIN弹最小、ZPOPMAX弹最大。 - 规避 :排行榜"出队 Top1"用
ZPOPMAX;.NET 里SortedSetPopAsync(key, Order.Descending)才对应ZPOPMAX。
7. ZRANDMEMBER 被当成"抽奖弹出"
- 现象:抽奖重复中奖。
- 根因 :
ZRANDMEMBER只随机取、不删除。 - 规避 :抽奖要
ZRANDMEMBER+ZREM(并发下需 Lua 原子化)。
8. ZREMRANGEBYSCORE 区间开闭写错
- 现象:窗口边界的请求被多算/少算一次。
- 根因:区间默认左闭右闭。
- 规避 :要开区间用
(value。
9. ZREVRANGEBYSCORE 的参数顺序和 ZRANGEBYSCORE 相反
- 现象:降序查分值区间时取不到数据或结果错乱。
- 根因 :
ZREVRANGEBYSCORE key max min第一个参数是 max ,而ZRANGEBYSCORE key min max第一个是 min。 - 规避 :牢记"降序先写大值、后写小值",或统一用 6.2+ 的
ZRANGE key max min BYSCORE REV。
10. ZINCRBY 加负数导致"扣分者"排序倒置
- 现象:扣分场景下,负分成员反而排到了榜首。
- 根因:ZSet 是"按分值从小到大"的集合,负数天然比正数小;分值语义混乱(既有正向得分又有负向扣分),升降序查询结果不可控。
- 规避 :统一分值语义------让所有分值都表达"越大越好",扣分改成"从基准分往下减",或用
GT/LT保护不倒退。
11. ZRANK 返回的是"物理下标",不等于"业务名次"
- 现象:多个用户同分时,前端展示的名次忽大忽小、对不上。
- 根因 :
ZRANK返回成员在有序集合里的下标(同分按 member 字典序),不是"按分值并列后的名次"。 - 规避 :需要"并列名次"时,用
ZSCORE拿分值后在应用层按分值分组再算名次;或用复合分值(见 3.1)把名次固化进 score。
12. 多步读写非原子,并发下超发或重复消费
- 现象:滑动窗口限流偶发超发;延迟队列同一任务被多个消费者执行两次。
- 根因 :
ZCARD + ZADD、ZRANGEBYSCORE + ZREM等多条命令分开执行,命令之间被其他客户端插队,读到的状态在写回前已变化。 - 规避 :把"读-判断-写"或"查-删"包进一个 Lua 脚本;延迟队列用
ZRANGEBYSCORE + ZREM同脚本,限流用ZREMRANGEBYSCORE + ZCARD + ZADD同脚本(见 3.3、3.4)。
13. 大 ZSet 批量删除阻塞主线程
- 现象 :延迟队列一批任务同时到期,
ZREMRANGEBYSCORE一次删十几万个节点,主线程卡住数秒。 - 根因 :
ZREMRANGEBYSCORE/ZREMRANGEBYRANK是 O(log N + M),M 为删除数量,释放内存和调整跳表都在主线程同步完成。 - 规避 :用 Lua
ZRANGEBYSCORE ... LIMIT分批取 + 删,每批几百到一千;或ZPOPMIN循环分批;删整个 key 用UNLINK(见 1.4、3.3、6.1 故障 4)。
6.3 分值坑
14. 毫秒时间戳 × 系数或拼随机数,超出 double 精度
- 现象:延迟队列运行一段时间后漏触发。
- 根因:double 只有 52 位尾数 + 1 位隐含前导 1,精确整数上限约 2^53,超大整数被舍入。
- 规避:用秒级时间戳;复合分值确保总量 < 2^53。
15. C# 里 long 时间戳隐式转 double 丢精度
- 现象 :
SortedSetAddAsync写入的分值和预期不符。 - 根因 :
score参数是double,超过 2^53 的long会被舍入。 - 规避:分值控制在 2^53 内,或做偏移(如减去一个基准时间戳)。
16. 分值用浮点做等值判断
- 现象 :
GT/LT的"相等不更新"行为不符合预期。 - 根因:浮点比较受精度限制。
- 规避:涉及等值的排序场景,分值尽量用整数。
17. 排行榜用 INCR 累加浮点分数,累积误差
- 现象 :分数出现
99.99999999这类值。 - 根因:浮点累加误差。
- 规避:分数用整数(如"分"为单位),或定期归一化。
6.4 编码坑
18. 一个超长成员把小榜打成 skiplist
- 现象:小榜内存突然变大。
- 根因:成员长度 > 64 字节触发升级。
- 规避:控制成员名长度(用短 ID),避免超长字符串做成员。
19. 批量导入把榜撑过 128,编码不可逆
- 现象:删回小规模后内存不降。
- 根因:listpack → skiplist 单向不可逆。
- 规避 :需要恢复最省编码时
DEL后重建。
20. 只看成员数估内存,忽略编码
- 现象:容量规划偏差大。
- 根因:listpack 与 skiplist 每成员开销差近 10 倍。
- 规避 :先
OBJECT ENCODING再估,skiplist 按"每成员约 120 字节"算。
21. 把 zset-max-listpack-entries 的 128 误当成"性能阈值"
- 现象 :调大阈值后
ZSCORE变慢,误以为 Redis 出了 bug。 - 根因 :listpack 的
ZSCORE是 O(N) 线性扫描,N 是成员数;阈值调大后 N 变大,延迟上升。 - 规避 :理解"128 是编码切换阈值,不是性能保证";对
ZSCORE延迟敏感的场景保持默认阈值或更小。
6.5 架构坑
22. ZUNIONSTORE/ZINTERSTORE 结果 key 忘设 TTL
- 现象 :Redis 里堆满
tmp:*中间榜单。 - 根因 :
*STORE的临时 key 常被遗忘。 - 规避 :
STORE后立即EXPIRE,或改用不落盘的ZUNION/ZINTER。
23. 集群跨 Slot 的 ZSet 运算报 CROSSSLOT
- 现象 :
ZUNIONSTORE/ZINTERSTORE/ZMPOP在集群上失败。 - 根因:多 key 命令要求同一 Slot。
- 规避:用 Hash Tag 让相关 key 落同一 Slot,或客户端聚合。
24. ZRANGE key 0 -1 拉全量
- 现象:榜单大时实例卡顿。
- 根因:一次性返回全部成员,撑爆输出缓冲。
- 规避 :遍历用
ZSCAN,只取 TopN 用ZRANGE 0 99 REV。
25. ZSCAN 遍历期间增删成员,可能丢数据或重复
- 现象 :用
ZSCAN导出全量榜单,结果不全或有重复。 - 根因 :
SCAN系列是弱一致性遍历,遍历期间若发生结构变化(如 rehash、编码升级),游标会不稳定。 - 规避:导出 / 对账类遍历尽量在从库或低峰期执行,遍历期间不要写入该 key。
26. 深分页性能衰减
- 现象:榜单第 1 页很快,第 100 页明显变慢。
- 根因 :
ZRANGE key offset offset+n官方复杂度是O(log N + M),但 offset 很大时实际退化为O(N),offset 越大越慢。 - 规避 :限制最大页码;或改游标分页(记住上一页最后一个成员的 score,下次用
BYSCORE从该位置继续,见 3.5)。
6.6 一页速查
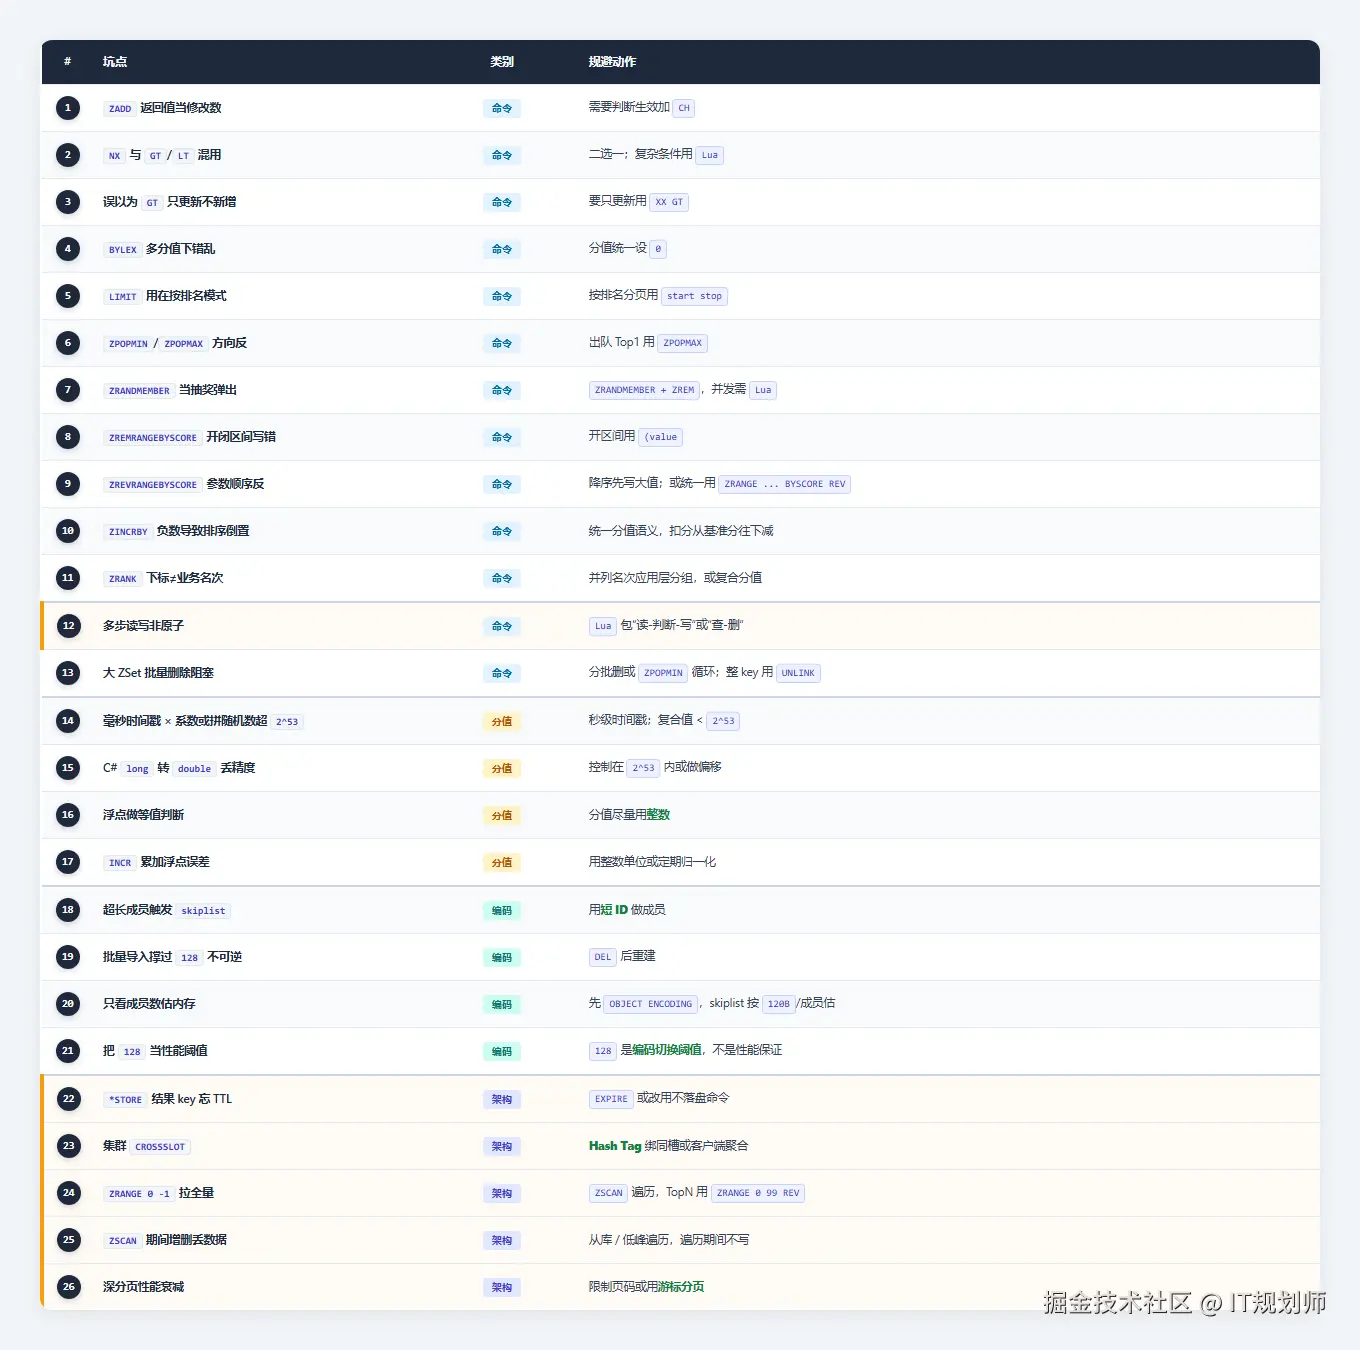
七、小结:10 条决策清单
- 双引擎是 ZSet 的根基。
ZSCORE在 skiplist + dict 编码下是 O(1)(字典),ZRANGE/ZRANK是 O(log N + M)(跳表)。代价是每个成员占两份索引,内存约为 Set 的两倍。 - 编码临界点记住 128 和 64。 成员 ≤128 且 ≤64 字节走
listpack(约 29B/元素,省约 3 倍内存);超出后走skiplist + dict(约 120~150B/元素)。升级不可逆;没有intset(那是 Set 的专属);ZSet 是 128,Hash 是 512,别记混。 ZADD六开关。NX(只新增)/XX(只更新)/GT(只记住更大)/LT(只记住更小)/CH(返回修改数)/INCR(原子加分)。排行榜防倒退用GT;NX与GT/LT互斥;GT/LT在成员不存在时仍会新增。ZRANGE三种模式。 默认按排名、BYSCORE按分值、BYLEX按字典序(分值需相同);LIMIT只支持后两种。6.2 之后ZRANGE统一了旧的ZRANGEBY*系列。红线:ZRANGE 0 -1和ZRANGEBYSCORE -inf +inf是全量操作,大 ZSet 禁用;Top N 的 N 必须有限,分页用LIMIT或游标。- 分值是 double,精确整数上限约 2^53。 延迟队列用秒级时间戳;复合分值确保总量 < 2^53;C# 注意
long隐式转double的精度丢失。score 设计铁律:一个维度一件事------不要把"时间戳 + 优先级 + 业务 ID"硬拼进一个 double。 - 多步读写判断并发下必须 Lua 原子。 延迟队列的"查 + 删"、滑动窗口的
ZCARD + ZADD、抽奖的ZRANDMEMBER + ZREM,分开执行都有竞态窗口。延迟队列还必须退避轮询(sleep 或通知);ZSet 延迟队列没有 ACK,不能丢的任务上 Stream。 - 7 种玩法本质是 score 语义的映射。 score = 积分 → 排行榜;score = 时间戳 → 延迟队列 / 时间线;score = 请求时间 → 滑动窗口限流;score = 权重 → 优先级队列;score = 热度 → 热搜衰减;全 0 → 字典序前缀搜索。把 score 想清楚,玩法自然出来。
- 选型边界。 要排序/排名/范围 → ZSet;要可靠消费(ACK/消费组/重试/回溯)→ Stream;简单 FIFO → List;只要去重 → Set;字段级读写 → Hash。"定时触发"用 ZSet,"可靠消息"用 Stream。
- 大榜治理四件事。 成员 >10 万或单 key >10 MB 必须治理;裁剪用
ZREMRANGEBYRANK留前 N;分片按渠道/时间拆小榜再合并;删除用UNLINK不用DEL。巡检看大榜分布、编码健康、无 TTL 历史榜、分值量级、慢查询。 - 故障复盘四条主因。 分值精度(2^53)、
ZADD覆盖(缺GT)、ZRANGE 0 -1全量、ZREMRANGEBYSCORE批量删除阻塞。对应规避:秒级时间戳、GT、ZSCAN/TopN、Lua 分批。