2026-10-05·编排与协作·Plan 系统
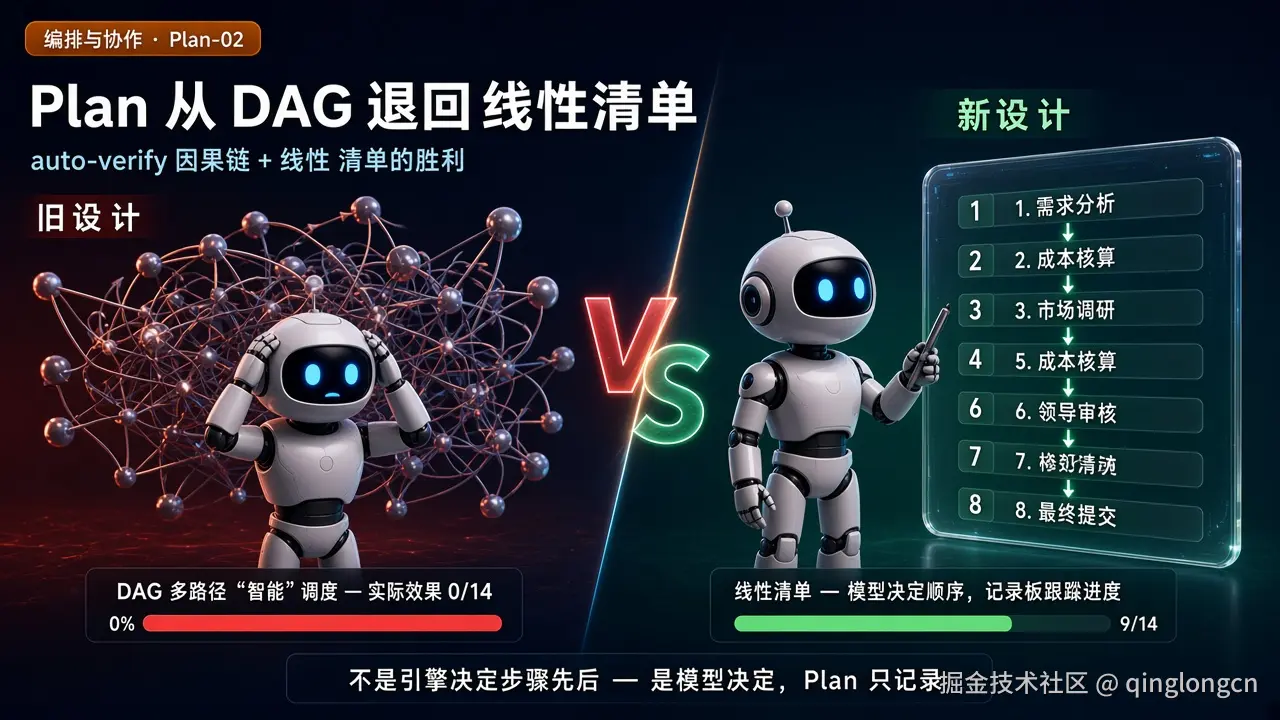
我们最初把 Plan 设计为 DAG------步骤有依赖关系、可以并行执行。然后花了两个月把它拆回线性清单。这篇文章讲的是这个'退回来'的完整过程:DAG 在理论上为什么诱人、在实践中为什么失败、以及'引擎不该替模型做认知判断'这条原则如何一步步被验证。
"依赖关系"听起来太对了
当你第一次设计 Plan 系统时,DAG(有向无环图)几乎是不假思索的选择。
一个"重构认证模块"的任务可以分解为:
bash
Step 1: 分析现有认证流程       → 无依赖
Step 2: 设计新的 token 方案     → 依赖 Step 1
Step 3: 修改 middleware          → 依赖 Step 2
Step 4: 修改测试                → 依赖 Step 3
Step 5: 更新 API 文档           → 依赖 Step 2(不依赖 Step 3/4)
Step 3 和 Step 5 可以并行------它们都依赖 Step 2 但互不依赖。DAG 可以表达这种关系,线性清单不能。引擎拿到 DAG 后做拓扑排序、并行调度无依赖分支------这在计算机科学里是教科书内容。
2026 年的学术界也在推这个方向。Atomic Task Graph(arXiv:2607.01942,2026 年 7 月发表)提出把 Agent 任务求解建模为 DAG,"explicitly exposing subtask dependencies, enabling parallel execution of independent branches, and localizing failures to the smallest affected region"。论文在 ALFWorld 和 WebShop 基准上展示了相比线性 Plan 的显著提升。
Task-Decoupled Planning(arXiv:2601.07577,2026 年 1 月)更进一步,提出一个 Supervisor-Planner-Executor 三层架构:Supervisor 把任务分解为 DAG 子任务,每个子任务有独立的 Planner 和 Executor,失败时只在受影响的子图内重新规划。
Plan-over-Graph(arXiv:2502.14563,2025 年 2 月)则让模型先分解任务为 DAG、再生成并行执行调度。实验显示 Claude 3.5 Sonnet 在 DAG 上达到 90% 成功率但只有 39.2% 最优率------能找到方案但难以优化。
看起来 DAG 是 Plan 的"正确"答案。我们也是这么想的。
我们的 DAG Plan 实现
最初的 Plan 结构体大致长这样(概念描述,不是源码):
bash
Plan {
  Steps: [
    { id: "step-1", description: "...", depends_on: [], status: "pending" },
    { id: "step-2", description: "...", depends_on: ["step-1"], status: "pending" },
    { id: "step-3", description: "...", depends_on: ["step-2"], status: "pending" },
    { id: "step-5", description: "...", depends_on: ["step-2"], status: "pending" },  // 和 step-3 并行
  ]
}
引擎的执行逻辑:
- HasCycle 检测 :创建 Plan 时检查
depends_on是否构成环 - DepsReady 判定:某步骤的所有前置步骤都 done 才标记为 ready
- ReadySteps 调度:每轮取出所有 ready 步骤,按优先级选择执行
- 模型选路或引擎调度:引擎从多个 ready 步骤中决定执行顺序
这套逻辑在编译原理课上是标准答案。
但在真实的 LLM Agent 中,它引发了一连串我们没有预料到的问题。
第一个问题:auto-verify 的因果链
这是最先暴露的 Bug,也是理解"为什么 DAG 不适合 LLM Agent"的关键。
症状
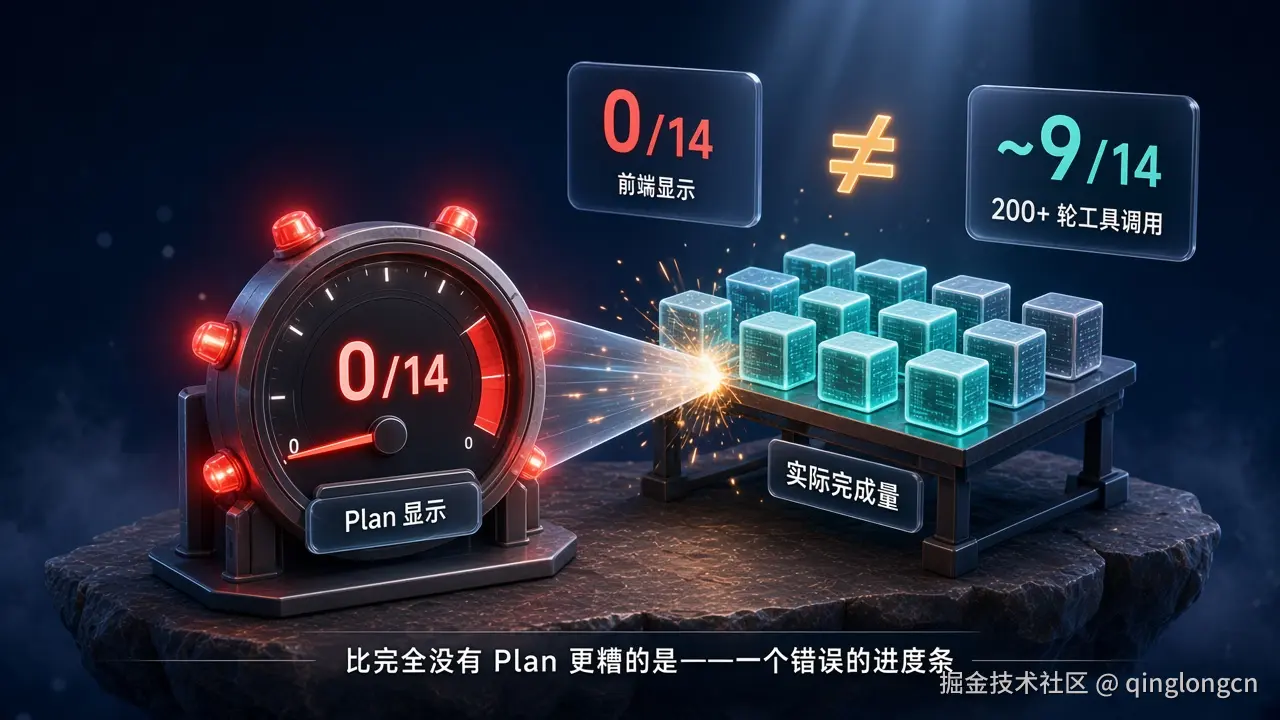
前端 UI 上显示的 Plan 进度:0/14。看起来模型什么都没做。
但打开引擎的可观测面板,工具调用记录显示模型做了大量 read、grep、exec、edit 操作------实际完成了大约 9 个步骤的工作。
0/14 和 ~9/14 之间的差距,来自一条隐藏的因果链。
根因链
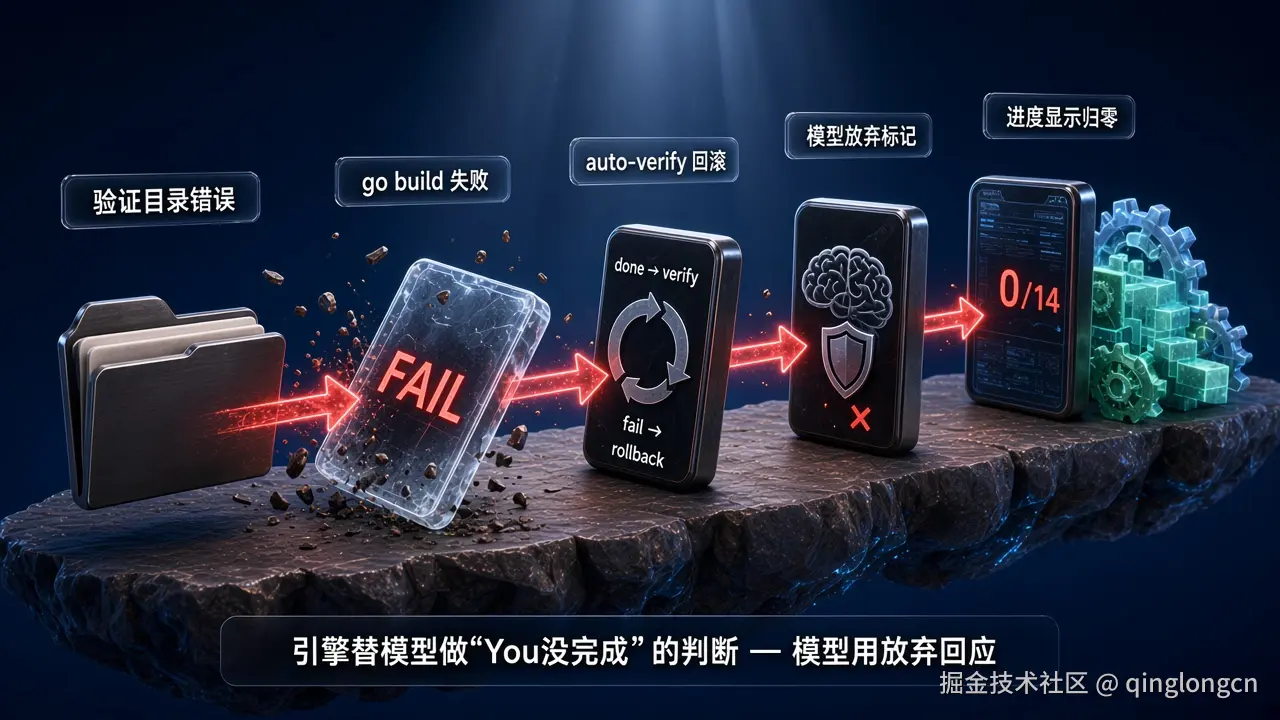
我们的 Plan 系统有一个 auto-verify 机制:步骤标记为 done 时,自动执行该步骤的验证命令(比如 go build ./...)。验证失败 → 自动回滚步骤状态到 in_progress → 模型看到"步骤未完成"→ 重试。
听起来合理。但验证命令的执行目录出了问题。
当时的实现从"项目根目录"取执行目录------这对应的是 VS Code 打开的根目录。在我们的开发环境中,VS Code 打开的是整个项目组织根,而代码实际在引擎子仓库中。
验证命令在错误的目录下执行 → 系统性失败 → 模型在几次尝试后学到 plan(update, done) 必定触发失败 → 放弃调用 plan → UI 显示 0/14。
用数据说话------auto-verify 因果链的完整传播过程:
| 轮次 | 模型行为 | auto-verify 结果 | 模型学到了什么 |
|---|---|---|---|
| 1-50 | 正常工作,不标 done | 未触发 | --- |
| 51 | 标步骤 1 为 done | go build 在错误目录执行 → 失败 → 回滚 |
"标 done 触发了验证失败" |
| 55 | 再次标步骤 1 为 done | 再次失败回滚 | "标 done 又失败了" |
| 60 | 标步骤 2 为 done | 同样失败 | "不管标哪一步,done 都失败" |
| 61-200 | 停止调用 plan(update, done) | 不再触发 | "plan 工具不安全,别碰" |
9 个步骤的实际工作被完成了------但 Plan 上显示 0/14。 差距来自模型对 auto-verify 的"条件反射"。
这不是一个简单的路径 Bug------它揭示了一个更深层的设计问题。
为什么 auto-verify 回滚是错误的设计
auto-verify 本身不是问题------在步骤完成后自动运行验证命令、检查结果,这是合理的。问题在于 验证失败触发自动回滚。
自动回滚意味着引擎在替模型做判断:"验证没通过 → 你没完成"。但实际情况远比这复杂:
- 验证命令可能在错误目录执行(如上述 Bug)
- 验证命令本身可能有 Bug
- 步骤可能在功能上已完成,只是有不相关的编译警告
- 模型可能已经知道验证会失败,计划在后续步骤中修复
验证应该是咨询信号("构建失败了,错误信息是 X"),不是执行权("因此你没完成")。 步骤是否"完成"这个认知判断,必须由模型做。
这和"为什么 Agent 需要 Plan"一章的结论一致:引擎不该替模型做认知判断。
第二个问题:模型不擅长生成正确的依赖关系
修完 auto-verify 的路径 Bug 后,我们发现了更根本的问题。
模型产出的 depends_on 经常是错的
典型错误:
- 过度依赖:模型把"读取文件 A"标记为"修改文件 B"的依赖------但实际上两者可以独立进行。模型的推理是"我需要先了解 A 才能改 B",但这个依赖是认知层面的(模型需要先看 A 的内容才能决定怎么改 B),不是执行层面的(A 和 B 的修改可以并行)。
- 遗漏依赖:两个步骤修改同一个文件的不同部分,但模型没有声明依赖------并行执行时产生冲突。
- 循环依赖:在复杂任务中,模型偶尔会生成循环依赖图。虽然引擎有 HasCycle 检测来拒绝,但被拒绝后模型通常无法自己修正------它不理解"为什么这个图有环"。
这不是模型太笨------是依赖关系在 Agent 场景中本质上是动态的。
模型在生成 Plan 时并不知道每一步的具体执行结果。步骤 A 的结果可能消除步骤 B 的必要性,或者创造一个新的步骤 C。静态的 depends_on 声明无法表达这种动态性。
学术 DAG 方案为什么在基准测试上有效
这里需要区分两种场景:
基准测试场景 (ALFWorld、WebShop、HotPotQA):任务类型固定、操作空间有限、每个子任务的输入输出明确。"打开柜子"和"拿起杯子"之间的依赖关系是确定性的------不受模型推理结果影响。DAG 在这类场景中表现好,是因为依赖关系本身就是确定的。
真实 Agent 场景(代码重构、文档撰写、多文件修改):每一步的结果会改变后续步骤的方向。模型可能在步骤 3 发现步骤 5 的假设是错的,需要追加一个全新的步骤 6。静态 DAG 无法表达这种运行时动态。
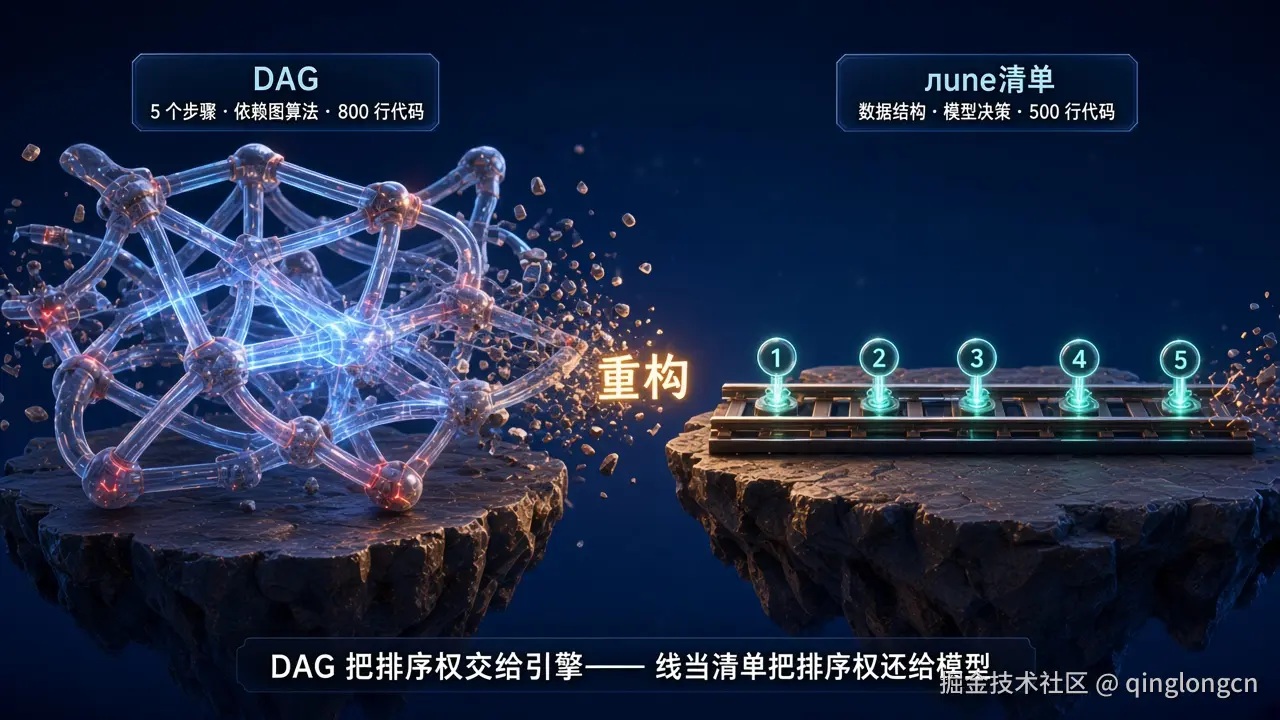
引擎维护 DAG 的成本远超收益------环检测、拓扑排序、就绪判断、并行调度、失败传播------这些逻辑加起来几百行代码,但在真实任务中,模型很少产出需要并行执行的 Plan。
第三个问题:"实质化"困境
DAG 引发的最后一个也是最隐蔽的问题:怎么判断一个步骤是否"完成"?
问题描述
模型在处理一个任务时,通常不会线性地做完步骤 1 再做步骤 2。更常见的模式是:
- 模型先大量读取文件(
read、grep、exec等探索性操作) - 这些操作可能覆盖 Plan 中多个步骤的范围
- 然后模型在一轮 plan-only 的调用中批量标记多个步骤为 done
引擎需要判断:模型说"步骤 2 完成了"------是真的完成了吗?
最初的实现:PlanUpdateGuard
我们最初加了一个守卫:同一轮(Turn)内必须有非 plan 工具调用,才能标记步骤为 done。逻辑是------如果你只调了 plan 工具而没有做任何实际工作,那你不可能完成任何步骤。
听起来合理。但实际场景是这样的:
bash
Turn N:   30 次 read/grep/exec(覆盖步骤 0、1、2 的范围)
Turn N+1: plan(update, step-0, done), plan(update, step-1, done), plan(update, step-2, done)
Turn N+1 是纯 plan 调用------没有非 plan 工具。PlanUpdateGuard 拒绝了步骤 1 和 2 的完成标记(只放行了步骤 0,因为一些特殊的"首个 pending 步骤"逻辑)。
结果:模型做了 30 次工具调用的实际工作,但 Plan 只承认了 1/3。前端显示 2/5 进度------实际工作量远超这个数字。
最终的解决方案:实质化同构
正确的判断标准不是"同一轮有没有做工具调用"------是**"该步骤仍处于 open 状态时,是否有过非 plan 工具调用"**。
这就是"实质化"(Substantiation)的概念:引擎维护一个 session 级的账本,记录每个 open 步骤在 open 期间有没有被"实质化"------即发生过真实的工具调用。记账可以跨轮次(Turn N 的调用可以为 Turn N+1 的步骤完成标记提供支撑)。
关键设计选择 :引擎无法把一次 grep 归属到某一个具体步骤(那需要理解 grep 的语义),所以所有 open 步骤共享同一条工作流盖章。如果步骤 0、1、2 都是 open(pending 或 in_progress),任何一次非 plan 工具调用都同时为三个步骤盖章。
这牺牲了精度(引擎验"调用存在"不验"调用成功"且不验"调用属于哪一步"),换取了和 LLM 行为模式的兼容------模型的探索性操作天然覆盖多个步骤,强制一一对应既做不到也没必要。
第四个问题:LangGraph 的教训------一个行业级验证
我们不是唯一走过这条路的。
LangGraph 的演进路径本身就是 DAG 方案从理想到现实的缩影:
- 2023 年 :LangChain 推出
SequentialChain------线性串联,太刚性 - 2024 年初 :推出
AgentExecutor------ReAct 循环,灵活但控制力弱 - 2024 年中:推出 LangGraph(StateGraph + 有向图)------想把 DAG 的控制力和循环的灵活性结合
- 2025 年 :LangGraph 在图模式之外增加了 Agent 模式(纯 ReAct 循环)------本质上回到了 while 循环
两年,一个完整的圈。从线性链 → DAG → 回到循环。
Reddit r/LangChain 上的一个帖子(200+ upvotes)记录了一个团队的类似经历:用单 Agent 配 6 个工具 + 巨大的系统提示词 → "幻觉工具参数、陷入无限循环、疯狂烧 token" → 最终换成 LangGraph 的三个"极其愚蠢、极其刚性的节点"------解析输入、路由、执行。不再 magical,但能调试。
这不是 LangGraph 的失败------是 DAG 编排在 LLM Agent 场景中价值有限的行业验证。
学术论文中 DAG 表现好的基准任务(ALFWorld 搬东西、WebShop 买商品)和真实的编程任务、企业任务之间有本质区别。真实任务的步骤之间的依赖关系是动态的、不可预测的------而 DAG 假设依赖关系在 Plan 生成时就能确定。
退回线性清单
最终的重构很干净------因为方向已经很清楚了:
- 删除
depends_on字段------执行顺序 = 数组顺序 - 删除 HasCycle / DepsReady / ReadySteps------不需要图算法
- auto-verify 降级为咨询信号------验证失败不回滚,返回结果和建议让模型自己决定
- PlanUpdateGuard 替换为实质化同构------跨轮次的 session 级账本
plan(complete)收口剩余 open 步骤------模型声明完成时,所有仍 open 的步骤被一并收口
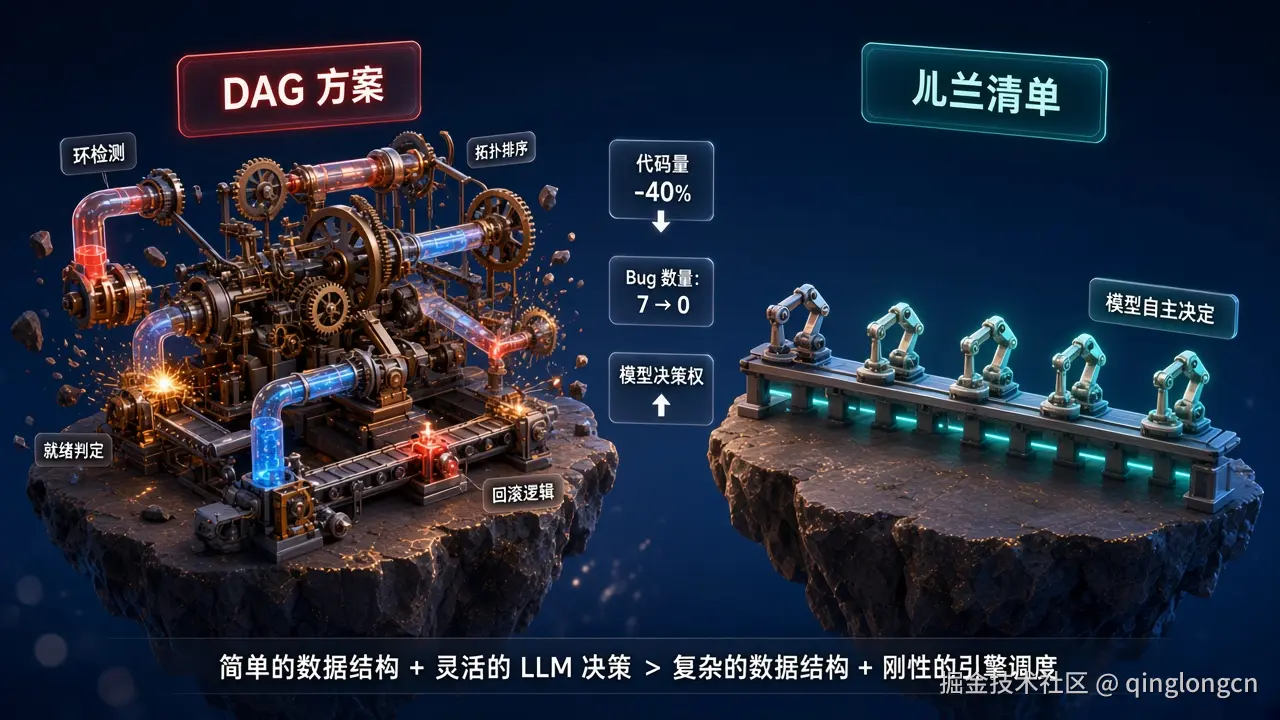
重构涉及引擎核心的 plan 工具实现、控制逻辑、状态持久化、事件发射、前端渲染------跨了大约 30 个文件。但核心逻辑反而简化了------删掉图算法后,Plan 系统的代码量减少了约 40%。
重构前后对比
| 维度 | DAG 方案 | 线性清单 |
|---|---|---|
| 步骤顺序 | depends_on 字段 + 拓扑排序 |
数组索引 |
| 并行执行 | 引擎调度无依赖分支 | 无(LLM 自己决定是否跳步) |
| 验证 | auto-verify + 失败回滚 | 验证为咨询信号,模型决定 |
| 完成判据 | same-turn 工具调用 | session 级实质化账本 |
| 异常处理 | 依赖链传播(步骤 A 失败 → B/C 被阻塞) | 模型自己决定跳过、重试或追加 |
| 引擎代码量 | ~800 行图算法 + 调度 | ~500 行线性执行 + 实质化 |
核心教训
教训一:引擎不该替模型做认知判断
DAG 的步骤排序、依赖检查、auto-verify 回滚------本质上都是引擎在替模型做认知判断。引擎在说"你应该先做 A 再做 B""你没通过验证所以你没完成"。
在模型能力较弱的时代(GPT-3.5 / 早期 GPT-4),这种"帮助"有价值------模型需要护栏。但随着模型能力跨过可靠自主决策的门槛,这些"帮助"变成了干扰。
正确的分工是:引擎管基础设施(持久化、可观测、崩溃恢复、隔离),模型管认知(规划、排序、验证判断、完成决策)。
教训二:动态环境下的依赖关系不适合静态声明
真实 Agent 任务中,步骤之间的依赖关系是运行时动态变化的。步骤 A 的结果可能消除步骤 B 的必要性。新的发现可能需要追加步骤 C。
线性清单把排序权交给 LLM------"你决定先做什么"。如果模型发现步骤 3 应该先做,它可以直接做步骤 3 而不需要"修改 DAG"。追加步骤只需要在数组末尾 append。跳过步骤只需要标记 skipped。
简单的数据结构 + 灵活的 LLM 决策 > 复杂的数据结构 + 刚性的引擎调度。
教训三:基准测试上有效不等于生产中有效
DAG 在 ALFWorld(机器人搬东西)和 WebShop(自动购物)上表现好,是因为这些环境的操作空间有限、步骤之间的因果关系确定。
真实的编程/企业任务没有这个特性。"重构认证模块"的步骤 3 可能揭示步骤 5 的假设完全错误------这在 DAG 中无法表达。
选择 Plan 数据结构时,要参照的不是基准测试得分,是真实任务中 LLM 的实际行为模式。
教训四:进度显示不能是假的
这是最实际的教训。DAG 方案下的多个 Bug(auto-verify 回滚、PlanUpdateGuard 拒绝、依赖链阻塞)最终的症状都是一样的:前端显示的进度远低于实际完成量。
0/14 vs ~9/14------用户看到的和实际发生的脱节。这比完全没有 Plan 更糟------至少没有 Plan 时,用户不会被一个错误的进度条误导。
DAG 仍然有价值的场景
需要公平地说:DAG 在某些 Agent 场景中仍然是正确的选择。
多 Agent 编排 :当不同的 Agent 执行不同的子任务,且 Agent 之间有明确的数据传递关系时(比如 "Researcher Agent 的产出是 Writer Agent 的输入"),DAG 是自然的表达方式。GitHub 的 Copilot 内部架构(awesome-copilot DeepWiki 文档描述了一个 gem-planner/gem-orchestrator 系统)使用 DAG + wave-based 执行,在多 Agent 协作场景中效果好------因为 Agent 之间的依赖是进程级的数据传递,不是认知层面的"我需要先想清楚这个"。
批量处理:当任务是"对 100 个文件做同一种操作"时,DAG 的并行优势真正体现。
短 horizon 任务:学术论文中的基准任务通常是 5-15 步。在这个复杂度下,DAG 的收益(并行、精确依赖)超过成本(生成错误的依赖关系、维护图一致性)。
我们退回线性清单,是因为我们的核心场景------单 Agent 在长 horizon 任务中自主执行------不适合 DAG。 这是场景选择,不是 DAG 本身的否定。
你现在能做什么
1. Plan 步骤用数组,不用依赖图。 如果你在自建 Agent 框架,把 Plan 定义为有序数组(steps: [{...}, {...}]),不加 depends_on 字段。让模型在运行时自主决定跳步或追加步骤------比引擎维护 DAG 更灵活、更不容易出错。
2. 验证命令的执行目录要显式指定。 不要依赖"当前工作目录"------在多仓库、monorepo、IDE 多窗口场景中,"当前目录"可能不是你以为的那个。验证命令中显式传入 --workdir 或 cd 到目标目录。
3. "Agent 的工作量"和"Plan 显示的进度"不一致时,先查进度机制。 如果 Agent 做了 100 轮工具调用但 Plan 显示 0/14------问题大概率在"什么条件下才能标记完成",而非 Agent 没在工作。检查完成标记的前置条件是否合理。
4. 模型产出的 depends_on 不可信------如果你必须用依赖关系。 人工审查模型生成的依赖图,或者限制为"最多 1 层依赖"(A→B 可以,A→B→C 不行)。深层依赖链中错误会累积放大。
引用来源
- arXiv:2607.01942, "Atomic Task Graph: A Unified Framework for Agentic Planning and Execution"
- arXiv:2601.07577, "Beyond Entangled Planning: Task-Decoupled Planning for Long-Horizon Agents"
- arXiv:2502.14563, "Plan-over-Graph: Towards Parallelable LLM Agent Schedule"
- LangGraph 演进:SequentialChain → AgentExecutor → StateGraph → Agent Mode --- GitHub - langchain-ai/langgraph: Build resilient agents. · GitHub
- Reddit r/LangChain, "LangChain is too magical, we ripped it out" (paraphrased, 200+ upvotes)
- DeepWiki, "Task Planning and DAG Architecture" (gem-planner/gem-orchestrator) --- Task Planning and DAG Architecture | github/awesome-copilot | DeepWiki
- SWE-EVO: Benchmarking Coding Agents in Long-Horizon Software Evolution Scenarios --- arXiv:2512.18470