💡 一句话总结 :做 Agent 后训练最头疼的是「没有可信环境」。人大、复旦、上交团队发布的 ToolSpace 把环境合成的顺序整个倒过来------不先造数据库,而是先从真实执行轨迹里挖出工具之间被验证过的依赖关系,让任务复杂度从工具组合空间里自然长出来。Qwen3.6-35B 七个长时程基准均分 23.0 → 41.0 ,744B 版本 56.6 分追平 Claude Opus 5,代码、模型、数据全部开源。
导语:你的 Agent 训练数据,可能从头就是「塑料」的
先问一个可能戳到你的问题:你给 Agent 做 SFT 或者 RL 的时候,训练环境哪来的?
大部分团队的路子是「合成」:挑个主题(比如订机票、管邮件),让模型生成一个数据库,再配上一些工具定义,最后编几个任务。听起来很顺,对吧?但跑过真实业务的人很快会发现不对劲------模型在合成环境里分数很高,一接到真实 MCP 服务上就露馅:参数格式对不上、调用顺序想当然、跨服务的任务完全不会拆。
想自己动手试?
11 月 3 日,人大、复旦、上交三校联合团队在 arXiv 挂出的 ToolSpace ,把矛头直接对准了这个「合成环境塑料感」的问题。论文的核心论断很锋利:工具才是 Agent 能力增长的原子单元,不是环境数据------你先造环境再派工具,顺序从根上就反了。
这篇论文到底想解决什么问题?
论文管现在的主流路子叫数据中心(Data-Centric)环境合成:先造数据库和场景,再从里面派生工具和任务。作者指出这个顺序有三个先天缺陷,每一个都对应一线同学熟悉的翻车现场。
- 工具-功能错配:合成工具的参数逻辑是模型照着假数据库编的,跟真实工具接口定义对不上。Agent 学到的不是「怎么操作真实生态」,而是一套只在你自己沙箱里有效的「塑料协议」。
- 编排不真实:工具之间该不该连、怎么连,靠随机连边或者让 LLM 拍脑袋判断。可真实工具链路是有业务逻辑的------先查列表再读详情、先创建再修改,这些关系让 LLM 主观猜,猜出来的图看着像那么回事,执行起来全是断头路。
- 任务困在单环境:工具被锁在各自的沙箱里,跨环境组合连个显式的可达关系都没有。而真实任务偏偏经常跨服务------查完 Gmail 再把结果写进 Google Sheets,再拉个 Slacking 群通知。单环境里永远练不出这种长链编排。
三个缺陷共享同一个根因:环境合成的依赖顺序反了。真实世界里,是先有工具及其组合关系,环境数据只是工具执行的产物。要解决,就得把这个顺序摆正。
它的思路是什么?
ToolSpace 的答案分两个阶段,我们一层层拆。
🛠️ 第一阶段:从真实轨迹里「考古」出工具组合图
首先,团队攒了 20 万条真实执行轨迹:一部分是在真实 MCP 服务上跑出来的(从 Smithery 注册表拿真实工具目录,只保留工具定义与线上服务器精确匹配的任务),另一部分从开放语料收集(Toucan-1.5M、ToolBench 的真实调用,SWE-agent/OpenHands 在真实容器里的操作记录),按执行真实性分三级递进过滤。
然后是全文最关键的一个设计决策:对轨迹里相邻的两次工具调用 ,用确定性规则(注意,不是 LLM 判断)连出三类边。
- 🔗 数据依赖 :下一步的输入用了上一步输出里的值,且字段类型匹配------比如搜索接口返回的
file_id被下游的读取接口拿去用了。 - 💾 状态依赖 :上一步修改了某个环境对象,下一步读写的是同一个对象,不是碰巧数值相等------先创建订单再查询这笔订单,才算。
- 🔁 重试依赖:上一步报错、换了个工具、下一步成功了。错误也是有效信息,连着成功重试一起保留。
每条边还带频率权重(这对工具组合在真实轨迹里出现了多少次),低频边和参数溯源不上游输出的假边(比如大家共用 limit=10 这种常数)直接剪掉。
为什么坚持规则而不是 LLM?这里先按下不表,后面消融实验的数字会告诉你这个决定值多少钱。
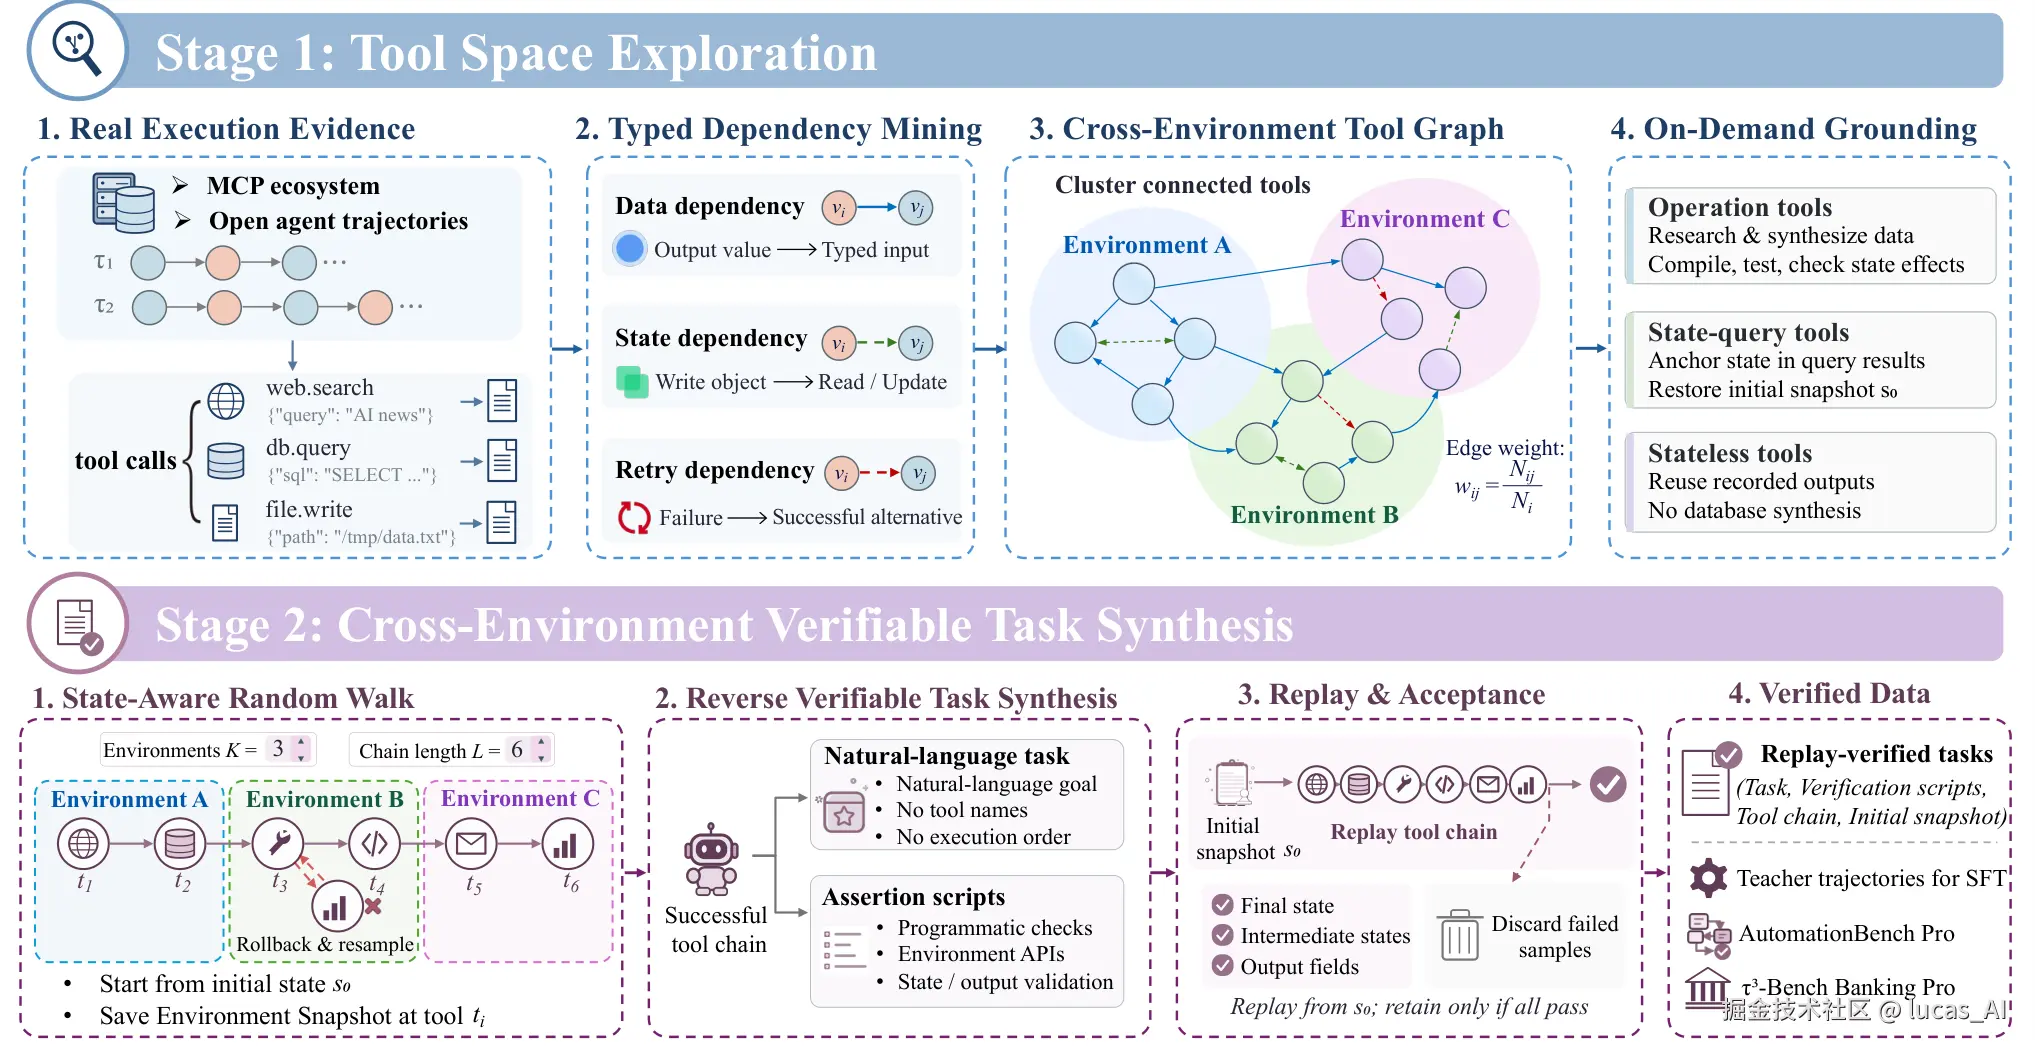
图说:左半边是 Stage 1------轨迹进、工具组合图出、按需造环境;右半边是 Stage 2------图上随机游走出长链,反编译成任务,回放验证通过才保留。
🗄️ 按需造环境:无状态的不造库,成本直接砍半
有了图,接着按连接密度聚类出 804 个环境簇。这里 ToolSpace 做了个很务实的区分------不是所有环境都值得造数据库:
- 操作环境(含增删改工具的,181 个,22.5%):才真正需要底层数据库,用研究智能体按主题从网络收集对齐数据、迭代扩展,过单元测试才保留。
- 状态查询环境 :不造库,直接拿
gmail.users.messages.get这类工具的真实返回值当锚点恢复初始快照。 - 无状态环境(623 个,77.5%):连快照都不要,缓存的工具返回直接当执行输出。
这个「选择性物化」策略的效果很直接:抽 500 个环境对比,数据中心方法 Agent-World 要合成 2,724 个文件,ToolSpace 只需要 1,218 个------少了 55.3%。省钱这种事,能从架构上省就别从工资里省。
🎲 第二阶段:带回滚的随机游走 + 回放验收
环境就位后,Stage 2 在图上做状态感知随机游走:从绑定初始状态的节点出发,每一步只考虑「输入能被之前返回值或当前快照填满」的邻居,按边权重采样下一步------真实世界里常一起出现的工具组合,更容易被走到。
游走是真执行的:每步真实调用工具、更新状态快照。执行失败或者状态跟所走的边类型对不上,就回滚到上一步重采。走满目标长度、跨够目标环境数,这条链才算活下来。
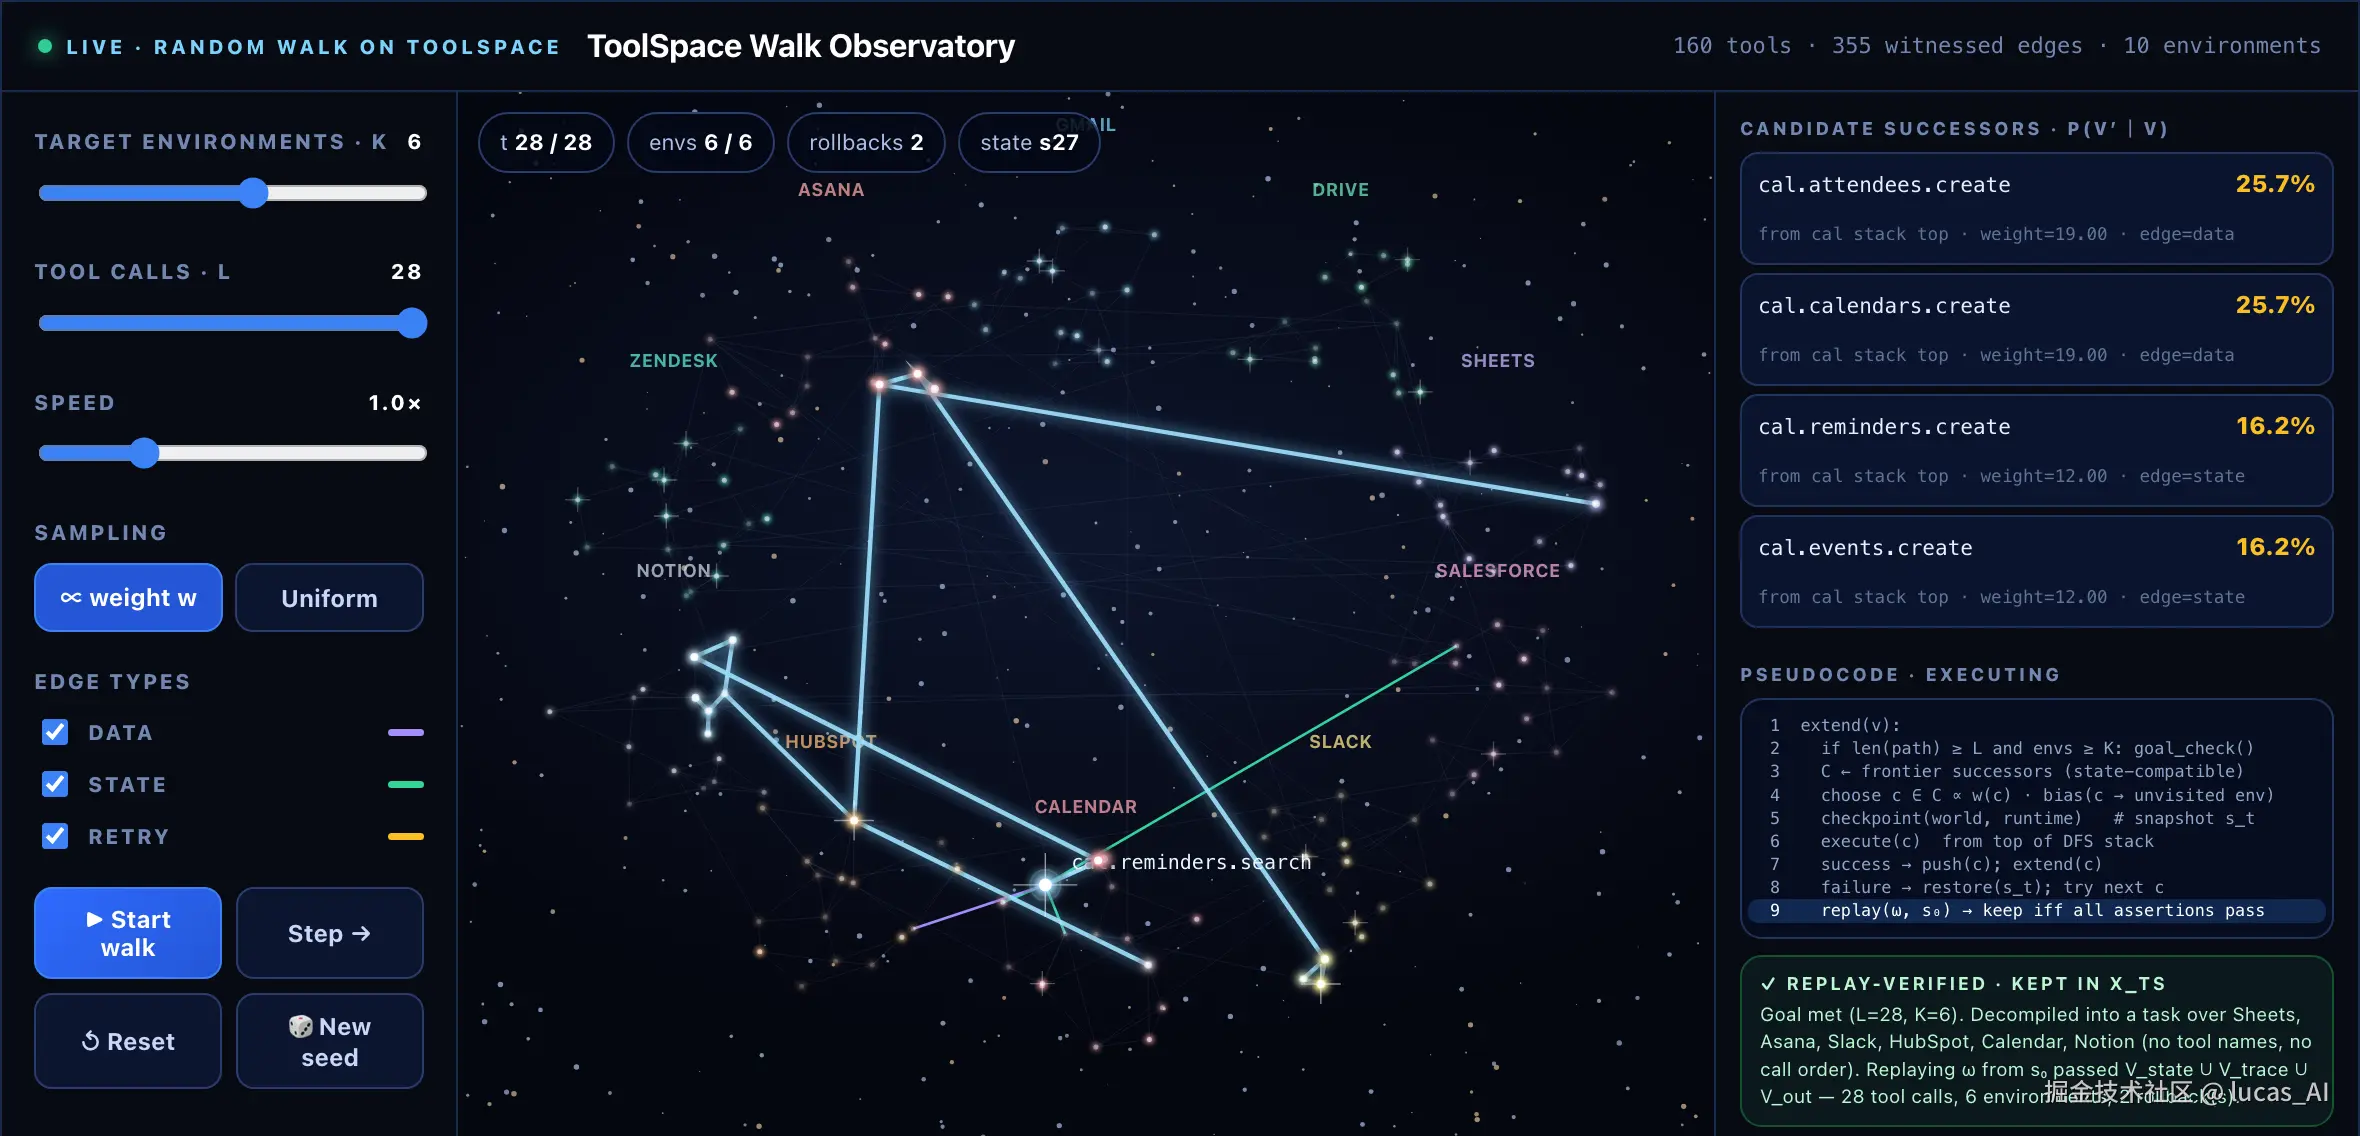
图说:项目页的交互 Demo 截图。右边能看到每一步的候选后继和采样概率------这不是画出来的示意图,是真实跑出来的执行记录。
最后一步是「反向出题」:让 LLM 把每条链路反编译成不含工具名、不含调用顺序 的自然语言任务(逼 Agent 自己做规划),同时生成三合一断言集------查最终状态、查关键中间快照、查返回字段。这条链要从初始状态完整回放一遍、全部断言通过,才能进训练集。
看出来了吧?整条流水线的哲学就是「宁可少要,不可造假」:边的真实性靠执行记录背书,链路的可执行性靠回滚保证,任务的可验证性靠回放验收。每层都在过滤「看起来像」的数据,只留「确实跑得通」的。
效果到底怎么样?
直接看数字。三个骨干模型(8B / 35B / 744B),七个长时程工具使用基准(AutomationBench、SkillsBench、JobBench、τ³-Bench Banking、BFCL V4、Harvey LAB、OfficeQA Pro),三个规模全涨。
- 🎓 35B 档最亮眼 :Qwen3.6-35B-A3B 底座均分 23.0,SFT 后 41.0(+18.0) ,再加 on-policy RL 到 43.2。同规模的 7-8B 环境扩展系基线(EnvScaler、Agent-World、Agent-Reflex)全都不到 10 分。
- 🧊 744B 档追平闭源旗舰 :GLM-5.2 骨干从 44.6 练到 56.6,与 Claude Opus 5 的 56.6 持平,超过 GPT 5.6 Sol(48.9),也超过它的教师模型 Kimi K3(49.7)。
- 📈 8B 档碾压同类:7.2 → 20.7,而全部 7-8B 环境扩展基线都在 10 以下。
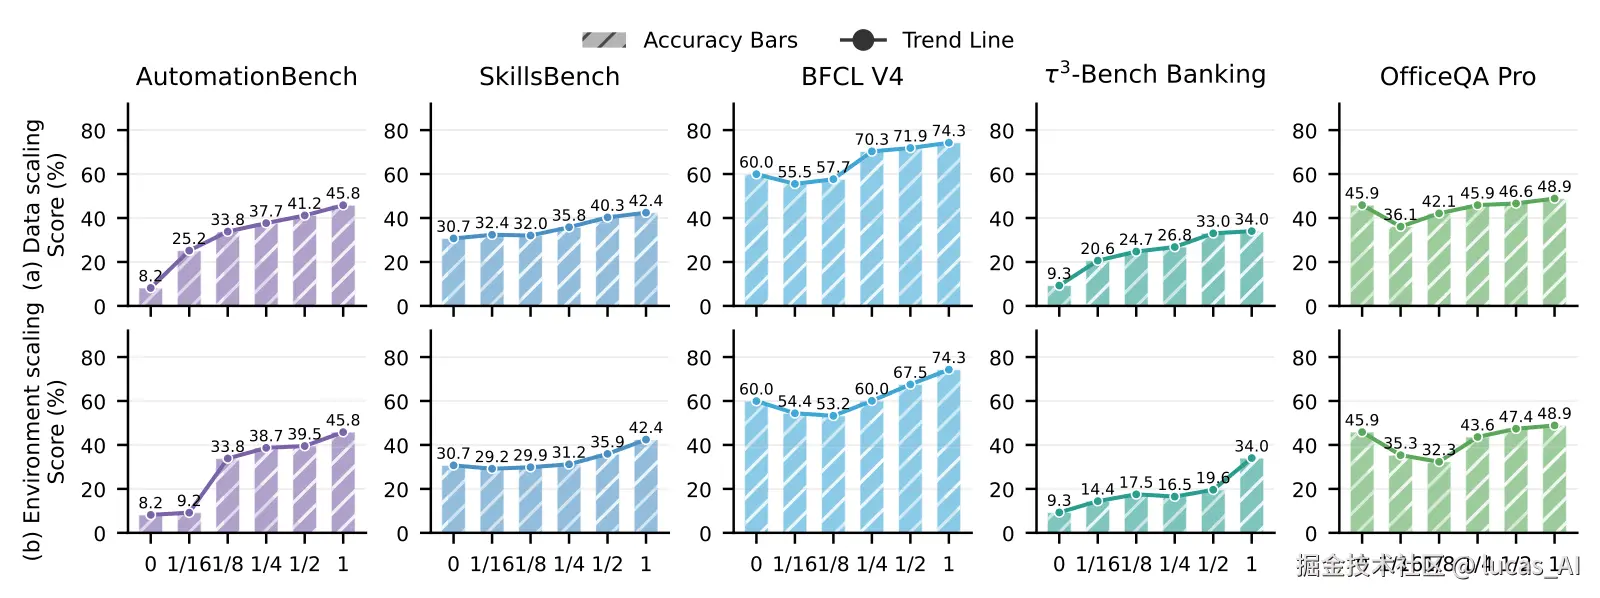
图说:左图是训练数据比例的 scaling,右图是环境数量比例的 scaling------两条曲线都在涨,说明增益不是靠一小撮高质量样本,而是真的来自组合空间的覆盖面。
更有意思的是两个「排除了侥幸」的分析。一个是环境相关性实验:把与评测基准最相关的前 50% 环境挑出来训练,跟随机抽 50% 比,四个基准差距不超过 1.7 分------说明收益不是过拟合基准环境,学到的确实是可迁移的组合结构。另一个是任务多样性:t-SNE 聚类下 ToolSpace 的合成任务形成 42 个簇,明显多于 EnvScaler(25)、Agent-World(31)、Agent-Reflex(34)。
还有一组数字专治「合成数据是不是塑料的」的怀疑------就是前面卖的那个关子。消融实验里,把「确定性规则挖边」换成「让 LLM 判断该不该连边」,五个基准全面退化,退化幅度几乎等于直接砍掉状态依赖边。换句话说,LLM 的主观编排判断不仅没加分,反而约等于噪声源。在执行证据可得的时候,朴素的规则赢了,而且赢得不小。
Pro 版基准更是把「难度上限」拉出来遛了一圈:用同一流水线把 AutomationBench 扩成跨环境的 Pro 版后,七个前沿模型全部大幅掉分,最大跌幅 38.2 分,Claude Opus 5.5 也掉了 32.9 分。跨环境长链编排,现在就是前沿模型的软肋。
为什么你要关心?
说三件跟你直接相关的事。
- 做 Agent 训练的团队:环境合成的成本大头(造数据库)可以砍一半以上------先问自己「这个环境真的需要持久状态吗」,无状态工具直接缓存回放。这个思路不需要全套 ToolSpace,明天就能在你自己的数据管线里用。
- 做工具生态/MCP 服务的:你的工具有没有被合成进训练数据,可能直接影响下游 Agent 对它的「肌肉记忆」。ToolSpace 的建图规则(数据/状态/重试三类依赖)反过来也是一份「工具接口设计检查清单」------参数可溯源、状态语义清晰的工具,才容易被 Agent 学会用。
- 做评测的:Pro 版基准的造法(同流水线扩难度 + 专家审核)给「基准太快被刷满」提供了模板。你的 benchmark 下次升级难度,未必需要人工出题。
再往远看一层:这篇论文和近期的 Agent-World、WorkRover 等工作一起,正在把「环境工程」变成 Agent 领域的正式分工------就像当年 RLHF 把「奖励建模」独立成一个岗位。数据合成不新鲜,带执行验收的合成才是这批工作的共同门槛。
理性看待
几处需要保持清醒的地方。工具图是从既有 20 万条轨迹里挖的,组合空间受限于轨迹里出现过的组合------冷门但有用的编排模式进不了图,随机游走也只在图内探索。回放验收保证「链路可重放」,但不保证「任务对人类自然」:断言锚定的是标准解法路径,可能误伤正确但路径不同的解法(论文未报告假阴性率)。744B 的对比也别简化传播------那是用 256 卡在 GLM-5.2 上特化训练过的版本,跟官方 GLM 5.3 并列看时别忽略这个差异。另外成本节省的 55.3% 是合成文件数的代理指标,不是真实的 token 或美元开销。