最近有不少关于 Anthropic 下一代模型 Claude Fable 5.5 的内部测试消息。
这次 Claude Fable 5.5 在查代码底层 Bug、猜用户真实意图,还有写复杂动画上的进步确实让人惊喜。不过 Anthropic 官方近期披露的另一项机制更引起我的注意。在这套叫 Self-Assessment(自评估)的机制下,我们每次跟 Claude 聊完天,它都会在后台悄悄对整段对话做一次看不见的安全审查。
今天就站在日常使用者的角度,结合外部流出的测试报道和官方技术文档,聊聊曝光的新模型有哪些看点,以及那个藏在暗处的审查机制是怎么回事。
Claude Fable 5.5 内部测试传出了哪些信息
先说说大家最关心的模型能力。虽然 Claude Fable 5.5 还没正式向公众开放,但从目前流出的早期内测报道来看,新版本没有搞那些花里胡哨的噱头,而是实打实地对准了平时干活最让人头疼的三个痛点。
写代码的人最怕遇到连环报错。以前把错误日志丢给模型,它多数时候就是头疼医头,给个局部修补的代码段,贴进大项目里很容易把别的地方搞崩。从这次流出的测试反馈来看,Fable 5.5 在编程调试上变聪明了,它不再只盯着报错的那一行修修补补,而是顺着报错信息和调用关系往底层扒,直接把数据结构定义或者异步逻辑里的病根找出来。要是正式版发布后真能稳住这个水平,平时维护老旧复杂项目就能省下大量跨文件排查的时间。
第二个让我觉得很省心的地方是意图理解。平时赶进度的时候,我们敲给 AI 的提示词经常写得丢三落四,只说了表面需求。内测反馈显示,Fable 5.5 现在很擅长结合上下文猜出我们真正想干什么。它能顺着前几轮对话里的代码环境或者业务背景,自己把没明说的限制条件补齐,直接去解决背后的实际问题。这样一来,我们就不用像以前那样反复修改提示词、一遍遍补充背景信息了。
另外在图形和动画生成上,新模型的耐力明显变强了。拿写交互式 JavaScript 动画来说,里面涉及物理碰撞、帧率控制,还有好几个元素的状态同步,以前写到一半很容易出现变量丢了或者画面逻辑断层。这次传出的测试消息里,Fable 5.5 在处理这种长周期、多步骤的复杂任务时,前后连贯性保持得很好,能一直记住不同组件在时间轴上的状态变化,一气呵成把复杂动画跑通。
不过作为老用户也得保持理性,目前关于 Fable 5.5 的这些表现都来自外部渠道的零散测试报道,还没有看到可复现的完整测试记录和统一的基准跑分,这些表现现阶段只能算初步观察,到底稳不稳还得等正式发布后我们自己上手试过才算数。
为什么每次聊完天它都要在后台搞自查?
模型写代码越来越溜、越来越懂人话,对我们干活肯定是好事,但站在平台的角度,管理压力也就跟着来了。这么强的代码追踪和任务执行能力,万一被黑客拿去写网络攻击脚本,或者被灰产拿去搭全自动诈骗工具,破坏力也同样惊人。
以前平台抓违规,多半靠敏感词过滤或者外挂一个小型的安全分类模型。但现在的违规操作都很隐蔽,多半藏在几十轮看起来人畜无害的技术探讨里。小模型根本看不懂这么长的上下文,很容易被绕过去。可要是平台专门在旁边架设一个同样庞大的大模型,把每个人聊天的长篇大论从头到尾重新读一遍来抓违规,那算力成本和电费账单直接就翻倍了。
为了省钱又省事地把安全网铺开,Anthropic 干脆想了个很取巧的工程办法,不找外援,直接让刚刚陪我们聊完天的 Claude 原地掉头,在后台顺手给刚才的对话打个安全分。
看不见的审查怎么运行,抓得准不准?
看完 Anthropic 官方放出的技术文档,我才搞明白这套已经在运行的暗中自查是怎么跑起来的。当我们看到屏幕上 Claude 敲完最后一个字,前端的回答就算结束了。但就在这一瞬间,系统会在后台悄悄塞入一条我们完全看不见的反思指令,让 Claude 顺着现成的对话缓存生成一份简短的评估,然后把里面的风险信号直接送进后续的审核队列。
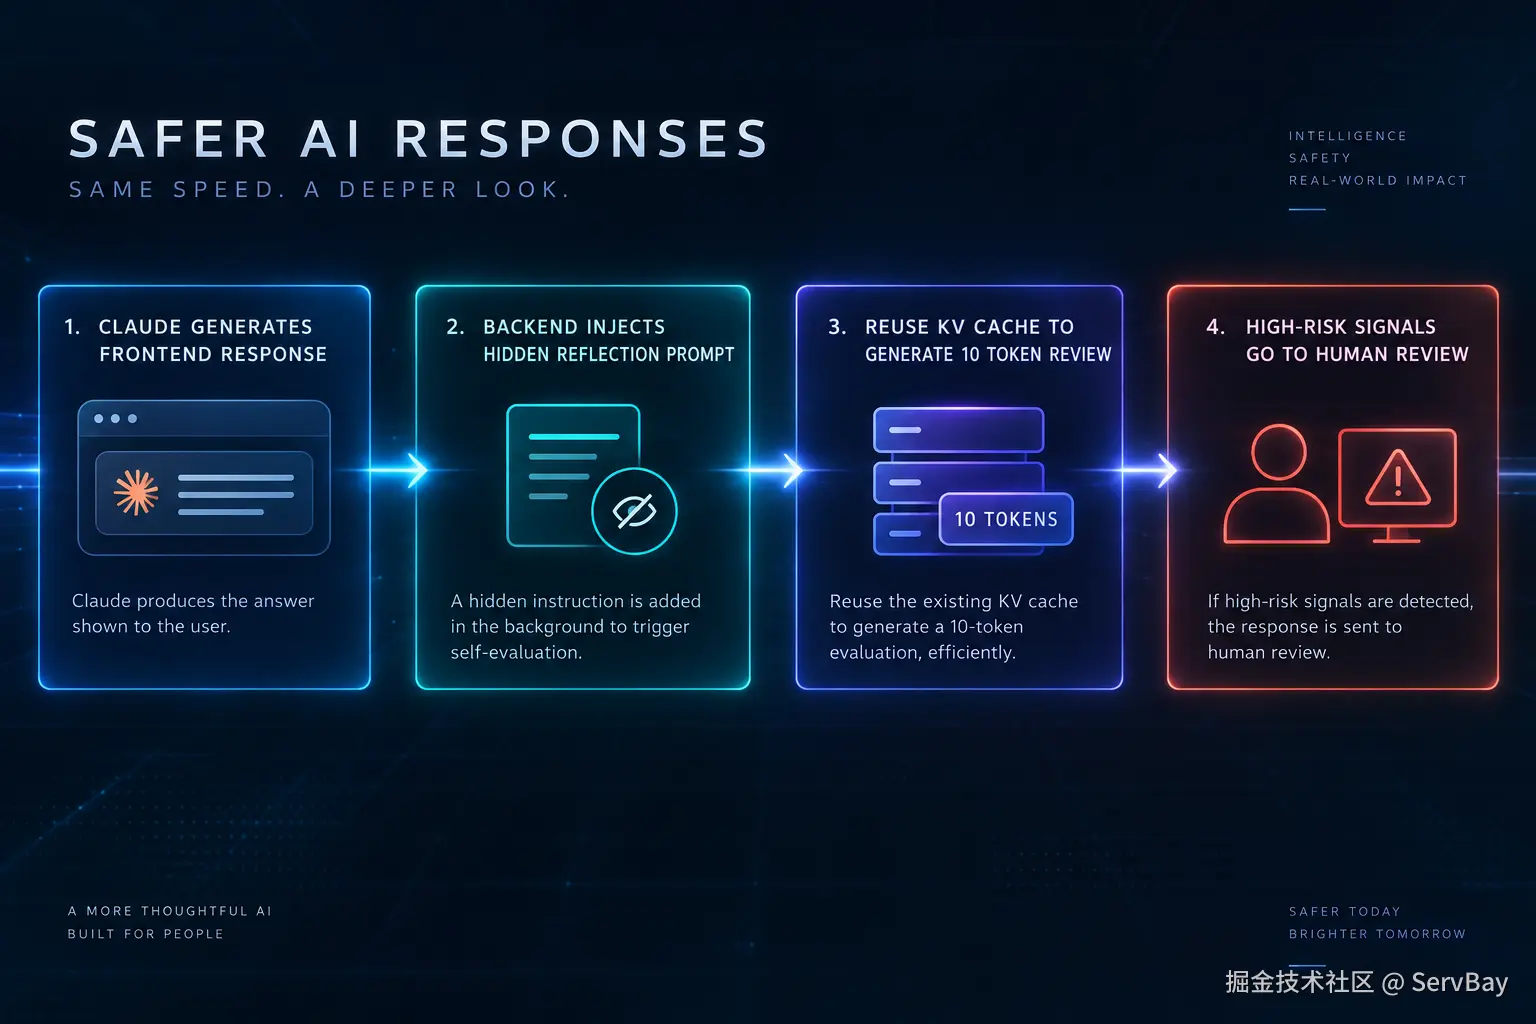
在这场不到一眨眼工夫的暗中审视里,Claude 会在后台默默回答五个问题,这段对话有没有潜在危害、属于哪一类风险、简短的判断理由是什么、刚才回答的时候有没有当场拒答,以及这件事需不需要人工审核紧急介入。
作为用户,我一开始还担心这种后台小动作会不会拖慢打字响应速度,或者偷吃我的 Token 额度。官方文档里解释得很清楚,因为整段对话的历史记录本来就已经保存在显卡的 KV Cache(键值缓存)里了,模型根本不用从头再读一遍,只需要顺着刚才的状态多吐出大约 10 个输出 Token 就能把小报告写完。官方测算,这步操作增加的额外推理算力连总量的 2% 都不到,而且这笔算力开销由平台自己承担,不会算在客户的账单头上。
只多花 10 个 Token,抓违规的效果还是很不错的。官方在现有的 Fable 5 模型上做过测试,拿一个体积庞大、专门用来抓违规的重型教师分类器做对比标准。数据显示,在把误报率严格压在 1% 的情况下,这种顺手自查能抓出 78% 的违规对话,而针对那些性质恶劣的高优先级风险,召回率更是高达 94%。
在实际应用里,这套机制主要用来捞出那些传统分类器漏掉的复杂违规,顺便帮安全团队摸清新型的滥用套路。官方披露过一个很典型的真实案例,之前有团伙用 Claude 批量生成嘘寒问暖的聊天话术,拿去搞全自动恋爱诈骗,也就是常说的杀猪盘。单看每一句对话,全是怎么关心人的正常闲聊,传统过滤器根本抓不到把柄。但 Claude 在每次回答完的暗中自查里,结合上下文察觉出了不对劲,多次把这些账号标为高优先级欺诈风险。安全团队顺着这些重复出现的信号介入人工调查,最后顺藤摸瓜封禁了这批账号。
当然,这套机制也不是铜墙铁壁。目前生产环境里的自评估主要是做离线监测和事后排查,并不会当场掐断对话。要是遇到真正懂行的攻击者,专门设计提示词把后面的自评估指令也一起忽悠过去,单靠这一招还是防不住的。
被 AI 暗中打分,对我们日常使用有什么影响?
知道自己每次聊完天都在被 AI 暗中审视,估计大家跟我一样,心里多少会有点犯嘀咕,生怕平时讨论点网络安全技术、写个爬虫脚本就被误判封号,也担心自己的业务代码和隐私数据被看光。
仔细翻了官方的说明后,有几个关系到切身利益的细节可以先吃个定心丸。
在平时聊天的时候,后台塞进去的那条评估指令和打分结果,我们前端完全看不见,而且绝对不会带进下一轮对话的上下文里。这就保证了 Claude 不会因为上一句刚做完安全反思,下一句跟我们聊天就变得畏首畏尾、答非所问。
至于大家最怕的误封问题,官方明确说单次对话被标为有风险,只是在后台留下一条调查线索,不会直接触发封号。后续审核会综合看风险的优先级,以及同一个账号是不是反复触发高危标记,凑齐了证据才会转交人工处理,正常敲代码调试不用太担心被一刀切。
在数据隐私方面,官方表示这套机制完全跟着现有的数据处理政策走。如果是签了零数据保留协议(Zero Data Retention)的企业客户,系统目前根本不会在那些流量上跑自评估。不过对于我们普通用户来说,一旦账号因为频繁触发高危信号被盯上,进入可疑违规调查流程后,平台依然会保留相关对话记录,并交给安全人员进行人工查看。
总结
把这次 Claude Fable 5.5 的内部测试消息和后台自评估机制放在一起看,其实能很清楚地摸到 Anthropic 接下来的产品脉络。对于没时间细看长文的朋友,我把最值得关注的几个要点浓缩在了下面。
-
能力升级对准真实痛点,从流出的测试报道来看,尚未发布的 Fable 5.5 在查代码底层根因、结合上下文补全模糊意图、维持长周期动画状态三个方面表现亮眼,但这批反馈尚属早期外部观察,真实水平有待正式发布后验证。
-
后台自查实现低成本风控,每次回答结束后,Claude 会利用现成的 KV Cache 顺手生成约 10 个 Token 的安全评估,额外算力消耗低于 2% 且由平台买单,在 Fable 5 的测试中以 1% 误报率抓出了 94% 的高优先级风险。
-
日常使用体验不受干扰,隐形评估结果不展示、不进入下一轮对话,单次风险标记仅作线索不会直接封号,签署零数据保留协议的企业流量完全豁免此项审查。
站在日常使用者的角度,我们当然期待 Fable 5.5 早点正式发布,给我们带来更聪明、更省心的干活工具,但也同样在意头顶那把安全尺子的尺度。随着大模型越来越深入我们的工作流,未来评价一家 AI 服务好不好用,比的不仅是前台的代码写得有多溜,还要看它后台那双看不见的审查眼睛能不能做到透明、克制、不误伤好人。只有把这条边界守住了,我们才敢放心地把真正的重活累活交给它。