本篇主角,DataKit 采集器与四条数据通道,其中 RUM 走官方 SDK
环境,cn3 北京站点,DataKit 2.16.1,Windows 主机,一个 Spring Boot 业务系统
一、先泼一盆冷水
很多人评测可观测平台,流程是装个 Agent,看一眼面板出图,然后开始夸。这么玩其实测不出东西。真正的分水岭在接入层,数据进不来,后面所有功能都是空中楼阁。
接入层为什么是命门,想清楚一件事就明白。数据断一天,监控就是盲区,告警就是哑巴,出了故障你连第一现场都找不到。生产环境里这段盲区的时间成本,是按小时算的加班费和用户投诉单。我见过太多团队平台买得很贵,接入却是半吊子,面板上好看的曲线只覆盖了三成流量,剩下的七成在裸奔,出了事才发现监控是个摆设。
我这台 Windows 主机上跑着一套脱敏业务系统,还原一个电商的完整链路,用户进站,大模型咨询,下单,支付。要让它出现在观测云里,得先把四条通道全部打通。指标走 UDP 8125 的 StatsD,日志走文件采集,链路走 9529 端口的 ddtrace,用户访问数据走官方 RUM SDK 的公网 OpenWay。
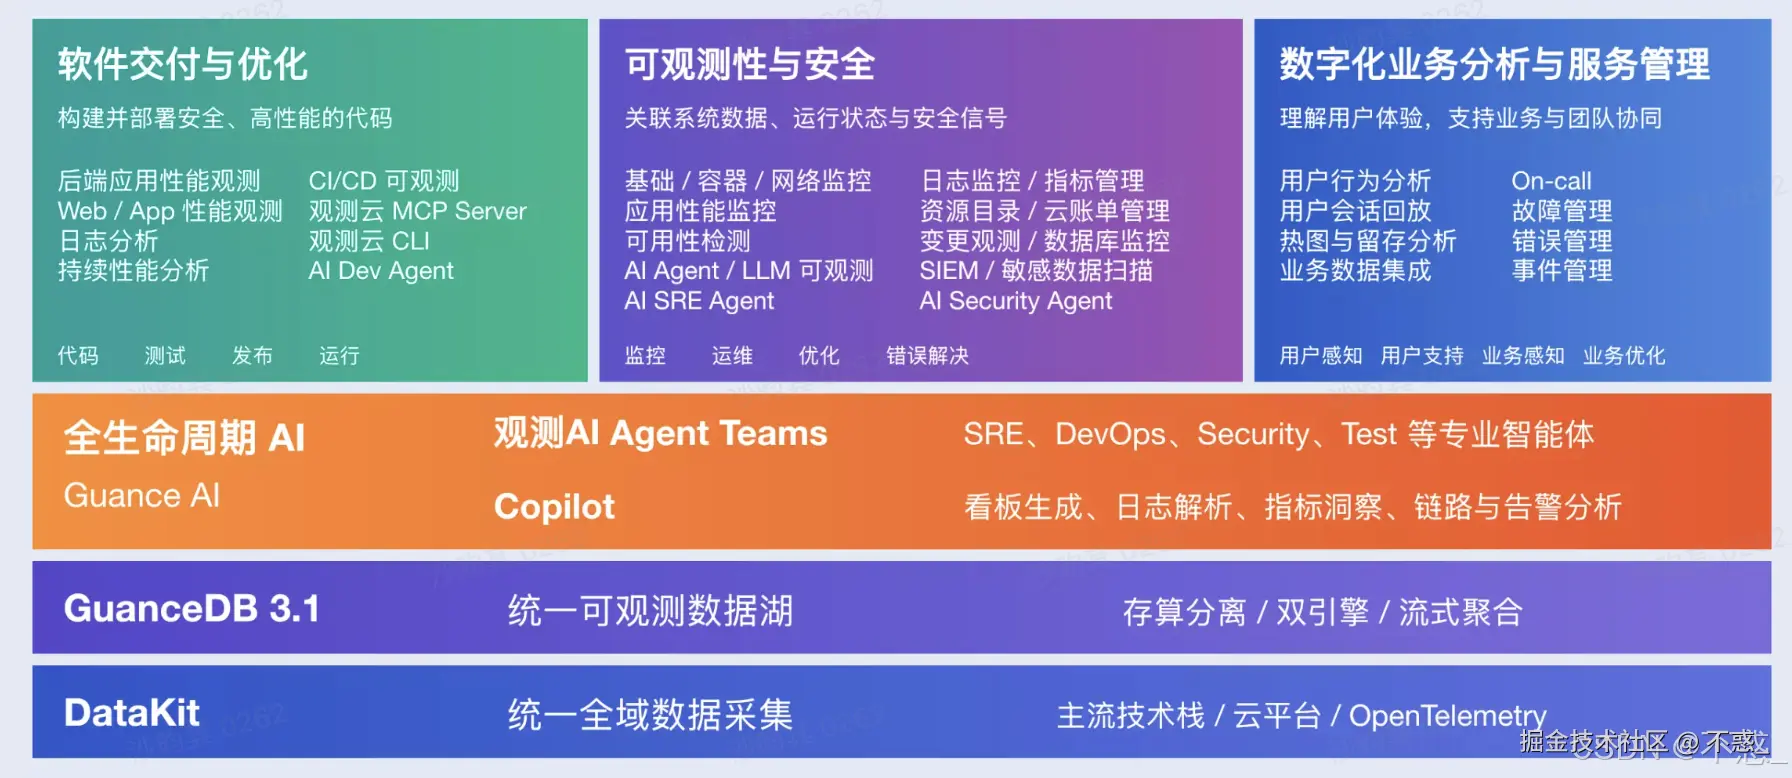
三条走 DataKit,一条走 SDK,三个坑。这篇文章就把踩坑过程完整摊开,坑怎么定位,怎么修,以及怎么让它们别再发生。
二、第一条通道,指标
装完 DataKit,默认只有主机基础采集器。要让业务指标进来,得启用 statsd 采集器,监听 UDP 8125。
配置短得离谱。
TOML
[[inputs.statsd]]
  protocol = "udp"
  service_address = ":8125"
  parse_data_dog_tags = true
应用侧用 Micrometer 的 StatsD 注册表,把计数器往 8125 扔。这条通道是最顺的,几秒钟就通了。判断标准很简单,发一个探测指标,一分钟后在指标查询里能搜到,通了。
有个细节值得说。parse_data_dog_tags 这个开关必须开,否则指标带不上业务标签,后面按渠道,按运行批次过滤全都免谈。标签丢了,指标就只剩一个总数,分析价值砍半。
三、第二条通道,日志,一个开关值千金
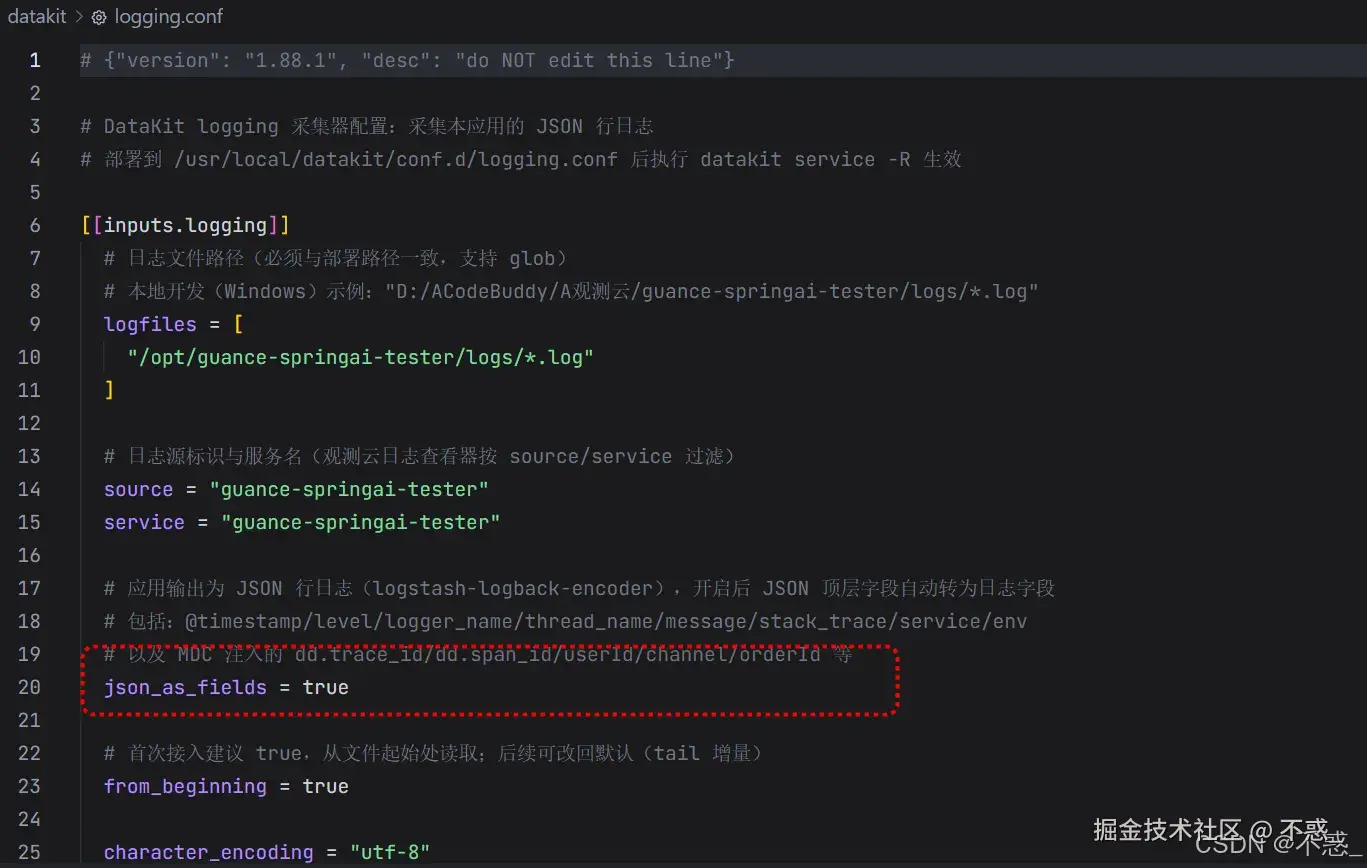
日志通道配置也不复杂,但藏着一个决定成败的开关。
TOML
[[inputs.logging]]
  logfiles = [".../logs/*.log"]
  source = "guance-springai-tester"
  json_as_fields = true
json_as_fields = true,就这一行。日志是 JSON 行格式,开了它,每个字段都被展开成可检索列。runId,userId,channel,orderId,trace_id,全都能直接筛。不开它,这些字段混在 message 一坨文本里,检索等于瞎子摸象。
我实测过新鲜度。应用打完日志,到查看器能搜到,延迟稳定在一分钟以内。这个数字后面几篇会反复用到,因为它是全链路对账的时间底线。
还有个容易翻车的点,logfiles 必须写绝对路径,Windows 下正反斜杠都认。配置完记得重启 DataKit,采集器默认只 tail 新写入的行,老日志不会回扫。
四、第三条通道,链路,我被 503 骗了很久,官方模板其实一行不缺
轮到链路通道,故事来了。
应用侧注入 dd-java-agent,参数指到 127.0.0.1 的 9529。启动,看日志,一切正常。定时任务在跑,业务在产出,指标日志都在平台里出现。
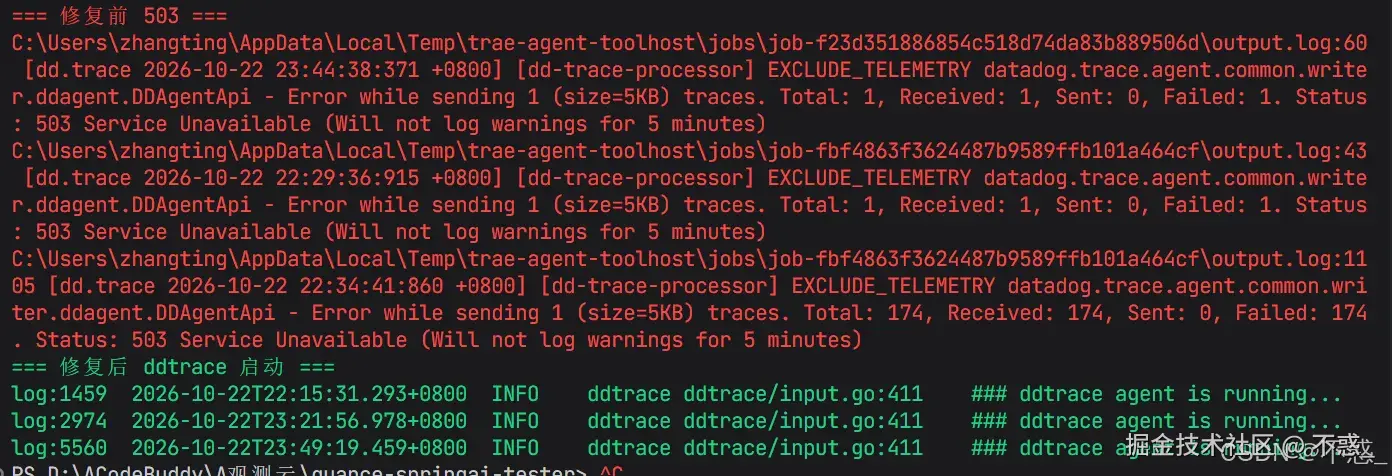
直到某天我翻应用日志,发现一行不起眼的警告。tracer 往 9529 发链路,服务端回 503。查 DataKit 状态,ddtrace 采集器明明在运行。
那一刻的心情很复杂。进程活着,端口活着,采集器状态正常,唯独数据不来。这种半死不活的状态比彻底挂掉更磨人,因为它不给任何线索。要是服务直接起不来,报错信息会指路,这种能跑但数据失踪的,排查起来全靠猜。
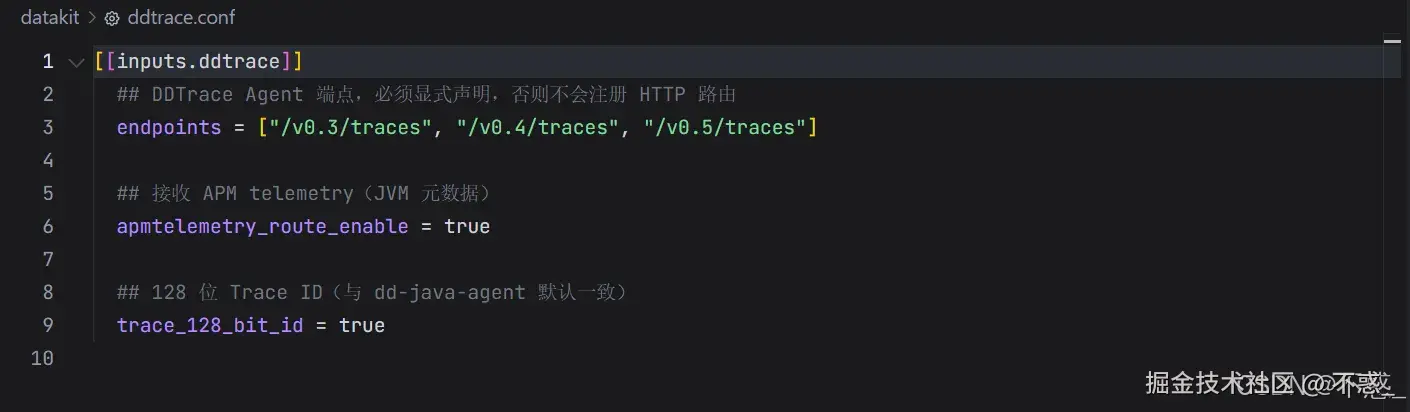
卡了一阵才定位到根因。DataKit 的 ddtrace 采集器配置里,如果只写 \[inputs.ddtrace] 而不声明 endpoints,HTTP 路由根本不会注册。采集器活着,端口活着,但 /v0.4/traces 这个路径没人接,请求直接 503。更隐蔽的是,采集器日志里没有任何报错,因为它压根不知道自己该监听这些路径。
这里得说句公道话。官方模板不是这样,DataKit 自带的 ddtrace.conf.sample 里 endpoints 是齐全的,我当时的错在于手写了一个最简配置,把这一行省了。新环境照着模板复制,根本不会遇到这个坑。
正确做法比想象中简单。
Linux 主机,进 conf.d 目录,把样例复制成正式配置,重启 DataKit。
Bash
cd /usr/local/datakit/conf.d
cp ddtrace/ddtrace.conf.sample ddtrace/ddtrace.conf
datakit service -R
Windows 主机,在 DataKit 安装目录下找到 conf.d\ddtrace\ddtrace.conf.sample,把文件名改成 ddtrace.conf,然后重启 DataKit 服务。
模板里已经写好这一段,不用自己补。
TOML
[[inputs.ddtrace]]
  endpoints = ["/v0.3/traces", "/v0.4/traces", "/v0.5/traces"]
如果你已经复制过模板,还是 503,先别怀疑模板,按顺序查三件事。配置文件是不是放在 conf.d\ddtrace 目录下,文件名是不是 ddtrace.conf,改完有没有重启 DataKit。这三步都对,再去看应用侧探针地址和端口。
我当时补上这一行,重启,链路立刻哗哗进来。一小时一千七百多个 span。这个坑给我的教训是,采集器状态正常和数据真的进来,是两回事。接入层必须做端到端验证,不能只看进程活着。另一个教训更便宜,能用官方模板就别手写,少一行配置,多一晚上排查。
五、第四条通道,用户访问监测,别再往 DataKit 里硬写
先纠正我自己一个错误。
早前为了省事,我让后端直接往 DataKit 的 /v1/write/rum 端点 POST JSON。view,resource,action 三类事件都能进,error 事件却老是 400,报 invalid key。翻源码才明白,error 事件必须带 sdk_name,官方 SDK 会自动补,手工写就得自己填。
这条路能跑通,但官方已经不推荐。观测云的态度很明确,新接入走公网 OpenWay,不要再用 DataKit 直连。DataKit 直连只留给老客户做兼容,新项目照着旧教程走,后面升级,排障,公网暴露都会多出一层麻烦。
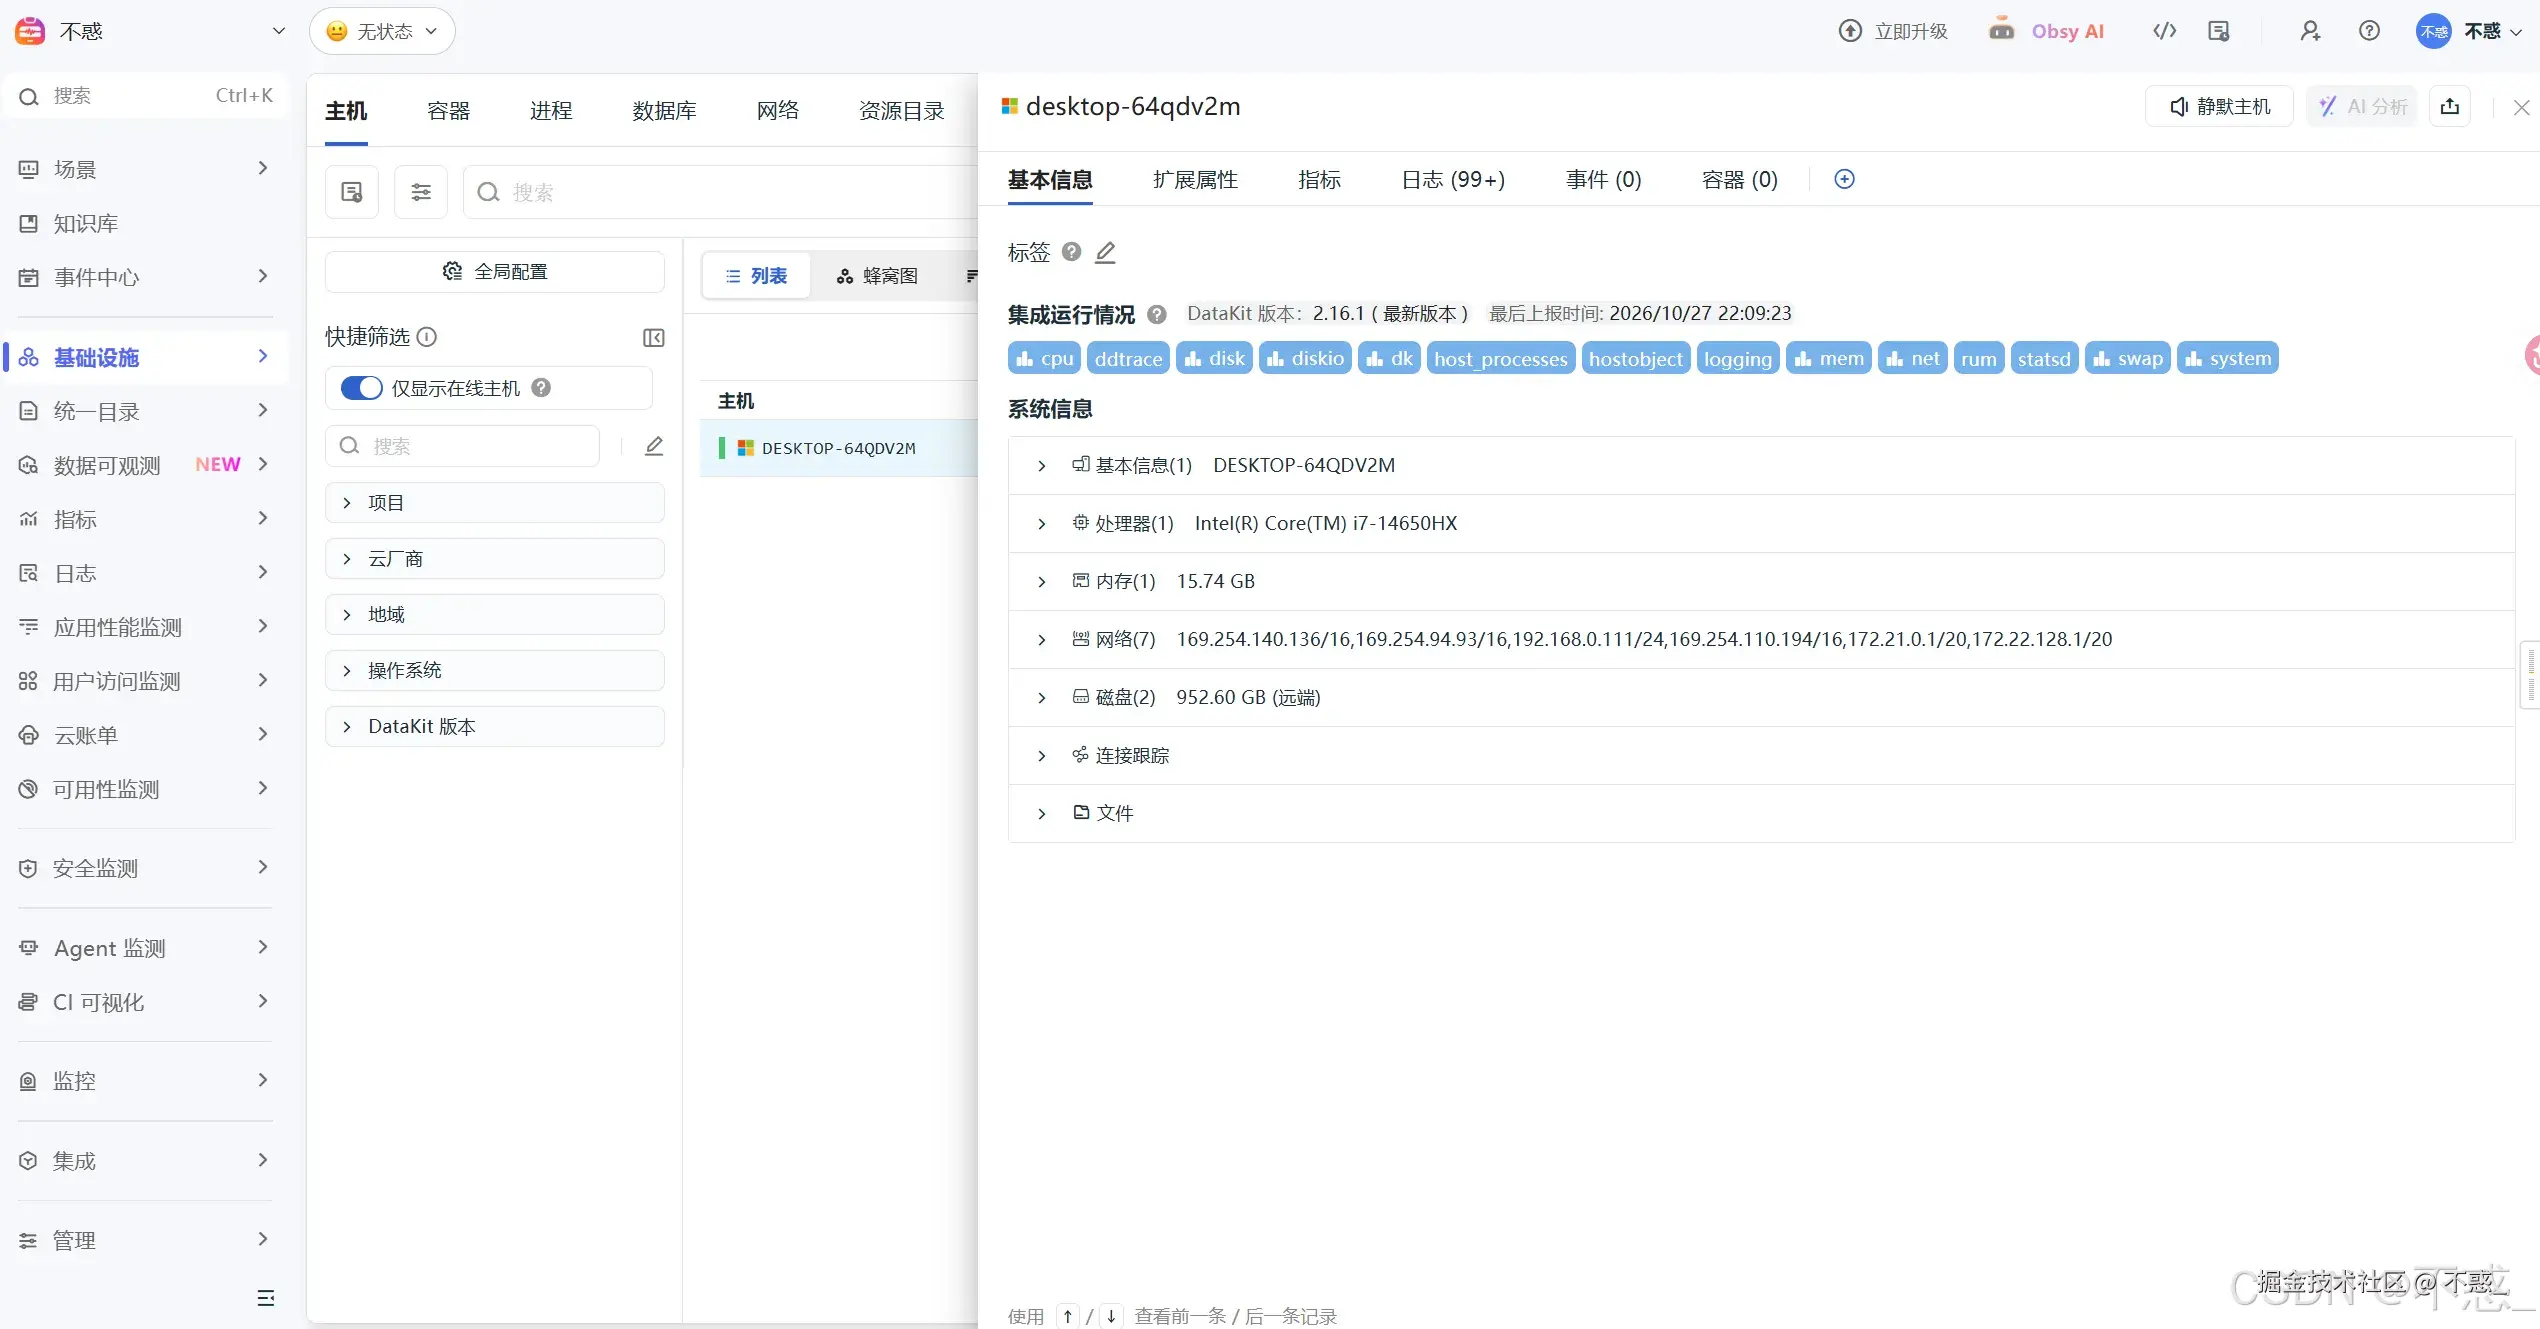
这套评测机没有前端页面,所以系列里的 RUM 数字,来自我早期用后端直写做的一次协议摸底。数据能用,方法不推荐,真实项目接入,按下面的官方 SDK 走。
Web 应用,拿三个必填参数,加一段初始化
第一步,控制台进 用户访问监测 > 应用列表 > 新建应用 > Web,填应用名,拿到 applicationId,env,version。上报方式选公网 OpenWay,再拿 site 和 clientToken。前端直接上报,本机不用装 DataKit,也不用把 9529 暴露到公网。
第二步,前端项目装 SDK。有构建流程就用 NPM,版本好锁,按需集成。
Bash
npm install @cloudcare/browser-rum @cloudcare/browser-core入口文件里初始化。
JavaScript
import { datafluxRum } from "@cloudcare/browser-rum"

datafluxRum.init({
  applicationId: "<APPLICATION_ID>",
  site: "<PUBLIC_OPENWAY_URL>",
  clientToken: "<CLIENT_TOKEN>",
  service: "web-app",
  env: "production",
  version: "1.0.0",
  sessionSampleRate: 100,
  trackUserInteractions: true
})
没有构建流程的静态页,把 SDK 脚本和初始化直接写进 HTML。
HTML
<script src="https://static.guance.com/browser-sdk/v3/dataflux-rum.js"></script>
<script>
  window.DATAFLUX_RUM && window.DATAFLUX_RUM.init({
    applicationId: "<APPLICATION_ID>",
    site: "<PUBLIC_OPENWAY_URL>",
    clientToken: "<CLIENT_TOKEN>",
    service: "web-app",
    env: "production",
    version: "1.0.0",
    sessionSampleRate: 100,
    trackUserInteractions: true
  })
</script>
要采集页面最早阶段的错误就用同步,不想阻塞解析就用异步,代价是可能漏掉初始化前的请求。三种加载方式的取舍,官方文档写得很细,链接放在本节末尾。
第三步,验证。打开页面,跳一次路由,点一个按钮,发一个接口请求。浏览器 Network 里过滤 /v1/write/rum,看到 200 就说明上报通了。再进 用户访问监测 > 应用列表,打开刚建的应用,按 service,env,version 筛选,能看到 View 数据,基础接入就算完成。Error,Resource,Action 要等页面真的发生对应事件才会出现,别刚初始化完就怀疑没接上。
新手最容易犯的错,是 site 和 clientToken 配了,datakitOrigin 也配了。两种上报方式互斥,只能留一套。公网 OpenWay 就不要再写 datakitOrigin,否则请求打到哪一头都说不清。
不想走 NPM,官网也提供 dataflux-rum-miniapp.js 直接下载,本地 require 就行。小程序后台记得把上报域名加进 request 白名单。traceType 默认就是 ddtrace,要和后端 APM 串链路时再显式写,同时后端要放行对应的 Trace Header。
老项目如果还在用 DataKit 直连,datakitOrigin 那套配置继续有效,但新项目别再照着抄。官方已经把公网 OpenWay 作为默认推荐,少一层 DataKit,少一堆公网暴露和证书问题。
回头看那个 sdk_name 报错
现在再看 error 事件 400,结论很清楚。平台没有故意刁难,直写协议本来就会把这层校验暴露出来。官方 SDK 把这些字段,采样,会话,批量上报都封装好了,按文档初始化,不会让你在 sdk_name 这种细节上翻车。
这也是我重写这一节的原因。评测可以走非常规路径摸底,但写给别人看的接入教程,必须跟着官方推荐走。自己踩坑是经验,把坑当教程就是误导。
六、三条 DataKit 通道加探针,一张体检报告
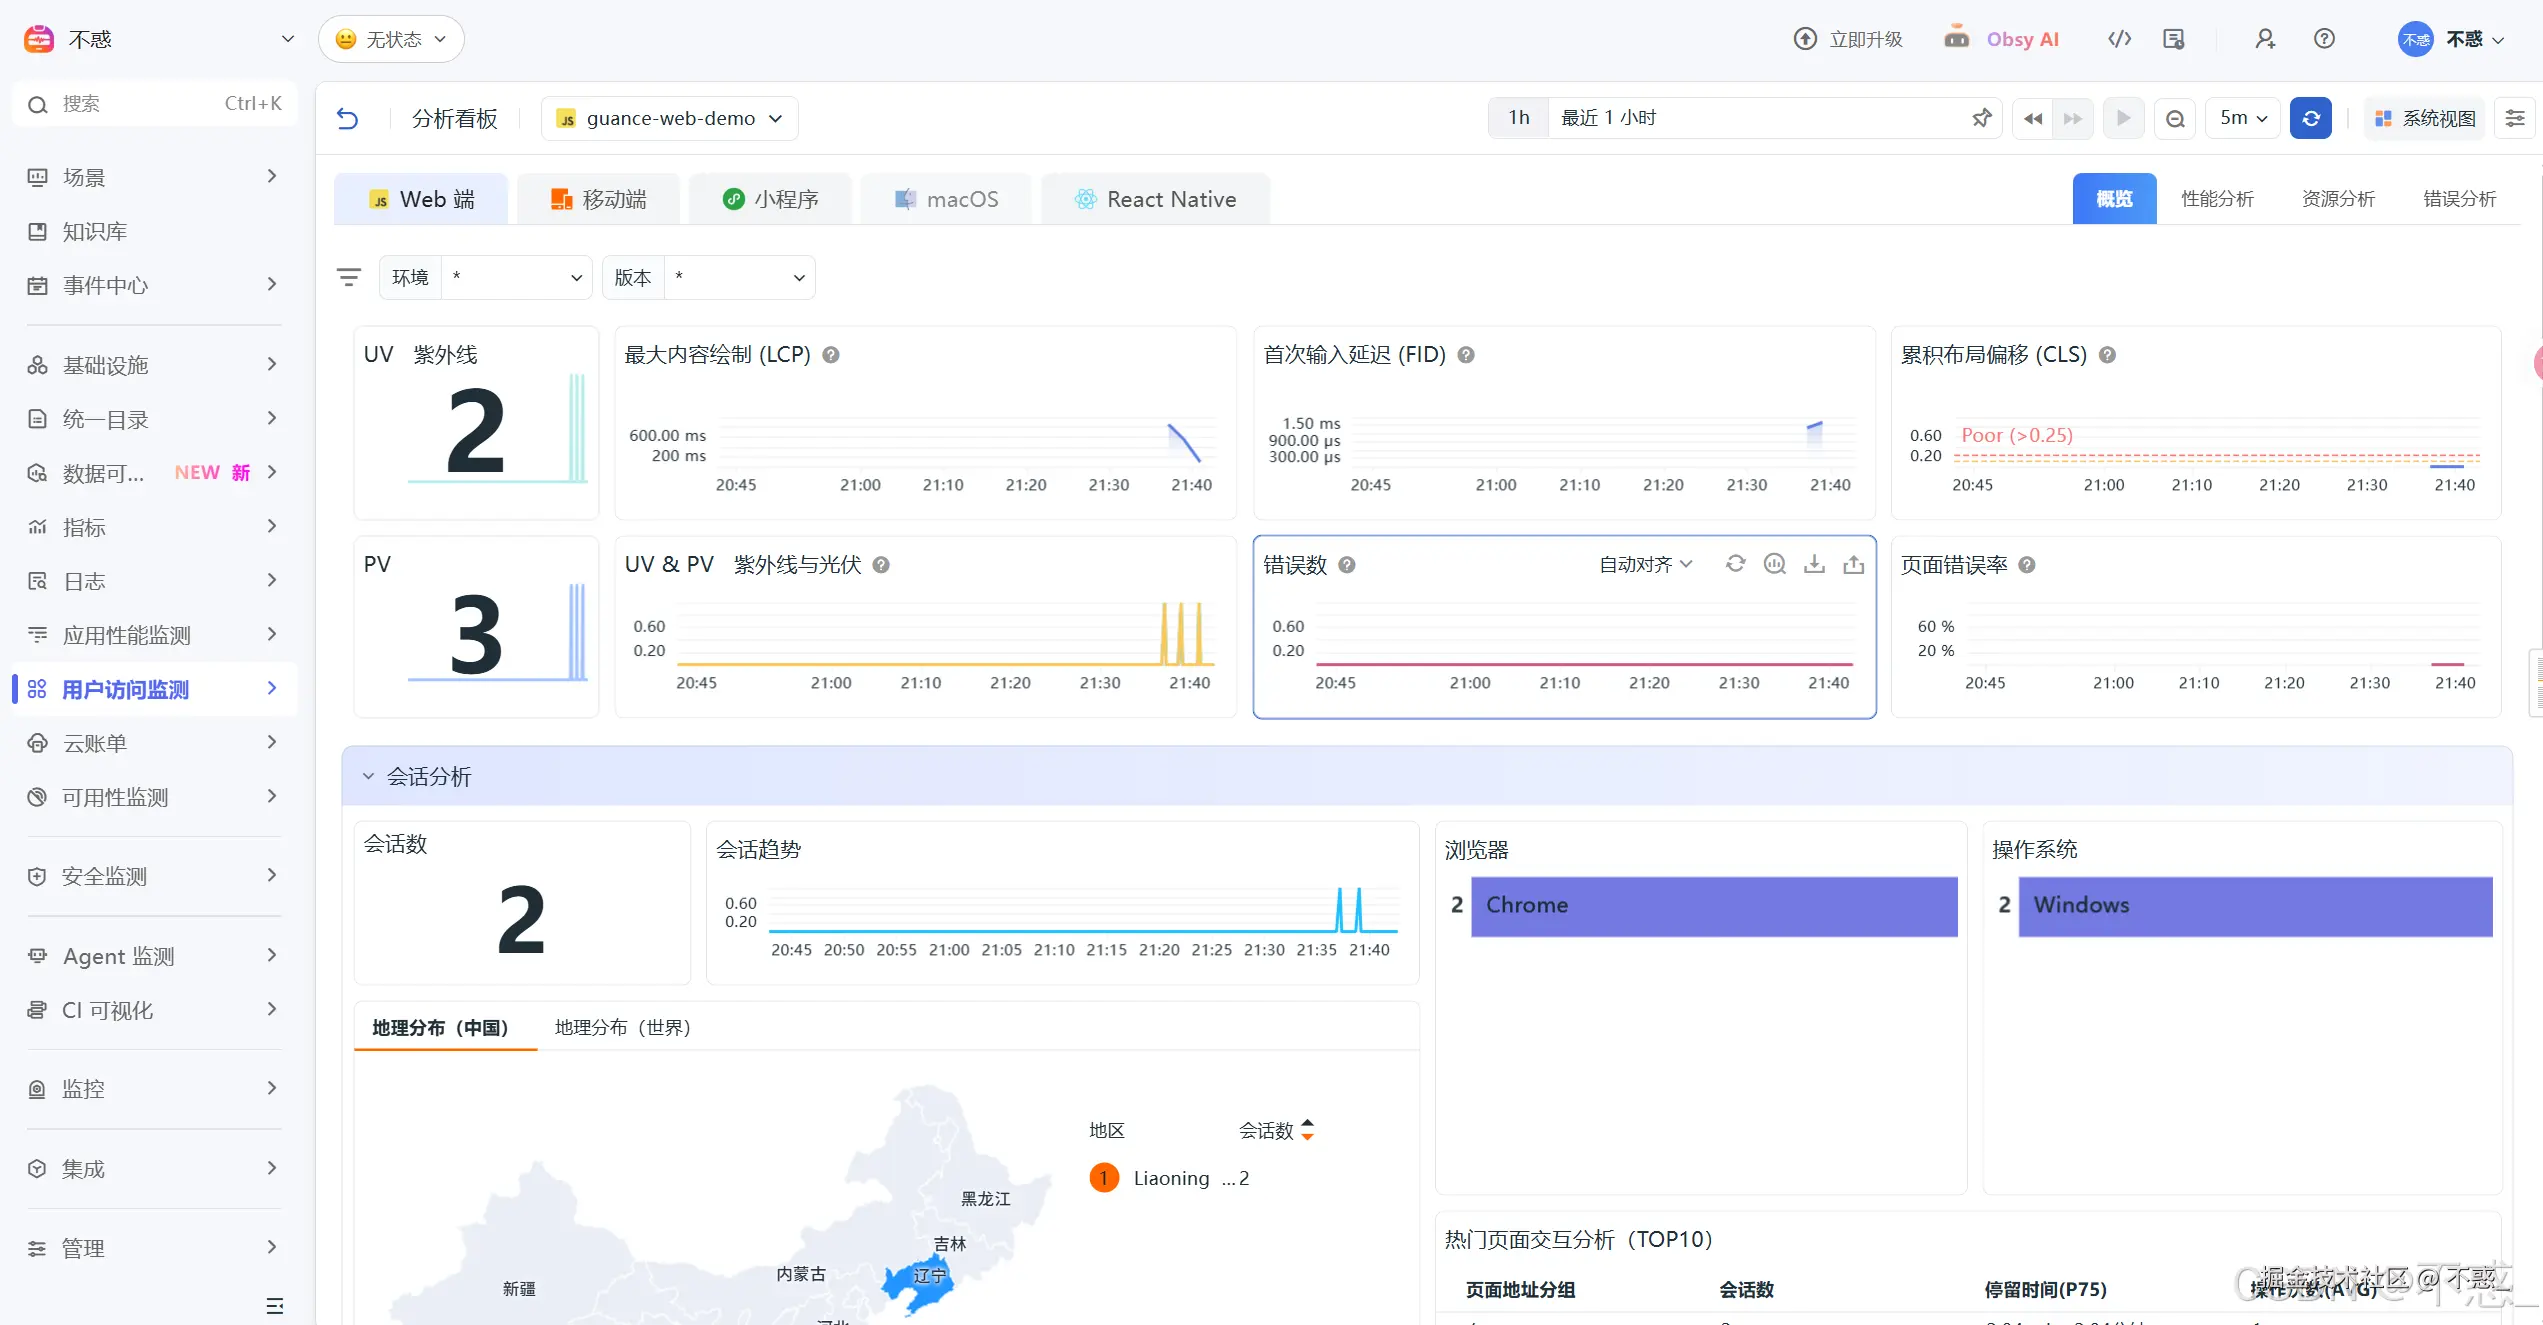
三条 DataKit 通道和探针都通之后,项目里内置的采集链路自检接口一次请求检查四项,实测全绿。RUM 走官方 SDK,单独在应用列表和查看器里验,不混进这张表。
| 通道 | 目标 | 结果 |
|---|---|---|
| ddtrace 采集器 | 127.0.0.1,9529 | 正常 |
| statsd | 127.0.0.1,8125 UDP | 正常 |
| logging | 应用日志绝对路径 | 正常 |
| dd-java-agent | 探针注入状态 | 正常 |
这份体检报告的建议是每个接入观测云的环境都该有一份。通道级自检比界面看图靠谱得多,界面出图是结果,通道连通是原因。原因健康,结果才有意义.
顺带交代时间账。从 DataKit 装完到三条通道加探针全绿,我花了整整一个晚上。安装本身十分钟,DataKit 的安装器很顺手,剩下的时间全喂了三个坑。endpoints 缺失排查四十分钟,那是我手写配置省出来的,埋点参数的分号逗号乌龙最贵,一小时起步,早期走 RUM 直写踩的 sdk_name 校验又占半小时。这份学费每个初次接入的人几乎都要交一遍,链路和 RUM 都按官方模板和 SDK 走,能省掉一小时以上。
七、别忽略第五路数据,主机本身
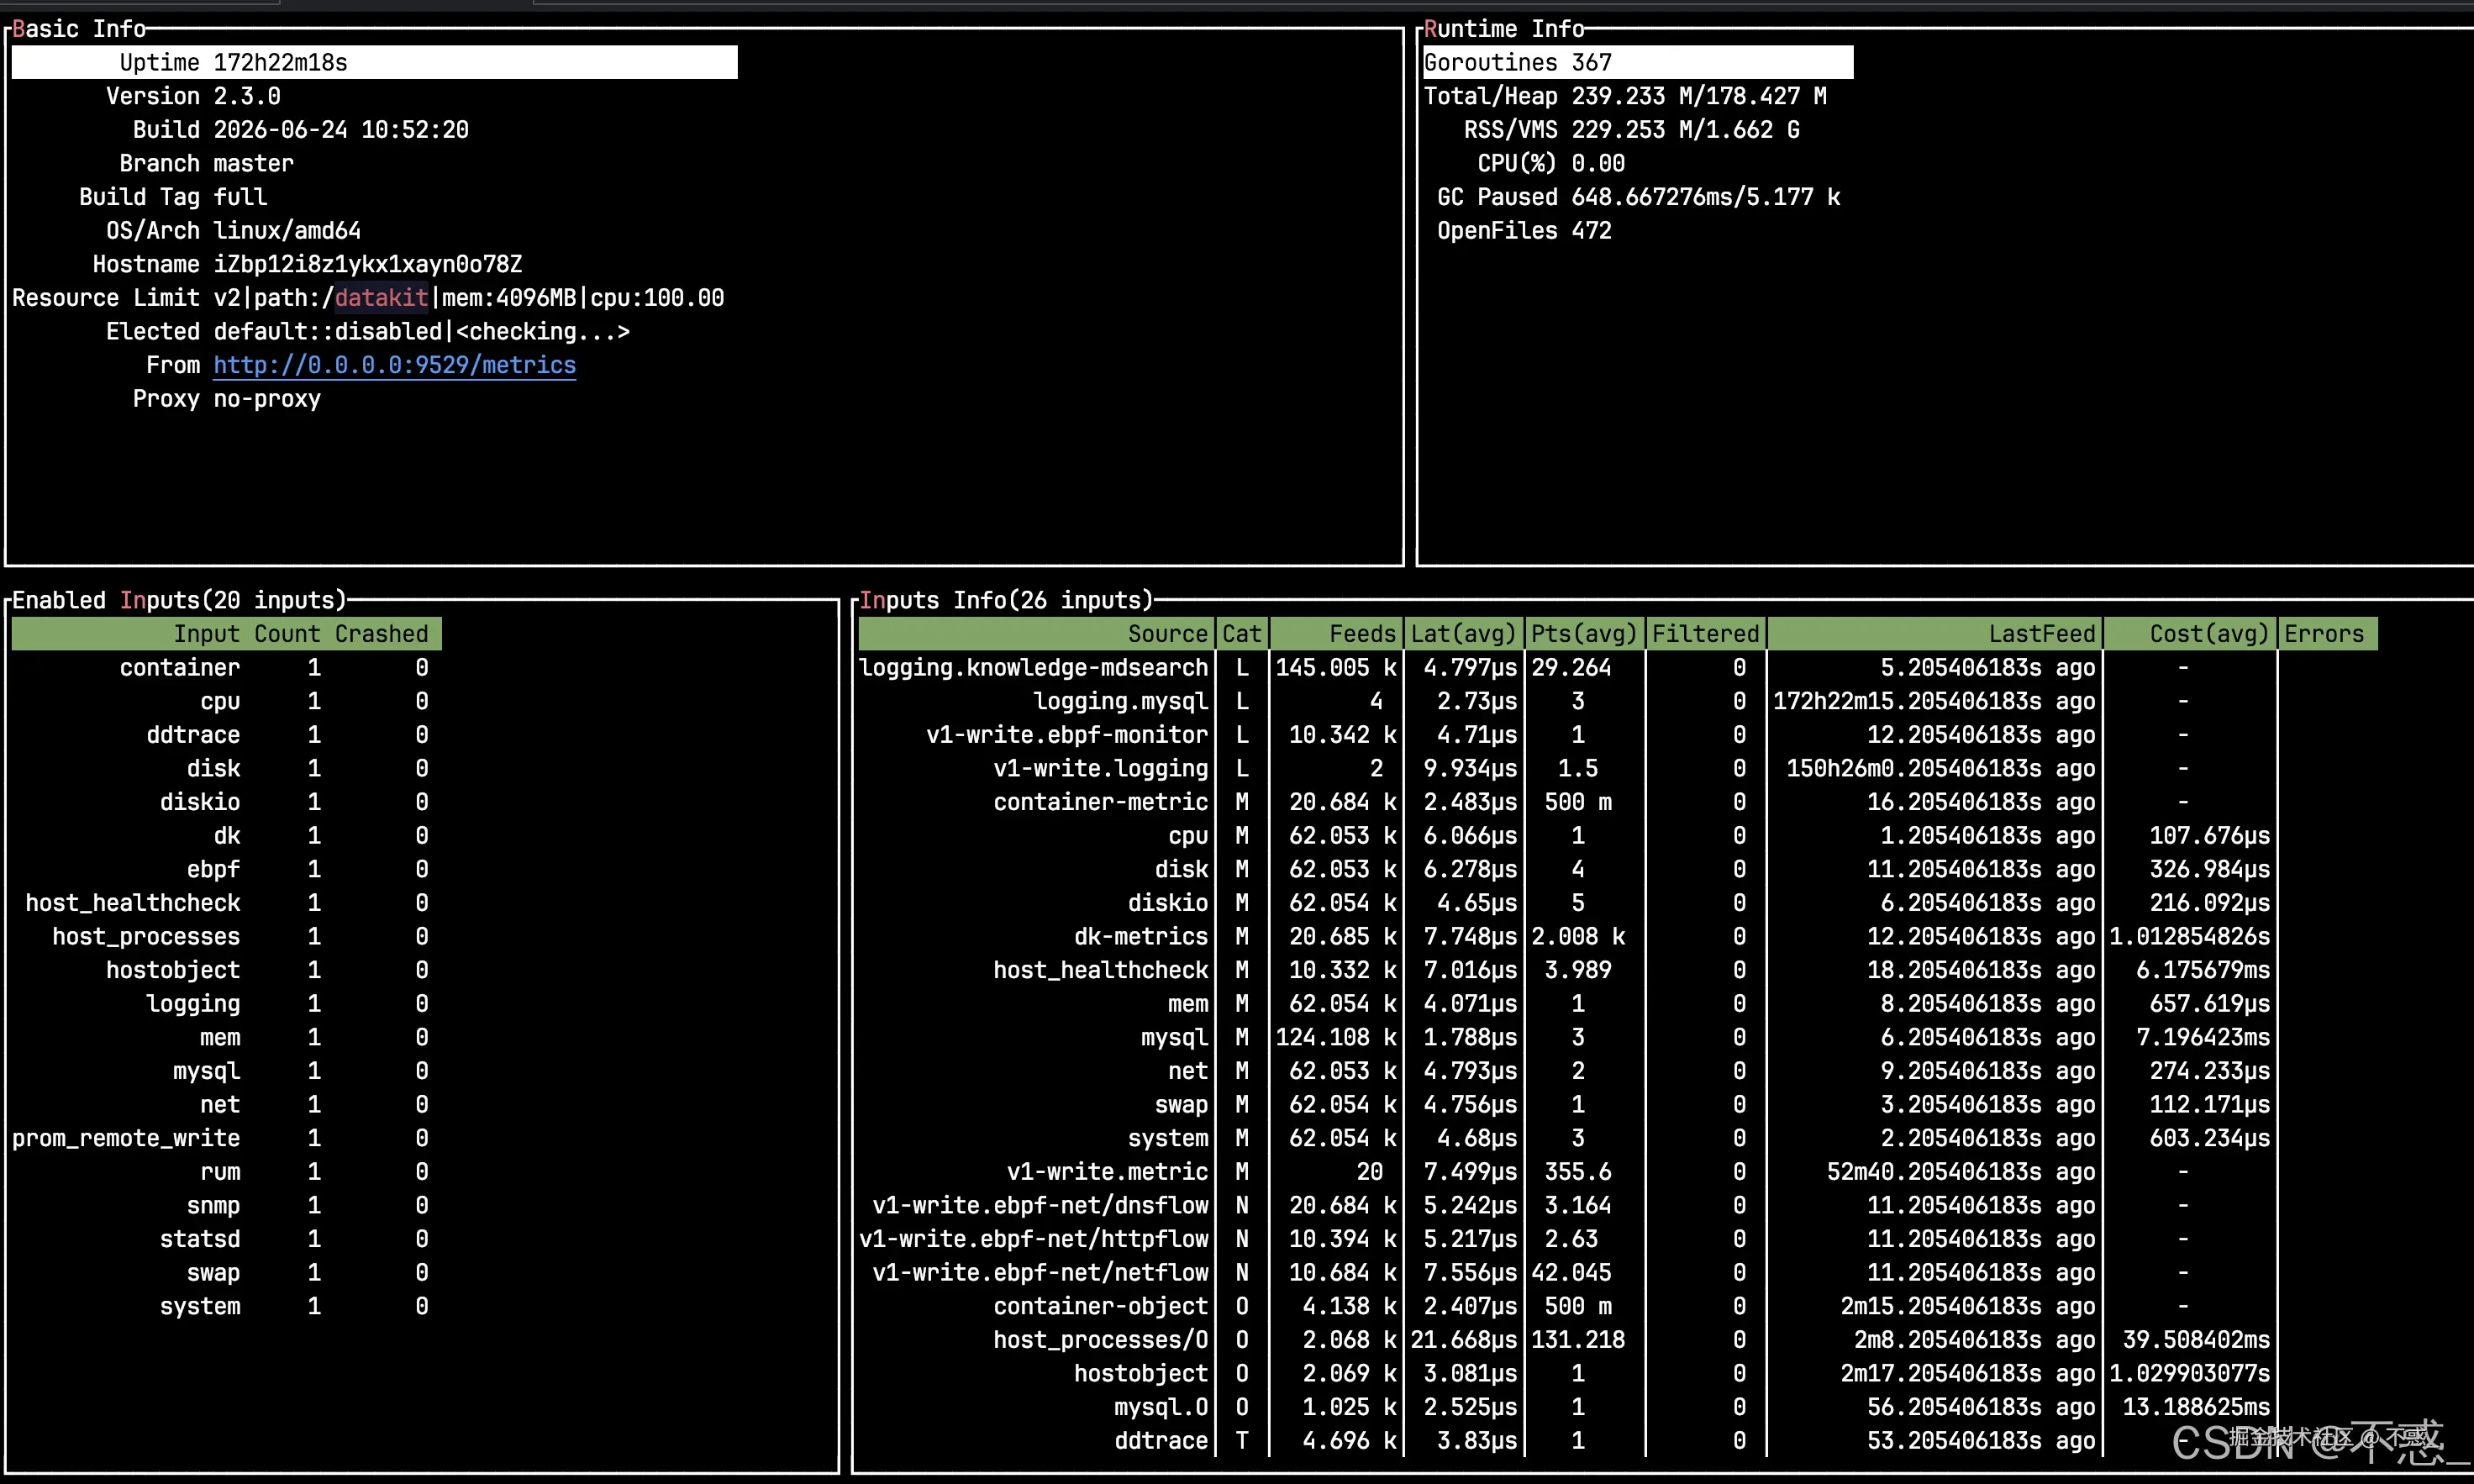
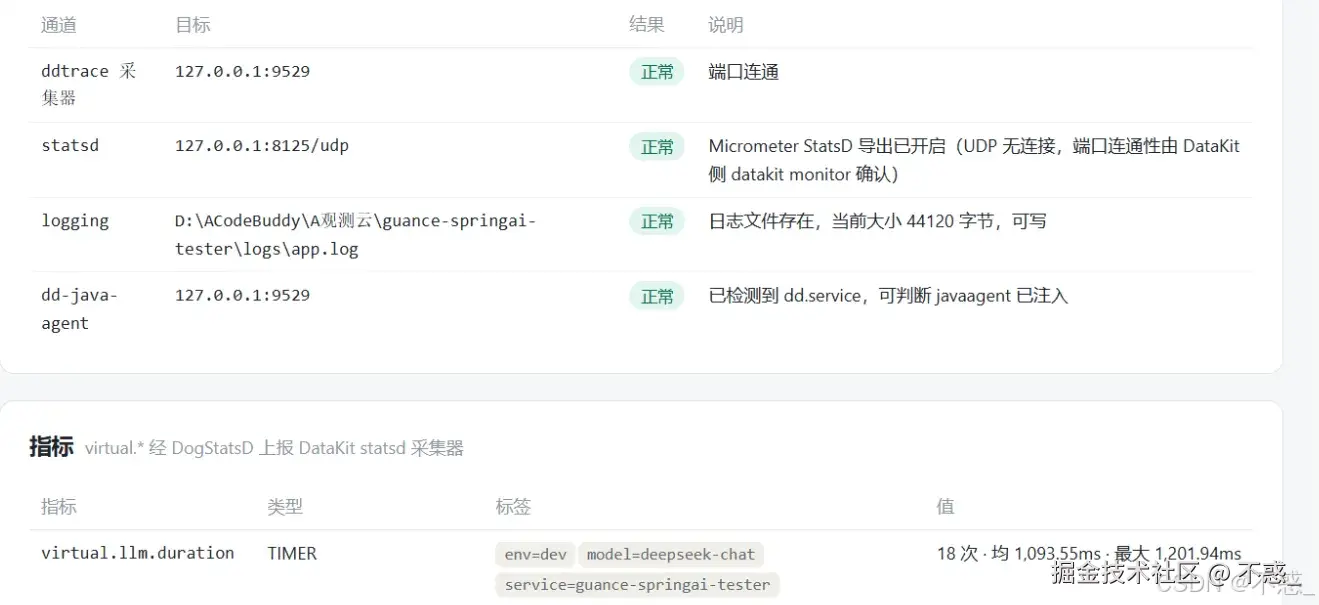
四条业务通道之外,其实还有第五路数据在悄悄进来。DataKit 安装完成后,cpu,mem,disk,net 这些主机采集器默认就位,我的那台 Windows 机器在观测云基础设施模块里自动出现,主机名,操作系统,CPU 曲线,内存水位,磁盘容量一应俱全。
这路数据经常被当成背景板,我要替它说两句话。业务指标异常时,第一反应该看什么,很多同学会去翻应用日志,其实更快的路径是先瞄一眼主机层。内存打满导致的雪崩,磁盘写满导致的日志断流,CPU 被邻居进程抢走导致的超时,这类故障在主机视图上一秒钟现形,绕过它能省下大量无谓的排查。
还有个工作区安全区的提醒。datakit.conf 里写着上报地址和那把 tkn 开头的工作空间 token,这个文件等同于数据库密码,权限要收紧。查询用的 API Key 和上报用的 token 是两把钥匙,各管各的门,混用是新手常见事故,token 泄漏等于整个工作空间的数据裸奔。
八、接入这一层,三家放一起看
坑踩完了,顺手做个横向对比。这三家我都有实际使用经验,观测云测了三周,Prometheus 自建前后用了三年,阿里云云监控在前公司用过两年,凭真实体感说,两边都挨板子。
DataKit 的接入效率前面已经见识了,一条命令装完,模板复制,重启生效,四类数据一个采集器全包。Prometheus 的接入是另一幅画面,node_exporter 装到每台机器,Prometheus 管拉取,Grafana 管展示,Alertmanager 管告警,四个组件各配各的,我第一次搭花了一整个周末。换来的是生态,任何问题搜一下,前人全踩过,这个红利三年吃不完。
阿里云云监控最省心的一面是云资源,ECS 装个插件,云产品的基础指标开箱就有。但它的主场止步于阿里云内,前公司机房里的物理机它罩不住,当时的方案是机房另起一套 Zabbix,两套系统看数据,割裂感很重。
九、本篇小结与下一站
接入层的坑总结下来就一句话,每条通道都要用自己的数据做一次端到端验证,别信状态灯。
这一晚上对我个人的回报,远不止打通了链路。三个坑后来全部沉淀成项目里的自检脚本和配置模板,同事拿去部署,半小时全绿。我交的学费变成了团队的生产力,这笔账怎么算都划算。这也是我坚持把踩坑过程写出来的原因,坑自己踩过一遍就够了,写下来能让后来的人免踩一遍。
指标通道最顺,日志通道靠一个 JSON 开关,链路通道的坑是我手写配置省掉了 endpoints,用户访问通道的坑换成了上报方式选择。前三个是 DataKit 的坑,最后一个是接入路径的坑,官方模板和文档都写了,难的是别被旧教程带偏。
数据进来了,接下来的问题变成,平台把这些数据算对了吗。下一篇我们进指标模块,聊聊为什么我搜 virtual.user.total 永远搜不到,以及 StatsD 的命名拆分规则坑了多少人。
系列导航,一 接入篇 当前 / 二 指标篇 / 三 日志篇 / 四 链路篇 / 五 用户访问篇 / 六 闭环对账篇 / 番外 横评篇