h3 .c 的两个权重槽,怎样把内存压力换成 SSD 等待
看到" DiT 存储降到约 2 GiB",最容易问错的问题是:这台电脑是不是只要 2 GiB 内存就能生成视频?另一个容易跳过的问题是:下一层覆盖缓冲区时,上一层的 GPU 真的用完了吗?
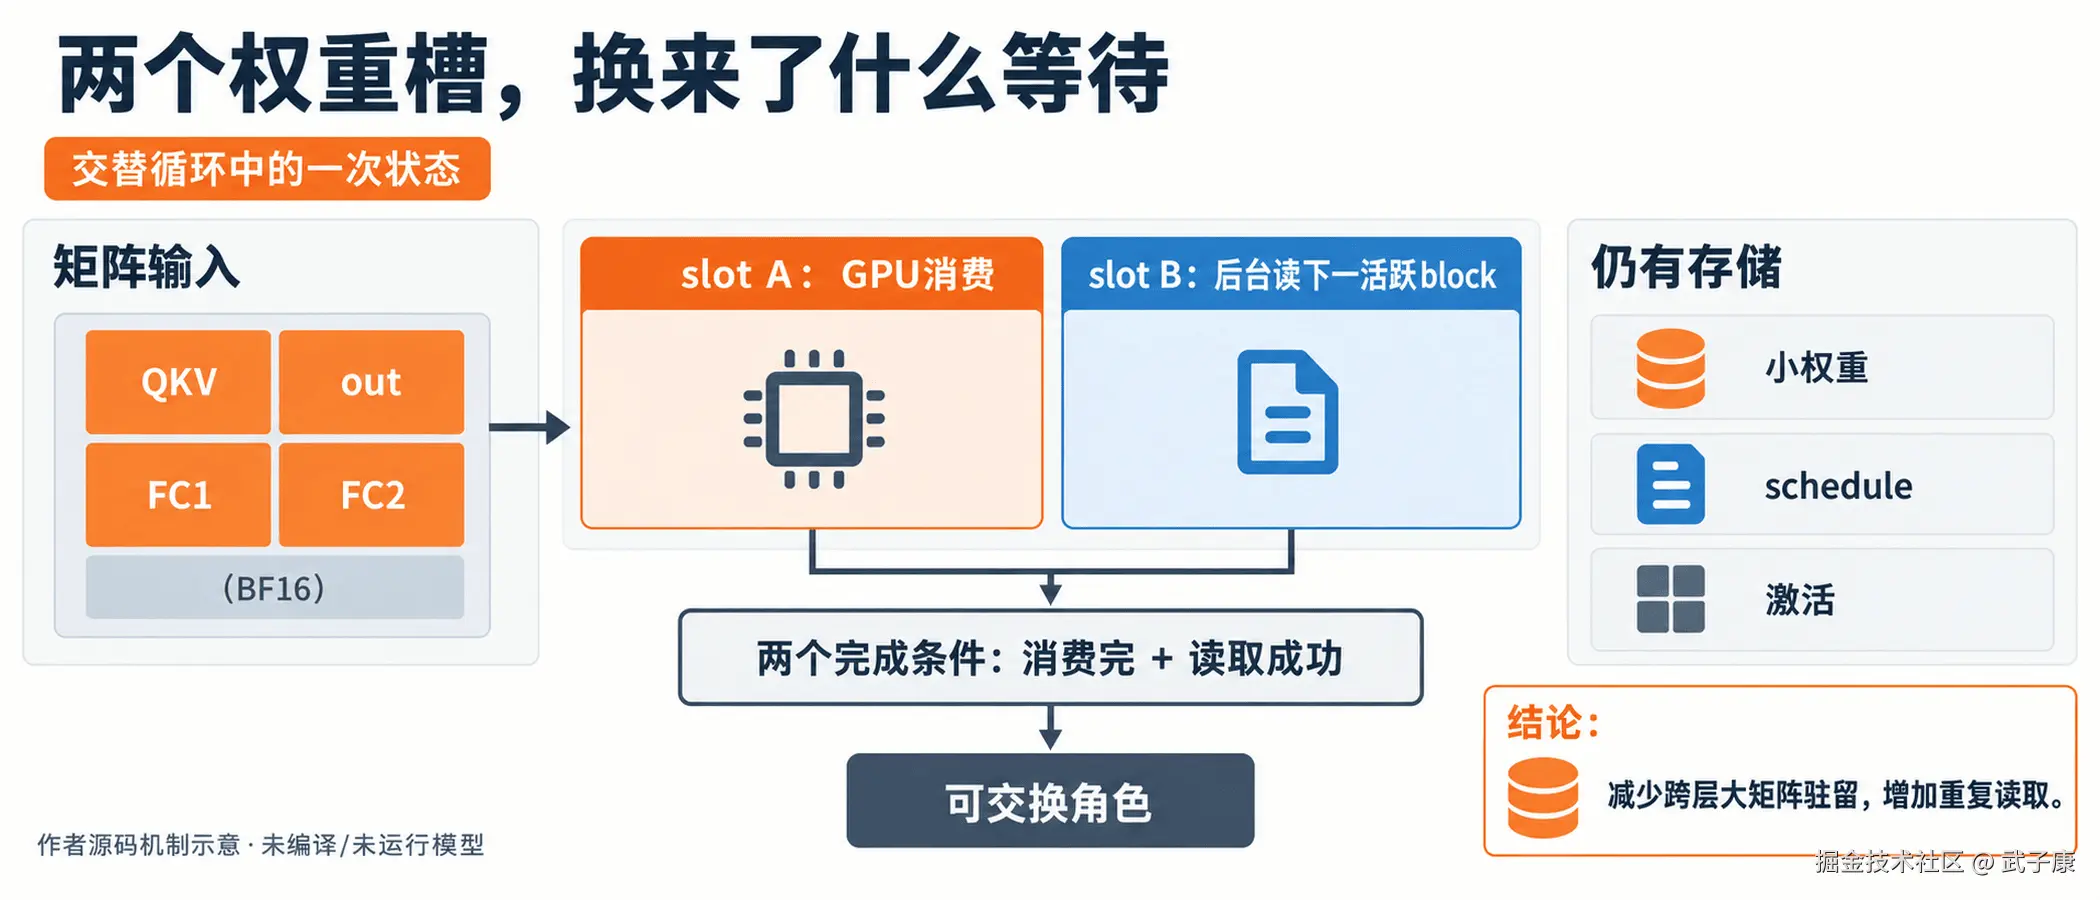
h3.c 固定版本 8974cc0 的 SSD streaming 把这两个问题连在了一起。它没有先压缩权重,而是为反复执行的 DiT block 保留两个大矩阵槽:GPU 消费一个,后台线程填另一个。省下的是同时驻留的大矩阵,增加的是重复读取与必须守住的同步边界。 本文以固定源码分析为依据,新增一个已运行的纯 Python 整数事件例;未编译 h3.c、下载权重或运行 Metal 生成。
两个槽替换的是大 矩阵 ,不是整个模型
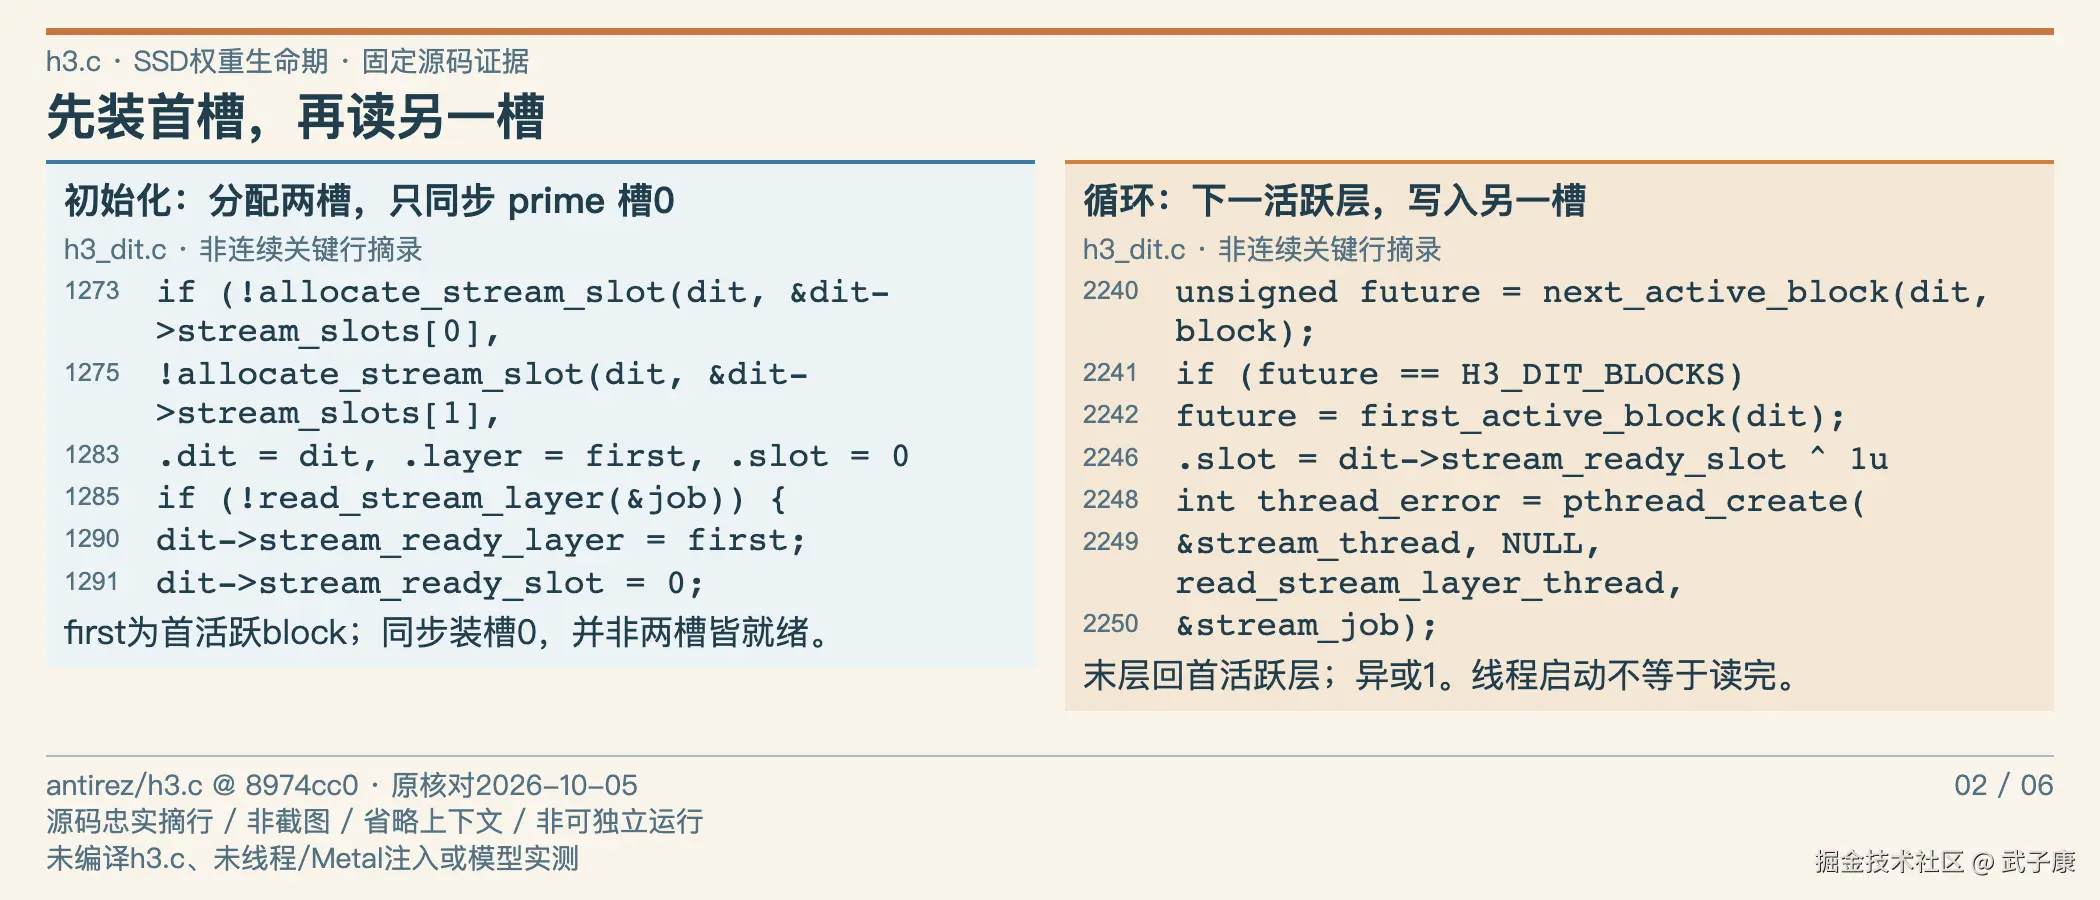
load_core 遍历活跃 block 时, streaming 分支加载各层的归一化权重,并登记需要从文件读取的大矩阵。prepare_stream_layer 给每层登记 QKV、attention output、FC1、FC2 四项,校验 BF16 、二维 shape 和目标尺寸,保存路径、文件偏移、元素数量及目标字段;读取顺序再按分片路径与偏移排序。1
随后,allocate_stream_slot 为这四项各分配 BF16 tensor,函数被调用两次。它没有为每个活跃层各保留一套完整的大矩阵,也没有把整个 DiT 变成两个无差别的文件块。层自己的小权重、输入输出投影、schedule 和运行时激活仍有各自的存储。省下的是四类大矩阵的跨层常驻,读取仍为原始 BF16;这不是量化,两槽容量也不是进程或整机峰值。
初始装载也有一个值得核对的细节:源码分配两个槽后,只把首个活跃 block 同步读入 slot 0 ,写下 stream_ready_layer 和 stream_ready_slot。它没有在进入计算前先读满两个槽。第二个槽的填充发生在后面的逐 block 执行中。1
先列驻留清单,再解释省下的容量
可以把一次核心求值的存储划成三类:随层切换的四类大矩阵、跨层仍要保留的小权重与结构、随输入尺寸变化的运行时激活。这里是阅读源码的分类,不是新测得的内存分布。两个槽主要压低第一类的同时驻留数量,另外两类不会因槽复用自动消失。输出分辨率、序列长度改变时,激活部分也可能改变,因此同一槽机制不等于所有请求具有相同峰值。
假设某个 模型 的每层矩阵大小相同,一共有若干活跃层,完整常驻保留每层一份,双槽则只保留两份可复用矩阵。这能说明容量为什么下降,却不能直接套用作者的 GiB 数字:小权重、投影、运行时、媒体输出以及系统占用都没有进入这个简化算式。真正部署时应把矩阵估算和进程采样分列,避免估算表被当成容量验收。
源码校验 shape 与目标尺寸还有正确性含义。一个槽下一轮可以装另一个层,但写入内容必须对应这个层的字段,不能只确认读了相同字节数。分片路径与偏移排序改变的是读取组织,不能改变 QKV、OUT、FC1、FC2 的目标归属。若移植到另一模型,应先核四矩阵形状和映射,而不是先照搬"双缓冲"名字。
首槽同步装载属于启动成本,后面的交替属于稳态成本。若只测 warm forward,很容易漏掉第一次登记、分配和装载;若只测启动,又看不出反复核心求值的重复读取。这两种结果都可以记录,但必须注明请求从哪个阶段开始计时。
槽能复用,要等两件不同的事
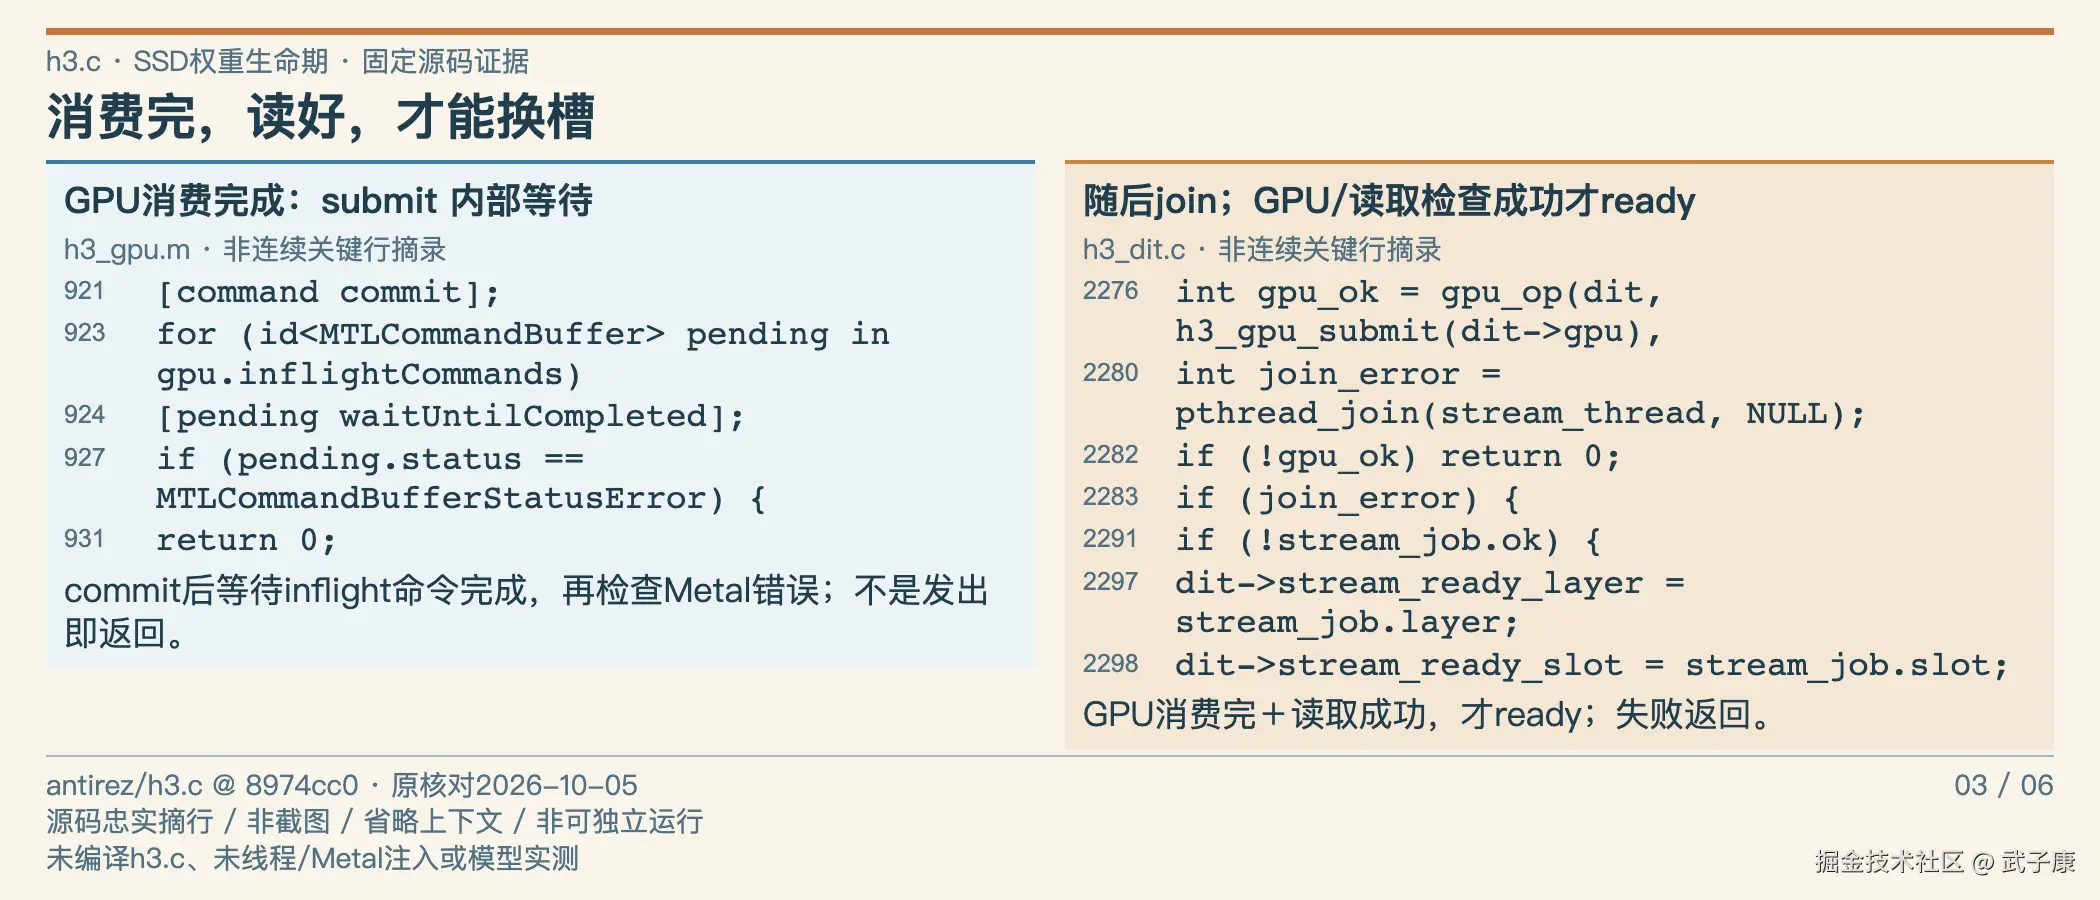
执行当前 block 前,代码先核对 ready 标记是否指向它,再把该层的小权重结构复制到临时对象,并将四个大矩阵指针改指当前槽。接着寻找下一活跃 block,给后台读取任务分配另一个槽:stream_ready_slot ^ 1u。2
这里的"下一层"不是机械地加一;不活跃 block 会跳过。到最后一个活跃 block 时,future 回到第一个活跃 block,给下一次核心求值准备权重。
真正决定覆盖安全性的,是后面的顺序:
| 源码动作 | 完成了什么 | 还不能据此认定什么 |
|---|---|---|
| pthread_create | 启动另一槽的读取任务 | 下一槽已经读好 |
| run_block | 组织当前 block 的 GPU 运算 | GPU 已经消费完当前权重 |
| h3_gpu_submit | 提交命令,并在内部等待已提交命令完成 | 后台文件读取一定完成 |
| pthread_join 与结果检查 | 等待读取线程,确认读取成功 | 所有后续层都已常驻 |
| 更新 ready 标记并开始下一命令 | 下一轮可以使用新槽 | 以后可以省略这两个等待边界 |
尤其不能只看函数名,把 submit 理解为"发出去就返回"。该版本 h3_gpu_submit 在 commit 后遍历 inflight commands 调用 waitUntilCompleted,然后检查 Metal 错误。逐 block 路径等它返回后才 join 读取线程;GPU 消费旧槽已结束且读取新槽成功,才更新 ready 标记,下一轮旧槽才有覆盖许可;线程已启动不能代表已就绪。3
异常路径也不能把半成品标成 ready。run_block 失败时会先 join 已启动的读取线程再返回;提交、join 或读取结果失败时,不会沿成功路径更新 ready。这里核到的是这些显式分支,没有做故障注入,也不据此宣称所有异常都经过运行验证。2
用三个连续 block 检查覆盖关系
原先可以用 A、B、C 三个活跃 block 解释:A在槽零,读B到槽一,确认A消费完且B读好,再执行B并覆盖旧槽为C。下面把它收窄为可复算整数标签:A/B/C对应作者设定的0/2/5,1、3、4不活跃;不是实际模型的层清单。只等读完不能证明GPU已不用旧槽,只等GPU完也不能证明新权重已齐,程序分别检查这两个反例。
单文件不创建线程、不调用Metal,也不读权重。slots只存层编号或None;读任务"启动"时新槽内容为None,两个完成状态满足后才更新ready。事件来自代码设定,不是采到的h3.c时间线。保存为 two-slot-events.py 后可用 python3 two-slot-events.py;本仓库根目录实际命令如下:
bash
python3 08-publishing-pipeline/generated-packages/PKG-20261005-0008-h3c-ssd-weight-lifetime/examples/two-slot-events.py完整代码:
python
"""Finite integer event model; no threads, Metal, weights, file I/O or timers."""
active = [0, 2, 5]  # Author fixture; blocks 1, 3 and 4 are inactive.
slots = [active[0], None]
ready = (active[0], 0)  # Synchronous prime, only slot 0.
read_jobs = 1
consumed = []

def ready_permitted(gpu_done, read_done, read_ok, block_ok, submit_ok, join_ok):
    return all((gpu_done, read_done, read_ok, block_ok, submit_ok, join_ok))

def overwrite_permitted(slot, gpu_in_use):
    return slot not in gpu_in_use

print('scope=finite integer event model; no h3.c/threads/Metal/performance execution')
print('prime: layer=0 slot=0; slot=1 empty')
for core in range(2):
    for index, layer in enumerate(active):
        current, slot = ready
        assert current == layer and slots[slot] == layer
        future = active[(index + 1) % len(active)]
        other = slot ^ 1
        gpu_in_use = {slot}  # Assumed reservation until gpu_complete event.
        assert not overwrite_permitted(slot, gpu_in_use)
        assert overwrite_permitted(other, gpu_in_use)
        slots[other] = None  # Reader started, contents not declared ready.
        events = ['reader_start', 'run_block']
        assert not ready_permitted(False, True, True, True, True, True)
        events.append('gpu_complete')  # Set by this model, not a GPU signal.
        gpu_in_use.clear()
        events.append('join_read_success')
        slots[other] = future
        assert ready_permitted(True, True, True, True, True, True)
        ready = (future, other)
        events.append('ready_advance')
        read_jobs += 1
        consumed.append(layer)
        assert events.index('reader_start') < events.index('run_block')
        assert events.index('gpu_complete') < events.index('join_read_success') < events.index('ready_advance')
        print(f'core={core} layer={layer} slot={slot} prefetch={future} into={other} events={">".join(events)}')
assert consumed == active * 2
assert read_jobs == 7 and ready == (0, 0)
print(f'active={active}; skipped=[1, 3, 4]; consumed={consumed}')
print(f'read_jobs_including_prime={read_jobs}; consumed_blocks={len(consumed)}; final_ready={ready}; final_prefetch_consumed=false')

# Separate status fixtures: failure means abort, not permission to reuse old ready.
cases = {
    'gpu_incomplete': (False, True, True, True, True, True),
    'reader_incomplete': (True, False, True, True, True, False),
    'read_failed': (True, True, False, True, True, True),
    'run_block_failed': (False, True, True, False, False, True),
    'submit_failed': (True, True, True, True, False, True),
    'join_failed': (True, True, True, True, True, False),
}
for name, flags in cases.items():
    advanced = ready_permitted(*flags)
    assert not advanced
    print(f'{name}: ready_advanced=false; continue_allowed=false')
assert not overwrite_permitted(0, {0})
assert overwrite_permitted(0, set())
print('early_overwrite_of_in_use_slot=rejected; after_gpu_completion=permitted_in_model')
print('self_check_groups=6; measured_ram/read_time/gpu_time/output_identity=UNKNOWN')
本机 Python 3.11.6 实际运行退出码0,stderr为空。stdout原文如下:
text
scope=finite integer event model; no h3.c/threads/Metal/performance execution
prime: layer=0 slot=0; slot=1 empty
core=0 layer=0 slot=0 prefetch=2 into=1 events=reader_start>run_block>gpu_complete>join_read_success>ready_advance
core=0 layer=2 slot=1 prefetch=5 into=0 events=reader_start>run_block>gpu_complete>join_read_success>ready_advance
core=0 layer=5 slot=0 prefetch=0 into=1 events=reader_start>run_block>gpu_complete>join_read_success>ready_advance
core=1 layer=0 slot=1 prefetch=2 into=0 events=reader_start>run_block>gpu_complete>join_read_success>ready_advance
core=1 layer=2 slot=0 prefetch=5 into=1 events=reader_start>run_block>gpu_complete>join_read_success>ready_advance
core=1 layer=5 slot=1 prefetch=0 into=0 events=reader_start>run_block>gpu_complete>join_read_success>ready_advance
active=[0, 2, 5]; skipped=[1, 3, 4]; consumed=[0, 2, 5, 0, 2, 5]
read_jobs_including_prime=7; consumed_blocks=6; final_ready=(0, 0); final_prefetch_consumed=false
gpu_incomplete: ready_advanced=false; continue_allowed=false
reader_incomplete: ready_advanced=false; continue_allowed=false
read_failed: ready_advanced=false; continue_allowed=false
run_block_failed: ready_advanced=false; continue_allowed=false
submit_failed: ready_advanced=false; continue_allowed=false
join_failed: ready_advanced=false; continue_allowed=false
early_overwrite_of_in_use_slot=rejected; after_gpu_completion=permitted_in_model
self_check_groups=6; measured_ram/read_time/gpu_time/output_identity=UNKNOWN
第一轮第三条事件把layer5的下一层定为layer0,没有把inactive层当消费者,也没有在末层停止预取。第二轮起点用上一轮就绪的槽一,不重新prime;因此两轮六个消费block产生六笔预取,加启动装载为七个模型read_job。最后一笔首层权重已经准备好但没有第三轮去消费。这些整数只说明本例边界,不能推导真实模型的读取字节、步数、带宽或命中效果,真实核心复用还由源码中的evaluate_core条件决定。
每行事件顺序都是reader_start在run_block前,gpu_complete后join_read_success,最后ready_advance。模型规定当前槽在消费完成前不可覆写,另一槽可以填;这解释下一轮覆盖旧槽依赖上一轮完成,不是读取线程创建得够早。提前覆写反例只拒绝整数状态许可,没有执行真实竞争或错误写入。
后面六种标志组合分别缺GPU完成、读取完成、读取成功、run_block成功、 submit 成功或join成功,都拒绝advance。失败表示停止这条模型路径,而不是保留旧ready继续运行;源代码如何等待已启动线程及释放其他资源,仍须追显式分支。Python旗标不是pthread/Metal故障注入,不覆盖所有取消、短读、系统错误或资源清理结果。
本例刻意不编造毫秒或GiB数。它只能帮助读者审查完成证据在哪一行出现:读取任务已启动、GPU命令已编码、submit已完成、join已成功,各自能支持什么。若以后换成异步submit,必须补真正的消费完成信号,而不能把模型里的True搬进真实系统当同步保证。
如果将当前 submit 改为异步返回,原先靠返回顺序成立的安全关系也会变化。此时必须重新设计消费完成信号与覆盖许可,不能只为减少等待删掉 waitUntilCompleted。本文没有提出这样的补丁;迁移时先把现有证明条件写出来,才知道优化删掉了什么保障。
失败分支则应从未完成资源看起。读取线程可能仍持有槽地址,GPU 也可能已提交引用;过早析构会改变所有权风险。现有源码中核到的 join 和成功检查是具体证据,不能推广为所有取消、系统错误都绝对安全。若做后续验证,短读、创建线程失败、GPU 错误应分别观察返回与清理路径,而非只测成功生成。
最后一层还会读,等待指标也有自己的边界
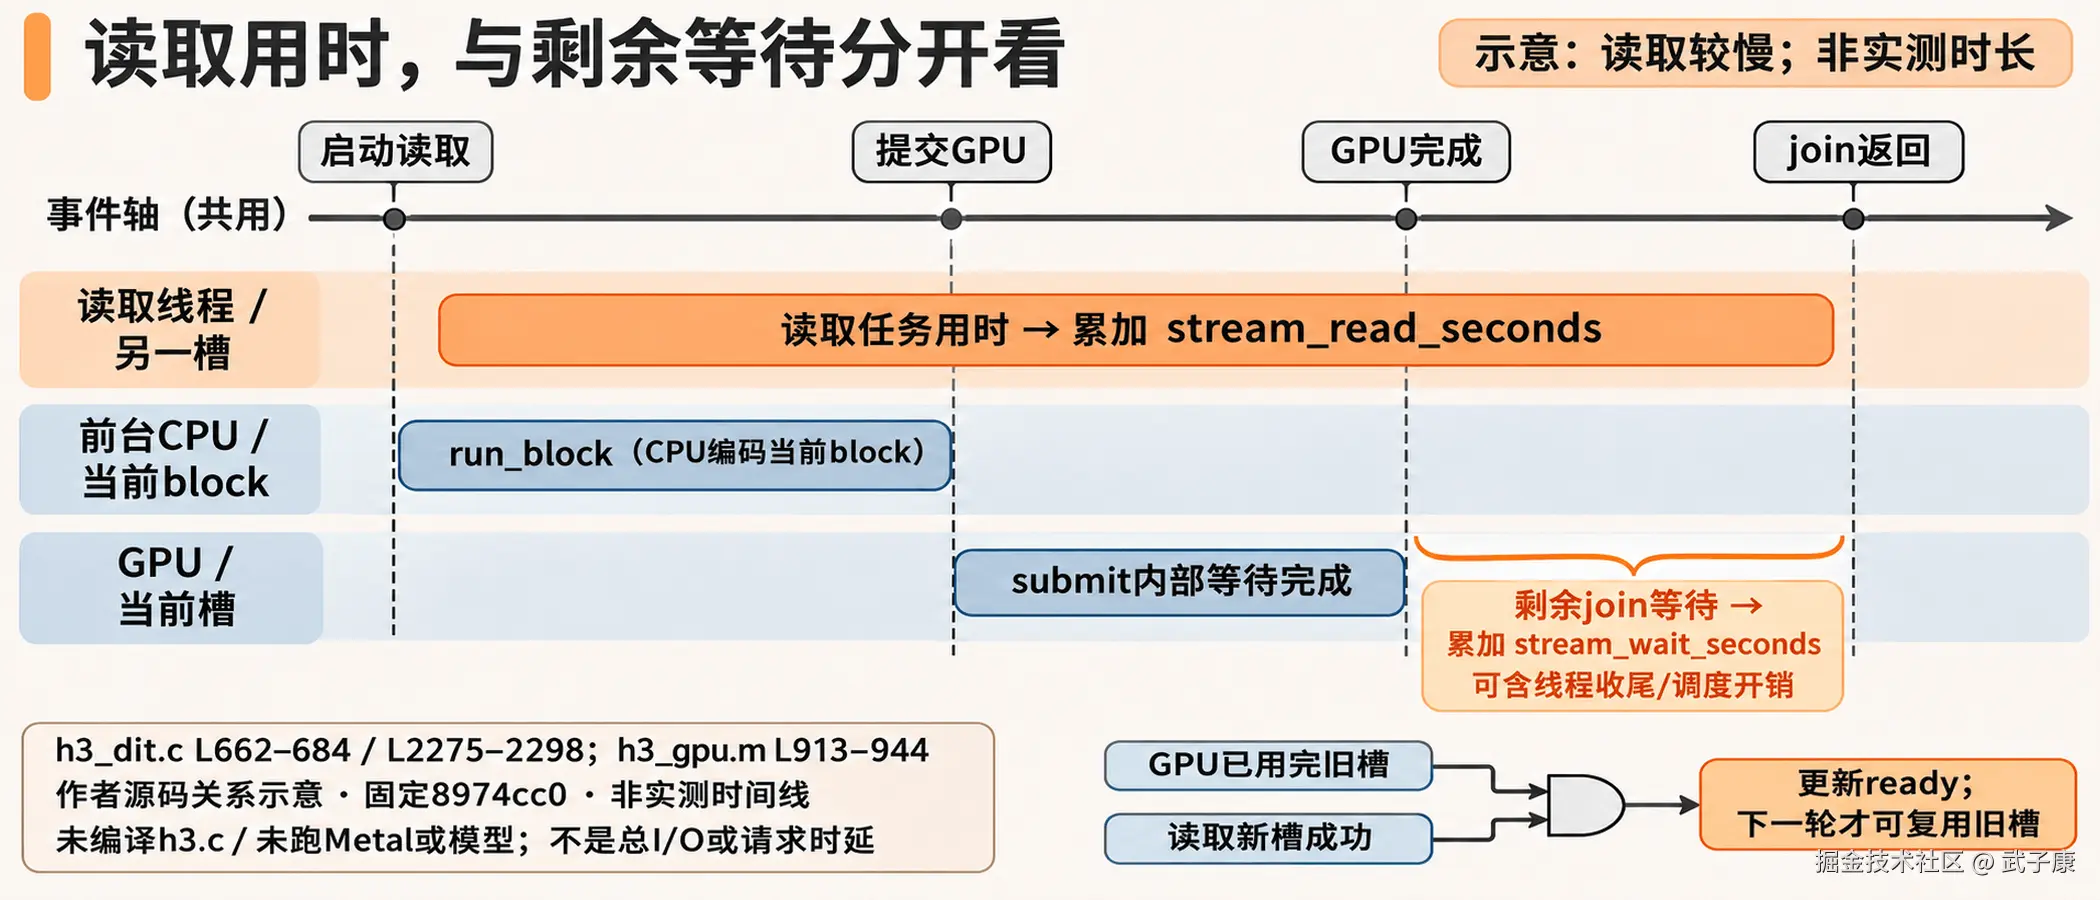
源码先启动后台读取,再调用 run_block,最后提交并等待 GPU。因此读取有机会与 CPU 编码及 GPU 工作重叠,不能把流程画成"当前 GPU 完全结束后才读取下一层"。反过来,也不能因为使用了线程,就说 I/O 一定被计算完全隐藏。
stream_read_seconds 累加读取任务的用时;stream_wait_seconds 则在 h3_gpu_submit 返回之后、调用 pthread_join 之前开始计时。后者主要显示 GPU 等待结束后,还需在 join 上付出的剩余等待,包括线程收尾和调度开销;它不是全部文件读取时间,更不是整个生成请求的时延。4
如果下一槽早已到位,这段等待会较小;若读取仍在进行,就要继续等。较长序列可能给读取留下更大的重叠窗口,但不能仅用标称 SSD 带宽预测实测收益:分片、系统调用、CPU 编码、其他 I/O 竞争和 GPU 工作都在这条路径里。
最后一个活跃 block 期间预取首层,也是一笔实际读取。即使这是本次请求最后一次需要执行核心的求值,循环仍按这条规则发起;如果模型马上释放,准备好的首层就不会被本次请求再次消费。若 prepared DiT 被交互 缓存 保留,它可以服务下一次求值。这里没有依据把总读取量简单写成"步数乘全部权重":活跃层选择、核心复用和这笔首层预取都要纳入口径。应把本轮发起的读取与真正消费的权重分开;马上清缓存使它成为未消费预取,继续求值则可利用准备结果,不要把两者混成平均收益。2
底层文件函数使用只读 open 与 pread,把数据填到 Metal buffer 的 CPU 可见地址;Darwin 可用时会尝试设置 F_NOCACHE。源码忽略了该 fcntl 的返回值,所以只能说它请求减少文件缓存保留,不能说已证明绕过所有缓存,更不能从这个读路径推出实际 SSD 写放大或寿命损耗。读取压力、写入量和寿命是不同指标,真实缓存效果须另有系统观测。5
重叠窗口只解释剩余等待,不产生凭空带宽
设想一轮读取需要的时间比当前 block 编码与 GPU 工作更短,join 前读取已经结束,剩余等待可能接近线程收尾;反过来,读取更长,join 会等待未完成部分。这个定性例子说明为什么读用时大而剩余等待小并不矛盾。它没有给出本机毫秒数,也不保证计时等于两者简单相减,因为线程启动、调度和计时范围不同。
同样,累计读取用时和整条请求的墙钟时间不能相加当总耗时:有一段已经与计算重叠,再加一次会重复计算。源码输出的读吞吐也只对应已统计的字节与读取任务时长,不能当整机持续 SSD 速度,或者外部设备的可承诺带宽。对比时先固定字节统计范围,再明确 warm、cold、系统缓存及其他读取者。
生成结束,不一定立刻释放这两个槽
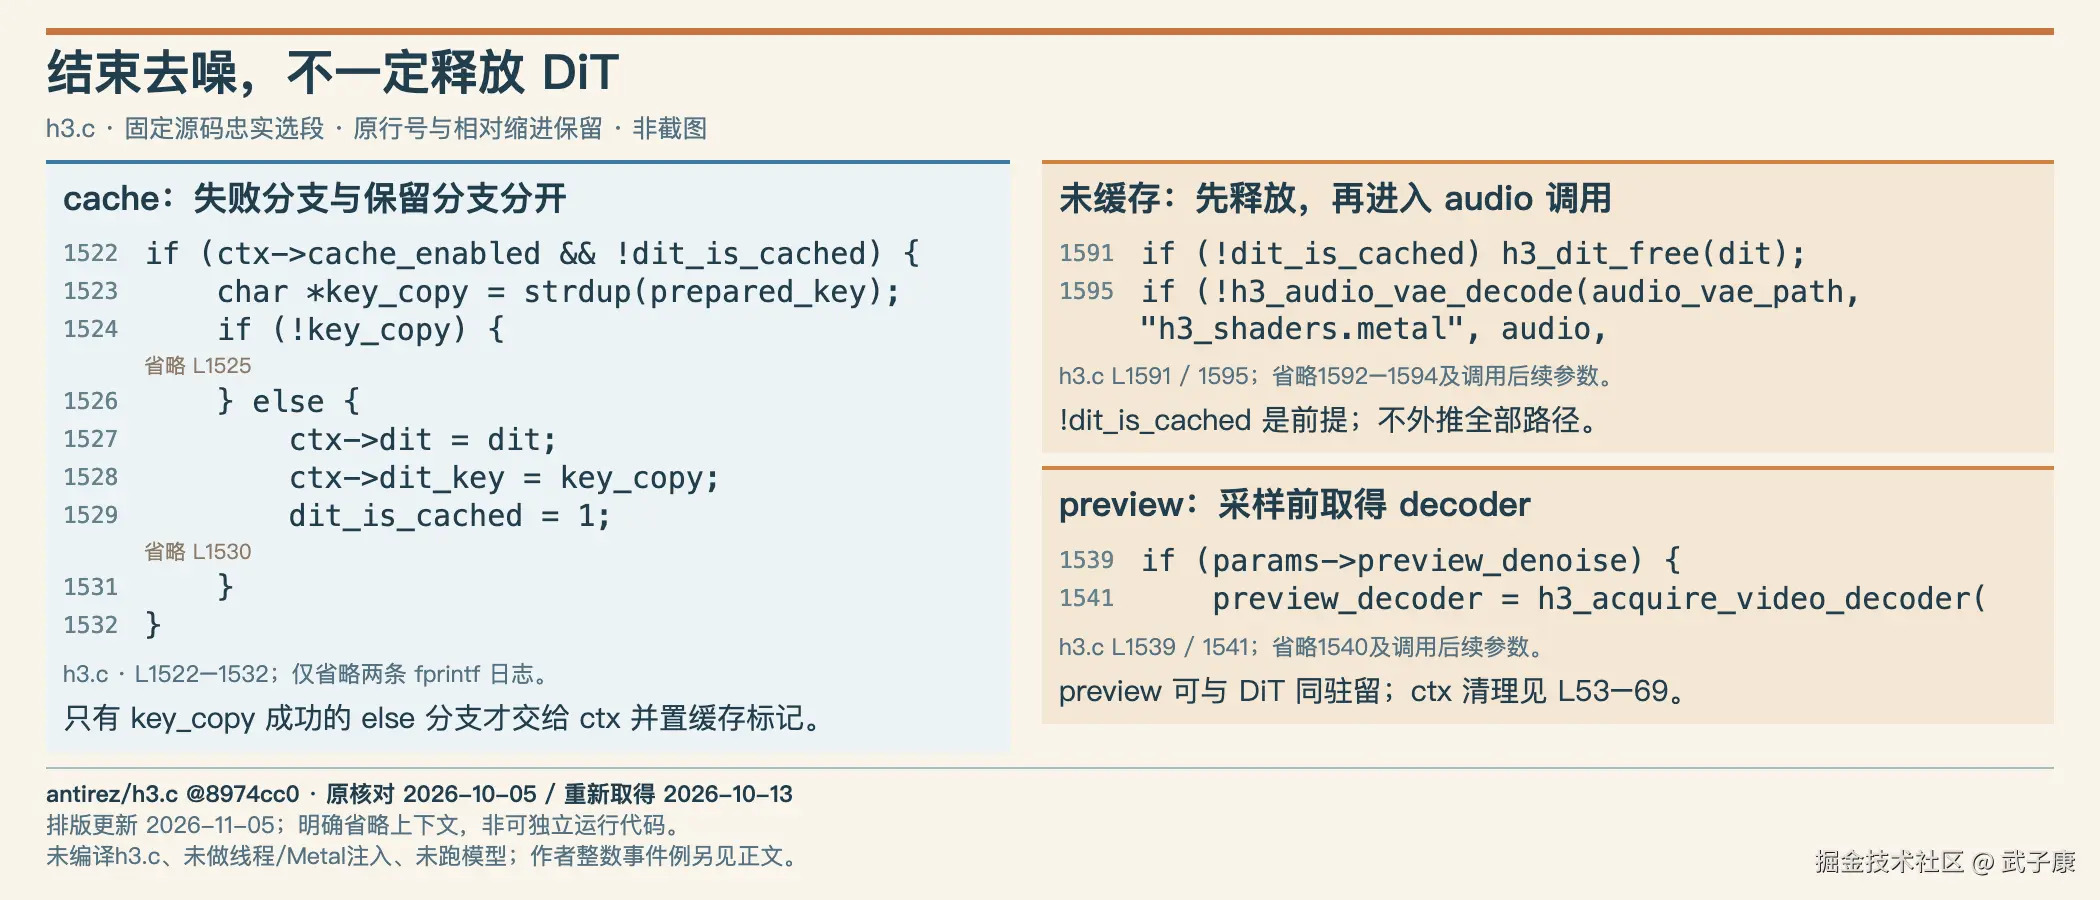
h3_dit_free 会释放每层小权重、两个 stream slot、激活与 schedule,随后释放 GPU 对象和 weight store。槽的所有权归 DiT 对象,而不是归每一个读取线程;线程负责填充,循环负责安排何时复用,对象析构负责最终释放。6
外层 h3_generate 决定这个 DiT 活多久。未缓存时,denoise 成功后会先释放 DiT,再进入音频和视频解码;缓存开启且模型被保留时,会跳过这次释放。h3_cache_clear 才会明确清掉保留的 DiT、conditioning 和视频 decoder。7
所以,"各模型阶段不必把全部权重同时留住"是一种生命期安排,不能写成永远互斥。交互缓存会延长 prepared DiT 的驻留;启用 denoise preview 时,还会在采样前加载视频 decoder,让预览能力和较低驻留发生取舍。只盯着最终解码开始的时刻,会漏掉这段重叠。
这也解释了 README 数字的口径。项目作者报告特定 M5 Max 条件下 DiT tracked tensor storage 从约 36.5 GiB 降到约 2.0--2.1 GiB,同时 warm forward 变慢;README 明确说后一个数字不是系统总 RAM。它只能作为作者报告,不能替代本文未做的进程峰值、完整生成时间或本机容量测试。8
一次结束、一次清缓存,回答不同生命期问题
请求生命周期和 prepared DiT 生命周期并不相同。未保留的路径在 denoise 后释放,保留的路径让对象留在 context,供后续请求使用。判断是否存在异常驻留,应先说明期望的缓存策略:如果产品设计就是交互复用,结束后仍占用不自动等于泄漏;如果用户明确关闭缓存后仍有对象,则应检查清理路径与实际持有者。
可构造四种对照:cache 与 preview 都关、只开 cache、只开 preview、两者都开。每组固定输入与采样配置,分别记录采样开始、denoise 结束、解码完成和显式清缓存后的驻留。这是待执行实验矩阵;它能区分槽容量下降、decoder 重叠与跨请求缓存,而不是用一个峰值猜每个对象的责任。
还有一种容易误读的情形:对象析构已发生,进程指标却没有按 tensor 计数立即下降。不同采集指标可能包含分配器、系统或其他对象,不应据此反推 h3_dit_free 没执行。相反,tracked tensor storage 较小也不能证明其他对象不存在。对象调用记录与外部内存采样应互相补充,不能要求两个不同口径数值处处相等。
如果后续在该路径加入并发请求,还需重新核 context 与缓存对象是否被多个请求共享。本篇追踪的是当前固定版本的调用顺序,未验证新并发架构。缓存延长生命期虽然节省重复准备,却扩大了资源重叠范围;并发上限应根据完整请求观测决定,不以"仅两个槽"推算。
判断是否值得开,先把一次请求的驻留和等待对上
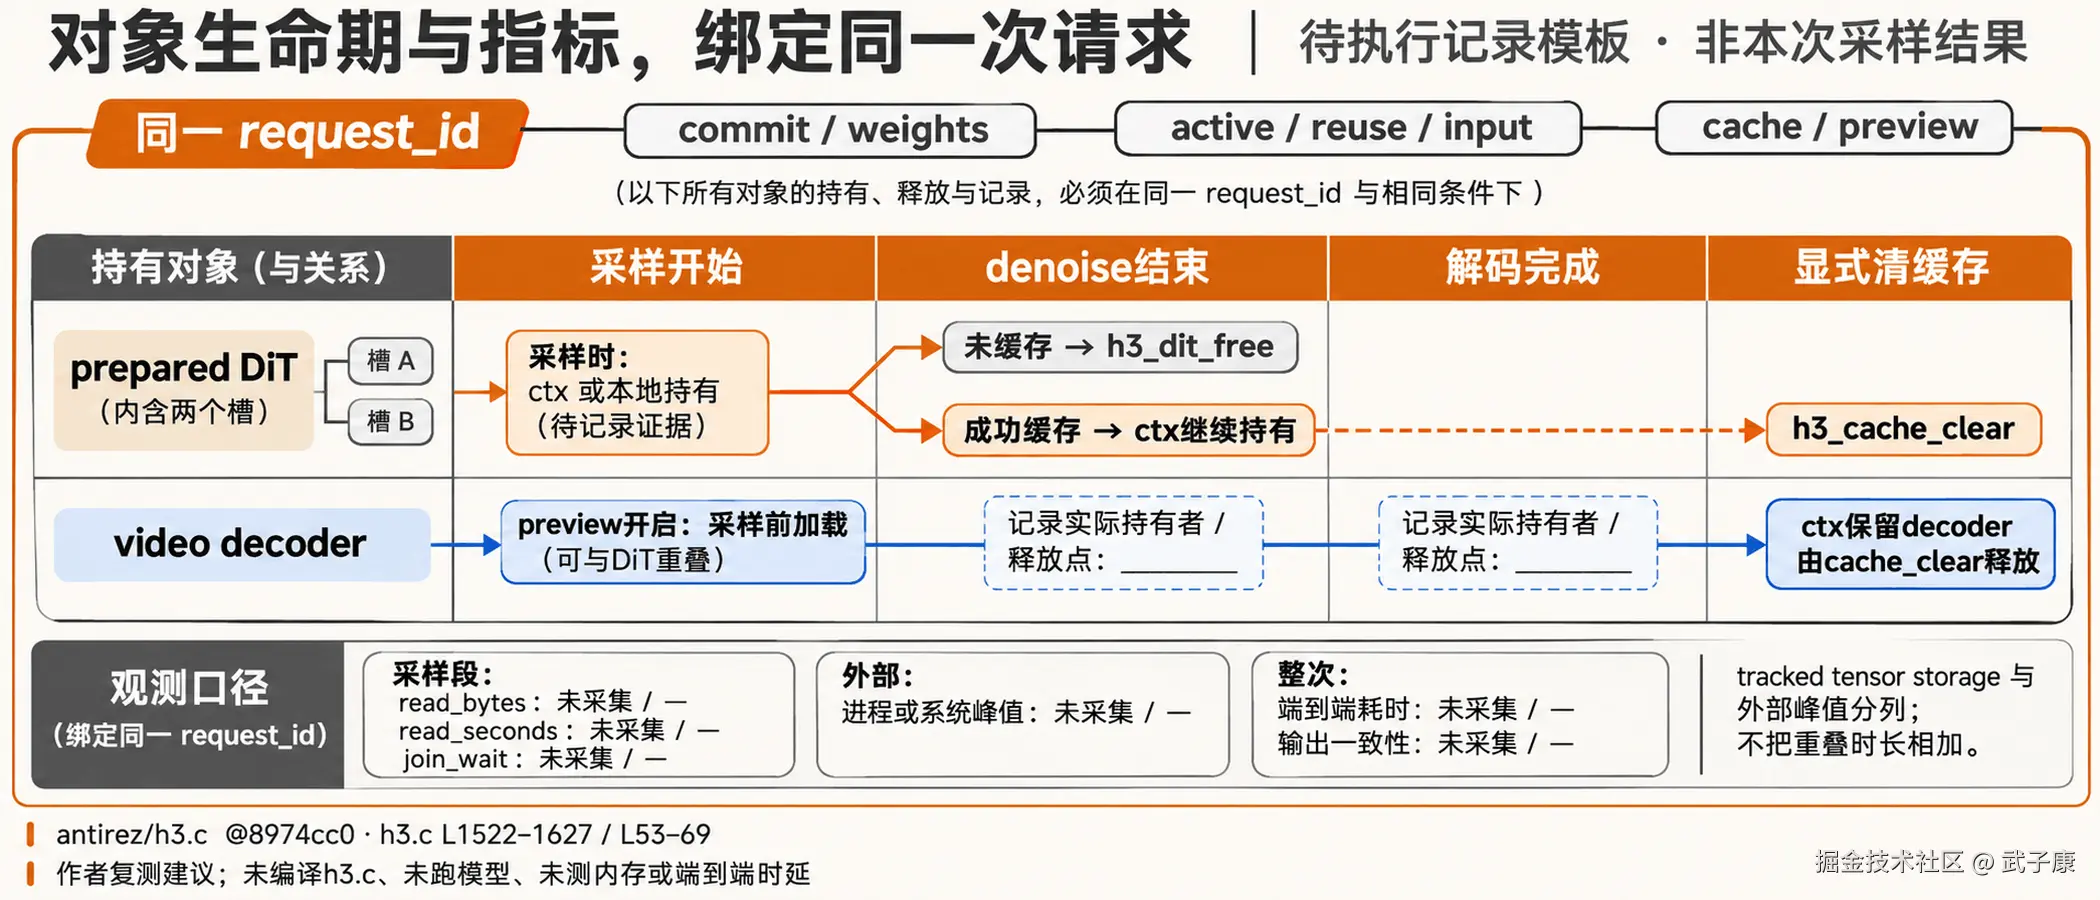
复测这类优化时,值得留下的产物是一张同请求条件的生命期记录:权重与版本、活跃层和核心复用配置、cache/preview 是否开启、各阶段谁持有对象,以及采样阶段的读取量、读取时间和剩余 join 等待。再把它们与独立采集的进程或系统内存、端到端耗时放在同一请求上比较。
这是一项复测建议,不是本文已经采到的 trace。记录的目的也不是把所有指标压成一个"省了多少 GiB":如果 tracked storage 下降,但预览或缓存继续持有大对象,进程峰值未必按同样比例下降;如果读取等待明显,容量问题虽然缓解了,延迟代价仍然存在。
h3.c 这条路径最有迁移价值的部分,是把"下一块权重何时需要""上一块何时不再被 GPU 使用""谁最终释放缓冲区"写成可核的顺序。SSD streaming 能减少同时驻留的大矩阵;它是否适合你的请求,还取决于重叠窗口、其他驻留对象和允许的时延。
把容量约束与时延预算分别验收
决策可以先问两个具体问题:完整常驻是否使目标输入无法运行,streaming 增加的端到端等待是否仍可接受。前者是容量约束,后者是服务体验。若常驻已经有足够余量,开 streaming 未必值得;若容量已成为硬限制,允许一定等待的离线任务可能有不同取舍。这是需求判断框架,不是对任何硬件的购买建议。
一张比较表应让每行对应同一个配置和请求:固定提交、权重标识、活跃层、复用配置、cache/preview、输入尺寸、读取字节、读任务用时、剩余 join 等待、外部峰值、完整耗时。缺了字段就标未采集,不把 README 数据填成自己的观测。只比较 tracked storage 会漏掉媒体与 decoder;只比较 GPU forward 会漏掉加载和最终解码。
对正确性也应有独立栏。复用两个槽后,输出是否与相同条件的常驻路径一致,需要目标版本实际对照。README 的 byte-identical 是作者在特定检查中的报告,不能替本次未执行的输出比对。若输出不同,先核层映射、读取完成和消费完成,再讨论精度或算法,不能因为仍为 BF16 就默认全部等价。
一次请求通过之后,还应覆盖反复求值、最后一次预取后立刻清理、取消、读取失败及 cache 切换。这些场景决定对象和线程是否按设计收尾。观察重点是错误没有把未就绪槽投入计算,旧槽没有被提前覆盖,所有者在使用者结束后释放。本文只提供对应源码定位和实验问题,没有形成运行通过证明。
最终记录应把三层证据分开:源码证明了调用顺序,作者报告了特定设备数字,自己的复测才证明目标容量与延迟。这样"两个槽"就成为可解释的资源安排,而不是一个脱离请求条件的内存标签。
来源与核验范围
原2026-10-05核对、2026-10-13重新取得完整官方文本,antirez/h3.c 固定提交 8974cc055ea9c02fcd14cc27dfda3e1027c05153。本次重新取得四个官方源码/README,原字节SHA与原记录一致;所取默认main四文件也相同,但不推断整个项目或未来默认分支稳定,行号仍限定固定提交。作者有限Python整数事件例已运行,不是h3.c官方fixture;未编译h3.c、下载权重、执行模型生成或性能采样。原研究 ZIP 提供线索,初始化两槽、线程启动时刻与缓存生命期均以本次固定源码核验为准。
-
h3_dit.c L579--641、L1241--1294:schema、四矩阵、双槽和首槽同步装载。 ↩︎ ↩︎
-
h3_dit.c L2218--2301:另一槽预取、提交、join 与 ready 更新;核心复用条件见 L2160--2178。 ↩︎ ↩︎ ↩︎
-
h3_gpu.m L913--944:提交与等待 GPU 完成。 ↩︎
-
h3_dit.c L662--684、L2275--2298、L3048--3055:读取与剩余等待的计时位置。 ↩︎
-
h3_gpu.m L723--790:只读文件、pread、F_NOCACHE 请求及读取边界。 ↩︎
-
h3_dit.c L2995--3059:槽与对象析构。 ↩︎
-
h3.c L1522--1627、L53--69:保留、解码前释放、预览和显式清缓存。 ↩︎
-
固定 README L142--158:作者报告与内存口径,非本文性能实测。 ↩︎