语音聊了十分钟,为什么不能拿转写分钟算费用?
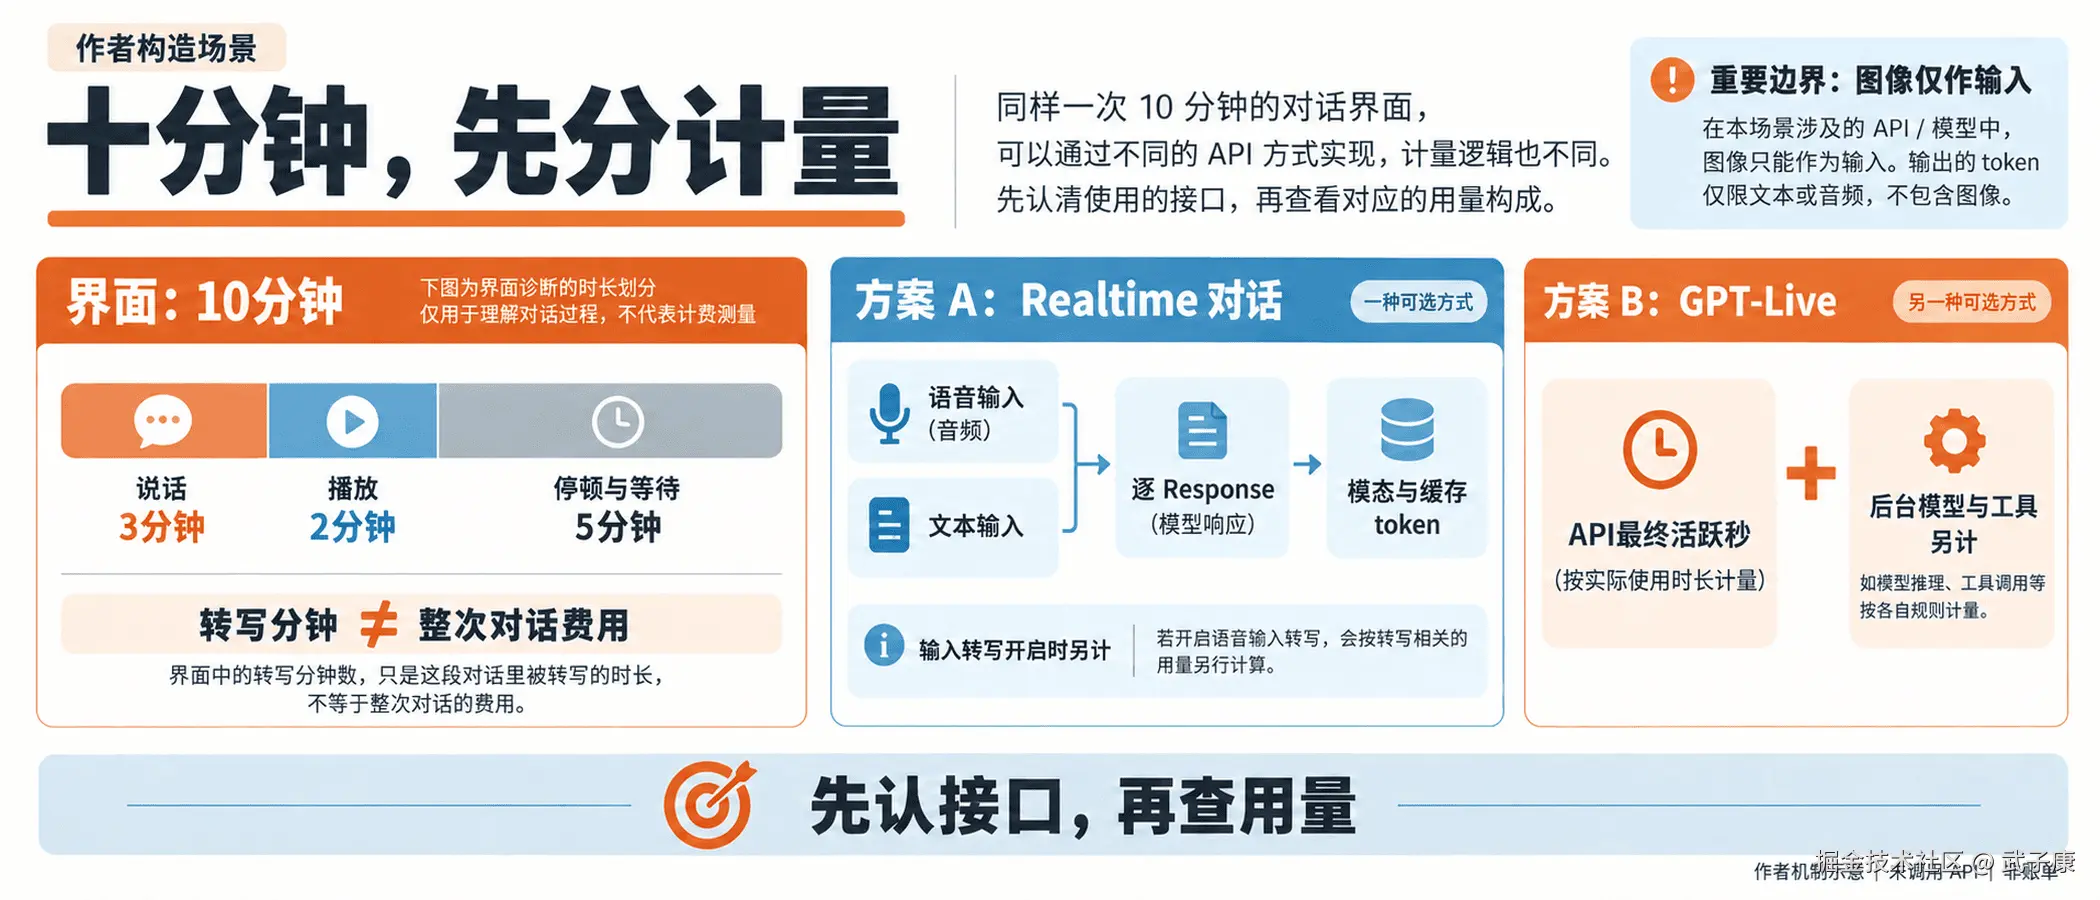
作者计量机制或核对记录;两独立构造演算,仅本地算术,无API/设备/实际账单测试。
手机显示这次对话持续十分钟。用户真正说话三分钟,配件播放回答两分钟,其余时间在停顿和等待。工程侧若只拿三分钟录音乘转写单价,得到的只是某一段转写费用,不能代表这次 语音对话 。
先确认应用调用的是哪套接口。对话型 Realtime 的主要计量是每次 Response 的输入、输出 token ;GPT-Live 的语音部分计量是活跃会话秒数,后台模型与工具另算。同样叫"十分钟",它们需要的用量证据不同。
下面按 2026 年 10 月 10 日核对的 OpenAI 官方文档,给出一份作者构造的核对例。只有本地算术复算;没有连接配件、调用模型、产生扣费或取得真实 usage。 示例不比较两个 模型 谁便宜,也不据此推导订阅价。
先认清这次"分钟"来自哪里
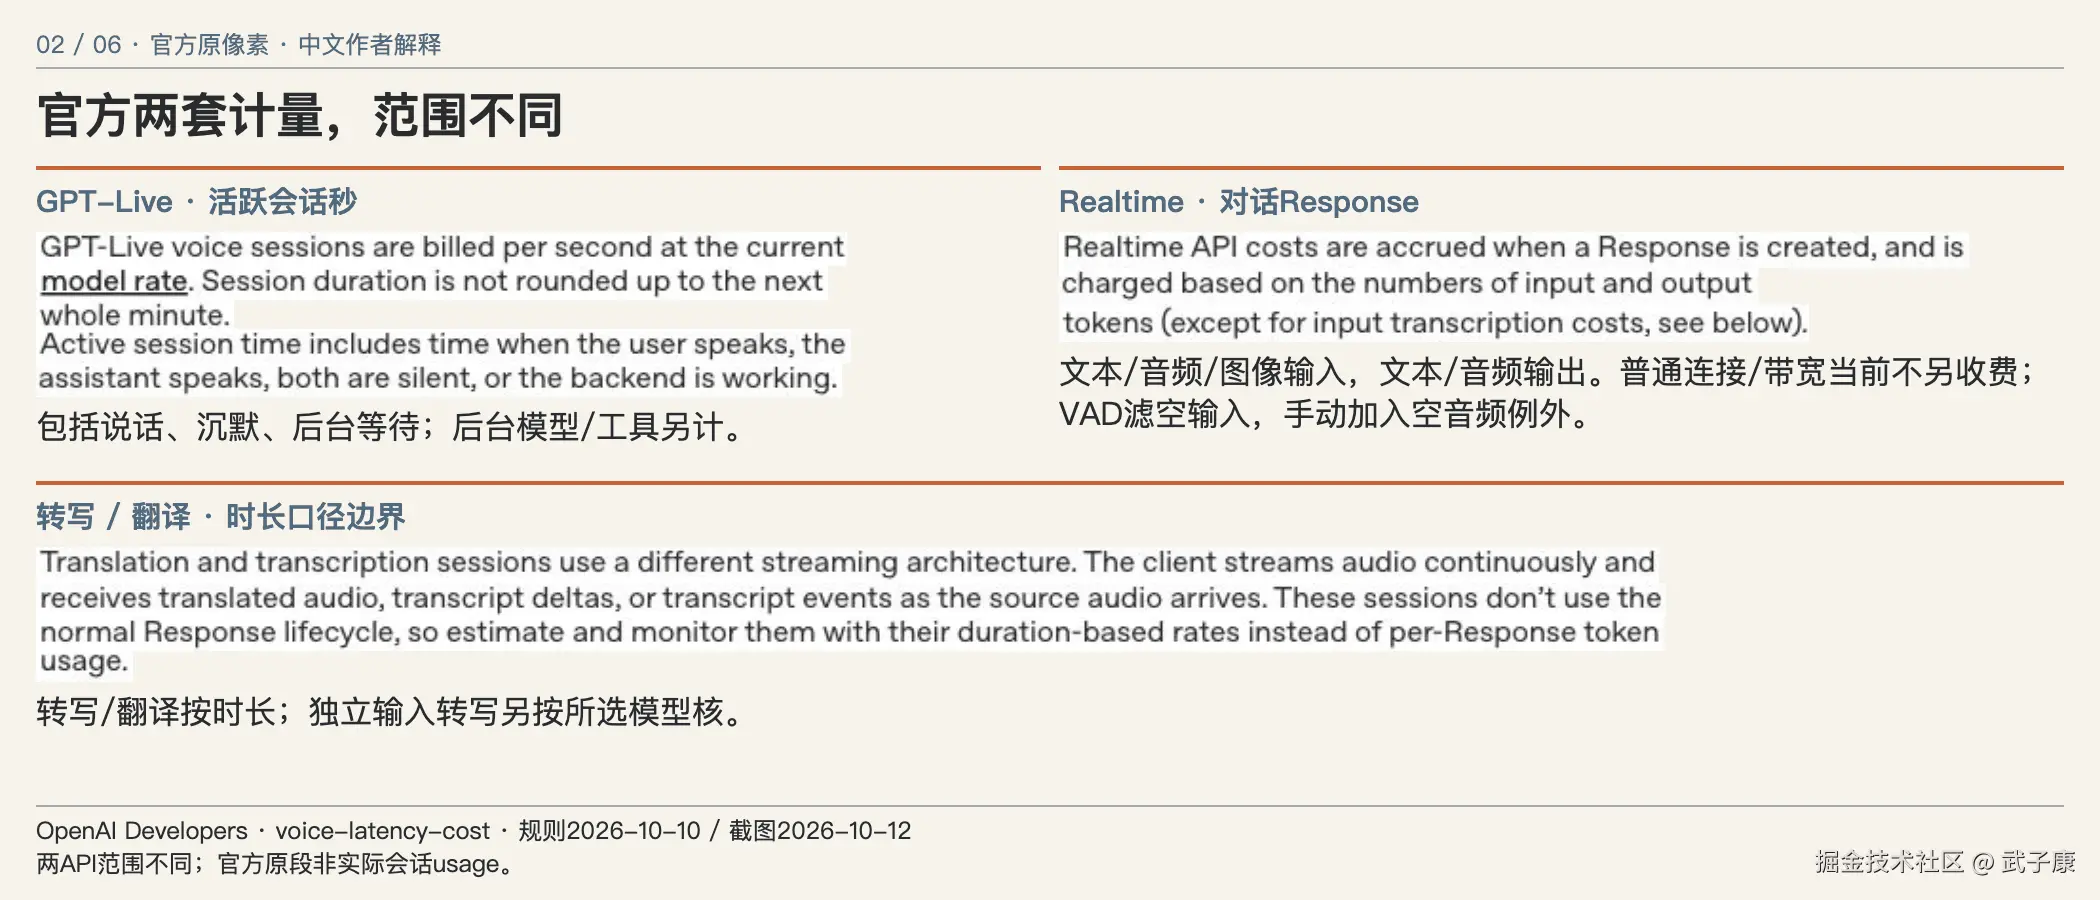
官方网页原像素,中文为作者解释;价目/规则冻结2026-10-10,截图2026-10-12重核原文一致。
官方费用指南给 GPT -Live 的计量说明是:
"GPT-Live voice sessions are billed per second"
它计入用户说话、助手说话、双方沉默和后台工作时的活跃会话时间。应采用 API 报告的会话时长,不能只累加实际播放音频。1 会话管理文档也明确,静音麦克风仍让会话保持活跃。4
同一指南对 Realtime 对话给出的规则是:
"Realtime API costs are accrued when a Response is created"
Response 是一次模型响应。它的输入包含当前提交的内容和保留的对话历史,上一轮输出会成为后续轮次输入;文本、音频、图像适用各自计价。历史进入输入不代表全部按新输入单价收费,实际 缓存 量还要从用量里拆出来。普通对话连接和网络带宽当前不另收费;VAD(语音活动检测)会滤除空输入,但手动把空音频加入对话输入是例外。1
这解释了为何一个计时器不够:播放只描述用户听到了多久,转写分钟只描述被送去识别的音频量,界面墙钟时间只描述应用经过了多久。它们不能互相替代供应商的计量。
这里的 Realtime 规则限定为对话型会话。流式转写与翻译采用音频时长计量,不走普通 Response 生命周期。只做录音转写的产品,按其所选服务的录音时长和转写费率做预算仍然合理;增加生成回答、持续语音会话或工具之后,再补对应的费用。1
Realtime:一条响应里,缓存输入不能再算一遍
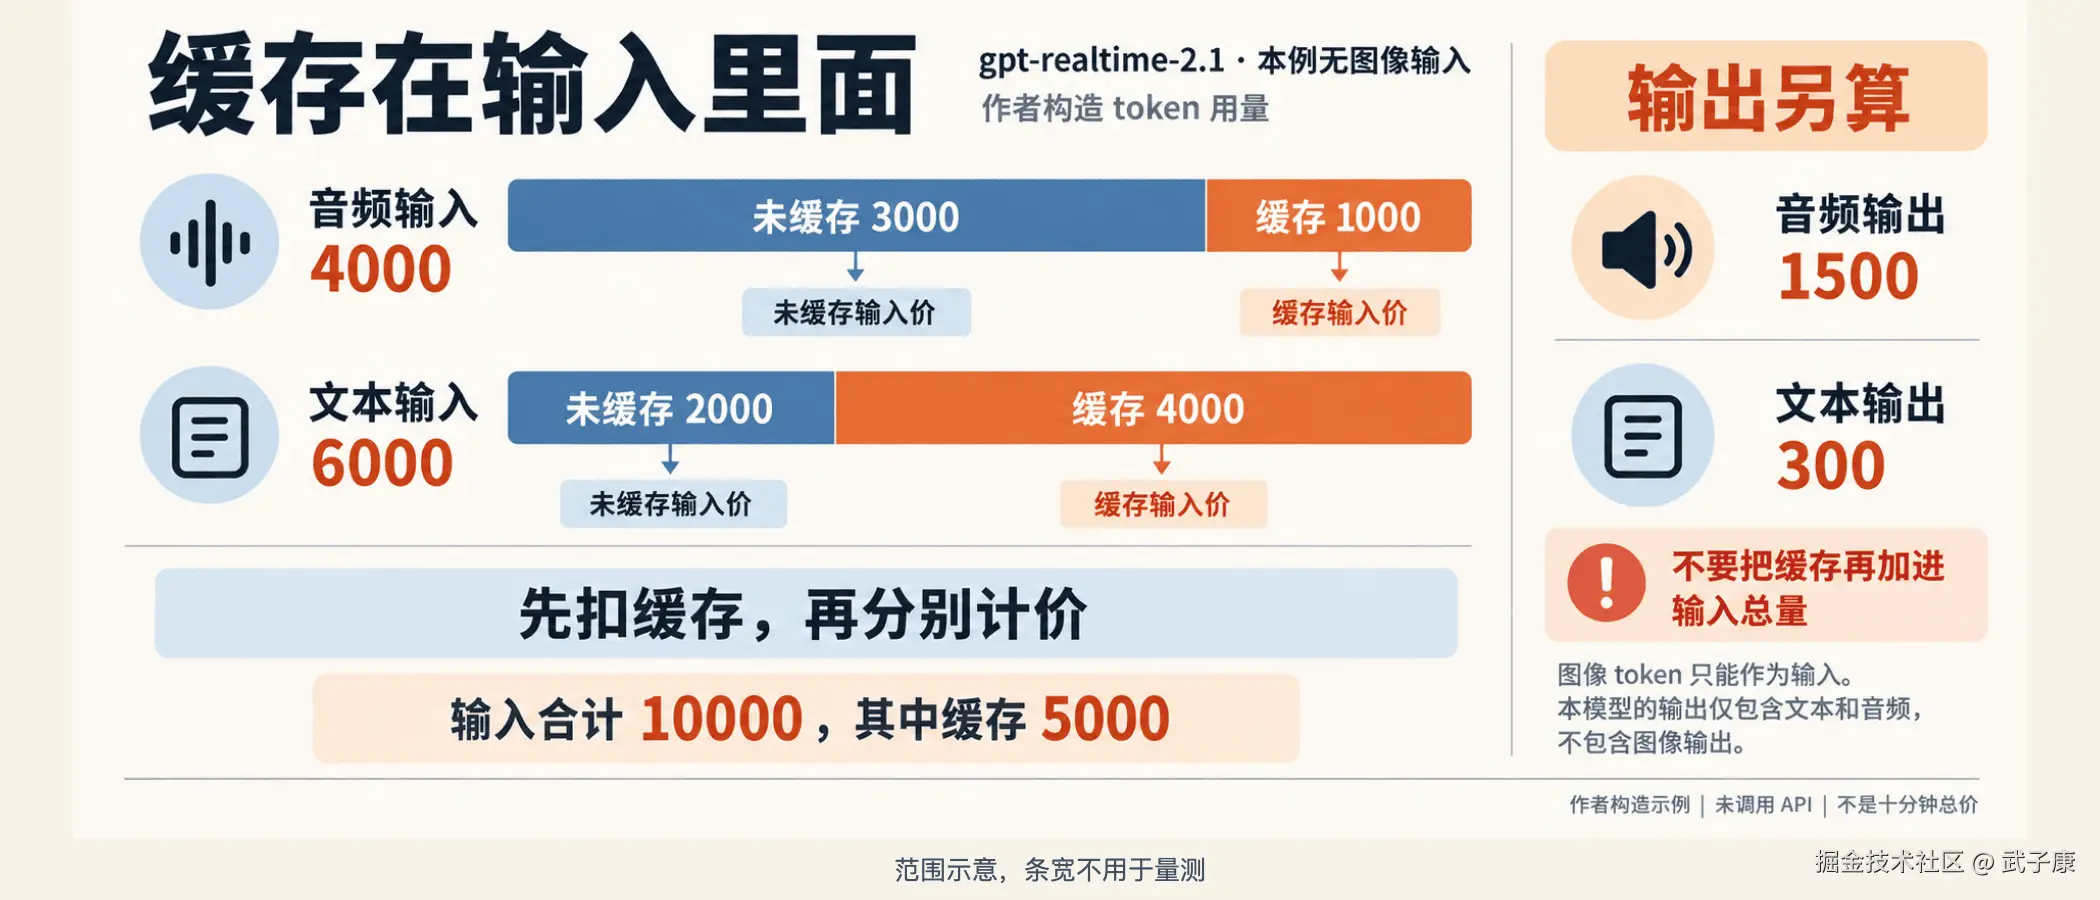
作者计量机制或核对记录;两独立构造演算,仅本地算术,无API/设备/实际账单测试。
服务器事件参考把 response.done 中的 response.usage 定义为该 Response 的用量,并明确:
"Cached tokens here are counted as a subset of input tokens"
缓存 token 属于输入量。2 因此,按模态计费时先拆出缓存部分,再对剩余输入计新输入价格。只记录 total_tokens 无法区分输入、输出、音频、文本和缓存价格。
以下数值都是作者构造,单位是 token,假设一条 gpt-realtime-2.1 Response 无图像输入,所有使用量字段齐全。它只是一条响应,不是整段十分钟对话的实测或估算:
| 用量部分 | 输入总量 | 其中缓存 | 输出量 |
|---|---|---|---|
| 音频 | 4000 | 1000 | 1500 |
| 文本 | 6000 | 4000 | 300 |
对应实际接入时的读取位置是 response.usage.input_token_details 中的 audio_tokens、text_tokens 及 cached_tokens_details,输出来自 output_token_details。本例输入合计 10000、其中缓存 5000,输出合计 1800;缓存没有多产生另一份输入。2
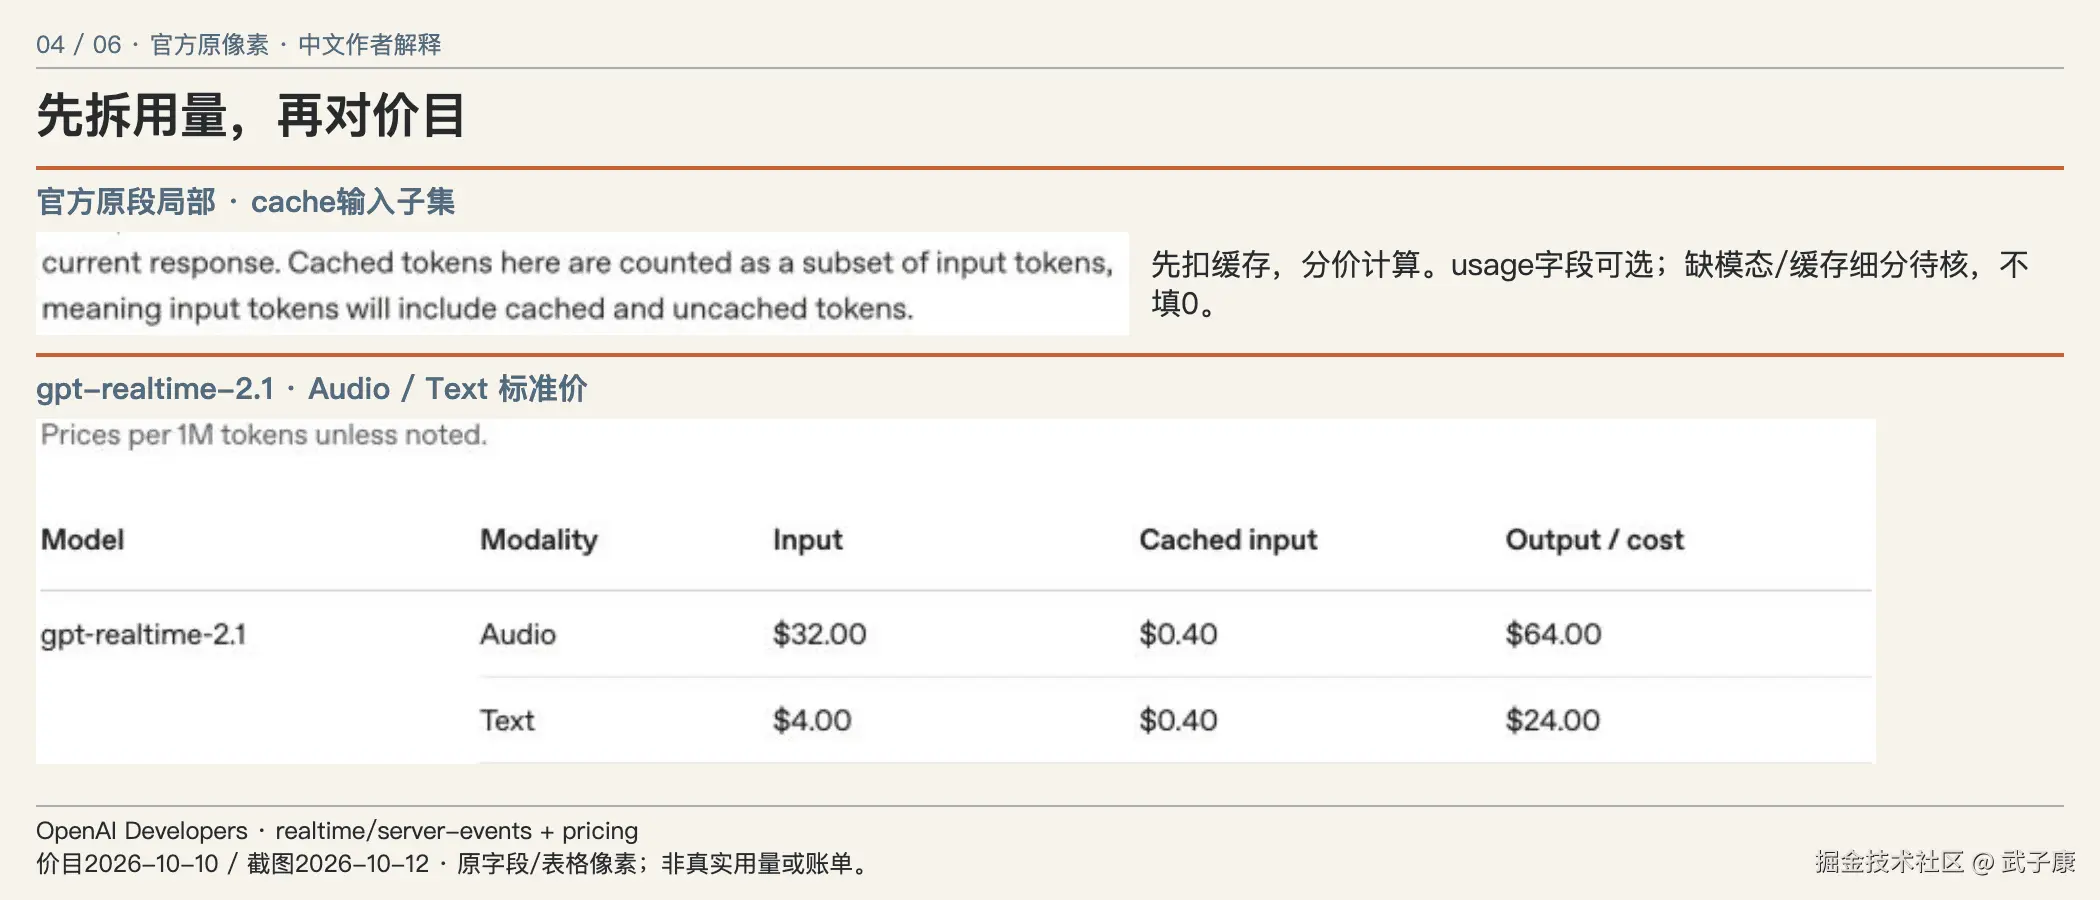
官方网页原像素,中文为作者解释;价目/规则冻结2026-10-10,截图2026-10-12重核原文一致。
核对日的标准美元价目如下,均为每百万 token:3
| gpt-realtime-2.1 | 新输入 | 缓存输入 | 输出 |
|---|---|---|---|
| Audio | $32.00 | $0.40 | $64.00 |
| Text | $4.00 | $0.40 | $24.00 |
于是,这条响应的六项模型费用为:
text
音频新输入:(4000-1000) × 32 / 1000000 = $0.0960
音频缓存:1000 × 0.40 / 1000000 = $0.0004
文本新输入:(6000-4000) × 4 / 1000000 = $0.0080
文本缓存:4000 × 0.40 / 1000000 = $0.0016
音频输出:1500 × 64 / 1000000 = $0.0960
文本输出:300 × 24 / 1000000 = $0.0072
本条 Response 模型费用:$0.2092
计算使用了实际运行的 Decimal 脚本。脚本核对缓存不超过对应模态输入、各模态合计和上述金额,只证明这组构造输入的算术正确。
如果开启独立的输入转写,还需加该转写模型的用量和价目。费用指南说明它使用不同于语音对话模型的模型,完成事件是 conversation.item.input_audio_transcription.completed。事件参考区分 token 与时长两种 usage,应用应依所选转写模型读取,不统一换成对话 token。2 本例未给这项构造用量,因此 $0.2092 仅覆盖列明的 Response 模型费用。
计量记录要区分新增响应与重复事件
一个应用会话可能产生多条Realtime Response,不能把某条响应的费用直接代表整个会话。作者建议先按实际response ID逐条归集,保留模型、价目与必要细分,再在应用会话层汇总已确认分项。按唯一 response ID 保留每条终态响应的用量,避免相同事件重投递重复计费;用户重新发起一次生成,即使回答文字相似,也可能是另一个真实响应。去重依据应来自响应身份,不能用文本相似度猜测是否重复收费。
文档中的 usage 与细分字段是可选项。2 缺 usage、必要模态或缓存细分时保留待核,不填零,也不按"上下文看起来没变"自行认定命中。若终态事件的字段不完整,先保留原始可用数据及缺失字段,再安排对账。已经取得input_tokens却没有模态与缓存拆分,通常还不能按本例六项价格精确复算。应用可以展示已观察总量与费用待核,但不能把缺失细分强行分配成全音频或全新输入。一个看似完整的美元数值,若靠猜字段凑出,反而降低记录的可信度。
取消的回答也要按实际用量处理。用户没有听完,不等于模型没有生成;执行中出错,也不一定意味着这条响应没有成本。计费记录与播放记录各自保存,再用同一应用会话关联。这样可以分析"生成了但未播放"的部分,却不会把它直接从账本删除。本文没有执行取消或测量浪费,只提出排查时应保留的对象。
数值计算还应区分内部 精度 与展示精度。六个分项可以用十进制保存较完整的金额,汇总后再按展示规则格式化。若先把每个很小分项舍入到两位小数,大量响应相加可能偏离完整计算。具体账单采用何种舍入、合同价或调整项,需要按实际供应商账单核对;本文的Decimal输出只验证构造数值,不代表账单的最终结算规则。
GPT-Live:累计快照取最终值,后台留在另一项
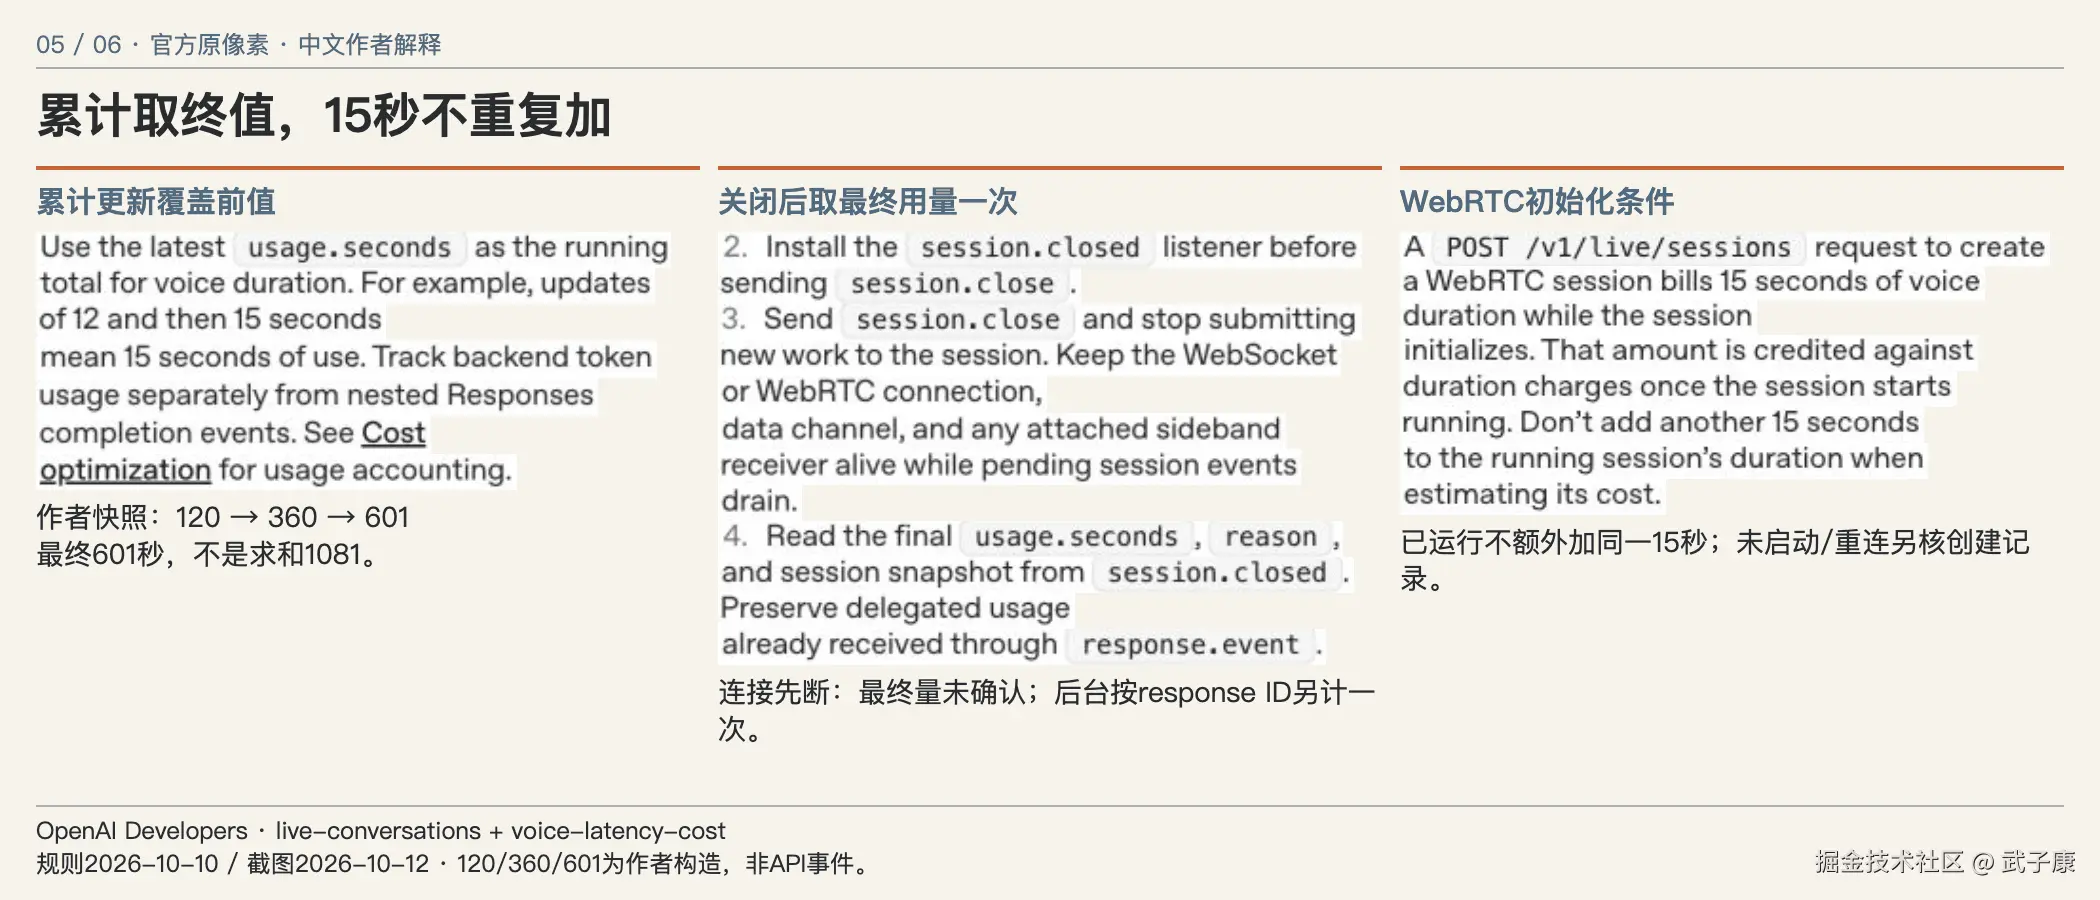
官方网页原像素,中文为作者解释;价目/规则冻结2026-10-10,截图2026-10-12重核原文一致。
GPT-Live 的 session.usage.updated 报告累计 usage.seconds。例如收到 120、360、601 三个快照,不能相加成 1081 秒。按会话文档,先安装 session.closed 监听器,发送 session.close 后保持连接,记录关闭事件最终的 usage.seconds 一次。若连接先断,保留最新观察值,标最终用量未确认。4
再构造一条独立示例:界面约十分钟,最终 API 用量假设为 601 秒,模型为 gpt-live-1。2026-10-10 价目是 $0.05/分钟,按秒计费、不向上取整到整分钟。3
text
语音部分 = 601 / 60 × $0.05 ≈ $0.50083333
后台模型/工具部分 = 待核
会话总费用 = 待核
这个 601 秒不是测量结果,也没有从前三分钟说话或两分钟播放推出来。后台为待核时,不把语音部分写成会话总费用。它与前面的 Realtime 响应是两份独立构造输入,既没有相同任务集,也没有相同完成结果,金额不可用于模型价格排序。
费用指南另有一个容易重复计账的条件:WebRTC 创建请求 POST /v1/live/sessions 会先计 15 秒初始化语音时长,运行后抵扣到时长费用里。已经开始运行的会话不能在其总计量时长之外再追加同一份 15 秒。会话创建后未开始运行、重连等路径仍需保留创建收费记录再核对,不能用这句抵扣说明抹掉所有初始化费用。1
后台若由 Responses 委派执行,应读取经 response.event 传来的嵌套 response.completed 的 usage,按后台 response ID 计一次;应用自行调用的模型或服务也要另收用量。1 这些是 GPT-Live 的事件路径,不能拿来读取 Realtime 的 response.done。
最终秒数没收到时,留下观察范围
假设应用看到累计360秒后连接突然断开,没有取得 session .closed。360秒是最后一次观察值,不是已经确认的最终时长;后面是否还有活跃时间,要依据实际会话与账单记录查证。不能用手机计时器补成某个精确供应商秒数,也不应为了让表格完整填零。报告可以先写观察值与最终值待核,等待所需证据。
重连同样要确认形成的是同一会话的连接恢复,还是新的会话创建。后一种情况可能产生独立创建记录与独立时长;不能把两个会话的累计快照当作同一计数器续接,也不能因为界面只显示一段聊天就漏掉第二个计量对象。本文没有验证重连行为,实际接入应按所用协议记录会话身份和创建结果。
语音结束与后台结束也可能不同。用户结束前台对话时,后台工具或模型工作是否继续,由应用与接口支持决定;对已实际发生的后台响应,仍需采集相应用量。这里不假定关闭语音会话自动取消所有后台请求,也不假定所有后台都会继续收费。把各对象的终态与用量分项留下,才能依据事实汇总。
为了验证自己的采集逻辑,可以用录下来的事件或构造事件分别检查累计快照不相加、同一响应事件不重复计、新响应保留、缺终态不填最终值、缺细分不推价格。这样的检查验证的是记账程序,不是实际供应商费用或语音服务质量。本文的既有脚本只完成列明两份输入的算术检查,这些采集用例仍属于后续作者建议。
在本机复算,先看输出究竟证明什么
把下面完整源码保存为 calculate.py,在同一目录执行 python3 calculate.py。它只使用Python 3标准库,不安装SDK,不需要API key,也没有网络代码;不要使用会关闭断言的 -O。程序只向标准输出打印JSON,不写文件。本例的八项算术断言与构造输入保持不变,不是用量数据库或供应商账单。
脚本有八条 assert。前四条约束缓存位于对应输入之内,以及输入、缓存、输出的模态合计;后四条确认六项合计、最终秒数对应构造快照末项、语音费用的八位展示数值,以及快照总和不能当最终时长。它们没有验证任意 usage 是否完整,也没有实现 response ID 去重或读取真实 session.closed。文中提出的采集用例仍是后续建议,不能用这次复算替它们打勾。
本次实际运行退出码为 0,标准错误为空。下面给出完整源码与真实标准输出,便于读者逐项复算。两组输入、固定价目和场景独立性没有改变;输出中的 transcription_usd、backend_usd 与两个 session_total_usd 为 null,含义是本例缺证据,不是这几项免费或总额为零。
python
from decimal import Decimal as D
import json
row={'input_audio':4000,'cached_audio':1000,'input_text':6000,'cached_text':4000,'output_audio':1500,'output_text':300,'input_total':10000,'cached_total':5000,'output_total':1800,'image_input':0}
assert 0 <= row['cached_audio'] <= row['input_audio'] and 0 <= row['cached_text'] <= row['input_text']
assert row['input_audio']+row['input_text']+row['image_input']==row['input_total']
assert row['cached_audio']+row['cached_text']==row['cached_total']
assert row['output_audio']+row['output_text']==row['output_total']
rates={'new_audio':'32','cached_audio':'.40','new_text':'4','cached_text':'.40','out_audio':'64','out_text':'24'}
units={'new_audio':row['input_audio']-row['cached_audio'],'cached_audio':row['cached_audio'],'new_text':row['input_text']-row['cached_text'],'cached_text':row['cached_text'],'out_audio':row['output_audio'],'out_text':row['output_text']}
parts={k:D(v)*D(rates[k])/D(1000000) for k,v in units.items()};total=sum(parts.values());assert total==D('.2092')
live_snapshots=[120,360,601];final_live_seconds=601;assert final_live_seconds==live_snapshots[-1];voice=D(final_live_seconds)/D(60)*D('.05');assert voice.quantize(D('.00000001'))==D('.50083333');assert sum(live_snapshots)==1081 and final_live_seconds!=sum(live_snapshots)
result=dict(evidence_tier='author_constructed_local_arithmetic_only',api_called=False,model_or_device_tested=False,billed=False,price_date='2026-10-10',currency='USD',realtime_model='gpt-realtime-2.1',realtime_scope='one_response_model_only',synthetic_usage=row,rates_per_million=rates,component_usd={k:str(v)for k,v in parts.items()},response_model_usd=str(total),transcription_usd=None,realtime_session_total_usd=None,live_model='gpt-live-1',live_scope='voice_duration_component_only',synthetic_cumulative_snapshots_seconds=live_snapshots,synthetic_final_seconds=final_live_seconds,live_voice_rate_per_minute='.05',voice_usd=str(voice),backend_usd=None,live_session_total_usd=None,comparison_performed=False,assertions_passed=True)
print(json.dumps(result,ensure_ascii=False))
实际标准输出:
text
{"evidence_tier": "author_constructed_local_arithmetic_only", "api_called": false, "model_or_device_tested": false, "billed": false, "price_date": "2026-10-10", "currency": "USD", "realtime_model": "gpt-realtime-2.1", "realtime_scope": "one_response_model_only", "synthetic_usage": {"input_audio": 4000, "cached_audio": 1000, "input_text": 6000, "cached_text": 4000, "output_audio": 1500, "output_text": 300, "input_total": 10000, "cached_total": 5000, "output_total": 1800, "image_input": 0}, "rates_per_million": {"new_audio": "32", "cached_audio": ".40", "new_text": "4", "cached_text": ".40", "out_audio": "64", "out_text": "24"}, "component_usd": {"new_audio": "0.096", "cached_audio": "0.0004", "new_text": "0.008", "cached_text": "0.0016", "out_audio": "0.096", "out_text": "0.0072"}, "response_model_usd": "0.2092", "transcription_usd": null, "realtime_session_total_usd": null, "live_model": "gpt-live-1", "live_scope": "voice_duration_component_only", "synthetic_cumulative_snapshots_seconds": [120, 360, 601], "synthetic_final_seconds": 601, "live_voice_rate_per_minute": ".05", "voice_usd": "0.5008333333333333333333333335", "backend_usd": null, "live_session_total_usd": null, "comparison_performed": false, "assertions_passed": true}修改输入后重新运行,只能验证修改后的本地算术。脚本写死了构造字段,没有处理坏类型、缺字段、负数或所有真实 API 响应;它不是通用计费 SDK。Decimal 保留十进制计算精度,语音部分的长小数是其计算结果,约 $0.50083333 是展示精度,均不代表供应商最终舍入或结算规则。要获得真实会话总额,仍需分别取得实际终态用量与适用价格,检查转写、后台和工具分项。
2026 年 10 月 14 日再次 GET 官方全文后,费用指南、价目与独立转写页面原文仍与此前保存字节一致;事件参考及会话管理全文有更新,但变化分别涉及错误 message 字段与启动问候方式。本文引用的缓存子集、usage 可选、累计秒数和关闭取终值规则核对未变。因此本例继续使用 2026-10-10 固定模型与标准美元价,不把重核日期改造成新的模型测试或真实账单日期。
把十分钟落实到这一条核对记录
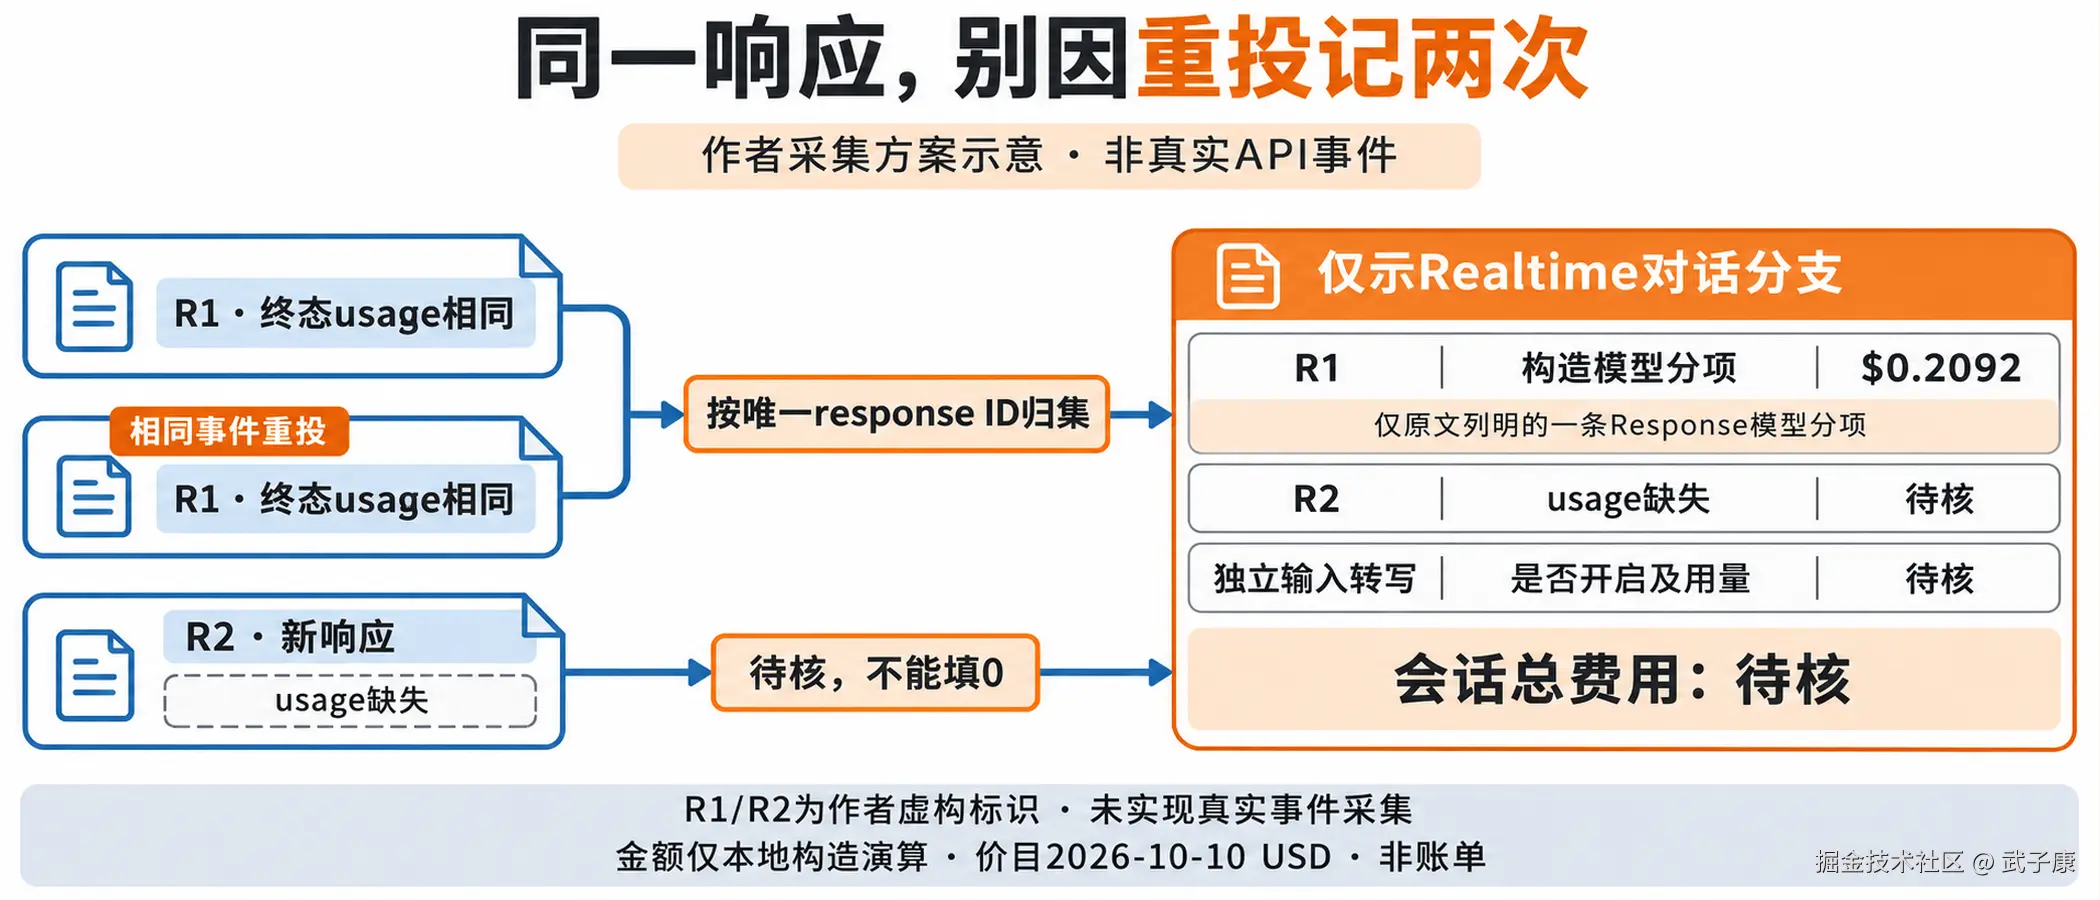
作者拟定的采集方案示意;R1/R2为虚构标识,金额复用原文一条Response的本地构造演算,未实现真实事件采集或取得账单。
工程交给产品的记录,可以从下面这一条开始。字段组织由作者设计,不是可以直接提交给供应商的 API 请求:
text
应用会话标识:[实际值待填]
API / 实际模型:[Realtime 对话或 GPT-Live;实际值待核]
价目日期 / 币种 / 价格范围:2026-10-10 / USD / 标准公开价
界面时长、说话时长、播放时长:[诊断信息,不直接作费用量]
Realtime 分支:唯一 response ID -> 模态输入/缓存/输出 [待填]
独立输入转写:是否开启、模型、完成事件用量 [待核]
GPT-Live 分支:session.closed 最终 usage.seconds [待填]
GPT-Live 后台:唯一 backend response ID -> 模型usage;工具费用 [待核]
已算分项:[金额及范围];缺少分项:[逐项列明]
总费用:[证据齐全后汇总;当前待核]
实际项目只保留自己使用的分支。如果十分钟只送去一次独立转写,就不必创建 Realtime Response 或 GPT-Live 后台记录。反之,进入持续对话后,应先让会话、响应和转写各自对应实际模型与用量,再汇总费用。另有电话、存储或第三方工具费用时,补其来源,不把本表当完整经营成本。
对账后再决定从哪一段降低成本
当语音部分已确认、后台仍待核时,可以先讨论这段语音时长的形成原因,却不能称已经得到完整会话成本。例如检查用户结束后会话是否按产品约定关闭,能够定位不必要的活跃时间;只静音麦克风却未关闭,不支持把这段时间从GPT-Live用量里去掉。任何策略变更都应保持用户需要的对话能力,再观察真实用量变化。
Realtime分支则应先看哪类输入、输出和历史缓存占比影响费用。减少某条输入、缩短回答或调整历史管理,可能改变任务质量与缓存条件,不能仅凭单价表预测净节省。用同一任务与验收标准记录变更前后真实usage,才适合比较效果。本文未运行这种实验,不从构造的$0.2092推出优化比例。
产品订阅价还需要使用分布、失败与重试、工具服务和运维等实际成本。本文的一条响应费用和一条语音时长费用不具有相同任务基础,因此不能拿金额高低判断模型更便宜。它们的作用是说明各自计量怎样复核,让预算从确定的接口和用量开始,而不是从一个含义不明的十分钟开始。
这样得到的结果是一条可查的计量记录:哪套接口,用了哪个模型,哪份价目适用,已算哪些部分,还缺哪份证据。是否限制会话时长、如何制定订阅价,仍需真实使用分布和服务承诺;本例只让那句"聊了十分钟"有对应的费用依据。
1 OpenAI --- Cost optimization,2026-10-10 核对,两套接口计量、初始化抵扣、使用量与独立转写说明。
2 OpenAI --- Realtime server events,2026-10-10 核对,response.done 的 usage 与缓存子集定义。
3 OpenAI --- API pricing,2026-10-10 核对,gpt-live-1 与 gpt-realtime-2.1 标准价快照;实际账单若适用合同或其他价格条件,需换用对应价目。原素材的旧价格、BOM 与全天陪伴月费结论未沿用。
4 OpenAI --- Managing GPT-Live sessions,2026-10-10 核对,静音、累计秒与 Usage and graceful close。