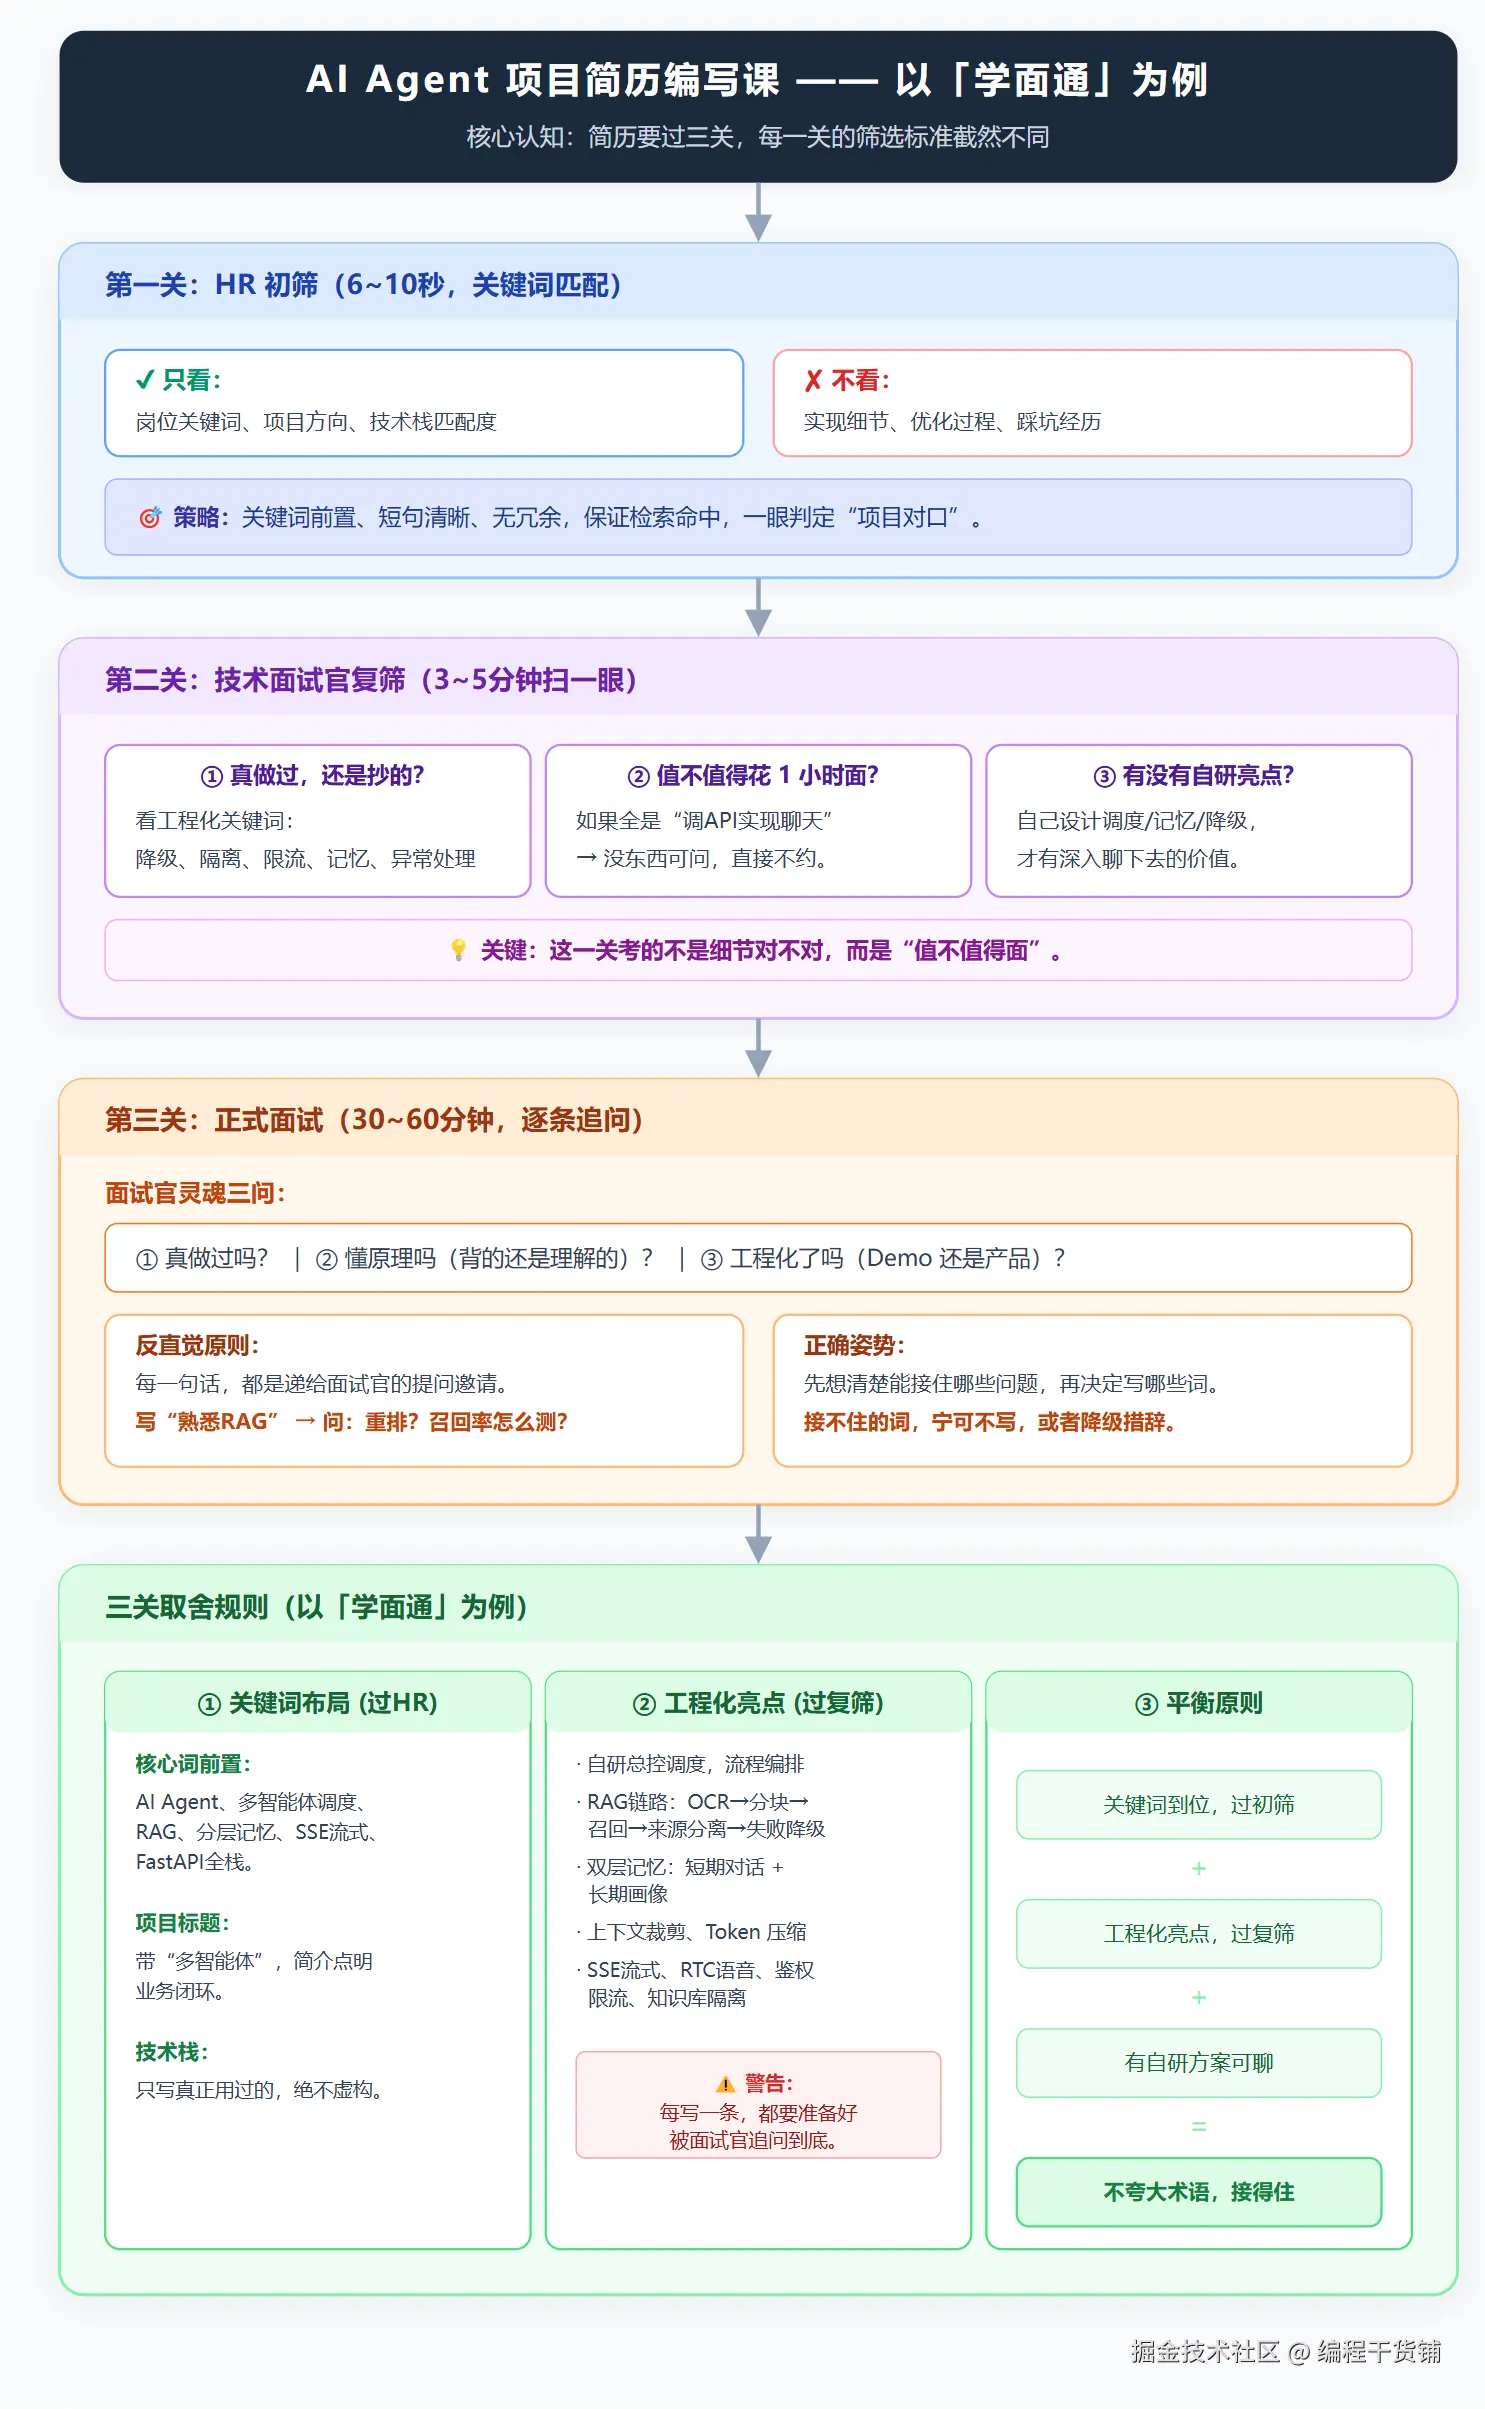
摘要: 简历不是自述,是要被三道标准不同的关卡各扫一遍的文档。技术很强却约不到面试,问题往往不在能力,在于力气花错了关卡。文末有三组「改前 / 改后」对照,可以直接照着改。
写在前面
「把我做过的东西都写上去」,是写简历最常见的起手式,也是最容易白费力的一种。
简历不是自述,是一份要被三道关卡各扫一遍的文档:HR 初筛、技术面试官复筛、正式面试追问。三关的标准不一样,有的地方甚至相反。技术很强却约不到面试,问题多半不在能力,而在你把力气花在了第二关和第三关,第一关没人接住。
下面按这三关拆,最后落到具体句子上。案例用 AI 智能体项目,这类项目踩的坑比较典型。
第一关:初筛,本质是关键词匹配
初筛的耗时按秒算,不是按分钟算。看的人可能是 HR,也可能是一边开会一边刷简历的用人部门负责人。他不会去读你的降级方案设计得多巧,他只做一件事:拿岗位 JD 里的词,在你简历上找对应。
找不到,就下一个。
所以这一关的淘汰理由通常很朴素:岗位关键词、项目方向、技术栈,三者对不上。注意是「关联度」,不是「有没有」。你写了 LangChain、写了 RAG,但岗位要的是「智能体编排」「多轮对话」,中间没有桥,照样出局。
写法上:
- 岗位名放最上面,别让人猜你投的是什么。
- 技术栈单独一行,尽量用 JD 里的原词。他写「大模型应用开发」,你就别只写「AI 开发」。
- 项目标题带上方向词。「企业知识库智能问答(RAG + 多轮对话)」比「XX 智能系统」有用得多。
- 删修饰。「深入参与」「全面负责」「有效提升」这类词在初筛阶段是纯噪音,既占地方又挡关键词。
小结: 第一关不奖励文采,只奖励命中。
第二关:技术复筛,看的是「这活是不是你干的」
过了初筛,简历落到技术面试官手里。他扫得很快,心里同时过三个问题。
- 项目真的做过吗。 判断依据是工程化痕迹:降级、限流、超时重试、上下文隔离、异常兜底、灰度。有这些词,说明你面对过真实流量和真实故障;全是「实现了」「接入了」「完成了」,读起来就像跑通 demo 就写上去的课程作业。
- 值不值得花一小时面。 面试有成本,面试官的时间比你的更紧张。他会快速判断这是个调 API 的聊天壳子,还是有人真的在用、出了问题有人兜的东西。判断不了,他就不约------不是你不合格,是他排不出这一小时。
- 有没有能聊半小时的点。 比如你自己设计的路由或调度逻辑、记忆怎么存怎么裁、模型超时或返回空的时候怎么兜、成本怎么压下来的。有一个就够,一个都没有,面试会变成尬聊八股。
小结: 这一关不看你多努力,只看项目有没有「被真实使用过」的痕迹。
第三关:面试追问,简历上每句话都是提问邀请
到了面试,简历的角色变了:从「介绍」变成「题面」。
面试官不会平均用力,他会挑简历里最亮的那两三行往下钻。你写「熟悉 RAG 检索」,他大概率会问:文档怎么切?切完怎么保证不切断语义?为什么用这个 chunk size?召回不准的时候先调哪一层?要不要加 rerank,加了之后延迟涨多少?线上召回你用什么指标看?
注意这些问题没有一个是「RAG 是什么」。全是「你当时怎么定的」。这也是背面试题的人在这一关露馅的原因:概念题能答,决策题答不了。
所以写简历时最该养成的习惯,是每写一句就问自己一句:这句话如果被追问三层,我答得上来吗?
答不上来,两个选择。
- 方案一:降级措辞。 把「精通」「负责设计」「独立实现」换成「参与」「使用」「在 XX 方案基础上改造」。措辞降下来,追问的深度也跟着降。
- 方案二:补齐认知。 先把这块内容吃透,等真能答了再写回去。
避坑提醒: 最不该做的是硬写------面试官在这个方向上通常比你熟,一句追问就能听出来。
落到句子上:三组对照
原理说完了,看句子。以下都取自智能体类项目,数字是示意,换成你自己的真实值------编数字在追问环节一秒就露馅。
案例 1
改前: 负责智能体项目的后端开发,使用大模型 API 实现了多轮对话功能,提升了用户体验。
改后: 智能体对话服务的会话层由我负责。原始方案是每轮把全量历史塞进 prompt,长会话下 token 成本随轮次线性上涨,超过 8k 之后模型开始丢前文。改成按主题分段摘要 + 最近 N 轮原文的双层上下文,单会话平均 token 降了约 40%,长会话答非所问的情况明显减少。
案例 2
改前: 使用 RAG 技术搭建知识库问答,提升回答准确率。
改后: 知识库问答的检索侧。第一版纯向量召回,实操中发现表格类和编号类问题经常召回失败,加了 BM25 做混合召回、再统一 rerank,人工抽检的 badcase 从百条 9 条降到 4 条左右。代价是 P95 延迟涨了约 200ms,用一层高频问题缓存抵掉了一部分。
案例 3
改前: 熟悉大模型调用,有丰富的 prompt 工程经验。
改后: 模型调用层做了两级兜底:主模型超过 8s 未返回或返回结构不合法时切备用模型,备用也失败则返回规则兜底话术并打点告警。上线后这类失败约占总请求的 3%,用户侧基本无感。
核心规律: 改后的句子都包含三样东西:一个具体的场景,一个当时做的取舍,一个能对账的结果。这三样凑齐,面试官的问题会自然往深里走,而你能答------因为那就是你干过的事。
反面坑: 写「独立设计并实现高并发智能体调度系统,支撑百万级调用」,如果实际是几十个用户的内部工具,这一行就是给自己挖坑:追问 QPS、追问部署形态、追问瓶颈在哪,三轮之内必然穿帮。简历上最贵的不是亮点,是漏洞。
写完自检
三关串起来其实是一件事:简历的写法是从后往前倒推的。
- 为了让初筛扫到: 关键词往前放、用 JD 的原词;
- 为了让技术面试官愿意约: 把工程化痕迹和真实使用结果写出来;
- 为了扛住追问: 每句话都先过一遍「这个我能答三层吗」。
自检方法:
写完做一次自检:把简历发给一个不了解你项目的人,让他只根据简历提十个问题。答得上来的留下,答不上来的改措辞或者删掉。这一轮做完,简历就不再是经历的流水账,而是一份你能兜住的东西。