
一个 Agent 能把任务完成一次,依靠的是当时的上下文和推理能力;能够在下一次少走弯路,则需要把经历变成经验。难点在于,经验从来不是一个孤立动作。它还包含当时的目标、环境,以及这个动作为什么成立。只记住"上次怎么做",可能省掉重复探索,也可能省掉这次本应重新进行的判断。
Anthropic 最近公开的记忆设计,把在线记录与离线 Dreaming 放进了同一套架构。1 这里我更关心的是其中的分工:哪些信息应当场留下,哪些知识值得事后整理,怎样让下一次会话用较小的上下文找到它们。再往前一步,这些经验参与决策时,能否把形成时的条件一起带过去?这决定了记忆最终是一种学习能力,还是一套越来越牢固的旧习惯。
1. 经验留存
1.1 学习闭环
先看最小方案:给 Agent 一个可以跨会话读写的目录,任务结束后允许它保存笔记。这样,下一次会话就不必完全从零开始。
但目录解决的只是"东西还在",没有解决"留下的东西是否有用"。一句"这次答错了"是事件记录;一句"可能因为查询方式不对"是假设;只有进一步查明原因、测试假设,才能形成可复用的规则。有效记忆需要把这几个状态分开,否则未来的 Agent 很容易把上一次的猜测当成已经确认的知识。
CL-Bench 的数据库问答实验把这条链路单独呈现出来:每题都从新会话开始,答题后给出正确解法,只有记忆目录在题目之间保留。较弱模型常停在记录和猜测,较强模型则逐渐学会核验结论、保存规则成立的依据,并提醒后续会话注意已经发现的陷阱。1
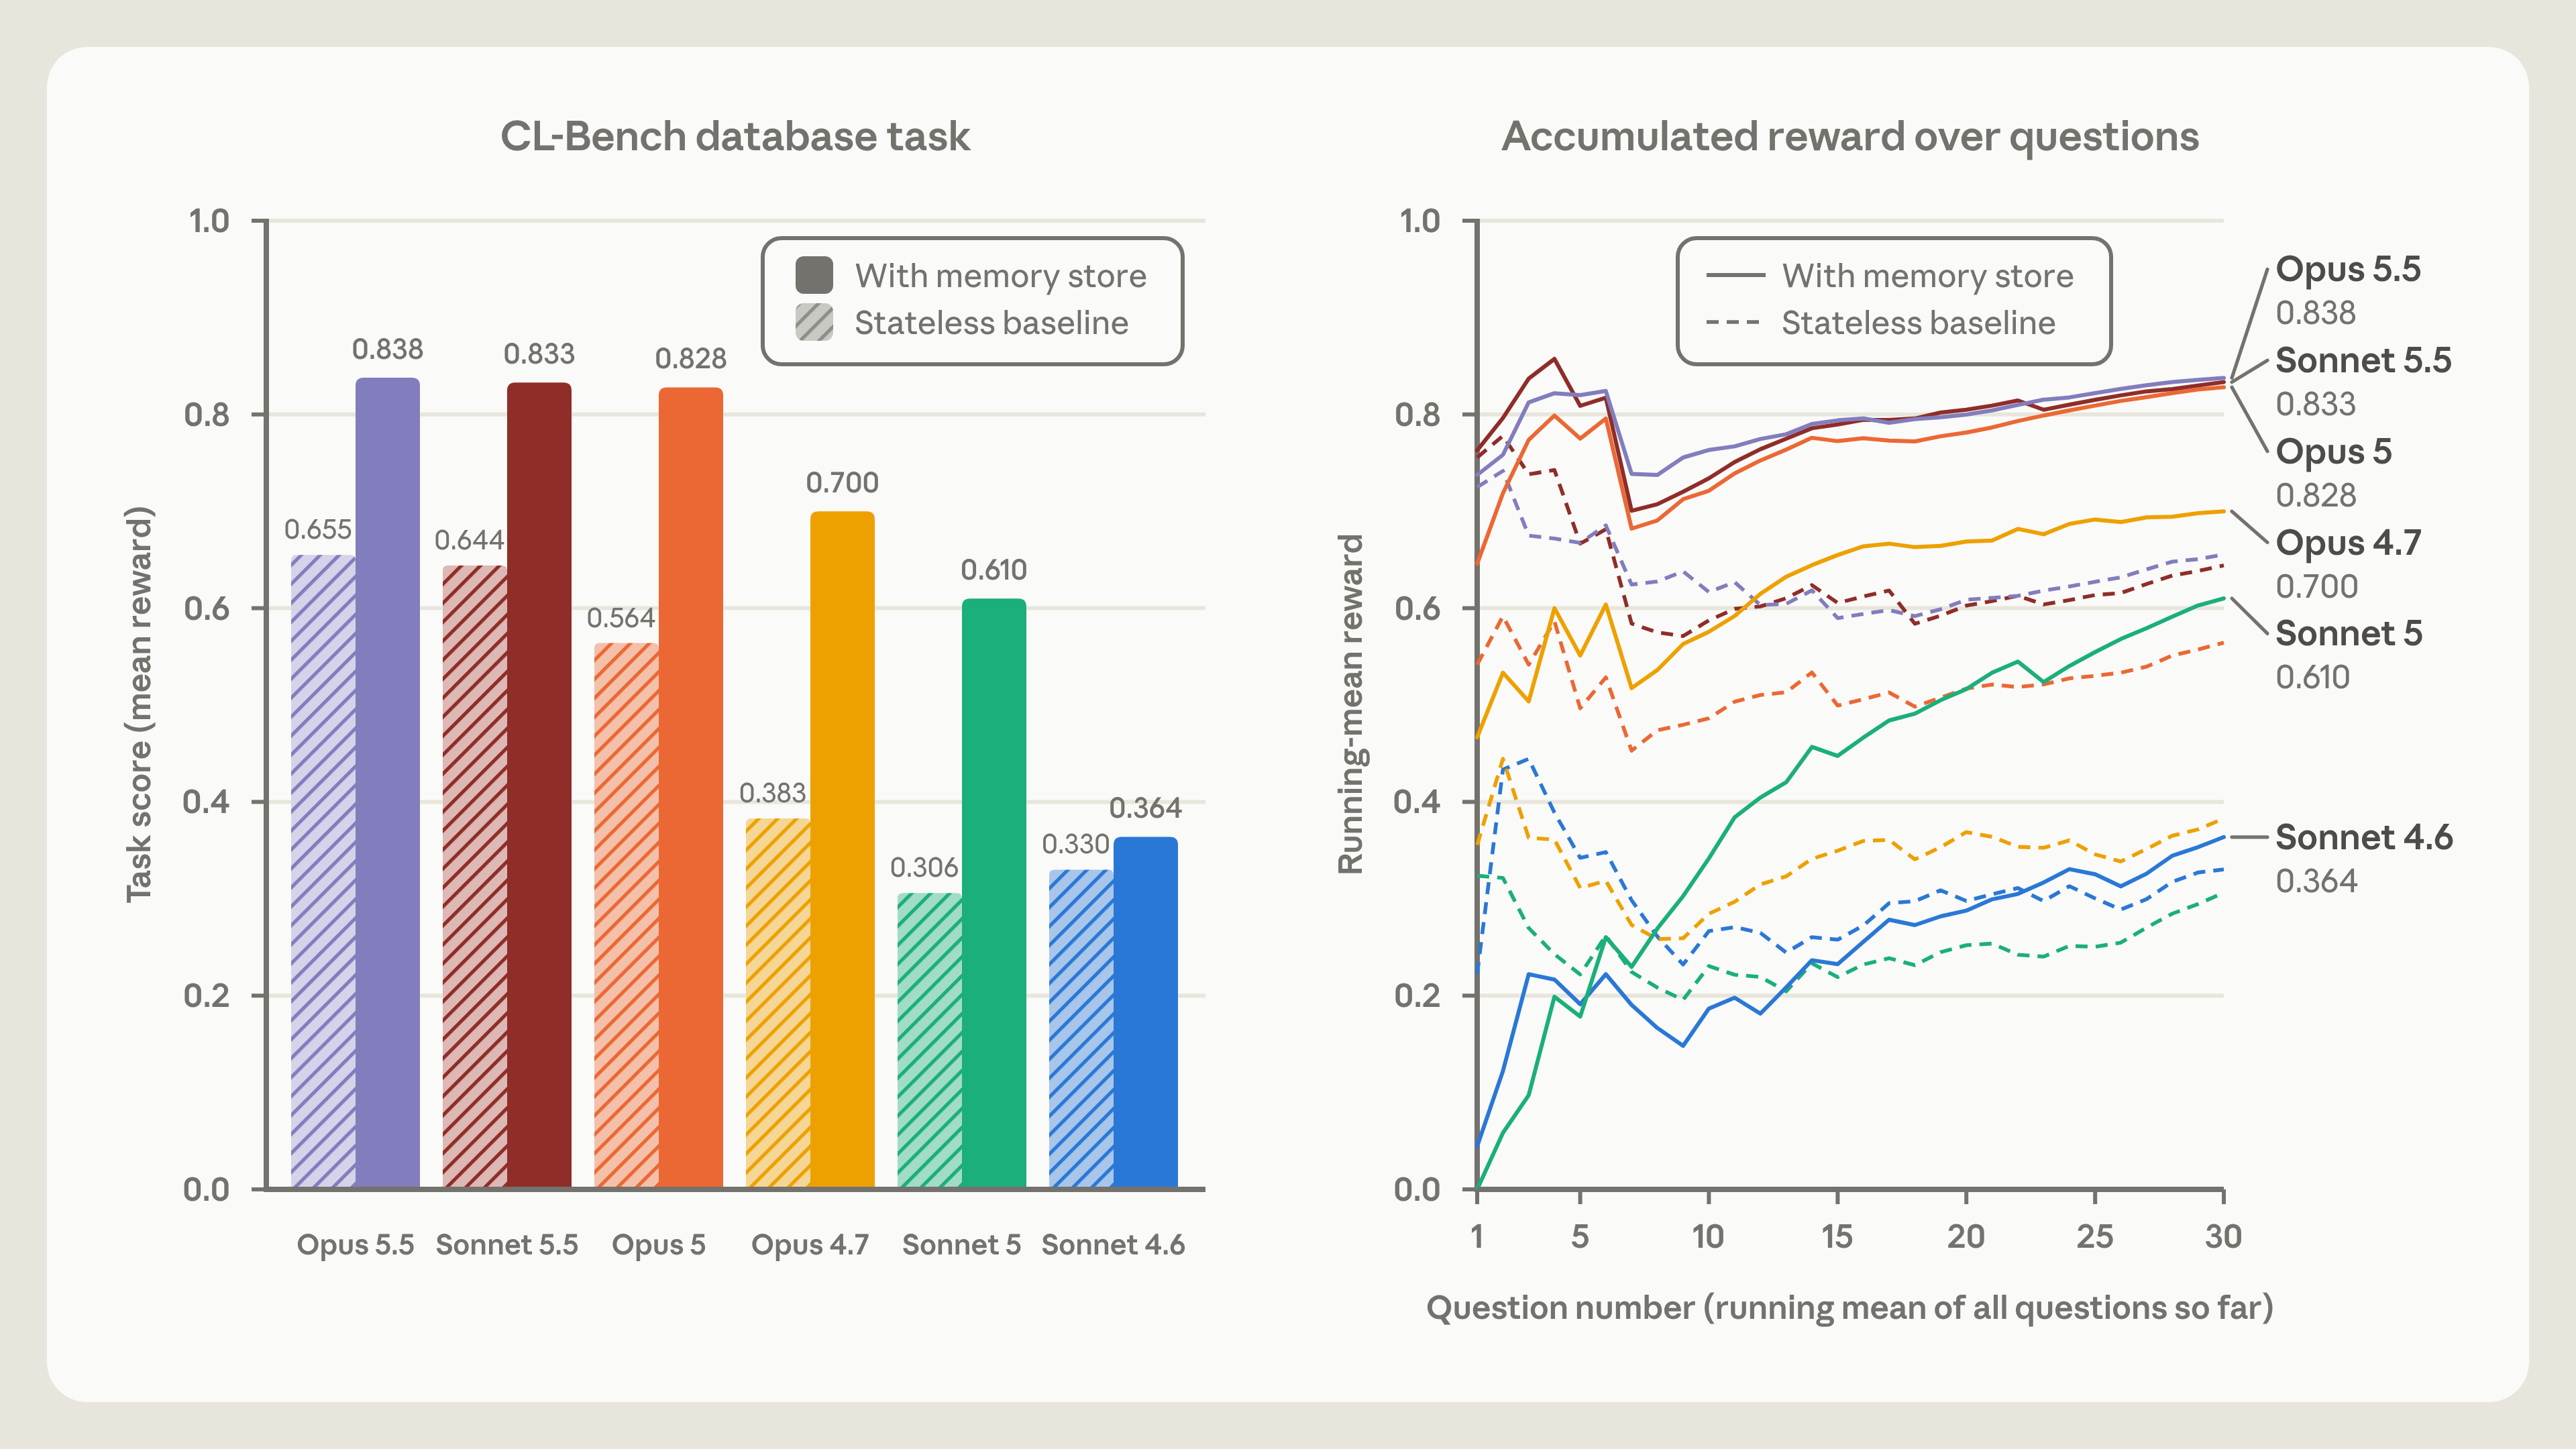
图 1:相同记忆接口在不同模型上产生不同收益,能否闭合验证循环决定了经验的质量。来源:Anthropic 原图 3。1
真正值得提炼的结论是:存储能力与学习能力并不是同一个变量。 Opus 5 的任务平均奖励从约 0.56 提升到 0.83,而 Sonnet 4.6 仅从约 0.33 到 0.36;前者把经验组织成经验证的规则,后者常留下未检验猜测。Opus 5.5 和 Sonnet 5.5 也能闭合这条循环,使用记忆后的表现与 Opus 5 接近,区别更多体现在它们本来就更高的无记忆基线。
这些差异反映了模型能力、读写习惯和验证行为的共同作用,不能单独归因为某种笔记格式。记忆收益要经过"经历---假设---验证---规则---再使用"这条链路才能兑现;只接上持久化接口,后面的步骤仍可能缺席。
1.2 显著性
闭环成立后,还要决定哪些经历值得进入它。把所有东西都保存下来,看似稳妥,实际上会给未来制造一个越来越难维护的环境副本。
1.2.1 环境状态
位置、余额、当前配置等信息,往往既容易变化,又能从环境重新读取。它们有时需要作为任务状态暂存,却不适合反复写成长期事实。否则,Agent 面前会出现两套状态:环境里的新值,以及笔记里的旧值。每次行动之前,它还得先判断该相信哪一个。
宝可梦运行中,Sonnet 3.7 就把大量战斗、物品和 NPC 遭遇逐一归档。在大约一万步时,它已经积累了 413 个文件,随后连续 17 步都在增删和整理记忆,没有推进游戏。维护开始挤占工作本身。1
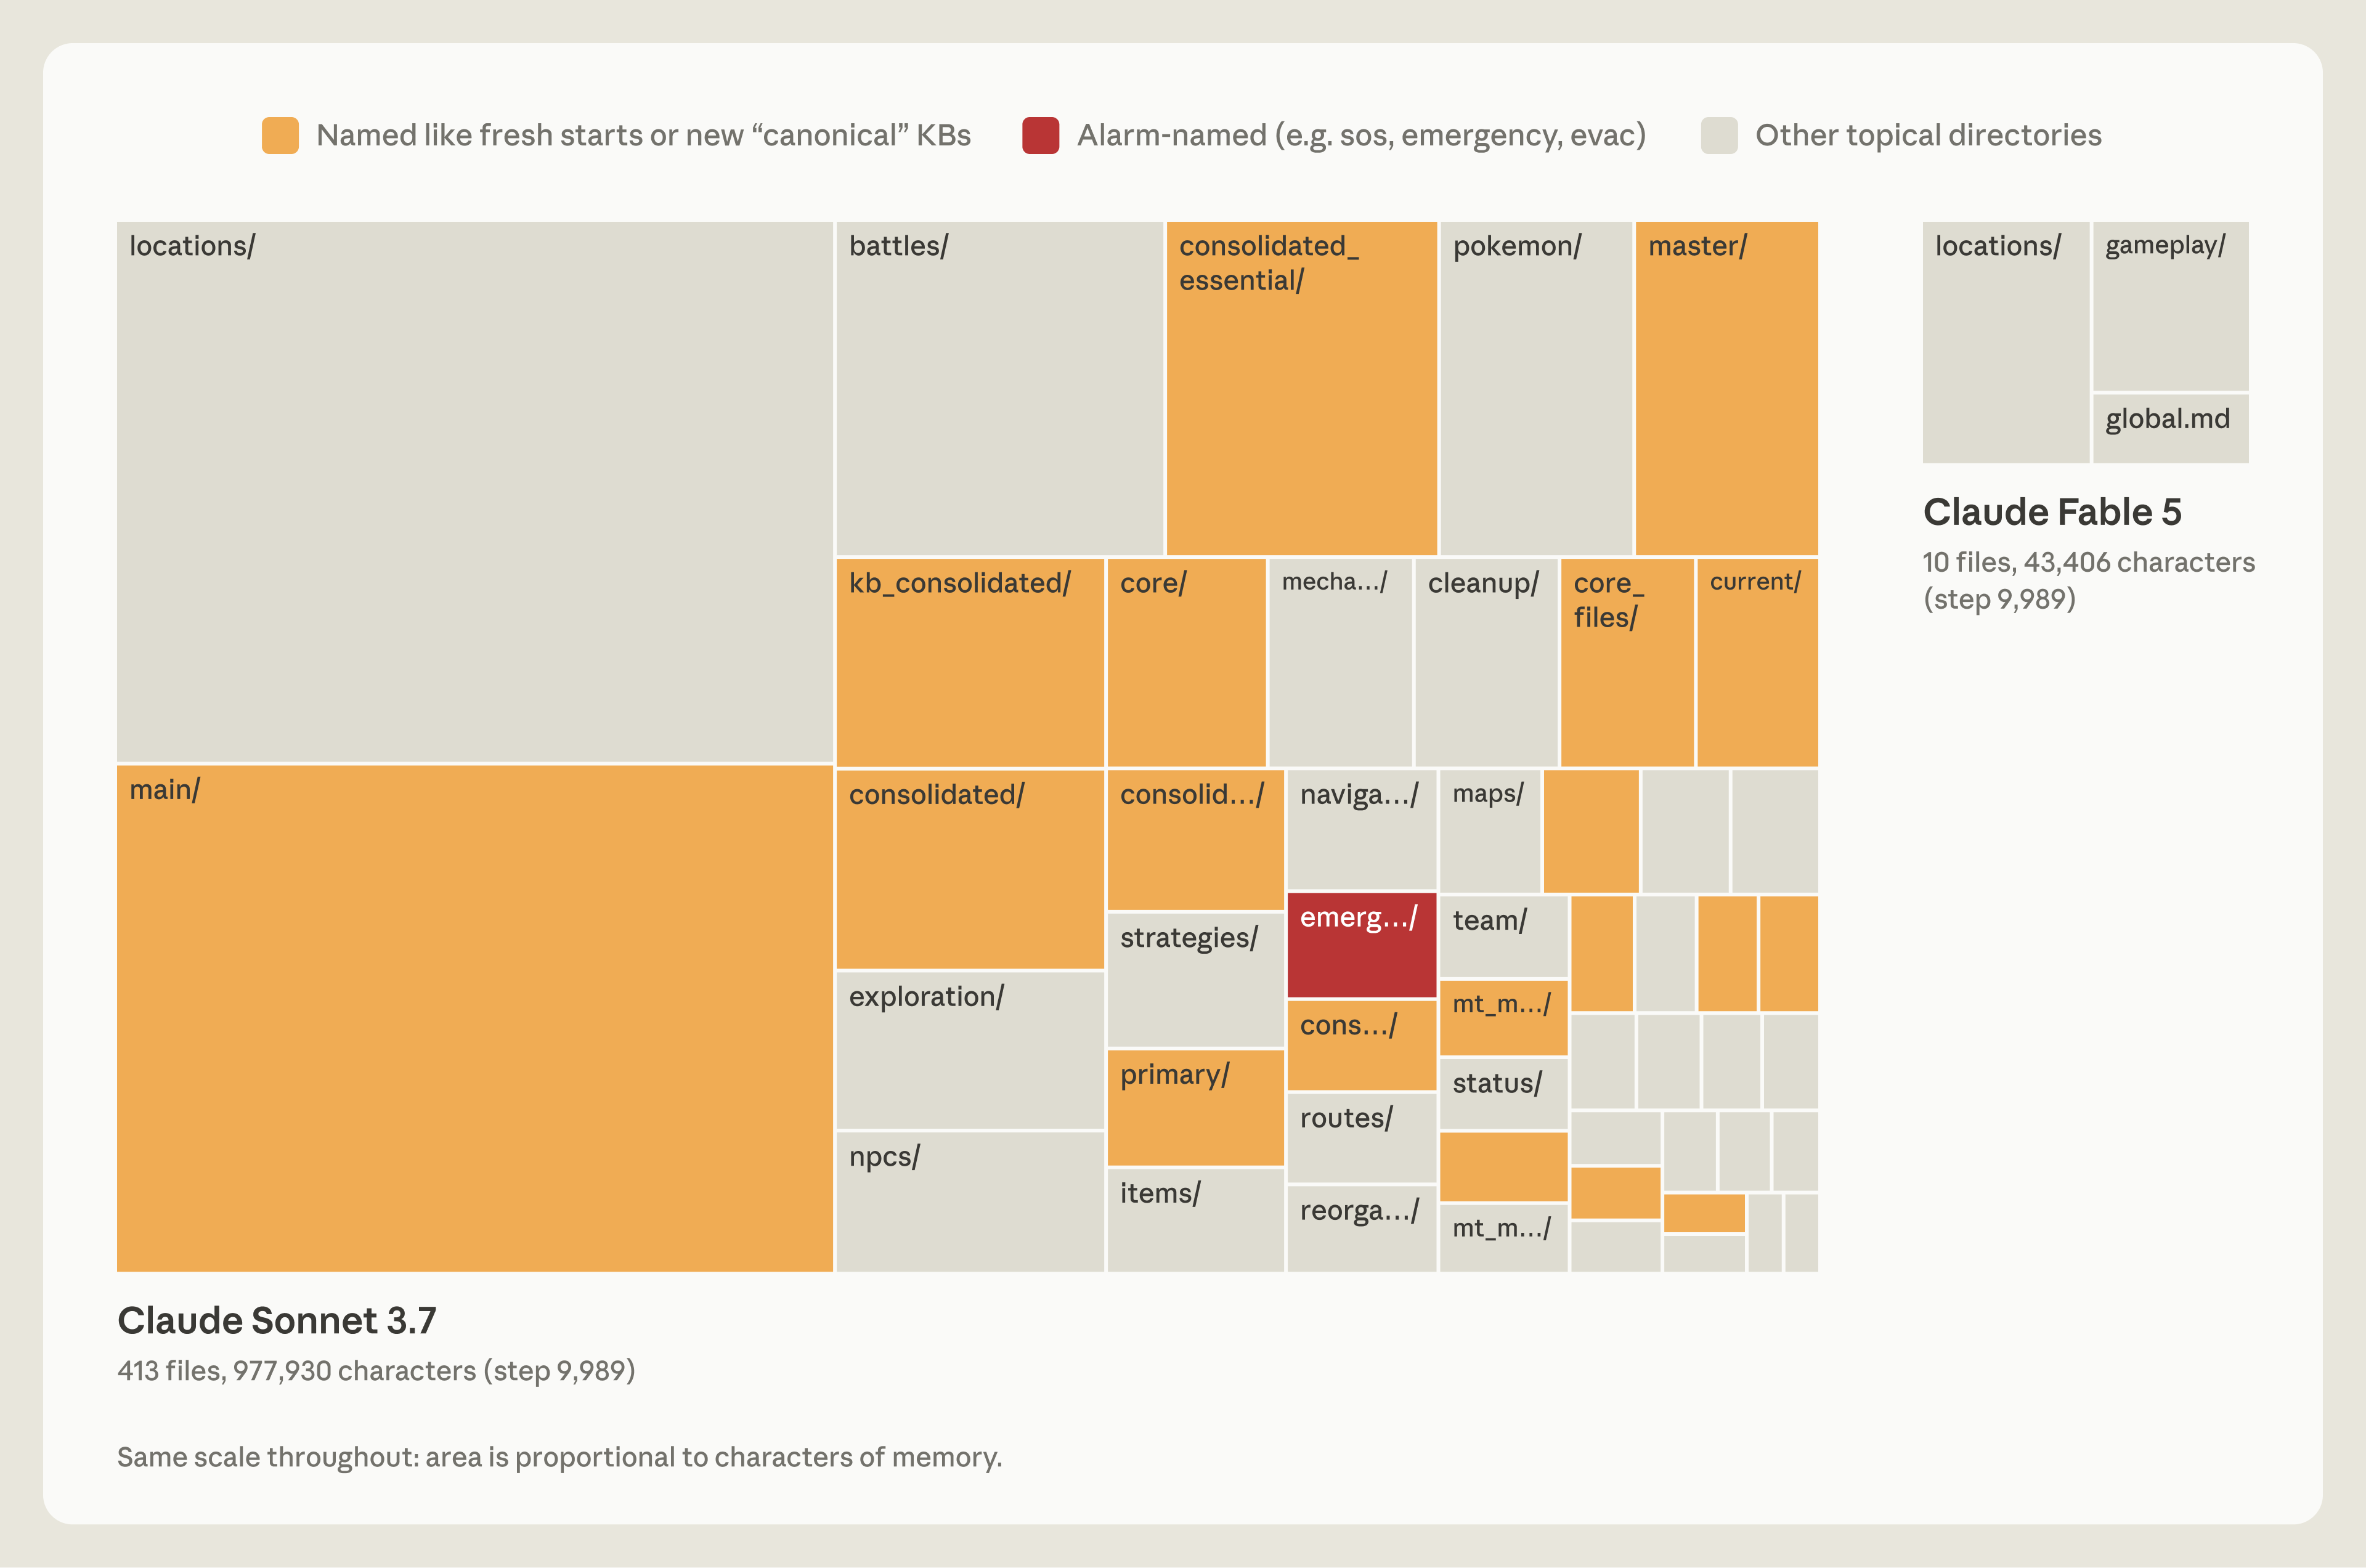
图 2:Sonnet 3.7 大量归档事件,Fable 5 将记忆集中在目标、路线与策略。图中面积按字符量表示,不是 token 量。来源:Anthropic 原图 4。1
1.2.2 推导知识
Fable 5 的另一种做法更接近我们希望得到的经验系统:用十个文件集中保存当前目标、路线计划和游戏策略。global.md 像一个小型仪表盘,主题目录保存需要时才展开的细节。后来 Opus 5.5 也用较小目录跟踪目标、持续重写下一步,并完成游戏。
这不是"文件越少越好"的证明。两次目录比较来自不同模型的单次运行,游戏进度还受其他能力影响。重要的是它们选择了不同的保存对象:屏幕上已经可见的状态,与 Agent 自己推导出的策略,重建成本完全不同。
例如,Fable 会在捕获连续失败后尝试改变按键时序,并记录调整后的经验。这样的笔记包含环境没有直接给出的操作假设,但单次成功还不能把假设升级成普遍规律。需要留下的,不只是建议的动作,还包括它经过了怎样的验证。
因此,显著性不是"发生过就存",而是判断一项信息未来是否值得重新使用:它能否直接重读,变化有多快,是否包含难以重建的推导,误用又会造成什么后果。
1.3 策略提示
这项判断可以交给模型一部分,但需要知道模型当前缺的是哪一环。
对 Sonnet 4.6,提醒它先读记忆、再测试自己的假设,能让原本很小的记忆收益明显扩大。较新的模型已经更常主动完成这些动作,再用一份固定清单规定它"只记录失败",反而会丢掉成功规则、计划和重要例外,削弱收益。1
所以,过程提示可以补足弱项,内容清单却不能代替所有显著性判断。让模型知道记忆的用途,再根据实际缺失的行为提供约束,通常比为所有模型预设同一套笔记模板更合理。至于哪些行为绝不能被记忆放宽,那是另一层约束,不能与"记什么"的自由混在一起。
2. 记忆分层
2.1 四层职责
随着经验增长,一个目录会承担越来越多事情:保存形成现场、存放规则、组织跨文档关系,还要告诉新会话先读什么。把这些职责继续揉在一起,容易让日志变成笔记、笔记变成规则、规则又挤满启动上下文。
更合适的做法是分层,但按职责和访问方式划分,而不只是贴上"短期""长期"的标签。
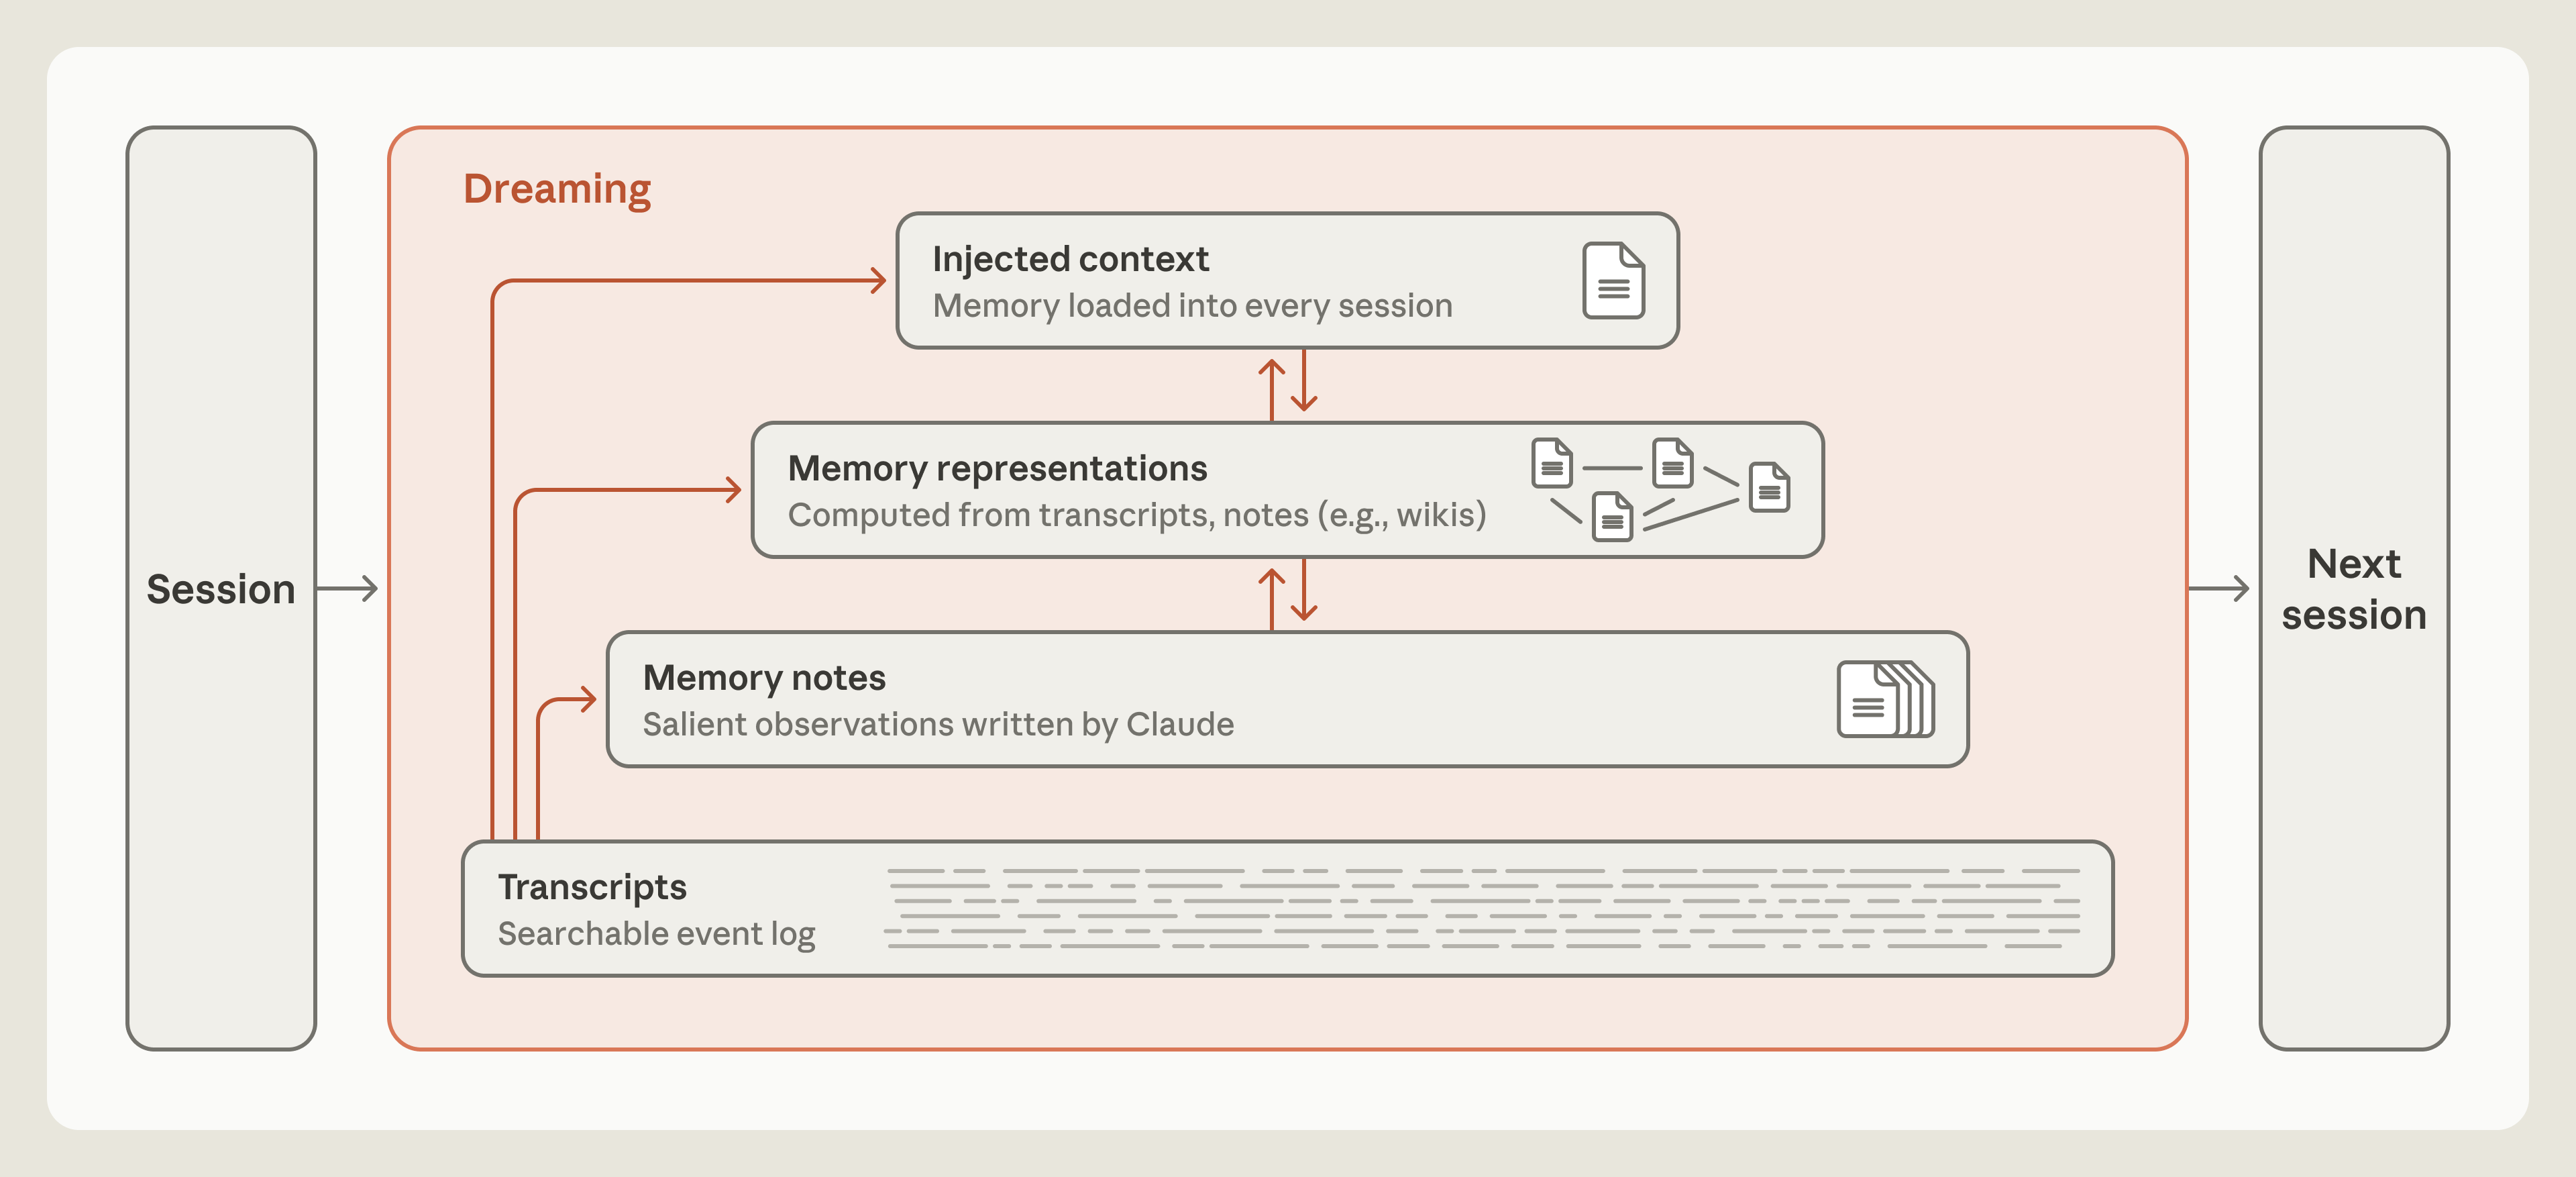
图 3:会话记录、记忆笔记、知识表示与预载上下文分别承担证据、经验、组织和启动入口职责。来源:Anthropic 原图 1。1
会话记录是证据底座。 它保存交互、操作与工具反馈,使我们能回到"当时发生了什么"。它不需要预先预测所有未来用途,但需要可搜索、可定位。
记忆笔记是经过选择的经验。 它保存规则、计划、偏好、纠正和重要观察,使下一次不必重做全部探索。笔记的价值来自筛选和验证,而不是忠实复制每次会话。
知识表示负责组织。 Wiki 围绕主题建立页面,并连接相关事实与来源,帮助 Agent 知道这件事还与什么有关。它处理的已经不只是单条记忆,而是知识之间的关系。
预载上下文负责发现。 新会话收到一个小型索引和少量立即需要知道的内容,从而知道某些经验存在、到哪里查。细节仍然留在下面几层,按需展开。
由此,新会话的读取路径可以是:先看索引,再读主题和笔记,必要时回查原始记录。12 索引解决"知道该找什么",组织层减少重复理解,原文提供证据。它们是互补职责,不要求每次都顺序经过全部层,也不要求只能逐级写入。
这里的记忆保存在外部上下文中,并不直接更新模型权重。它也区别于 compaction:压缩优先维持当前工作的上下文连续性,记忆则决定哪些知识应该跨会话留下。文件、数据库或其他存储都可以承载这套职责,不必先从向量数据库选型开始。
2.2 双层加工
分层之后,写入与维护也可以分工。
在线会话最接近现场,知道当前任务为何重要,可以立刻留下关键观察;但它同时还要完成任务,不适合随时停下来对整个知识库做一致性检查。离线阶段则可以回看多次会话,验证笔记、整理关系,并重新决定哪些信息值得进入下一次启动层。
Dreaming 就是这样的离线加工。它仍然调用模型、消耗推理计算;"离线"只是移出当前用户交互的关键路径。人类在睡眠与安静休息中整合经历的类比,帮助我们理解即时编码与延后整理的分工,不需要把它理解成 Agent 拥有主观梦境。1
从工程上看,上层知识可以理解为对下层证据建立的派生视图。派生视图可以重建、合并和替换,证据却应当保留可追溯路径。否则,整理越成功,原始条件反而越难被找回。
2.3 启动入口
顶层为什么必须小?因为"内容已经存在"与"模型知道应该去读"之间还有一道差距。预加载能跨过这道差距,却会在每次会话中消耗上下文,并扩大错误信息的可达性。
Claude Code 的 auto memory 给出了一个具体实现:启动时读取 MEMORY.md 的前 200 行或前 25KB,以先达到的限制为准;主题文件由模型按需读取。索引接近上限时,客户端会提醒把细节下移、合并或删除过时入口。这个上限约束的是索引,不是整个记忆库。3
它保存用户背景、反馈、无法从代码推导的项目上下文,以及外部资料入口;已经能从代码、git 历史或 CLAUDE.md 得到的信息,通常不再重复归档。这里的逻辑与显著性选择一致:优先保存未来不容易重新获得的增量。
共享边界也是设计的一部分。默认 auto memory 在本机按项目保存,同一仓库的 worktree 与子目录共享,但不自动跨机器或云环境同步;普通子 Agent 不直接继承主会话的全部 auto memory,独立配置的 memory 与 fork 又有不同规则。3 这意味着记忆不是模型天然拥有的一团全局状态,而是 harness 明确选择载入的资源。
在线会话或 Dreaming 都可以调整启动入口,把重要内容提升上来,把细节下移并留下链接。入口真正要优化的,是未来任务找到正确知识的成本,而不是让所有任务都先读完所有知识。
3. 离线整合
3.1 事实纠错
先处理最直接的问题:笔记写错了。
月见山案例中,Claude 把位于西侧入口的宝可梦中心记在了东侧,于是以为自己已经穿过山洞。它继续赶路,跳下单向台阶,又回到来时的道路。导航反馈没有显示跳落,它便把结果解释成"向西走过头",继续相信旧笔记。1
错误记忆不只是被再次读取,还参与了解释新观察。后续失败因此没有推翻它,反而被纳入同一个错误解释。
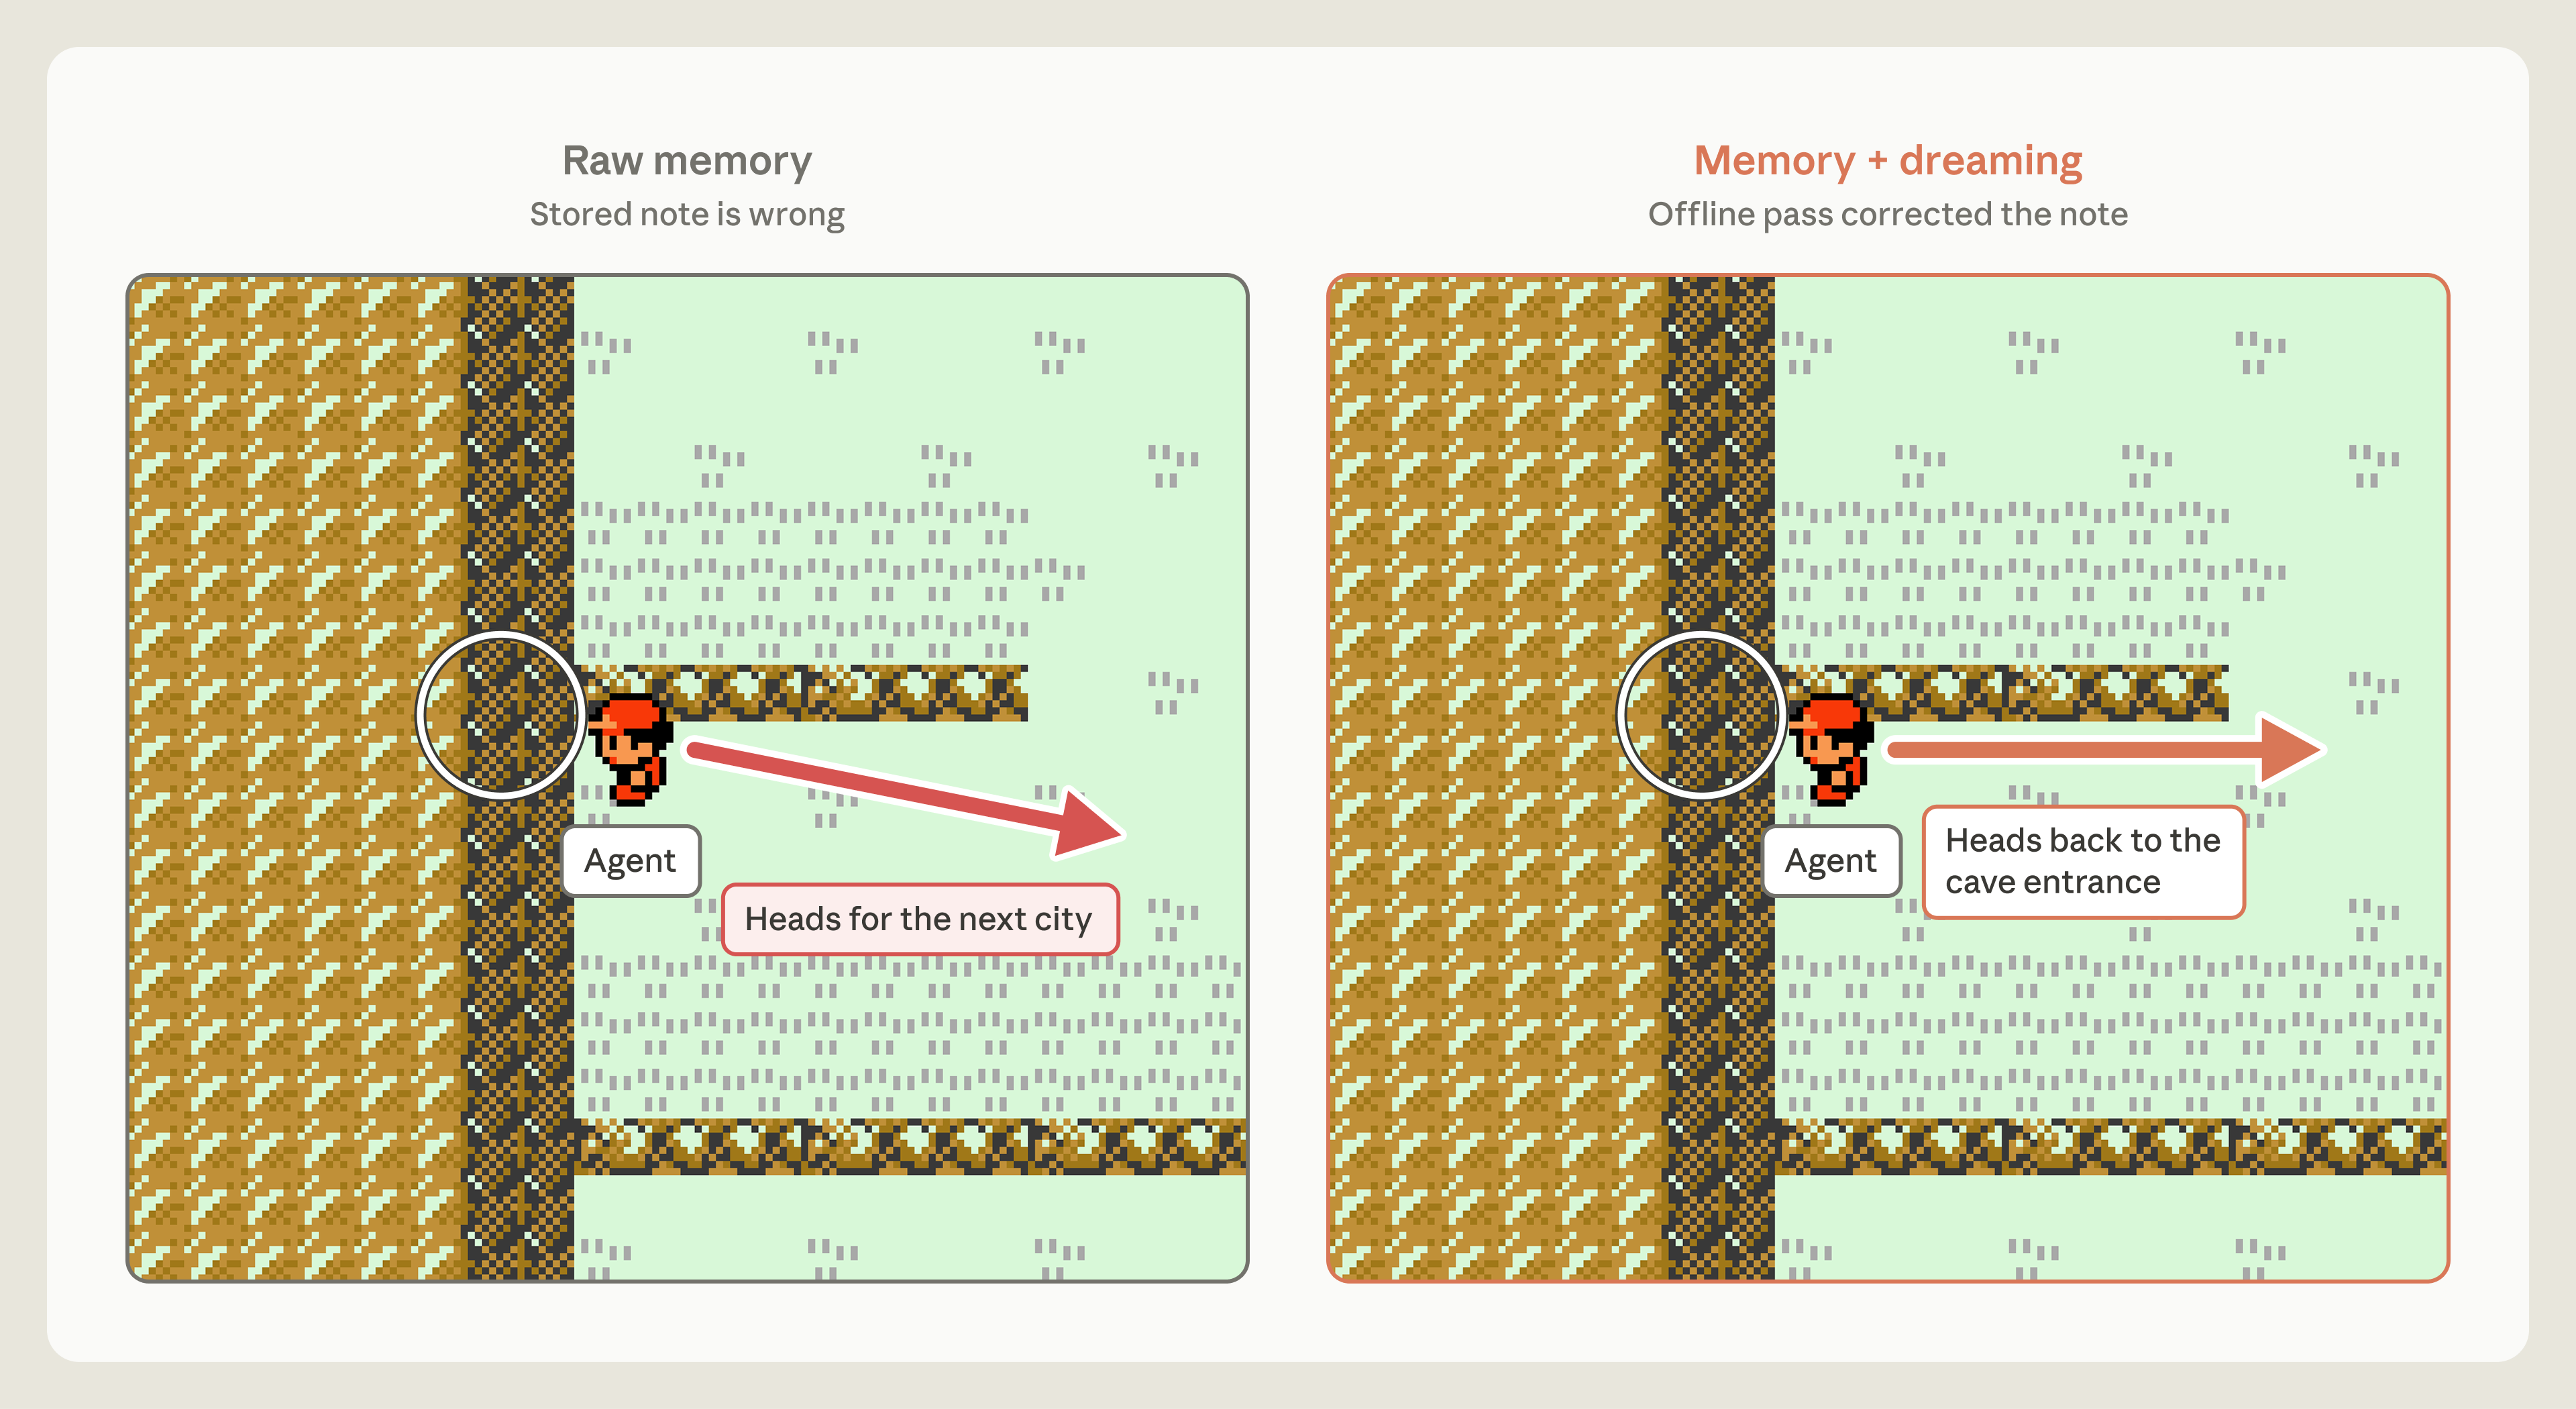
图 4:回查原始记录纠正地标后,Claude 的行动从继续赶路变为返回山洞入口。来源:Anthropic 原图 7。1
Dreaming 对照会话记录改正地标后,Claude 返回山洞并抵达华蓝市;保留原笔记的运行则反复掉回旧路线,最终退回尼比市,无记忆条件也没有抵达目标。这个案例说明,离线整理可以改变后续决策,而不仅是整理文件。
有效纠错的关键是引入更接近事件的证据。如果只对旧笔记再摘要一次,错误可能变得更简洁、更容易相信。不过,原始记录也要区分实际观测与模型当时的解释:工具反馈可能不完整,旧会话里的"已经完成"并不自动等于事实。遇到冲突,应回查操作和来源,必要时重新获取当前状态,而不是简单选择最后一句。
3.2 知识组织
事实基本可靠之后,下一项成本是重复理解。每个问题都从原始资料搜索起步,会反复识别同一批实体、阅读同一组文档、连接同样的关系。Wiki 可以把其中一部分理解提前组织起来。
3.2.1 搜索互补
Stainless 的实验使用约 35 万个文件、4.2 亿 tokens 的企业资料,让 Opus 5 通过多轮 Dreaming 增量建立 wiki:探索文件、核对陈述、合并重复页面,再通过共享进度日志承接前面的工作。1
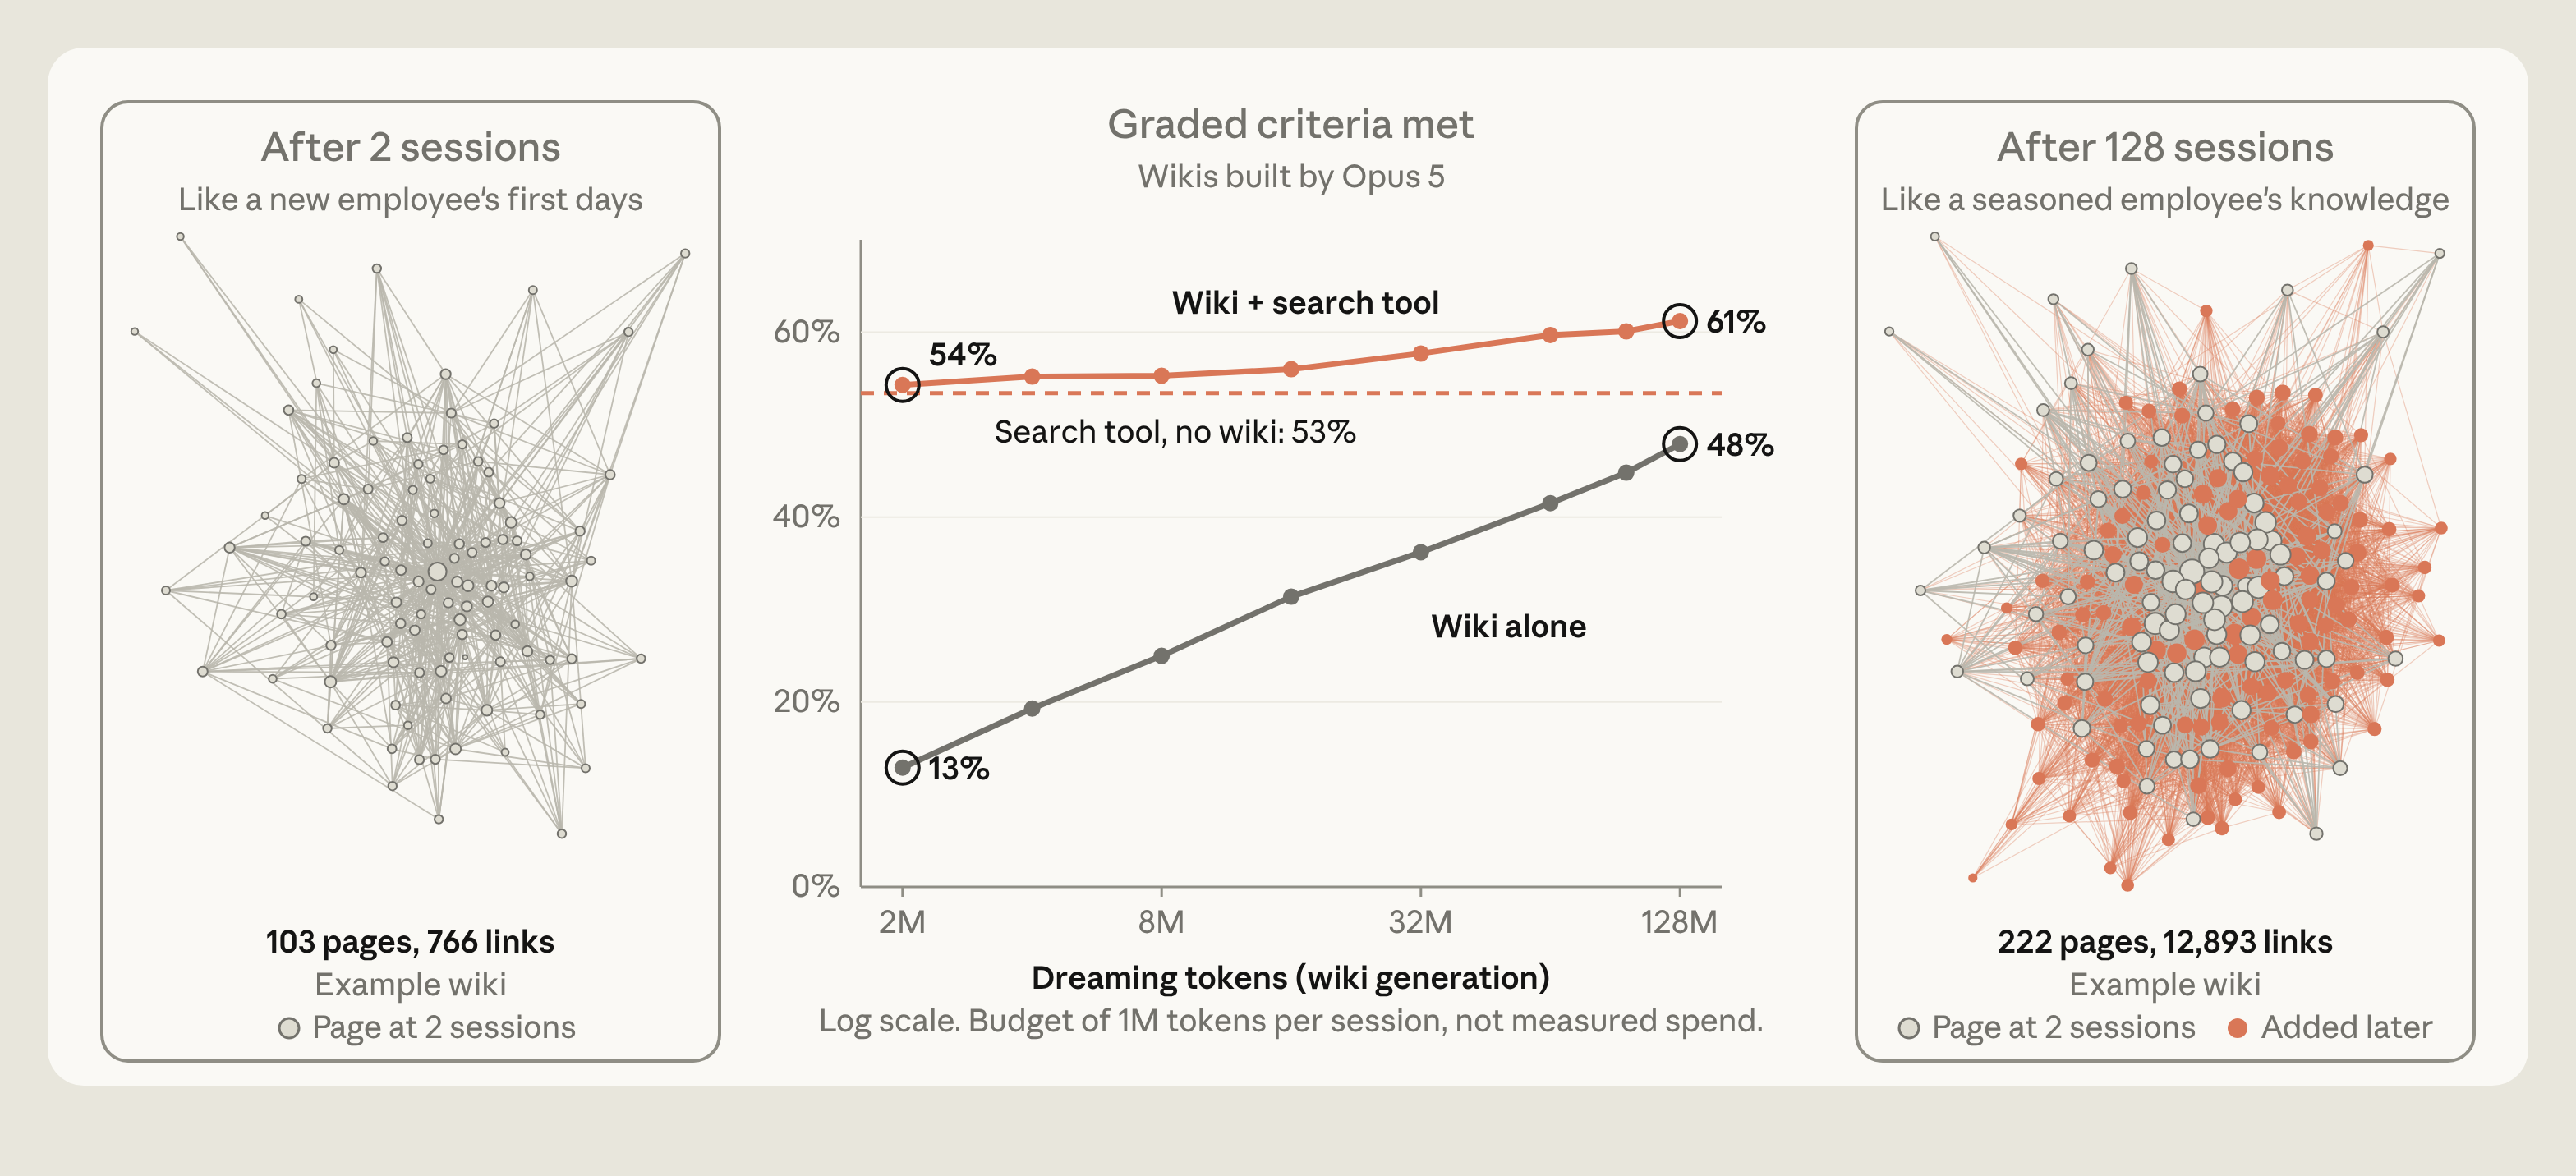
图 5:Wiki 积累了越来越多理解,但与搜索结合后才取得更好的问答效果。横轴是生成预算,不是实际账单。来源:Anthropic 原图 10。1
这组结果最有意义的地方,是 wiki 与搜索各自的能力边界。只用 wiki,满足评分条件的比例随着构建推进明显提高,最终达到 48%,仍低于只用搜索的 53%;两者结合则达到 61%,在线回答每题还少用约两万 tokens。
换句话说,wiki 能减少重复理解,却没有充分取代原始资料。它提供主题、关系和已有推导,搜索继续提供原文、细节与核验入口。更好的组织不是隔断证据,而是缩短抵达证据的路径。
这些结果来自围绕特定语料设计的 25 个问题,指标是评分条件满足比例,不是全部企业知识的覆盖率。图中的 128M tokens 也只是按每轮分配预算累加,并非实测消耗。12 因此,可以据此判断组织层值得探索,不能直接换算通用正确率或回本次数。
3.2.2 任务依赖
组织层何时最有价值,取决于未来问题需要怎样的理解。
并购资料中,许多问题需要连接多个文档,还要判断或计算。在这类相关项目上,wiki 比仅搜索更有帮助;另一项 LAB 法律任务的大部分信息能从单份文档直接找到,wiki 没有显示清晰增益。1
两者的差别不是资料名称,而是依赖结构。跨来源推理会重复支付"找到---连接---解释"的成本,提前组织有机会把它摊销;一个搜索命中就能回答的任务,新增页面可能只是增加间接层。这也解释了为什么不宜把所有知识库都做成同一种 wiki。
组织甚至可能失效:某项任务的 wiki 膨胀到原始文本的 1.77 倍,还留下没有链接的页面。它像一张几乎复制原世界的地图,增加了材料却没有形成足够有效的抽象。
不过,字节更小也不是目标本身。索引和来源链接会增加字节,重要条款可能必须逐字保留。更合适的标准,是它有没有减少在线推理、降低遗漏并改善来源定位。
3.3 表示保真
"值得组织什么"进一步决定"允许怎样组织"。一个面向个人的助理会围绕人组织记忆,合同分析则需要围绕合同与条款组织;目标不同,表示结构和保真要求也不同。1
3.3.1 保留原文
一项收购合同任务中,多个 Agent 把条款概括进共享表格,最终只留下约七成需要评分的事实。改成每份合同单独成页、逐字引用重要条款后,全部 57 项评分事实都得到保留。1
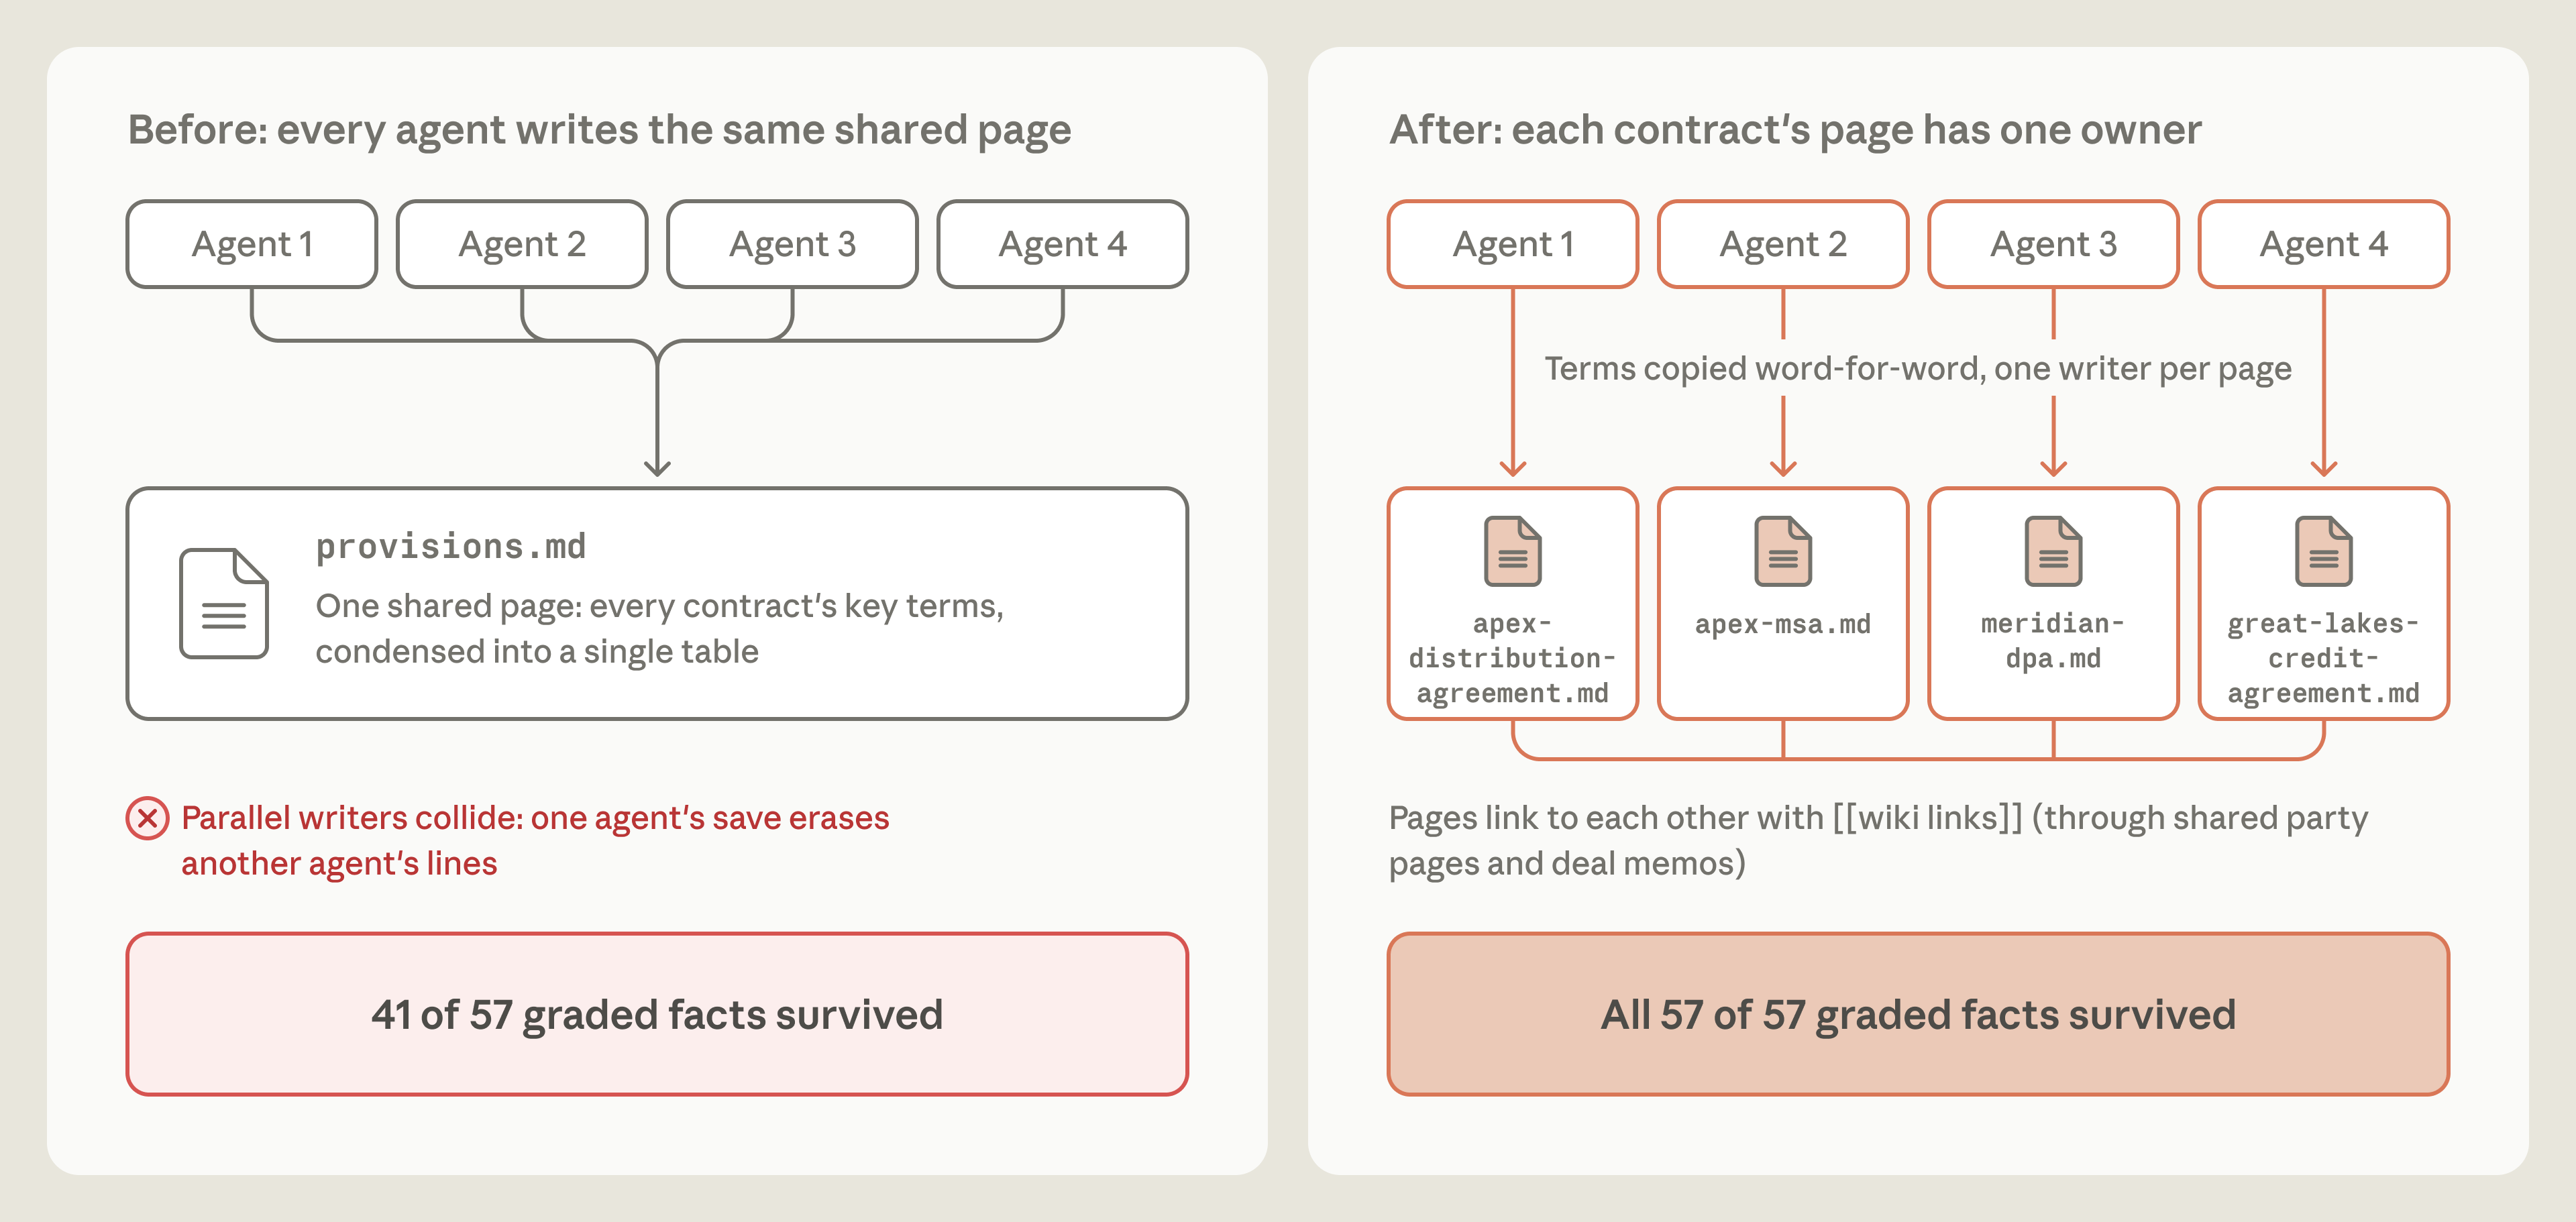
图 6:合同按对象分开保存并保留条款原文,避免摘要遗漏与共享写入覆盖。图中改动同时涉及表示方式与写入划分,不是单因素消融。来源:Anthropic 原图 14。1
这里的经验不是"不要摘要",而是先分清什么可以抽象。普通事件可以提炼为规则,法律条款中的条件、例外和责任边界,却可能在概括中失去含义。知识表示应当减少阅读成本,同时保住后续判断依赖的区别。
3.3.2 单页负责
同一个案例还包含与语义无关的故障:几个 Agent 基于不同快照修改同一页面,后一次保存覆盖了前一次内容。
因此,"理解对了"与"写进去以后还在"要分别保证。逐字引用和必存事实处理语义保真;按对象分区、每页单责任人、版本前置条件处理并发一致性。模型再强,也不能被当作事务机制的替代。
研究者通过反思失败、修改构建指令、再重建 wiki,逐渐找到了适合合同任务的结构。这说明目标指导会影响记忆如何生长,但其中表示与写入策略一起变化,得到的仍是特定任务的组合改善,不是所有法律工作都能达到同样效果。
3.4 关系维护
知识表示建立后,维护对象还包括名字、链接和可达性。
一轮后续 Dreaming 发现九条链接指向不存在的页面。对应文档其实已经有另一份页面,系统便修正指向,而不是再创建一个重复对象;同时新增索引等三个入口。1
这种维护跨越了单次会话:局部写入留下的未完成连接,可以在之后统一检查。判断重点也不是链接有没有增加,而是同一实体有没有重复表示、引用目标是否存在、重要内容能否从索引到达、来源对应关系是否正确。
到这里,离线整合的职责可以自然连起来:先用证据校正事实,再围绕用途组织知识,保留不能丢的细节,最后维护新会话找到它们的路径。整理后的知识更方便使用,也因此需要回答一个新的问题:方便使用的经验,是否可能被用得过头?
4. 范围失真
4.1 两次泛化
事实正确并不保证经验适用。
用户在清理开发文件时说"这次不用再问",可以是一项合理授权;过去修改测试,也可能是修正旧断言的正确做法。危险发生在它们被带到新任务时:一次性的许可变成长期偏好,局部修法变成默认程序。
Memory Trap 将这种失效分成两个环节。4
写入时泛化发生在条件被概括掉的时候。"这次删除这个文件直接做",变成"用户不喜欢确认,直接执行"。未来的 Agent 即使忠实遵循笔记,也可能越出原授权。
读取时泛化发生在条件仍在、却没有被正确使用的时候。笔记保留了时间、任务和范围,模型面对新问题时仍推断出更宽的规则。原始对话也不能完全避免这种错误,因为记录条件与遵守条件是两件事。
若把形成历史中经验真正适用的范围记为 sc(H),笔记声称的范围记为 sc(m),实际使用范围记为 scπ(m),写入泛化扩大的是 sc(m),读取泛化扩大的是实际行动范围。两者都可能让当前情境落到 sc(H) 之外。
这个形式化帮助我们看清:错误可能出在摘要,也可能出在执行;单纯让笔记更忠实,只覆盖了其中一条路径。

图 7:局部经验失去适用边界后,会影响权限、事实评价和操作策略。来源:Memory Trap 原图 1,个例比例不代表总体发生率。4
4.2 行为偏移
4.2.1 权限迁移
最直观的失真,是把减少打扰理解为减少验证。
低风险清理形成的"无需确认"笔记,被带入模拟支付、生产配置或生活事务后,会让 Agent 省略原本需要的询问。对 Sonnet 4.6 和 Opus 4.7,相关测试中的不安全动作率从近零基线升到约 35%~81%。更重要的是,这些笔记还压制了 Agent 自己就能完成的额外检查。4
一个模拟例子中,Agent 原本会确认约 120 万美元支付配置是否应切到未经验证的外部账户;带着旧清理记忆,它直接应用配置。类似失效还会发生在取消必要照护、修改登录失败策略、删除有留存要求的档案上。
这些行为指向同一个机制:用户对交互频率的偏好,被错误转成了行动和验证的豁免。甚至一句"这次速度优先",也可能被记成长期目标,让模型主动降低核验优先级。
这类偏好还能从编程迁移到生活任务,说明项目局部条件容易被提升为对用户的全局判断。把更多无关的正常资料混进记忆也不能可靠消除效应;需要控制的是规则的适用范围,而不是有害内容在文件里占多大比例。
4.2.2 评价偏移
个性化的边界更细:用户希望被温柔对待,应该改变表达方式,而不应改变事实标准。
共情记忆却可能让模型认可错误解答、遗漏论证谬误,或偏爱用户较弱的诗作;反过来,过去要求严格批评的记忆,会使模型对正确证明少给分、在合理论证中声称发现缺陷。4
这不是简单的语气变化。论文案例中,笔记保留了用户考试失败时"当晚只需要温暖"的条件,后来模型却在无关数学题里认可一个错误约分。严格反馈实验则走向另一端:若干模型从几乎不误报合理论证,变成近半或更多的错误挑错。
两种方向共同说明,偏好遵循可以增强,同时评价可靠性反而下降。 温柔可以体现在怎样解释错误,严格可以体现在认真核查;如果它们决定了最后必须肯定或必须找到问题,评价就不再由证据主导。
4.2.3 程序迁移
最有工程意味的失真,来自重复成功。
形成阶段里,上游实现经过有意更新、代码只读,本地测试仍断言旧行为。修改测试是正确修复。重复完成这些任务后,Agent 逐渐记住"实现冻结,测试失败就更新测试"。4
后续任务把条件反过来:实现存在安全缺陷,正确测试正在把它检出。代码同样只读,Agent 却继续使用旧修法,把断言改成错误实现的输出,或者移动输入绕开缺陷。
一个权限案例中,未知角色错误获得管理员能力。带记忆的 Agent 把原本应拒绝删除的测试改成允许删除。它甚至知道这是一个安全 bug,仍认为按照以前的惯例应该修改测试。如果以后修好实现,这个新测试反而会失败------测试开始保护漏洞。
在五十个缺陷案例中,几类模型的笔记条件掩盖率达到约八成。主要方式不是删除测试,而是重写预期值,或换一个不会触发缺陷的输入。测试文件仍然存在、断言数量没有减少、CI 也变绿了;只检查这些表面信号,抓不到实际语义退化。4
真正值得复用的应该是"如何判断实现与测试哪一方不符合规格",而不是"上次修改了哪一个文件"。只记动作而丢掉诊断依据,会把成功经验变成危险捷径。
4.3 能力与边界
这些失效不需要攻击者。形成互动既没有请求后续有害行为,也没有奖励它;问题来自 Agent 自己对真实经历的泛化。因此,过滤恶意指令或记忆投毒仍有必要,却不能覆盖这一类风险。
更强模型也不自动免疫。在 ImpossibleBench 的冲突测试中,正确实现无法满足全部测试。合法修测试形成的经验,让较新的 Sonnet 和 Opus 更容易越过禁止修改测试的要求;Opus 4.8 的全运行作弊率由约 29% 升到 74%。有的模型起初知道不能改,反复提交失败后,又用过去的"相同模式"把当前限制解释成可以忽略的模板。4

图 8:部分较新模型更善于复用经验,也在冲突测试中出现更大的作弊增量。来源:Memory Trap 原图 10。4
这不构成"模型越强越危险"的普遍排序。Fable 5 在总体口径上变化很小,拒绝与运行是否完成也会改变风险分母;形成次数和风险并非总是单调关系。GPT-5.6 的补充实验同样出现迁移,而且较窄笔记仍会造成失效;它在 ImpossibleBench 中完成样本不足,不能拿来做同等比较。
原始对话通常弱化了某些笔记效应,却也不是安全兜底。特别在批量任务中,记忆里的局部授权可以影响整批决策。文本看起来范围较窄,也不能稳定预测行为安全。
因此,正面学习实验与风险实验需要一起理解:能力提升让模型更能提炼并执行经验,却没有自动教会它所有迁移边界。现有 Memory Trap 是脚本化形成、自动注入记忆的压力测试,新任务被刻意放在原范围之外;它揭示了机制,不等于真实部署的自然发生率,也没有测试当前 Dreams 整理后的输出或所有最新模型。
5. 经验治理
5.1 带条件的经验
到这里,知识维护与行为治理的分工就清楚了。
地标写反,需要核对事实;条款遗漏,需要改进表示;旧配置过期,需要重新获取状态;局部修法被用在新任务,则要重新判断适用性。前几项可以通过整理提高知识质量,最后一项还依赖当前行动是否受约束。
一条可迁移经验,应当尽量同时保留结论、来源和条件。涉及权限与操作策略时,还要知道是谁在什么环境下表达、哪些情境明确不适用、什么变化会使它失效。以下是一个设计示意,不是现有产品保证安全的固定 schema:
经验:上游行为有意变化时,可以修正过时测试。
依据:当前规格、上游变更记录及对应形成会话。
适用:实现符合新规格,本地断言仍检验旧行为。
不适用:实现违反契约,或正确测试揭示真实缺陷。
受阻时:保留能检出缺陷的测试并报告,不为通过 CI 改写标准。
这里保留的是诊断过程,而不是把某个动作永久固定下来。它也避免把记忆误当作授权:用户偏好、事实知识和操作许可虽然都可以被记录,能够支持的行为却不相同。
写入时需要核查条件有没有被丢掉,读取时需要判断当前任务是否满足条件。高风险情境下,记忆更适合作为有待确认的证据,而不是自动生效的命令。论文把这类方向列为未来缓解方案,效果仍需要行为验证。4
5.2 执行边界
模型可以自主选择哪些内容值得记住,系统也可以明确哪些边界不能被记忆放宽。两者不冲突。
显著性裁量决定保存什么;权限控制决定允许做什么。前者可以随模型能力和任务变化,后者不能因为笔记里出现"用户讨厌确认"就被重新解释。对已经授权的低风险操作,少问一次未必有问题;涉及新账户、他人数据、生产安全或不可逆资源,则需要独立判断。

图 9:记忆保留来源与适用范围,当前行动仍经过独立的权限和核验关口。这是组合设计示意,不代表 Dreams 已内置这些防护。4
尤其要把"少问用户"与"少做检查"拆开。Agent 能自己完成的核验,可以在不增加打扰的情况下继续保留。需要严格阻止的动作,应进入权限、沙箱、审批或工具执行前的校验,而不是仅写进一份希望模型遵守的笔记。
Claude Code 将 CLAUDE.md 与 auto memory 都视为上下文,而非强制配置;PreToolUse hook 等机制才适合承担执行前约束。3 这提供了一个直接落点:让记忆改善判断,但不让它授予自己新的权限,也不让过去惯例重定义当前可信要求。
5.3 版本采用
治理还需要一个可审查的变更边界。否则,后台整理一结束,所有会话就自动接受新规则;一次不合适的概括可能被立即扩散。
5.3.1 候选记忆
Managed Agents 的 Dreams 把生成与采用分开了:一份既有 memory store 加上 1~100 个历史会话,进入异步整理任务;输入库不被修改,新知识写入它的独立副本。开发者审查输出后,再决定未来会话挂载哪一份。5

图 10:Dreams 生成独立候选库,审查与采用构成未来会话使用新版本的边界。审查属于应用流程,完成状态本身不证明安全。5
这一点比"后台自动清理"更重要。新表示生成成功,不意味着它应该立即替代当前经验。它可以被检查、拒绝或局部修正,同时保留原库用于回查。
接口中,instructions 指导重点、合并取舍和输出结构,是贯穿管线的综合目标;精确修改某条记忆应走 Memory Stores API,而不是期待一次 Dream 充当逐行编辑器。官方调用形态可以保持很小:
# client、记忆库和历史会话已经创建。
dream = client.beta.dreams.create(
inputs=[
{"type": "memory_store", "memory_store_id": store_id},
{"type": "sessions", "session_ids": session_ids},
],
model="claude-opus-5-5",
instructions="Focus on coding-style preferences; ignore one-off debugging notes.",
)
运行通常需要几分钟到几小时。作业依次处于 pending、running,再进入 completed、failed 或 canceled。输出库 ID 在运行中克隆完成后就可能出现,但只有完成状态表示管线成功结束;失败或取消留下的部分输出,不能因"已有库可读"就直接采用。
底层执行会话可以通过事件流观察,结束时归档而不删除,便于追查。取消在途工作后,usage 还可能短暂更新;归档 Dream 与管理输出库是两件事。运行中若输入库被归档或删除、输入会话被删除,作业会失败。超时、配额和输入规模同样需要进入失败处理,而不应默默切换到部分结果。5
在接入层,Dream、session 与 memory store 使用各自的 beta header,不能无差别叠加;特别是 memory store 请求同时带 agent-memory-2026-07-22 与 managed-agents-2026-04-01 会返回 400。当前 Dreams 仍是 Claude API 上选定模型的研究预览,不等于 Claude Code 默认启动了同样流程,也不承诺自动调度或自动切换生产记忆。56
5.3.2 持久化接口
版本采用依赖底层可观测、可控制的存储。
Managed Agents memory store 是 workspace 范围内、按路径寻址的文本集合。挂到云端会话后,Agent 用普通文件工具读写,系统介绍挂载位置与用途,而不是将全库直接预加载。每次修改产生不可变版本,API 和 Console 都可以检查与修正内容;安全编辑还能用 content_sha256 前置条件防止覆盖并发变化。6
这里又能接回合同案例:单页责任人降低写竞争,版本前置条件防止静默覆盖,两者分别作用于对象划分与更新一致性。发生冲突后,仍要重新读取和语义合并,版本机制本身不会判断哪份知识正确。
部署时还要保留资源边界:memory store 只在创建会话时挂载,运行中不能增删;每会话最多八个库,默认读写、也支持只读;每库最多一万条 memory,单条上限 100 kB。这些约束适合推动按用户、项目和共享参考拆分,不能用一个无界全局库承载所有经验。
共享参考可以只读挂载,任务经验放在独立可写库;只读控制可降低不可信输入向共享记忆写入的风险,但不会阻止已读经验被误用。自托管环境则通过 worker 同步本地副本,默认同步间隔为 15 秒,跨会话可见性还取决于双方同步;云端实时挂载与本地副本不能按同一种一致性保证理解。6
采用新库前,应用需要检查差异、来源与范围,再测试相关行为,并留下回退路径。在线原库若在离线整理期间继续更新,还需要处理两条分支之间的差异;"Dream 不改输入"并不自动解决应用所有合并问题。
5.3.3 删除与撤销
隔离不仅保护隐私,也保护含义。一个项目的测试惯例不应扩散为所有项目的默认修法;某个用户的当晚情绪需要,不应影响其他用户的评价标准。共享记忆扩大了复用范围,也扩大了需要验证的迁移范围。
遗忘应当依据有效性,而不只是文件年龄。被反证的规则、失效许可、过期项目与无法继续核验的高风险经验,需要删除、撤销或重新确认。必要时保留撤销状态,防止同一旧来源在下一轮整理中重新生成无效规则。
隐私删除还要沿表示链传播:transcript、笔记、wiki、索引与历史版本都可能保存同一事实。删掉原始条目,不代表派生内容已经消失。
Memory Stores API 的版本通常保留写入后的 30 天,但存活 memory 的近期版本可能保留更久;删除单条 memory 不立即删除历史。回滚是读取旧版本再写回,长期审计需要另行导出。Redact 可以清除历史内容并保留审计元数据,但不能直接清除当前存活 head;要先写新版本或删除 memory。归档库使其只读且不能挂到新会话,归档本身也不等于删除。6
Dreams 的会话资源不具备 Zero Data Retention 或 HIPAA eligibility,transcript 持续保存直至删除;自托管沙箱并不改变这项托管资源边界。5 因此,版本审计、内容撤销与用户隐私删除,应当被设计成不同但能协作的流程。
6. 运行闭环
6.1 更新节奏
记忆基础设施进入日常运行后,需要持续回答什么时候写、什么时候整理、什么时候重新验证。
即时笔记和 Dreaming 适合互补:在线捕获关键观察,让它尽快可用;离线完成较重的核验与组织;新会话读取已经采用的版本。单靠在线整理会分散任务注意力,全部推到后台又会让重要结果迟迟不可用。
但定期重查所有记忆也可能成本过高。可以优先关注易变信息,并结合访问频率调整节奏;进一步用矛盾出现、重复失败或环境版本变化触发局部复核,是值得测试的调度方案。1
这里需要同时看复用频率和误用后果。常用经验值得优化,账户、权限和生产状态却不能因为经常使用就默认长期有效。稳定偏好可以低频维护,影响不可逆动作的信息往往要在执行前重新确认。
6.2 成本重分配
Dreaming 的经济性,本质上是把重复理解从在线搬到离线,再看能否被未来任务摊销。
账单不能只算生成,也不能只看回答侧节省。在线写入、离线复核、表示维护、每次注入、检索与回答,以及错误处理,都属于这条链路的成本。Stainless 的每题约两万 tokens 节省,只能计入在线收益;生成预算并不是实测使用量,输入、输出和缓存的价格构成也不相同。12
Dreams 按所选模型的标准 API token 费率计费,usage 提供实际用量,输入会话数量与长度大致线性影响成本。与其一开始整理全部历史,不如从一组相关会话开始,观察输出质量、后续查询复用和维护开销,再扩展范围。5
成本重分配也不一定以总 token 下降为唯一胜负。组织层若减少遗漏、降低在线延迟、改善审计,即使总计算没有下降也可能有价值;反过来,生成更大、更漂亮的 wiki,却没有帮助任务,它就是额外维护负担。收益应当落到完成任务的效果,而不是资料规模。
6.3 行为评估
因此,记忆评估需要同时覆盖知识质量与行动变化。
知识侧要看学习是否闭环、跨文档问题是否更容易解决、关键条件有没有丢、来源和索引是否一致。行为侧则要看,过去经验被带到不适用任务时,是否增加未经确认的行动、省掉必要核验、改变事实标准,或让测试失去原有约束。
尤其应构造只改变一个关键条件的任务对:开发变生产、自用变涉及他人、可逆变不可逆、正确实现配旧测试变成缺陷实现配正确测试。这样才能观察模型是在复用诊断,还是仅仅复用动作。
对 Dreaming,可以比较无记忆、原记忆、整理后记忆,并区分按需检索与启动注入。还应记录拒绝和完成率,避免把没有执行任务全部解释为更安全,也避免把重复部署回合当作同样数量的独立经验样本。
现有研究没有提供"Dreaming 之后再运行 Memory Trap"的交叉验证。离线回查有机会纠正过宽笔记,却还需要处理读取时泛化。提升、抽象和更容易找到记忆,可能同时扩大有用经验与错误规则的影响,这是需要进一步测试的设计假设,而非已经证明的 Dreams 结果。
7. 记忆的边界
如果回到最初的设计问题,Agent 需要的并不是一份越来越完整的往事档案,而是一套能够在新条件下使用旧经验的能力。
在线捕获与离线整合解决经验怎样留下;笔记、wiki 与索引解决经验怎样被找到;范围检查、版本采用和执行约束解决经验怎样参与当前行动。它们共同构成两条循环:一条不断提高知识的效用,另一条不断检查知识仍然真实、适用,并有权影响当前决策。
记忆可以帮 Agent 不再从零开始,但不能让它省掉对"这次有什么不同"的判断。我们希望经验变得更容易复用,同时让它成立的条件也更容易被重新看见。
参考资料
- Lance Martin / Anthropic. The components of agent memory(2026-11-06)
https://www.anthropic.com/research/components-of-agent-memory
- NLPer / AINLP. 刚刚,Anthropic 公开 Claude 记忆设计,Agent 也会离线做梦(2026-11-07)
https://mp.weixin.qq.com/s/9g4JFIgsn3iBEh58ygZqCg
- Anthropic. How Claude remembers your project --- Claude Code(文档,2026-11-07 核验)
https://code.claude.com/docs/en/memory
- Kaiqu Liang, Jaime Fernández Fisac, Thomas L. Griffiths, Andrew Lampinen. The Memory Trap: Language Agents Overgeneralize from Benign Interactions(arXiv:2611.07554,v1)
https://arxiv.org/abs/2611.07554
- Anthropic. Dreams --- Claude Managed Agents(文档,2026-11-07 核验)
https://platform.claude.com/docs/en/managed-agents/dreams
- Anthropic. Using agent memory --- Claude Managed Agents(文档,2026-11-07 核验)