ChatMemory 要被弃用了?Spring AI 2.1 用事件溯源重做 Agent 记忆
你要是现在去搜"Spring AI 多轮对话记忆怎么实现",翻出来的教程十有八九还在写这几样东西:ChatMemory、MessageWindowChatMemory、MessageChatMemoryAdvisor,然后配一个 InMemoryChatMemoryRepository 或者 Redis 的仓库,告诉你这样 Agent 就有记忆了。
我不怪这些教程,它们在 2.0 时代确实是标准答案。但你要是把依赖升到 2.1,打开 IDE 会发现一个有点吓人的现象:上面那几个类,名字全被划上了删除线。官方把它们整套标记成 @Deprecated,并且写得很明白------for removal in 3.0.0,3.0 版本直接删掉。
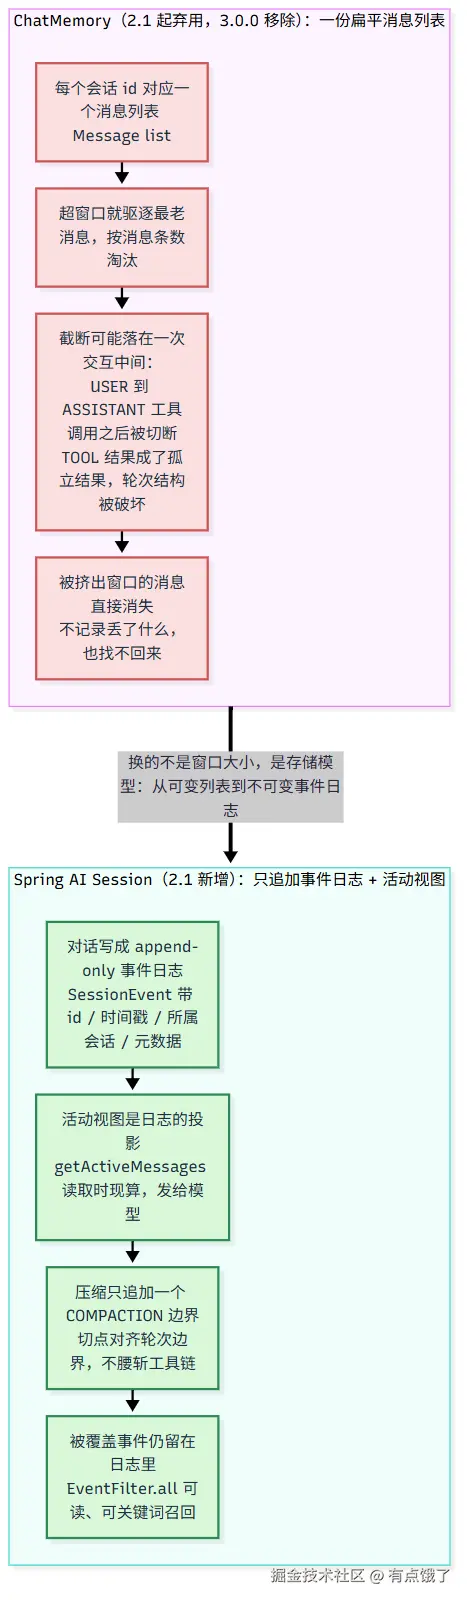
替代者是一个叫 Session 的新抽象。它不是给旧接口换了个名字,而是把"记忆"这件事的存储模型整个换了:从一个会被原地修改、超长就丢消息的列表,变成一条只追加、不可变、还能随时重放的事件日志。
这篇我想讲清楚四件事:旧的 ChatMemory 到底差在哪、新的 Session 是怎么设计的、代码上怎么落地和迁移,以及一个官方博客自己都"翻车"了的地方------它当初重点宣传的多 Agent 分支隔离,在正式进 2.1 之前被维护者自己删掉了。
一、先看旧的 ChatMemory,问题到底出在哪
先把旧方案的模型摆出来。ChatMemory 的思路非常直白:每个会话 id 对应一个消息列表,模型每说一轮,就往列表尾部加一条;等列表长度超过窗口容量,就把最老的消息踢出去。
ini
conversation-id-1: [msg1, msg2, msg3, ..., msgN]
                       └── 超了就从这里开始驱逐
短对话里这完全没问题。问题出在对话变长、而且中间夹着工具调用的时候。
截断不管"轮次",会把一次完整交互腰斩
你得先记住一个单位:一轮(turn)。用户说一句话,后面跟着助手的思考、工具调用、工具返回结果、助手基于结果给出的最终回答------这一整段才是一次完整的交互,它从一条用户消息开始,到下一条用户消息之前结束。
而 ChatMemory 是按"消息条数"淘汰的,它根本不看你这条消息处在一轮里的什么位置。于是可能出现这种情况:
sql
USER      "帮我查下广州的天气"
ASSISTANT  (调用 getWeather 工具)
─────────── 截断线正好切在这里 ───────────
TOOL      {"temp": 28, "city": "广州"}
ASSISTANT "广州现在 28 度"工具调用被留下了、工具结果被踢掉了,或者反过来。模型下一轮拿到的上下文里,就会出现一个没有对应调用的工具结果 ,或者一个永远等不到结果的工具调用。这种结构破损的输入喂给模型,它的行为基本是不可预测的------轻则答非所问,重则开始鬼打墙。
更难受的是第二点:被踢出去的消息是真的没了。你不知道具体丢了哪几条,也没法事后找回来。记忆系统自己对"遗忘"这件事没有任何记录。
公允地说一句,旧方案后来补了这个坑
我不想把 ChatMemory 批判得一无是处,那样不客观。在 2.1 的文档里,MessageWindowChatMemory 其实已经改成按整轮淘汰了------切点会对齐到轮次边界,不会再把工具调用和结果切开。
所以如果你对 Session 的理解停留在"它就是不会腰斩工具链",那是低估了这次改动。腰斩问题旧方案的后期版本已经解决了,Session 真正的差异,是换掉了存储模型本身。
在 ChatMemory 里,记忆是一个可变的、会被原地删除的列表 ;而在 Session 里,记忆是一条不可变的、只追加的事件日志,你看到的"上下文"只是这条日志在某个时刻的一个投影。这是两种世界观的差别,下面展开讲。
二、换脑:把记忆从"可变列表"改成"只追加的事件日志"
Session 背后的思路有个正经名字,叫事件溯源(Event Sourcing) 。这个词在后端领域并不新鲜,核心就一句话:不要只存"当前状态",而是把"发生过的事"一条条记下来,当前状态需要的时候从这些事件里重新推导。
银行账户是最经典的例子:你不会直接在数据库里存一个"余额"字段然后每次覆盖它,而是记下每一笔收入和支出,余额就是这些流水加总的结果。这样任何时候你都能重放、审计、回到历史某个点。
Spring AI 把同一套思想搬到了对话记忆上。它用四个概念把这件事讲清楚。
1. Session:只存元数据的不可变值对象
Session 代表一次连续对话的身份,但它不装对话内容,只装元数据:会话 id、创建时间、过期时间,以及一个任意的元数据 map。对话的事件日志单独存在仓库里,用到的时候再去取。
有个设计细节值得注意:Session 没有 owner 字段 。那怎么知道这个会话属于谁?答案是放进元数据里,键是 SessionAttributes.PRINCIPAL_NAME。这个键所有存储都会建索引,所以想列出某个用户的全部会话,按元数据查就行:
java
Session session = sessionService.create(CreateSessionRequest.builder()
        .id("session-abc")                          // 不填则随机 UUID
        .timeToLive(Duration.ofDays(7))             // 不填用默认值(默认 60 天)
        .metadata(SessionAttributes.PRINCIPAL_NAME, "alice")
        .metadata(SessionAttributes.AGENT_NAME, "support")
        .build());
2. SessionEvent:日志的最小单位,追加后永不修改
真正的内容载体是 SessionEvent。它包了一条 Spring AI 的 Message,然后补上 Message 本身故意不带的几样东西:事件 id、所属会话 id、时间戳、框架标记。
事件类型 EventType 是开放的:内置 MESSAGE 和 COMPACTION 两种,你也可以把自己业务里发生的事(比如"任务进度""人工审批结果")记进同一条日志。不过要注意,只有 MESSAGE 类型的事件参与提示词组装和压缩,自定义事件只是安静地躺在日志里。
java
SessionEvent progress = SessionEvent.builder()
        .sessionId(sessionId)
        .type(EventType.of("MY_APP.PROGRESS"))
        .payload("step", "research")
        .build();
3. Turn:一切操作的原子单位
前面提过的轮次,在 Session 里是一等公民。一个 turn = 一条用户消息 + 到下一条用户消息之前的所有事件。后面你会看到,无论是压缩还是读取,所有操作都在 turn 这个粒度上进行,这就从机制上保证了不会出现"半轮"的上下文。
4. Active View:发给模型的,是日志的一个投影
这是整个设计里最关键的一环。日志是只追加、不会变的,那模型每次看到的"当前上下文"是什么?
答案是活动视图(Active View) ,它不是一个被存起来的东西,而是读取时用 getActiveMessages() 现算出来的投影。一次压缩会往日志里追加一个 COMPACTION 边界事件,由这个边界点名"视图里现在包含哪些事件",边界之后新追加的事件也自动进入视图。
于是一个事件的一生可以分成三个状态:
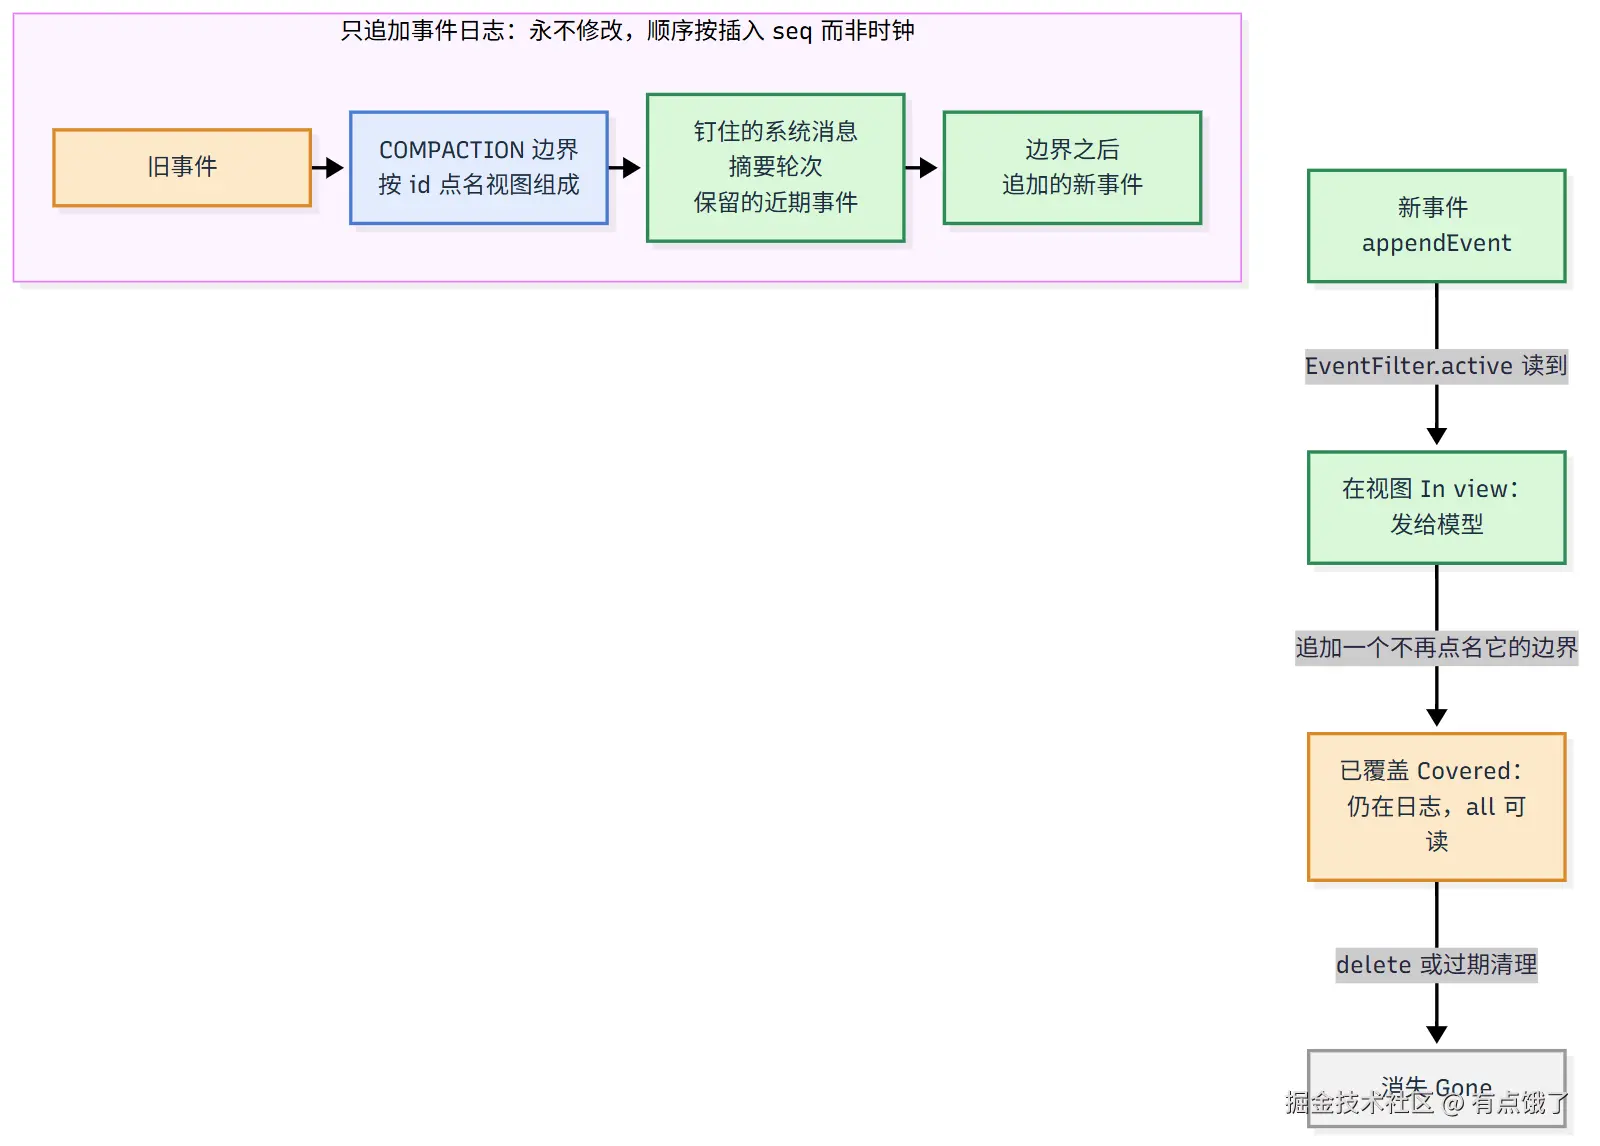
- 在视图(In view) :新事件刚追加,
EventFilter.active()能读到,会发给模型; - 已覆盖(Covered) :追加了一个不再点名它的压缩边界,它离开活动视图,但仍在日志里 ,用
EventFilter.all()还能读到; - 消失(Gone):只有整个会话被删除、或者过期清理时,才会真正消失。
看明白这个三态,你就懂了 Session 最值钱的地方:压缩永远不删除任何东西。 旧方案里"被踢出窗口就找不回"的问题,在这个模型里压根不存在------原始日志一直都在,活动视图只是它的一个读取窗口。
三、上下文压缩:什么时候压、压什么、怎么保住要点
这一节具体讲压缩。它由两个可以自由组合的抽象驱动,分工很清楚:
- **触发器(Trigger)**回答"什么时候该压了";
- **策略(Strategy)**回答"压的时候让哪些东西离开视图"。
触发器:按轮次、按 token,或者组合
java
new TurnCountTrigger(20);                          // 超过 20 轮触发
TokenCountTrigger.builder().threshold(4000).build(); // 估算 token 到 4000 触发
CompositeCompactionTrigger.anyOf(triggerA, triggerB); // 任一满足就触发这里有个容易踩的小坑:TurnCountTrigger(n) 是"超过 n 轮"才触发,恰好等于 n 轮时不触发。另外,trigger 和 strategy 必须成对配置 ,只配一个,构建时直接抛 IllegalArgumentException------这是框架在帮你兜底,防止你配了个永远不会生效的压缩。
窗口策略:保留最近的一段
WindowCompactionStrategy 是最常用的策略,它保留最近的对话、覆盖更早的部分,留多少可以按三种口径指定:
java
WindowCompactionStrategy.builder().lastEvents(20).build();    // 最近 20 个事件
WindowCompactionStrategy.builder().lastTurns(10).build();     // 最近 10 轮
WindowCompactionStrategy.builder().tokenBudget(4000).build(); // 4000 token 内放得下的最新事件
不管用哪种口径,它都给你两条硬保证:
- 保留窗口一定从一轮的开头开始。 切点如果落在轮次中间,会向前挪到下一个轮次开头,绝不会留下工具结果却丢了开启这轮的用户消息。
- 最新一轮永远保留。 哪怕这一轮本身就超长(比如一个很长的工具循环),也不会被压缩覆盖,保证正在进行的对话永远完整。
系统消息则会被钉(pin)在视图最前面,永远不被摘要、不占窗口名额,每轮都稳定地出现在上下文开头。
滚动摘要:用一个小模型,给被压掉的内容留个"备忘"
纯窗口策略有个代价:被覆盖的内容虽然还在日志里,但对模型的活动视图而言等于"消失"了。如果这些内容里有需要记住的要点怎么办?
可以给策略配一个 ChatModelSummarizer。它会把被覆盖的轮次浓缩成一个摘要轮次------形式是一条"影子用户消息"加一条助手摘要,这样模型看到的始终是用户/助手交替的完整结构。
java
WindowCompactionStrategy strategy = WindowCompactionStrategy.builder()
        .lastTurns(10)
        .summarizer(ChatModelSummarizer.builder(chatModel)
                .overlapSize(2)                              // 把活动窗口的 2 个事件喂进摘要,保证连贯
                .shadowPrompt("请总结我们到目前为止的对话。")
                .chatOptions(ChatOptions.builder().model("small-model").build()) // 用便宜的小模型做摘要
                .onSummarizationFailure(req -> { /* 报警、打点 */ })
                .build())
.build();它叫"滚动摘要"是有原因的:前一份摘要会作为上下文喂给下一次摘要,所以每一份摘要都建立在前一份之上,像滚雪球一样累积,而不是每次从零开始。用小模型做这件事,成本几乎可以忽略,但能显著降低长对话里关键信息丢失的概率。
四、为什么它敢上生产:幂等、乐观锁、可插拔存储
讲到这,你可能会有个疑问:日志只追加、还要支持多实例并发写,万一两个请求同时往一个会话里写、或者压缩和新消息撞在一起,会不会乱?
Session 靠三个工程细节把这些问题压住了。
第一,追加是幂等的。 对同一个已经提交过的事件 id 重试追加,是一个空操作:不报错、不重复、也不推进日志版本。网络抖动导致的重试不会写出重复数据。
第二,并发写入靠乐观锁,而不是悲观锁。 每个会话维护一个事件版本号,批量追加的 API 长这样:
java
boolean ok = sessionService.appendEvents(sessionId, events, expectedVersion);它的语义是"只有日志当前版本还等于我读到的 expectedVersion,才把这批事件写进去 ",本质就是一次比较并交换(CAS)。如果期间有别的写入者,这次调用返回 false,你重新读一遍、重建事件再写就行。压缩的边界和摘要就是用这个方式落盘的,撞车了会有限次重试,不会把摘要白算一遍。
第三,顺序按插入顺序,而不是时钟。 JDBC 仓库里维护一个单调递增的 seq 列,事件先后以它为准。这避开了分布式环境里多台机器时钟不一致、回拨之类的麻烦。
存储本身也是可插拔的:
InMemorySessionRepository给测试和本地开发用,重启就没;JdbcSessionRepository是生产选项,支持 PostgreSQL、MySQL、MariaDB、H2,两张表(会话表 + 只追加的事件表);- 你想接别的存储(比如自家的 KV),实现 SPI 后用
spring-ai-test里的契约测试验证一遍,行为和官方实现对齐即可。
这里顺手记三个实战里很容易忽略的点,都是不报错、但行为不对的那种坑:
deleteExpiredSessions不会自己运行,得你在调度器里定时调(比如每小时一次);findByMetadata只对建了索引的键 有效。principalName始终有索引,其他键要通过spring.ai.session.repository.jdbc.indexed-attributes显式声明。否则会出现"内存仓库查得到、JDBC 仓库返回空列表"的诡异差异,测试好好的、上线就失灵;SystemMessage默认拒绝落盘 ,需要的话得在构建DefaultSessionService时显式打开。
五、ChatClient 落地:每次必传会话 id,Advisor 自己无状态
前面讲了不少底层概念,实际接进 ChatClient 反而非常简单,一个 SessionAdvisors 就把脏活全包了:
java
@Bean
ChatClient chatClient(ChatModel chatModel, SessionService sessionService) {
    return ChatClient.builder(chatModel)
            .defaultAdvisors(SessionAdvisors.builder(sessionService)
                    .compaction(new TurnCountTrigger(20),
                            WindowCompactionStrategy.builder().lastTurns(10).build())
                    .build())
            .build();
}

String answer = chatClient.prompt()
        .user("你好")
        .advisors(SessionAdvisors.session("session-abc"))   // 每次调用都要带会话 id
        .call()
        .content();
每次请求,Advisor 自动做这几件事:加载活动视图、把历史前置到提示词、把这一轮新产生的用户消息和助手回复追加进日志、触发器命中就执行压缩。应用代码里完全不用手写这些。
有两个设计决策我觉得特别值得讲。
第一,刻意没有"默认会话",每次调用必须显式传 id。 为什么?因为如果给一个全局默认会话,不同用户的历史会被悄无声息地写进同一条日志,串号是迟早的事。框架宁愿让你多传一个参数,也不替你冒这个险。会话不存在也没关系,首次使用会自动创建。
第二,Advisor 自己是无状态的。 它只在单次请求里干活:读视图、调模型、追加事件,请求结束手里不留任何东西。这意味着一个会话的第一轮可以在 A 实例跑,第二轮可以在 B 实例跑,随便负载均衡、随便扩缩容。
这其实和我前面两篇讲的东西是同一条主线:MCP 2.0 把状态从协议里删掉、DeepSeek Super-agent 的评估器无状态,到这里 Spring AI 的记忆运行时也无状态------状态全部下沉到外部存储,计算节点保持无状态,这是当下这套 Agent 基础设施能水平扩展的共同前提。
六、一个"翻车点":被删掉的多 Agent 分支隔离
好,现在讲这篇里我最想让你知道的一个"破案"细节,因为它直接关系到你照着官方博客写代码会不会踩空。
还记得 4 月那篇官方博客《Spring AI Agentic Patterns Part 7》吗?它用了不小的篇幅讲一个叫 branch(分支隔离) 的多 Agent 特性:让所有子 Agent 共享同一个会话,给每个事件打一个点分路径的标签(比如 orch、orch.researcher、orch.writer),读取时按分支过滤,保证 researcher 看不到 writer 的内容。
听起来很美好。但真相是:这套 branch API 在正式进入 Spring AI 2.1 之前,被维护者自己删掉了。
时间线很清楚:
| 版本 | 时间 | 变化 |
|---|---|---|
| 社区 0.2.0 | 2026-04 | 博客描述的版本,有 branch,但 Advisor 只在读侧过滤、写侧不打标签,实际隔离不生效 |
| 社区 0.9.0 | 2026-09-27 | 整套 branch API 标记为待移除 |
| 社区 0.10.0 | 2026-09-28 | 直接删除 |
| 官方 2.1.0-RC1 | 2026-10 | 源码里没有 branch,建表脚本里也没有这一列 |
为什么删?因为它和压缩合不来,也没服务好真实场景
维护者在决策记录里给的理由挺实在的。首先他们意识到,"多 Agent 协作"其实是两种不同的模式,branch 夹在中间,哪边都没服务好:
- 接力(handoff) :几个 Agent 轮流和用户对话,每个都该看到完整对话,这种共享一个会话、根本不需要过滤;
- 委派(delegation) :父 Agent 把任务交给子 Agent、只拿回一个结果,这种最合适的是每个子 Agent 一份独立历史,只有任务进去、只有结果出来。
更要命的是 branch 和压缩机制天然冲突:压缩的单位是根轮次,预算却把所有分支加一起算;递归摘要写的是根级事件、对所有 Agent 可见,结果就是一个子 Agent 的工作内容会通过摘要"泄露"给兄弟 Agent;当活动窗口里没有根级用户消息时,甚至会触发把整个窗口归档的数据丢失 bug。
于是结论很干脆:删掉 branch,文档直接推荐"一个子 Agent 一个会话"。
现在的正确姿势:把子 Agent 暴露成工具
在 2.1 里做委派式多 Agent,标准做法是把子 Agent 包装成一个工具。工具被调用时,从父会话 id 派生出一个稳定的子会话 id,子 Agent 用自己的 ChatClient(独立的系统提示词、独立的压缩参数)干活,只把最终答案返回给父会话。
java
public class SubAgentTools {

    private final SessionService sessions;
    private final ChatClient researcher;

    public SubAgentTools(SessionService sessions, ChatClient researcher) {
        this.sessions = sessions;
        this.researcher = researcher;
    }

    @Tool(description = "把研究任务委派给 researcher,返回它的结论")
    public String research(@ToolParam(description = "研究任务") String task,
                          ToolContext toolContext) {
        String parentId = (String) toolContext.getContext()
                .get(MemoryAdvisor.CONVERSATION_ID);

        String childId = parentId + ":researcher";   // 稳定 id,子 Agent 记得本会话里之前的任务
        sessions.findOrCreate(CreateSessionRequest.builder()
                .id(childId)
                .metadata("parentSessionId", parentId)
                .build());

        // 只有任务进去,只有最终结果回来
        return researcher.prompt()
                .user(task)
                .advisors(SessionAdvisors.session(childId))
                .call()
                .content();
    }
}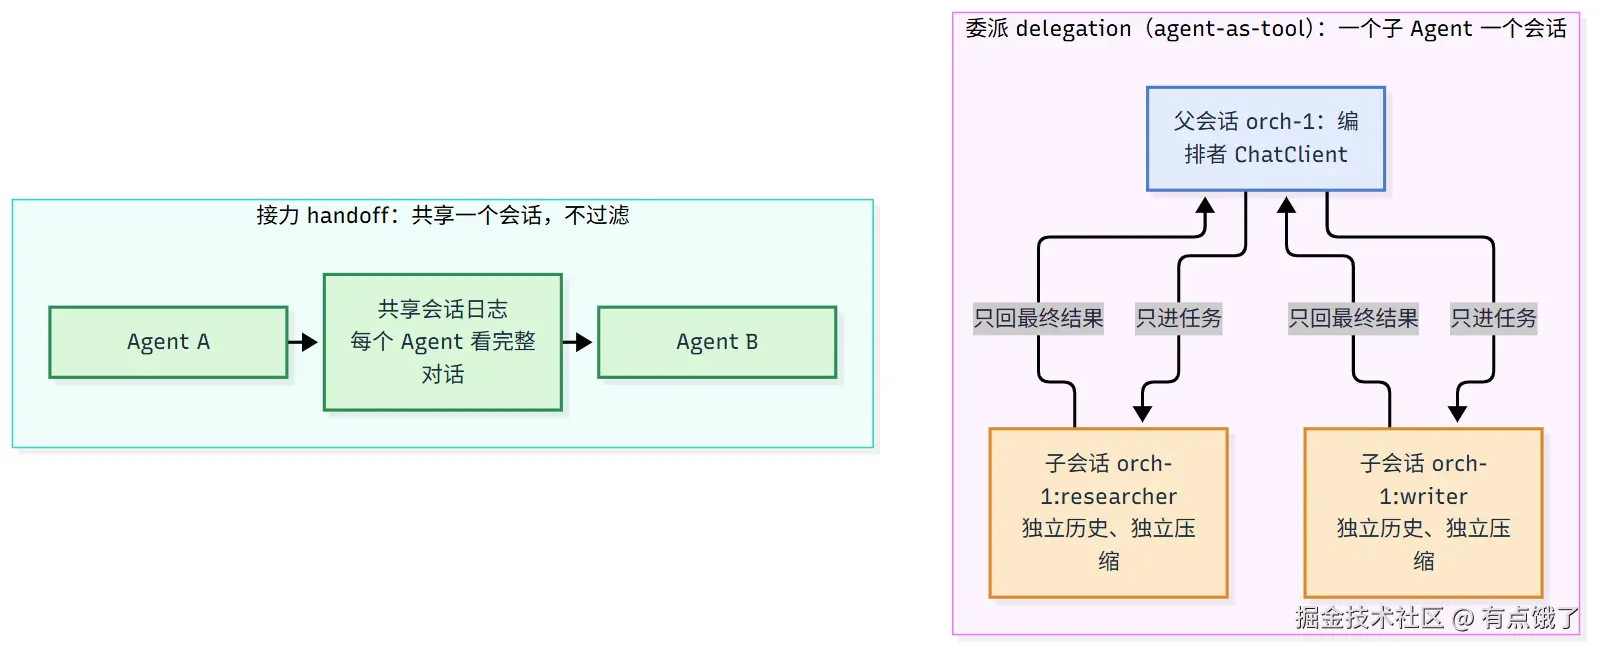
这样跑出来的结果是:researcher 只看得到自己的任务和自己的历史,既看不到编排者的对话,也看不到兄弟 Agent 在干嘛;编排者也看不到子 Agent 内部的工具调用,只拿到最终答案。
这个"翻车点"给我的提醒是:看技术博客一定带上版本号。 这套东西在社区孵化期是 0.x 版本,维护者明确保留了 1.0 之前做破坏性变更的权利,博客里的截图和代码很可能已经过时。照着写之前,先确认你用的版本里这个 API 还在不在。
七、顺带一提:工具确认也是"无状态"的
2.1 还有一个和 Session 同期上线的特性,叫工具调用确认(Human-in-the-Loop),我觉得它和 Session 的设计哲学是一套的,值得一起说。
场景很具体:订机票、删文件、发邮件、转账这类高危操作,你不希望模型一调用就执行,得有个人先点头。只要在工具上标一个注解:
java
class BookingTools {
    @Tool(description = "订机票", requiresConfirmation = true)
    String bookFlight(String flightNumber) {
        return bookingService.book(flightNumber);
    }
}模型调用这个工具时,工具循环会在执行前暂停,这次回复里的所有调用都不会运行,而是把"等待决策的调用列表"作为一个普通响应返回给应用。应用把它展示给真人,收集到允许或拒绝的决策后,再带着结果发起下一次请求。
最妙的是那句设计原则:暂停是一个普通响应,恢复是一个普通请求。 等待期间框架不保存任何挂起线程、不存任何会话状态,所以应用重启也不怕,只要对话(也就是你的 Session 日志)还在。确认策略还能按参数来,比如只拦截金额超过 1000 的转账。
你看,这和 Session 的"运行时无状态"、MCP 的无状态,又是同一个思路。
八、划清边界:Session 是短期记忆,不是记忆的全部
最后得把一个边界划清楚,免得你以为上了 Session 就万事大吉。
Session 管的是短期记忆 :一次会话内、给模型看什么、怎么压缩。它不负责"跨会话记住一个用户的长期偏好和事实"。后者在 Spring AI 的体系里是 AutoMemoryTools(以及做记忆整理的 AutoDreamService)的活------把值得长期保留的事实提炼出来,独立于具体会话存好。
官方原话说得很直白:一个完整的 Agent 记忆栈,短期和长期两者都需要,谁也替代不了谁。这部分我在前面第八篇《给 Agent 塞满 128K 上下文,它还是会失忆?》里详细聊过记忆分层和上下文工程的通用原理,这里就不重复了,这篇聚焦的是框架里这层抽象具体怎么演进、怎么落地。
写在最后:怎么迁移,以及别急着上头
如果你是从社区版或者 ChatMemory 迁过来,有几个高频的 API 改名先记一下,能少踩点坑:
| 旧写法 | 2.1 里的对应 |
|---|---|
CreateSessionRequest.builder().userId(...) |
没有 userId,归属放元数据 PRINCIPAL_NAME |
SessionMemoryAdvisor + compactionTrigger/Strategy |
SessionAdvisors.builder().compaction(trigger, strategy) |
SlidingWindowCompactionStrategy |
WindowCompactionStrategy.lastEvents(...) |
| 先 findById 再 create 并捕获异常 | 直接 findOrCreate,并发安全 |
| 手动 param 传会话 key | SessionAdvisors.session(id) |
最后泼三句冷水,免得你看完热血上头就把生产环境改了:
- 现在最新稳定版还是 2.0.2,Session 相关的构件只在 2.1.0-RC1 里,官方文档页首也写着"仍在开发中、尚不稳定",GA 之前个别 API 还可能微调;
- Cassandra、Neo4j、MongoDB、Redis 这些存储的 Session 对应实现还没出,官方计划在 3.0.0 之前补齐,
VectorStoreChatMemoryAdvisor也暂时保留; - 我的建议是:新项目、新模块可以直接按 Session 设计,老项目在 3.0 之前按迁移指南慢慢换,没必要在生产上追一个 RC 版本。
但方向是确定的。把"记忆"从一个会被原地修改的列表,重构成一条只追加、可重放、可投影、还能安全压缩的事件日志,这不只是 Spring AI 一家的选择,而是整个 Agent 基础设施走向工程化、可运维的一个缩影。理解了事件溯源这套底层逻辑,换哪个框架你都能看得懂它在干什么。