前言:按图索骥的艺术
在上一篇文章中,我们建好了一个完美的'仓库登记表'(Scope作用域 )。现在,我们要进入第二阶段 SqlAnalyzerListener,顺着 SELECT 子句,去查出每一个字段最底层的来源。
我们的目标是:不管用户在 SELECT 里写了多复杂的函数、子查询或表达式,引擎都要能剥开重重伪装,追踪到最底层的物理字段。
💡开源项目地址::Hermes-SQL
字段级血缘追踪初识
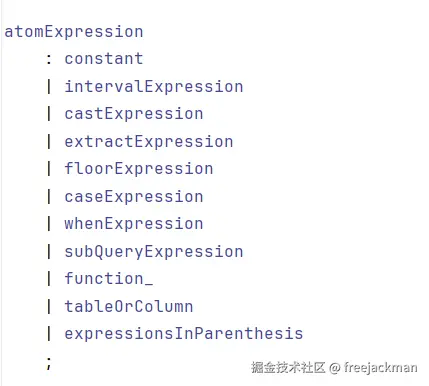
在 Hive SQL 语法中,SELECT 后面支持多达 11 种表达式。如果全放在一篇文章里讲完会非常臃肿,今天我们先啃下最核心的几块硬骨头:物理字段、函数嵌套与子查询。
📍 第一关:AST 的陷阱 ------ t1.id 去哪儿了?
普通物理字段 (tableOrColumn),正常情况下,物理字段名就在tableOrColumn节点下面,但是字段名一旦有前缀之后,情况就不一样了。
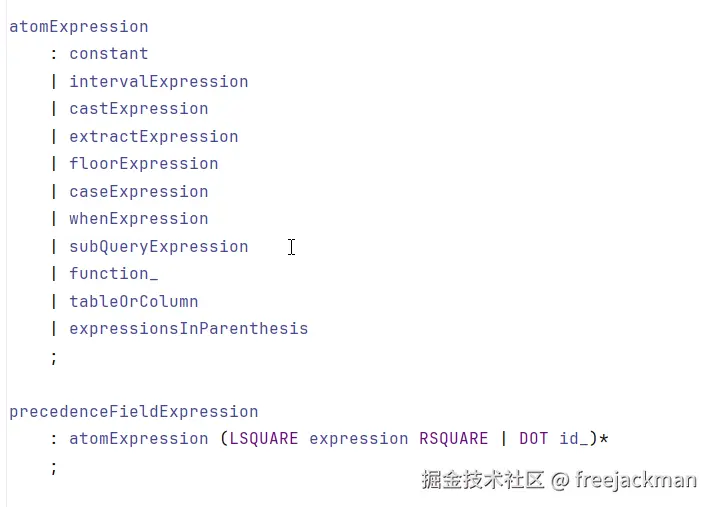
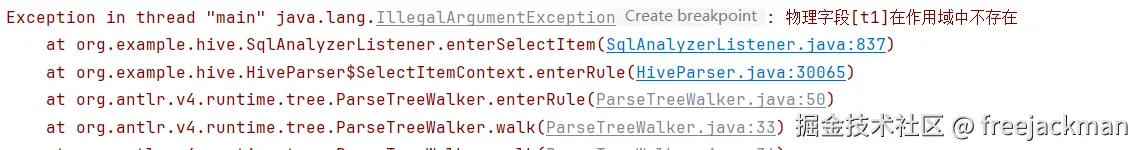
比如解析 SELECT t1.id FROM user t1 时,最早我按照惯性思维,以为能直接拿到完整字符串 t1.id。但结果却报错了。我仔细看了官方语法文件,发现在实际解析中,ANTLR 把它拆成了 TableOrColumn("t1") 和 DOT id_("id") 两个兄弟节点。
为什么 ANTLR 要这么设计? 因为它在兼容极其复杂的语法,比如 arr[0](数组下标)或 t1.struct_col.field
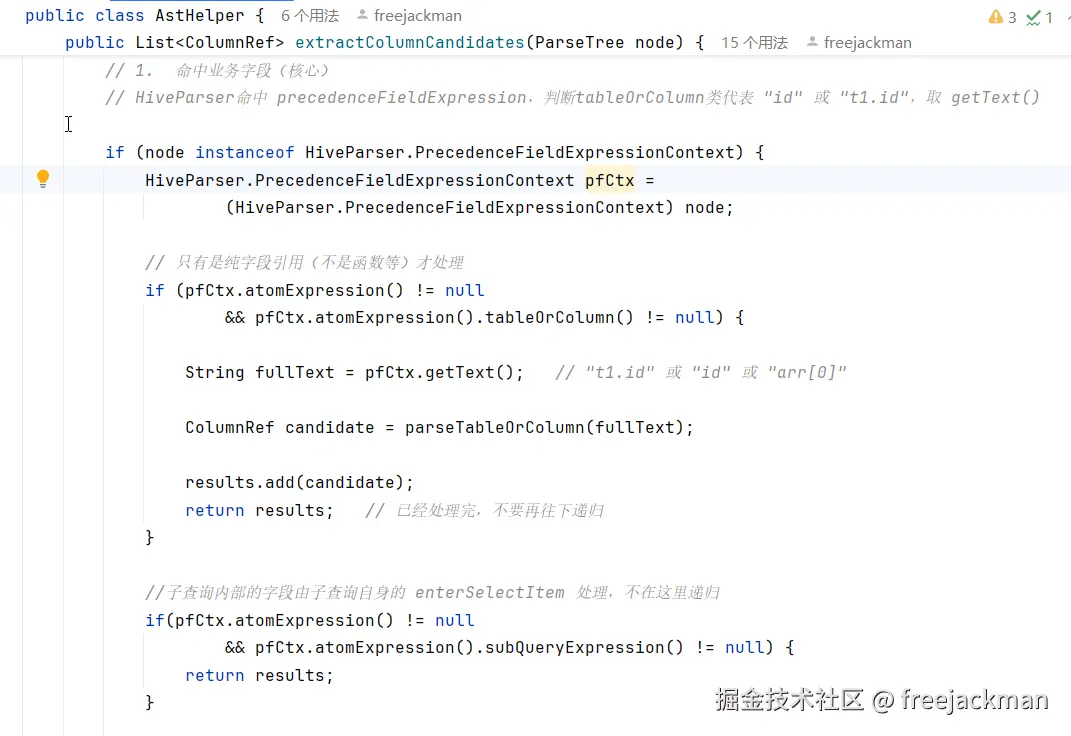
如何解? 既然它们是兄弟节点,我们就必须向上追溯它们共同的父节点 PrecedenceFieldExpressionContext(优先级字段表达式),直接将父节点的整体文本提取出来,从而获得完整的 t1.id
java
// 核心代码:在 AstHelper 中向上回溯
if (node instanceof HiveParser.PrecedenceFieldExpressionContext) {

    HiveParser.PrecedenceFieldExpressionContext pfCtx = (HiveParser.PrecedenceFieldExpressionContext) node;

    // 判断是纯字段引用,不是函数
    if (pfCtx.atomExpression() != null && pfCtx.atomExpression().tableOrColumn() != null) {
        // 直接拿整体的 getText()
        String fullText = pfCtx.getText();   // 得到 "t1.id" 或 "id" 或 "arr[0]"
        ColumnRef candidate = parseTableOrColumn(fullText);
        results.add(candidate);
        return results;   // 关键:处理完直接返回,截断递归,防止重复提取
    }
}
📍 第二关:按图索骥 ------ 裸字段归属与歧义检测
当我们遇到 t1.id,直接去第一阶段建好的 Scope.aliasToTableMap 里找 t1,直接命中。
当我们遇到 SELECT id 这种裸字段,去 Scope.columnToTableMap 里找。因为有第一阶段元数据服务的加持,我们可以轻松拿到包含 id 的表。
但实际业务中,字段往往包裹在算术表达式(如 a.id + b.id)中。为此,我写了一个通用的递归提取器 AstHelper.extractColumnCandidates,只要递归命中 TableOrColumn 节点就抓取;如果遇到子查询节点,直接 return 阻断递归。这样就能把复杂表达式树里所有的物理字段全部揪出来。
高能预警 :如果多张表都有 id,结果列表会大于 1。这时引擎必须抛出警告,标记 isAmbiguous = true。在真实的生产事故中,多表 JOIN 漏加别名是导致数据混乱的最常见原因。
java
// 核心逻辑:歧义检测
List<TableInfo> tableInfos = scope.columnToTableMap.get(columnRef.columnName);
if (tableInfos.size() == 1) {
    columnRef.originTable = tableInfos.get(0); // 唯一命中
} else if (tableInfos.size() > 1) {
    columnRef.isAmbiguous = true; // 多表同名,标记歧义警告!
}
📍 第三关:洋葱剥壳 ------ 函数链(FunctionChain)的构建
函数 (function_),当我们遇见单个函数或者函数嵌套时,比如UPPER(SUBSTR(name, 1, 3)),我们需要提取出 name 字段,同时记录它经过了哪些加工。
如何解? 这就要用到我们的函数栈 functionStack:
- 外层函数
UPPER先入栈。 - 内层
SUBSTR后入栈。 - 出栈时精准关联上对应的
parentFunction。
java
// 核心代码:利用 functionStack 建立父子函数关系
FunctionInfo currentFunc = new FunctionInfo();
currentFunc.functionName = ctx.functionName().getText();

if (!functionStack.isEmpty()) {
    // 栈顶元素即为当前函数的父函数(外层函数)
    currentFunc.parentFunction = functionStack.peek();
    currentFunc.isNested = true;
}
functionStack.push(currentFunc); // 压栈
对于每个函数的参数(如 name),我抽象出了 FunctionArgument 模型,把参数类型分为(字段、常量、子查询、嵌套函数等),精准挂载到 arguments 列表里。
踩坑实录:上下文污染
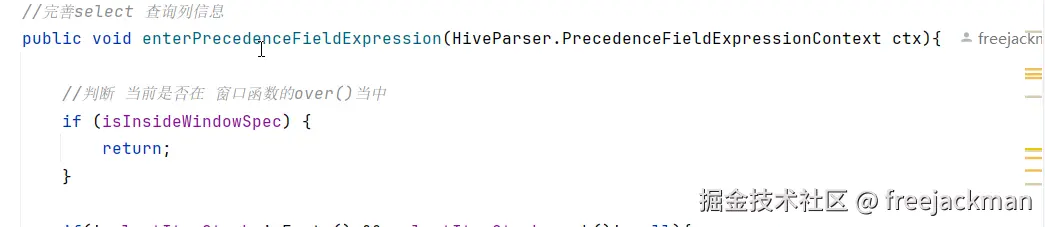
在遍历窗口函数 OVER(PARTITION BY ...) 时,有一个极其隐蔽的坑。比如 ROW_NUMBER() OVER (PARTITION BY id ORDER BY age),ANTLR 在遍历 id 和 age 时,functionStack 的栈顶是 ROW_NUMBER,它会顺理成章地把 id 当成 ROW_NUMBER 的输入参数(Arguments)挂载上去!
为了解决这个问题,我增加了一个 isInsideWindowSpec 状态标记。在进入 OVER 子句时设为 true,拦截所有参数挂载操作,让这些字段只做血缘归属,不进参数列表。
📍 第四关:乾坤大挪移 ------ 子查询与虚拟表血缘穿透
这一关是解析器最容易翻车的地方,分为两种截然不同的子查询。
1. 列级子查询穿透 (subQueryExpression)
在前面第一阶段,对于 FROM 子查询 ,我们将它视作一个虚拟的 TableInfo 数据源。但是对于 SELECT 列级子查询,我们却不能这么处理。
两种子查询的入口完全不同! 列级子查询直接以 selectStatement 的形式包裹在 subQueryExpression 里,跳过了 queryStatementExpression 这一层。如果你用同样的条件去判断,直接漏抓!
如何解? 必须独立处理,用 selectItemStack(查询列栈)来判断当前是否正在解析某个 SELECT 列 ,如果是,就把内部的子查询归挂到当前SELECT 列 的 selectItemSubQueries 属性中,等子查询解析完毕后,向上层递归合并子查询的 sourceColumns 血缘。
2. UDTF 虚拟列穿透 (第一阶段数据源后的LATERAL VIEW)
业务场景:SELECT score FROM user LATERAL VIEW explode(arr) e AS score。
- 第一阶段,
score被归到了虚拟表e中。 - 第二阶段,当查到
score来源是e(虚拟表类型为 FUNCTION)时,启动 "血缘穿透" !顺着e.inputSourceTable找到底层的物理表user,然后把score的最终血缘指向user.arr。
📍 第五关:打造全景图 ------ transformType 的综合判定
数据处理的类型,就是引擎要给拿到的数据打标签。经过上面的解析,我们收集了物理字段 (sourceColumns)和函数链 (functionChain)。最后我们需要综合判定并打上标签:
标签类型 (TransformType) |
判定条件 | 业务含义 |
|---|---|---|
| DIRECT(直取) | 没有函数链,且只有一个物理字段 | 原始数据直接输出 |
| SIMPLE(简单加工) | 经过了单个函数,或者经过了 UDTF表函数处理 | 轻度数据清洗 |
| COMPLEX(复杂加工) | 包含了子查询、CASE WHEN、嵌套函数 | 重度计算,迁移重灾区 |
这个标签在未来做脱敏策略和方言迁移时极其重要,它直接决定了我们需要重点关照哪些数据列(SelectItem)。
结语与预告
至此,普通物理字段、函数和函数嵌套、子查询的血缘已经被我们彻底扒光了!
但这还不够,真实业务中的大魔王还没出现。下一篇,我们将死磕高阶子句:CASE WHEN 的四种分支拆解,以及令人头皮发麻的窗口函数(Window Functions) !敬请期待😁。