在优化算法研究中,我们经常会遇到一个看似简单、实际却十分棘手的问题:为了找到更好的解决方案,算法需要不断评价新的候选解,但如果每一次评价都非常昂贵,该怎么办?
例如,在云资源调度中,优化算法可能需要评估成千上万种资源配置方案。对于每种方案,我们可能需要重新分配 CPU 和 Memory,运行真实工作负载,监控服务延迟,并计算资源成本和 SLA 违约情况。如果每次评价都需要数分钟甚至更长时间,那么传统进化算法动辄数万次的 Fitness Evaluations,将带来巨大的计算和时间成本。
机器人控制、复杂工程设计和科学计算同样存在类似的问题。一个候选解的评价可能需要运行完整仿真、执行物理实验,或者调用代价高昂的数值求解程序。优化算法本身或许并不复杂,真正昂贵的是每一次目标函数评价。
这正是 Surrogate Model(代理模型) 受到广泛关注的重要原因。
Surrogate Model 通过历史评价数据学习真实目标函数的近似关系,让优化器能够以更低的成本预测候选解的性能,并据此决定哪些方案值得进一步进行真实评价。
近年来,随着进化计算(Evolutionary Computation)、贝叶斯优化(Bayesian Optimization)和生成式学习(Generative Learning)的发展,代理模型的作用也逐渐从简单的 Fitness Prediction,扩展到搜索方向引导、优化策略学习以及不确定性管理。
最近在阅读和复现进化计算领域的论文时,我重点关注了两项研究:2026 年的 Evolutionary Generative Optimization(EvoGO),以及 2021 年的 Dynamic Workflow Scheduling Genetic Programming(DWSGP)。前者已经将代理模型引入生成式搜索过程,后者则提出可以通过代理模型降低云调度规则的演化评价成本。
这两篇论文虽然研究的问题和方法不同,却都指向一个值得深入思考的方向:能否通过学习真实目标函数及历史优化经验,降低昂贵的搜索成本,并获得更加高效、可靠的优化策略?
本文将从 Surrogate Model 的基本原理开始,逐步介绍其数学基础、主流方法和在进化计算中的作用,并结合 EvoGO 与云资源调度研究,进一步探讨代理模型在动态环境下的挑战与研究机会。
01. 什么是 Surrogate Model?
1.1 用更便宜的模型,近似更昂贵的目标函数
Surrogate Model,中文通常译为"代理模型",也可以称为替代模型或近似模型。它的基本思想并不复杂:当真实系统的评价成本很高时,先通过少量真实数据建立一个近似模型,再利用这个模型快速预测其他候选方案的性能。
假设我们需要最小化目标函数:
x∈Xminf(x)
其中, x 表示一个候选解决方案, X 表示搜索空间, f(x) 是真实目标函数。
对于某些数值优化问题,计算 f(x) 可能只需要几毫秒;但在复杂工程或云计算系统中,一次评价可能意味着完整的仿真、部署或性能测试。
因此,我们希望训练一个计算成本更低的模型:
f^θ(x)≈f(x)
这里, f^θ 就是代理模型, θ 为模型参数。它通过历史评价数据,学习输入配置与真实目标函数之间的关系。
需要注意,代理模型的预测值并不等于真实评价结果。它始终存在模型假设、训练数据覆盖和预测误差等限制,因此不能简单地将代理预测视为已经验证的事实。
1.2 一个云资源分配的例子
假设需要为 Kubernetes 集群中的一个微服务分配 CPU 和 Memory,其决策变量可以表示为:
x=(c,m)
其中, c 为 CPU Allocation, m 为 Memory Allocation。
我们希望在满足一定服务性能要求的条件下,尽可能减少资源成本。真实评价可能需要部署指定资源配置,并通过压力测试获得 P95 Latency。
假设我们已经测得以下数据:
| CPU | Memory | P95 Latency |
|---|---|---|
| 0.5 Core | 1 GiB | 350 ms |
| 1 Core | 2 GiB | 190 ms |
| 2 Cores | 2 GiB | 120 ms |
| 2 Cores | 4 GiB | 105 ms |
| 4 Cores | 4 GiB | 90 ms |
注:以上为用于说明原理的假设数据,并非真实云平台测试结果。
利用这些数据,我们可以训练一个性能预测模型:
L^=f^θ(c,m)
当优化算法提出一个尚未测试的资源配置,例如 CPU 为 1.5 Cores、Memory 为 3 GiB 时,代理模型可以直接预测该配置下的服务延迟,而不必立即部署和压测。
如果模型预测结果为 145 ms,这只能说明该配置可能具有一定潜力。真正的服务延迟仍然需要通过真实系统或可信仿真进行验证。
这就是代理模型的核心价值:让优化算法能够在消耗真实评价预算之前,以较低成本获得候选方案的性能信息。
02. 为什么进化计算特别需要 Surrogate Model?
2.1 进化算法的评价成本问题
进化计算(Evolutionary Computation,EC)是一类基于种群搜索机制的智能优化方法,包括 Genetic Algorithm(GA)、Differential Evolution(DE)、Evolution Strategies(ES)和 Genetic Programming(GP)等。
这类算法通常需要维护一个候选解种群,并通过选择、交叉、变异等操作不断产生新的候选解。对于新解,算法需要计算其 Fitness,然后才能判断哪些解值得保留、哪些搜索方向具有潜力。
假设种群大小为 N,优化过程执行 G 次种群更新,且每次更新都评价 N 个新解,那么包括初始种群在内,真实函数评价次数约为:
NFEs=N(G+1)
例如:
N=100,G=100
则需要:
NFEs=10,100
如果每次真实评价都需要 60 秒,完全顺序执行时,累计评价时间约为 168 小时。这还不包含算法训练、系统调度与其他运行开销。
虽然并行计算能够缩短实际运行时间,但计算资源消耗和实验成本依然可能很高。
因此,对于昂贵的 Black-box Optimization,如何减少真实函数评价次数,成为优化算法研究中的重要问题。
2.2 Surrogate-Assisted Evolutionary Algorithms
为解决上述问题,研究人员提出了 Surrogate-Assisted Evolutionary Algorithms(SAEAs),即代理模型辅助进化算法。
其基本思想是利用代理模型参与优化过程,让算法无需对每个候选解都立即进行真实评价。
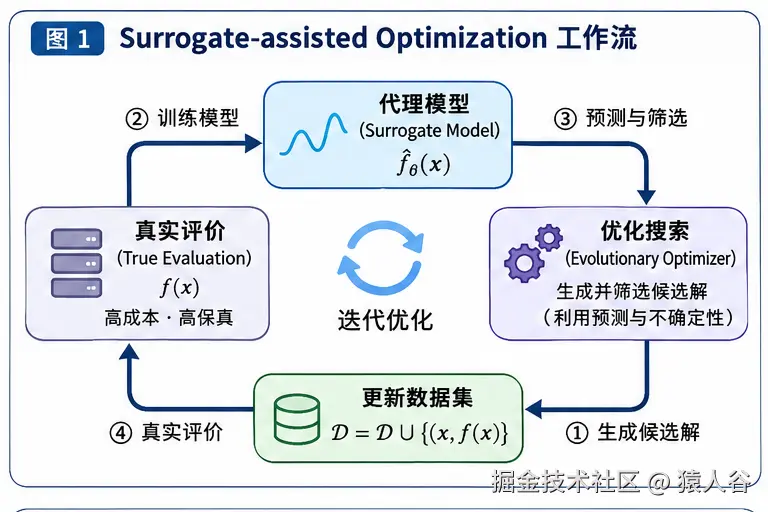
一个典型的代理辅助优化过程包括以下几个阶段:首先,收集真实评价数据。 通过初始采样、历史实验或已有系统日志,获得一组候选解及其真实目标函数值,形成训练数据集。
其次,训练代理模型。 选择 Gaussian Process、Random Forest、Neural Network 或其他回归模型,学习决策变量与目标函数之间的关系。
然后,利用代理模型辅助搜索。 优化器可以通过代理预测对候选解进行筛选,也可以使用不确定性估计决定下一批需要真实评价的方案。
最后,使用真实评价结果更新模型。 对选出的候选解执行真实评价,将新数据加入训练集,并在必要时重新训练代理模型。
这一过程形成了一个持续反馈的优化循环:
真实评价 → 代理学习 → 候选解搜索 → 真实验证 → 模型更新。
代理模型的目标不是消除所有真实评价,而是更加合理地使用有限的真实评价预算。不过,一个重要的研究问题随之出现:如果代理模型的预测不准确,优化算法是否会受到误导?要回答这个问题,就需要进一步理解代理模型的数学原理,以及预测不确定性在优化中的作用。
03. Surrogate Model 的数学基础
3.1 从监督学习角度理解代理模型
从机器学习角度看,Surrogate Model 本质上是一类监督学习模型。
假设真实目标函数为:
f:X→R
我们首先选择 n 个候选解:
x1,x2,...,xn
通过真实评价获得:
yi=f(xi)
形成训练数据集:
Dn={(xi,yi)}i=1n
随后,利用这些数据训练代理模型:
y^i=f^θ(xi)
如果使用常见的 Mean Squared Error(MSE)作为训练损失,则有:
L(θ)=n1i=1∑n(f^θ(xi)−yi)2
训练目标是寻找一组模型参数,使预测结果与真实观测之间的误差尽可能小:
θ∗=argθminL(θ)
这是代理模型最基础的数学形式。当然,不同模型具有不同的训练方法。例如 Gaussian Process 通常通过概率建模和边际似然估计参数,并不一定使用普通 MSE 进行训练。
3.2 预测准确并不意味着优化有效
如果我们只是开发一个普通回归模型,可能主要关注 Mean Absolute Error(MAE)、Root Mean Squared Error(RMSE)或者 R2 等指标。但对于优化问题,情况更加复杂。
假设存在三个候选方案:
| Solution | True Cost | Predicted Cost |
|---|---|---|
| A | 100 | 103 |
| B | 90 | 95 |
| C | 80 | 120 |
虽然代理模型对 A、B 的预测误差不大,但它错误地认为 C 是成本最高的方案。如果优化器完全依赖代理预测,就可能错过真正最优的 C。
因此,一个具有较低整体预测误差的模型,不一定能够帮助优化器找到更好的解。
对于代理辅助优化,我们不仅需要关注 Prediction Accuracy,还需要关注 Ranking Quality、Local Accuracy 和最终的 Optimization Performance。这也是为什么 Surrogate Model 的评价标准,不能简单等同于普通机器学习回归任务。
04. 主流 Surrogate Model:为什么 Gaussian Process 如此重要?
Surrogate Model 并不是某个具体算法,而是一类能够近似复杂目标函数的模型。在智能优化研究中,常见方法包括 Gaussian Process(GP)、Radial Basis Function(RBF)、Random Forest(RF)、Neural Network(NN)以及 Ensemble Models 等。
| 模型 | 主要特点 | 典型优势 | 主要挑战 |
|---|---|---|---|
| Gaussian Process | 概率函数建模 | 可提供预测均值与不确定性 | 大样本训练成本高 |
| RBF | 径向基函数近似 | 适用于一定规模的连续优化 | 高维和样本分布复杂时可能受限 |
| Random Forest | 决策树集成 | 能处理复杂非线性与混合特征 | 不确定性估计需要额外考虑 |
| Neural Network | 深度非线性映射 | 适用于复杂函数和较大数据集 | 依赖数据质量与训练设置 |
| Ensemble Model | 多模型联合预测 | 可利用模型分歧辅助不确定性分析 | 计算与校准成本较高 |
对于进化计算和昂贵黑盒优化,我认为 Gaussian Process 是一个非常值得优先掌握的模型。原因在于,GP 不仅能够预测候选解的目标函数值,还能够描述模型对预测结果的不确定性。这使它不仅是一个 Regression Model,也能够成为优化决策的重要组成部分。
4.1 Gaussian Process 的基本思想
Gaussian Process(高斯过程)可以理解为对函数本身进行概率建模。
其标准表达为:
f(x)∼GP(m(x),k(x,x′))
其中, m(x) 为 Mean Function, k(x,x′) 为 Covariance Function,也称为 Kernel Function。
均值函数描述我们对目标函数平均行为的先验假设,而核函数描述两个输入位置对应的函数值之间具有怎样的相关性。
一种常见的核函数是 Radial Basis Function Kernel:
k(x,x′)=σf2exp(−2ℓ2∥x−x′∥2)
其中, σf2 控制函数变化幅度, ℓ 为 Length Scale,控制相关性随输入距离衰减的速度。
直观来说,如果两个候选解在决策空间中比较接近,核函数通常会认为它们的目标函数值具有较强相关性。但这种关系本质上属于建模假设,并非所有优化问题都天然满足。
4.2 Gaussian Process 的两个重要输出
对于一个新的候选解 x∗,Gaussian Process 可以提供:
μ(x∗)
以及:
σ2(x∗)
其中, μ 表示预测均值, σ2 表示预测方差。
在假设独立高斯观测噪声的标准 GP 回归模型中,其预测均值可以表示为:
μ(x∗)=m(x∗)+k∗⊤(K+σn2I)−1(y−mX)
对应的潜在函数预测方差为:
σ2(x∗)=k(x∗,x∗)−k∗⊤(K+σn2I)−1k∗
其中, K 是训练数据之间的核矩阵, k∗ 表示新候选解与训练样本之间的相关性, σn2 表示观测噪声方差。
这些公式看起来比较复杂,但最重要的思想其实很简单:Gaussian Process 不仅告诉我们一个方案可能有多好,还尝试告诉我们模型对这个判断有多大的把握。
正是这种 Prediction + Uncertainty 的组合,使 Gaussian Process 在 Bayesian Optimization 和 Surrogate-Assisted Optimization 中具有重要地位。
05. Acquisition Function:如何决定下一次评价哪个候选解?
有了代理模型之后,一个新的问题出现了:如果模型能够预测成千上万个候选解的表现,究竟应该选择哪个方案进行真实评价?
这就涉及 Exploration--Exploitation Trade-off,即探索与利用之间的权衡。Exploitation 表示优先尝试当前预测较好的区域,尽可能利用已有知识找到更优解。Exploration 则强调对模型了解不足的区域进行评价,避免因过度依赖当前预测而错过未知的优良区域。
Acquisition Function(采集函数)正是用于指导这一选择的工具。
5.1 Lower Confidence Bound(LCB)
对于最小化问题,一种常见的 Acquisition Function 是 Lower Confidence Bound:
LCB(x)=μ(x)−κσ(x)
其中, μ(x) 是预测目标函数值, σ(x) 是预测标准差, κ 是控制不确定性权重的参数。
优化器选择:
xnext=argxminLCB(x)
当 κ 较小时,优化器更加关注预测均值较低的候选解;当 κ 增大时,不确定性较高的区域会获得更多探索机会。
例如,某个候选解的预测成本为 100,但不确定性很高;另一个候选解的预测成本为 95,但预测非常稳定。优化器最终选择哪个方案,取决于搜索阶段和不确定性权重。
这说明代理辅助优化并不只是简单选择 Predicted Fitness 最低的解,而是可以进一步利用模型的不确定性信息指导搜索。
5.2 Expected Improvement(EI)
另一种经典方法是 Expected Improvement,即期望改进。
对于最小化问题,设当前已知最佳目标函数值为 fbest,则候选解的改进量可以表示为:
I(x)=max(0,fbest−Y(x))
其中, Y(x) 表示代理模型在候选位置上的随机预测变量。
Expected Improvement 定义为:
EI(x)=EI(x)
如果预测服从高斯分布,可以进一步推导为:
EI(x)=(fbest−μ)Φ(z)+σϕ(z)
其中:
z=σfbest−μ
Φ 和 ϕ 分别是标准正态分布的累计分布函数与概率密度函数。这里假设 σ>0,并采用不额外引入改进阈值的定义。
EI 的核心思想是,同时考虑候选解可能取得的改进幅度,以及该改进发生的概率。通过这些 Acquisition Functions,代理模型能够从简单的预测工具,进一步成为优化器选择真实评价点的重要依据。
06. EvoGO:代理模型如何从 Fitness Prediction 走向 Generative Search?
最近研究的 EvoGO 论文提供了一个很有意思的案例。传统代理辅助进化算法主要通过代理模型估计候选解的 Fitness,而 EvoGO 希望进一步学习产生候选解的过程。
其核心搜索映射为:
xt+1=γϕt(xt)
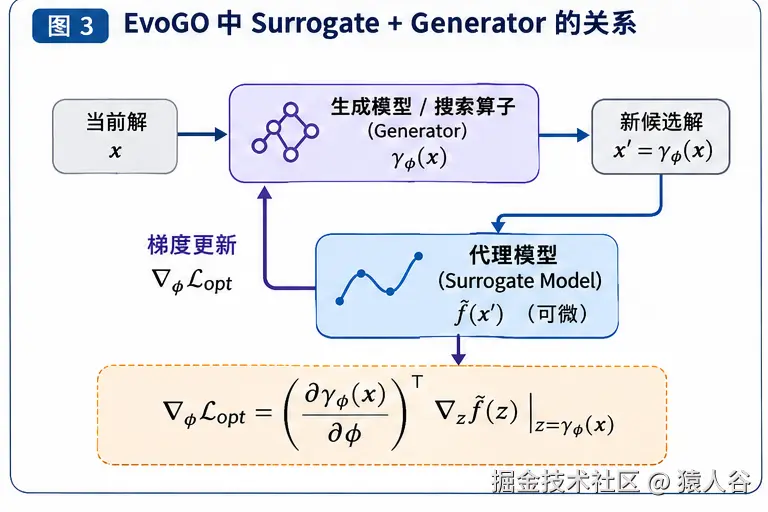
其中, γϕt 是训练后的生成模型。EvoGO 的关键设计之一,是将 Surrogate Model 与 Generative Model 结合,使代理模型预测的优化信息能够参与生成模型的训练。
6.1 两类模型分别学习什么?
在 EvoGO 中,Surrogate Model 主要学习:
x→f(x)
即候选解与目标函数之间的近似关系。
而 Generative Model 主要学习:
x→x′
即如何将当前候选解转换为新的候选解。两者承担着不同的任务。前者学习目标函数的近似结构,后者学习搜索行为。
6.2 为什么代理模型可以指导生成模型训练?
为了理解其中的数学机制,可以先考虑一个简化的 Optimization Loss:
Lopt(ϕ)=f~(γϕ(x))
其中, f~ 表示可微分的代理模型。
利用链式法则可以得到:
∇ϕLopt=(∂ϕ∂γϕ(x))⊤∇zf~(z) z=γϕ(x)
这一公式表明,代理模型对候选解的预测梯度,可以通过反向传播传递给生成模型,从而指导生成模型参数更新。
也就是说,即使真实目标函数不可微,生成模型仍然可以借助可微代理模型获得训练信号。
当然,这里展示的是用于理解梯度传播的简化形式。EvoGO 原文实际采用的损失函数还包含 Similarity、Reconstruction、Uncertainty 等相关项,并不能简单等同于上述公式。
6.3 结合 EvoGO 的实际复现实验
在此前的 EvoGO 论文复现中,我使用 Mac M2 和 JAX,在 Rosenbrock 5D 问题上完成了一个小规模端到端实验。
实验配置包括 Population Size 为 100、5 次种群更新和 600 次真实 Function Evaluations,最终得到约 5.3489 的 Best Fitness。
在运行日志中,可以清楚看到 Gaussian Process 的训练过程:
text
Training Gaussian Process ...
Loss epoch 80/1600 ...
...
Loss epoch 1600/1600 ...
这正是 EvoGO 训练代理模型的环节。不过,GP Training Loss 和 Rosenbrock Best Fitness 是两种不同的指标。GP Loss 下降意味着代理模型的训练目标改善,但只有真实 Fitness 的变化,才能说明优化算法是否找到了更好的候选解。
此外,减少真实函数评价次数并不一定意味着总运行时间更短,因为模型训练、预测和数据处理也需要消耗计算资源。
因此,对 Surrogate-assisted Optimization 的性能评价,必须同时关注 Function Evaluations、Best Fitness 和 Wall-clock Time。
07. DWSGP:代理模型能否降低云调度规则的演化成本?
另一篇值得联系起来研究的论文是:
Budget and SLA Aware Dynamic Workflow Scheduling in Cloud Computing with Heterogeneous Resources(Yang et al., 2021)。
该论文发表于 2021 IEEE Congress on Evolutionary Computation(CEC),提出 Dynamic Workflow Scheduling Genetic Programming(DWSGP),利用 Genetic Programming Hyper-Heuristic 自动生成动态云工作流调度规则。
与 EvoGO 主要学习候选解生成机制不同,DWSGP 学习的是实际任务调度策略:当一个工作流任务进入 Ready 状态时,根据任务状态和虚拟机状态,为候选 VM 计算优先级,并选择相应的执行资源。
7.1 DWSGP 优化什么?
论文从 SaaS Provider 的角度出发,考虑两种主要经济成本:VM Rental Fees(虚拟机租赁费用)与 SLA Violation Penalties(工作流超过 Deadline 产生的违约罚金)。
论文的目标函数可以表示为:
minF=i∈W∑DPCi+k∈RVMS∑RFk
其中, DPCi 为工作流的 Deadline Penalty Cost, RFk 为虚拟机租赁费用。
DWSGP 使用 GP Tree 表达调度规则,并通过 Cloud Simulator 评价每棵 GP Tree 的总成本。算法不断演化规则,希望找到能够兼顾租赁成本和 SLA 要求的调度策略。
7.2 为什么 DWSGP 也可能需要代理模型?
论文实验设置中的 GP Population Size 为 1024,Generations 为 50,每个 GP Individual 的评价次数设为 3。
如果按每代完整评价全部个体计算,其名义仿真评价工作量为:
1024×50×3=153,600
实际调用次数需要结合实现中的精英保留及其他评价机制确认,但这一设置已经说明,调度规则的演化需要大量仿真评价。
而每一次 Fitness Evaluation 都可能涉及多个动态到达的工作流、任务依赖、虚拟机选择和经济成本计算。
因此,降低 GP Tree 的评价成本具有实际意义。事实上,作者在论文 Conclusion 中明确提出,未来可以考虑使用 Surrogate Model 提高 DWSGP 的计算效率。
7.3 与 EvoGO 的区别
虽然两篇论文都与自动学习优化策略有关,但它们并不处于同一个算法层次。
| 比较维度 | DWSGP(2021) | EvoGO(2026) |
|---|---|---|
| 主要领域 | Dynamic Cloud Workflow Scheduling | Evolutionary Black-box Optimization |
| 自动学习对象 | Scheduling Rule | Search Operator |
| 候选解表示 | GP Syntax Tree | 连续决策向量 |
| 核心机制 | Genetic Programming Hyper-Heuristic | Generative Learning |
| Surrogate 角色 | 论文提出的未来可能方向 | 已包含在核心方法中 |
| 优化目标 | VM 租赁费与 SLA 罚金 | 各类 Benchmark 的目标函数值 |
这里还有一个重要的研究问题:DWSGP 的候选解是可变结构的 GP Tree,而 EvoGO 主要处理固定维度的连续向量。
如果希望为 GP Tree 建立 Surrogate Model,就需要进一步解决规则结构的表示问题,例如 Tree Features、Behavioral Features、Tree Kernels 或 Graph Neural Network Embeddings。
因此,代理模型并不是可以直接套用到所有优化算法中的通用模块,它的具体设计必须考虑候选解的表示方式和实际优化任务。
08. Surrogate Model 最大的风险:优化器可能学会利用模型的错误
代理模型能够降低真实评价成本,但同时也引入了模型误差。
假设:
f^(x)=f(x)+e(x)
其中, e(x) 是代理模型的预测误差。
如果优化器不断寻找:
argxminf^(x)
那么它可能并不是在寻找真实目标函数的最优区域,而是在寻找代理模型错误预测出较低目标值的区域。
这种现象通常被称为 Surrogate Exploitation。
例如,真实成本为 150 的候选方案,代理模型却预测其成本只有 60。如果优化器过度相信这个预测,就可能优先选择实际上很差的方案。
更值得注意的是,优化器的搜索能力越强,它可能越容易发现代理模型在训练数据之外的错误区域。
因此,更强的优化能力,并不一定能弥补代理模型的不准确。两者结合不当,反而可能放大预测误差。
解决这一问题可以考虑 Trust-region Optimization、Uncertainty-aware Candidate Selection、Periodic True Evaluation 等机制,但不同机制的有效性仍然需要通过严格实验验证。
09. Dynamic Workloads:为什么静态准确的代理模型可能突然失效?
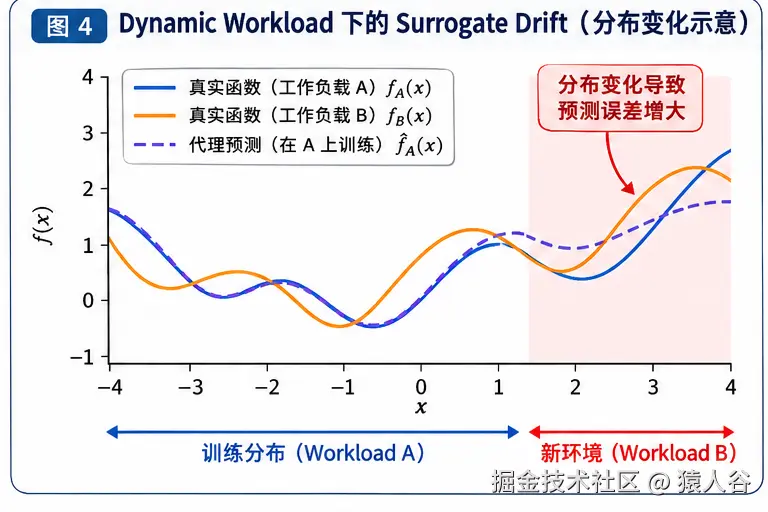
对于动态云资源调度,我认为 Surrogate Model 最值得深入研究的问题之一,是环境变化下的可靠性。
假设在 Workload A 下训练代理模型:
f^A(x)
当工作负载变化为 Workload B,即使资源配置保持不变,其真实性能也可能明显变化:
fA(x)=fB(x)
例如,同样为某个微服务分配 2 Cores CPU 和 4 GiB Memory,在每秒 100 个请求和每秒 1000 个请求的条件下,P95 Latency 可能有显著差异。
如果代理模型没有充分考虑 Workload Context,它可能无法正确预测变化后的系统表现。
因此,可以进一步构建条件化代理模型:
f^θ(x,wt)
其中, wt 表示当前工作负载状态,例如 Request Arrival Rate、CPU Utilization、Queue Length、Traffic Pattern 或服务依赖特征。
不过,加入更多状态特征并不意味着泛化能力一定更强。模型仍然可能因为训练数据覆盖不足、环境漂移或输入分布变化而产生错误预测。
这也引出了三个需要明确区分的研究概念:Dynamic Optimization 关注优化目标或环境随时间变化时,算法如何持续寻找更好的解;Robust Optimization 关注扰动和不确定性条件下的可靠性能;Generalization 则关注模型或策略能否在训练阶段未见过的工作负载与环境中保持有效。
这三个问题相互联系,但并不等价。对于云资源分配而言,真正困难的地方可能不是训练一个能够预测 Latency 或 Cost 的模型,而是让这个模型在工作负载改变、资源发生争用、服务拓扑变化时,仍然能够可靠地支持优化决策。
10. 如何判断一个 Surrogate Model 是否真正有效?
如果将 Surrogate Model 用于优化算法,评价指标不应该只有 RMSE。
我更倾向于建立以下多层评价体系:
| Evaluation Dimension | 代表指标 | 研究目的 |
|---|---|---|
| Prediction Accuracy | MAE、RMSE、 R2 | 预测是否准确 |
| Ranking Quality | Spearman Correlation、Pairwise Accuracy | 能否正确比较候选解 |
| Uncertainty Quality | Calibration、Interval Coverage、NLL | 预测不确定性是否可信 |
| Optimization Performance | Best Fitness、Regret | 是否帮助找到更好的解 |
| Sample Efficiency | FEs to Target | 是否减少真实评价次数 |
| Computational Efficiency | Runtime、Training Cost | 是否真正降低计算成本 |
| Generalization | Test Performance、Degradation | 未见过的环境下是否有效 |
| Robustness | Worst-case Cost、Recovery Time | 环境扰动后是否可靠 |
这里尤其需要注意两个问题。首先,预测误差小并不自动意味着优化效果好。如果代理模型在多数普通区域预测准确,却在最有潜力的区域预测错误,优化器仍然可能被误导。
其次,减少真实 Function Evaluations 并不自动意味着更高的整体效率。如果代理模型训练成本很高,其额外开销可能抵消减少评价次数带来的收益。
因此,研究 Surrogate-Assisted Optimization 时,应该同时考虑预测质量、搜索质量和总体计算成本,而不是只关注单一指标。
11. 动手实践:使用 Python 构建一个 Gaussian Process Surrogate
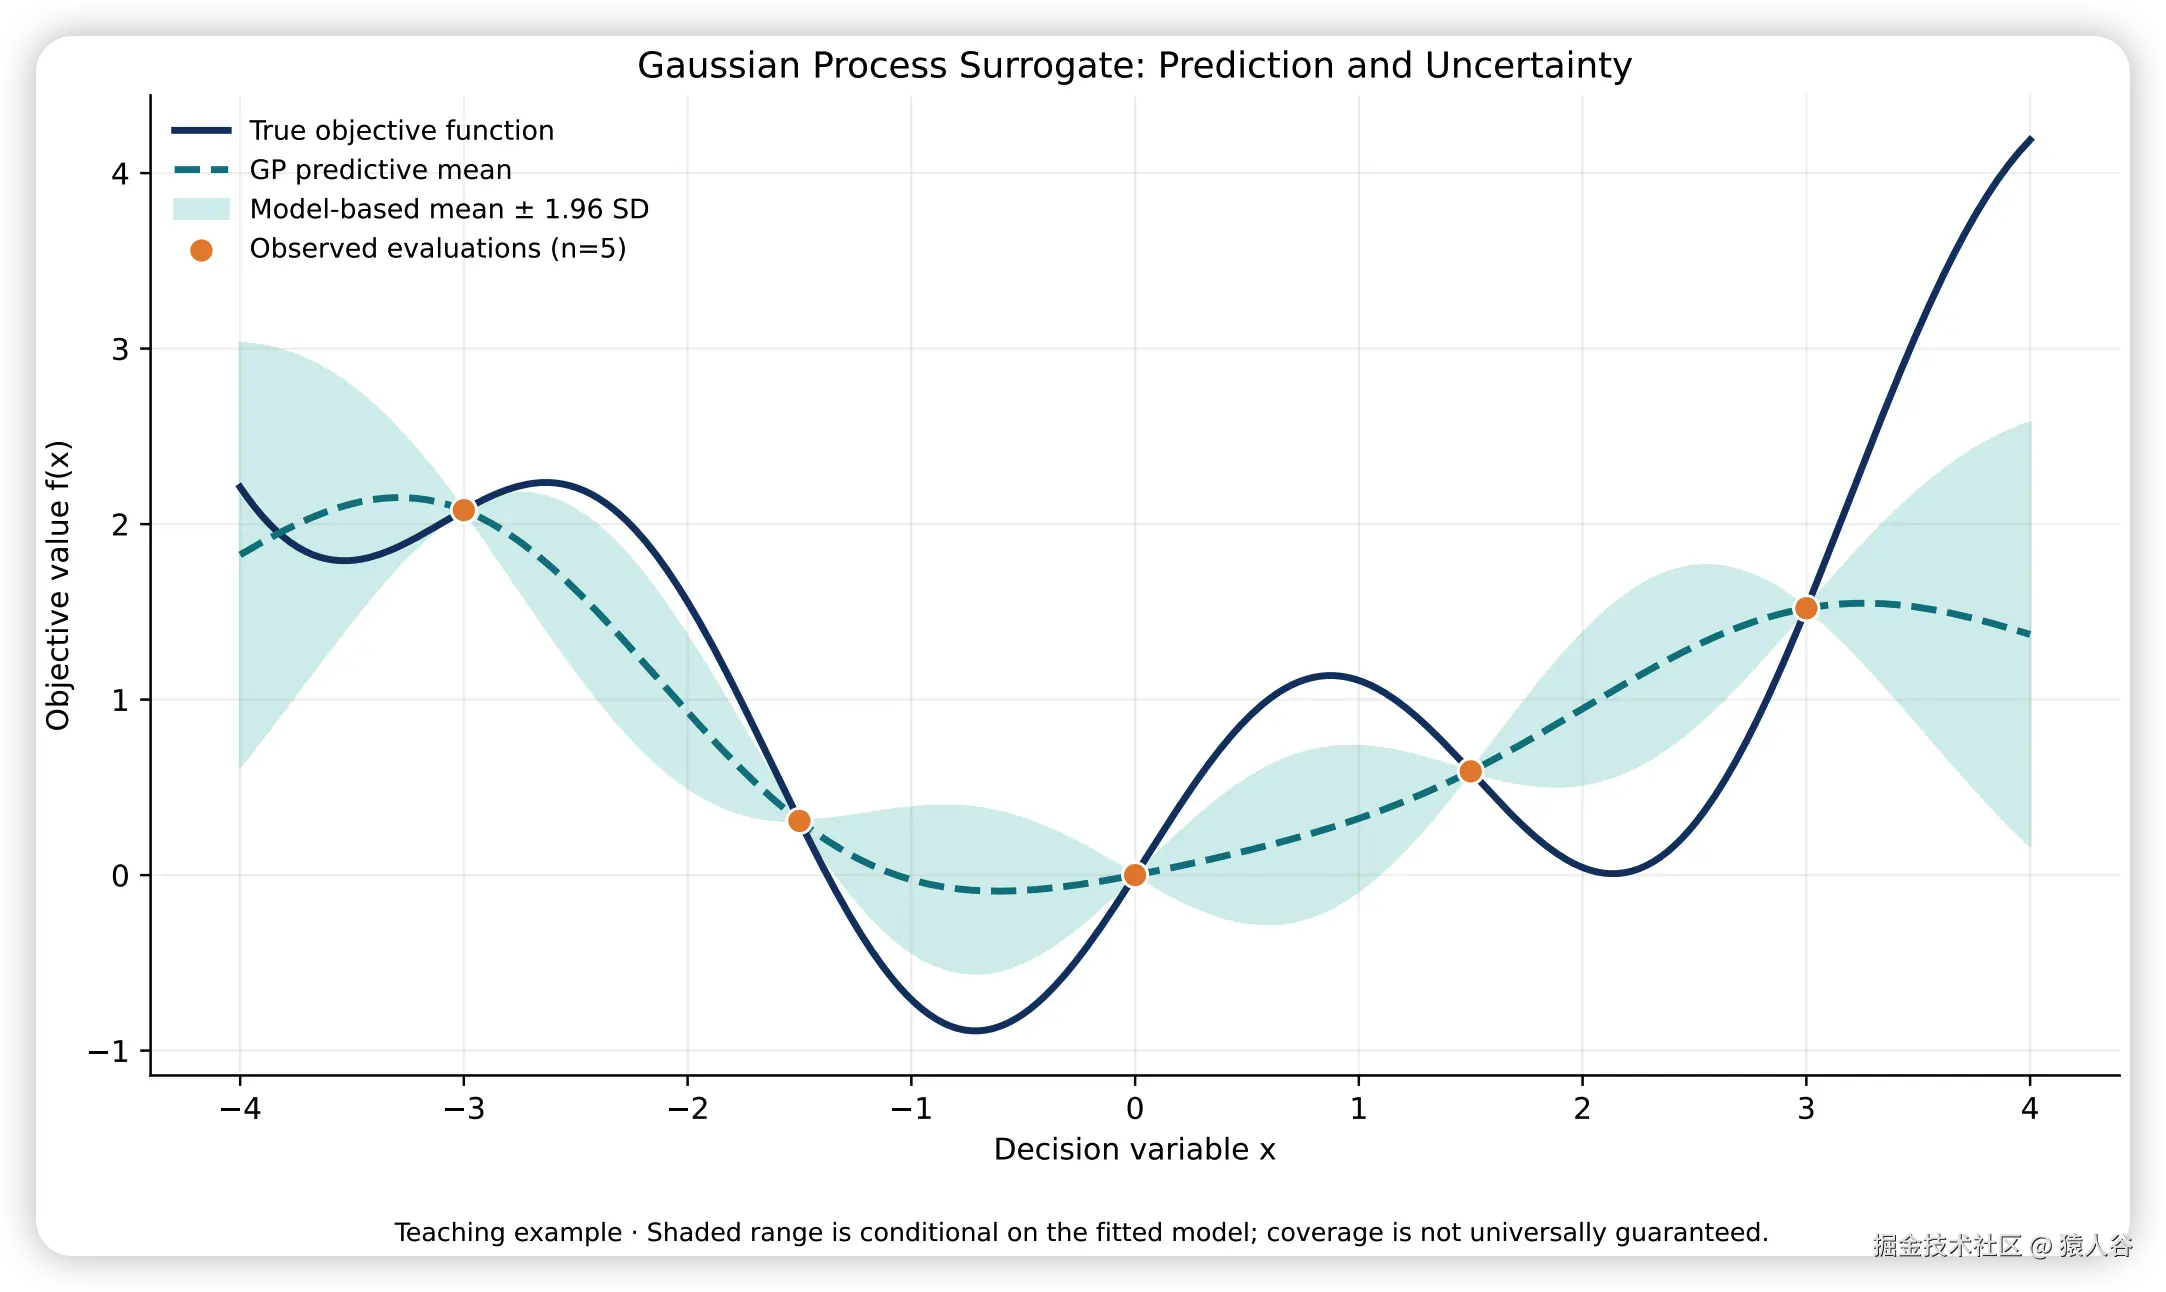
为了更直观地理解 Surrogate Model,可以设计一个简单的一维实验:只使用少量真实观测点训练 Gaussian Process,然后绘制真实函数、预测均值和预测区间。
首先定义一个目标函数:
f(x)=sin(2x)+0.2x2
选择少量训练样本,再使用 Scikit-learn 的 GaussianProcessRegressor 拟合目标函数。
核心代码如下:
python
import numpy as np
import matplotlib.pyplot as plt

from sklearn.gaussian_process import GaussianProcessRegressor
from sklearn.gaussian_process.kernels import RBF, ConstantKernel


def true_function(x):
    return np.sin(2 * x) + 0.2 * x**2


# 少量真实观测点
X_train = np.array([-3, -1.5, 0, 1.5, 3]).reshape(-1, 1)
y_train = true_function(X_train.ravel())

# Gaussian Process
kernel = ConstantKernel(1.0) * RBF(length_scale=1.0)

gp = GaussianProcessRegressor(
    kernel=kernel,
    normalize_y=True,
    random_state=42
)

gp.fit(X_train, y_train)

# 预测
X_test = np.linspace(-4, 4, 400).reshape(-1, 1)
mean, std = gp.predict(X_test, return_std=True)

# 可视化
plt.figure(figsize=(9, 5))
plt.plot(X_test, true_function(X_test.ravel()), label="True Function")
plt.plot(X_test, mean, label="GP Prediction")
plt.fill_between(
    X_test.ravel(),
    mean - 1.96 * std,
    mean + 1.96 * std,
    alpha=0.2,
    label="Approx. 95% Interval"
)
plt.scatter(X_train, y_train, label="Observed Data")
plt.xlabel("Decision Variable x")
plt.ylabel("Objective Value")
plt.legend()
plt.grid(alpha=0.3)
plt.tight_layout()
plt.savefig("surrogate_gp.pdf")
plt.show()
运行后,可以观察代理模型在不同位置的预测均值及不确定性范围。需要说明的是,图中的预测区间依赖 GP 模型假设,并不保证对任意真实函数都具有严格的 95% 覆盖率。
在这个基础上,还可以进一步开展三个小实验:增加训练样本数量,观察数据覆盖对预测的影响;改变 Kernel Length Scale,研究核函数假设如何影响函数拟合;改变真实函数的形状,在不重新训练的情况下测试代理模型的预测退化。
例如,将原始目标函数:
fA(x)=sin(2x)+0.2x2
调整为:
fB(x)=sin(2x+1)+0.2x2
如果仍然使用原先训练的代理模型,就可以直观观察环境变化对预测性能的影响。
这种简单的实验虽然远比真实云资源调度容易,但它能够帮助我们建立对 Surrogate Error、Distribution Shift 和 Online Adaptation 的直觉,为后续研究动态优化问题打下基础。
12. 从代理模型走向更可靠的智能优化
回顾 Surrogate Model 的发展脉络,可以发现它正在承担越来越丰富的角色。
最初,我们主要利用代理模型近似昂贵的目标函数,希望减少真实评价次数。随后,Gaussian Process 和 Bayesian Optimization 等方法进一步利用预测不确定性,在 Exploration 与 Exploitation 之间取得平衡。
在 Surrogate-Assisted Evolutionary Algorithms 中,代理模型开始参与种群搜索与候选解筛选。而 EvoGO 等研究则进一步尝试将可微代理模型与生成式学习结合,让代理信息参与搜索算子的训练。
与此同时,DWSGP 等动态云调度研究也表明,自动生成调度规则虽然可以减少人工启发式设计的依赖,但大量仿真评价仍然构成重要计算成本,代理模型因此成为值得探索的加速方向。
这些研究之间存在一个共同的技术逻辑:通过学习历史评价数据,使优化过程更加高效,并减少对昂贵真实评价或人工设计规则的依赖。
然而,随着代理模型在优化系统中的作用越来越重要,其误差、不确定性和泛化能力也逐渐成为核心问题。
对于动态云资源调度,未来值得深入研究的可能不只是如何训练一个更准确的代理模型,而是如何让代理模型与进化搜索策略协同工作,使优化器在环境变化、预测误差和未知工作负载下仍然能够维持可靠表现。
从科研角度看,这也提出了几个值得进一步调查的问题:代理误差如何影响搜索算子的行为?如何判断何时应该重新训练模型?能否在有限真实评价预算下快速适应新的工作负载?是否可以建立具有跨任务迁移能力的代理辅助优化策略?
这些问题尚需结合现有文献判断其研究边界和原创性,但它们为 Dynamic Optimization、Robust Optimization 和 Generalization 的交叉研究提供了有价值的思考方向。
Surrogate Model 的真正价值,并不只是让优化算法预测得更快,而是帮助优化器在有限信息、有限预算和不确定环境下,做出更加有效且可靠的搜索决策。
参考文献(References)
1 Jiang, T., Sun, K., Liang, Z., Cheng, R., Jin, Y., & Tan, K. C. (2026). Evolutionary generative optimization: Towards fully data-driven evolutionary optimization via generative learning . IEEE Transactions on Evolutionary Computation . Accepted manuscript. doi.org/10.1109/TEV...
2 Yang, Y., Chen, G., Ma, H., Zhang, M., & Huang, V. (2021). Budget and SLA aware dynamic workflow scheduling in cloud computing with heterogeneous resources. 2021 IEEE Congress on Evolutionary Computation (CEC) . doi.org/10.1109/CEC...
3 Jones, D. R., Schonlau, M., & Welch, W. J. (1998). Efficient global optimization of expensive black-box functions. Journal of Global Optimization, 13 , 455--492. doi.org/10.1023/A:1...
4 Jin, Y. (2011). Surrogate-assisted evolutionary computation: Recent advances and future challenges. Swarm and Evolutionary Computation, 1 (2), 61--70. doi.org/10.1016/j.s...
5 Rasmussen, C. E., & Williams, C. K. I. (2006). Gaussian Processes for Machine Learning . MIT Press. gaussianprocess.org/gpml/
6 JAX Developers. JAX Documentation . docs.jax.dev/
7 Scikit-learn Developers. Gaussian Process Regression . scikit-learn.org/stable/modu...
8 Matplotlib Development Team. Matplotlib Documentation . matplotlib.org/