前言:你以为的脱敏,可能只是"掩耳盗铃"
在数据安全测试中,你是不是以为只要在 SELECT 层面对敏感字段加了 MASK() 函数,就万事大吉了?
举个真实的例子:ROW_NUMBER() OVER (PARTITION BY id_card ORDER BY trade_time)。
如果你只解析了 SELECT 层,你可能觉得 id_card 被脱敏了。但实际上,大数据引擎在执行这行代码时,底层必须要拿明文的 id_card 去进行 Shuffle 分区! 如果引擎识别不出 OVER() 里面的字段,你的脱敏策略直接就漏成了筛子。
在真实的金融数仓中,还有一种极其常见的 SQL 写法:对敏感字段做 CASE WHEN 逻辑判断(比如根据身份证号判断性别)。如果你只解析了 SELECT 层,这种场景同样会成为脱敏的致命盲区!
一旦发生数据泄露,根本查不到源头。今天我们就来死磕这两个大魔王。
💡开源项目地址::Hermes-SQL
字段级血缘追踪进阶
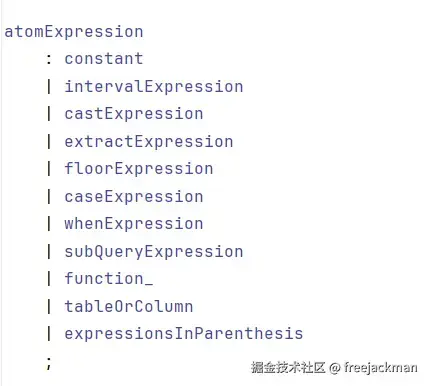
📍 第一战:拆解多源分支 ------ CASE WHEN 的"千层套路"
在Hive SQL的语法文件中,CASE WHEN 分为两种:简单 CASE(CASE col WHEN 1 THEN...)和搜索 CASE(CASE WHEN col=1 THEN...),对应语法文件节点分别为caseExpression 和whenExpression。
业务难点? 它并不是真正的 function_,在实际业务场景中,一个 CASE 里可能有多个 WHEN、THEN、ELSE 分支。如果你直接把它们全平铺塞进血缘列表,你根本不知道某个字段到底是哪个分支的。
怎么解? 把它当成一个特殊的虚拟函数 CASE。定义四个专属的参数类型:CASE_BASE(基准列)、CASE_WHEN_COND(条件)、CASE_WHEN_RESULT(结果)、CASE_ELSE(兜底)。
在遍历时,我们需要向上寻找最近的 CaseExpressionContext 祖先节点,然后通过判断当前表达式的前置 Token (是 KW_CASE、KW_WHEN 还是 KW_THEN),将其精准归类组装进 FunctionArgument 列表中。
java
int tokenType = ((TerminalNode) lbrother).getSymbol().getType();

if (tokenType == HiveParser.KW_CASE) {
    functionArgument.type = ArgumentType.CASE_BASE;
} else if (tokenType == HiveParser.KW_WHEN) {
    functionArgument.type = ArgumentType.CASE_WHEN_COND;
} else if (tokenType == HiveParser.KW_THEN) {
    functionArgument.type = ArgumentType.CASE_WHEN_RESULT;
} else if (tokenType == HiveParser.KW_ELSE) {
    functionArgument.type = ArgumentType.CASE_ELSE;
}

functionInfo.arguments.add(functionArgument);   //将函数参数与函数关联
经过上述的抽丝剥茧,原本散落在 AST 里的 CASE 节点,就被完美聚合成了一个树形的 FunctionArgument 列表。当后续进行脱敏校验时,引擎能一眼看出 WHEN 条件里到底用了哪些敏感字段。
📍 第二战:深入 OVER() 子句,填平脱敏盲区
业务场景:functionName (args) OVER (PARTITION BY ... ORDER BY ... ROWS BETWEEN ...)
-
连环坑 1:上下文污染 。第四篇提过,
functionStack栈顶是ROW_NUMBER,遍历到PARTITION BY t1.id时,t1.id会被误认为ROW_NUMBER的输入参数。- 解法 :进入
window_specification节点时,打上isInsideWindowSpec = true标记,拦截参数挂载。
- 解法 :进入
java
//完善select 查询列信息

public void enterPrecedenceFieldExpression(HiveParser.PrecedenceFieldExpressionContext ctx){

    //判断 当前是否在 窗口函数的over()当中
    if (isInsideWindowSpec) {
        return;
    }

   //处理查询列的具体情况......
}
java
//设置 是否在窗口函数中 的标识为true
public void enterWindow_specification(HiveParser.Window_specificationContext ctx) {
    isInsideWindowSpec = true;
}

//更新 是否在窗口函数中 的标识为false
public void exitWindow_specification(HiveParser.Window_specificationContext ctx) {
    isInsideWindowSpec = false;
}-
连环坑 2:数据模型不够用 。原先的
FunctionInfo存不下窗口信息。- 解法 :扩展数据模型,增加
partitionByColumns(分区字段)和orderByColumns(排序字段)。
- 解法 :扩展数据模型,增加
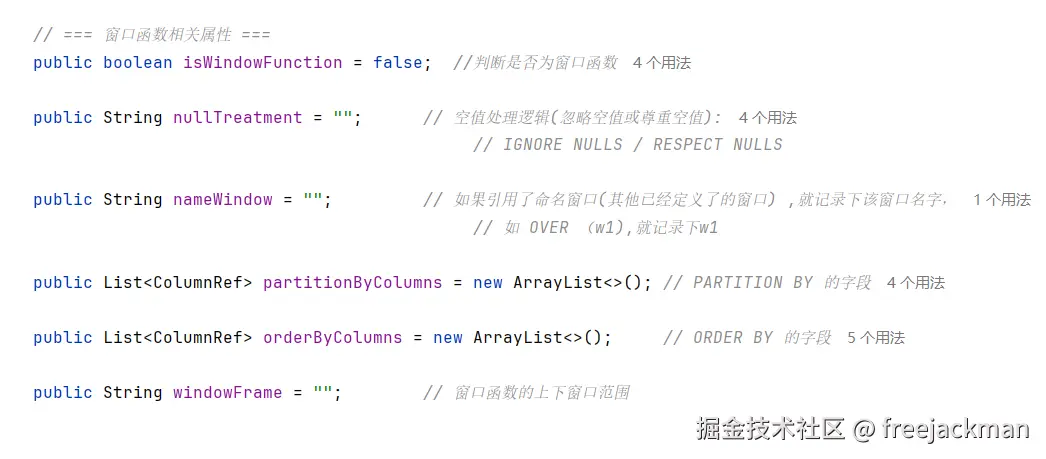
java
// 核心提取逻辑
if (ctx.KW_OVER() != null && ctx.window_specification() != null) {
    func.isWindowFunction = true;
    HiveParser.Window_specificationContext wsCtx = ctx.window_specification();

    if (wsCtx.partitioningSpec() != null) {
        // 提取 PARTITION BY
        if (wsCtx.partitioningSpec().partitionByClause() != null) {
            List<ColumnRef> partCols = astHelper.extractColumnCandidates(
                wsCtx.partitioningSpec().partitionByClause().expressions());
            optColumnRefsList(partCols);
            func.partitionByColumns.addAll(partCols);
        }

        // 提取 ORDER BY(如果存在)
        if (spec.orderByClause() != null) {

            List<ColumnRef> orderCols = astHelper.extractColumnCandidates(spec.orderByClause());
            optColumnRefsList(orderCols);

            //将functionInfo与order by 字段信息相关联
            functionInfo.orderByColumns.addAll(orderCols);
        }
    }
}
📍 第三战:安全推导 ------ 为什么要费这么大劲?
当我们处理好case when 和 窗口OVER()子句时,我们的引擎就可以做安全预警了。
前提准备 :我们的引擎会结合第一阶段的元数据服务(如 YAML 配置),识别出哪些物理字段属于敏感信息(比如 id_card_no、phone)。
此时,我们的安全扫描逻辑就非常简单粗暴了:
java
// 安全预警核心伪代码
for (ColumnRef partCol : windowFunc.partitionByColumns) {
    if (metadataService.isSensitive(partCol.columnName)) {
        System.out.println("⚠️ [安全预警] 发现敏感字段 " + partCol.columnName + " 参与 PARTITION BY 分区,脱敏可能失效!");
    }
}

// 检查 CASE WHEN 的条件字段
for (FunctionArgument arg : caseFunc.arguments) {
    if (arg.type == ArgumentType.CASE_WHEN_COND && arg.columnRef != null) {
         if (metadataService.isSensitive(arg.columnRef.columnName)) {
             System.out.println("⚠️ [安全预警] 敏感字段 " + arg.columnRef.columnName + " 参与条件判断!");
         }
    }
}- 场景1 :如果
PARTITION BY id_card_no,引擎立刻报警:"警告:敏感字段 id_card_no 参与了 Shuffle 分区,当前脱敏策略可能失效!" - 场景2 :如果
CASE WHEN phone LIKE '138%',引擎报警:"警告:敏感字段 phone 参与了条件判断,存在信息泄露风险。"
📍 第四战:顺水推舟 ------ GROUP BY 与 HAVING
除了上面Case When 和窗口函数以外,GROUP BY 和 HAVING 也是大数据常客。
- 解析它们不需要写新代码!
GROUP BY直接提取字段挂到SqlInfo.groupByColumns。 HAVING本质上就是聚合后的WHERE,它的 AST 结构和 WHERE 一模一样。可以直接复用我们后面要讲的FilterCondition模型。
📍 第五战:给数据打上"防弹标签" (transformType 升级)
经过 CASE WHEN 或 OVER() 处理的字段,数据加工类型 绝对不能再是 DIRECT 或 SIMPLE。
因此我们设定, 只要 functionChain 里出现了 CASE 或者窗口函数,或者 sourceColumns中 有多个(比如 CASE WHEN a=1 THEN b ELSE c,依赖了 a, b, c 三个字段)最终物理来源字段,就必须强制打上 COMPLEX(复杂加工)标签,这是脱敏和迁移的红色预警。
结语与预告
至此,SQL 中最复杂的表达式已经被我们彻底肢解。下一篇也是实战篇的最后一篇,我们将走向多表关联的深水区,看看 JOIN ON 和 WHERE 里的隐式关联该怎么抽丝剥茧,敬请期待😁!
🚨 数据安全测试防坑指南 🚨
在做数据脱敏验证时,除了看 SELECT 里的函数,一定要重点排查以下三个地方:
- 窗口函数的
PARTITION BY字段(明文 Shuffle)。 CASE WHEN的WHEN条件字段(即使输出被脱敏,判断条件本身可能泄露数据特征)。JOIN ON的关联字段(跨表关联时,两边都必须脱敏才能保证一致性,否则会被撞库)。