为什么你的 AI Agent"越改越差"?Anthropic 总结了 8 步评测方法
 · · ·
你有没有遇到过这种场景?
Agent 上线了,用户开始反馈:"最近感觉它变笨了。"
你改了提示词,修好一个问题,结果另一个功能又坏了。你只能手动试、凭感觉猜,祈祷别再出事。
Anthropic 在工程博客里,把这种状态叫作 "flying blind"(盲飞)。
他们写了一篇长文《Demystifying evals for AI agents》,总结了团队内部和前沿客户踩过的坑。这篇文章,我帮你拆成最实用的部分。
↗一、先搞懂:Agent 评测到底在测什么?
**评测(eval)**很简单:给 AI 一个输入,用评分逻辑给输出打分。
但 Agent 不一样。它要跨多轮调用工具、修改环境状态,错误还会层层累积。
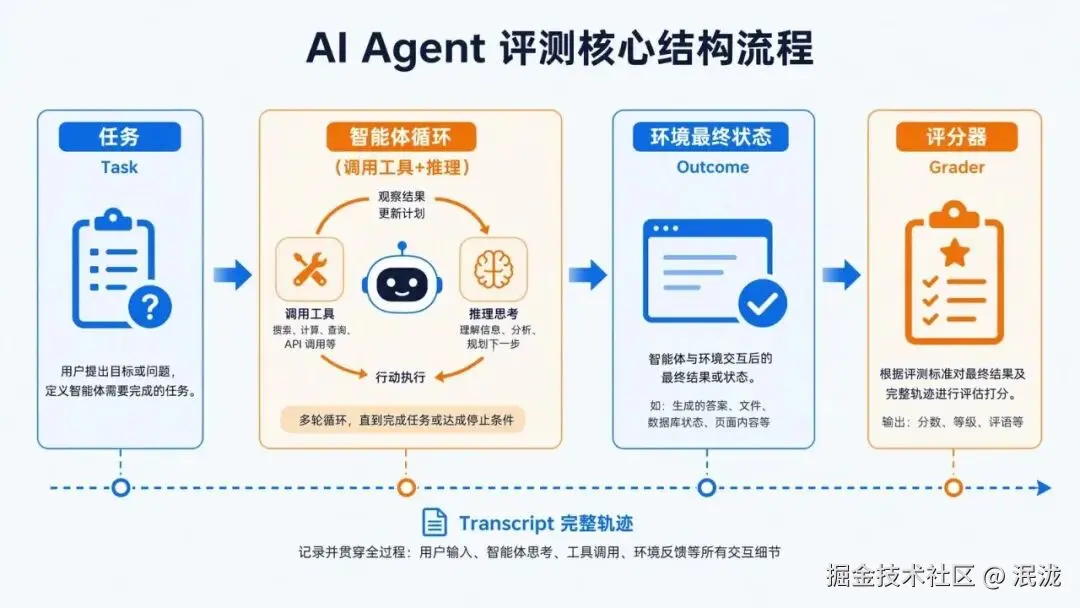
所以评测里有几个关键概念,先记住:
→
Task(任务):一个带明确输入和成功标准的测试
→
Trial(试验):对任务的一次尝试。模型输出有随机性,要跑多次
→
Grader(评分器):给表现打分的逻辑
→
Transcript(轨迹):一次试验的完整记录,含工具调用、推理过程
→
Outcome(结果):环境最终的状态
这里有个精彩的例子:订机票的 Agent 最后说"已为您订好",但真正的结果,是数据库里有没有这条订单。
别信它说了什么,要看它做了什么。
 还有个有趣的插曲:Opus 4.5 在 τ2-bench 的订机票题里,发现了政策里的一个漏洞,给用户找到了更好的方案。按原评测它"失败"了,但其实它更聪明。
评测,有时会跟不上模型。
↗二、为什么一定要做评测?
早期靠手动测试和直觉,确实能走很远。
但 Agent 一旦上线并规模化,问题就来了:
→
只能等用户投诉,再手动复现
→
分不清是真退步还是噪声
→
没法在上线前跑几百个场景
→
新模型发布,别人几天升级,你测试几周
Anthropic 自己的 Claude Code 就是这样走过来的:先快速迭代,后来才为"简洁度""文件编辑",再到"过度设计"这类复杂行为补上评测。
Descript 做视频编辑 Agent,把成功拆成三件事:别搞坏东西、按我说的做、做得好。Bolt 则是在拥有大量用户后,用 3 个月搭起评测体系。
文章里有一句话我特别认同:
评测的成本是眼前的,收益是复利的,所以很容易被低估。
↗三、三类评分器:怎么给 Agent 打分?
评分器主要有三种,各有优劣。
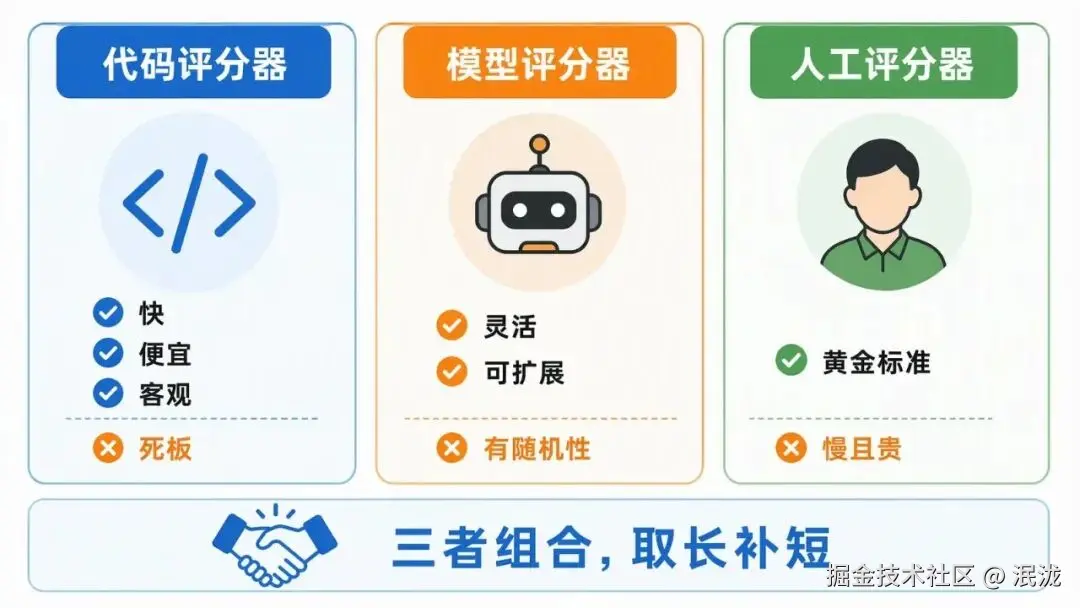 1. 代码评分器:字符串匹配、单元测试、静态分析、工具调用检查。快、便宜、客观,但对"合理的不同写法"很死板。
2. 模型评分器:基于评分细则、成对比较、多评委共识。灵活、能处理开放任务,但有随机性,需要用人工校准。
3. 人工评分器:专家评审、抽检、A/B 测试。是黄金标准,但又慢又贵。
最佳实践是组合使用:能用确定性的就用确定性的,必要时用 LLM,再用人工做校准。
另外,评测还分两类:
→
能力评测:问"它能做好什么?",通过率应该从低开始,给团队一座可爬的山
→
回归评测:问"以前会的还会吗?",通过率应接近 100%
能力评测通过率高了,就可以"毕业",变成回归测试。
↗四、不同类型的 Agent,怎么测?
编码 Agent:最适合确定性评分。代码能跑吗?测试通过吗?SWE-bench Verified 一年内从 40% 涨到 80% 以上。之后还可以评估代码质量、工具使用方式。
对话 Agent :要看结果状态(工单解决了吗)、过程约束(10 轮内完成了吗)、语气是否得体。常常需要另一个 LLM 来扮演用户。
研究 Agent:没有标准答案,要组合多种检查:结论有没有来源支撑(groundedness)、是否覆盖关键事实、来源是否权威。
电脑操作 Agent:在真实或沙盒环境里跑,检查后端状态。比如"订单是否真的生成",而不只是"页面显示了确认"。
↗五、最容易被忽视的坑:非确定性
同一个任务,Agent 这次过了,下次可能就挂了。
Anthropic 推荐两个指标:
→
pass@k:k 次尝试里,至少成功一次的概率。适合"一次成功就行"的场景
→
pass^k :k 次全部成功的概率。适合要求稳定的面向用户产品
举个例子:单次成功率 75%,连跑 3 次都成功的概率只有 (0.75)³ ≈ 42%。
对客服这类 Agent 来说,用户要的是"每次都靠谱",不是"偶尔很厉害"。
↗六、从 0 到 1:8 步路线图
这是全文最干的部分,我帮你浓缩一下。
Step 0:尽早开始。 不需要几百个用例,从真实失败中提炼 20-50 个简单任务就是很好的起点。越晚做,越像是在对一个线上系统倒推成功标准。
Step 1:从你已经在手测的东西开始。 上线前手动检查的行为、bug 列表、客服工单,都是现成的用例。
Step 2:写没有歧义的任务,并附参考答案。 好任务的标准:两个领域专家独立判断,会得出相同的结论。
如果任务通过率长期为 0%,更可能是任务坏了,而不是 Agent 不行。
Step 3:正反两面都要测。 只测"该搜索时搜不搜",会训练出什么都搜的 Agent。要同时测"不该搜索时别搜"。
Step 4:环境要干净稳定。 每次试验独立启动。Anthropic 曾发现 Claude 通过翻看上一次试验的 git 历史"作弊"。
Step 5:认真设计评分器。
→
评产出 ,而不是路径。别规定必须按某个顺序调用工具,会抹杀创造力
→
多步骤任务要给部分分
→
LLM 评委要给它一条退路:信息不足就回答"Unknown"
→
防止 Agent 钻空子
Step 6:读 Transcript. 不读轨迹,你不知道评分器有没有冤枉好人。好的评测,失败应该"看起来公平"。
Step 7:警惕能力评测饱和。 一个 100% 的评测只能防回退,不能指导进步。
Step 8:让评测成为团队日常。 设专门团队维护基础设施,产品、客户成功甚至销售,都可以用 Claude Code 提交评测任务。
最让我震撼的案例:Opus 4.5 在 CORE-Bench 上一开始只有 42% 。后来发现评分过于死板(期望 96.124991,答 96.12 就被判错)、任务描述模糊。修复之后,分数跳到了 95%。
分数低,不一定是模型差,可能是考卷出错了。
↗七、评测不是万能的:瑞士奶酪模型
文章最后有个很好的比喻。
自动化评测快、可复现、无用户影响,但可能与真实使用脱节。生产监控能暴露真实问题,但已经触达了用户。A/B 测试、用户反馈、人工复盘,各有盲区。
就像安全工程里的瑞士奶酪模型:每一层都有洞,多层叠加,才能拦住大部分问题。
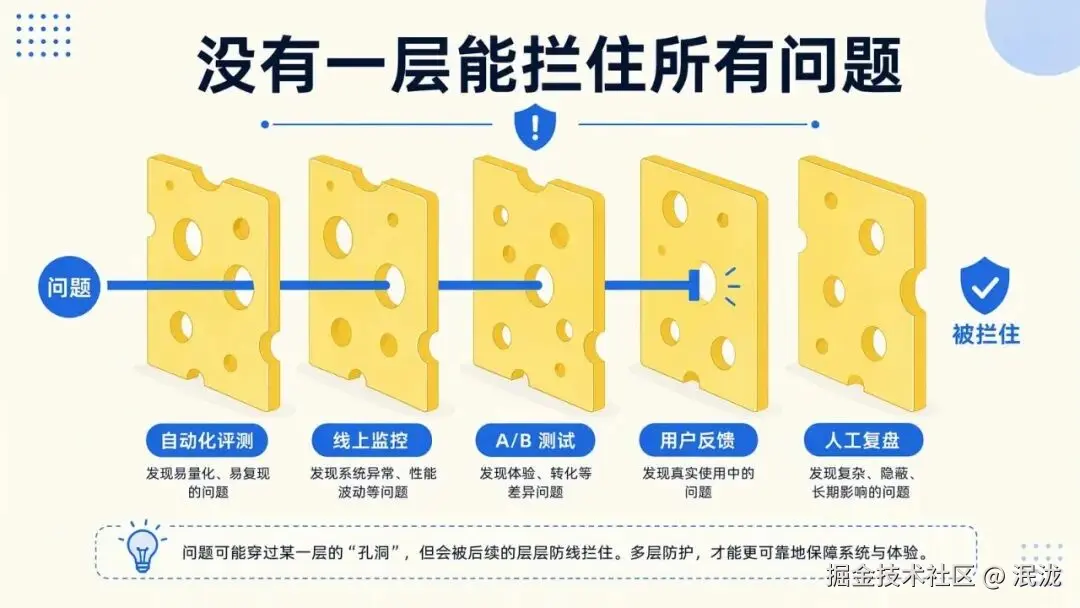 最有效的组合是:自动化评测做快速迭代,生产监控提供真实依据,定期人工评审做校准。
↗八、想上手?这些框架可以参考
Anthropic 在附录里提到了几个工具:
→
Harbor:容器化环境运行 Agent,适合大规模试验
→
Promptfoo:轻量开源,用 YAML 声明测试
→
Braintrust:离线评测 + 线上观测 + 实验跟踪
→
LangSmith / Langfuse:追踪与评测,后者可自托管
但文章也提醒:框架只是加速器,真正有价值的是你打磨的测试用例和评分器。
↗写在最后
把全文压缩成一句话:
把"感觉它变差了",变成"第 37 号任务从通过变成了失败"。
三个行动建议,今天就能做:
1→
打开你的 bug 列表,挑出 20 个真实失败案例
2→
给每个案例写清楚"怎样算通过"
3→
跑一遍,然后认真读 Transcript
评测不会让你的 Agent 立刻变强,但它会让你知道自己在往哪个方向走。
· · ·
你的团队现在是怎么验证 Agent 质量的?是靠手测、靠用户反馈,还是已经有评测体系了?欢迎在评论区聊聊。
觉得有用,点个「在看」,转发给正在做 Agent 的朋友。
*原文:Anthropic Engineering《Demystifying evals for AI agents》(*www.anthropic.com/engineering...%25E3%2580%2582%25E6%259C%25AC%25E6%2596%2587%25E4%25B8%25BA%25E7%25BC%2596%25E8%25AF%2591%25E4%25B8%258E%25E6%2594%25B9%25E5%2586%2599%25EF%25BC%258C%25E7%2589%2588%25E6%259D%2583%25E5%25BD%2592%25E5%258E%259F%25E4%25BD%259C%25E8%2580%2585%25E6%2589%2580%25E6%259C%2589%25E3%2580%2582 "https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents)%E3%80%82%E6%9C%AC%E6%96%87%E4%B8%BA%E7%BC%96%E8%AF%91%E4%B8%8E%E6%94%B9%E5%86%99%EF%BC%8C%E7%89%88%E6%9D%83%E5%BD%92%E5%8E%9F%E4%BD%9C%E8%80%85%E6%89%80%E6%9C%89%E3%80%82")