如果把深度学习看成一棵树,那么神经网络是树干,CNN 和 RNN 是两条重要分支,Encoder--Decoder 负责把"理解输入"和"生成输出"分开,而 Attention 则是通往 Transformer 的关键一步。
这篇文章不追求罗列名词,而是沿着一条主线说明:数据进入模型后经历了什么,模型又是怎样学会的。
一、神经网络究竟在做什么?
神经网络本质上是一个可以通过数据自动调整参数的函数。输入可以是一组数字、一张图片或一句话,输出可以是分数、图片类别,也可以是另一句话。
一个典型的神经网络由三部分组成:
- 输入层:接收原始数据;
- 隐藏层:不断提取、组合特征;
- 输出层:给出最终结果。
只有输入层和输出层的模型通常称为单层网络;含有一个隐藏层的网络常称为浅层神经网络;含有多个隐藏层,才是我们常说的深度神经网络。
1. 神经元:最小的计算单元
一个神经元可以理解成一台小型计算器。它先给每个输入分配一个权重,再加上偏置,最后经过激活函数:
y=f(w1x1+w2x2+⋯+wnxn+b)
其中:
- x 是输入;
- w 是权重,表示每个输入有多重要;
- b 是偏置,让模型能够整体移动判断边界;
- f 是激活函数,为网络加入非线性。
如果没有激活函数,无论叠多少层,整个网络最终仍相当于一次线性变换,无法学习复杂规律。ReLU 是最常用的激活函数之一:输入大于 0 时原样输出,小于 0 时输出 0。它计算简单,也能在一定程度上缓解梯度消失。
2. 模型是怎样学会的?
以"根据学习时长预测考试分数"为例,最简单的模型是:
y^=wX+b
训练开始时, w 和 b 通常是随机初始化的,因此预测很不准确。随后模型反复执行四步:
- 正向传播:输入学习时长,逐层计算预测分数;
- 计算损失:比较预测分数与真实分数,衡量错了多少;
- 反向传播:利用链式法则,计算每个参数对损失的影响,也就是梯度;
- 更新参数:优化器沿着让损失下降的方向调整权重和偏置。
可以把它类比为学生做题:先写答案,再对答案,分析错误来自哪一步,最后调整解题方法。经过许多轮训练,损失逐渐下降,参数中也就"记住"了数据里的规律。
训练完成后进入推理阶段。此时模型只使用学到的参数进行正向传播,不再计算损失,也不再反向传播和更新参数。
3. 为什么深层网络不好训练?
梯度可以理解成模型从错误中得到的"修改建议"。反向传播时,这份建议从最后一层逐层往前传。如果每经过一层都变小,传到前面时就可能几乎为 0,前面的参数也就很难继续学习,这就是梯度消失 ;如果梯度被层层放大,则可能形成梯度爆炸。
常见的缓解方法有三种:
- 使用 ReLU 激活函数:它像一道门,正数直接放行,让梯度在正数区域更容易通过;
- 合理初始化参数:Xavier、He 初始化就像调节音响的初始音量,让权重既不过大也不过小;
- 使用批量归一化:Batch Normalization(BN)像一位"整理员",把每层输出调整到相对稳定的范围,让训练更加平稳。
这三种方法分别改善激活方式、训练起点和中间数据的稳定性,只能缓解梯度消失,不能保证它彻底消失。它们也不是分别优化某一个参数;网络中的参数最终仍由反向传播计算梯度,再由优化器统一更新。
二、CNN:怎样让神经网络看懂图片?
一张图片在计算机眼中只是一个像素矩阵。若把所有像素直接连接到全连接层,参数量会非常大,也忽略了图像最重要的特点:相邻像素关系紧密,同一种特征可能出现在任意位置。
卷积神经网络(Convolutional Neural Network,CNN)正是针对这两个特点设计的。
1. 卷积层:用小窗口寻找局部特征
卷积核是一个很小的权重矩阵,常见尺寸为 3×3。它像一扇滑动的小窗口,在整张图片上从左到右、从上到下扫描。每到一个位置,就与覆盖区域逐元素相乘并求和,得到一个新数值。
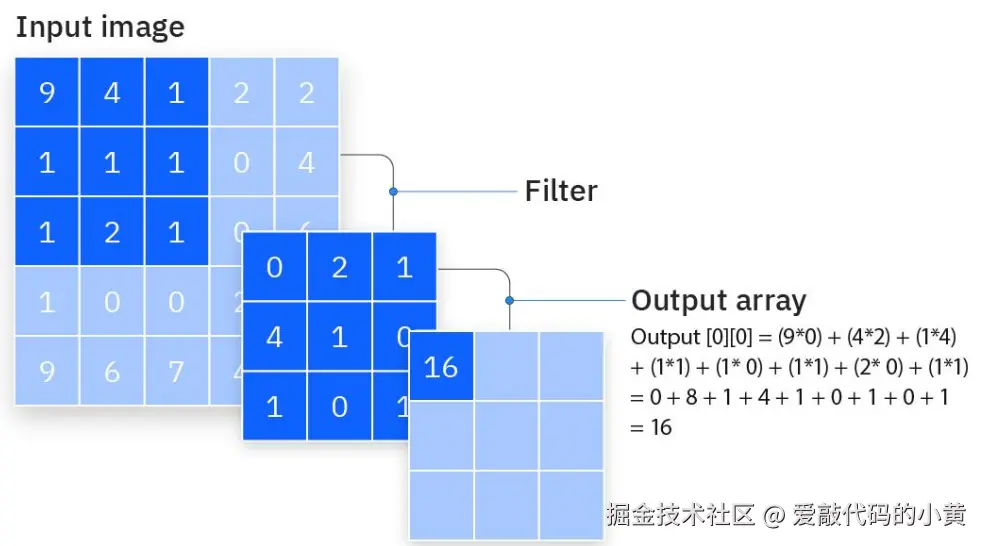
同一个卷积核会在整张图上重复使用,因此:
- 参数更少,这叫权重共享;
- 无论某种特征出现在图片哪里,都可以被同一个卷积核识别;
- 每个卷积核学习一种模式,例如边缘、方向或纹理。
彩色图片通常有红、绿、蓝三个通道,卷积核会同时处理这三个通道。一个卷积核扫描后得到一张特征图,16 个卷积核就会得到 16 张特征图,分别记录模型发现的不同特征。
像素 → 边缘和颜色 → 纹理与形状 → 眼睛、轮胎等局部结构 → 完整物体
第一层卷积只能看到很小的局部区域;随着卷积层不断叠加,后面的神经元能间接看到更大的图片范围。这个范围叫感受野。感受野越来越大,正是深层 CNN 能从局部边缘逐步理解完整物体的重要原因。
卷积还有三个常见参数:
- 卷积核大小决定观察范围
- 步幅(stride)决定每次移动多远
- 填充(padding)决定是否在边缘补值以控制输出尺寸。
2. 池化层:保留重点,压缩尺寸
池化层会对一小块区域做汇总。例如最大池化只保留区域中的最大值。它能缩小特征图、减少计算量,并让模型对特征的小幅位移不那么敏感。
现代 CNN 有时会用步幅卷积代替池化,但目的相似:在尽量保留关键信息的同时降低空间尺寸。
3. 一张图片如何完成分类?
一条典型的数据流是:
输入图片 → 多轮卷积与激活 → 下采样 → 得到高级特征 → 汇总特征 → 分类层输出各类别概率
例如识别猫时,前层可能检测边缘,中层组合出耳朵和眼睛,深层再把这些特征组合成"猫"。训练时,分类误差仍会通过反向传播传回所有卷积核,卷积核也因此逐渐学会提取有用特征。
卷积结束后,模型会将多张特征图展平或汇总,再交给全连接层。若使用两层全连接,第一层负责组合耳朵、胡须、轮廓等特征,第二层为猫、狗等类别计算原始分数(logits)。Softmax 再把这些分数转换成概率,模型最终选择概率最高的类别。
特征图 → 展平或汇总 → 组合特征 → 类别打分 → Softmax 概率 → 预测结果
全连接层的数量并不固定。经典 CNN 常使用多个全连接层,现代 CNN 则常用全局平均池化加一个全连接层,以减少参数量。
4. CNN 为什么越做越深?
LeNet 验证了卷积结构的有效性;AlexNet 让深度 CNN 真正受到关注;VGG 用连续的小卷积核构建更深网络。但网络并非越深越好:层数增加后,梯度和信息传播都会变得困难,甚至出现"更深反而更差"的退化现象。
ResNet 的关键是残差连接:
y=F(x)+x
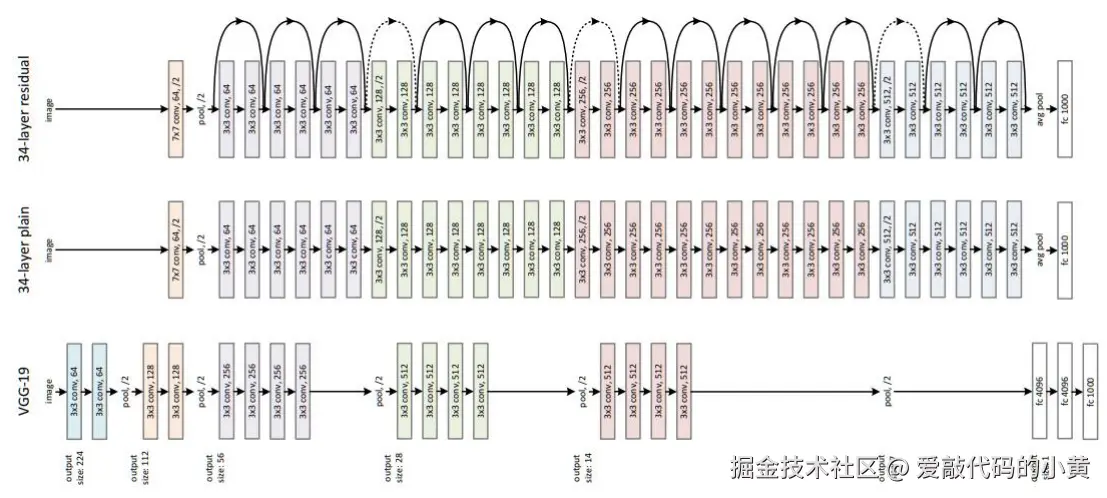
它让输入 x 可以绕过若干层直接传到后面,相当于为信息和梯度修建了一条高速公路,使很深的网络更容易训练。后来的 DenseNet 则进一步让不同层之间建立更密集的连接,促进特征复用。
三、RNN:怎样让神经网络理解顺序?
图片的核心是空间关系,而文本、语音和时间序列的核心是先后顺序。"我打了他"和"他打了我"包含相同的字,意思却完全不同。
循环神经网络(Recurrent Neural Network,RNN)会按顺序读取数据,并用隐藏状态保存已经看过的信息。
1. 文字如何进入 RNN?
RNN 不能直接处理文字,文本需要先转换成数字向量:
文字 → Token → Token ID → Embedding 向量 → RNN
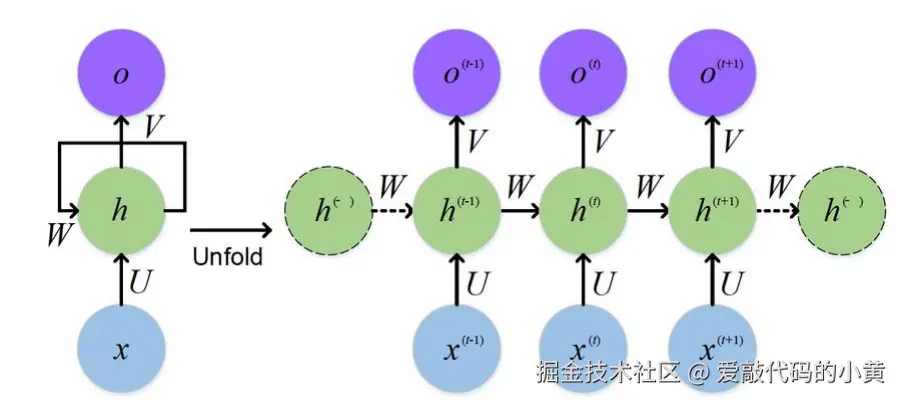
例如,"我喜欢学习"会先被切分成"我""喜欢""学习",再根据词表转换成对应的 ID。由于 ID 只是编号,还需要经过 Embedding 层,把每个 Token 转换成带有语义信息的向量。RNN 图中的 xt,就是第 t 个 Token 对应的向量。
训练和推理必须使用相同的分词规则、词表和 Embedding 参数,否则模型无法正确理解输入。
2. RNN 如何传递上下文?
在第 t 个时间步,RNN 接收当前 Token 的向量 xt 和上一步记忆 ht−1:
ht=f(Uxt+Wht−1+b)
ot=g(Vht+c)
新的隐藏状态 ht 会走向两个方向:一边通过 V 生成当前输出 ot,一边作为上下文传给下一时刻。也就是说,横向传递的是 ht,不是 ot。只有在文本生成等任务中,当前预测出的 Token 才可能再作为下一时刻的输入。
图中的三个矩阵各有分工:
- U:把当前输入 xt 转换到隐藏空间;
- W:把上一时刻的记忆 ht−1 传递到当前时刻;
- V:把当前隐藏状态 ht 转换为输出 ot。
这些参数在所有时间步共享。也就是说,RNN 不是为句子中的每个词建立一套新网络,而是让同一个单元被反复使用。
以"我喜欢自然语言处理"为例:模型读到"我"后形成一份记忆;读到"喜欢"时,把当前词与此前记忆结合;继续向后读取,隐藏状态不断更新。最终状态包含了模型认为重要的上下文。
3. 普通 RNN 的两个难题
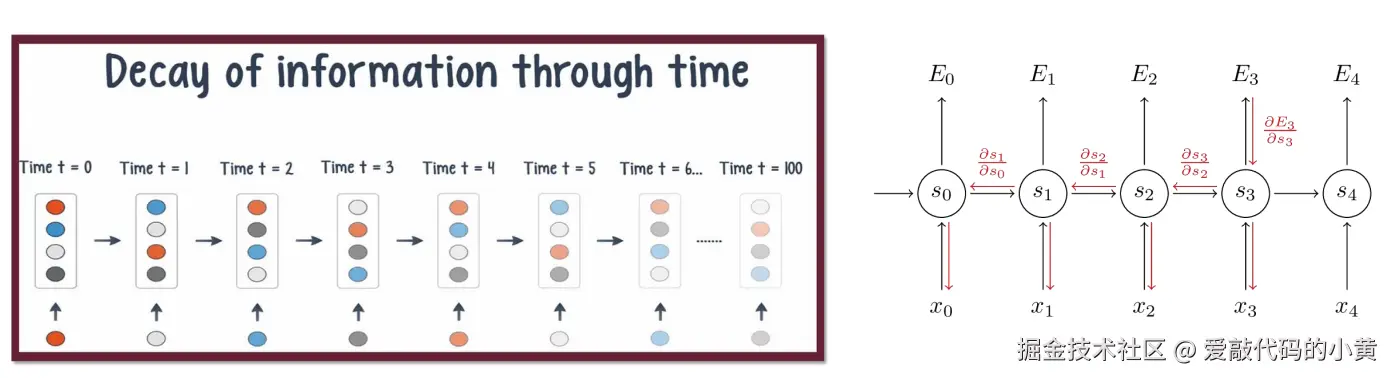
第一,后一个时间步依赖前一个时间步,因此训练难以像 CNN 那样充分并行。
第二,早期信息要经过很长的传递链。正向传播时它可能逐渐被后续信息稀释;反向传播时,梯度经过多次连乘,容易消失或爆炸。这使普通 RNN 很难学会长距离依赖。
4. LSTM:给记忆增加三道门
LSTM(Long Short-Term Memory)主要缓解普通 RNN 的长期信息丢失和梯度消失,但没有解决顺序计算、难以并行的问题。它在隐藏状态之外增加了一条更稳定的"细胞状态",再通过门控机制决定信息如何流动。
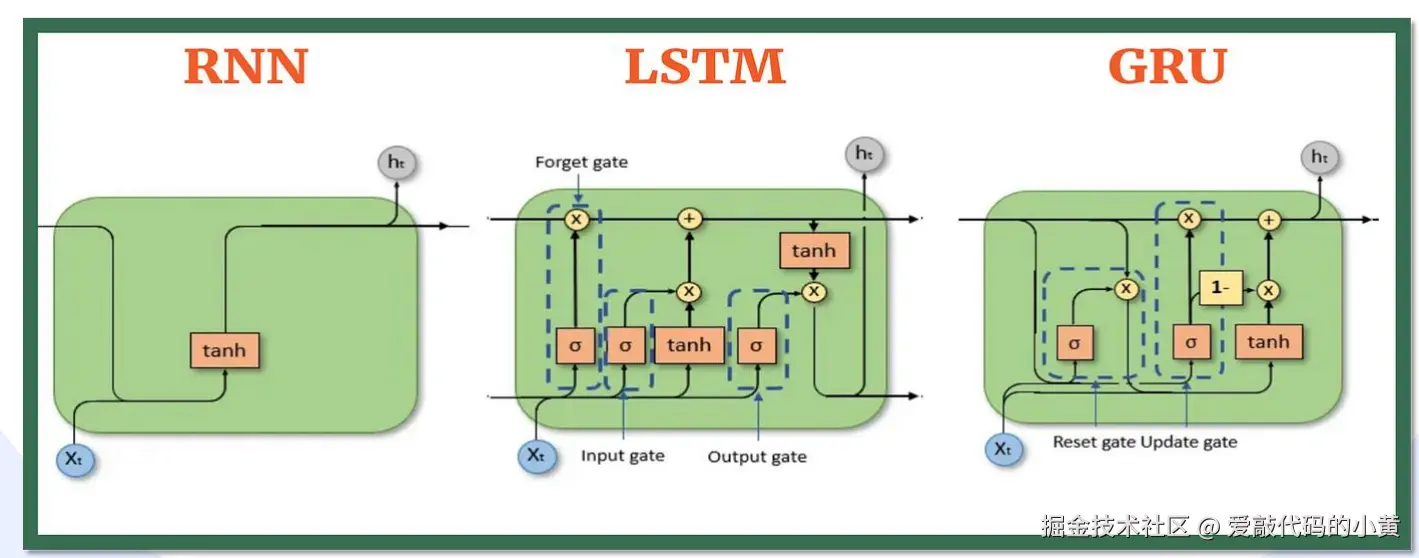
三个门可以这样理解:
- 遗忘门:旧记忆保留多少,哪些内容应该丢掉;
- 输入门:当前输入中哪些新信息值得写入长期记忆;
- 输出门:当前时刻应该从记忆中拿出哪些内容作为输出。
门的取值通常在 0 到 1 之间,接近 0 表示"拦住",接近 1 表示"放行"。这些门不是人工编写的规则,而是由训练数据学习出来的。细胞状态提供了较顺畅的信息通道,因此 LSTM 比普通 RNN 更能保留长期信息。
例如读到"中国"时,输入门可以把相关信息写入记忆;处理中间的长内容时,遗忘门决定是否继续保留;读到"母语"时,输出门再取出这段记忆,帮助模型预测"中文"。
5. GRU 与 BiLSTM
GRU 是 LSTM 的简化版本。它把多个状态和门进行合并,主要使用更新门与重置门,参数更少、训练更快,实际效果常与 LSTM 接近。
BiLSTM 则用两个 LSTM 分别从左向右和从右向左读取序列,再合并两边的信息。这样理解一个词时既能看到前文,也能看到后文,适合文本分类、命名实体识别等任务。但在逐词生成文本时,未来词尚不存在,不能直接依赖完整的双向信息。
四、Encoder--Decoder:为什么要把"理解"和"生成"分开?
如果任务只需要对输入进行判断,通常使用特征提取模块加分类器即可;如果需要先理解输入,再生成一段新的序列,就适合使用 Encoder--Decoder(编码器---解码器)。它是"序列到序列"任务的通用框架,常用于机器翻译、摘要、对话和语音识别。输入与输出的长度可以不同,内容和表现形式也不必一一对应。
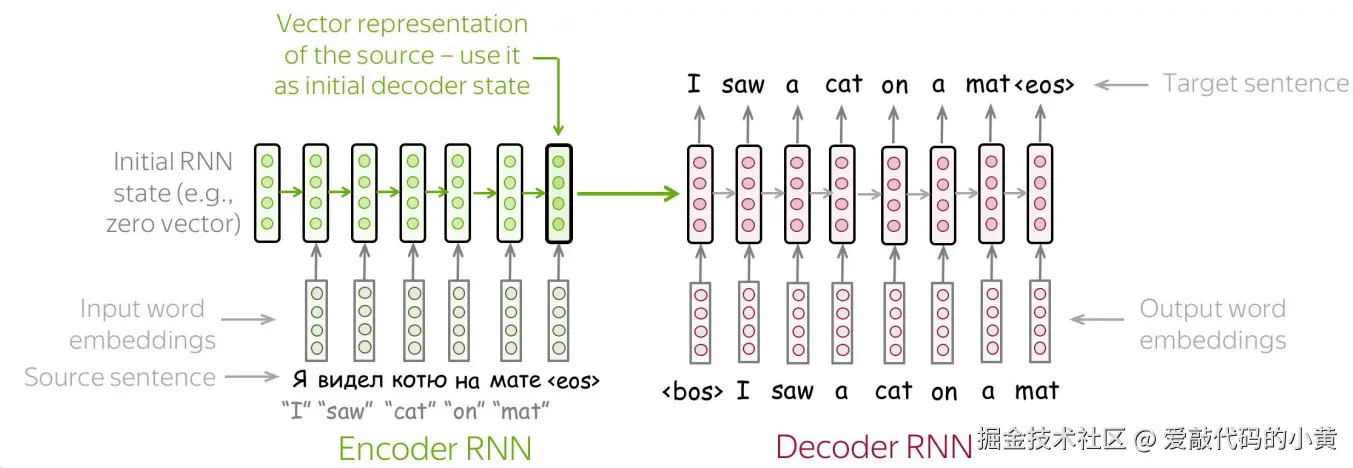
它的运行过程分为两段。
1. Encoder:把输入读懂
编码器依次读取源句子的每个词,将词向量和已有隐藏状态不断融合:
输入句子 → 词向量 → 逐步更新隐藏状态 → 得到输入的语义表示
传统 RNN Encoder--Decoder 通常把编码器最后一个隐藏状态当作整句话的压缩表示,再交给解码器。
2. Decoder:根据语义逐步生成
解码器接收编码结果,并从起始标记 <BOS> 开始逐词生成:
- 根据编码结果和
<BOS>预测第一个词; - 把刚生成的词作为下一步输入,预测第二个词;
- 不断重复,直到生成结束标记
<EOS>。
每一步生成时,Decoder 都会根据当前状态,为目标词表中的所有 Token 计算原始分数,再通过 Softmax 转换成概率并选择一个 Token:
Decoder 状态 → 词表中各 Token 的分数 → Softmax 概率 → 输出 Token → 作为下一步输入
训练时常把上一步的正确答案喂给解码器,帮助它稳定学习,这叫 Teacher Forcing;推理时没有正确答案,只能使用自己刚刚生成的词,所以前面一旦出错,错误可能继续累积。
3. 固定长度向量为什么不够?
传统结构要求编码器把整句话压进一个固定长度向量。句子越长,这个向量越容易成为信息瓶颈:开头的细节可能在传递中丢失,解码器也无法知道生成当前词时应该重点查看原句的哪一部分。
Attention 正是为解决这个问题而出现的。
五、Attention:需要什么,就回头看什么
在不带 Attention 的经典结构中,Encoder 将最终状态 hn 交给 Decoder。Decoder 随后结合上一个 Token,不断更新自己的状态 s1、s2......。这些状态记录生成过程,并不意味着它能回看 Encoder 的 h1、h2......。Attention 增加的正是这条访问通道。
Attention(注意力机制)的核心思想非常直观:解码器每生成一个词,都重新查看编码器的全部输出,并挑选此刻最相关的信息。
假设把"我喜欢机器学习"翻译为英文。当解码器准备生成 "machine" 时,应更多关注"机器";生成 "learning" 时,则应更多关注"学习",而不是始终依赖同一个句子压缩向量。
一次注意力计算可以分成四步:
- 保存全部信息:编码器不只保留最后一个状态,而是保留每个输入位置的表示;
- 计算相关性:用解码器当前状态与每个编码器状态进行匹配,得到一组分数;
- 归一化权重:用 Softmax 把分数变成总和为 1 的注意力权重;
- 加权汇总:权重越高的位置贡献越大,最终得到当前步骤专属的上下文向量。
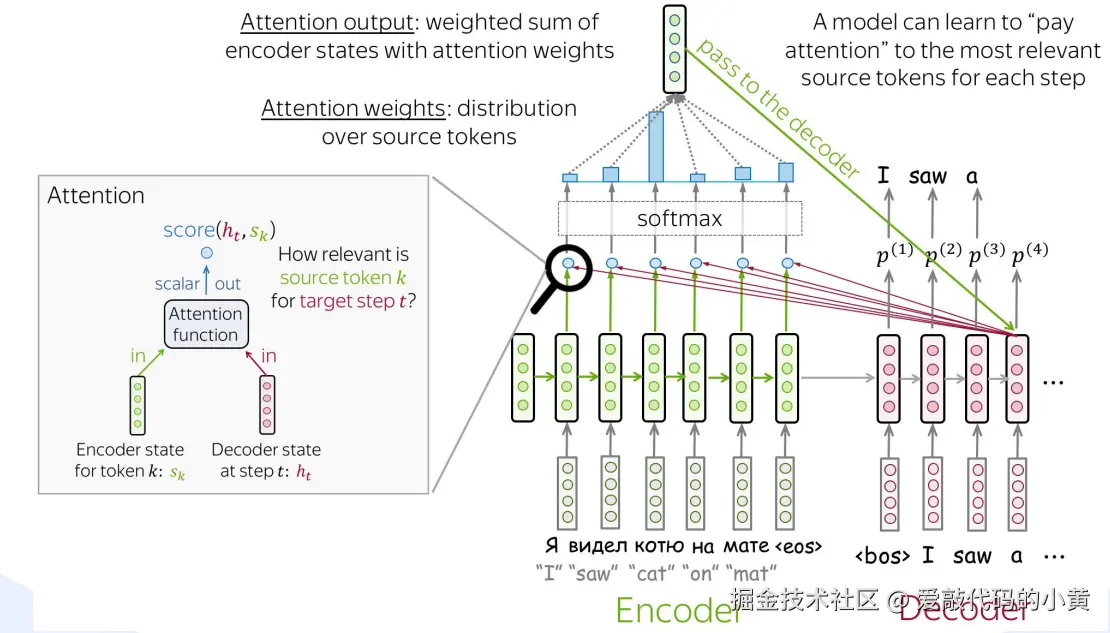
图中绿色表示 Encoder 状态,粉色表示 Decoder 状态;图用 s 表示 Encoder、 h 表示 Decoder,与正文的符号约定相反。注意力权重表示对原文各位置的关注程度,不是英文词表的输出概率。Decoder 结合加权汇总的信息与自身状态,再预测下一个 Token。
可简写为:
αt,i=softmax(score(st−1,hi))
ct=i∑αt,ihi
hi 是编码器在第 i 个位置的表示, st−1 是解码器当前用于查询的状态, αt,i 是对该位置的关注程度, ct 则是本次生成所需的上下文。
于是,原来的流程:
整个输入 → 一个固定向量 → 整个输出
变成了:
整个输入 → 保留所有位置 → 每生成一步都动态选取相关信息
Attention 缓解了长序列的信息瓶颈,也让模型的对齐关系更容易观察。例如翻译某个词时,我们可以看到模型主要关注了源句中的哪些词。
六、Attention 之后,为什么还需要 Transformer?
Attention 缓解了传统 Encoder--Decoder 的信息瓶颈:Decoder 不再只依赖一个固定长度的向量,而是可以在生成每个 Token 时,重新寻找输入中最相关的信息。
但此时的主体仍然是 RNN。Token 还要按照顺序逐个处理,后一个时间步依赖前一个时间步,因此难以充分并行;两个距离很远的 Token,也仍然需要经过较长的信息传递路径。
于是,一个新的问题出现了:
能不能去掉循环结构,让任意两个 Token 直接建立联系,并且同时处理整个序列?
Transformer 给出的答案是:让 Attention 从辅助机制变成整个模型的核心。至于它如何使用 Self-Attention、QKV、位置编码和多头注意力,将在下一篇文章中继续拆解。
从本文的路线回看,技术演进其实非常自然:
RNN 依靠隐藏状态传递上下文 → LSTM 改善长期记忆 → Encoder--Decoder 分开理解与生成 → Attention 动态查找相关信息 → Transformer 让 Attention 成为核心
结语
神经网络的学习,本质是"预测---比较---纠错"的循环;CNN 通过局部连接与权重共享理解图像;RNN 通过隐藏状态传递上下文;LSTM 和 GRU 用门控机制管理记忆;Encoder--Decoder 把理解与生成拆成两个阶段;Attention 则让模型在每一步都能主动寻找最相关的信息。
到这里,我们已经走完了从普通神经网络到 Attention 的完整路线。下一篇将正式进入 Transformer,看看它如何摆脱 RNN 的顺序计算,又如何让每个 Token 直接找到与自己相关的信息。