关注我的公众号:【编程朝花夕拾】,可获取首发内容。
01 引言
自从opencode升级到2.x以后,几轮对话下来免费额度直接耗尽,有时候甚至一轮对话直接耗尽,真的让人很抓狂。第一反应这不可能将额度用完。前两天还用免费额度做了一整天的任务,甚至分享了一篇通过OC工具将opencode免费额度一键导入Workbuddy的文章。
好家伙,这两天就不能用了。顺便去anomalyco/opencode一搜,竟然发现老铁们已经把评论区挤爆了,对于免费额度的问题五花八门。本节我们一起捋捋。
02 缘起
从GitHub下载了1.19.5的版本后,做项目的时候发现,模型直接不给用了,让直接通过https://opencode.ai/download下载。我的已经是最新版本了,怎么还要下载。
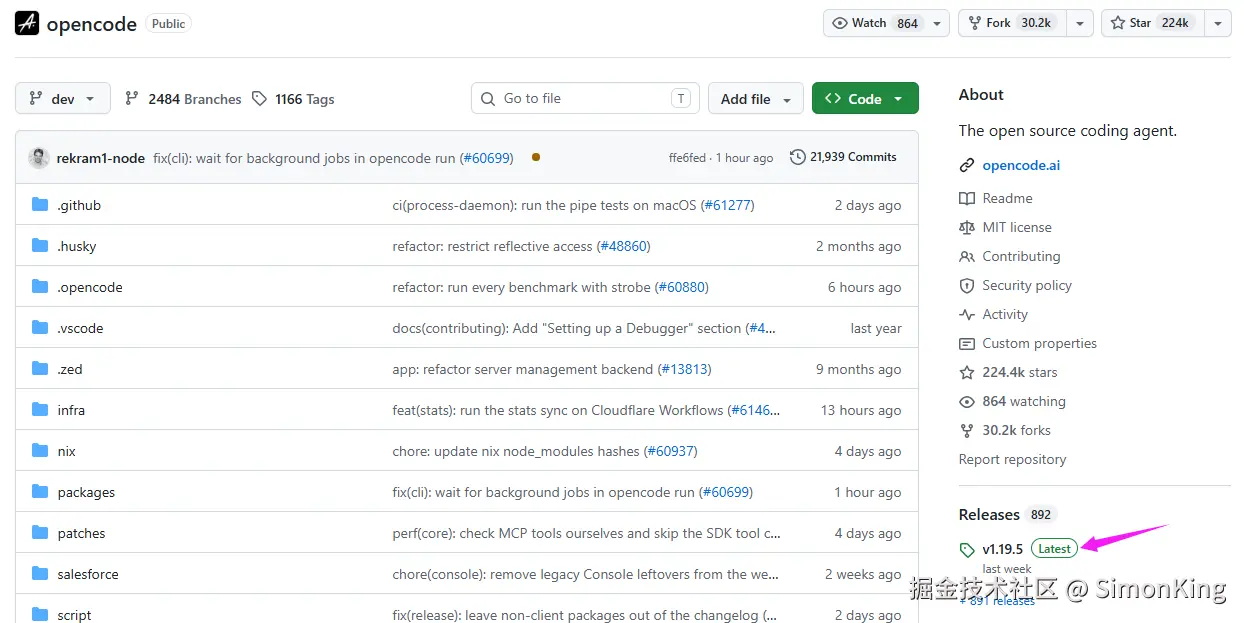
没办法,模型不能用,只能从官网下载:
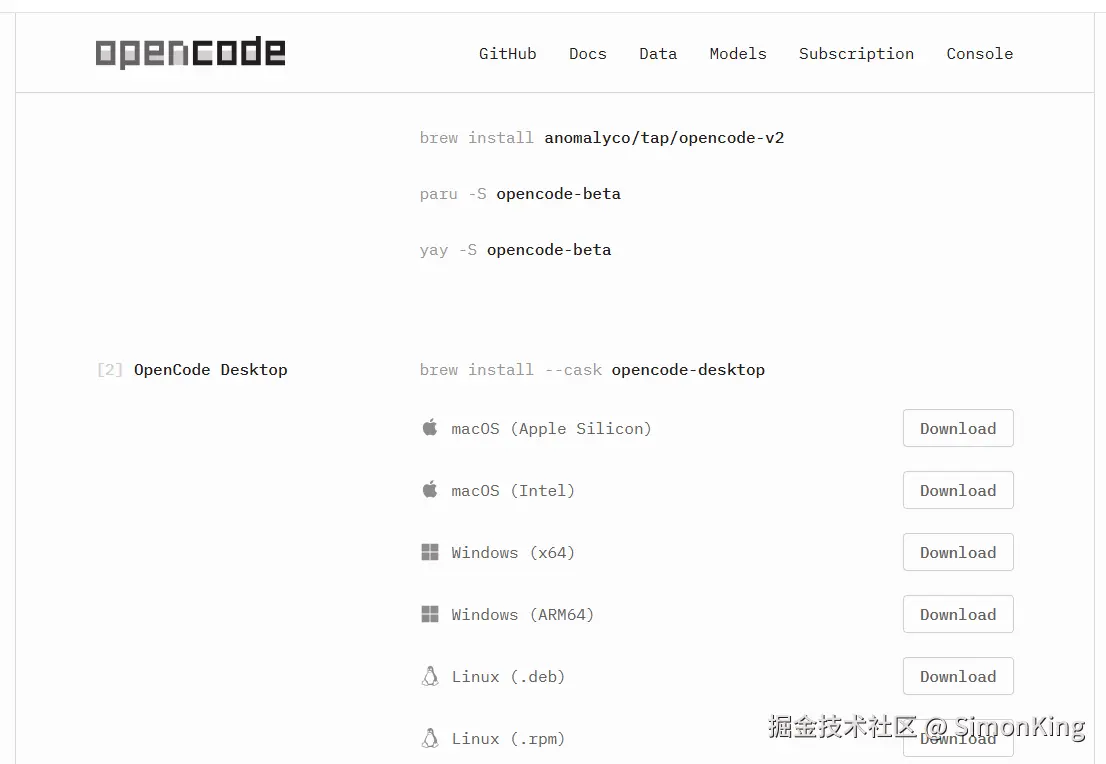
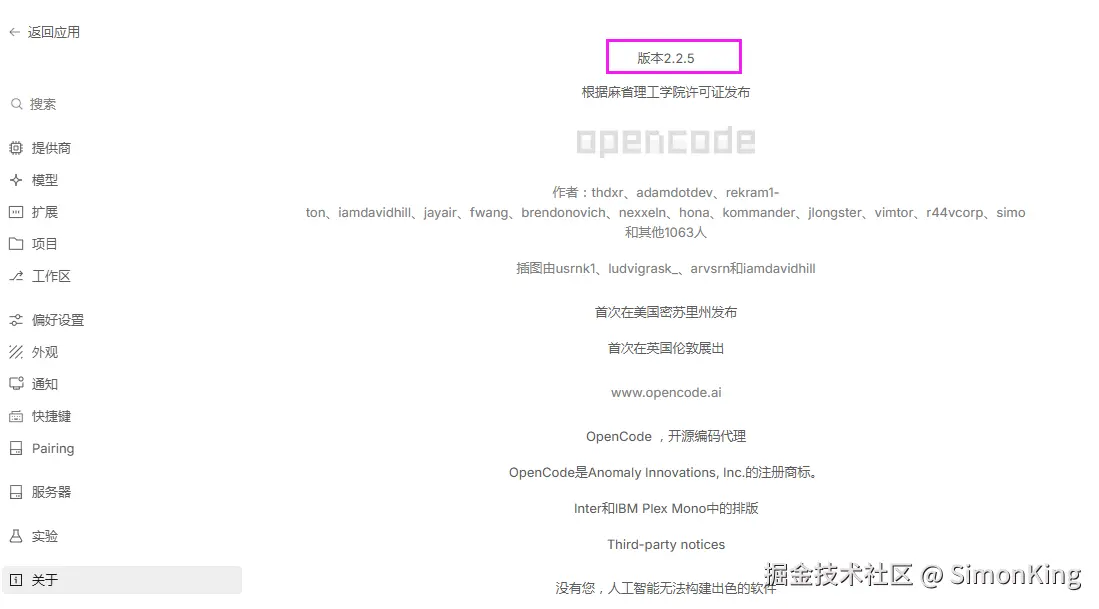
结果下载完之后,发现已经是2.2.5的版本了。
新版果然改变很多东西,最直接就是将免费模型直接单独拿出来,方便选择,真的让人很惊喜,不用再去全量里面挑选了。
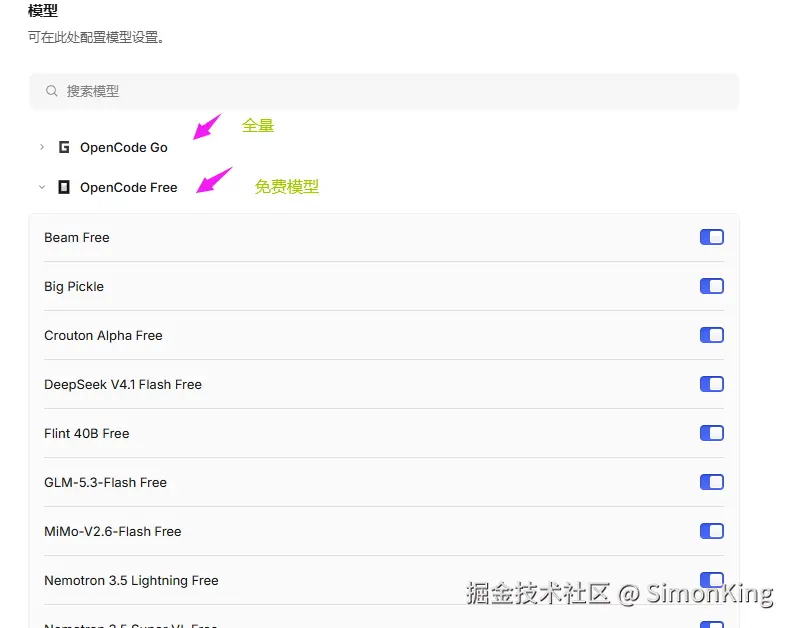
喜出望外之际,想使用deepseek v4.1 flash优化一下之前写的小插件,结果两轮下来,额度直接耗尽,得等到第二天才能重置。
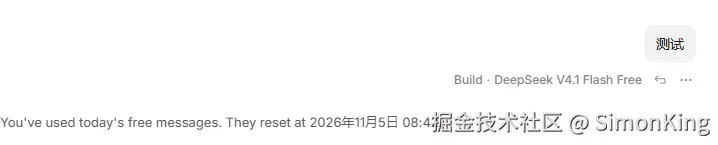
这到底是怎么回事呢?
03 追踪
opencode在GitHub上有224k的star,说明关注人数非常大,其他人肯定也会遇到类似的问题。
于是就翻了翻issues,关于free关键词的issue:
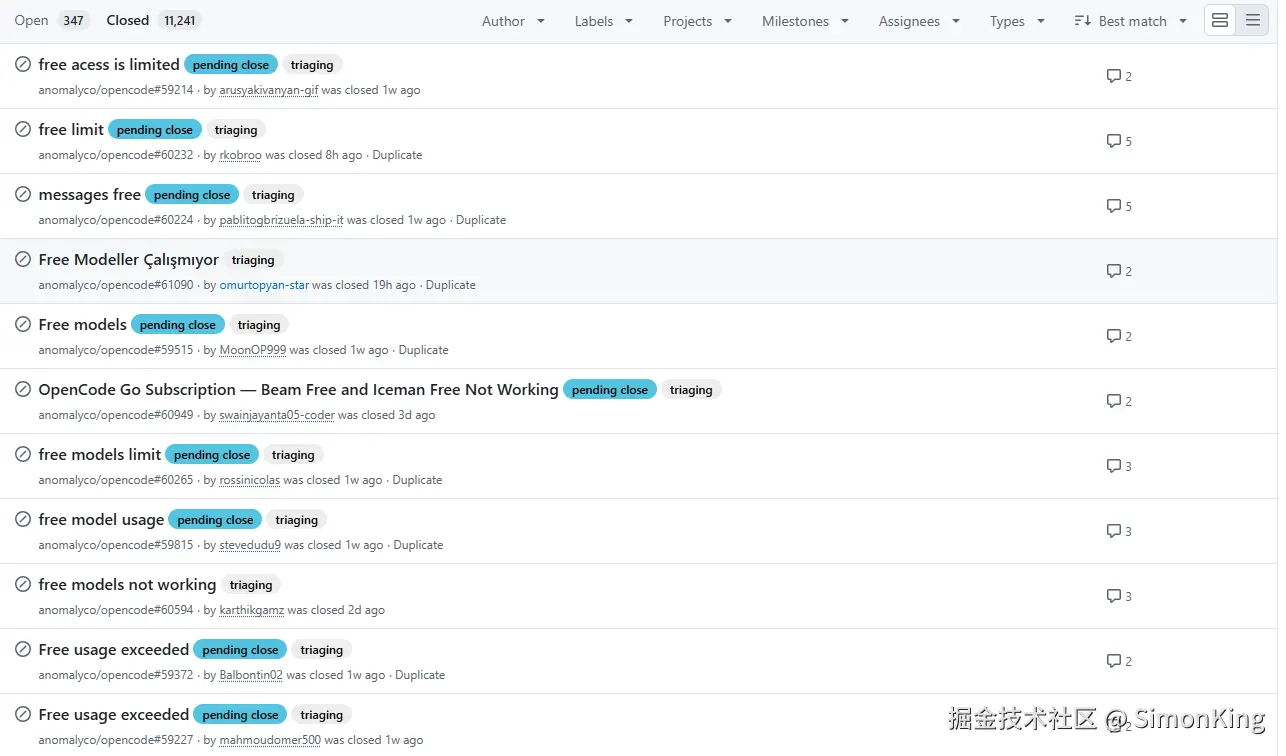
密密麻麻的issues还是英文,还是使用AI分析一下关于免费额度耗尽的情况的时间线,比我自己一个个找方便多了。
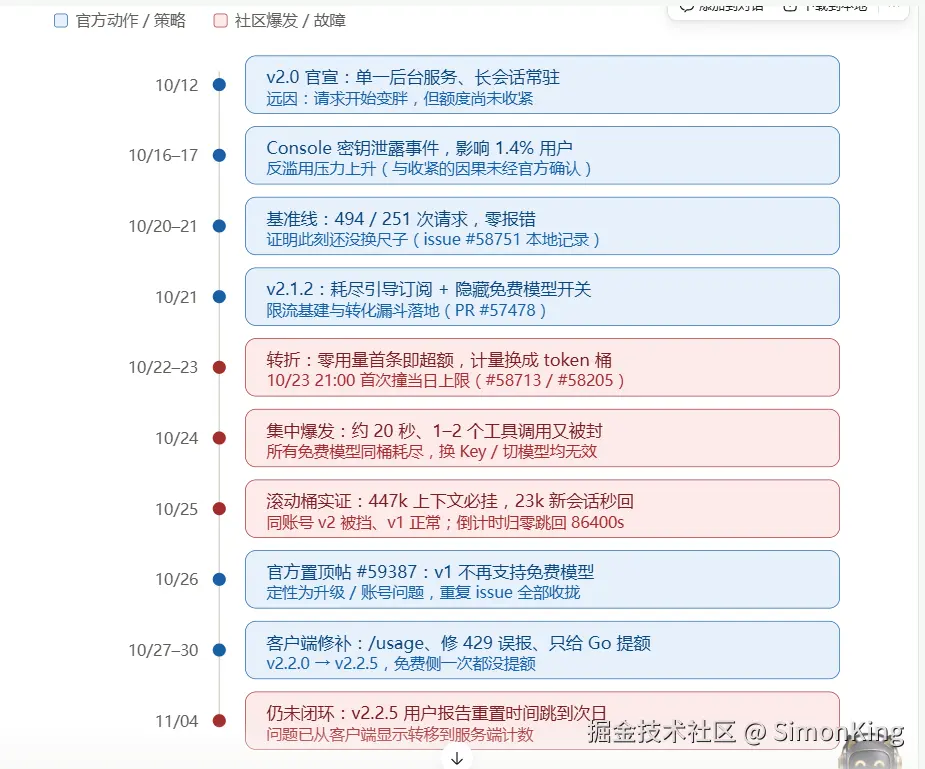
看来v2.x官方做了很多使用的门槛,同时也带来了一些问题。目前尚未修复。
04 v2.x体验变差
4.1 计量单位的变更
issue #58751 中一个反馈者直接本地 sqlite 把数据扒出来了。他用 opencode/deepseek-v4.1-flash-free,同一账号、同一台机器:
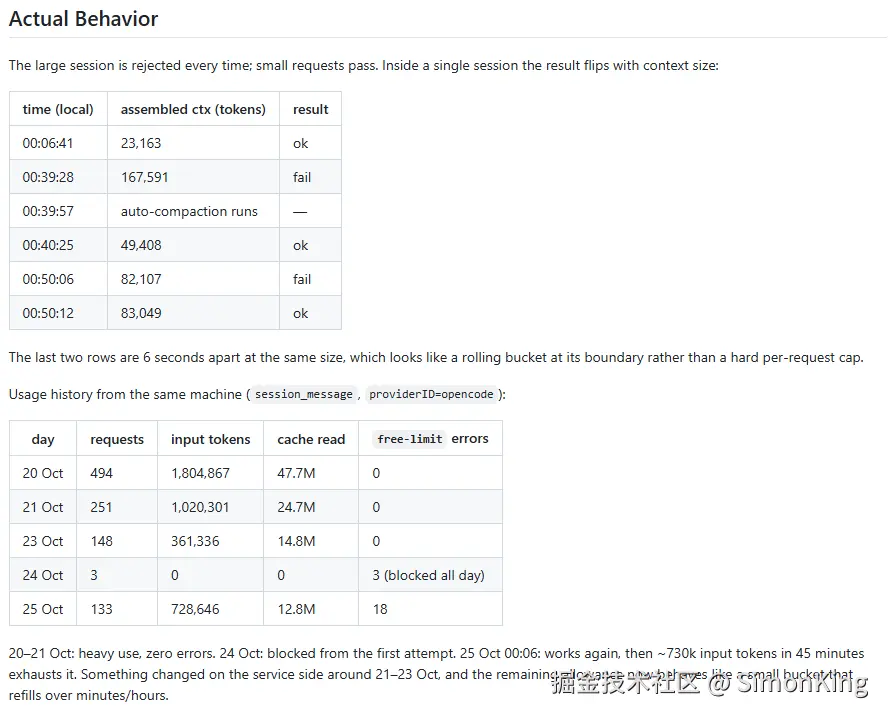
前半部分两行相隔 6 秒、体量几乎一样却结果相反------反馈者判断这是滚动桶在边界上,而不是硬性 per-request 上限。他那个攒了 985 条用户消息、组装上下文约 447k token 的老 session,每一轮都返回 provider.free-limit;同一分钟新建一个 23k token 的 session,18 秒后正常返回。
后半部分20--21 号重度使用零报错,24 号起第一次请求就被挡。反馈者自己的判断是「Something changed on the service side around 21--23 Oct」。这个时间点,刚好和 v2.1.2(10/21)那批限流基建、以及置顶帖(10/26)开张严丝合缝。
所以「额度变少」更准确的描述是:计量模型从宽松的日计数,换成了按 token / 请求特征扣减的滚动预算。你的额度数字可能没变,但每一轮对话变贵了。
4.2 会话变胖
一次请求能吃掉过去十次的量。v2 的 agent 更爱读文件、LSP 上下文更全、长会话靠 auto-compaction 撑着,一次 build 请求的组装上下文动辄十几万 token。加上 #58205 日志里那个细节:同一秒内,主模型报 Free usage limit reached,标题生成的小模型 gpt-5.4-nano 报 Insufficient account funds。连自动起标题这种「隐形请求」都在敲免费池的门。#58176、#58521 更是专门记了免费档下标题生成被 403 FreeTierError 拒掉。
05 小结
opencode之前的免费模型还是很抗打的,现在突然狠狠地限流,可能会让很多开发者敬而远之。如果工作证真的需要模型还得需要稳定的BYOK,免费的模型要门限流,要么降智,可能会带来一定的麻烦。