Anthropic 在 11 月 9 日发布了一份选模型指南《Which Claude model should you build with?》,作者是 Addy Osmani。指南覆盖 Haiku 5.5、Sonnet 5.5、Opus 5.5、Fable 5.2 四个模型和五个 effort 档位。
其中最反直觉的是下面这组数据。同一批 SWE-bench Pro 题目,Opus 5.5 先全部用 low 档跑,只把失败的用 high 重跑,通过率约 97%,每题约 0.17 美元。每道题都用 high,通过率是 95.3%,每题 0.29 美元。
本文依次拆解这组数据成立的前提、Opus 5.5 各档位的分数与成本、Fable 5.2 单价翻倍而任务成本减半的原因、模型不够用时官方给的三步顺序,以及在 Claude Code 里落地的具体设置。
这组数据否定了一个常见做法:为了稳妥,把档位一次开到 high 或更高。low 档单独跑只比 high 低约 8 分,成本约为三分之一。全程 high 等于给所有简单题都付了难题的价钱,最后通过率还低了约 1.7 个点。档位应该按题分配,而不是按项目分配。
先 low 后 high 的前提:结果能自动判对错
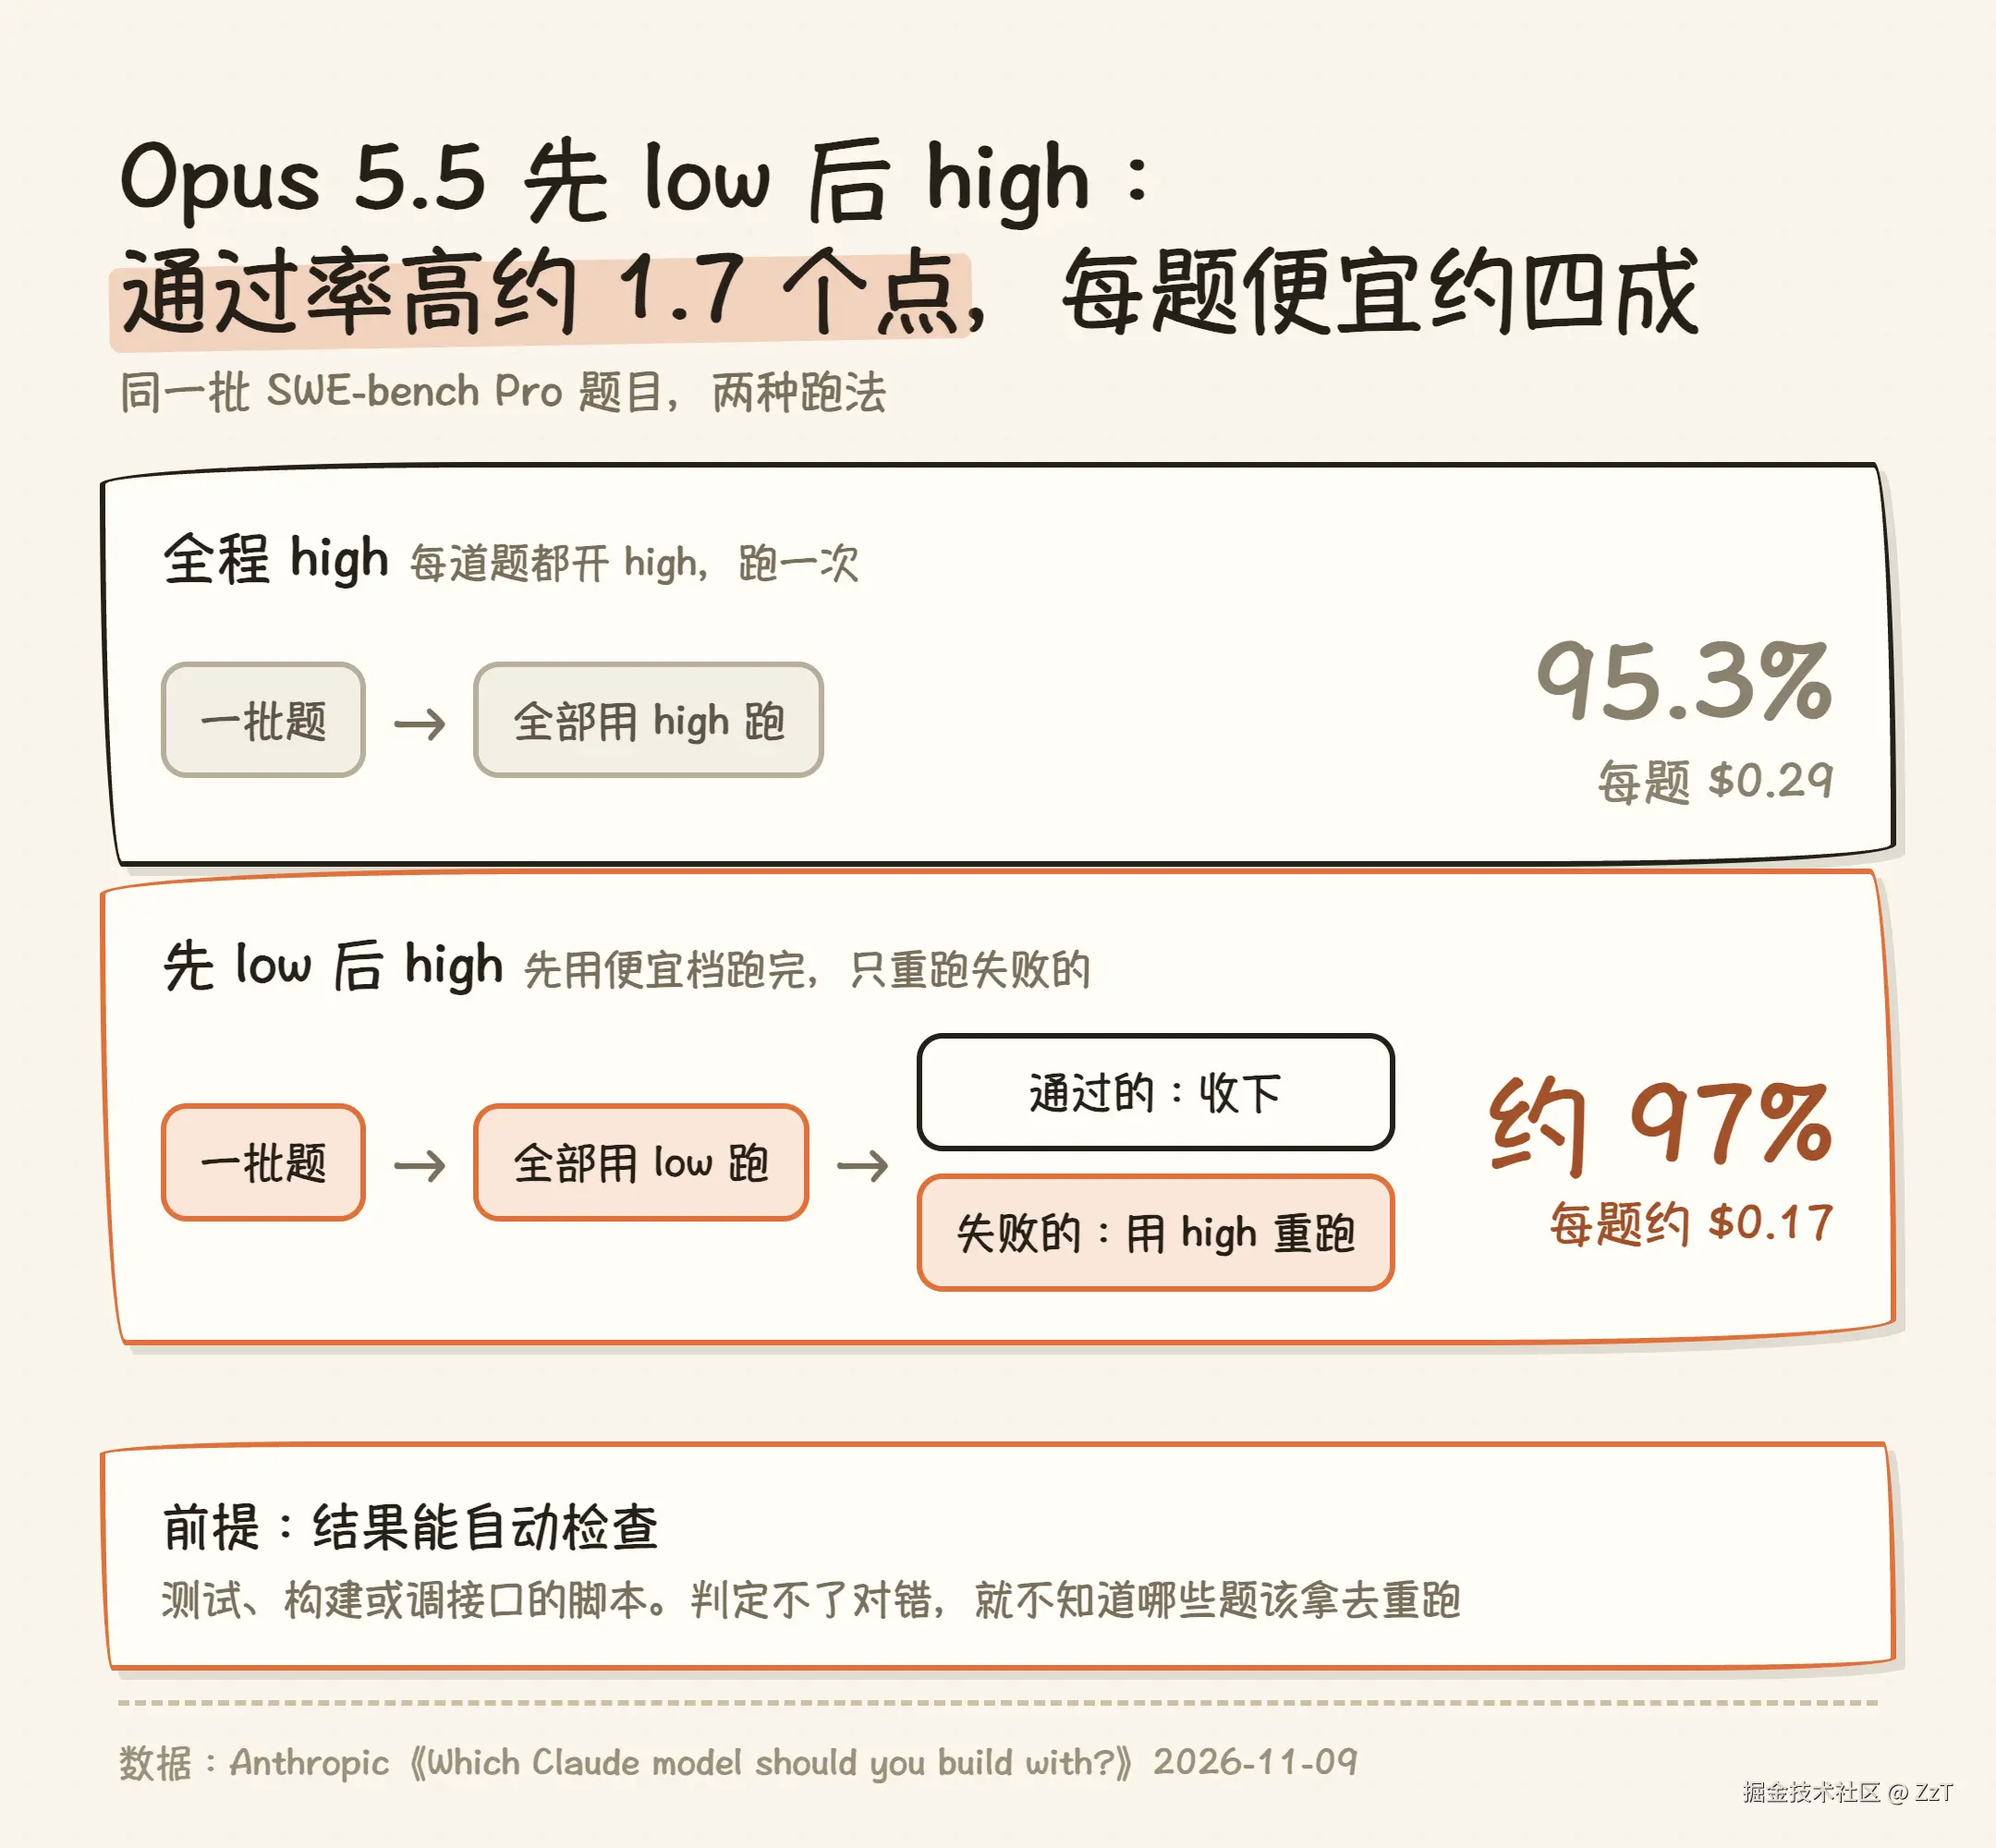
指南对这个做法的限定写得很明确:「If you can check outcomes automatically」。只有结果能被自动判定对错,才知道哪些题失败了、需要拿到 high 重跑。可用的判定方式包括测试通过、构建成功,或者一段调用接口的脚本。
如果判不了对错,就只能人工复核每一道题,省下的模型费用会被人的时间抵消。
为什么先 low 后 high 反而比全程 high 多出约 1.7 个点,指南没有解释。从做法上看,low 没做出来的题还有一次用 high 重做的机会,而全程 high 每题只跑一次,这是它能超过全程 high 的直接原因。
花费方面,0.17 美元包含了所有题的一次 low,加上失败题的一次 high,比全程 high 的 0.29 美元低约 41%。
Opus 5.5 四个档位的分数与成本
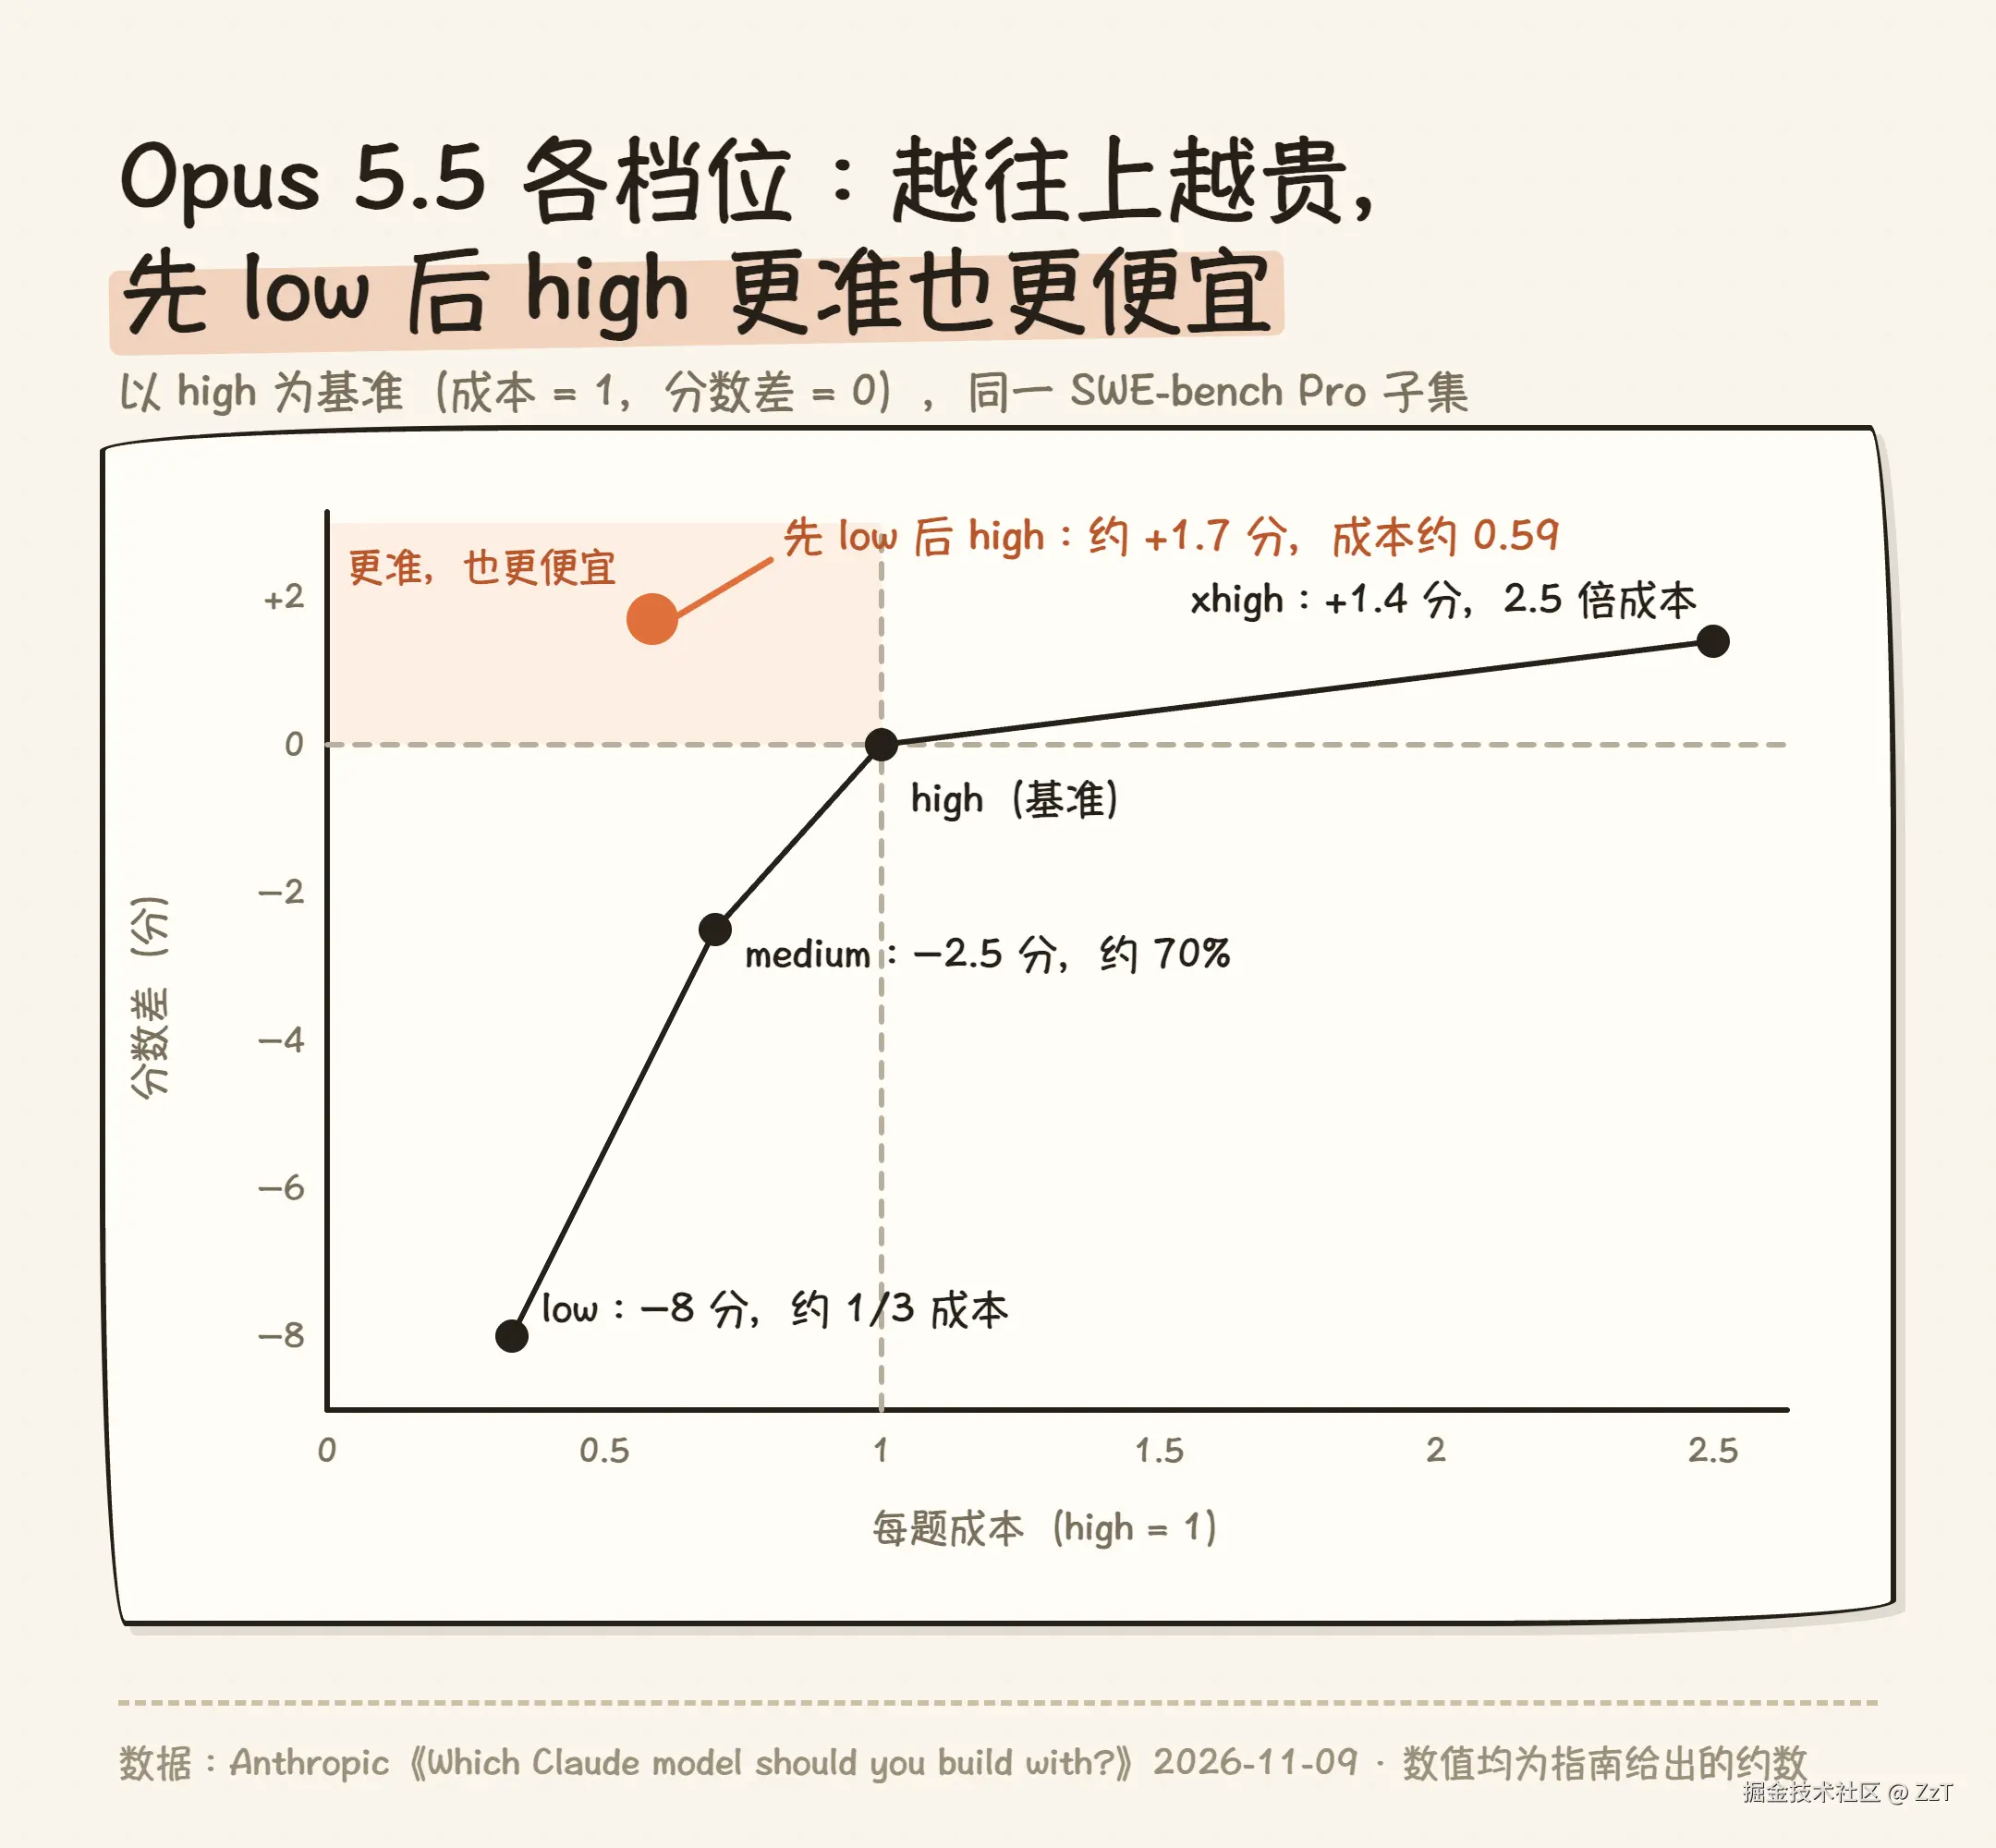
指南以 high 为基准,给出了 Opus 5.5 在 SWE-bench Pro 上的另外三个档位:
| 档位 | 分数(相对 high) | 成本(相对 high) |
|---|---|---|
| low | 低约 8 分 | 约三分之一 |
| medium | 低约 2.5 分 | 约 70% |
| xhigh | 高约 1.4 分 | 2.5 倍 |
这条曲线越往上越平。从 high 加到 xhigh,花 2.5 倍的钱只换来 1.4 分。指南因此建议:越过 high 之后,再加一档的花费可能已经接近换一个更大的模型,应该把两者放在自己的任务上比较;已经在 high 以上的,先试一下大一号模型的低档位。
指南还特别说明,提高 effort 不会给模型带来它本来没有的知识或能力,那种情况只能换模型。
Claude Code 里 Opus 5.5 的默认档位是 medium,指南建议大多数编码和知识工作从这里开始。当前会话用的是哪一档,可以用 /effort status 查看。
Fable 5.2 单价是 Opus 5.5 的两倍,每题成本约为一半
指南给出的四个模型 API 单价(每百万 token,输入 / 输出)如下:
| 模型 | 输入 / 输出 | 缓存读取 |
|---|---|---|
| Haiku 5.5 | 0.10 / 0.50 美元(100K 以内),0.50 / 2.50 美元(超过 100K) | 0.01 / 0.05 美元 |
| Sonnet 5.5 | 2 / 10 美元 | 0.10 美元 |
| Opus 5.5 | 4 / 20 美元 | 0.20 美元 |
| Fable 5.2 | 8 / 40 美元 | 0.20 美元 |
按单价,Fable 5.2 是 Opus 5.5 的两倍。但在 FrontierCode 2.0 这组难题上,Fable 5.2 开 high 的得分(45.3%)和 Opus 5.5 开到 max 的得分(45.5%)基本持平,每题成本约为一半。
Fable 5.2 的 System Card 给出了具体花费:Fable 5.2 开 high 平均每题 6.72 美元,Opus 5.5 开 max 平均每题 12.82 美元,前者约为后者的 52%。这组成绩和花费由 Cognition 统一测出,Claude 模型在 Claude Code 里运行。需要说明两点:System Card 没有写明这项测试的花费按什么价格计算;每个分数只有一次结果、没有误差范围,0.2 分的差距不能说明谁更强。
指南还引用了 Terminal-Bench 3.0 上的另一组数据:上一代 Fable 5.1 开 max 得 58.0%,Opus 5.5 开 high 得 58.9%,用的 token 只有一半。
这两组数据说明同一件事:每题成本取决于单价和用掉的 token 两项,档位开得越高,后一项涨得越快。同一份 System Card 里,Fable 5.2 自己从 high 开到 max,平均每题花费从 6.72 美元涨到 44.70 美元,分数只从 45.3% 变成 45.7%;它的最高分出现在 xhigh,49.1%,每题 14.19 美元。
长任务还有一个容易被忽略的因素。Fable 5.2 和 Opus 5.5 的缓存读取价格相同,都是 0.20 美元,而长任务的输入大部分按缓存读取计费。所以在缓存命中率高的长任务里,两者的价差只体现在未缓存的输入和输出上。
比较模型时,指南要求把最难的那几题单独算价。它举的例子是一个 20 题的搜索基准,其中 2 道题占了 43% 的花费。只看平均题目会严重低估真实花费。
模型不够用时,官方给的三步顺序
指南给出的顺序是:
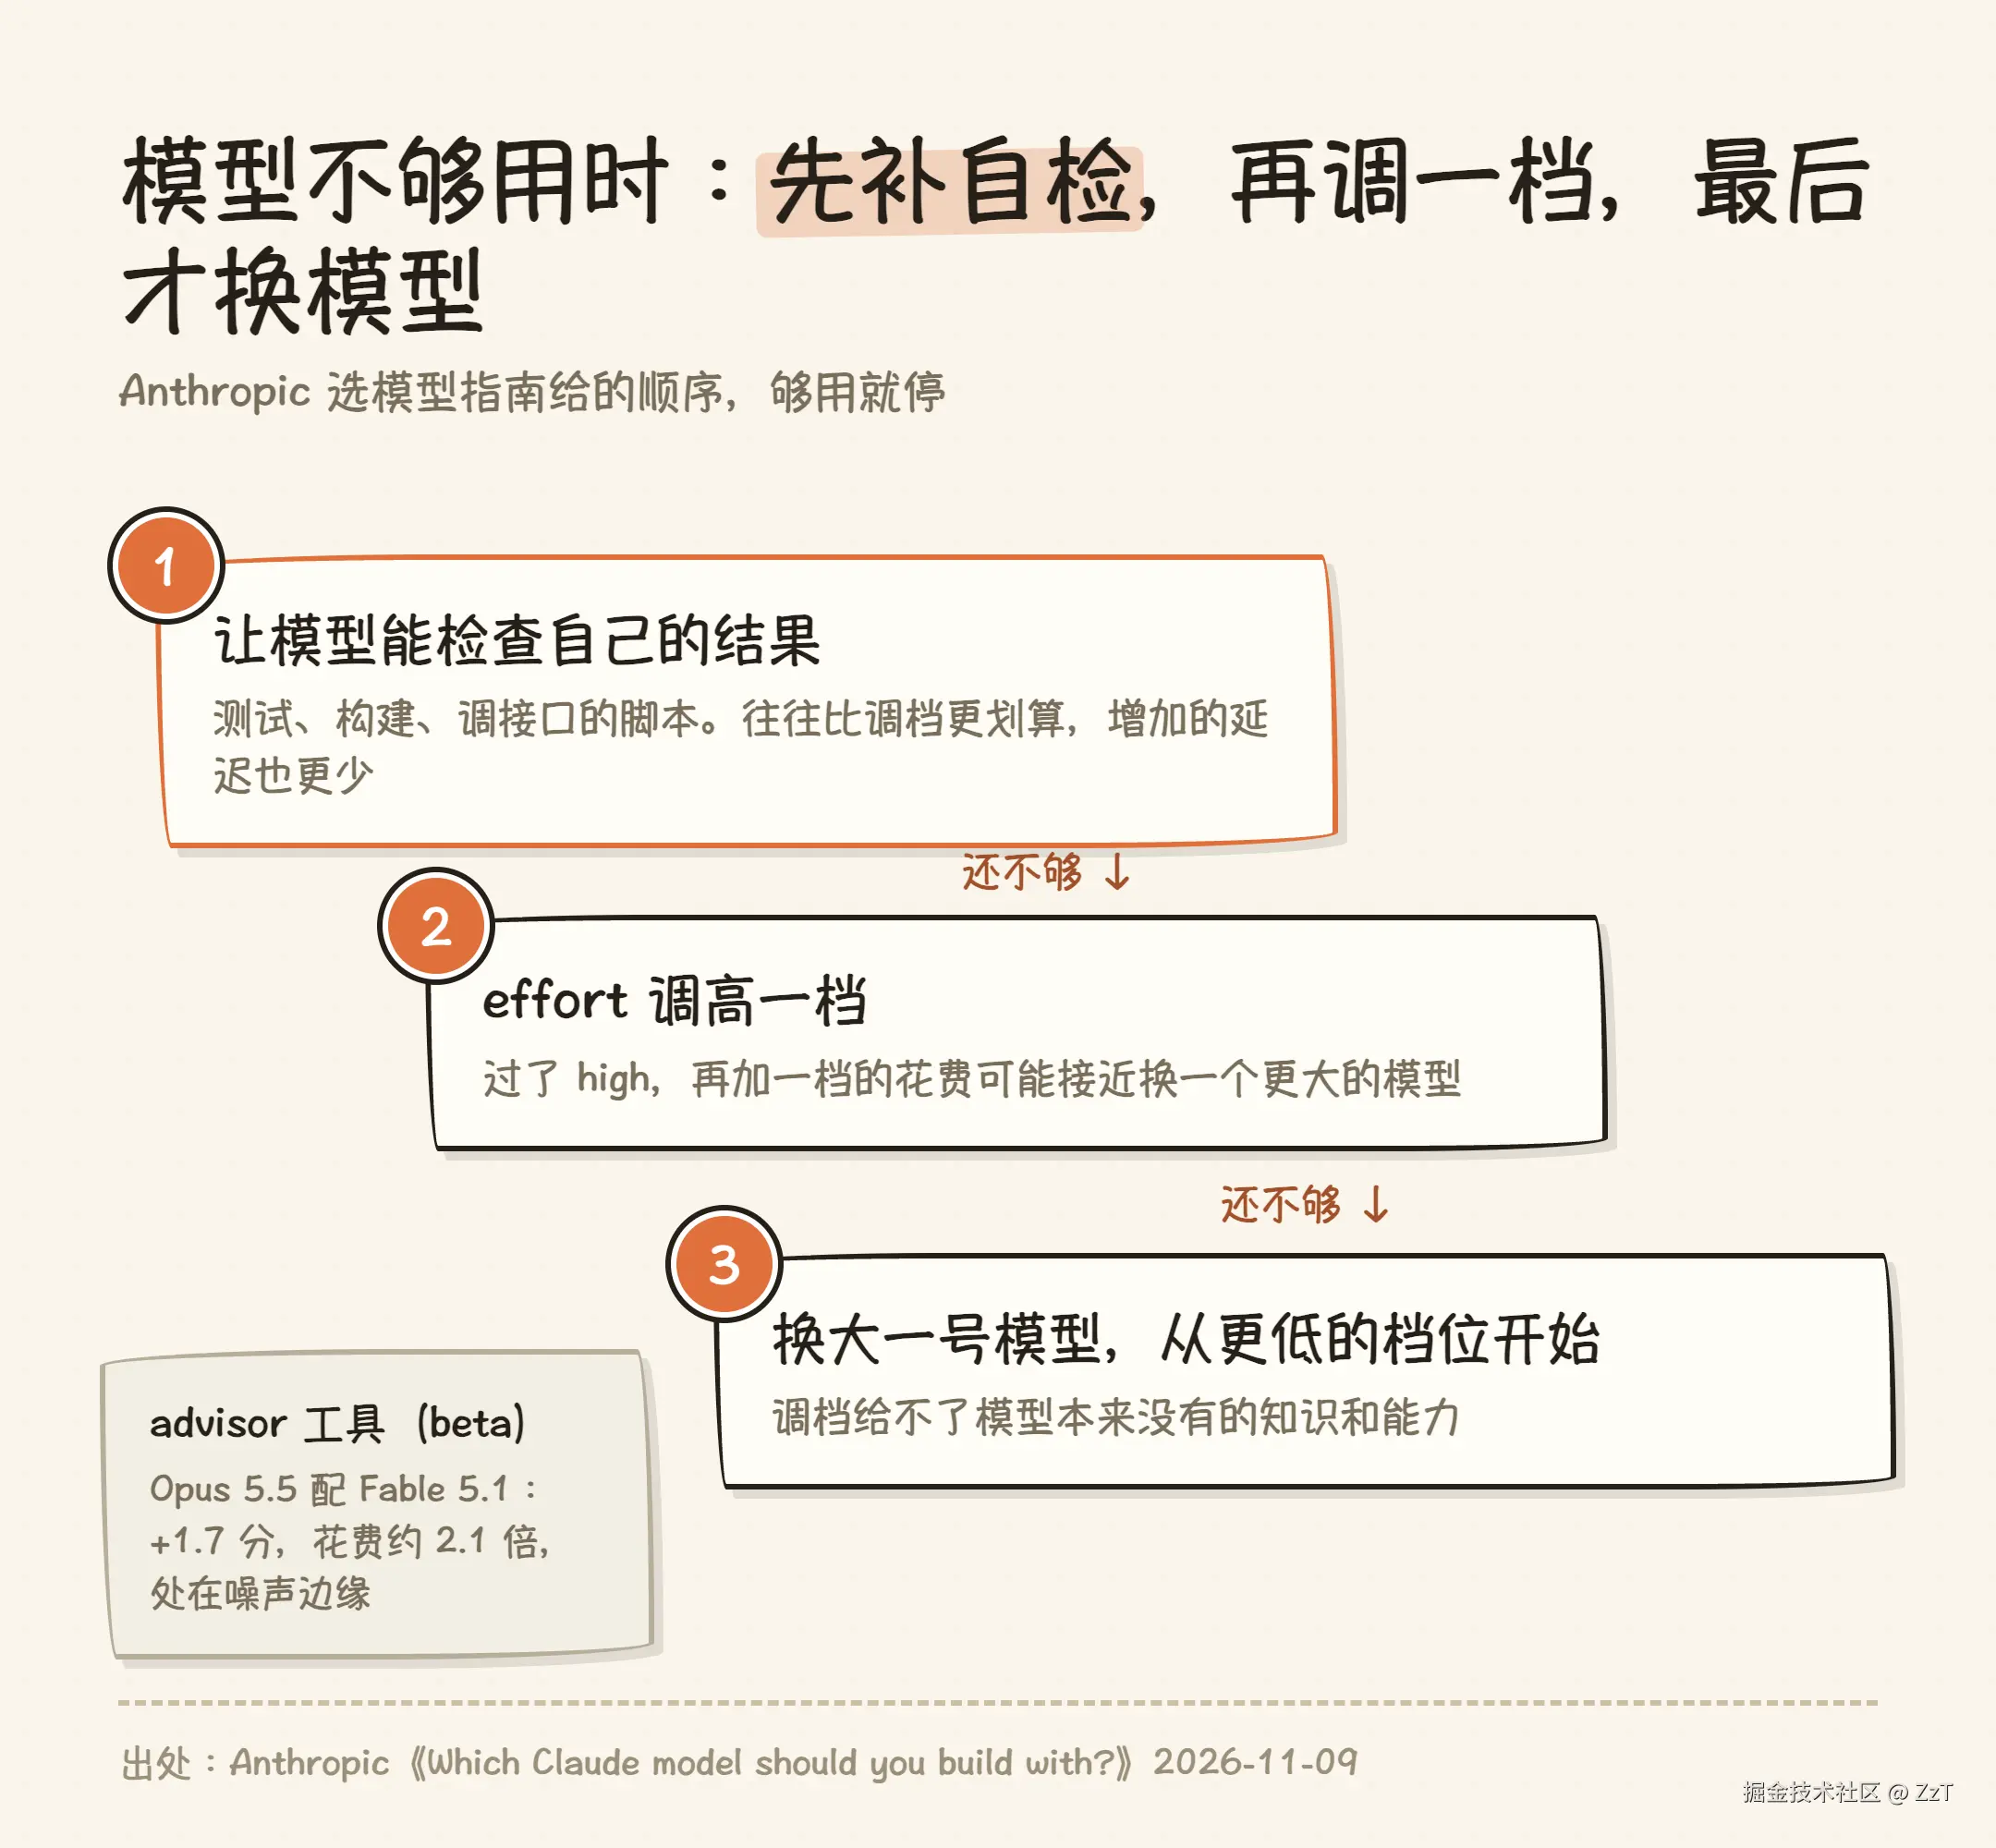
- 先确认模型能检查自己的工作,比如有测试、能构建,或者有一段调用接口的脚本。
- 再把 effort 调高一档。
- 最后才换大一号的模型,并且从比小模型更低的档位开始。
第一步排在调档之前。指南的解释是,给模型提供自检手段,往往比改档位更划算,增加的延迟也更少。
指南对 advisor 工具(beta)的评估也说明了调档和换模型之间的边界。advisor 让一个便宜的执行模型在中途向更强的模型请教。
- 内部编码基准上,Opus 5.5(high)配 Fable 5.1 做 advisor,得分 90.1%,每次尝试 2.92 美元。
- 这比 Opus 5.5 单独开 high 只高 1.7 个点,花费约 2.1 倍。
- 指南的判断是:这个差距处在多次运行的噪声边缘,大致等于调高一档 effort 能买到的提升。
Claude Code 的子 agent:内置 Explore 不再固定用 Haiku
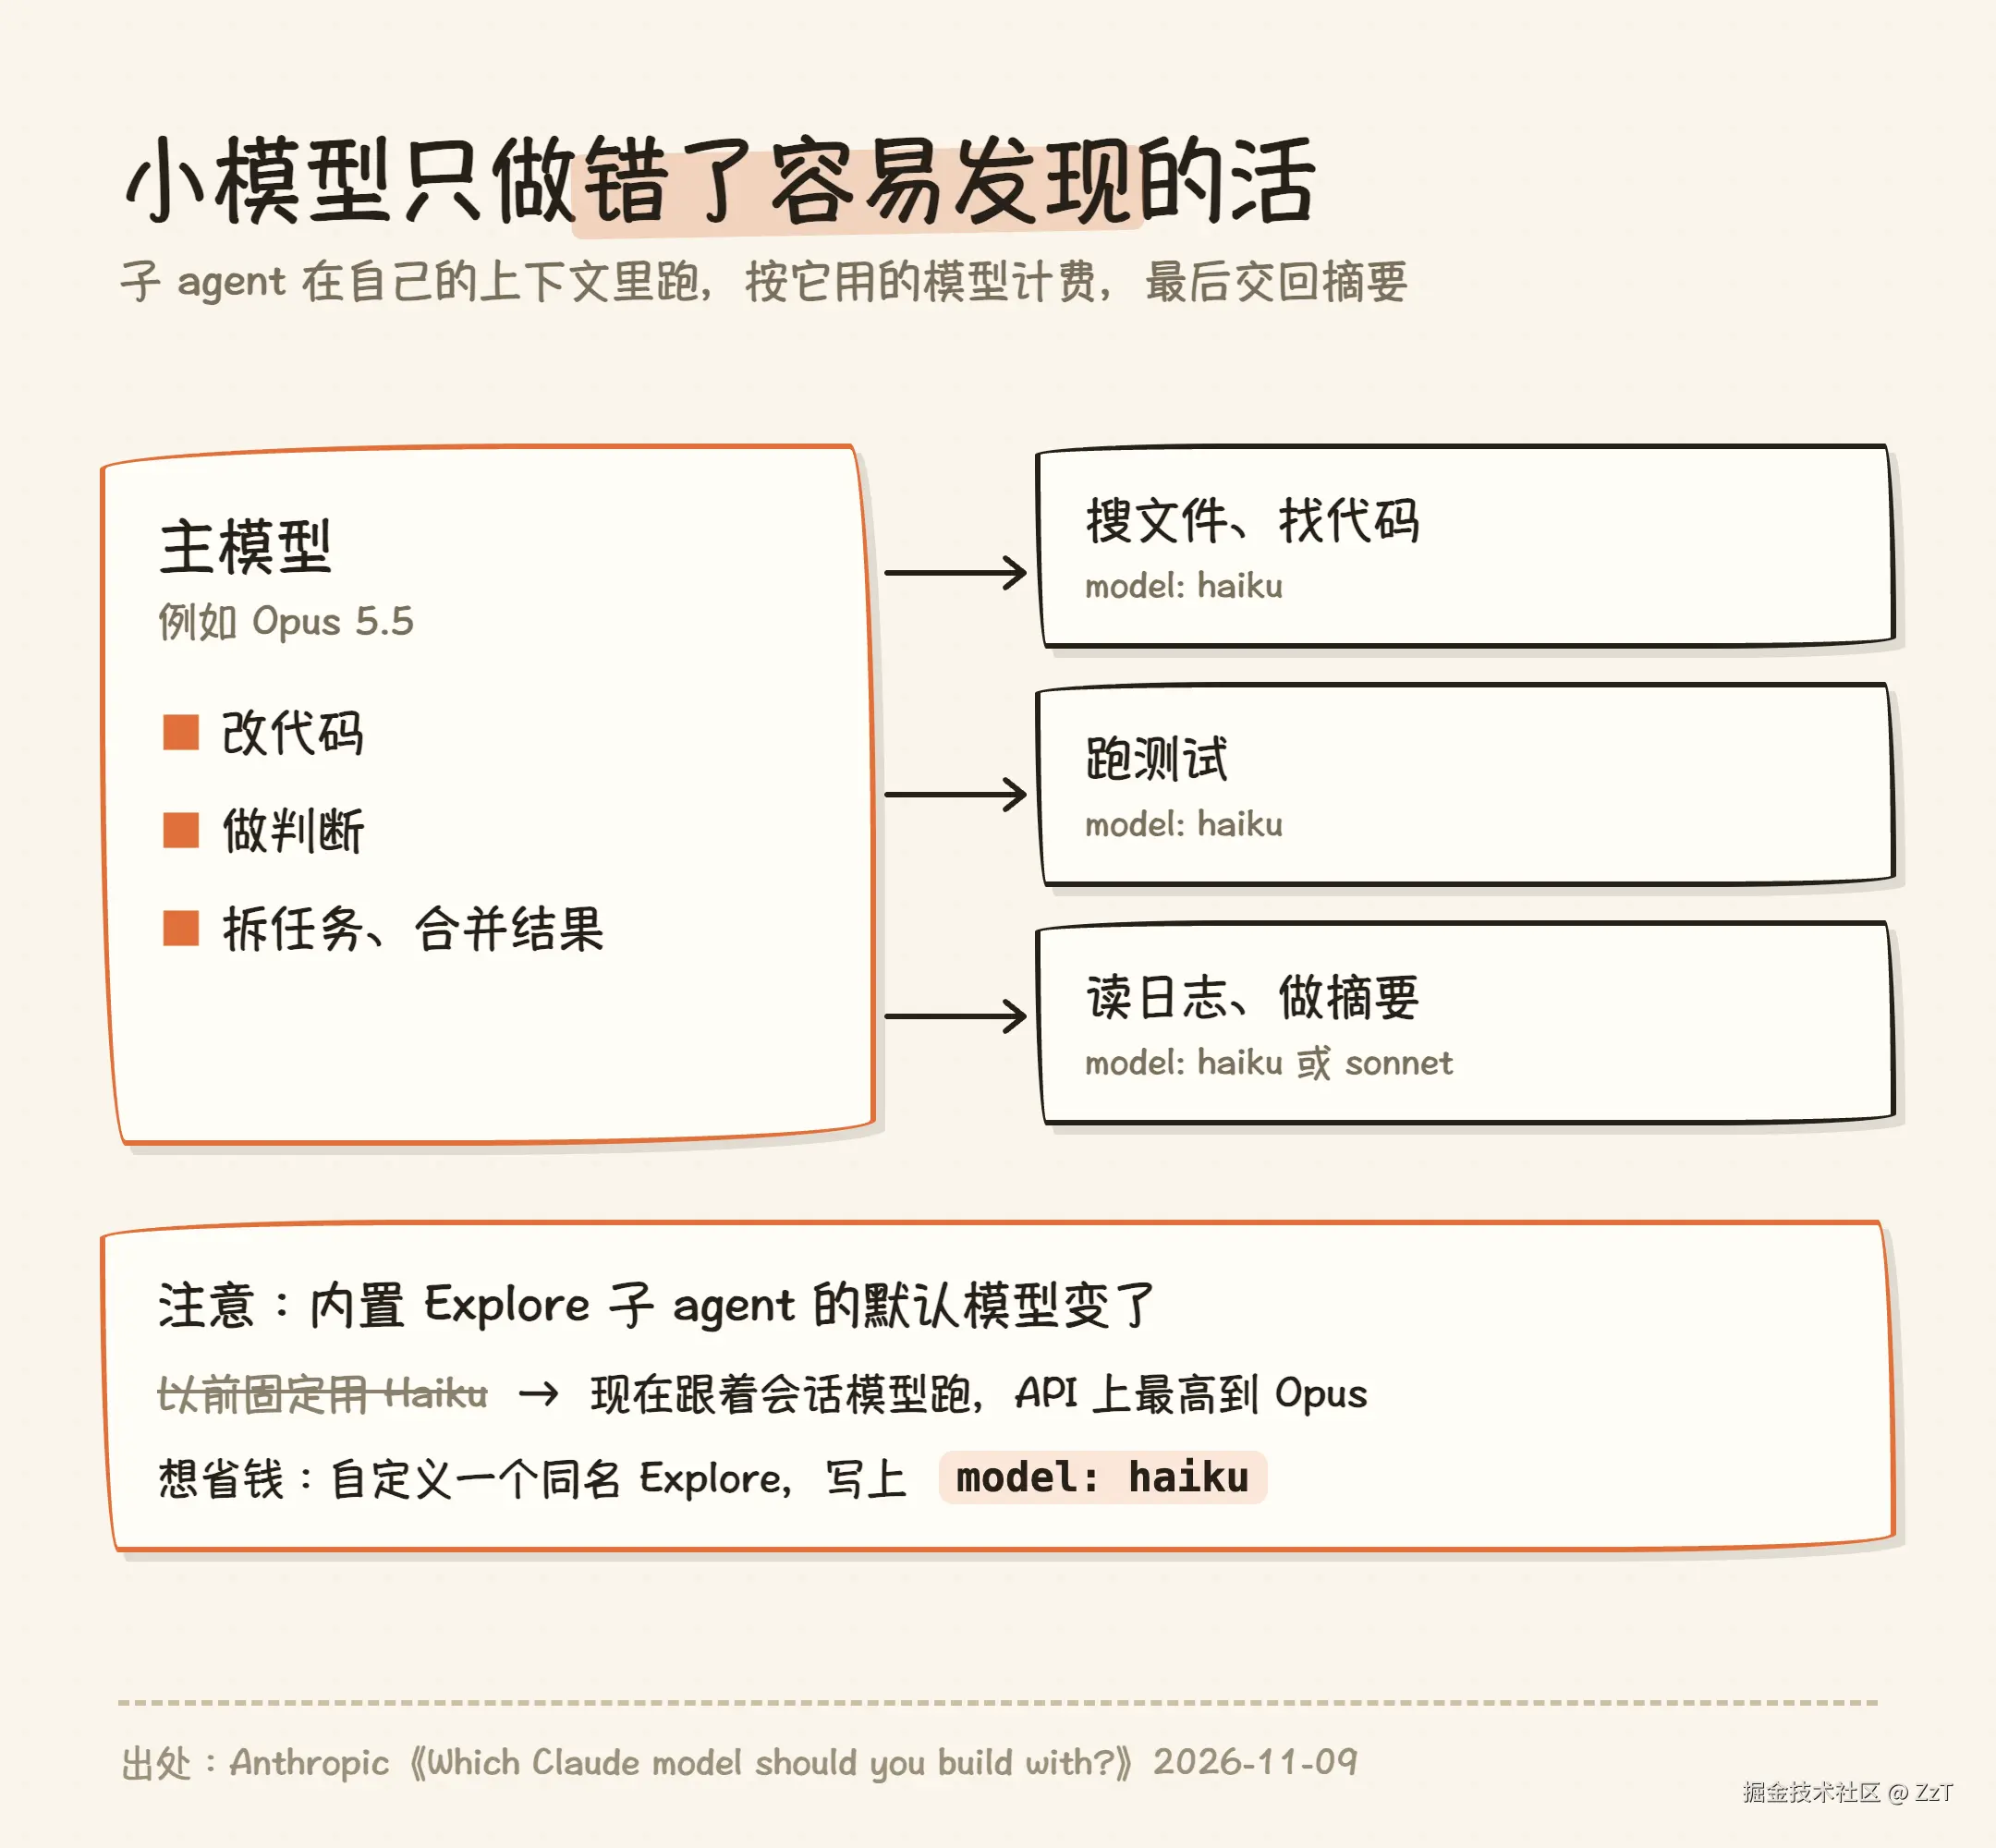
子 agent 在自己的上下文里运行,最后交回一份摘要,费用按它所用的模型计算。所以把搜索、读日志这类冗长的工作交给便宜的子 agent,主模型的上下文就能留给决策。
指南给出的设置方法是在子 agent 定义里写 model: haiku 或 model: sonnet。没有指定模型的子 agent,默认值由环境变量 CLAUDE_CODE_SUBAGENT_MODEL 控制。指南附了一个示例,保存为 .claude/agents/log-reader.md:
markdown
---
name: log-reader
description: Reads test output and logs, and reports each failing case. Use after a test run.
tools: Read, Grep, Glob, Bash
model: haiku
---
Read the logs you're given. For each failure, report the file, the test name and the first error line. Don't edit any files.
需要注意一个默认行为的变化。当前版本 Claude Code 内置的 Explore 子 agent 跟着会话的模型跑,不再固定用 Haiku;在 Claude API 上,这个模型最高到 Opus。主会话开着 Opus 5.5 时,每次探索代码库也按 Opus 计价。
指南给的办法是自己定义一个名为 Explore 的子 agent,写上 model: haiku。另外两个相关设置:
ANTHROPIC_DEFAULT_HAIKU_MODEL可以固定 haiku 这个别名指向的模型。- 在 Anthropic API 上,haiku 别名现在指向 Haiku 5.5,需要 Claude Code v2.1.293 或更高版本。Amazon Bedrock、Google Cloud 等平台上仍指向 Haiku 4.5。
分工的原则是:小模型只做出错代价低、容易发现的工作,比如找文件、跑测试、读日志;改代码和做判断留给主模型。指南的解释是,小模型读错一条搜索结果,主模型就会打开错误的文件,在上面花掉 token。
基于同样的理由,指南对 opusplan 别名持保留态度。它用 Opus 做计划、用 Sonnet 改代码,把代码修改放在了小模型上,和上面的原则正好相反。指南建议先在自己的任务上测过,再设为默认。
规模超过一个上下文窗口的工作,适合另一种结构:大模型牵头拆任务,把子任务并行分给多个便宜的 worker,最后合并。指南给的数据是:在约 2200 万 token 源码上做缺陷搜索的内部基准里,Opus 5.5 牵头、最多同时 25 个 Sonnet 5.5 worker,花费比 Opus 5.5 单独用默认档位低约三分之一,得分基本相同。一条前后依赖的步骤链,或者一个上下文窗口就装得下的工作,不适合这样拆。
中途切换模型也有成本。prompt 缓存属于写入它的模型,换模型后的第一轮要为整段对话重新付缓存写入费。指南建议先运行 /compact,或者带一份简短的书面计划开新会话。
在 Claude Code 里照着改的五项设置
指南里的数字来自 Anthropic 自己在公开基准上的运行,指南本身也要求在自己的任务上重新测量。落到 Claude Code 里,可以按下面五项操作:
- 默认从 Opus 5.5 的 medium 开始。 不确定用哪个模型时不用改,
/effort status能看到当前档位。 - 有测试的批量任务,先 low 后 high。 第一遍用
claude -p --effort low "<任务>"全部跑完,跑测试挑出失败的,再用--effort high重跑这几道。注意环境变量CLAUDE_CODE_EFFORT_LEVEL的优先级高于会话内设置和--effort,设了它,命令行里的--effort不会生效。 - 给子 agent 指定模型。 搜索、读日志类子 agent 写
model: haiku;想让探索也便宜,自定义一个同名 Explore。 - 想把 Opus 开到 high 以上之前,先试 Fable 5.2 的低档位。 切换用
/model fable,或启动时claude --model fable。 - 用自己的任务测一次。 指南给的方法是:
- 挑一批真实任务,每个配一个结果判定,比如测试通过、工单关闭、行数正确。
- 每个候选模型跑两三个档位,每次单独开会话,避免共享缓存。
- 记录每道完成的题花了多少钱,画出「分数-花费」图。
- 多模型组合只有在这张图上超过所有单模型的点时才保留。
- 想快速比较,可以在 Claude Code 里用
/model把同一个任务分别交给两个模型,再对比/usage的结果。
指南按任务给出的起点可以压缩成下表:
| 任务 | 起始模型 | 起始档位 |
|---|---|---|
| 日常工程、调试、多 PR 功能开发 | Opus 5.5 | medium,不够再 high |
| 范围明确的修 bug、按 spec 开发 | Sonnet 5.5 | medium,难题再 high |
| 搜文件、读日志、做摘要的子 agent | Haiku 5.5 或 Sonnet 5.5 | 模型默认 |
| 分类、路由、大批量抽取 | Haiku 5.5 | medium |
| 大型重构与迁移、架构规划、带很多子 agent | Fable 5.2 | medium,再 high |
| 不确定 | Opus 5.5 | medium |
按「每道完成的题」而不是「每百万 token」计价之后,这份指南里的三条结论都和直觉相反:低档加重跑比全程高档更准,贵一倍的模型在难题上可能更省,调档之前该先补自检。
三条结论都依赖同一个前提:结果能被自动检查。一个没有测试的项目,最先该补的不是档位,而是测试。