Qwen -Drive 的 91.4 分,究竟选中了什么?
一张成绩表里,Qwen-Drive-1.0-RL 的 NAVSIM 分数既是 90.7,也可以是 91.4。区别藏在后者旁边的 best-of-6:每个场景生成六条候选,再用该场景的 PDMS 评测分数选最高的一条。91.4 如实描述了这次评测,却没有证明车辆在当时可用的信息下,已经知道该选择哪条轨迹。1
这不是要抹去多候选结果。它能告诉研究者,候选 集合 里还有多少潜力;默认输出与择优输出的距离,也能帮助分辨生成和选择两个问题。但拿这个数字制定接入方案时,必须补上选择所用的信息、评分场景的分母、时间网格,以及结果来自哪种交互环境。否则数字没有抄错,工程判断仍可能做错。
下面沿官方评测文档和固定源码,把一个最高分还原成可比较的实验。本文引用的 模型 成绩均为官方报告;本次只核对论文、文档与代码,并做静态检查和显式时间算术,没有运行权重、数据集、评分器、仿真或车辆。
91.4 描述的是六个候选中的评测择优
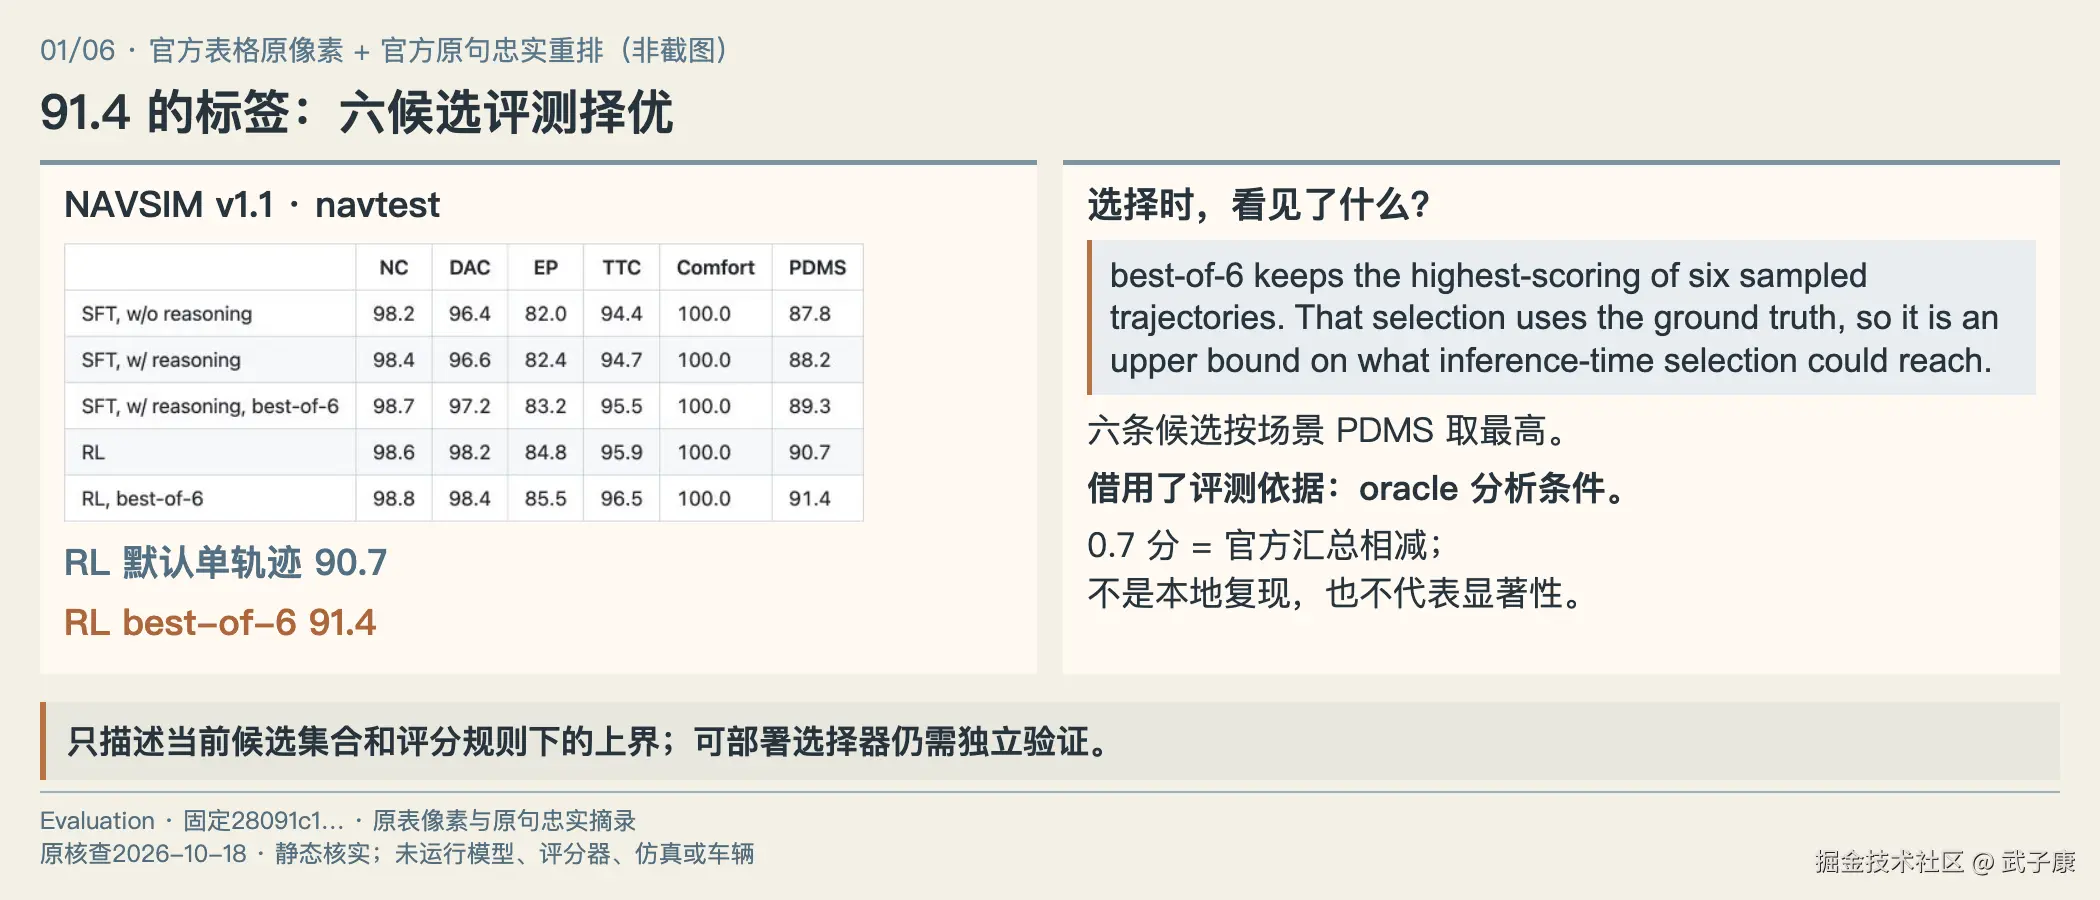
官方NAVSIM v1.1 navtest中RL默认单轨迹90.7、best-of-6为91.4;按场景PDMS择优,0.7是官方汇总相减,不是本地复现或显著性。
官方表使用 NAVSIM v1.1 navtest。 SFT 是模仿学习后的规划专家,RL 是进一步经过奖励优化的专家。相同表格列出了这些结果:1
| 官方条件 | PDMS |
|---|---|
| SFT,不带规划推理条件 | 87.8 |
| SFT,带规划推理条件 | 88.2 |
| SFT,带规划推理条件,best-of-6 | 89.3 |
| RL,默认单轨迹结果 | 90.7 |
| RL,best-of-6 | 91.4 |
这几行至少改变了三件事:是否使用 推理 条件,专家是否经过 RL,以及是否借助评测选择六条中的最好一条。把 87.8 到 91.4 的全部差距归为"会推理了",会把训练、输入条件与选择预算混在一起。即使只比较 SFT 的两个推理模式,也不能把整套条件变化直接当成某一句理由的因果贡献。
在 RL 行内部,91.4 比 90.7 高 0.7 个分数点;在带推理的 SFT 行内部,89.3 比 88.2 高 1.1 个分数点。这是官方汇总值的简单相减,不是本地复现实验,也没有给出统计显著性。它提示值得研究推理时选择,但没有交付一个能在道路上无标签选中最好候选的选择器。
这里的 oracle ,是允许看见评测依据后再择优的分析条件。它提供当前候选集合在这个评分规则下的上界,不是所有驾驶能力的上界。新增一个只能读取当前观测的学习排序器,仍需在独立数据上验证它追上了多少;不能把 oracle 的名次直接记到排序器名下。
同一份预测文件,不同指标可能选择不同轨迹
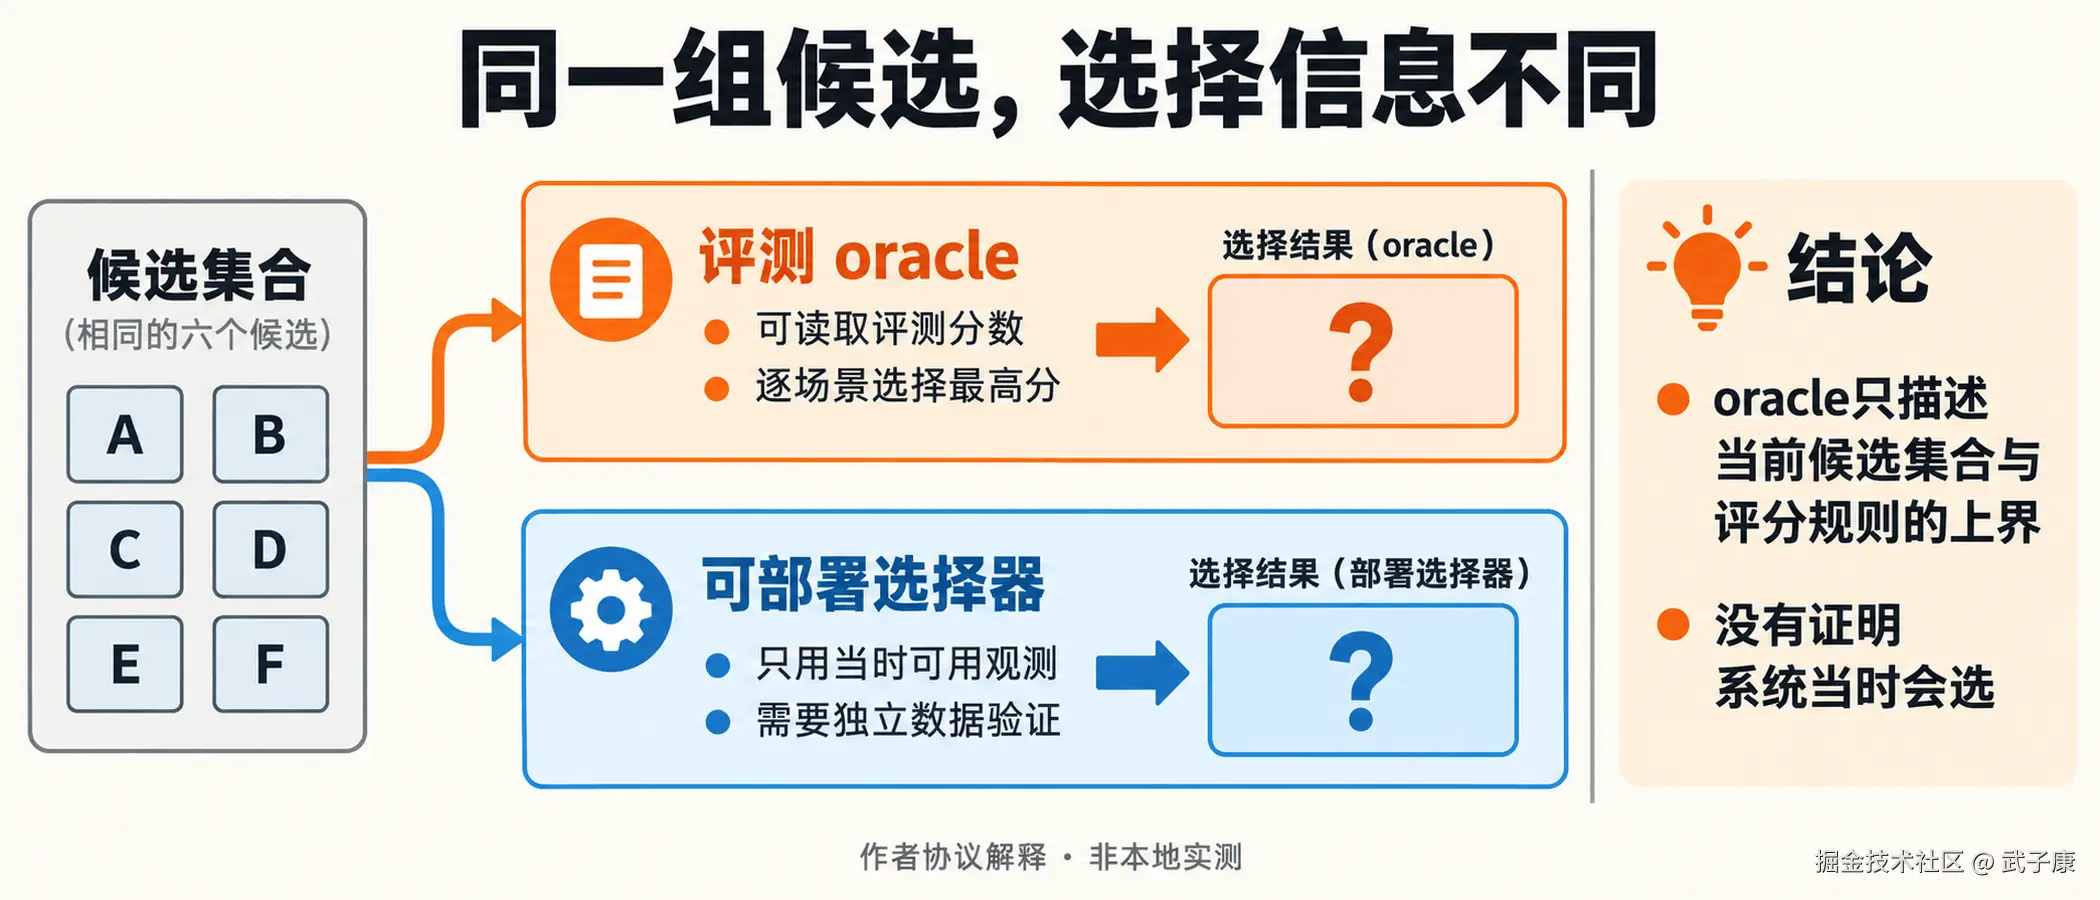
同一候选集合分成两个信息条件:评测oracle可看评分再择优,可部署选择器只读当时可用观测且需独立验证;oracle只给当前候选和评分规则的上界,不是完整驾驶能力上界。
打开官方 eval_navsim.py,有两个容易被总分掩盖的分支。位移误差报告取每个场景的候选零;PDMS 分支则遍历候选,用 score 最大的那一行进入场景汇总。2
python
predictions = np.stack([np.asarray(r["trajectories"])[0] for r in scorable])
best[key].append(max(candidates, key=lambda row: row["score"]))
这两行来自不同函数,放在一起是为了比较选择对象,不是完整的可执行片段。如果文件有六条候选,位移误差和 PDMS 就不一定在评价同一条。一个报告里同时出现 ADE 与 PDMS,也不自动意味着"这一条部署输出同时取得两项成绩"。若目的是比较真实选择器,应该先固定它选中的候选,再让各项指标评价该输出;oracle 结果另行标注。
PDMS 分支还分别处理 interp 和 direct 两种网格。它对两种处理分别取最高分,所以两组结果甚至可能来自不同候选索引。源码没有在汇总表里保留这些逐场景索引;想分析选择器,需要额外保存实际选择与逐候选分数,而不是从两个平均数反推。
Waymo 脚本也有自己的选择规则。只存在一条候选或缺少偏好参考时,它返回候选零;有多条且有偏好标签时,先找评分最高的偏好轨迹,再选与这条参考最接近的预测。这个分支用到了标签,而且"最接近最高评分参考"不等同于逐候选直接计算 RFS 后取最大。写复现说明时应保留实际规则,不能统一缩写为"模型自动挑选"。3
因此,候选数 N 既影响计算预算,也改变结果的含义。比较生成器时固定候选集合及随机设置;比较选择器时固定可用信息与训练、校准、测试划分。若另建选择损失来比较可部署选择与 oracle,必须先保证指标、场景、候选集合完全一致。没有逐场景预测的本次研究,不计算这项差距。
navtest 是目标切分,实际分母还要检查
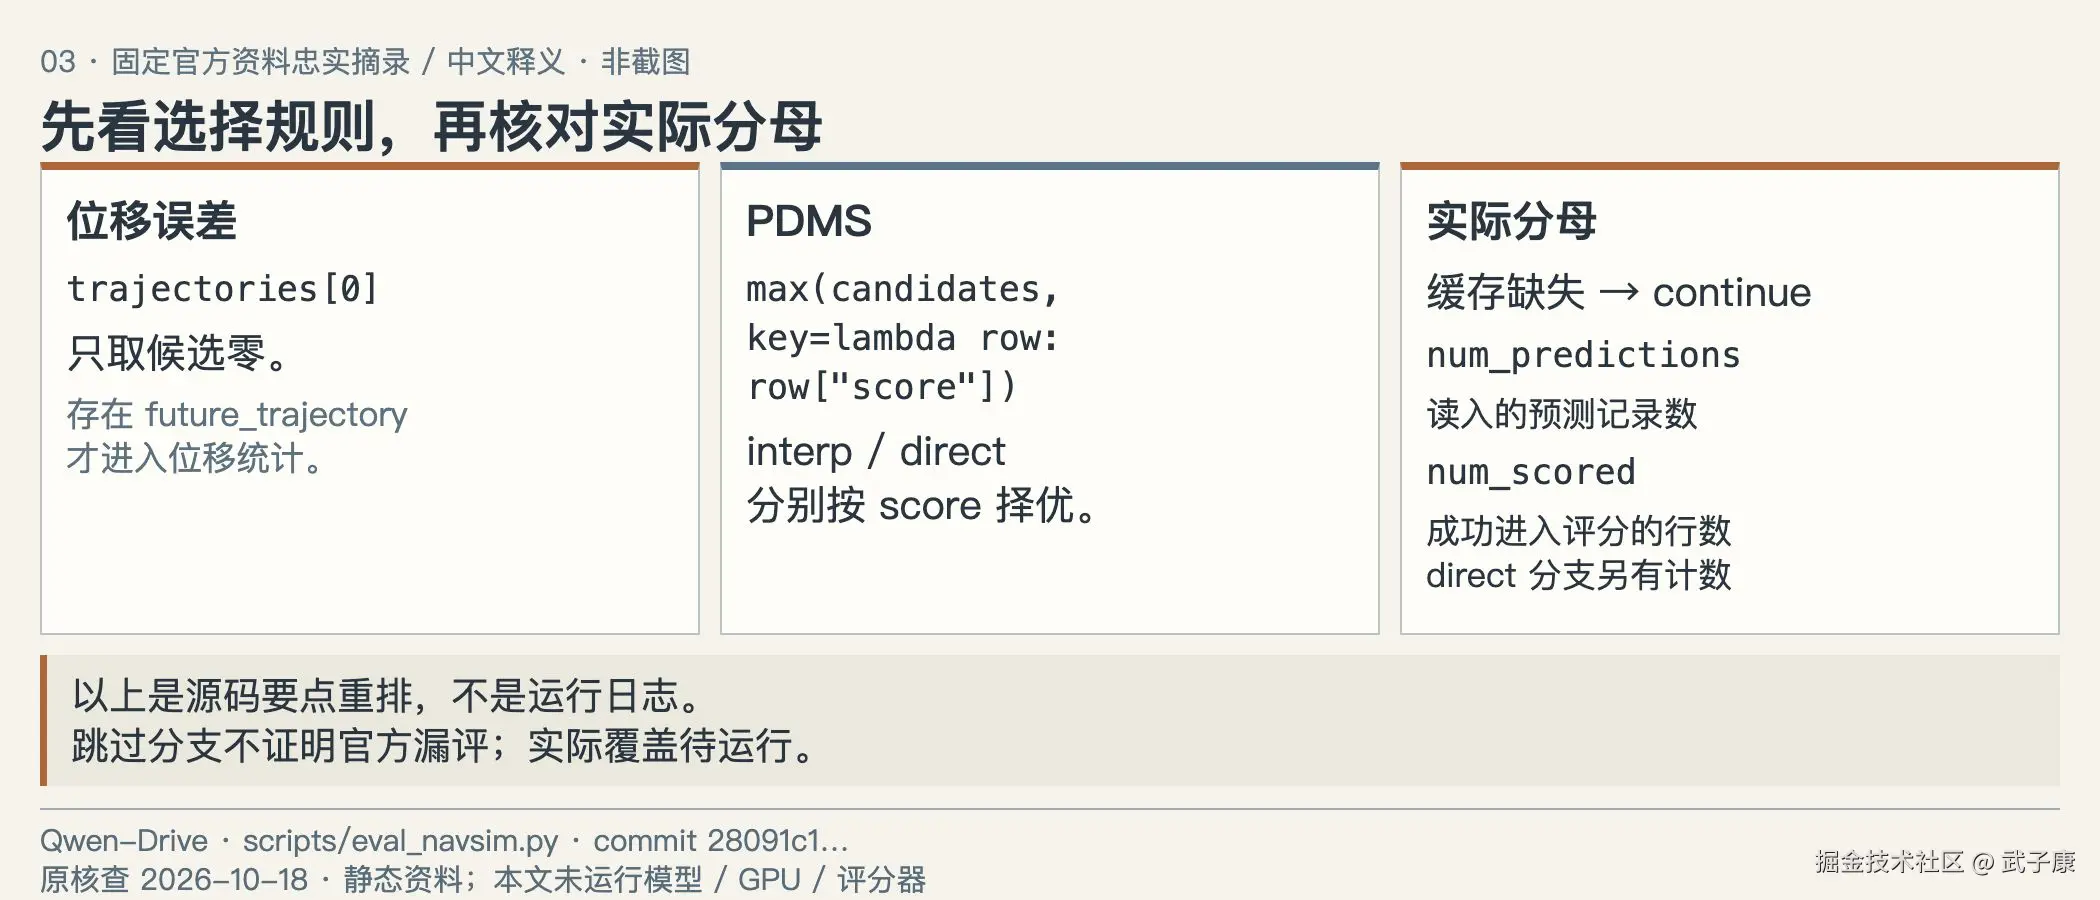
位移误差取候选零,PDMS对interp/direct分别取max;缓存缺失会跳过场景,num_predictions与num_scored分开。源码风险不证明官方漏评;实际分母待运行。
版本和 split 是实验身份的起点。NAVSIM v1.1 的 navtest 配置指向 test 数据,并加载对应场景过滤器。但配置名无法证明某次预测文件完整覆盖了过滤后的全部目标场景,更无法证明它们全部成功进入评分。4
官方读取预测文件的逻辑遇到没有换行结束的最后一行会停止。这是在防止中断写入的残行被误读。PDMS 分支加载某个 token 的 metric cache 时,如果遇到 KeyError 或 FileNotFoundError,则跳过该场景继续。最后输出的 num_predictions 是读入记录数,num_scored 才是该评分分支纳入汇总的数量。2
这不证明官方已报告的 91.4 存在漏评。它说明一个可以从代码核对的复现风险:即使预测文件来自名为 navtest 的目录,缺缓存或中断文件仍可能改变实际分母。更隐蔽的是,不同模型若缺失不同场景,直接比较两份平均值会把场景难度差异混入模型差异。
复现时应保留目标 token 清单、实际预测 token、成功评分 token、缺失原因和重复记录检查;对成对比较使用相同的有效场景集合,并公开剔除规则。不能只写"运行成功",也不能因为脚本输出一个分数就默认完整覆盖。这里没有真实预测文件与 metric cache,实际覆盖数保持"未核实",不借用数据集标称规模填满它。
这一点同样影响小分差的解释。即使两次均值只差零点几,若不知道是否是同一分母,也谈不上进一步判断随机性和置信度。取得逐场景配对结果之后,才有条件研究采样种子、道路分布与同一日志内相关性;本次不从汇总小数伪造误差条。
时间网格会改变被评分的轨迹
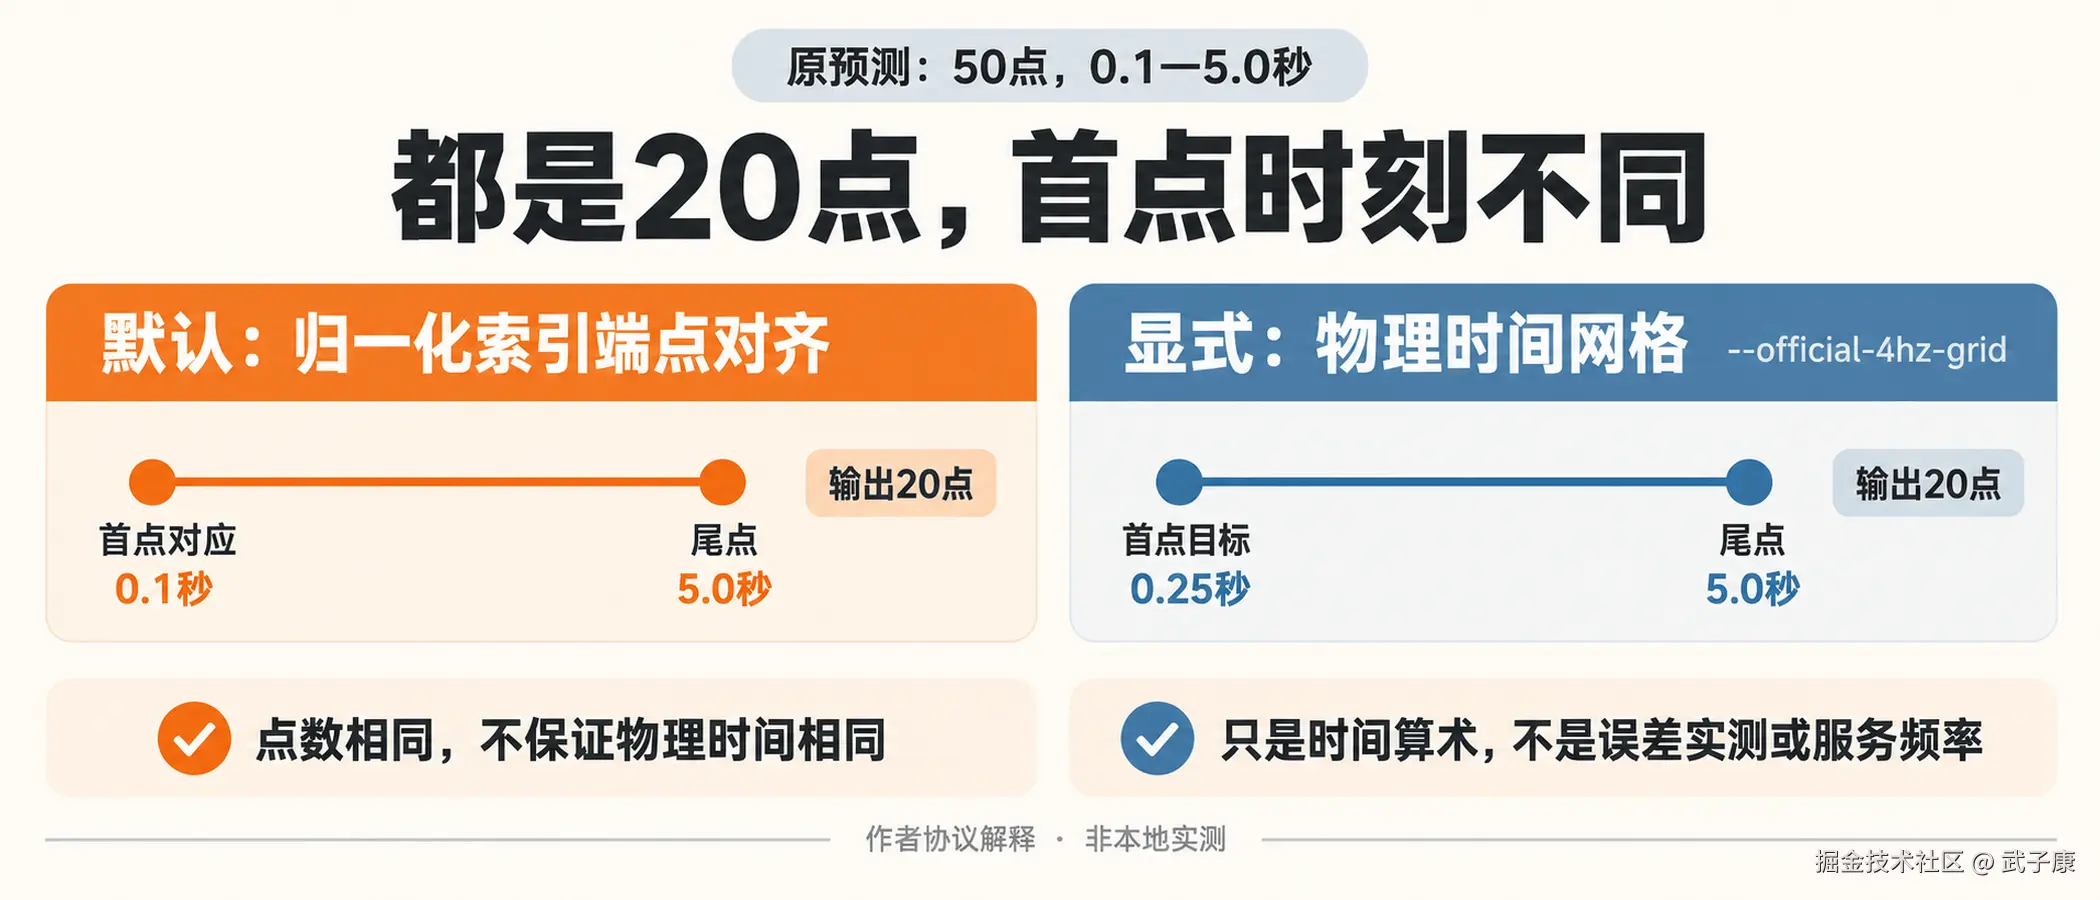
作者按固定源码作时间算术:50点0.1---5.0秒转20点,默认归一化索引端点对齐首点对应0.1秒;显式official-4hz-grid目标首点0.25秒,尾点均5.0秒。不是误差实测,不推分数升降或服务10Hz。
Qwen-Drive 输出 50 个未来点,覆盖 0.1 到 5.0 秒,间隔 0.1 秒。它不是每秒被服务调用十次的证明;这是预测轨迹内部的时间采样。不同 benchmark 需要不同网格,官方适配器在输出与评分器之间转换。5
NAVSIM 的 interp 取索引 4、9,直到 39,共八个点,物理时刻是 0.5 到 4.0 秒;评分器再使用相应插值路径。direct 保留前四十个 10 Hz 点,并在调用中跳过这一步插值。相同模型输出经两条路径进入评分,不应把带 _direct10hz 后缀的诊断结果与默认结果无标记混用。2
Waymo 更容易发生一种看起来合理的改动。其目标是二十个 4 Hz 点,但官方公布数值使用的默认转换,把输入和输出都映射到 0 到 1 的归一化索引,保留首尾端点;显式开启 --official-4hz-grid 后,才按照预测的 0.1 到 5.0 秒,向目标的 0.25 到 5.0 秒做物理时间插值。5
可以只看第一个点理解两者区别:归一化端点对齐把输入的第一个未来点带到输出首位,对应的原预测时刻是 0.1 秒;绝对时间路径的第一个目标时刻是 0.25 秒。二者最后都到 5.0 秒,中间却不是同一个时间对应关系。这里是时间网格算术,不是模型误差,也不能由此猜测改用另一网格后分数会上升还是下降。
所以"都变成二十个点"并不保证同口径。复现公开数字时保留公布约定;研究物理时间对齐时可以另报显式网格,但要写清改变了什么。航向角也不能跨正负 π 直接线性插值,源码通过正弦、余弦处理回绕。ADE 还须说明平均到几秒,FDE 则关注端点;只留下一个"ADE"标签,后续汇总很容易丢失这些条件。
验证集名称不保证它没有参与优化
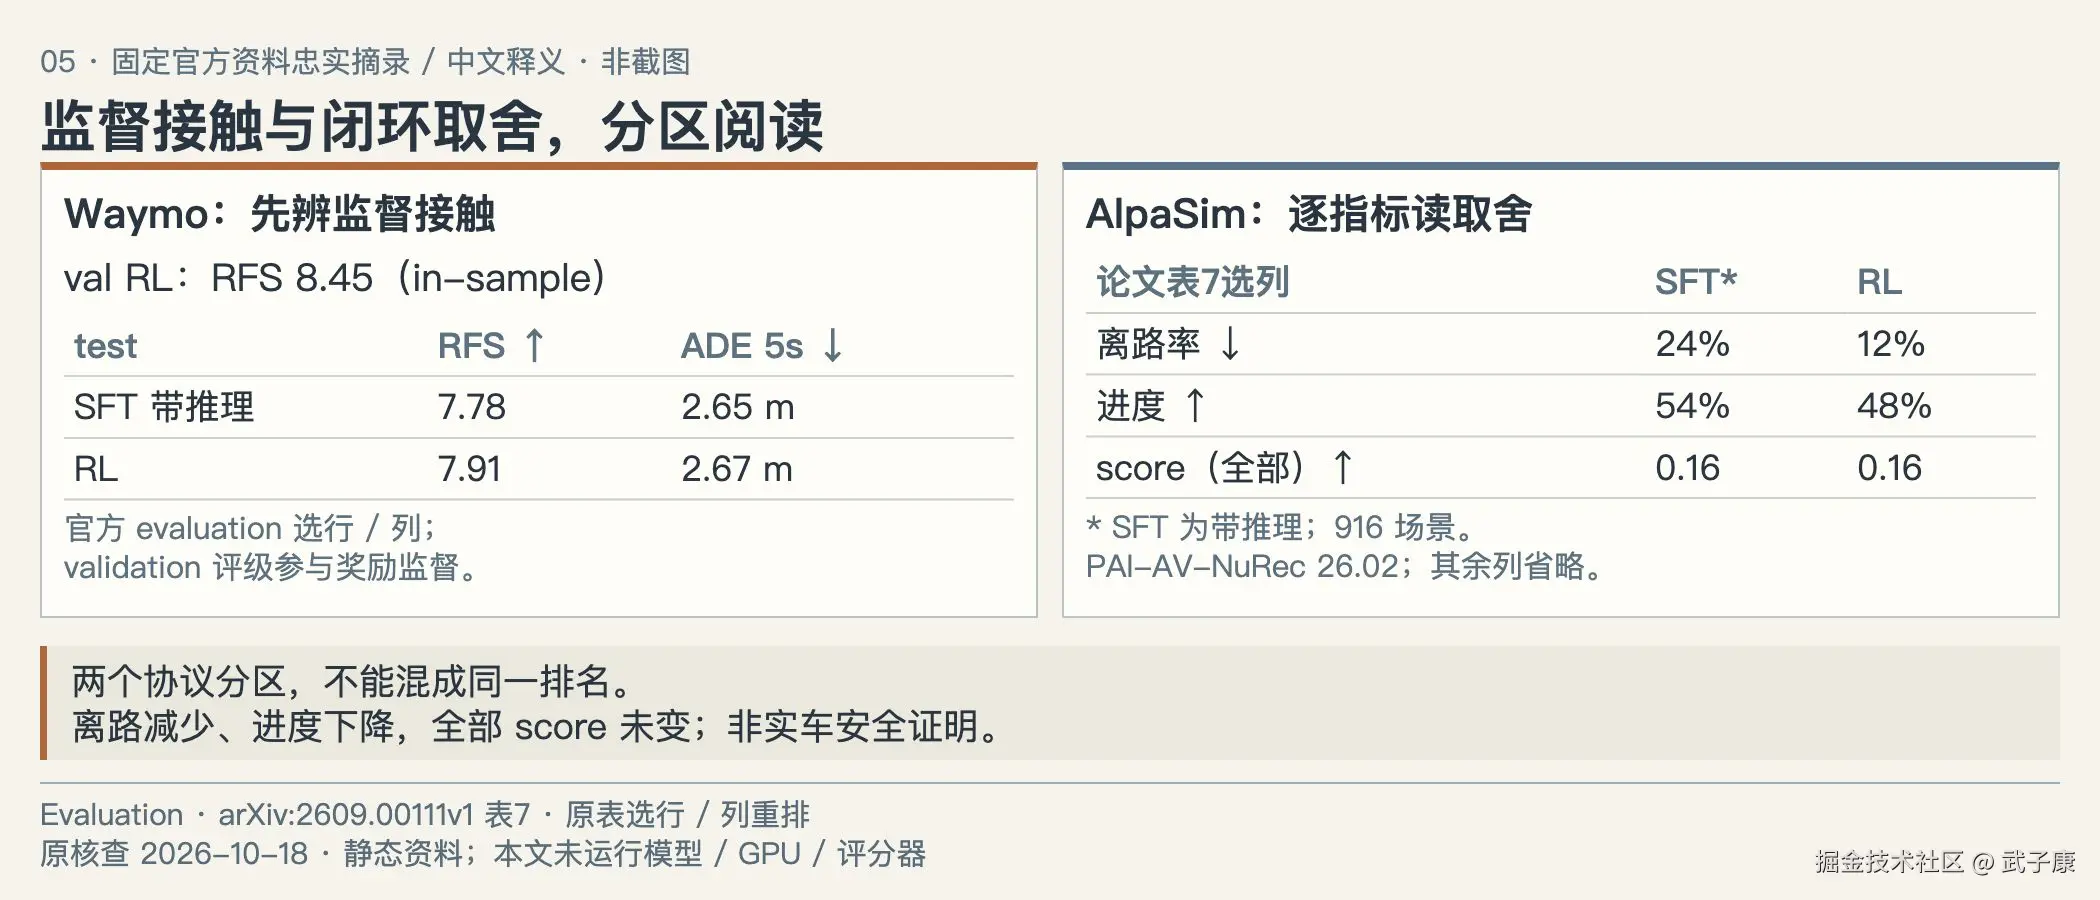
Waymo validation RL8.45属in-sample; test RFS7.78→7.91而ADE2.65→2.67m。AlpaSim带推理SFT→RL离路24→12%、进度54→48%,全事件score均0.16;不能把近距离事件改叫碰撞。不同协议分区不混表。
Waymo E2E 的官方结果中,SFT 带推理在 test 上的 RFS 为 7.78,RL 为 7.91;相应 5 秒 ADE 从 2.65 米到 2.67 米。偏好评分改善与对日志未来的位移误差略增,可以同时发生,因为两个指标回答的问题不同。1
更醒目的 8.45 来自 validation 的 RL 行。文档和论文明确说明,这部分偏好评分用于奖励优化,因此这行是 in-sample。它能够说明系统适应了训练中接触的反馈,不能被描述成在未见场景上"超过人类驾驶"。相对而言,独立 test 的改善更适合讨论泛化,但仍只限于该测试协议与偏好目标。6
对于 PhysicalAI,论文也区分标准 644-example split 和从 held-out test clips 整理的 700-frame subset,前者按官方构造与公开训练数据有重叠。不能从一个切分取平均 ADE,再从另一切分取 minADE,拼成同一组优点。平均候选误差评价一组候选的整体,minADE 则借助真实未来挑误差最小的一条,二者也不是同一个部署输出。7
拿带推理 SFT 的 700-frame subset 为例,官方 5 秒平均 ADE 为 1.23 米,minADE 为 1.11 米;RL 为 1.27 与 1.15 米。这组对照保留了一个现实取舍:某些奖励成绩提高,不意味着所有开放环位移误差都降低。它不否定 RL,也不足以独立诊断策略为什么改变。
因此,成绩记录里"是否涉及训练反馈"应该比"这个 split 叫 val 还是 test"更具体。生成器、选择器和评分代理各自用过哪些数据,都需要区分。把测试标签用于候选选择,仍然可以形成有价值的 oracle 分析,但必须继续保留该标签。
闭环证据要与进度和事件一起阅读
NAVSIM v1.1 是伪闭环:自车轨迹经过运动模拟,周围车辆回放记录运动,规划器只被查询一次。它能增加道路、碰撞等约束的检验,却不能观察策略不断读新画面、重新行动后的误差积累和恢复。官方 v1.1 指标又将无自车责任碰撞与可行驶区域作为乘法项,组合进度、TTC 与舒适性;不能把表内各列平均值直接代入单场景公式重建平均总分。8
Qwen-Drive 还报告了 AlpaSim 闭环实验,因此不能把它说成"完全没有闭环证据"。论文使用 PAI-AV-NuRec 26.02 的 916 个场景,在自车行为改变后重新生成观测并反复规划。这里的场景数属于论文报告,不是本地运行完成数。6
从带推理 SFT 到 RL,离路率由 24% 降到 12%,进度由 54% 降到 48%;全事件 AlpaSim score 都是 0.16,责任事件口径的分数从 0.27 到 0.37。同时,全事件 close encounter rate 从 38% 到 41%,责任口径从 12% 到 11%。close encounter 是近距离事件,不能直接改称交通碰撞率。
这些列需要一起看。论文作者将变化解释为更安全但更保守的行为;从汇总表本身,我们能够确认的是上述指标取舍,尚不能定位每一种场景的机制。若要决定接入,下一步应查离路减少发生在哪些场景、是否伴随停滞、责任划分和全事件为何变化,以及同一输入预算下能否稳定恢复。单一总分不会替我们回答。
模拟器结果也没有自动成为实车安全保证。传感器延迟、控制器、环境覆盖和车辆本体都会引入新的条件;它们需要实际系统证据。更简单的使用方式,是先把公开 benchmark 当成筛选研究候选的依据,在允许范围内做离线对照;没有必要为了读懂一张表就宣称完成部署验证。
把下一次比较写成一条可复核记录
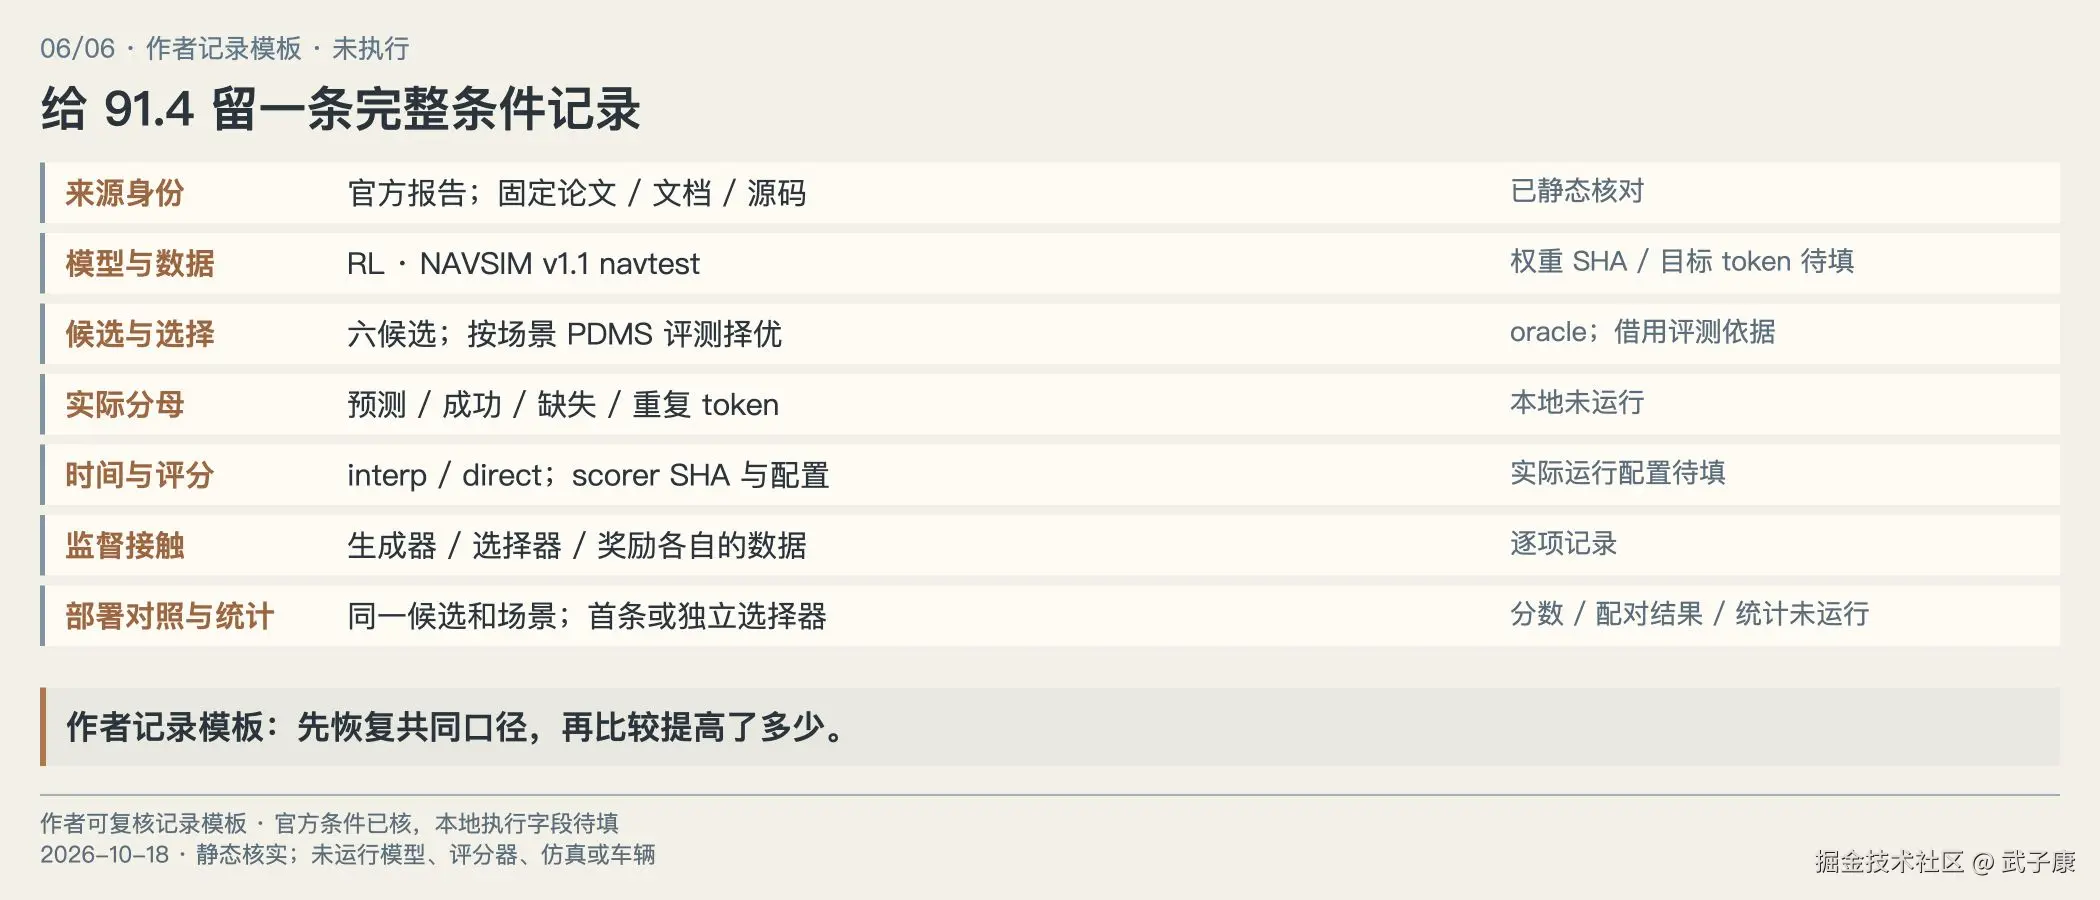
唯一产物记录来源身份、模型权重、数据与实际分母、候选和可用标签、时间评分网格、监督接触、可部署对照与不确定性。官方条件已核,本地权重/覆盖/分数/统计与车测均未运行。
如果只保留一项产物,可以把每个成绩扩展成下面这条记录。已核对的官方条件与尚未取得的真实运行证据分开填写,空白比想象的完整更可靠。
| 字段 | 本文以 91.4 为例的填写与待补项 |
|---|---|
| 来源身份 | 官方报告,非本地复现;论文 v1、评测文档及固定源码 SHA |
| 模型与条件 | Qwen-Drive-1.0-RL;具体权重文件 SHA、本地运行版本尚未取得 |
| 数据协议 | NAVSIM v1.1 navtest;实际目标 token 清单待运行留存 |
| 实际分母 | 官方汇总91.4;本地 num_predictions、num_scored、缺失/重复清单未运行 |
| 候选与选择 | 每场景六候选,按评测 PDMS 选择最高;借用评测依据,oracle |
| 时间与评分 | 保留公开结果的适配约定;本地显式记录 interp/direct、scorer SHA 与配置 |
| 监督接触 | 记录生成器、选择器与奖励各自用过的数据;不能只靠 split 名称判断 |
| 可部署对照 | 同一场景、同一候选集合下的首条或独立选择器结果,尚未运行 |
| 不确定性与边界 | 逐场景结果、种子和覆盖检查未取得;不推导显著性、长期交互或实车安全 |
使用这条记录时,先检查是否在比较同一种结果,再讨论提高了多少。若 N 或可用标签不同,先分开呈现;若网格或有效分母不同,先恢复共同口径;若只是 oracle 上界更高,就把它转成选择器研究问题。这样,91.4 既能保留应有的研究价值,也不会被误读成系统已经具备的完整决策能力。
参考来源
-
官方Evaluation文档,固定版本。表格与协议均为官方报告。 ↩︎ ↩︎ ↩︎
-
官方PhysicalAI评测脚本,切分说明见论文表5。 ↩︎