DeepSeek Harness Memory 插件总结:
一篇面向实践者的 DSH Memory 插件选型与落地指南 本文基于 DSH 官方文档、插件目录、插件维护者公开 README 和已核验的官方接入说明整理。社区插件迭代很快,文中能力描述以公开资料为准;正式安装前仍应锁定 DSH、Node/Python、插件包和后端服务版本,完成最小可运行验证。
引言:Memory 的问题,最终会走向两层
Coding Agent 每次开启新会话都从零开始,就很难成为稳定的工作搭档:它不知道项目约定、上次已经验证过的排查路径,也不知道用户反复纠正过哪些偏好。
Memory 插件解决的是一条完整链路:从对话和任务结果中提取值得保留的信息,按当前任务召回相关内容,把内容注入本轮上下文,并在记忆错误时允许纠正、降权、过期和回滚。
但"能记住"只是第一步。一个人的编码偏好可以直接服务本人;一条团队规则却会影响所有成员、项目和 Agent。因此,Memory 的落地天然分成两个问题:
- 插件调研:有哪些 DSH Memory 插件?它们如何捕获、检索和存储记忆?
- 分层方案:如何让个人记忆沉淀为可信的团队记忆?哪些插件适合个人层、项目层和团队层?
全文分为两章:第一章讲插件是什么、怎么工作、适合谁;第二章讲如何组合组件,把个人经验自动提炼成团队记忆,并用构建排障案例走完提取、验证、晋升、召回和失效处理。
第一章:DSH Memory 插件调研
1. DSH 架构中的 Memory 位于哪里?
DSH 是插件优先的 Agent Harness,模型、工具、会话、上下文和 Memory 都通过插件扩展。Memory 不是一个单独的"聊天记录文件",而是横跨 Agent 生命周期的处理链路:
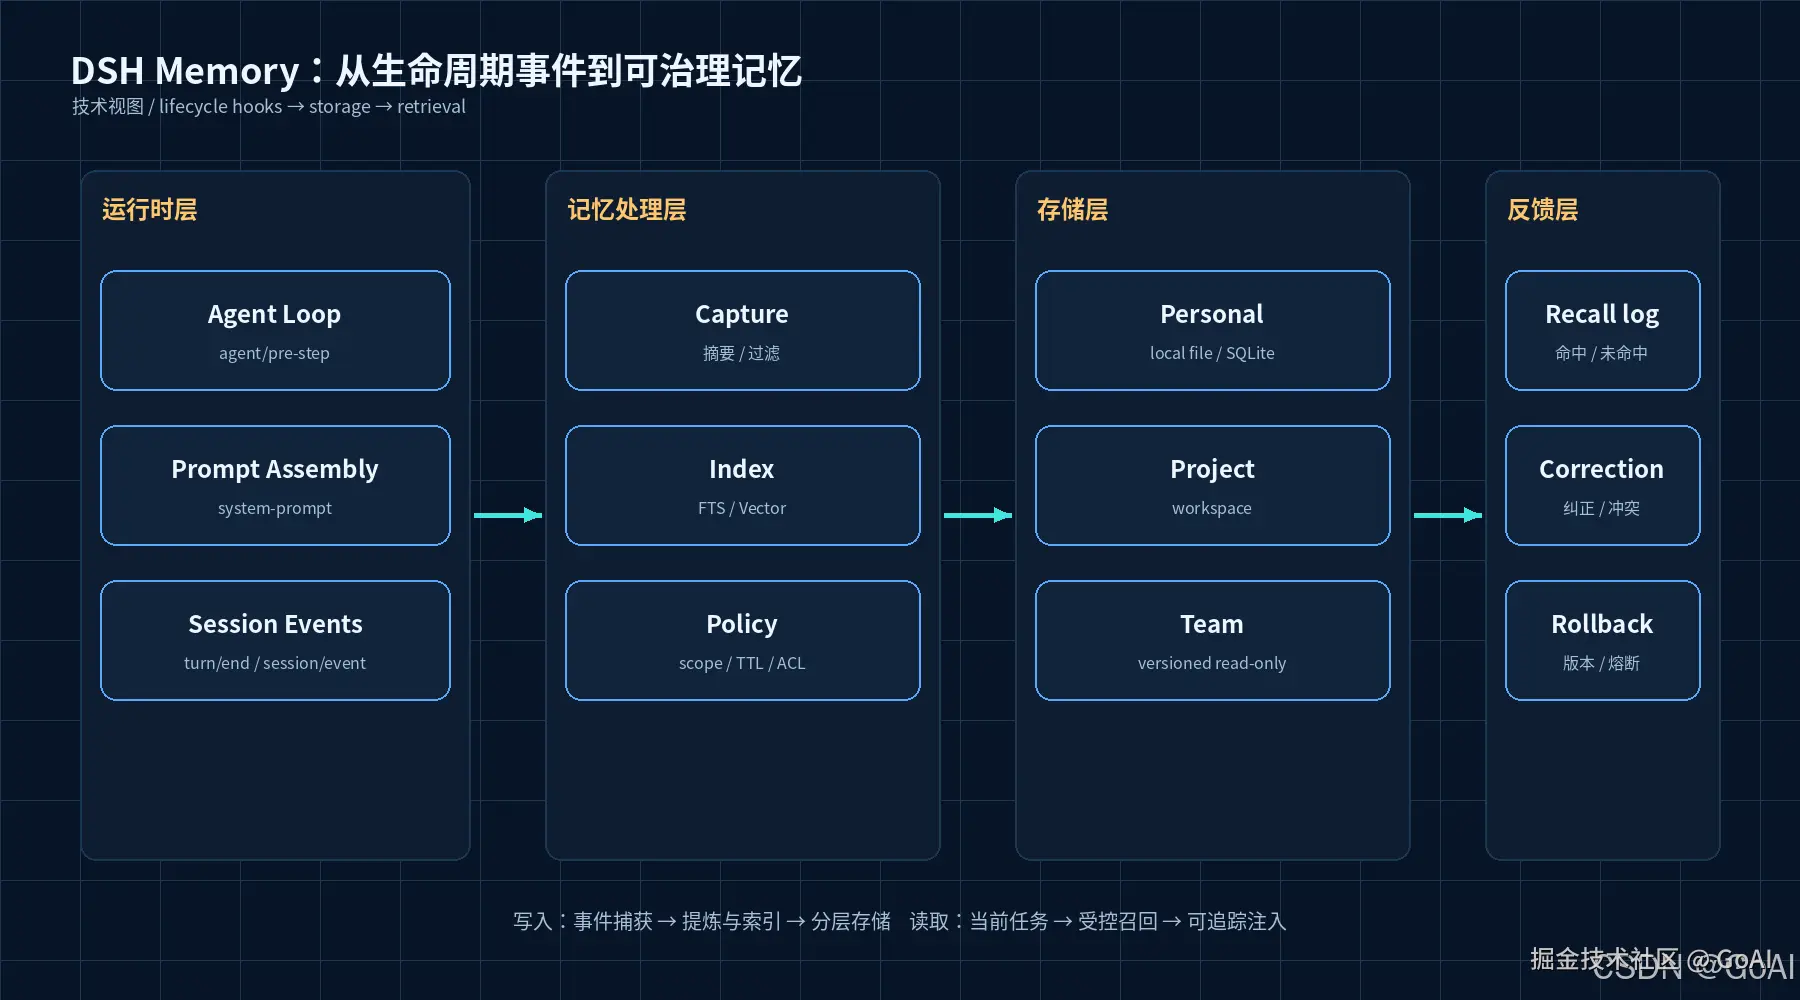
| 生命周期位置 | Memory 做什么 | 需要重点验证什么 |
|---|---|---|
agent/pre-step |
当前模型步骤前召回相关记忆 | 是否自动召回、是否有超时和 token 上限 |
system-prompt 或动态 prompt section |
注入事实、索引、使用指引或用户画像 | 注入的是记忆内容,还是仅仅告诉 Agent 如何检索 |
session/event、turn/end |
捕获用户、助手和工具事件,触发摘要或写入 | 是否保存原始对话,后台写入是否可靠 |
| 原生 memory tool / skill | 由 Agent 按需搜索、读取、更新和删除 | Agent 是否稳定调用,写入是否需要确认 |
因此,判断插件不能只问"有没有 Memory",而要看四个可验证行为:
- 什么时候写入:每轮写、任务完成后写,还是只接受显式记忆?
- 什么时候召回:每回合自动召回,还是模型主动调用工具才召回?
- 写到哪里:本地文件、SQLite、向量库、服务端空间,还是云端 API?
- 错了怎么办:有没有来源、状态、冲突、过期、删除和回滚机制?
2. 插件先按三种工作方式分类
| 类型 | 代表方案 | 核心特点 | 主要取舍 |
|---|---|---|---|
| 自动召回型 | MemOS、OpenViking、Hindsight | 生命周期钩子主动搜索并注入 | 体验顺滑,但需要更强的噪声和权限治理 |
| 按需检索型 | memsearch、ReMe | 提供检索工具或使用指引,由 Agent 决定何时查 | 注入更节制,但依赖工具调用可靠性 |
| 本地可审计型 | dsh-auto-memory | 记忆保存为可读文件,并区分候选和已确认状态 | 易迁移、易删除,但个人治理能力不等于团队治理 |
"自动召回"不一定更好:它降低了 Agent 主动检索的决策成本,也提高了无关记忆和错误记忆进入上下文的治理要求;"按需检索"更节制,但需要验证模型是否会在关键时刻调用工具。
3. 候选插件逐个看
下面统一按 定位 → 核心机制 → 优点 → 局限 → 适用场景 → 推荐结论 介绍。先用一张速览表建立印象,再按需求阅读详情。表中简介是对各节所列项目维护者资料的归纳,不是性能排名。
| 插件 | 一句话认识它 | 典型工作链路 | 选它主要为了什么 |
|---|---|---|---|
| MemOS 本地 | 把个人记忆引擎放进 DSH 本机进程 | 回合捕获 → 本地记忆 → 步骤前自动召回 | 少改 Agent 行为,先跑通个人记忆 |
| MemOS Cloud | 用托管服务承接记忆搜索与写入 | 回合前搜索 → 上下文注入 → 完成后添加 | 降低自建记忆后端的工作量 |
| OpenViking | 同时组织记忆、知识和 Skill 的上下文数据库 | 会话捕获 → 上下文空间 → 检索和工具访问 | 统一管理 Agent 所需的多类上下文 |
| Hindsight | 持续沉淀仓库决策与工程经验的项目记忆 | 吸收历史 → 项目记忆 → 工作开始时带回上下文 | 减少项目历史和约定的重复解释 |
| memsearch | 可读 Markdown 记忆加混合搜索 | 摘要写文件 → 建索引 → Agent 按需检索 | 文件可审计,同时保留搜索扩展能力 |
| ReMe | 按需搜索与后台整理结合的记忆方案 | 自动记忆/整理 → 搜索工具 → 按任务读取 | 控制上下文噪声,持续整理经验 |
| dsh-auto-memory | 用文件和状态管理个人记忆 | 候选写入 → 确认状态 → 索引与工具读取 | 本地可控、可查看和可纠正 |
| Mnemosyne | 通用本地记忆后端候选 | 后端能力 → 待补 DSH 适配 → 待验证生命周期 | 观察集成方向,暂不直接安装推荐 |
阅读时重点区分三件事:插件项目本身提供什么、DSH 适配器实际接入什么、团队治理还需补什么。服务端具备某项能力,不代表 DSH 插件已自动接好。
3.1 MemOS 本地 DSH 插件
官方资料 :MemOS 本地 DSH 接入说明 · MemOS 项目仓库
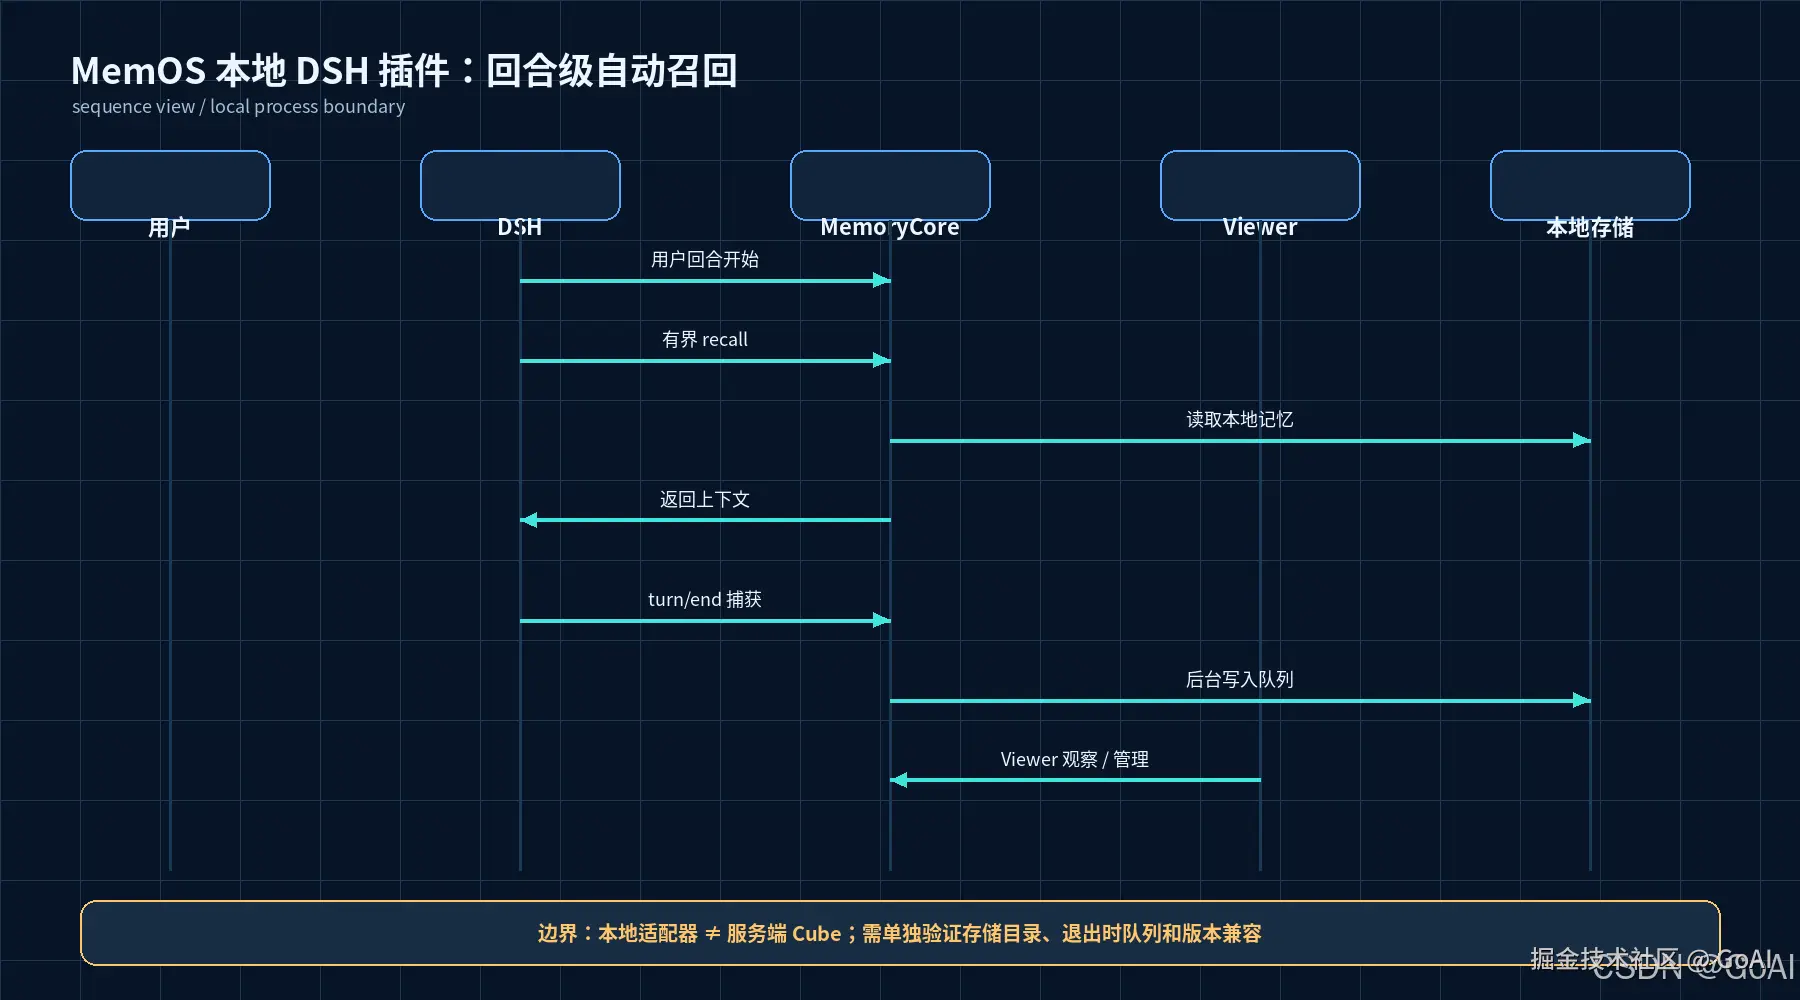
定位:在 DSH 本机进程内提供自动召回、回合捕获、显式记忆工具和本地 Viewer,适合先验证个人长期记忆。
核心机制 :公开接入说明描述了有界自动召回和回合结束后的后台捕获队列,并说明适配器在 DSH Node.js 进程内运行 MemoryCore 与 Viewer。它不会启动 MemOS JSON-RPC bridge 或 sidecar daemon。
优点:
- 本地运行,便于控制数据路径。
- 自动召回降低 Agent 主动检索成本。
- 有显式工具和 Viewer,便于检查记忆。
- 适合作为个人层 MVP 的起点。
局限:本地适配器不能直接等同于 MemOS 服务端部署,也不能把本地存储方式与服务端 Cube 能力混写。个人、项目和团队空间如何隔离,需要结合实际配置重新设计。
适用场景:个人长期记忆、本地优先、希望先验证跨会话价值的团队。
推荐结论:个人层优先评估;如果后续要做团队层,应在它之上增加独立的候选池、晋升器和团队只读库。
3.2 MemOS Cloud DSH 插件
官方资料 :MemOS Cloud DSH 插件说明 · MemOS 项目仓库
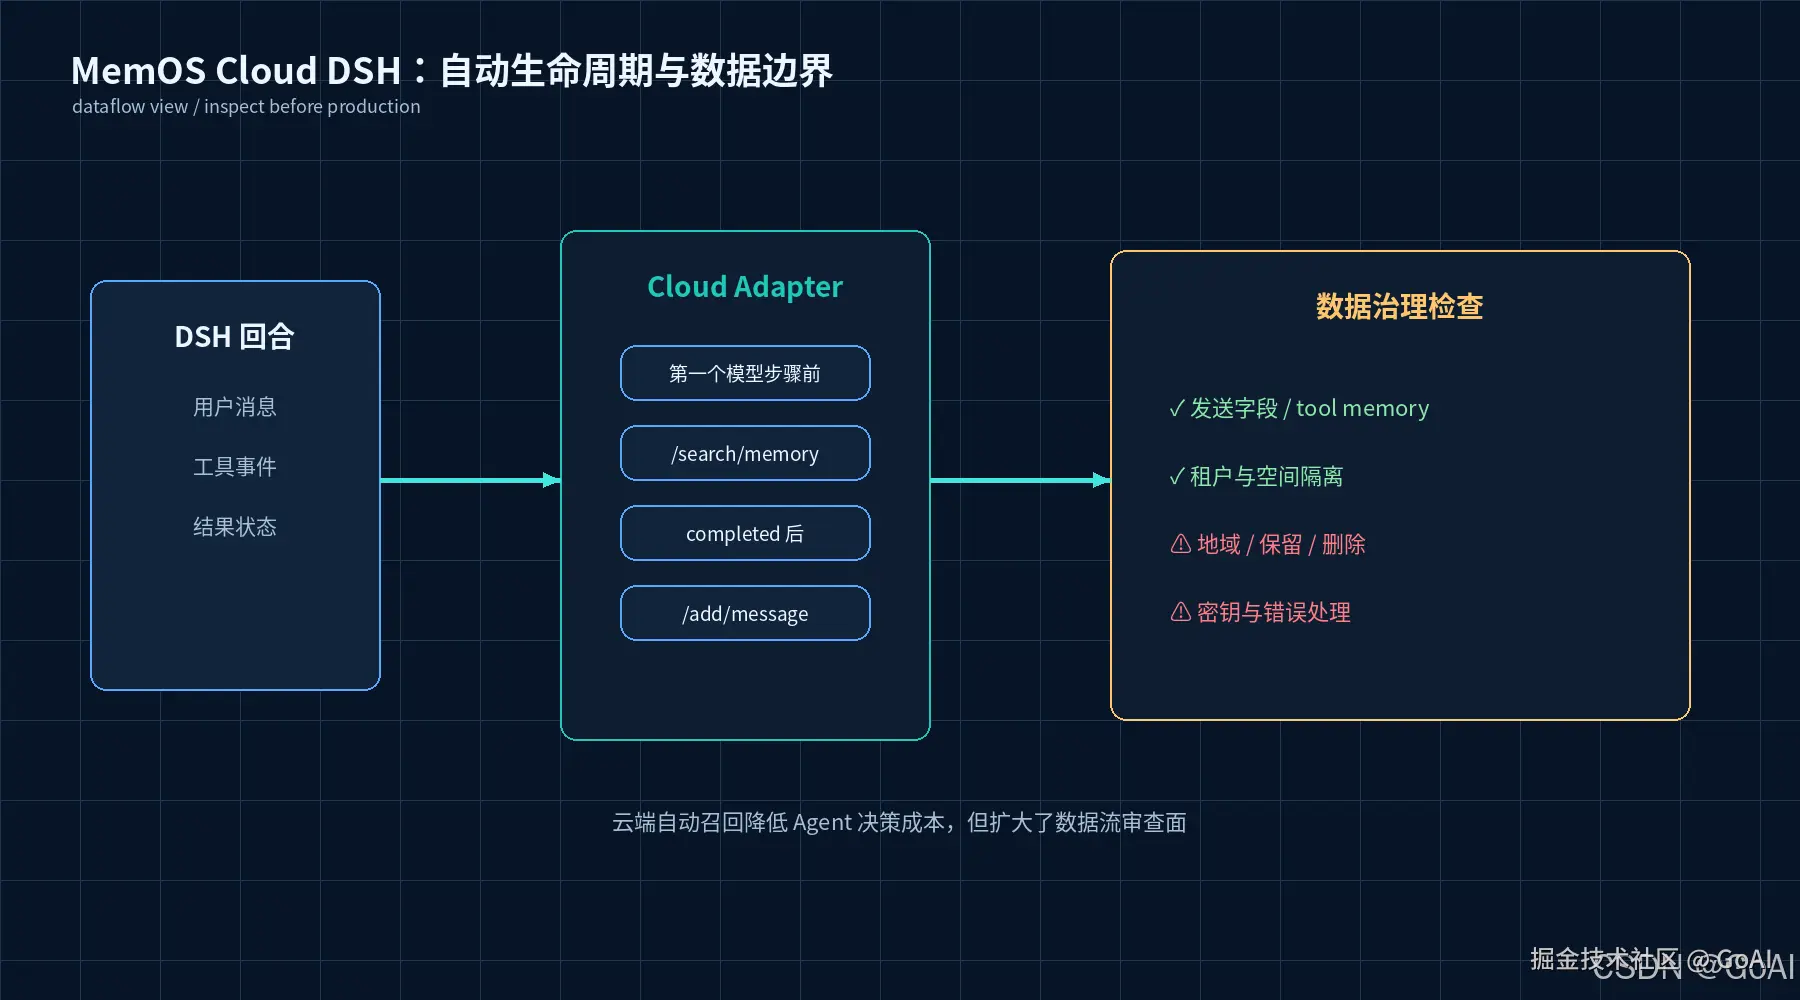
定位:把 DSH 的回合生命周期接到 MemOS Cloud,强调自动搜索和自动添加。
核心机制 :公开 README 描述了每个用户回合第一个模型步骤前调用 /search/memory,回合以 completed 结束后调用 /add/message;同时支持 user、public、knowledge-base、metadata、tags 等过滤条件。工具调用与结果是否纳入记忆由 includeToolMemory 控制。
优点:接入路径清楚,模型不必自己决定是否调用记忆工具;过滤条件也为用户、项目或知识空间隔离提供了基础。
局限:数据会进入云端服务,必须先审查发送字段、存储地域、保留期限、删除机制、租户隔离、错误处理和密钥管理。若内部对话不能离开本地或内网,云插件只能停在评估阶段。
适用场景:允许使用外部托管服务、希望快速验证自动化 Memory 的团队。
推荐结论:适合做体验验证,不建议未经合规审查直接承载内部代码和业务对话。
3.3 OpenViking DSH Memory 插件
官方资料 :OpenViking DSH Memory 插件 · OpenViking 多租户与 ACL 文档 · OpenViking 项目仓库
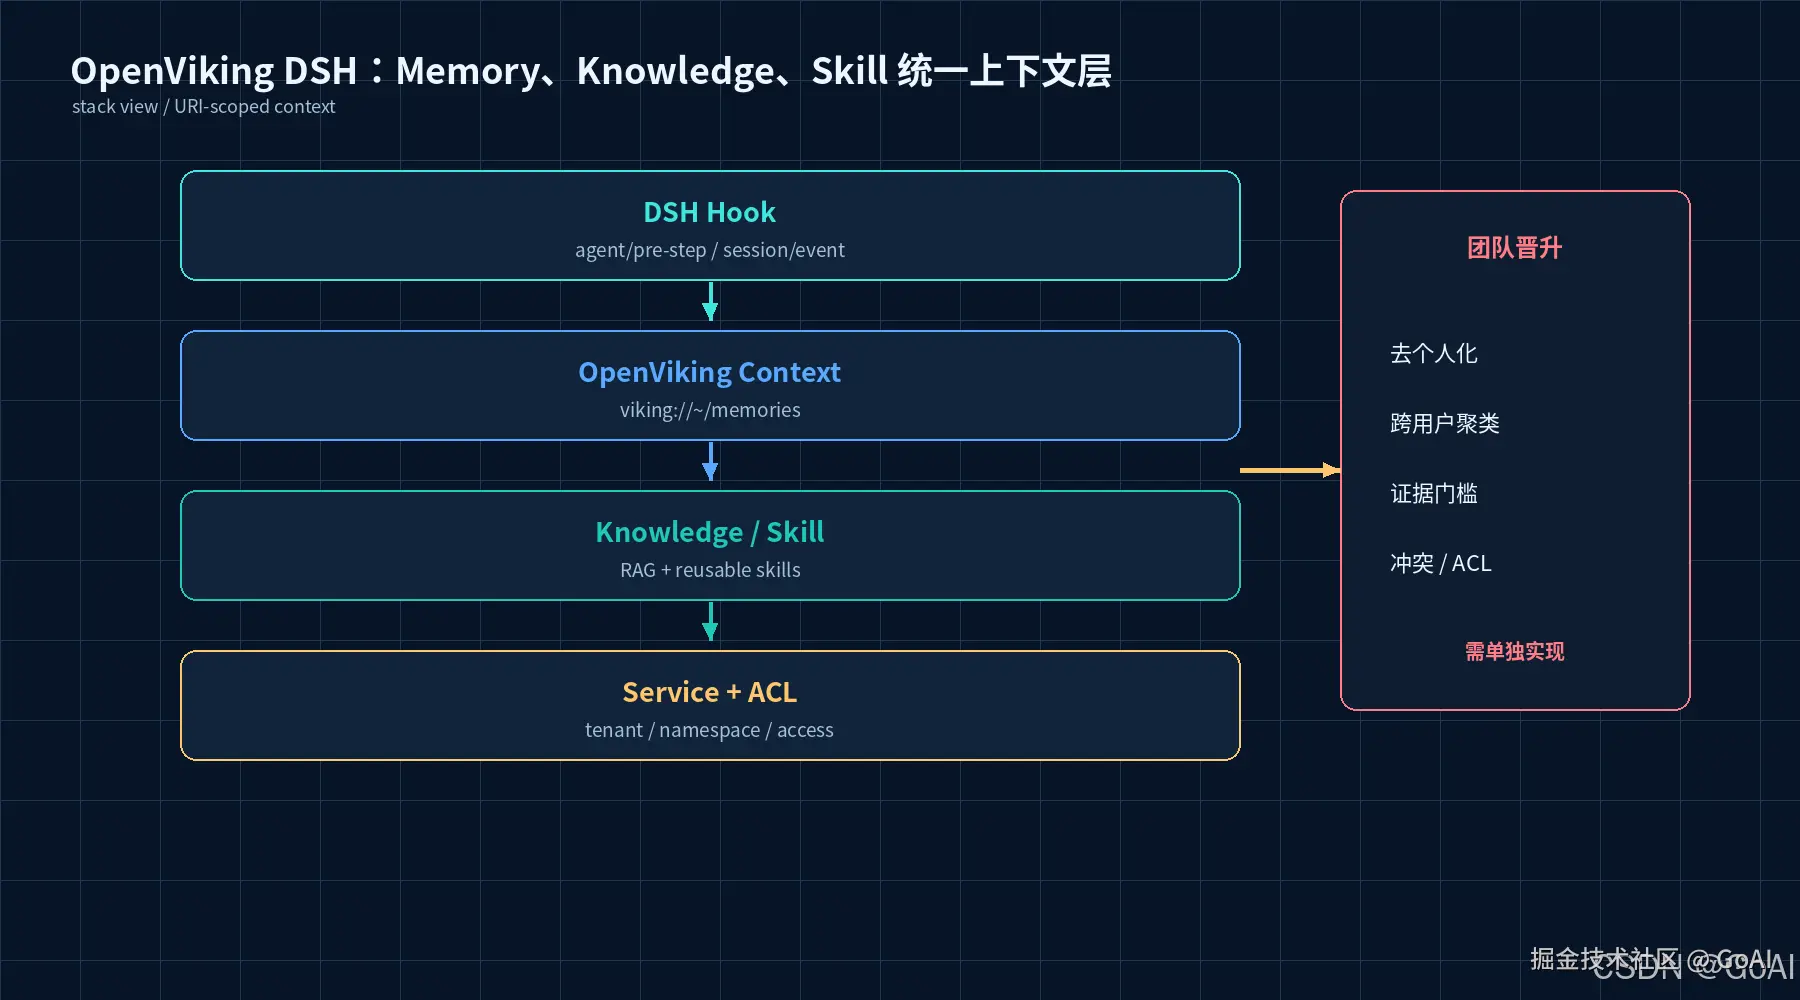
定位:把 Agent Memory、知识检索和 Skill 放进统一的上下文数据库,而不只是保存聊天摘要。
核心机制 :公开说明显示,插件在 agent/pre-step 召回,在 session/event 捕获会话,在满足阈值或结束条件时提交,并提供 viking:// URI 保护和 OpenViking MCP 工具面。召回目标使用调用者自己的上下文空间,例如 viking://~/memories 和 viking://~/skills。
优点:
- Memory、RAG 和 Skill 可以放进统一上下文体系。
- 有服务端空间、URI 和 ACL 方向,适合平台化建设。
- 更适合长期演化的 Agent 工作流。
局限:需要可访问的 OpenViking 服务;个人空间和共享空间不等于已经完成团队晋升。跨用户聚类、去个人化、证据门槛、冲突处理和团队权限仍需单独设计。
适用场景:有服务端部署能力,希望统一管理 Memory、知识和 Skill 的团队。
推荐结论:适合作为项目或平台层后端,但不应直接当作"个人记忆自动变团队规则"的完整方案。
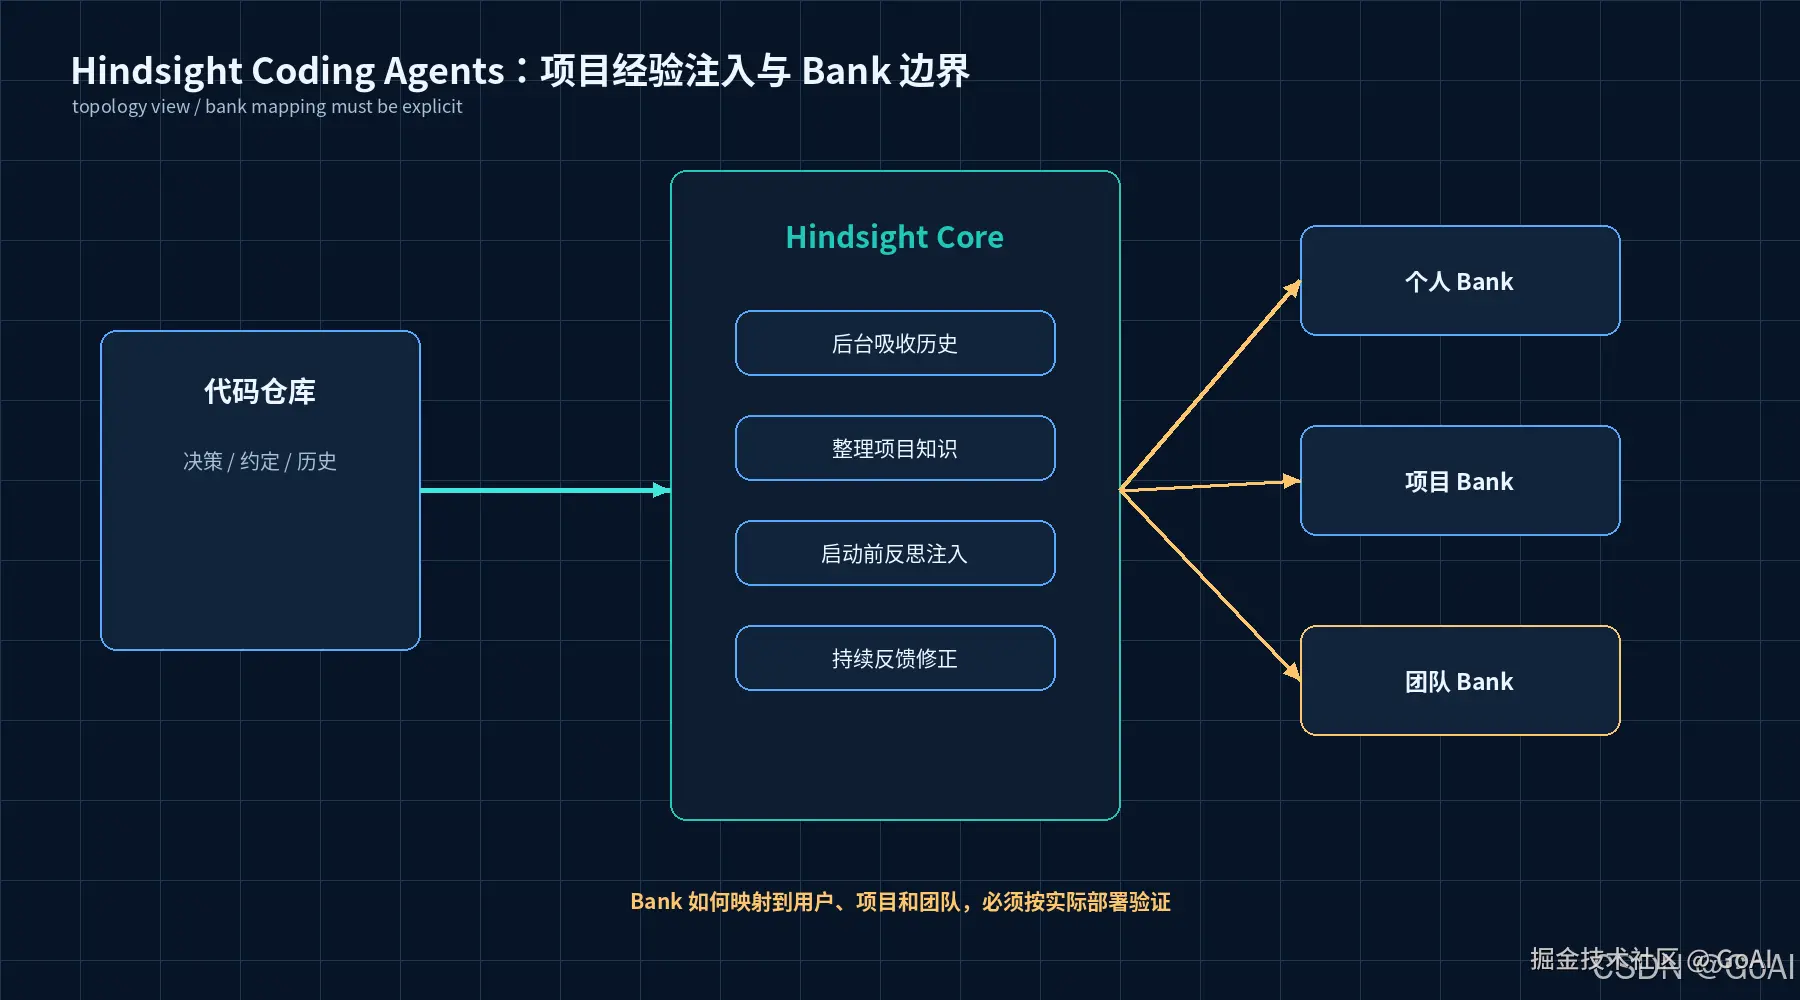
3.4 Hindsight Coding Agents
官方资料 :Hindsight Coding Agents · Hindsight 项目仓库
定位:面向 Coding Agent 的项目记忆、反思和上下文注入,重点沉淀代码仓库历史、项目决策和工程约定。
核心机制:公开接入说明描述了后台吸收代码仓库历史和对话,在 Agent 开始工作时把项目决策、约定和知识页面带回上下文,并支持云端、自托管服务和本地 daemon 等部署方向。
优点:项目经验导向明显,适合减少"同一个项目问题反复解释"的成本;也适合作为多个 Coding Agent 共享项目上下文的后端。
局限 :个人、项目和团队的隔离边界必须按实际配置验证。不能仅凭示例中的 bankId 推断其隔离能力上限;项目方基准中的效果也不能直接当成本团队代码库的效果承诺。
适用场景:希望持续沉淀项目决策、约定和历史经验的研发团队。
推荐结论:适合作为项目层记忆候选;团队层仍需显式设计 Bank 映射、ACL 和晋升机制。
3.5 memsearch
官方资料 :memsearch DSH 插件说明 · memsearch 项目仓库
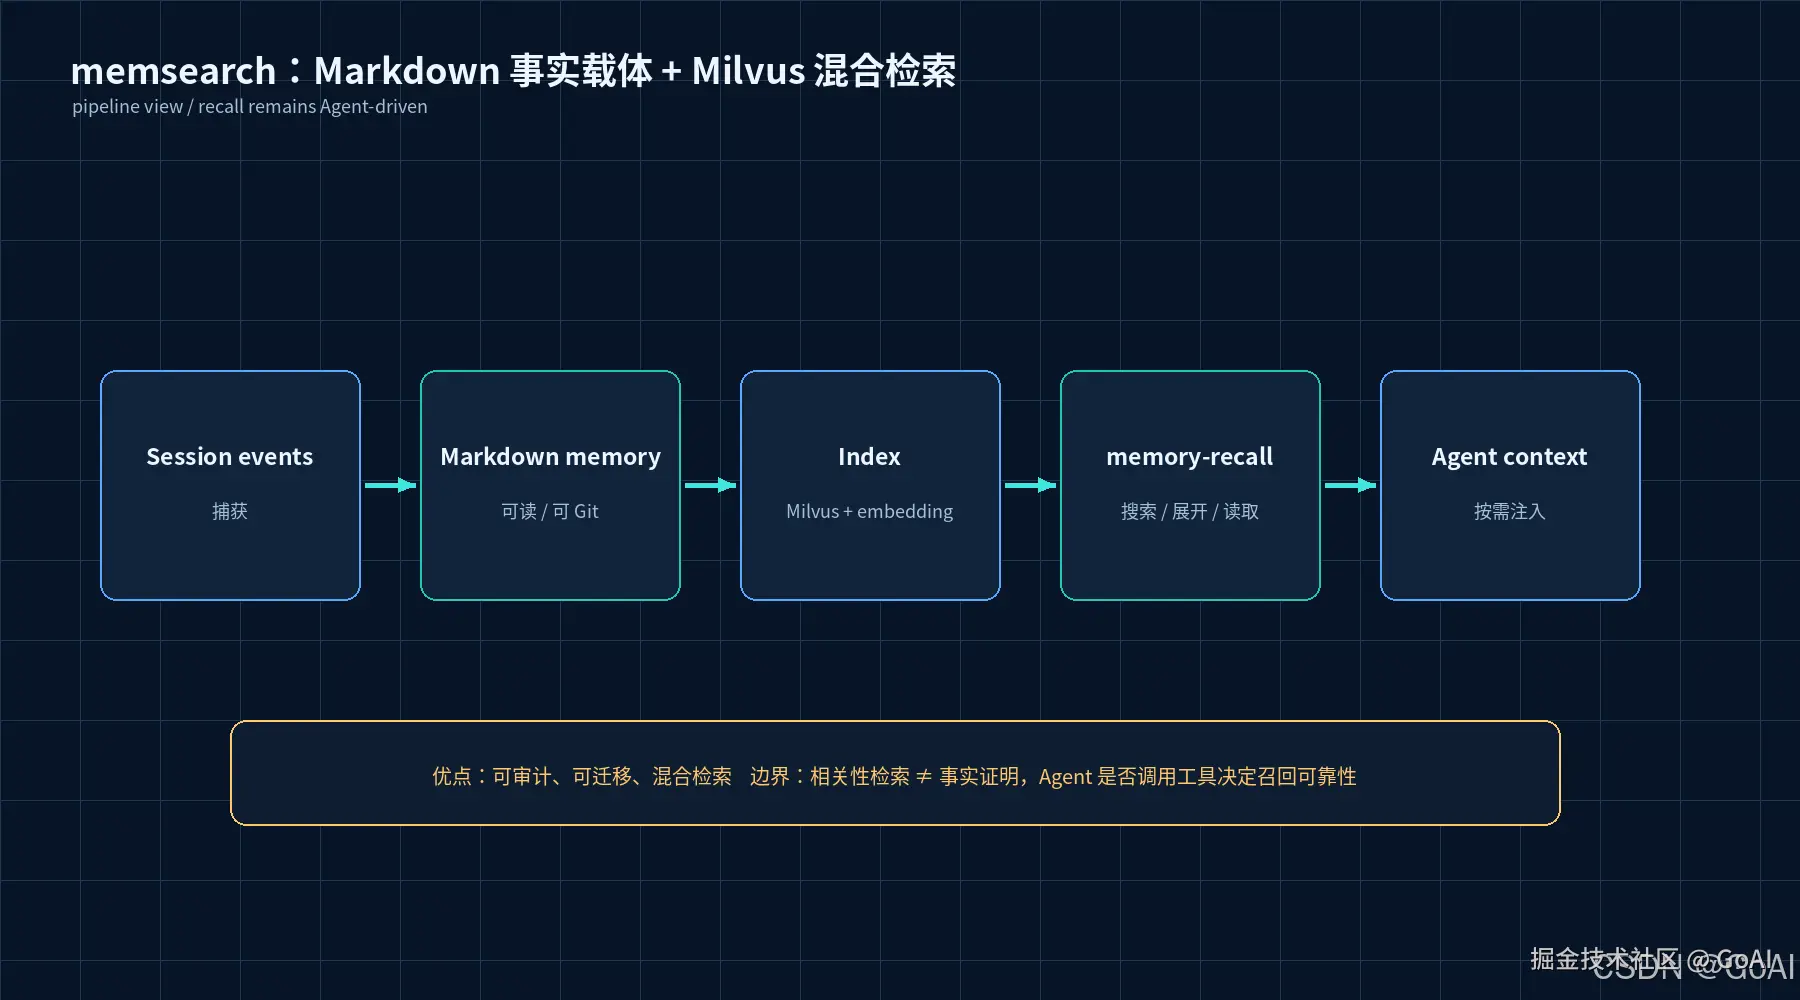
定位:用 Markdown 保存可读记忆,再通过 Milvus 做关键词与向量混合检索。
核心机制 :公开说明描述了通过 session/event 或 turn/end 捕获会话,将摘要写入 .memsearch/memory/,在 agent/pre-step 提醒 Agent 使用 memory-recall,由检索 Skill 搜索、展开和读取记忆。没有全局或项目配置时,embedding 可使用本地 ONNX 路径。
优点:Markdown 便于审计、Git 管理和迁移;Milvus 提供较强的检索扩展性;适合跨 Agent 共享可读记忆目录。
局限:更像"记忆目录 + 检索层",不是开箱即用的团队治理系统。需要验证摘要后端、Milvus 地址、集合命名、项目路径隔离、删除机制和 embedding 数据流。检索相似度只能发现候选,不能单独证明事实。
适用场景:接受 Markdown 作为事实载体,同时需要混合检索的个人或小团队。
推荐结论:适合个人层或项目层,团队层要额外增加证据与权限治理。
3.6 ReMe
官方资料 :ReMe DSH 插件指南 · ReMe 项目仓库
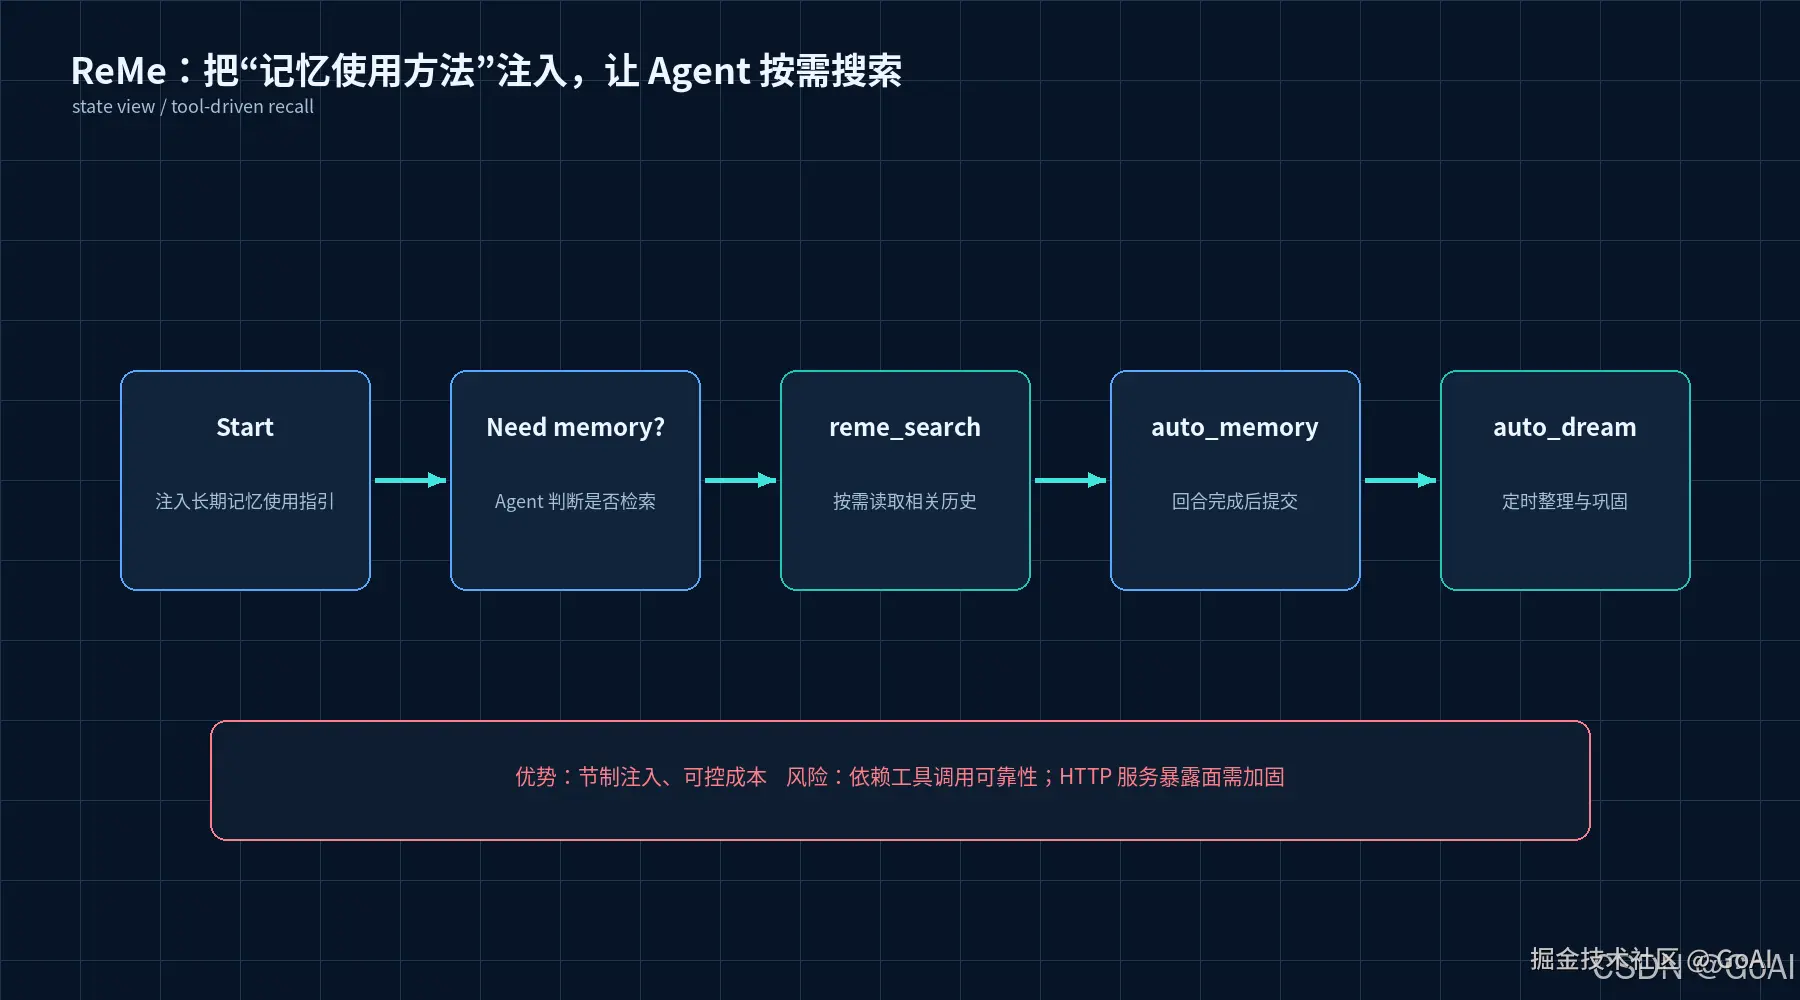
定位:让 Agent 按需搜索长期记忆,并通过自动整理和定期 consolidation 形成更稳定的知识。
核心机制 :会话开始注入长期记忆使用指引,注册只读 reme_search 工具,回合完成后可以提交 auto_memory,还可以通过 auto_dream 整理日志。它注入的是"如何使用记忆"的指导,不是把全部历史直接塞进系统提示词。
优点:按需检索可以减少无关内容和 token 消耗;自动整理适合持续沉淀工作经验。
局限 :相关历史是否进入当前对话,依赖 Agent 是否调用 reme_search。公开说明还提醒默认 ReMe HTTP 服务没有 API-key 鉴权,不应直接暴露到不可信网络。
适用场景:希望控制注入成本,并接受 Agent 主动检索的团队。
推荐结论:适合个人或项目层的按需检索;上线前重点测试工具调用可靠性和服务暴露面。
3.7 dsh-auto-memory
官方资料 :dsh-auto-memory 官方仓库
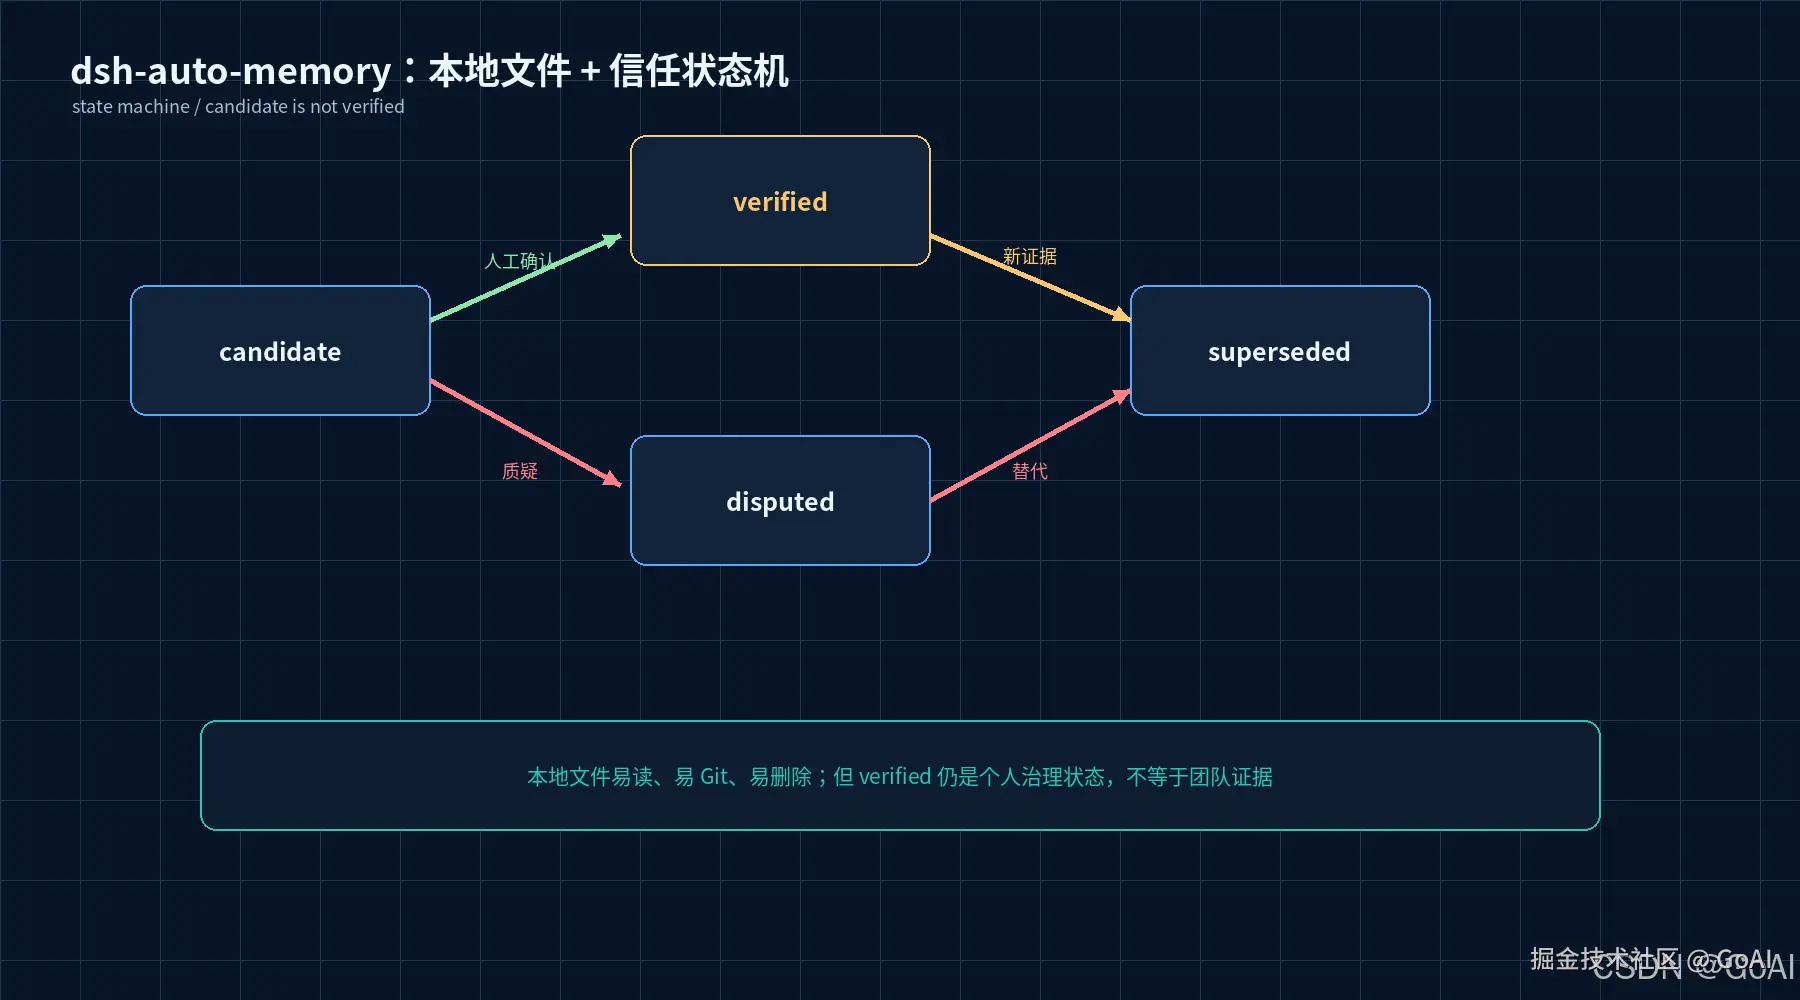
定位:零服务、零 embedding 的本地 DSH Memory 插件,重点解决个人记忆的可读性和可信写入。
核心机制 :记忆保存在 $DSH_HOME/memory/ 下的普通文件中,索引进入 DSH prompt,同时提供读取、搜索、更新和删除工具。新记忆可以先处于 candidate,人工确认后成为 verified;disputed 和 superseded 不再继续注入。
优点:本地优先、依赖少、文件可读、易编辑、易 Git 管理和删除;候选与已确认状态分开,适合控制错误记忆。
局限 :verified 只说明个人层已确认,不等于具备团队级证据。它没有天然解决跨用户聚类、去个人化、团队权限和团队版本治理。
适用场景:个人本地优先,希望把"模型说过的内容"和"已确认事实"分开的用户。
推荐结论:适合强调文件可审计和确认流程的个人层。如果要求完全无人审批,不能把它的人工确认路径作为主方案;必须先核验能否接入自动证据验证,或改选 MemOS 本地等自动生命周期方案。进入团队层仍需独立 Promoter 和团队只读库。
读者应抓住的三点:
- 它的核心价值是记忆可读、状态可查、错误可撤回。
- 个人
verified不能直接升级为团队可信规则。 - "自动保存"与"无需人工确认即可可信使用"是两项不同的能力。
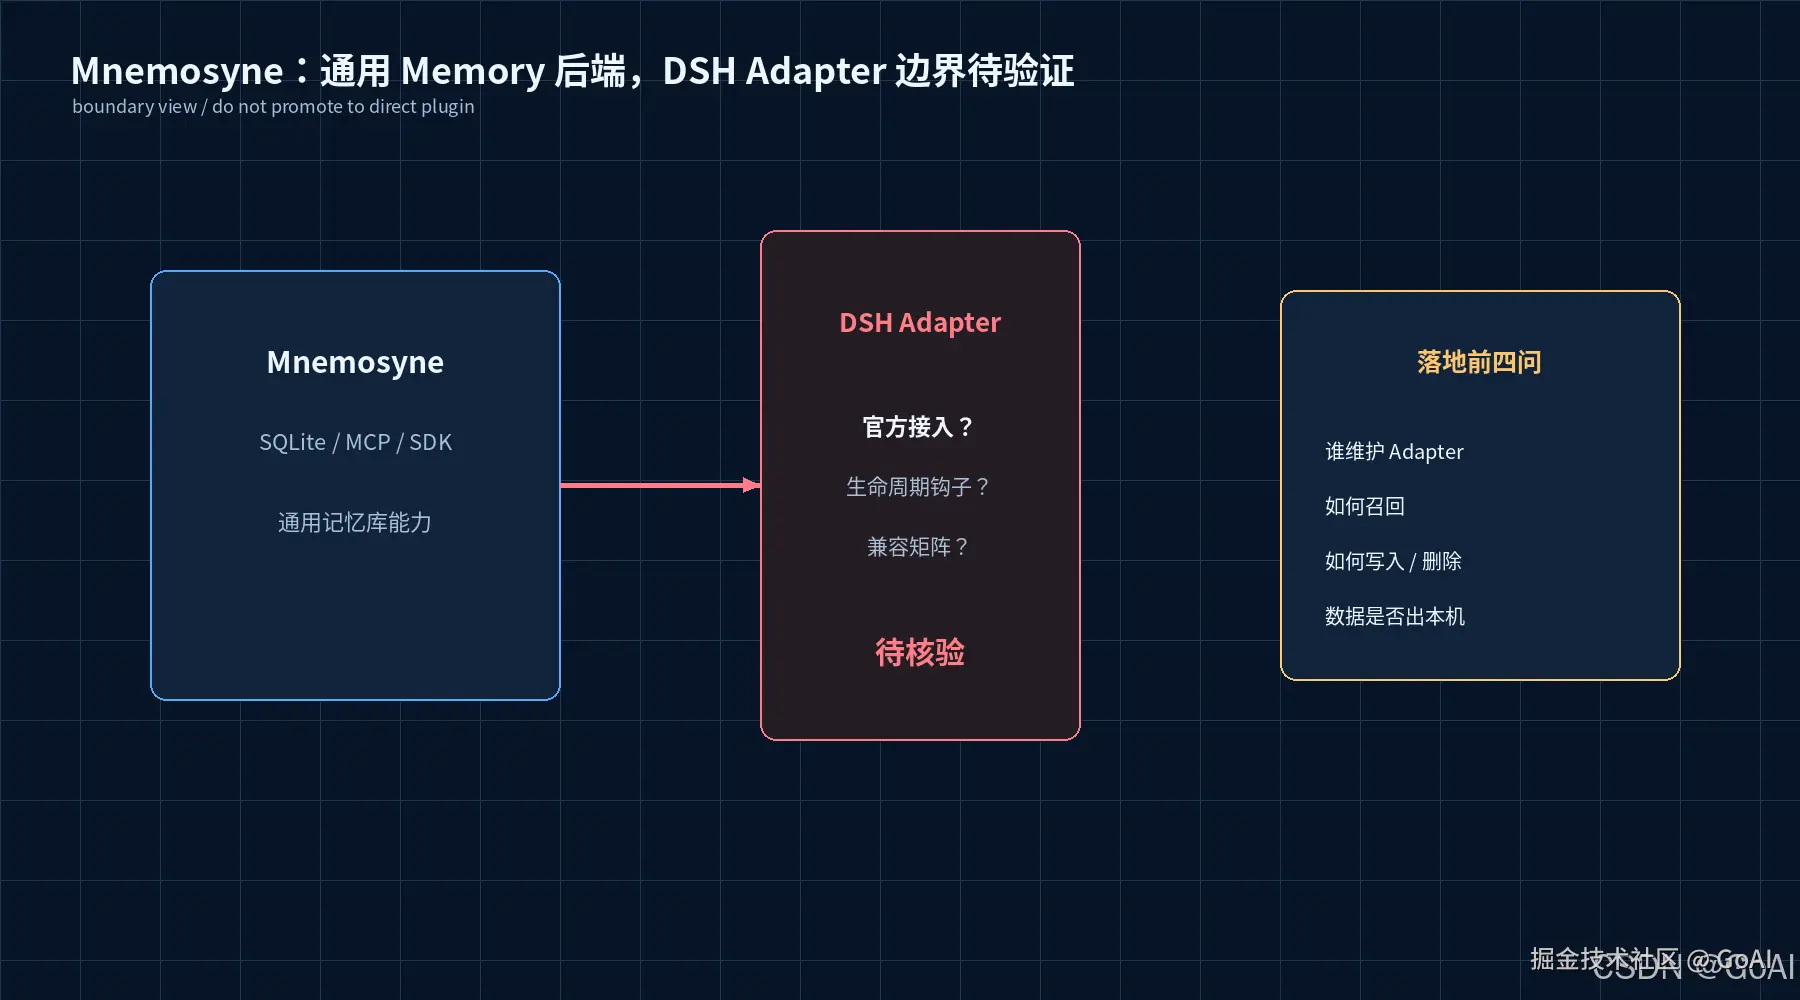
3.8 Mnemosyne:接入待核验
官方资料 :Mnemosyne 官方仓库
定位:通用本地 SQLite 记忆库方向,提供 MCP、SDK 和多种 Agent 集成思路。
核心机制:本轮查到的官方 README 没有 DSH 专用适配或 DSH 安装说明,因此不能把它列为可直接安装的 DSH Memory 插件。
优点:本地化、可迁移,适合作为通用记忆后端方向观察。
局限:DSH Adapter、生命周期钩子、数据边界和兼容矩阵都待核验。
适用场景:仅适合作为候选后端或集成思路,不适合直接进入 DSH 生产选型。
推荐结论:暂不推荐直接安装;先验证官方或维护者认可的 DSH 适配。
4. 插件调研结论
| 方案 | 自动召回 | 自动捕获 | 主要载体 | 适合层级 | 直接结论 |
|---|---|---|---|---|---|
| MemOS 本地 | 有界自动召回 | 后台捕获 | 本地 MemoryCore + Viewer | 个人层 | 优先做个人 MVP |
| MemOS Cloud | 回合前搜索 | 完成回合后添加 | Cloud API | 个人/项目层 | 先做合规评估 |
| OpenViking | agent/pre-step |
session/event |
服务端上下文库 | 项目/平台层 | 适合统一 Memory、知识、Skill |
| Hindsight | 启动时注入 | 后台吸收历史 | Cloud / self-hosted / daemon | 项目层 | 验证 Bank 与 ACL 映射 |
| memsearch | Agent 按需检索 | 事件摘要写文件 | Markdown + Milvus | 个人/项目层 | 适合可审计混合检索 |
| ReMe | Agent 按需搜索 | auto_memory |
ReMe workspace / 服务 | 个人/项目层 | 测工具调用与暴露面 |
| dsh-auto-memory | prompt 索引 + 工具 | 本地文件 | Markdown | 个人层 | 适合个人可信写入 |
| Mnemosyne | 待核验 | 待适配 | SQLite / MCP / SDK | 暂不推荐 | 先做 DSH Adapter 验证 |
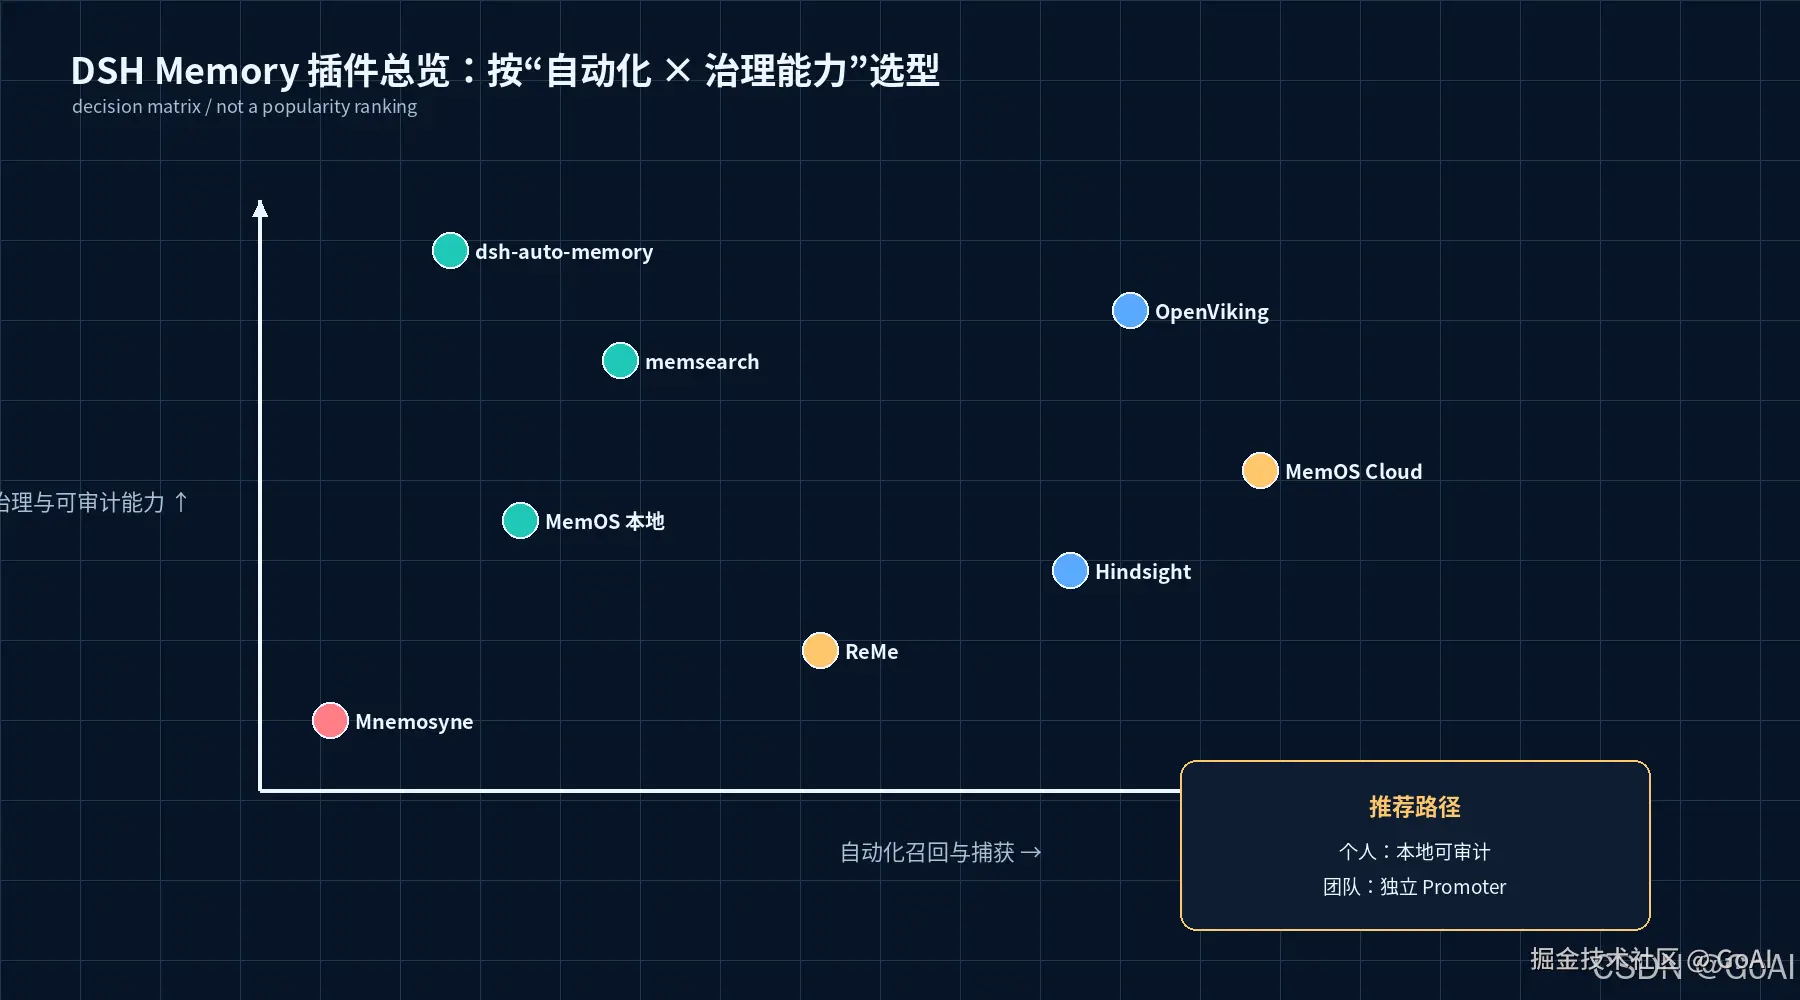
结论:现成插件大多解决"个人记忆"或"项目记忆",没有一个已经被公开资料证明能完整完成"多个人的记忆自动提炼为可信团队规则"。因此,第二章的重点不是继续堆插件,而是设计一层独立的团队治理能力。