一个小改动,让 Claude 在 SWE-bench 上刷新纪录:工具描述有多重要
原文:mp.weixin.qq.com/s/4VPb8r-n6...(2026年10月19日)
 很多人给 Agent 接工具,做法很朴素:把现有的 API 一个个包一层,丢给模型。
结果是,Agent 要么调错工具,要么参数填错,要么被一大坨返回数据淹没。
Anthropic 工程团队发了一篇博客,讲的就是怎么写出 Agent 真正好用的工具。更有意思的是,文中大部分建议,来自他们用 Claude Code 反复优化自家内部工具的经验。
下面是精华。
↗一、工具,到底是什么新物种?
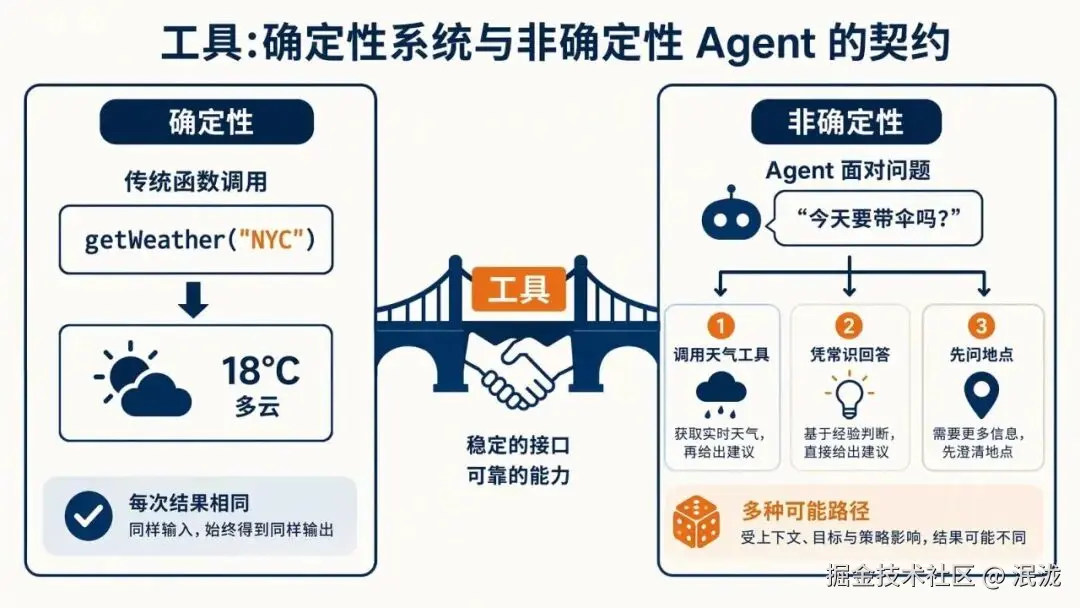
传统软件里,函数是确定性的。getWeather("NYC") 每次都以同样方式返回纽约天气。
但 Agent 是非确定性的。用户问"今天要带伞吗?",它可能调用天气工具,可能凭常识回答,也可能先反问你在哪个城市。偶尔还会幻觉,或者没搞懂工具怎么用。
所以 Anthropic 的定义是:工具是确定性系统与非确定性 Agent 之间的一种新型契约。
这意味着,不能再按"给其他开发者写 API"的方式写工具,而要为 Agent 设计。
好消息是,对 Agent 来说最"顺手"的工具,往往人类也觉得直观。
↗二、怎么写:原型 → 评估 → 与 Agent 协作
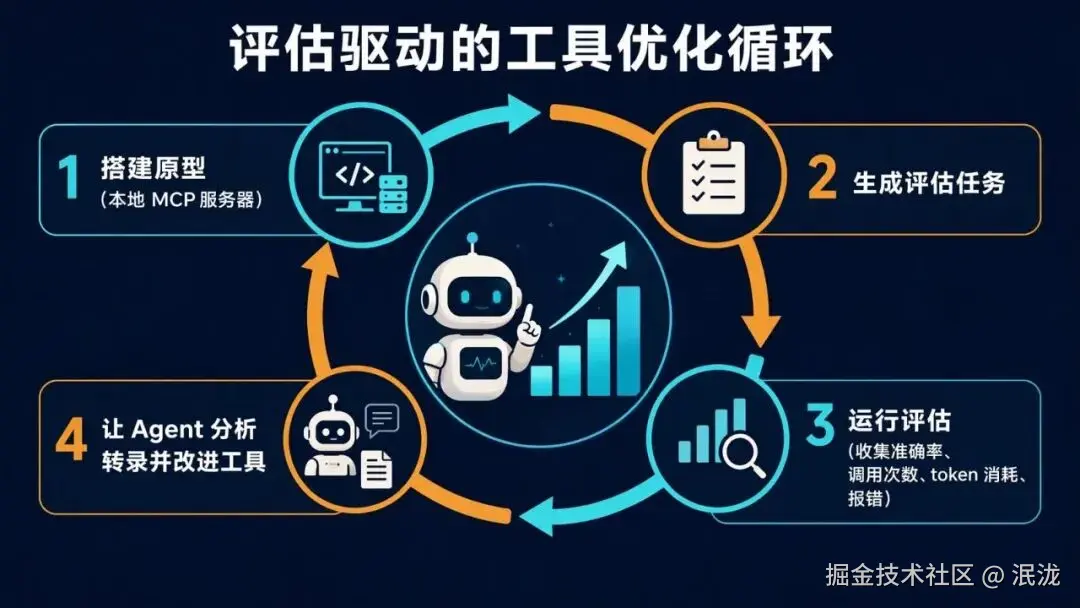
第 1 步:快速搭原型。
动手之前,很难预判哪些工具 Agent 会觉得顺手。所以先做个粗糙版本。
用 Claude Code 来写时,可以把相关库、API、SDK 的文档喂给它。很多官方文档站提供扁平的 llms.txt,对 LLM 很友好。
然后把工具包进本地 MCP 服务器或桌面扩展(DXT),在 Claude Code 或 Claude Desktop 里连上测试。Claude Code 里的命令是 claude mcp add <name> <command> [args...]。
自己先试一遍,找出粗糙之处,再收集用户反馈。
第 2 步:跑评估。
先生成大量基于真实场景的评估任务。不要用过于简单的"沙盒"环境,好任务可能需要连续调用几十次工具。
每个任务要配可验证的结果。验证器可以是简单的字符串比对,也可以让 Claude 当裁判。但别太严,别因为格式、标点、同义表述的差异就判错。
跑评估时,文章建议:
→
用直接的 LLM API 调用,每个任务一个简单的循环(while 循环包着 LLM 调用和工具调用)。
→
让评估 Agent 在工具调用之前,先输出推理和反馈。这可能触发思维链,提升效果。用 Claude 的话,可以直接开启交错思考(interleaved thinking)。
→
除了准确率,还要收集:单次调用和任务的运行时长、工具调用总数、token 消耗、工具报错。
第 3 步:分析结果,让 Agent 一起改。
Agent 是很好的搭档,能发现自相矛盾的工具描述、低效的实现、含糊的 schema。
但要注意一点:Agent 没说出口的,往往比说出口的更重要。 LLM 并不总是"言行一致"。所以除了看推理,还要翻原始转录,看工具调用和返回。
指标会说话:
→
大量重复调用,可能说明分页或 token 限制参数需要调整。
→
大量参数无效的报错,说明描述需要更清晰,或需要更好的示例。
文章给了个例子:Claude 网页搜索工具上线时,团队发现 Claude 会多余地在 query 参数后面加上"2025",让搜索结果产生偏差。后来改进了工具描述,把它纠正了过来。
实操上,可以把评估转录拼在一起贴进 Claude Code,让它一次性重构多个工具,保持实现和描述前后自洽。
团队还用留出测试集防止过拟合。结果显示,无论工具是研究员手写的,还是 Claude 自己生成的,经过这套流程都还能再提升。内部 Slack、Asana 工具的留出集表现,Claude 优化后的版本都超过了人工版本。
↗三、好工具的 5 条原则
原则 1:选对工具,别堆工具
最常见的错误,是把已有的软件功能或 API 端点简单包一层。
原因在于,Agent 的"可供性(affordance)"和传统软件不同:计算机内存便宜且充裕,但 Agent 的上下文有限。
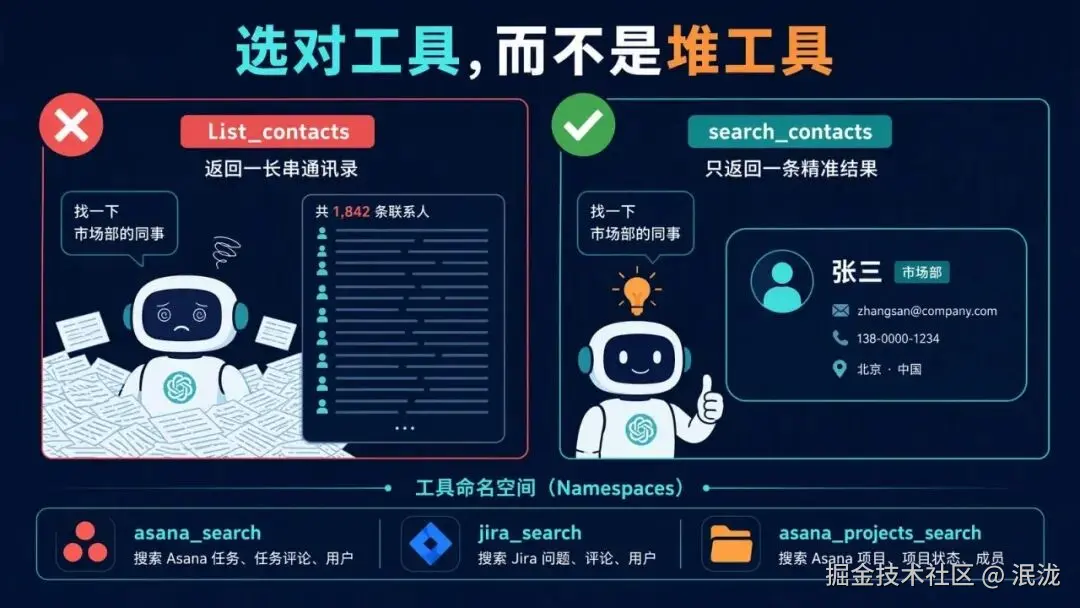
文章举了通讯录的例子。如果工具返回所有联系人,Agent 就得一个 token 一个 token 地读完,浪费上下文。更自然的做法,是像人一样先翻到对应页。
所以建议实现 search_contacts 或 message_contact,而不是 list_contacts。
好工具还可以把多个底层操作合并到一次调用里,比如附带相关元数据,或者处理常常连续出现的多步任务。
同时要保证每个工具目的清晰、互不重叠。工具太多或重叠,反而会分散 Agent 的注意力。
原则 2:给工具加命名空间
Agent 可能同时接入几十个 MCP 服务器、上百个工具。功能重叠或用途模糊,就容易选错。
做法是用共同前缀分组,比如按服务分:asana_search、jira_search;再按资源分:asana_projects_search、asana_users_search。
前缀式还是后缀式,对评估结果有"不可忽视"的影响,而且因模型而异。文章的建议是:用你自己的评估来决定。
原则 3:返回有意义的上下文
工具只该返回高信号信息。优先考虑上下文相关性,而不是灵活性。
尽量避免 uuid、256px_image_url、mime_type 这类底层技术标识,多用 name、image_url、file_type。
Agent 处理自然语言名称,比处理晦涩标识符成功得多。仅仅把随机的字母数字 UUID 解析成有语义的名称(甚至用从 0 开始的编号),就显著提升了 Claude 在检索任务上的精度,因为减少了幻觉。
但有时 Agent 又需要技术 ID 来触发下游调用,比如 search_user(name='jane') → send_message(id=12345)。
解决办法是在工具里加一个简单的 response_format 枚举参数,让 Agent 自己选择返回 concise(简洁)还是 detailed(详细)。
Slack 的例子里,同一个响应,详细版是 206 个 token,简洁版只要 72 个,约为三分之一。
另外,响应用 XML、JSON 还是 Markdown,也会影响效果,没有放之四海皆准的答案。同样,请用你自己的评估来选。
原则 4:优化 token 效率
除了质量,还要管数量。
对可能占用大量上下文的返回,建议组合使用分页、范围选择、过滤、截断,并设定合理的默认值。Claude Code 默认把工具响应限制在 25,000 个 token。
如果截断了,要用提示语引导 Agent 走更省 token 的路,比如"多做几次小而准的搜索,而不是一次大范围搜索"。
出错时也一样。别返回晦涩的错误码或堆栈,而是用 prompt 工程的方式,清楚说明具体、可操作的改进建议。
原则 5:像写新人手册一样,写工具描述
这是文章强调的"最有效的方法之一"。工具描述和规格会被加载进 Agent 的上下文,共同引导它的行为。
写的时候,想想怎么向团队新人介绍这个工具。把你默认的背景显式写出来:特殊的查询格式、冷门术语的定义、底层资源之间的关系。
输入输出要无歧义,并用严格的数据模型约束。参数命名要明确,比如别叫 user,叫 user_id。
效果有多大?文章说,在对工具描述做了精确的改进之后,Claude Sonnet 3.5 在 SWE-bench Verified 评测上达到了当时的最优表现,错误率明显下降,任务完成率提升。
此外,如果你在写 MCP 服务器的工具,可以用工具注解(tool annotations),说明哪些工具需要开放世界访问,或会做破坏性修改。
↗四、给你的 5 条行动清单
1→
别直接包 API。 围绕高价值工作流设计少而精的工具。
2→
加命名空间。 按服务、资源分组,并用评估验证命名方式。
3→
只返回高信号字段。 用名称代替 UUID,提供 concise/detailed 切换。
4→
给返回设上限。 分页、过滤、截断,并让错误信息"会说人话"。
5→
把描述当 prompt 来打磨。 用评估量化每一次改动。
↗写在最后
文章的结尾,是对软件开发思路的一次"重新定位":从可预测的、确定性的模式,转向非确定性的模式。
Anthropic 总结,有效的工具有四个特征:定义清晰有意图、节制地使用 Agent 的上下文、能在多样的工作流里组合、让 Agent 直观地解决真实任务。
未来 MCP 协议和底层模型都会演进。但只要坚持系统化、评估驱动的方法,工具就能和 Agent 一起进化。
你的 Agent 工具里,有没有那种"一调用就返回几千行"的反面典型?欢迎评论区晒一晒。觉得有用,转发给正在做 MCP 的朋友。
· · ·
原文:Writing effective tools for AI agents---using AI agents(Anthropic)
SEO 关键词:AI Agent 工具、MCP、工具设计