大模型会吃掉 Harness 吗?Agent 天空上的"两朵乌云"
原文:mp.weixin.qq.com/s/E_4kh5MAh...(2026年10月18日)
 1900 年,开尔文说,物理学晴朗的天空上,还飘着两朵乌云。
后来,一朵变成了相对论,另一朵变成了量子力学。
今天的 AI Agent,天空同样称不上晴朗。在我看来,同样有两朵乌云。
读完这篇,你会明白三件事:Agent 还差在哪、模型会不会吃掉 Harness、你该把力气花在哪。
先回到那个公式
理解 Agent,可以从一个公式开始:
Agent = LLM + 上下文 + 工具
几乎所有 Agent 技术,都能放进这三个词里:
--
构建:上下文工程、记忆与知识库、工具与代码生成、交互
--
评估与进化:评估、后训练、持续进化
--
协作:多 Agent 如何重组上下文、工具与责任
其中"持续进化"是汇合点。没有轨迹和知识系统,经验无处保存;没有代码能力,Agent 改不了自己的工具;没有评估,更分不清一次修改是进步还是退化。
第一朵乌云:它还不会"实时"
今天绝大多数 Agent,仍是一问一答的轮次制。
你说完一句,它想一整段,再一次性吐出来。
可真实世界不会等它想完。话会被打断,画面在变,邮件在不断到达。
一个真正"活着"的 Agent,应该能边听边想、边说边想,甚至在没人吩咐时,主动发现"这封邮件该处理了"。
通向实时,有两条路,往往并行:
1. 架构上做快慢分离。 实时与智能几乎是两条正交的轴,单一模型难以兼顾。于是让前台快模型维持对话节奏,后台慢模型负责深度思考。
2. 把推理本身做快。 当 decode 足够快,轮次的等待就短到近乎消失。
这条路正在被芯片和推理引擎快速推进:
--
小米 MiMo 在单个 8 卡节点上,把 1T 参数模型 的生成速度推过 1000 token/s
--
Taalas HC1 把 80 亿参数模型直接固化进芯片,约 17000 token/s ,响应低于 100 毫秒(代价是模型更新需重新流片)
当模型每秒能吐出上千个字,"想完再说"和"边想边说"的差距,就被抹平了。
第二朵乌云:它不会"越用越聪明"
今天的模型,像一个记性极好、却学不会新东西的天才。
训练时把人类知识背得滚瓜烂熟,上岗后几乎不再成长。每次任务结束,踩过的坑、试出的窍门,大多随着上下文一起被丢掉。
这是不是真问题?取决于两种针锋相对的假设。
**"小世界假设"**认为:足够大的模型(几万亿参数)装得下几乎所有重要的通用知识,学一次就够。AI 在编程上最强,不是因为代码特殊,而是因为编程是人类最开放的领域,有海量开源代码可学。别的行业缺的不是学习能力,是数据。把数据喂进去,训练一次,问题就解决了。
**"大世界假设"**则指出训练一次补不上的那一层:属于某个具体用户、某家具体公司的知识。
--
特定公司的代码规范
--
你做 PPT 的口味
--
某个客户特有的脾气
这些不在任何训练语料里,而且时时在变。模型只能在上岗之后持续学习。
这正是"记忆"与"持续进化"在摸索的方向:经验该写成知识文档、指令、程序,还是经过筛选后更新模型参数?
再往前走,"RSI(递归自我进化)"和"AI for Science",会把 Agent 推到没有现成答案的前沿。在那里,它只能从一次次实验的成败中自主学习,而不是事事回头问人。
所以,模型最强的能力,终将不是记住,而是学习与适应。
模型与 Agent,从来不是上下游
这两朵乌云,不会被某一次模型升级凭空吹散。
要理解它们怎样被跨越,得先看清一件事:模型和 Agent 是一起往前走的。
回头看 Harness 里那些层层叠叠的兜底逻辑:
--
多级上下文压缩
--
失败数千次才熔断的重试
--
悲观地默认"不安全"的权限判断
每一段看似丑陋的"屎山",记录的都是模型此刻还做不稳的地方。
下一代模型把约束内化,对应代码就能删掉。而模型之所以能内化,又恰恰因为 Agent 早已在真实业务里替它把坑趟了一遍,沉淀成下一轮训练的信号。
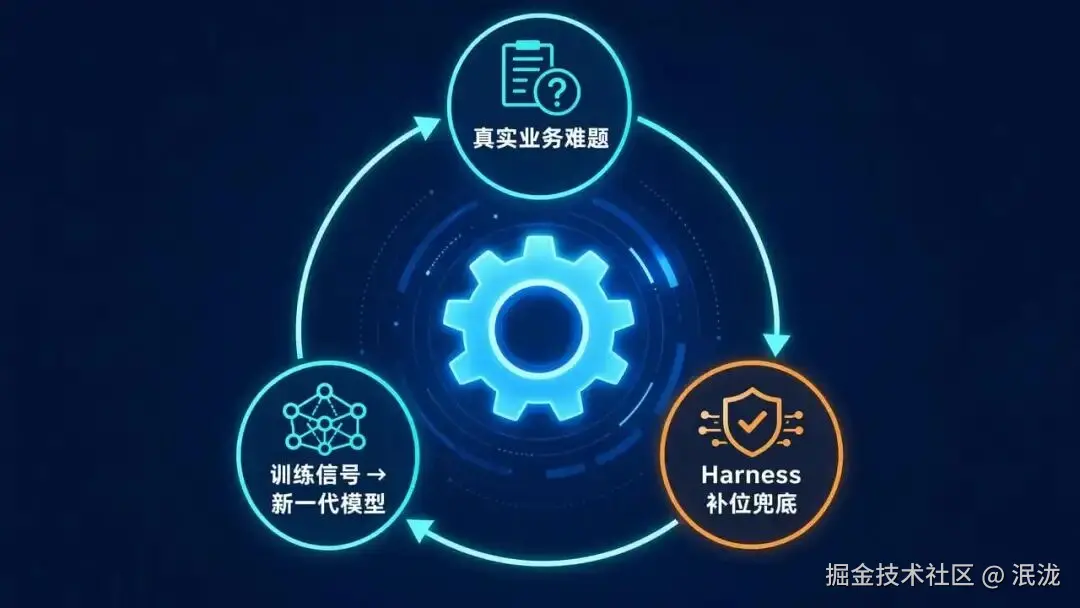 用户提出真实难题,应用层用 Harness 补位,补救再变成训练信号。这是一个自我强化的飞轮。
模型会不会吃掉 Harness?
我的回答是:
会,但不是一次性吃掉,而是一层一层地吃,并且没有吃完的那一天。
举个例子:打断、插话,曾经要靠外挂 Harness 才能拼出来,如今被直接做进了交互模型内部。
但"吃"永远不会完结,有三个原因:
训练以月计,模型等得起,业务等不起。
模型无法内化真实业务的所有约束与偏好,总有一层最新的边界要外部逻辑兜底。
每一代模型都会打开新的能力前沿,而前沿恰恰是模型最做不稳的地方。
所以 Harness 不会消失,它只是随着模型,不断向新的前沿迁移。
这也是《苦涩的教训》在 Agent 时代的读法:通用方法终将胜出,但"终将"二字里的每一段路,都是 Harness 铺出来的。
同时握住两端的人,转得最快
飞轮转得最快的地方,是同时握住两端的人。
Anthropic 用 Claude Code 做的,就是让自家模型和自家 Harness 互相喂养:模型知道 Harness 怎么调用它,Harness 也清楚模型的边界在哪。
曾有人做过一个实验:不换模型,只改 Harness,任务准确率从 52.8% 跳到 66.5%。
这说明 Harness 今天的杠杆有多大,也说明它杠杆大的原因:模型还没走到那一步。
这对你意味着什么?
取决于你站在飞轮的哪一端。
--
如果你在造模型:护城河就是把飞轮转起来,让真实场景的反馈尽快回流到训练里。
--
如果你在模型之上做应用:Harness 是你短期最锋利的杠杆,但要清醒,模型每内化一层约束,就会顺手抹平一批只靠 Harness 建立的优势。
应用层长久的护城河,往往在技术之外:
--
独占的数据
--
稳固的渠道
--
用户的信任
--
网络效应
--
必须由人与 Agent 协作的物理世界场景
用 Harness 争取时间,用这段时间构筑技术之外的壁垒。 这才是稳妥的打法。
不必焦虑框架会过时
模型每几个月迭代一次,具体的 API、产品和榜单都会翻篇。
但有三个问题不会过时:
看到什么?能做什么?如何验证做得对不对?
它们描述的不是某个模型的用法,而是一个智能系统与世界交互的基本方式。
掌握了它们,无论下一代模型带来什么新能力,你都知道该把它放进公式的哪个位置,也能一眼看出,它离吹散那两朵乌云还有多远。
去造点什么吧
Agent 技术仍在飞速演进,一本书追不上所有变化。
但如果你带走的,不是某个 API 的用法,而是一套能在技术浪潮里保持清醒的判断力,这就够了。
而 Agent 最迷人的地方,在于它能通过写代码创造新的能力,甚至改进自己。
读到这里,你已经握住了"创造"的原则。
接下来,去造点什么吧。
 💬 留言区互动: 你更认同"小世界假设"还是"大世界假设"?欢迎聊聊你的看法。
觉得有启发,转给正在做 Agent 的朋友吧。
*文中数据来源:小米 MiMo 官方技术博客;Forbes, Karl Freund, 2026。*