H3 -World 的 11.3 小时训练数据,是怎样对齐成动作监督的?
作者解释或未执行记录;人造演算不代表真实数据质量或训练运行结果。
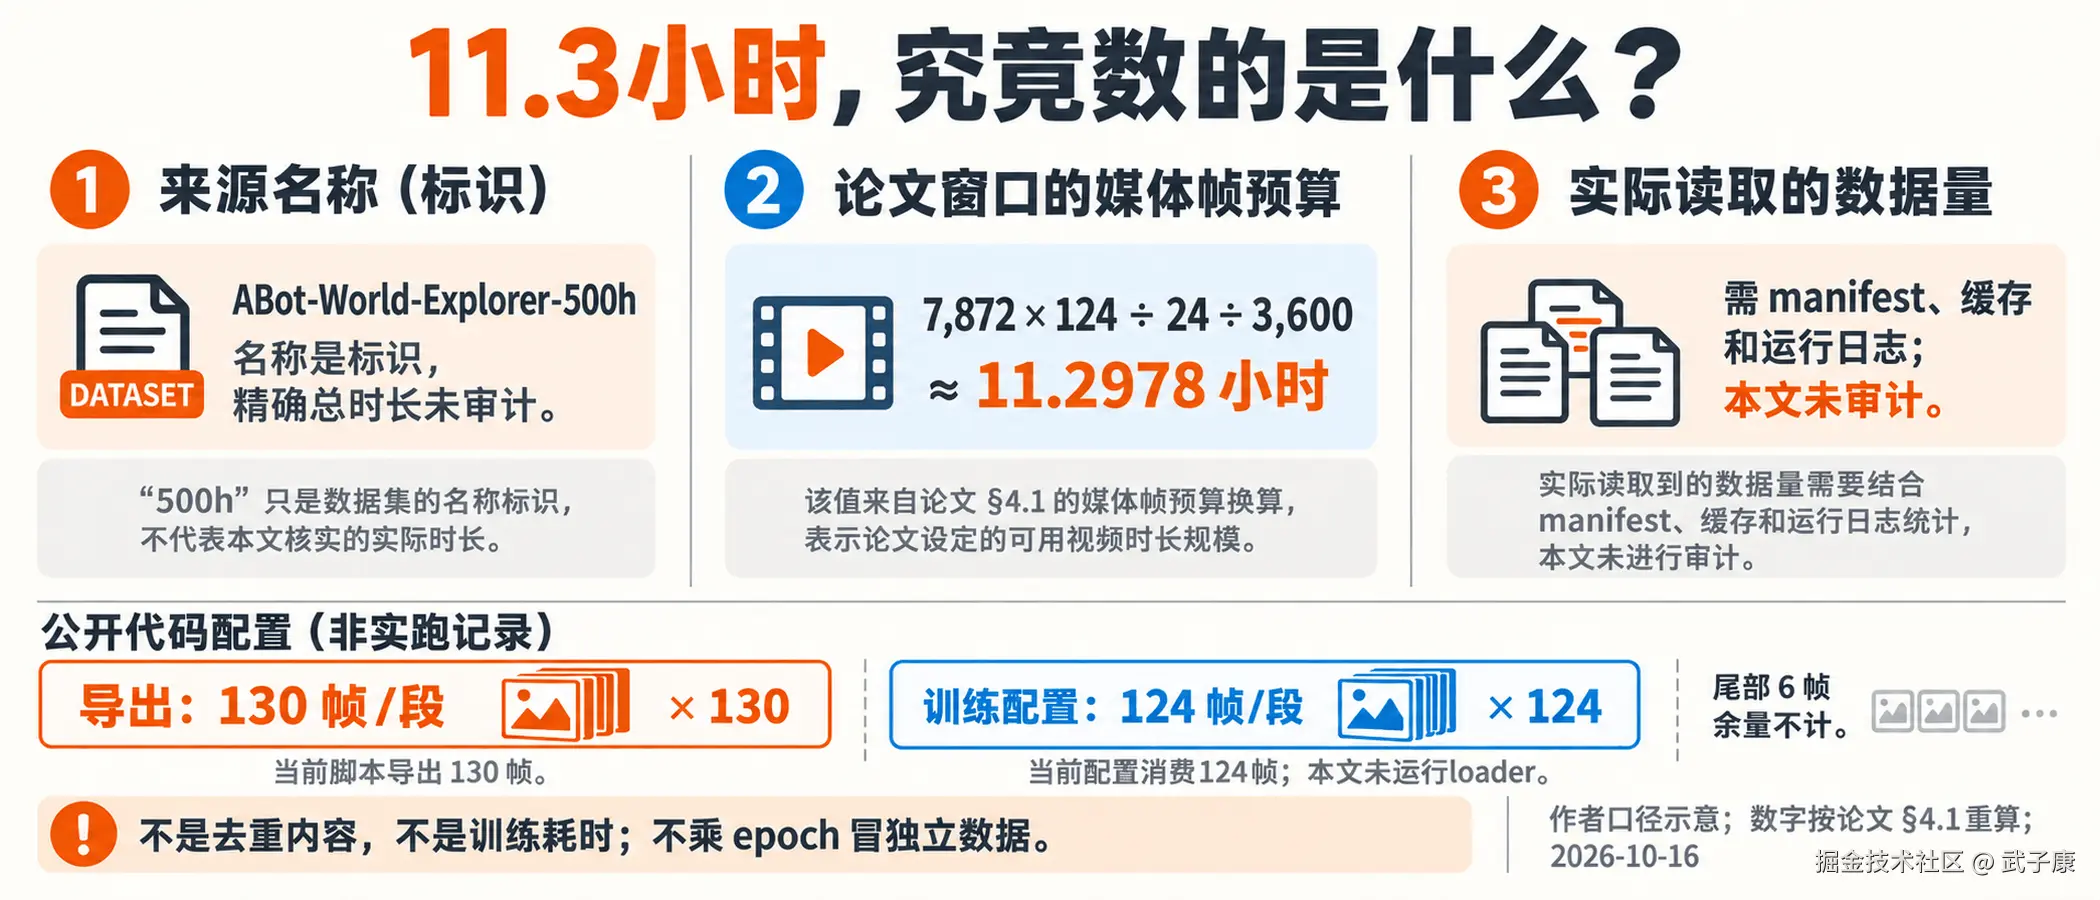
H3-World 从名字带有"500h"的 ABot 数据集取数据,论文实验却只用了 7,872 个训练片段。按每段 124 帧、24 FPS 计算,论文声明的训练窗口按帧预算折算约为 11.30 小时。这个落差首先改变的是我们要核查的问题:复现时不能拿来源库的名称回答"训练了多少",也不能把一段视频旁边放上按键文件,就认为已经获得可用的动作监督。
更值得看的是数据经过了什么变化。官方处理程序没有直接使用动作 JSON 中现成的连续变化数组。它从 COLMAP 相机姿态恢复运动,把视频与键态裁到共同的源帧索引,再把这些记录压到视频 latent 的时间区间里。最后给模型的并非原始姿态数值,而是由八个键与一个相机速度位生成的文本。这条链每一步都可能丢信息,检验目标也各不相同。
本文于 2026 年 10 月 16 日核对 H3-World 固定提交 f0c7be2acbbde8256b2473f6e7b088f58272acae、论文 2609.01560v1 和 ABot 数据卡固定修订 7337b5b5bdd5c7f8ccd83f8c6f4868be84d64c76。本文只审读公开资料,并运行标准库算术与固定源码纯函数的检查;没有下载数据载荷、遍历实际片段、安装模型依赖或运行训练。下文的真实数据统计均保留来源归属,演算样例不作为实测结果。
1. 先把来源库、短窗口和动作条目分开计数
ABot 数据卡声明有 30,969 个 episode,每个包含视频、动作、字幕以及 COLMAP 文本稀疏模型。同时明确:仓库名是标识符,不代表发布方已经审计了精确总时长、FPS 和对齐统计。因此"500h"既不能直接作为 H3-World 的训练时长,也不能由我们据此宣布整个公开库恰好有 500 小时。固定数据卡
论文 §4.1 给出另外一组对象:8,000 个 gameplay clips,划成 7,872 个训练片段与 128 个评估片段。每段 124 帧、24 FPS、832×480,提供 37 条与 latent 时间区间对齐的动作提示。这是论文口径,本次没有重新枚举公开训练 metadata。我们据此重算,得到下表。论文 §4.1
| 口径 | 片段数 | RGB 帧数 | 动作提示数 | 按帧数/FPS 折算时长 |
|---|---|---|---|---|
| 训练窗口 | 7,872 | 976,128 | 291,264 | 11.2978 小时 |
| 评估窗口 | 128 | 15,872 | 4,736 | 0.1837 小时 |
| 合计窗口 | 8,000 | 992,000 | 296,000 | 11.4815 小时 |
这里使用媒体帧预算口径 片段数×124÷24÷3600,而非首末采样 时间戳 之差。它没有扣除不同窗口之间可能共享的内容,也不是训练 wall-clock。291,264 条提示来自 7,872×37,同一片段内的提示互相关联,不能再把它们称为 29 万个独立场景。
源码还有一个容易造成口径偏差的细节:build_abot_clips.py 实际写出 130 帧,多出的 6 帧用来避免解码长度的取整问题;训练配置与动作文本读取只消费前 124 帧。用导出 MP4 的全部帧数反推模型消费时长,就会把保留的尾部余量也算进去。这里的 11.3 小时严格采用论文和训练入口的 124 帧,而非导出容器的 130 帧。构建脚本
还要区分数据预算与实际训练读取。构建程序只把成功窗口写进 manifest ,失败窗口会被排除;指定 --num-clips 8000 不独自证明产出了 8,000 条。缓存注入程序枚举已有 .pth 文件,以文件名中的行号对应 metadata,检查重复或越界,但不能仅凭目录名称证明 7,872 行都存在且没有旧缓存。正式训练脚本指向缓存目录,设置 dataset_repeat=1、num_epochs=20;论文报告 10,000 次优化。这些配置与报告不等于取得了此次训练实际读到的文件清单。没有 manifest、缓存清单与运行日志,就不能把 11.3 小时称为本次独立确认的实际读入量,更不能把它乘以 epoch 后称作独立数据小时。训练配置
这些数字说明的是一个强 预训练 底座上的短时域适配规模。它们不能回答从零训练视频生成器的成本,也不能推出换一个游戏、换一组操作仍只需 11 小时。论文保留 H3 底座并学习 LoRA,训练所要完成的任务本来就比从零学像素、场景与运动小得多。
2. 连续动作字段全零时,不能据此生成"静止"标签
官方固定源码忠实摘录,非原网页或终端截图;2026-10-16复核。
ABot 数据卡列出 action.json 的逐帧键态、时间戳,以及四组平移/旋转 delta 向量。字段存在,不能独自保证数值有效;数据卡也提醒,不应擅自推断未注明的平移或时间戳单位及跨模态对齐。
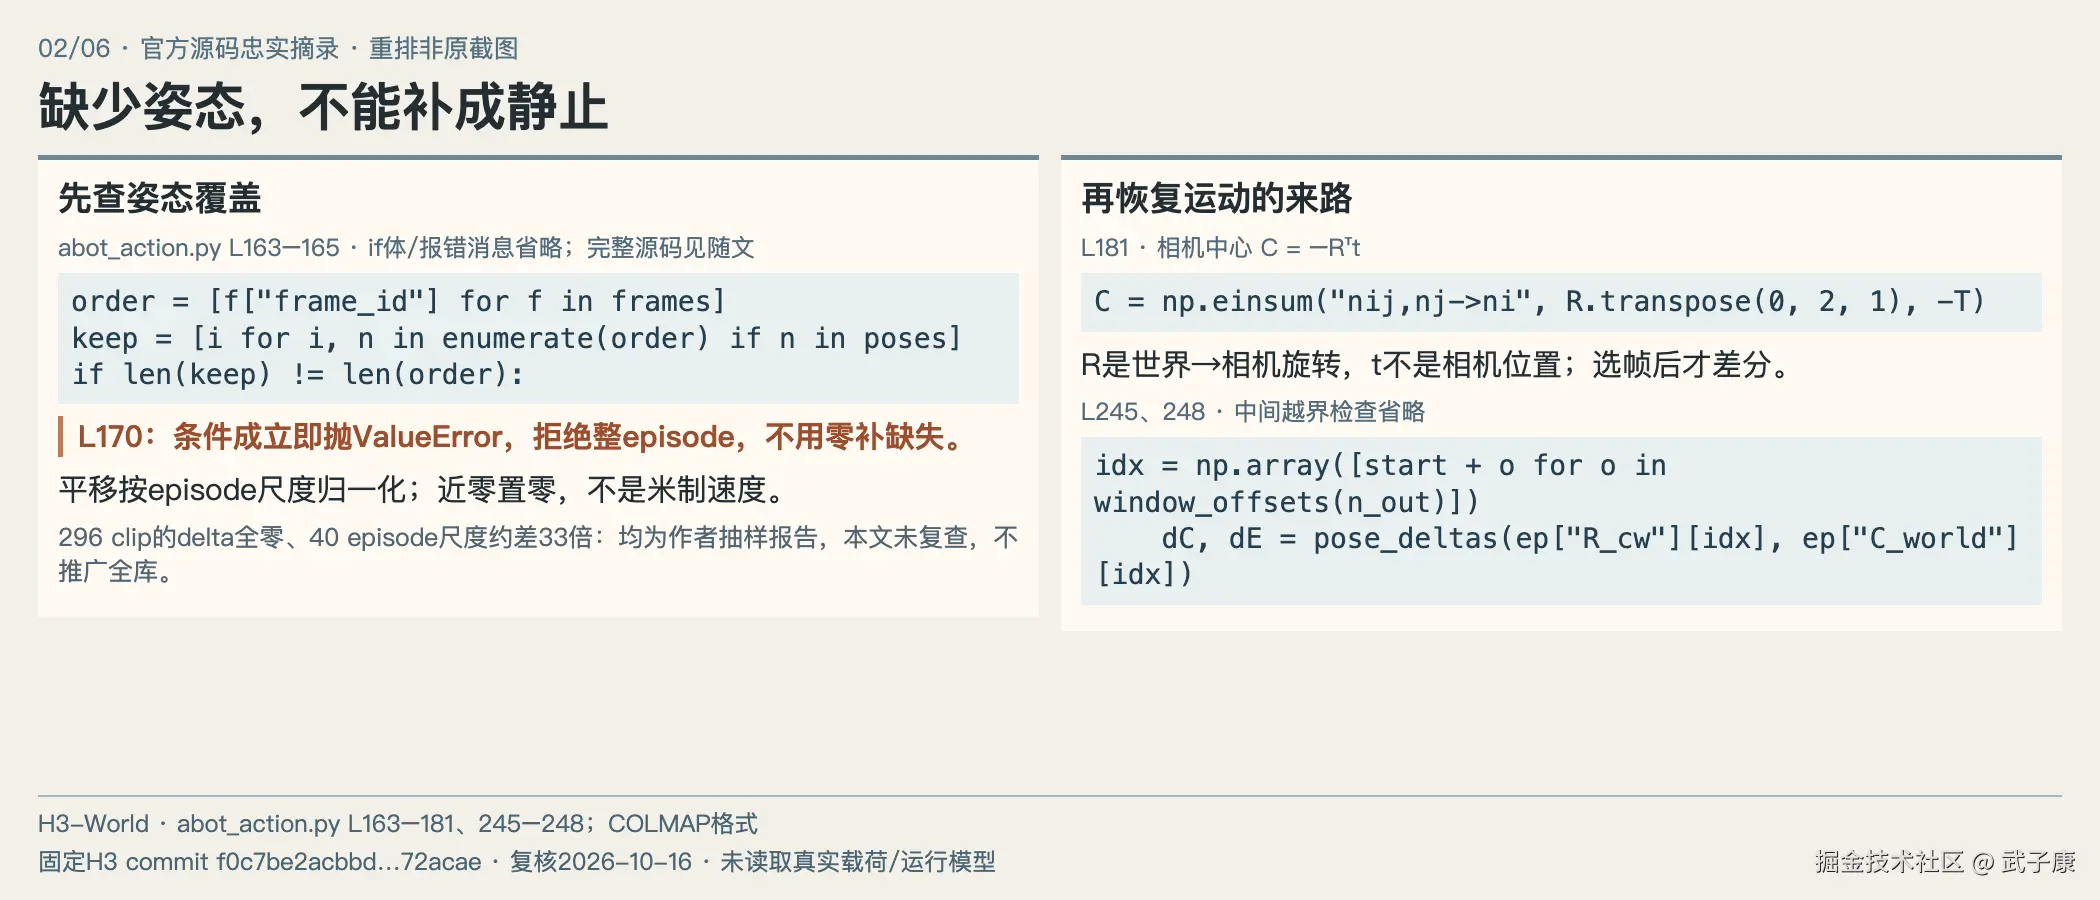
H3-World 的 abot_action.py 注释报告:作者在 296 个 clip 的抽样中看到四组 delta 向量全部为零,于是转用 sparse/0/images.txt 恢复相机运动。另一次 40 个 episode 的抽样中,典型逐帧位移中位数从 0.0045 到 0.1488,相差约 33 倍。这是源码中保留的作者抽样观察,本次没有重新下载这些样本复算,也没有证据把"全部为零"推广到 30,969 个 episode。动作预处理源码
实际实现给出了一个更有约束的替代路径。COLMAP 的姿态将世界坐标映射到相机坐标 x_cam=R_cw·x_world+t_cw,相机中心因此为 C=-R_cwᵀ·t_cw。相邻中心之差再用上一帧的旋转变换到上一帧相机坐标,得到向右、向下、向前的相对平移;相邻旋转矩阵则用于求 pitch、yaw、roll。不能把文件里的平移向量 t_cw 直接当成相机在世界中的位置。COLMAP 官方格式
代码按 action.json 的 frame_id 去匹配姿态记录的图像名,不依赖图像数字 ID 连续。只要某帧缺少姿态,就抛错使这个 episode 无法按当前路径生成窗口。补零会把"没有观测"伪装成"没有运动",这里选择停止生成标签。
每个 episode 的平移又除以该 episode 在选帧后时间线上的典型位移中位数,以减弱重建尺度差异。若尺度过小,代码将平移置零,避免除以近零数。这个归一化量代表相对运动强弱,不能改写成以米为单位的速度,也不能据此声称跨场景恢复了真实物理尺度。旋转角度不经过同样的 episode 尺度归一化,但后面的池化仍会缩放、裁剪旋转通道。
因此,检查数据时至少要区分三个结果:键是否按下、姿态是否可用、恢复的运动是否合理。按键是控制输入,姿态是重建出的视觉运动观测,两者可以共同帮助构造标签,却不保证逐帧一一对应,更不保证它们都直接成为最终模型条件。
3. 共同选帧定义对应关系,latent 池化改变监督分辨率
官方固定源码忠实摘录,非原网页或终端截图;2026-10-16复核。
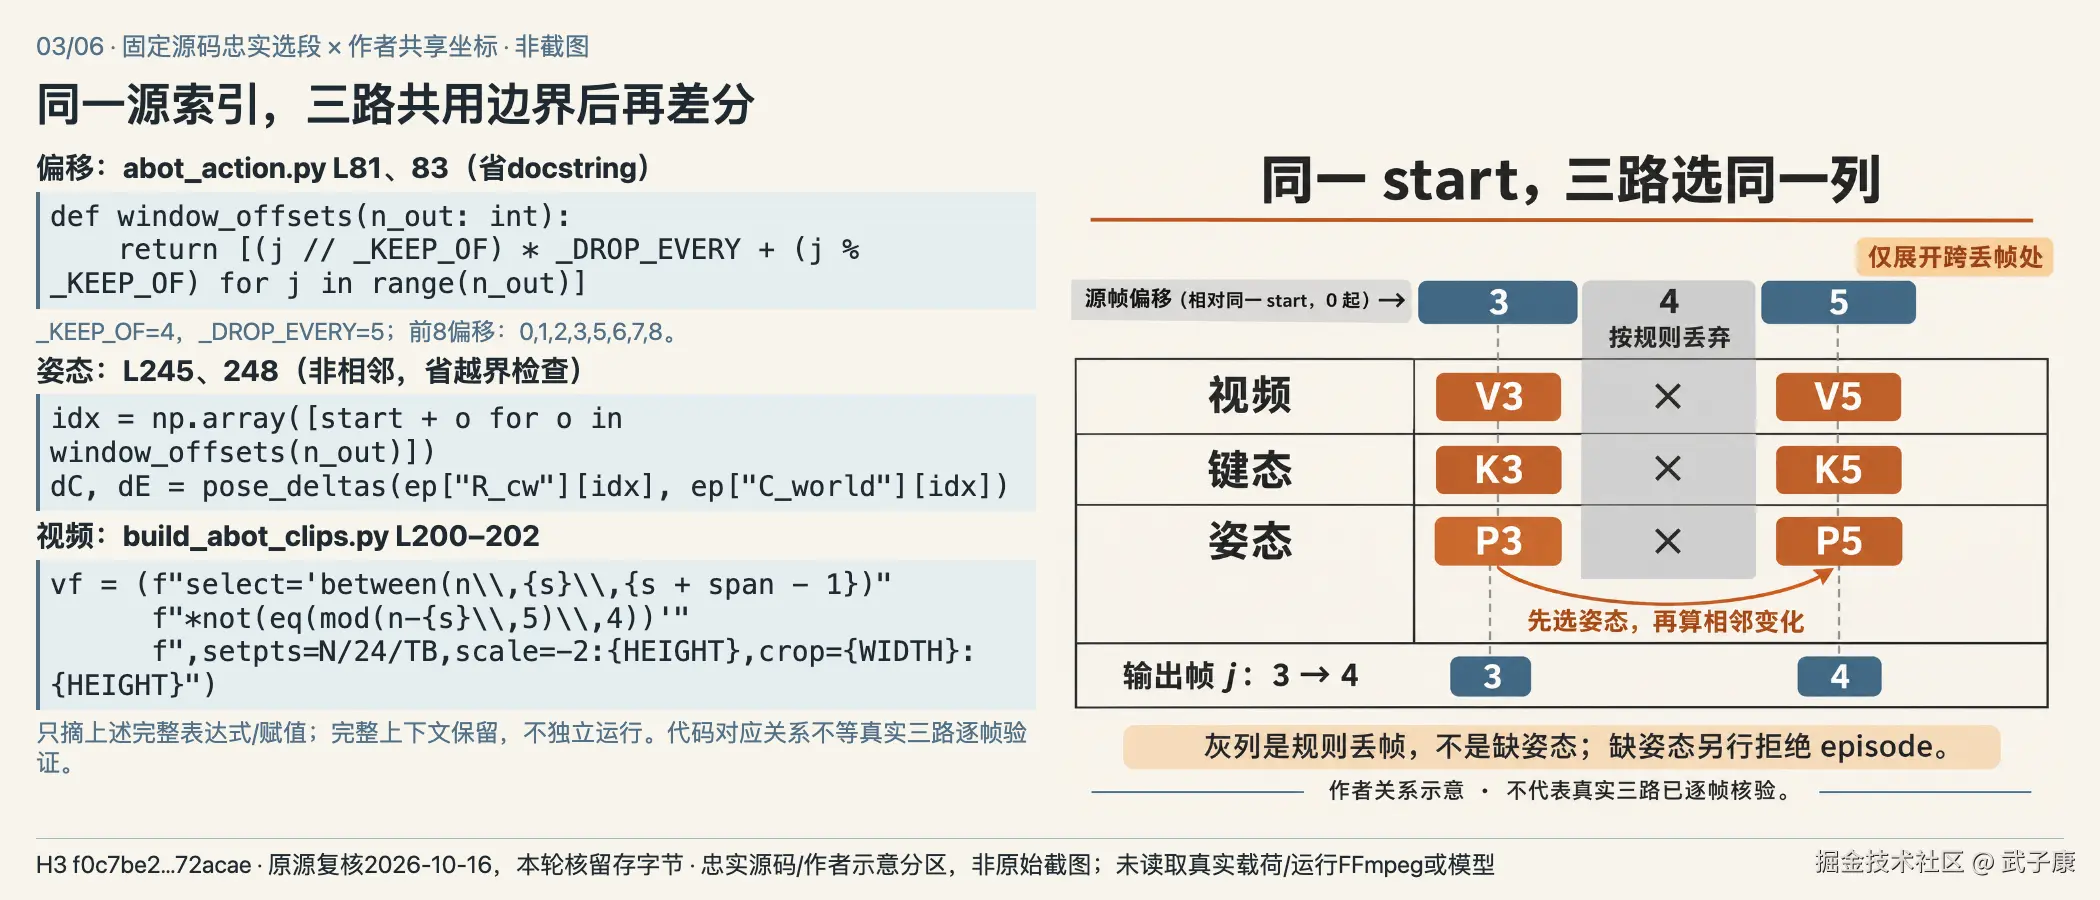
视频从 30 FPS 转为 24 FPS 的规则是每五个源帧保留前四个。动作矩阵也使用同一套偏移:输出帧 j 取窗口起点加 5×floor(j/4)+(j mod 4)。前八个偏移是 0,1,2,3,5,6,7,8,而不是按转换后时间戳去猜最近的动作记录。
这还影响姿态差分的顺序。当前源码先按上述索引选择相机姿态,再计算相邻姿态变化,因而跨越被丢弃帧时直接得到两个保留姿态之间的相对变化;并非先在原始逐帧序列上计算欧拉角差,再把它们简单相加。实际代码采取哪种顺序,是复现需要保留的处理语义。
共同索引能证明处理程序怎样建立对应关系。它不能替代对原始视频帧数、记录数量、时间戳与姿态覆盖的检查。构建脚本包含 --verify 抽查入口及作者关于读取一致性的说明,本次未执行它,不能把"代码采用共同索引"升级为"本地全部输出已经逐帧核验"。
124 个 RGB 帧接下来被组织成 37 个 latent 时间区间,区间宽度按 (1,4,4,4,4) 重复,最后在 124 帧处结束。固定源码纯函数检查得到首八个半开区间为 [0,1)、[1,5)、[5,9)、[9,13)、[13,17)、[17,18)、[18,22)、[22,26),37 项宽度之和确为 124。
键态在一个区间里取最大值:某一帧按过,就记作该区间激活。连续变化则在区间内求和,然后缩放和裁剪。两种池化没有相同的语义。一次短按会被保留,但四帧区间里"先 W 后 S"会把两个位都置一,后续文本规则再抵消相反键,原来的先后顺序已经不能恢复。因此,37 条动作文本是一组经过信息压缩的监督,不是 124 帧按键记录的无损译文。
作者解释或未执行记录;人造演算不代表真实数据质量或训练运行结果。
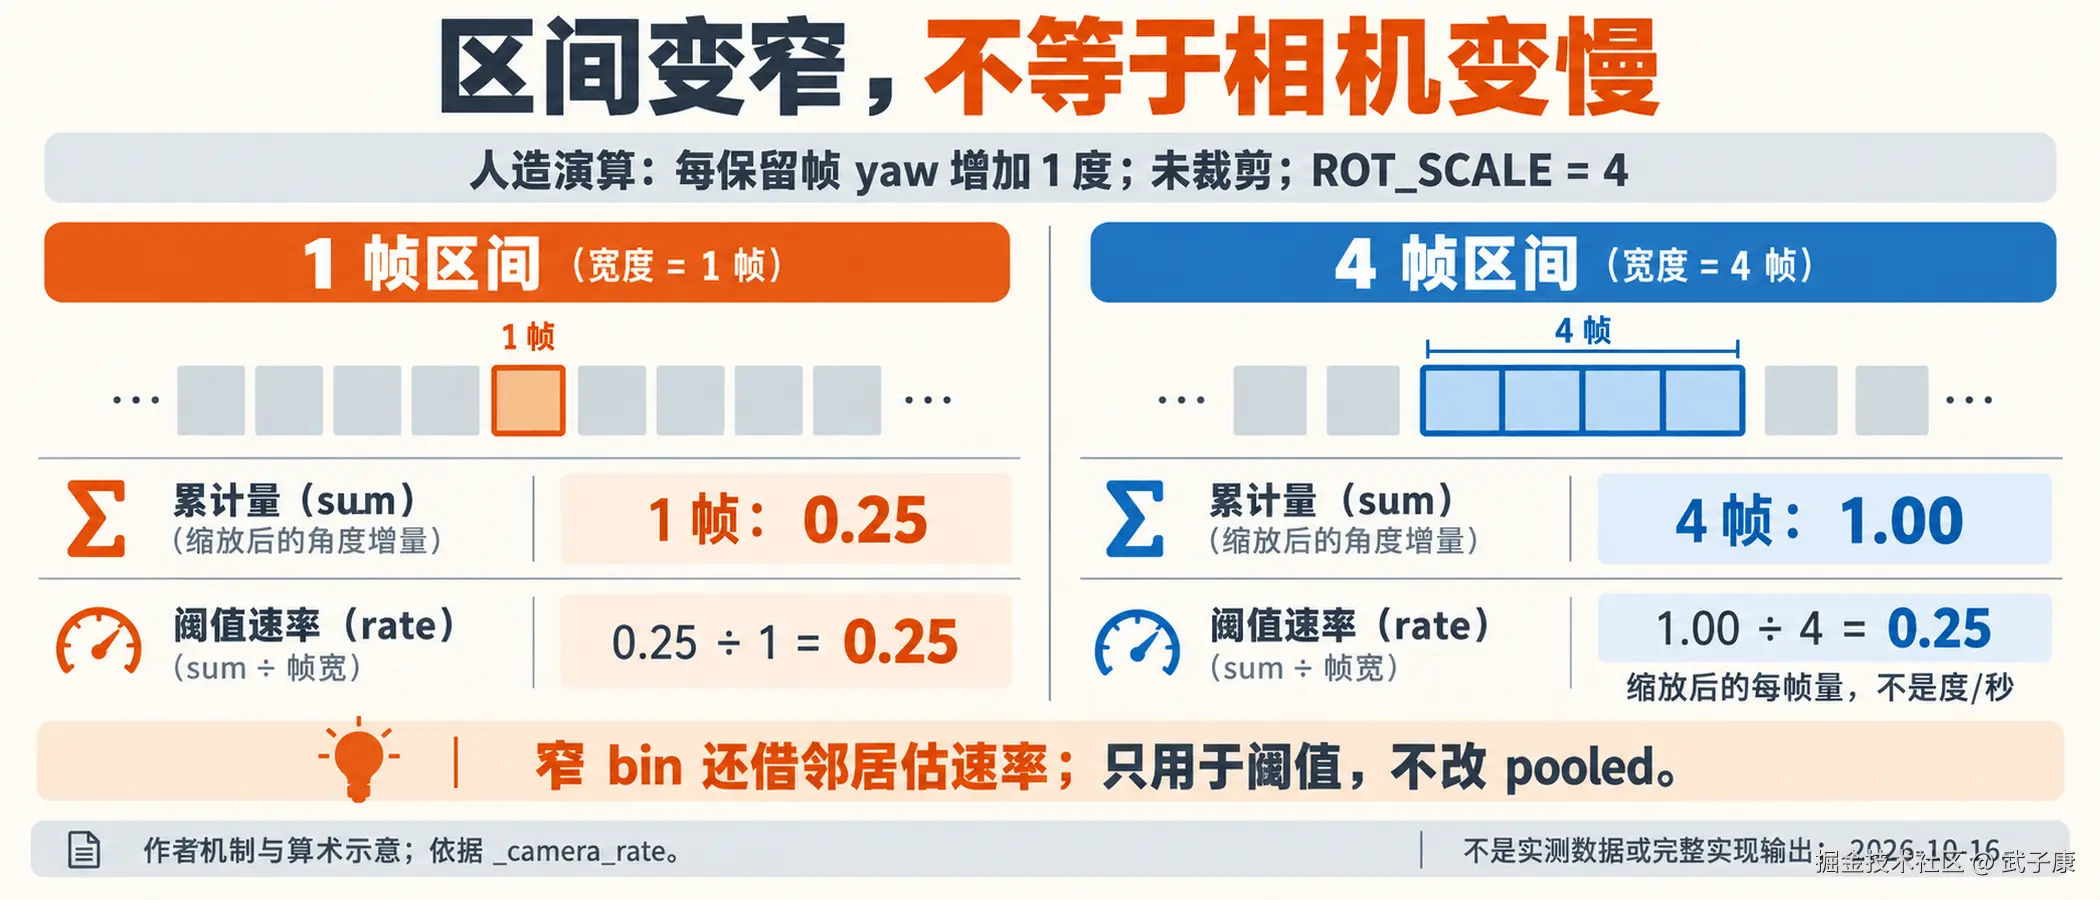
这里有一个比"求和还是平均"更容易漏掉的处理。单帧区间与四帧区间宽度不同,稳定转向时累积 yaw 的和也不同。如果直接对累积值设快慢阈值,同样的转向速度可能每隔几个区间就被判成慢下来。
当前 action_script.py 的 _camera_rate 先把连续通道除以各区间帧数;窄于四帧的区间还借相邻区间合并估计,只影响判阈值的速率,不回写原来的池化结果。这样既保留累积变化,也避免把区间宽度差异解释成相机变速。文本标签实现
用一个明确的人造演算就能看清这个差别:假设每个保留帧的 yaw 增量均为 1 度,且不触发裁剪。经 ROT_SCALE=4 缩放后,单帧区间的累积量是 0.25,四帧区间是 1.00;再分别除以 1 和 4,判阈值的速率均为 0.25。这个速率仍带有代码的缩放约定,不能直接称为度/秒。正文中的数值只是算术例子,没有证明真实样本的姿态噪声已经被消除。
4. 连续姿态最终怎样进入语言条件?
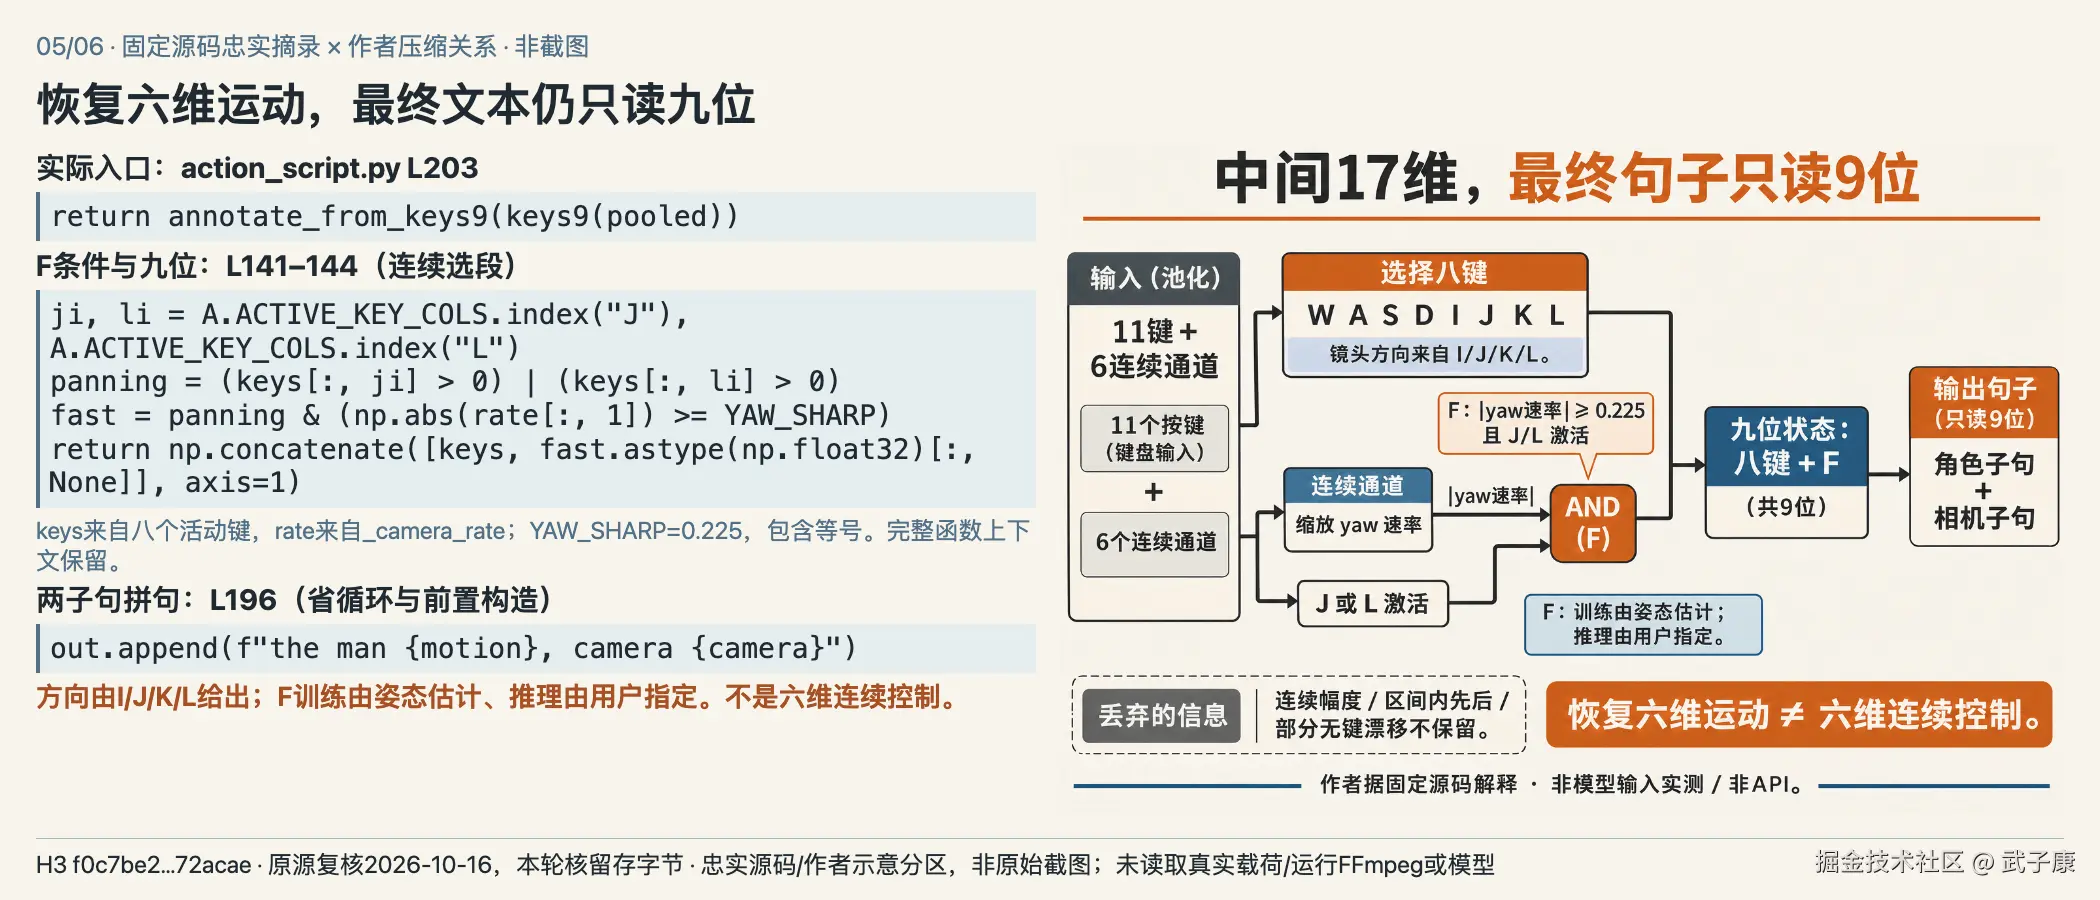
官方固定源码忠实摘录,非原网页或终端截图;2026-10-16复核。
预处理矩阵保留 11 个键与六个连续通道,共 17 维;最终文本接口采用其中八个活动键,加一个速度位 F。F 由转向键是否激活以及上述 yaw 速率是否达到或超过 YAW_SHARP=0.225 共同决定。训练时它来自姿态估计,推理时用户直接指定。完整映射仍以当前代码阈值为准,不能拿未经缩放的原始角度直接比较。
action_script.py 顶部还有"相机子句直接来自连续 COLMAP 变化"的概括,单读它容易误判现有路径。实际 annotate 先生成九位状态,再调用 annotate_from_keys9,后者只依赖这九个位。相机左右、上下方向由 I/J/K/L 键给出,COLMAP yaw 通过 F 提供快慢信息;先前可表达的无键相机漂移被折叠到现有状态中。应该沿函数调用读到真正的输出,不能把历史注释或仍在文件里的词表都算成当前已启用的监督能力。
这也解释了为什么"恢复了六维相机运动"不等于"模型接受六维连续控制"。中间表示比最终接口丰富,经过阈值与规则之后,模型读到的是一条角色子句加一条相机子句。精细运动幅度、区间内顺序和部分无键漂移都不在最终文本里。
缓存注入脚本为每个片段生成 37 条句子,将动作文本及对应区间信息写入训练缓存,保留视频/音频 latent,重新构造文本头部与动作段。动作文本并不是把整段 caption 拆成 37 份,也不是由 VLM 临时自由描述每一帧。缓存注入实现
论文图 3 报告 135 个合法动作组合中,训练覆盖 83 个,52 个未出现;前 20 个组合占提示的 71.4%,前 40 个占 95.4%。这些是论文统计,本次没有训练 manifest 来重建完整分布。它们足以提醒我们:时长相同的数据,可以拥有很不一样的动作覆盖。52 个组合未见不代表论文已经逐一量化了它们的成功率,少量组合示例也不能推出每个稀有动作都可靠。论文 §3.2 与图 3
5. 复现时留下哪一份对齐记录?
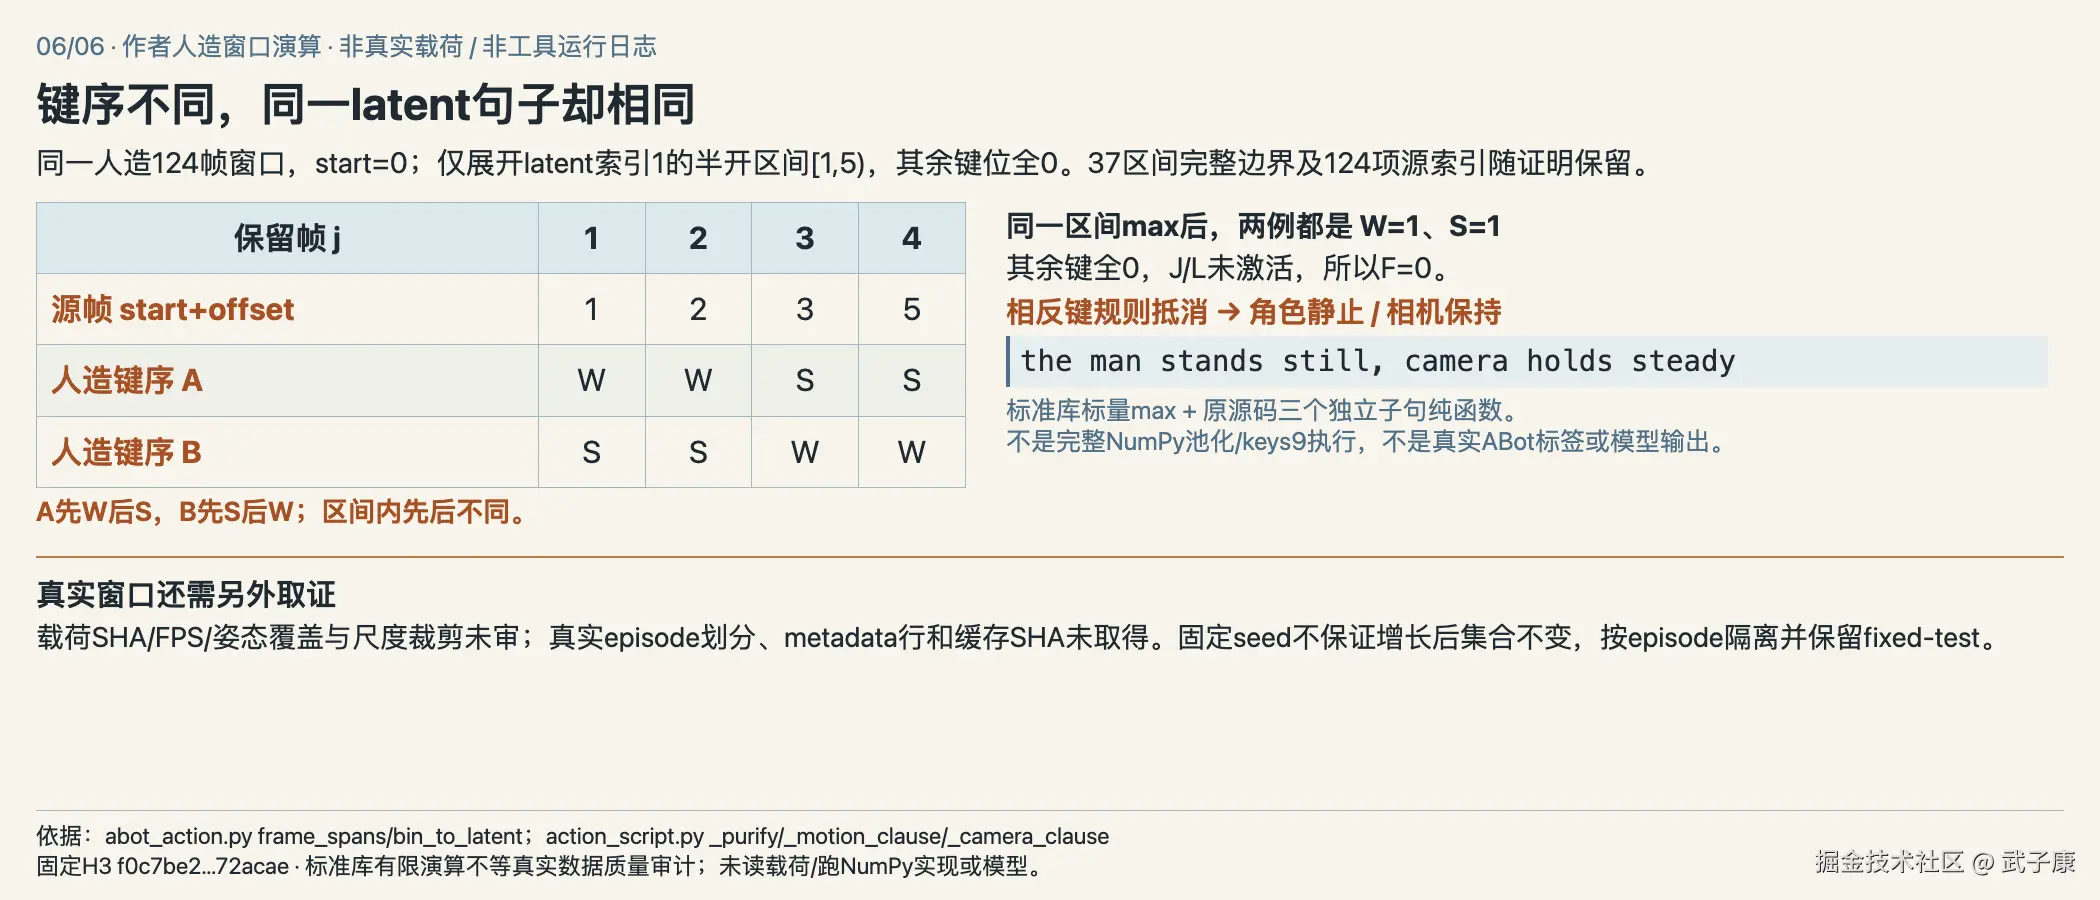
作者解释或未执行记录;人造演算不代表真实数据质量或训练运行结果。
这篇文章最实际的产物是一份按窗口保存的对齐记录。下面是作者建议字段,尚未在真实 ABot 样本上执行;它不是现有工具已经输出的日志。
| 记录对象 | 应保存的证据 | 据此做出的判断 |
|---|---|---|
| 原始 episode | 固定数据修订、sample_id、载荷 SHA、帧数/FPS、动作记录数量、时间戳检查 | 原始媒体与记录是否满足当前 30→24 路径假设 |
| 选帧窗口 | episode ID、窗口起点、完整源索引、导出 130 帧及实际消费 124 帧 | 视频、键态与姿态是否使用同一列表;尾部余量是否误入训练 |
| 姿态恢复 | frame_id 覆盖、相机中心计算、选帧后差分、episode scale、裁剪比例 | 缺观测是否被假装静止;异常重建是否主导标签 |
| 动作文本 | 37 个区间边界、池化键、冲突抵消、速率与 F、最终句子 | 标签的时间位置、快慢与信息损失是否可解释 |
| 样本划分与缓存 | train/test episode 集合、窗口 ID、metadata 行号、缓存与输入 SHA | 评估内容是否进入训练;缓存是否仍对应当前样本 |
最后一项尤其值得保留。当前划分脚本要求 sample_id 唯一,并按种子和样本 ID 的哈希选择测试集;默认数量是 128。数据集增长后,同样的种子不保证选中的集合不变,代码因此提供 --fixed-test 重用已有测试 ID。如果你改变构建方式,让同一 episode 产生多个窗口,则必须明确它们的共同来源,用 episode 分组检查隔离,不能只比较不同 clip 文件名。本次未取得实际构建 manifest,不声称正式划分已被重新审计。固定划分脚本
最便宜的开始方式是选一个窗口,连同原始源帧索引、37 个区间和最终文本一起检查;确认这条转换链后,再汇总全量覆盖与异常比例。一个能追溯"这句快速右转来自哪些帧、哪次姿态变化和哪个阈值"的窗口,比仅报告拿到了多少 GB 或标称多少小时更能帮助定位监督错误。
11.3 小时说明 H3-World 在公开实验里使用了多少短窗口。视频、动作、姿态到语言条件的转换,才说明这些窗口怎样成为训练信号。复现者需要同时保留这两个答案:消费规模可以重算,每条标签的来路也应当能沿同一窗口查回去。
来源与适用范围
官方源码固定提交与数据卡修订见开头,论文为 2026-09-01 的 v1;核实日期 2026-10-16。本文未重放视频、运行 COLMAP、下载训练数据、核验真实缓存或执行模型。作者抽样统计与论文结果按其公开报告引用;时长、区间和人造 yaw 样例由本文标准库检查重算,既不等于实际数据质量审计,也不证明训练、实时性或泛化成功。