数学建模比赛里,很多队伍把大把时间耗在调图上,字体对不齐,配色花哨,导出一模糊就被评委扣印象分。mathmodel-figure-templates 就是为这件事准备的。它是 Claude Code 里的一个技能(Skill),提供一套预先配置好的、可直接出版级别的科研图表模板,面向数学建模场景,用 Python 就能跑起来。
🧭 它到底是什么
一句话定位
它是一个图表模板库,装在 Claude Code 里。你把数据和需求交给 AI,它调用现成的绘图模板,生成风格统一的统计图和科学图。模板以 Python 代码形式给出,开箱即可运行。
它所处的生态
这类技能一般不单独出现,往往是整条建模流水线里的一环。GitHub 上有面向各大建模竞赛的全流程技能插件,覆盖从审题到成文的多个阶段。 另有一类技能,从 139 篇全国大学生数学建模竞赛(CUMCM)优秀论文里提炼出决策套路,帮助分析和求解赛题。 还有带"关卡"的工作流,把项目拆成解析、方法选择等阶段,由 Claude Code 或 Codex 逐步引导。
作图模板正好嵌在这条链的后段,负责把结果变成论文里能直接放的插图。

上图中的 D 环节,就是 mathmodel-figure-templates 发挥作用的位置。
🔍 两个具体案例
下面两个案例都用 Python 写成。需要说明一点,我检索到的页面只公开了模板库的整体定位,没有逐条列出每个模板的源码。所以这里的代码是按这类模板的典型写法给出的示意实现,用来说明思路,各模板的具体参数请以技能本身的内容为准。
案例一 相关性热力图,用于特征筛选
建模初期要判断哪些变量值得放进模型,相关系数热力图是最常用的一张图。皮尔逊相关系数定义为
rxy=∑i=1n(xi−xˉ)2 ∑i=1n(yi−yˉ)2 ∑i=1n(xi−xˉ)(yi−yˉ)
取值在 −1 到 1 之间,越接近两端,线性关系越强。
python
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

# 构造示例数据,实际使用时替换为你的数据表
rng = np.random.default_rng(42)
df = pd.DataFrame(rng.normal(size=(200, 5)),
                  columns=["温度", "湿度", "风速", "光照", "产量"])
df["产量"] = 0.8 * df["温度"] - 0.5 * df["湿度"] + rng.normal(scale=0.3, size=200)

plt.rcParams["font.sans-serif"] = ["SimHei"]
plt.rcParams["axes.unicode_minus"] = False

corr = df.corr()
mask = np.triu(np.ones_like(corr, dtype=bool))  # 只画下三角,避免重复信息

fig, ax = plt.subplots(figsize=(6, 5), dpi=300)
sns.heatmap(corr, mask=mask, annot=True, fmt=".2f",
            cmap="RdBu_r", vmin=-1, vmax=1, square=True, ax=ax)
ax.set_title("变量相关性热力图")
fig.tight_layout()
fig.savefig("corr_heatmap.png")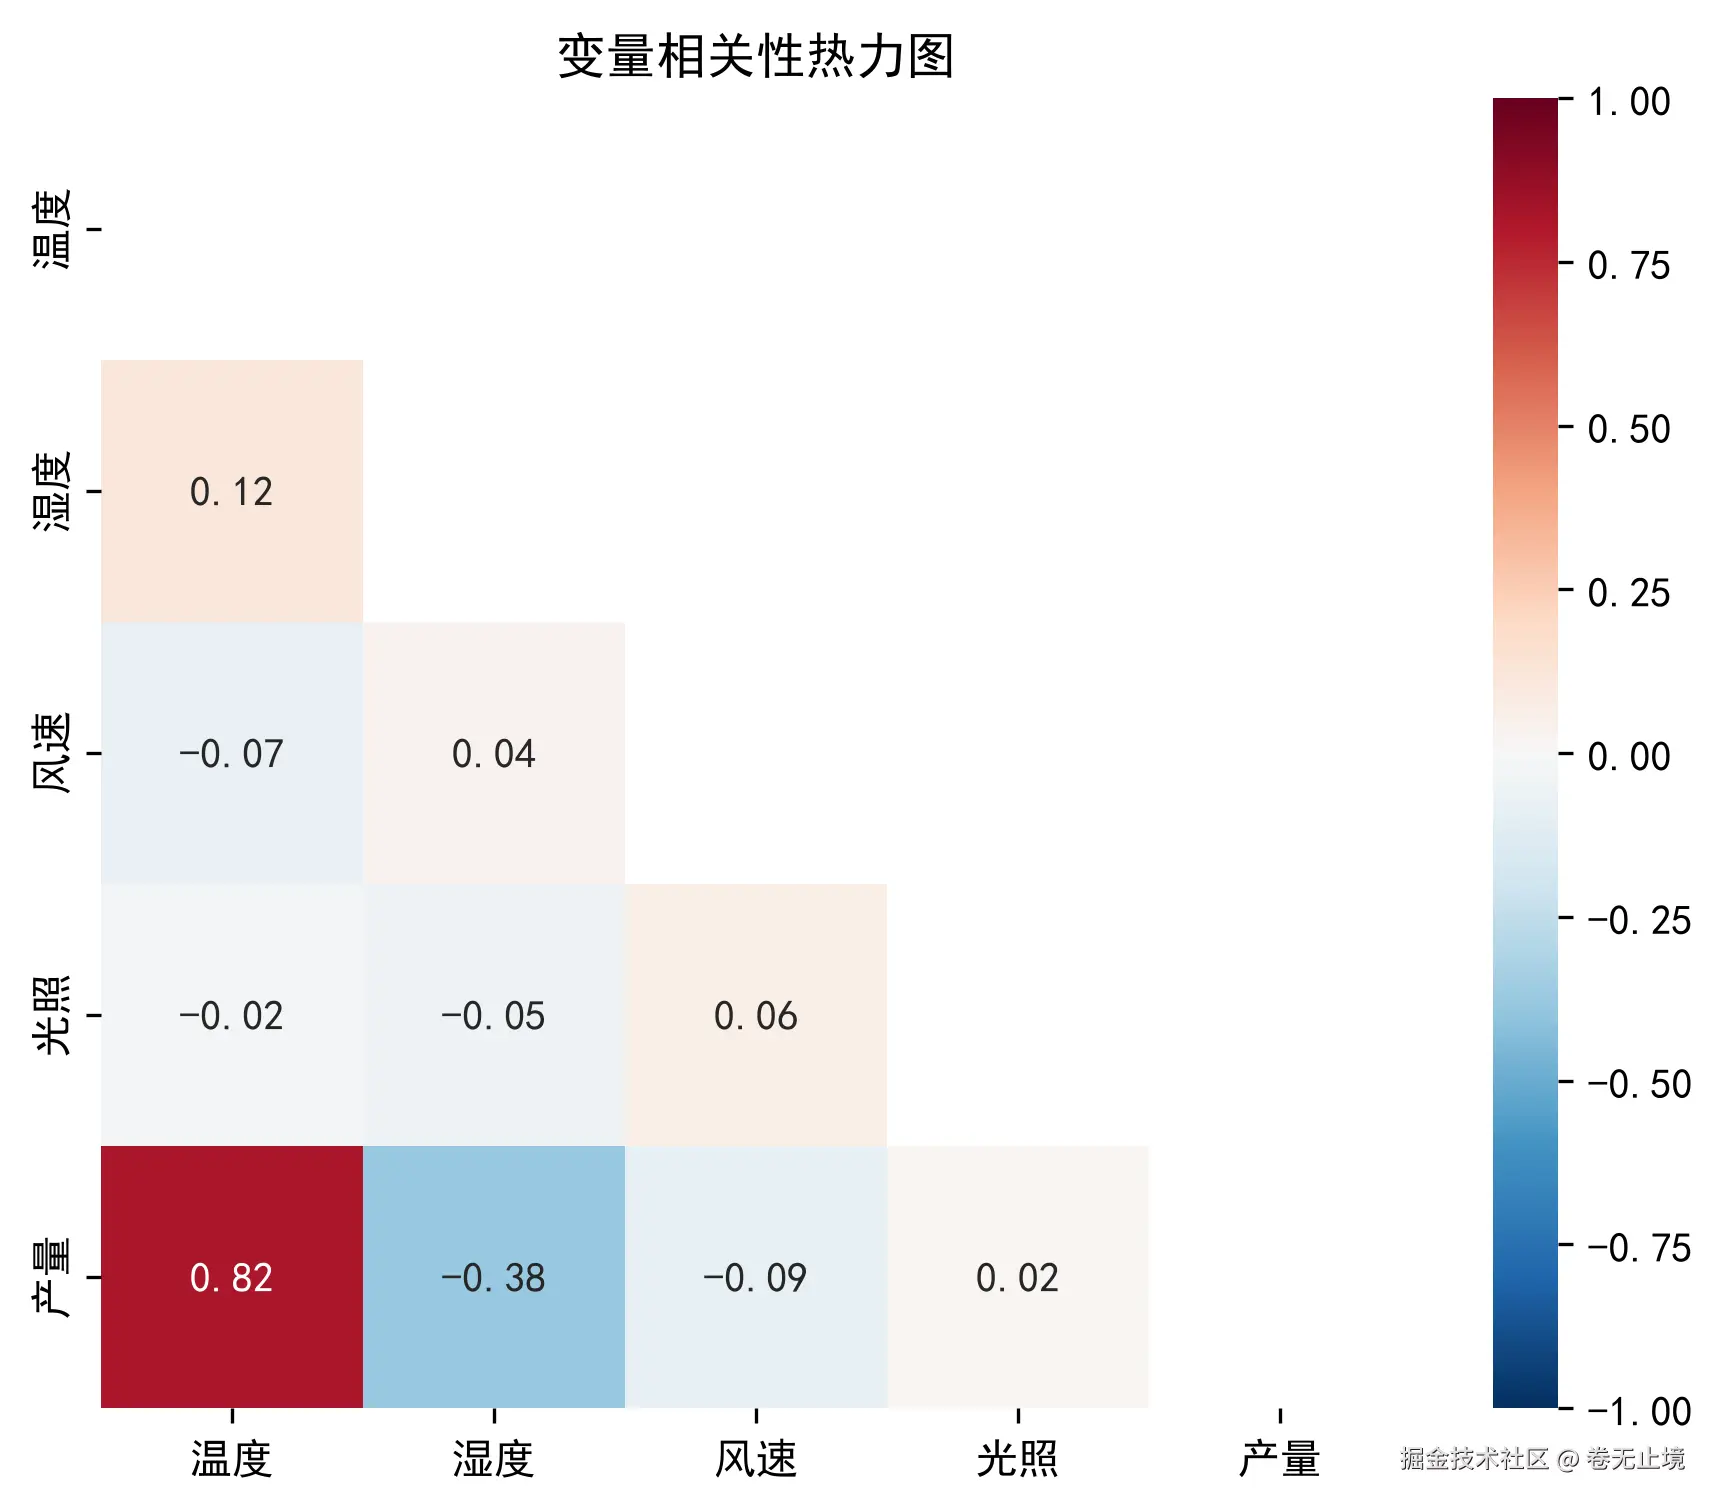
这张图有几个讲究。只画下三角,信息不重复,版面更干净。颜色用红蓝发散色,正负相关一眼可辨。导出分辨率设成 300 dpi,放进论文不会发虚。这些细节正是"出版级"模板想替你固定下来的东西。
案例二 预测值与真实值对比图,用于模型评估
回归、时间序列预测这类题目,评委最想看的是模型拟合得准不准。常用指标是决定系数
R2=1−∑i=1n(yi−yˉ)2∑i=1n(yi−y^i)2
越接近 1,说明模型对数据的解释力越强。
python
import numpy as np
import matplotlib.pyplot as plt
from sklearn.metrics import r2_score

# 示例数据,实际使用时替换为模型输出
rng = np.random.default_rng(0)
y_true = np.linspace(10, 100, 60) + rng.normal(scale=3, size=60)
y_pred = y_true + rng.normal(scale=4, size=60)

r2 = r2_score(y_true, y_pred)

fig, axes = plt.subplots(1, 2, figsize=(10, 4), dpi=300)

# 左图为真实值与预测值散点,对角线表示完美预测
axes[0].scatter(y_true, y_pred, s=20, alpha=0.7)
lims = [y_true.min(), y_true.max()]
axes[0].plot(lims, lims, "r--", lw=1)
axes[0].set_xlabel("真实值")
axes[0].set_ylabel("预测值")
axes[0].set_title(f"拟合效果 R² = {r2:.3f}")

# 右图为残差分布,检查误差是否围绕零点随机波动
residual = y_pred - y_true
axes[1].hist(residual, bins=15, edgecolor="white")
axes[1].axvline(0, color="r", ls="--", lw=1)
axes[1].set_xlabel("残差")
axes[1].set_ylabel("频数")
axes[1].set_title("残差分布")

fig.tight_layout()
fig.savefig("model_eval.png")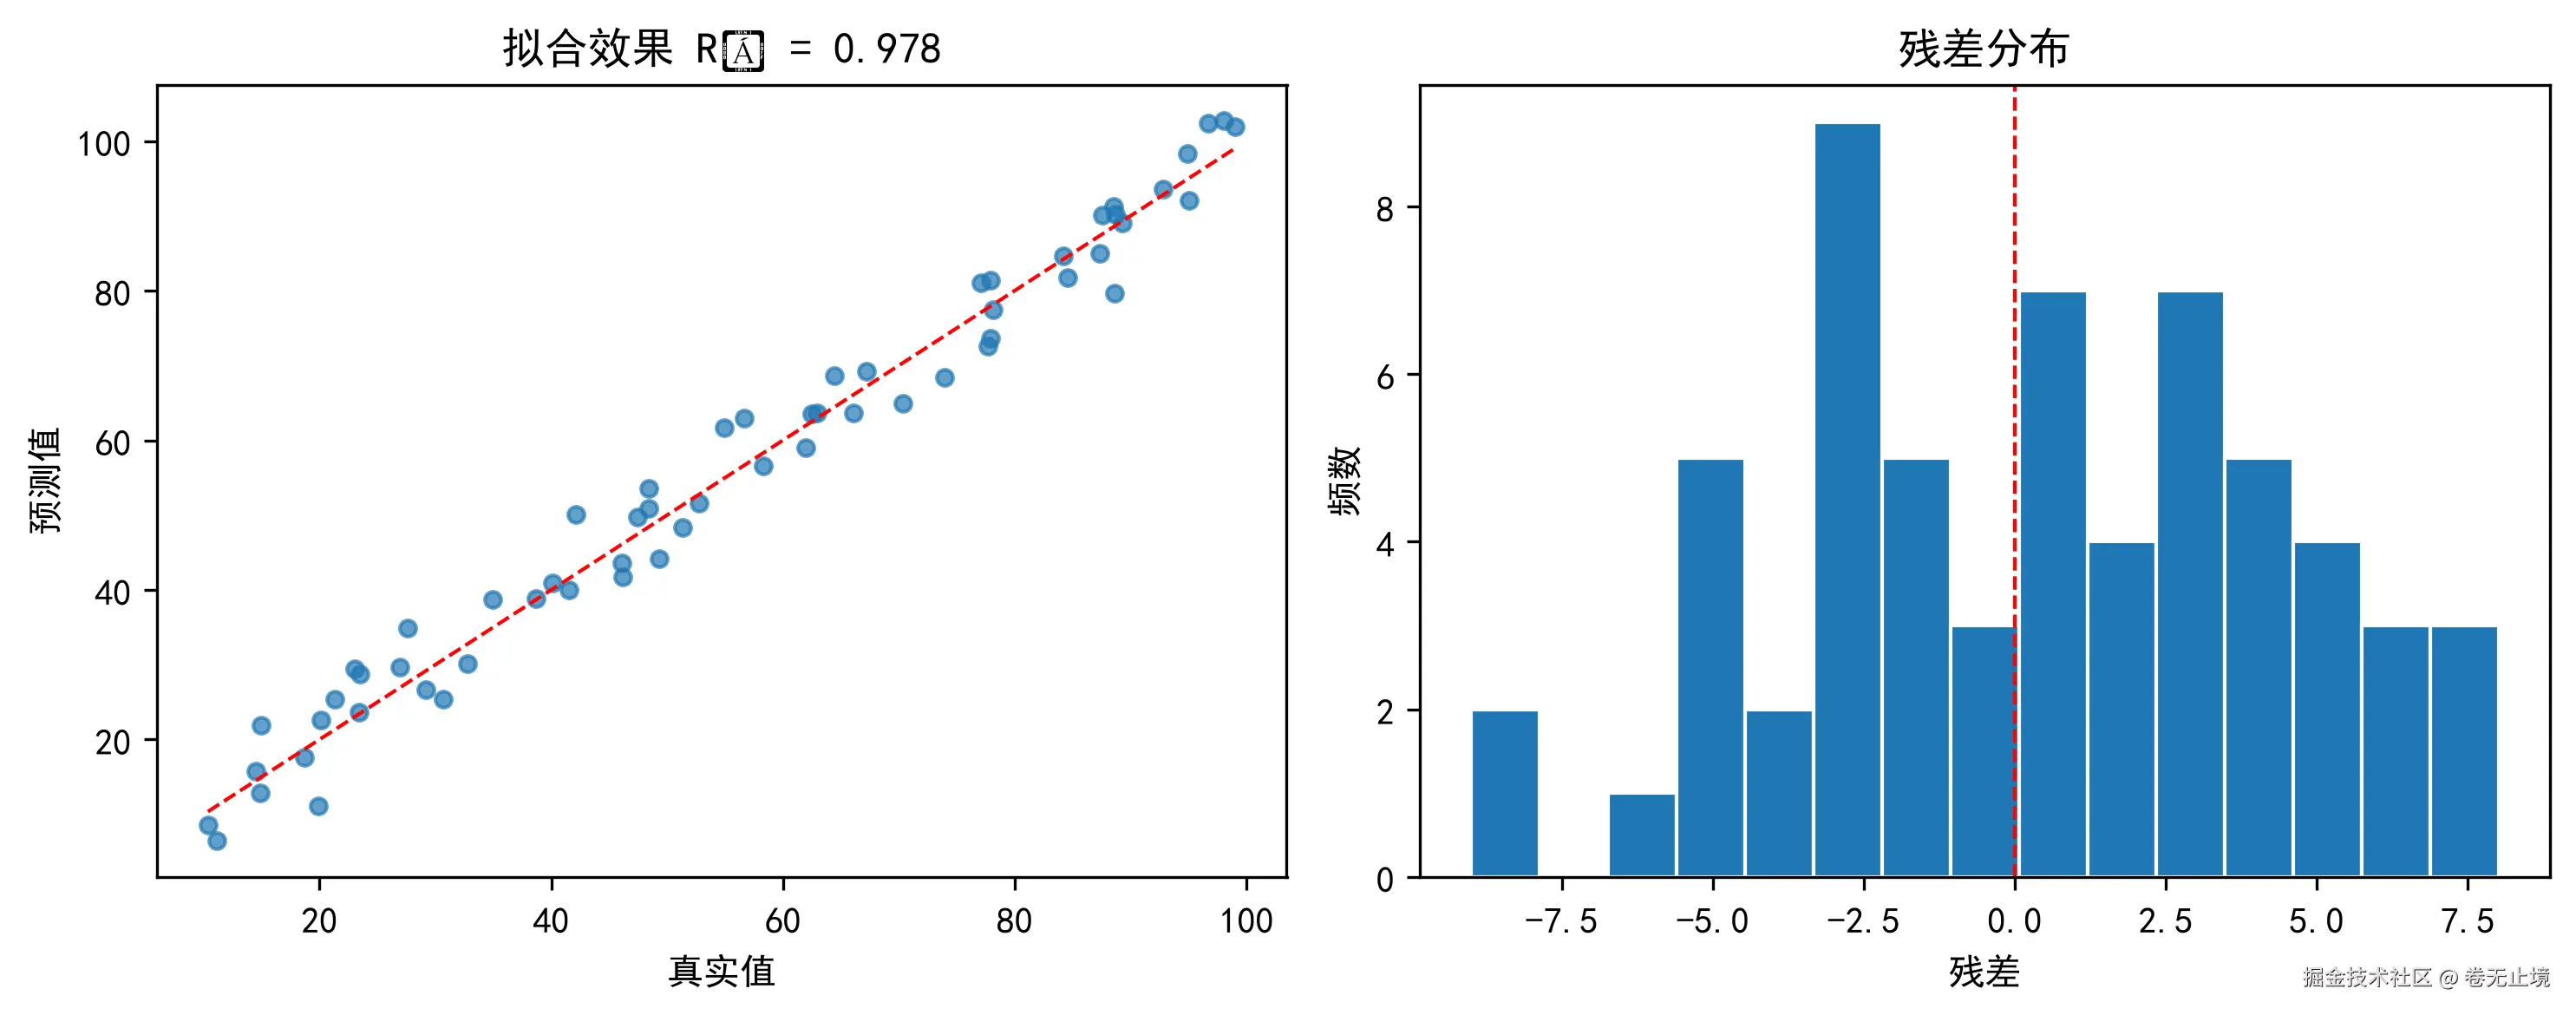
左图看整体贴合度,点越靠近对角线越好。右图看误差有没有系统性偏差,残差若围着零点对称分布,说明模型没有明显的方向性错误。一张双联图,把"准不准"和"稳不稳"同时交代清楚。
💡 小结
下表把两个案例放在一起对照。
| 案例 | 解决的问题 | 关键指标 | 适用阶段 |
|---|---|---|---|
| 相关性热力图 | 变量之间谁和谁有关 | 皮尔逊相关系数 r | 数据探索、特征筛选 |
| 预测对比与残差图 | 模型拟合得好不好 | 决定系数 R2、残差分布 | 模型检验、结果展示 |
总的来说,mathmodel-figure-templates 把"好看又规范"的作图经验固化成模板,让建模队伍把精力留给真正需要动脑的建模本身。它与全流程建模技能搭配使用时效果最好,前面负责想清楚,后面负责画漂亮。
参考资料
- MathModel Figure Templates - Claude Code Skill mcpmarket.com/tools/skill...
- ChinkInArmor/math-modeling-skill github.com/ChinkInArmo...
- Math Modeling Skill by skillforCUMCM www.typingmind.com/skills/skil...
- Run Gated Math Modeling Contest Workflows With MathModeling Skills www.skillsdirectory.com/skills/agen...