原文:mp.weixin.qq.com/s/UOqHPv-lb...(2026年10月17日)
用 AI 办事,最让我血压升高的,从来不是它不会做,是它以为自己做了
让它改个 bug,它写完代码没跑测试,回我一句已完成
让它办两件事,办完一件就把另一件忘了,径直说都办好了
让它去退款,它打了个电话被拒,就告诉我这事办不了,可换个渠道再试试,多半就成了
我把这类毛病叫过早终止,它有好几种模样
偷懒式的假完成,只做了一半就说做完了
过早放弃,一条路走不通就宣布整件事办不成
还有一种假成功,以为办成了,其实闭环没走完,电话里对方口头答应退款,可你还得在手机 App 上确认一步,它却报告已办妥
三种模样,指向同一个源头
在有人验证之前,完成只是模型嘴里的一句话,不是证明
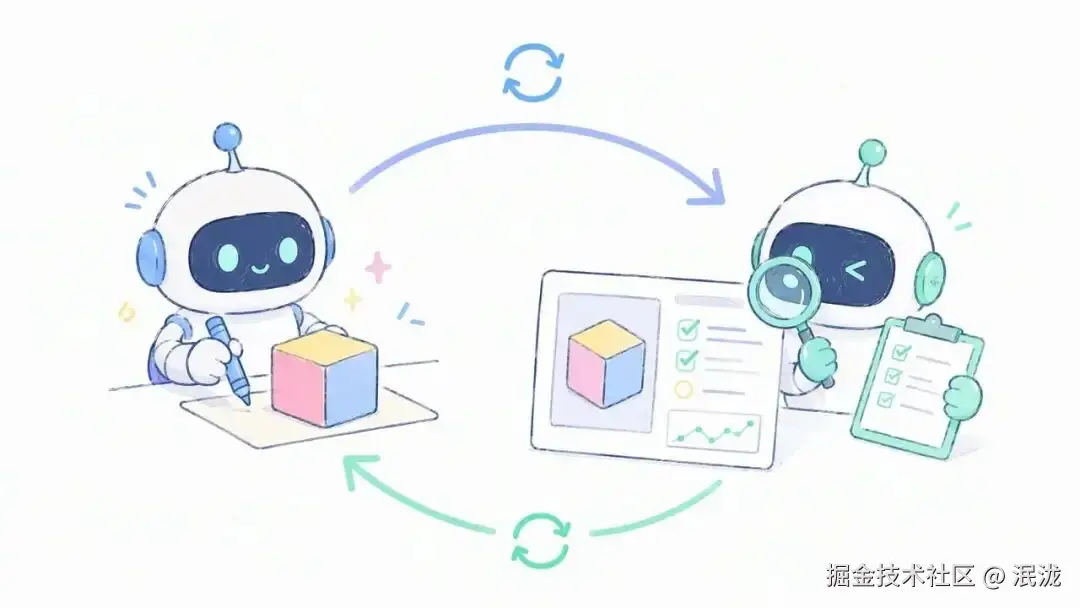 生成,验证,再生成,质量是这样被真正验出来的
先给它配一个验收员
怎么把一句话变成证明
我常想起工地,一个没人验收的工地,工人喊一声我完工了不算数,得有人拿着图纸去量一遍
Loop 工程想干的,就是给 AI 配这么一个验收员
设计一个循环,发现下一件事,执行,验证,记进度,由验证器而不是模型自己来决定能不能停
有句话我记了很久,循环的瓶颈在验证方,不在模型
验证不可靠,循环转得再快,也只是把劣质的东西更快地贴上一张完工标签
落地的方式我看到过两种
一种把循环搬到模型外面,只认那些被独立验证过的成果,模型可以喊完成,却不能自己批准完成
另一种把长任务拆成管理、执行、审计三段,模型和执行工具都不动,只改外面那层循环,几个基准上的成功率就明显往上走
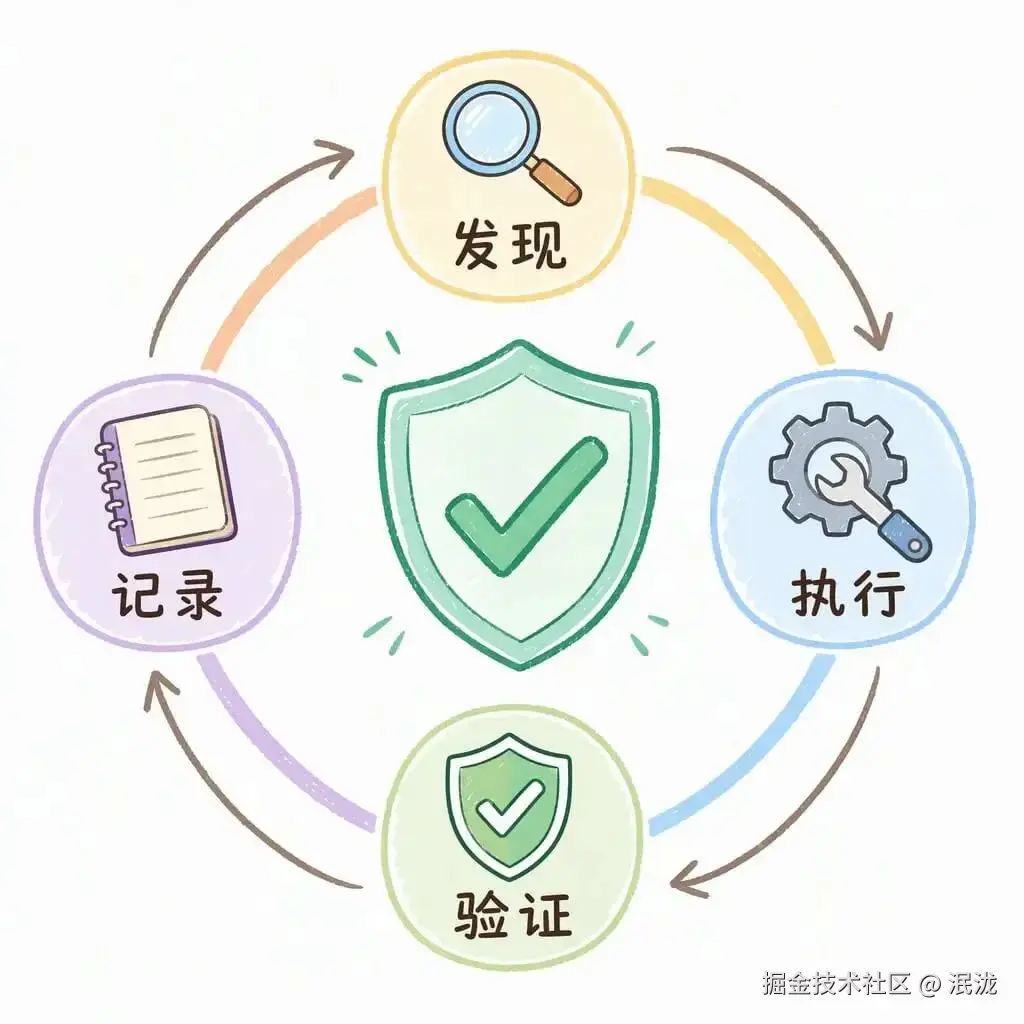 发现,执行,验证,记录,验证才是那个真正决定能不能停的关口
更靠谱的验证,是找个人拿证据来挑刺
最管用的形式,叫提议者跟审核者
道理很朴素,作者写完稿,不能自己当编辑
得另找一个人,拿着证据来挑刺,测试跑出来的结果,渲染出来的截图,一轮轮改到过关
有人问,为什么不干脆让一个 AI 自己生成再自己审
我试过,也看过实验,让 AI 在没有任何外部反馈的情况下做自我批评,准确率不升反降,它把对的改错,比把错的改对还多
原因不难想,没有新信息的审查,只是让模型把同样的话再想一遍
这套循环有条底线,审核的人看的是独立证据,不是复述提议者的解释
要退回,也得说清楚具体改哪里
还有一点容易漏,审核的人不能自己去改考题、改及格线,一旦能改,独立验证就成了自我批准
还有几副牌,各有各的脾气
除了提议者跟审核者,对等协作还有几种玩法
辩论,让几个 AI 分饰正反方互相反驳,听着聪明,争议却不小,把思考量拉平之后,单个 AI 常常不输,因为双方对着的是同一份信息,传话只会丢东西,不会凭空长出新的
头脑风暴,各自出点子,再互相点燃,碰出一个人想不到的组合
专家小组,每个 AI 代表一个专业视角,互补着拼出全貌
说句实在话
对等协作最值钱的一句话是,想让协作真正加出价值,就得让审查这件事引入新东西
做不到,你只是多花了钱,让同一段内容被多看了几遍
如果任务复杂到有几十个子任务还彼此牵连,平级互审就顶不住了,该请一个组长出面
下一篇,我想聊聊管理者模式