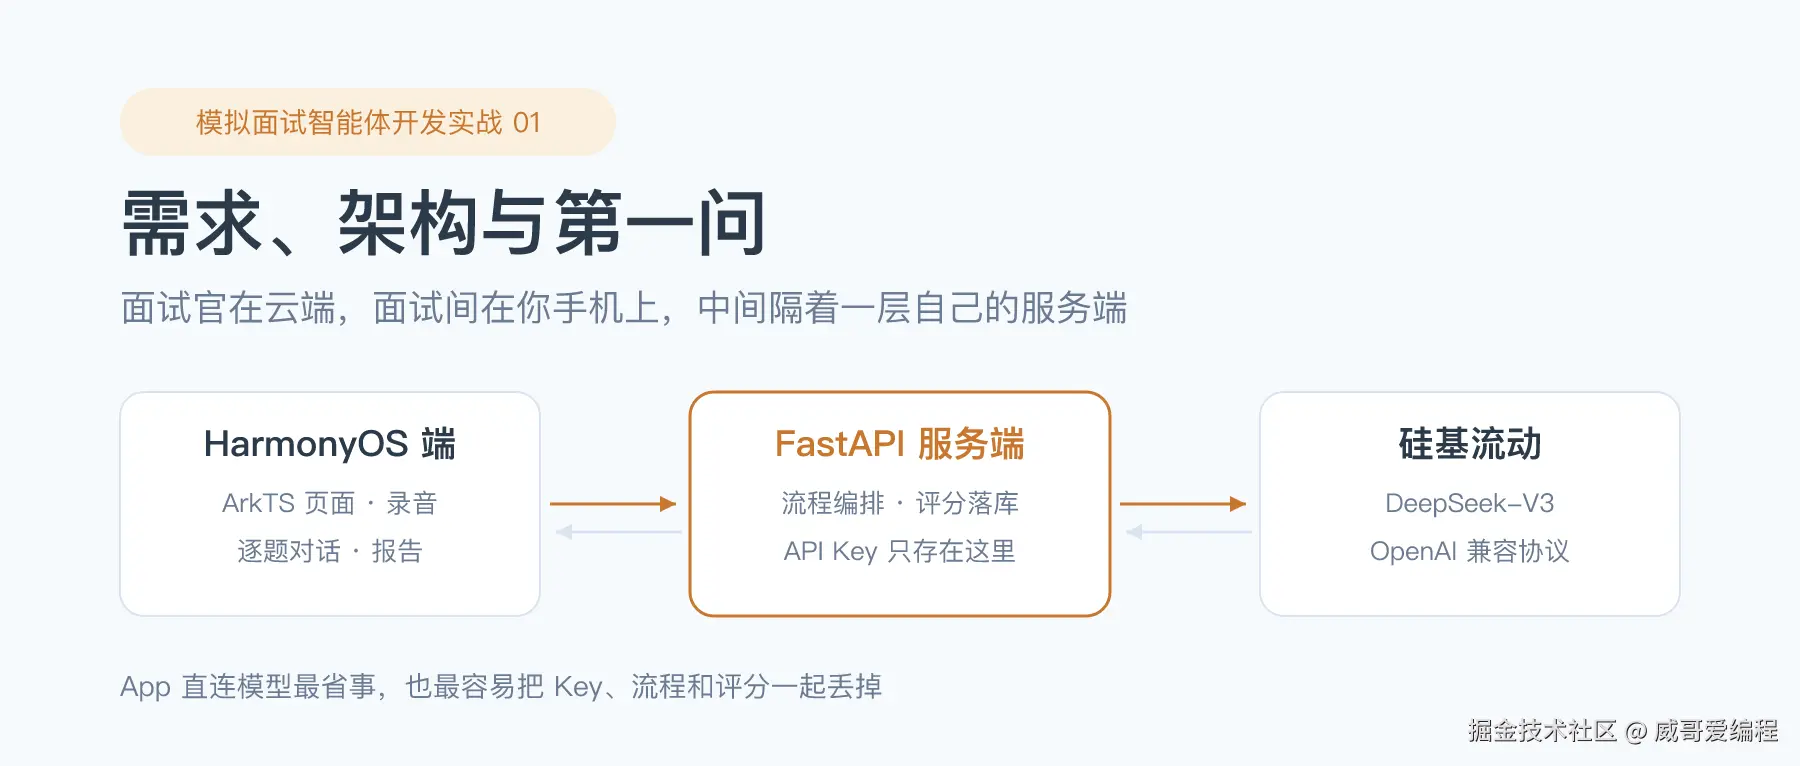
上个月我帮朋友复盘一场挂掉的面试。我问他被问了什么,他答"Redis 缓存";我问他面试官追问了什么,他答"好像是击穿还是穿透来着,我答岔了";我问他面试官当时是什么表情,他说没注意,光顾着紧张了。
这场面试就此变成了一团浆糊。他不知道自己哪句话暴露了知识盲区,不知道哪个回答其实答对了但表达太烂,更不知道下一场该补哪里。他手里唯一的复盘材料,是事后凭记忆敲的一段三百字感想。
这件事我太熟了,因为我自己也这么挂过。背八股的时候信心满满,真上场才发现八股是题目列表,而面试官要的是对话------你答一句,他顺着你的话再挖一层,挖到你露馅为止。这种"接招"的能力,背题背不出来,只能练。
练的成本却是离谱的:真人模拟面试一小时几百块,还得约时间;找朋友帮忙,人家不好意思往死里追问;自己对着镜子练,练完连个评分都没有。
所以有了这个系列。目标是一个能装进 HarmonyOS 手机里的模拟面试官:随时开一场针对性面试,面完拿到逐题点评和综合报告,清楚地知道自己挂在哪。整个系列 12 篇,这篇只做一件事------把地基打对。
一、先扫盲:面试官拆开是五块能力
动手写代码之前,我先把"模拟面试官"这个词拆开。它不是一个 prompt,是五块能力拼在一起:
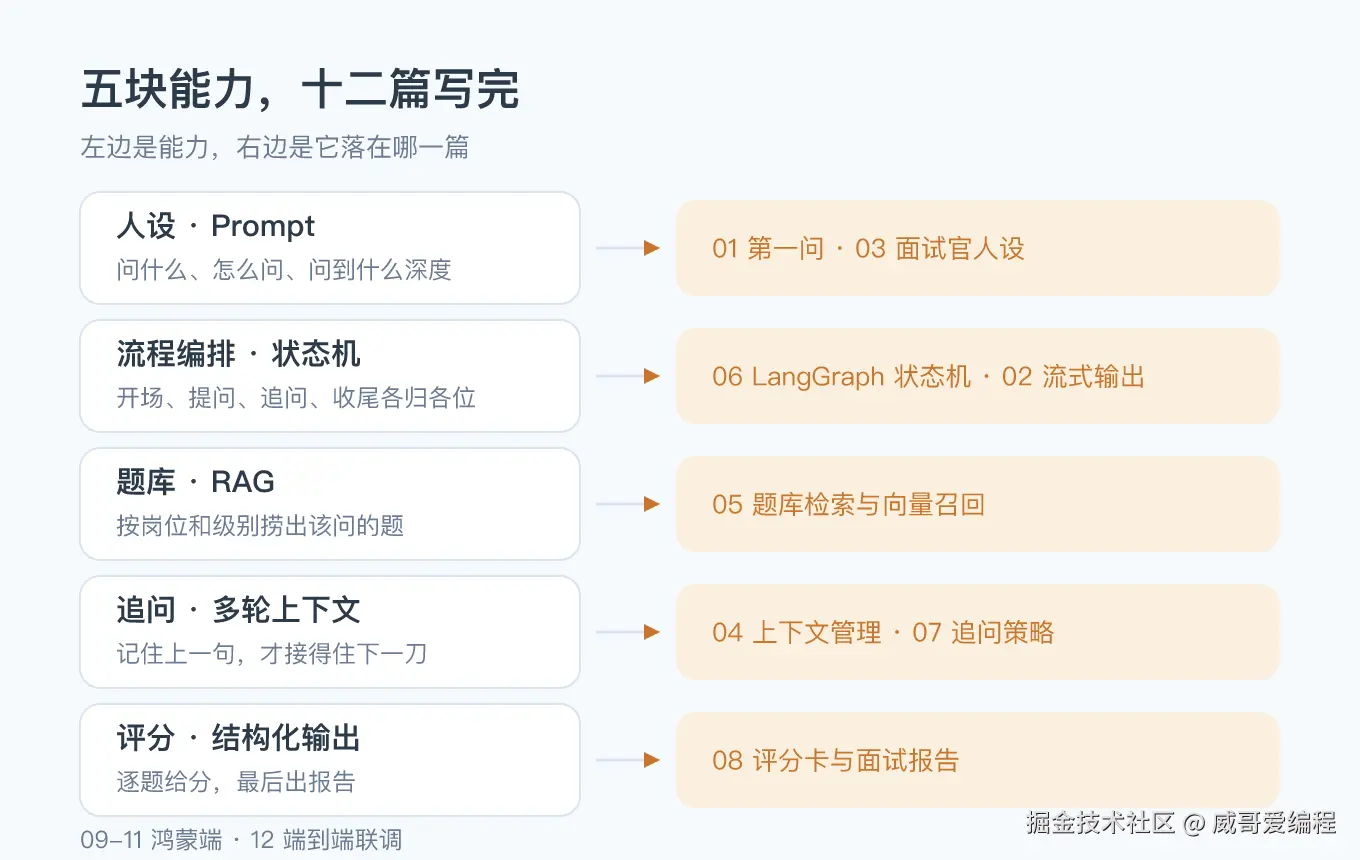
- 人设(Prompt):面试官问什么、怎么问、追问到什么深度。这是模型的行为说明书。
- 流程编排(状态机):一场面试有开场、出题、追问、收尾,每个阶段该干什么不能靠模型自觉。
- 题库(RAG):按岗位和级别捞出该问的题,而不是让模型每次现编------现编的题目质量像抽卡。
- 追问(多轮上下文):记住候选人上一句说了什么,才能接得住下一刀。没有上下文管理,追问就是每次重新开始。
- 评分(结构化输出):逐题给分、给理由,最后汇总成报告。评分必须是程序能解析的结构,而不是一段抒情散文。
有人会问:能不能一个 prompt 全搞定?写一段"你是资深面试官,负责出题、追问、评分",一次调用全返回?我一开始真这么试过,结论是三个死法:
**上下文先死。**一场面试十几轮对话,全部塞在同一个窗口里,模型要同时记得流程走到哪、刚才问了什么、候选人是怎么答的。轮数一多,前面的话被挤掉,面试官开始重复提问或者忘掉你答过的内容。
**评分跟着死。**出题和评分对模型是两种任务:出题要发散,评分要收敛。混在一次调用里,评分就成了"我觉得你答得还不错"------这不是评分,是客套。
**流程也死。**你无法在 prompt 里可靠地表达"追问最多两次,之后必须换题"。这种规则写在代码的状态机里是确定性的,写进 prompt 里就是祈祷。
所以这一篇开始,我们把这些能力一层一层搭出来,每层都能单独测试。这也是我给整个系列排的路线:01 打底子,02-08 把后端五块能力做完,09-11 上鸿蒙端,12 端到端联调。
二、总体架构:为什么中间要加一层自己的服务端
架构图里的三个方块,每个都有人想砍掉,尤其是中间那个。
HarmonyOS 端负责体验:开面试、说话、看报告。模型用硅基流动上的 DeepSeek-V3------它提供 OpenAI 兼容协议,base_url 填 https://api.siliconflow.cn/v1,用 langchain-openai 的 ChatOpenAI 就能直连,这个组合我已经冒烟测过。
那为什么不让 App 直接调模型?三个原因,每一个都够写一篇文章:
**密钥安全。**API Key 一旦打进 App 包体,等于公开。反编译拿 Key、拿去刷用量,都是几分钟的事。Key 只放服务端,App 端永远见不到它------这一篇的配置设计就是围绕这条做的。
**流程控制。**面试不是一问一答,是状态流转:什么时候追问、什么时候换题、什么时候收尾出分。这些逻辑放在 App 里,服务端就成了摆设;放在服务端,鸿蒙端只管渲染,后面换流程、换模型都不用发版。
**评分落库。**面试报告要存下来,用户下周还要回来看"上次挂在哪"。数据在服务端,App 端只拉结果,换手机也不丢。
代价是你要多维护一个服务。但这个"多"是值得的------从下一篇起我们就把它写出来。
三、工程搭建:先把地基浇好
本篇的工程目录长这样:
bash
01-需求与架构/
├── src/
│   ├── settings.py   # 配置:读 .env、校验、Key 脱敏
│   ├── llm.py        # 模型工厂:三条通路
│   └── prompts.py    # 最简面试官人设 + 第一问模板
├── tests/            # 33 个用例,离线全绿
├── demo.py
├── pytest.ini
├── requirements.txt
├── .env.example
└── .gitignore
环境三步走:
bash
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
配置文件从模板复制:
bash
cp .env.example .env.env.example 一共三行,我把它叫做"三件套":
ini
LLM_API_KEY=sk-你的密钥
LLM_BASE_URL=https://api.siliconflow.cn/v1
LLM_MODEL=deepseek-ai/DeepSeek-V3
这里有一条我给自己定的铁律:**真实 Key 不出现在任何文件里。**示例文件里写占位符,文章里的演示输出凡是涉及 Key 一律打成 sk-****,.gitignore 里把 .env 拦住。泄露 Key 的代价是真金白银,这条不值得赌。
requirements.txt 现在还很瘦:langchain-openai、pydantic-settings、pytest,加上后面要用的 fastapi、langgraph。先都装上,省得第二篇再动环境。
四、settings.py:把"配置"从字符串变成会自检的对象
配置层是整个系列最不会被夸、但被踩最多的一层。我用 pydantic-settings 来写,因为它把"读文件、类型转换、默认值、校验"四件事一次做完。
python
class Settings(BaseSettings):
    """一份只读的配置快照。"""

    model_config = SettingsConfigDict(
        env_file=DEFAULT_ENV_FILE,
        env_file_encoding="utf-8",
        extra="ignore",        # .env 里多写的无关变量不该让程序崩
        populate_by_name=True,
    )

    # alias 就是 .env 里那一行的键名
    llm_api_key: str = Field(default="", alias="LLM_API_KEY")
    llm_base_url: str = Field(default=DEFAULT_BASE_URL, alias="LLM_BASE_URL")
    llm_model: str = Field(default=DEFAULT_MODEL, alias="LLM_MODEL")
字段定义只是骨架,真正的价值在三个校验器里。第一个管地址:
python
@field_validator("llm_base_url")
@classmethod
def _check_base_url(cls, value: str) -> str:
    value = value.strip().rstrip("/")  # 吃掉手滑多写的结尾斜杠

    if not value.endswith("/v1"):
        raise ValueError(
            f"LLM_BASE_URL 缺少 /v1 后缀,当前是 {value!r}。\n"
            f"正确写法:{DEFAULT_BASE_URL}\n"
            "注意别写成 .../v1/chat/completions ------ SDK 会自己拼这一段。"
        )
    return value
为什么盯着 /v1 不放?因为这是我真正摔过的跟头:SDK 会在 base_url 后面自己拼 /chat/completions,你少写一段它就 404,而 404 的报错文本只会说"Not Found",不会告诉你少的是哪一段。既然我能预判这个错误,就该让它在启动时报出来,并且报得能照着改。
第二个校验器管 Key,处理一个特别阴险的场景:用户把 .env.example 直接复制成 .env,忘了改 Key。
python
PLACEHOLDER_KEYS = {"sk-你的密钥", "sk-xxx", "sk-xxxx", ...}

@field_validator("llm_api_key")
@classmethod
def _clean_api_key(cls, value: str) -> str:
    value = value.strip()
    if value in PLACEHOLDER_KEYS:
        return ""        # 占位符当没配,走"教用户配 Key"的分支
    if value and not value.startswith("sk-"):
        raise ValueError(...)  # 明显不是 Key 的值,提前拦,别等 401
    return value
如果不做这一步,程序会拿着"sk-你的密钥"这串中文去请求硅基流动,收到一个 401,用户盯着报错怀疑人生。现在它会被当成"没配",落到下一篇要讲的报错分支里,得到一段手把手的教学。
第三个是脱敏函数。任何要打印、要写日志、要截图发群的场合,Key 都必须先过它:
python
def mask_key(key: str) -> str:
    """sk-abc...xyz → sk-****xyz。前缀认类型,尾巴对账号。"""
    if not key:
        return "(未配置)"

    prefix = "sk-" if key.startswith("sk-") else ""
    if len(key) <= len(prefix) + 4:
        return "****"    # 短到只剩几位,连尾巴也不露

    return f"{prefix}****{key[-3:]}"
为什么留尾巴?因为排查"是不是配错了 Key"的时候,看最后三位能跟控制台里那一把对上号------能定位问题,又交不出整把钥匙。
五、llm.py:一个工厂,三条通路
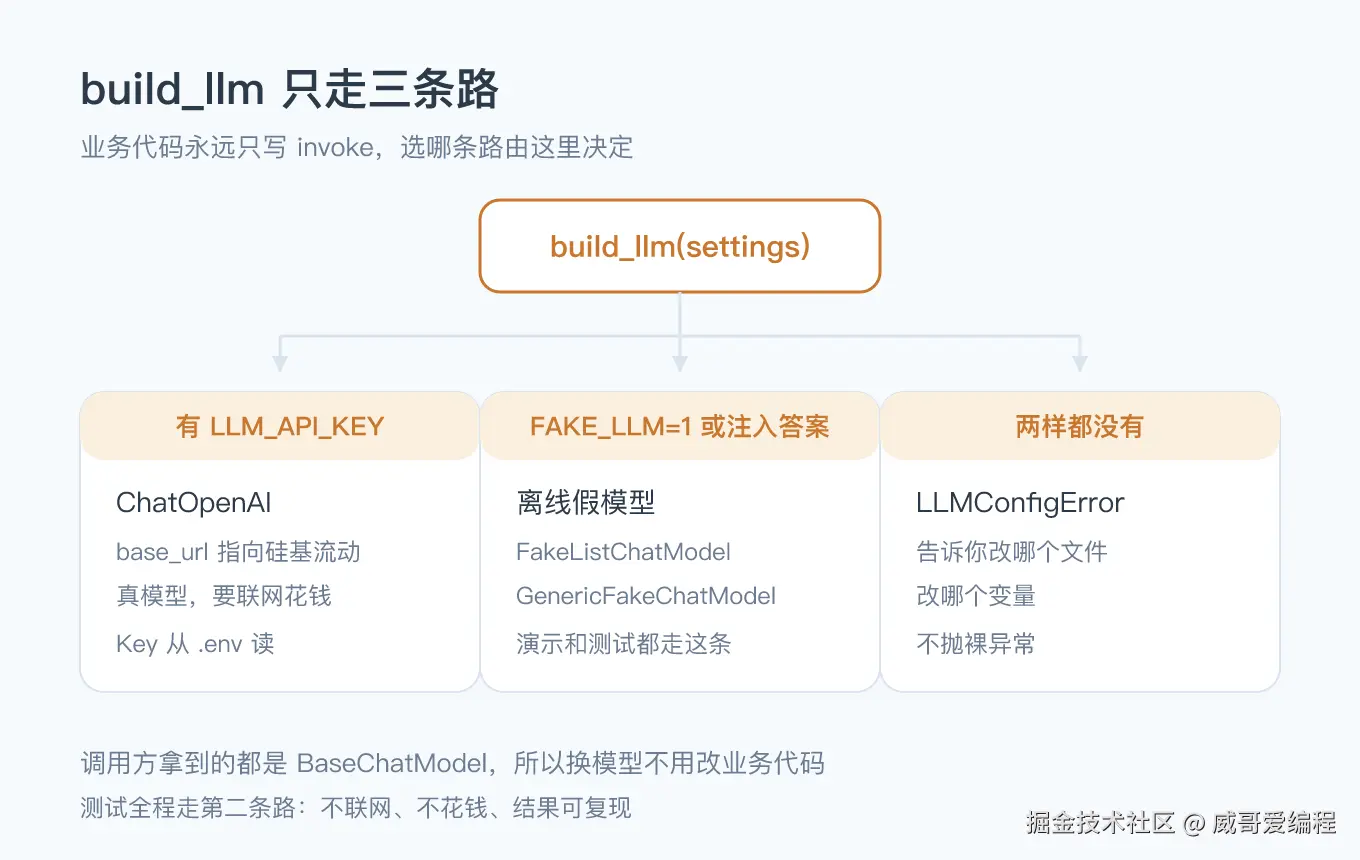
模型层我只写一个 build_llm(),它按三条通路返回模型:
python
def build_llm(
    settings: Settings,
    *,
    temperature: float = DEFAULT_TEMPERATURE,
    timeout: int = DEFAULT_TIMEOUT,
    offline_responses: Sequence[str] | None = None,
    fake_mode: bool | None = None,
) -> BaseChatModel:
    # 通路一:调用方直接把答案递进来,测试用,答案 100% 可控
    if offline_responses is not None:
        return FakeListChatModel(responses=list(offline_responses))

    if fake_mode is None:
        fake_mode = fake_mode_enabled()   # 看环境变量 FAKE_LLM

    # 通路二:明确要求离线,返回照剧本念台词的假模型
    if fake_mode:
        return GenericFakeChatModel(
            messages=cycle(AIMessage(content=line) for line in FAKE_SCRIPT)
        )

    # 通路三:没 Key 又不肯离线,把话说清楚
    if not settings.has_key:
        raise LLMConfigError(_missing_key_message(settings))

    return ChatOpenAI(
        model=settings.llm_model,
        base_url=settings.llm_base_url,
        api_key=settings.llm_api_key,
        temperature=temperature,
        timeout=timeout,
        max_retries=2,
    )
几个设计决定值得单独说。
**返回类型写 BaseChatModel 而不是 ChatOpenAI。**这是面向接口编程:调用方只需要 .invoke() 能用,不会因为"背后是真是假"写出两套代码。整个系列后面换模型、加缓存、做降级,动的地方只有这个工厂。
两个假模型各干各的。 FakeListChatModel 按列表顺序背台词,测试里预置什么就返回什么,断言可以写死;GenericFakeChatModel 接一个消息迭代器,我给它套了个 cycle,让它永远念不完------不然第二次 invoke 就抛 StopIteration,多轮对话测试直接翻车。
**没 Key 的报错必须能照着做。**这是我给报错文案定的硬标准,成品长这样:
ini
没有读到 LLM_API_KEY,连不上硅基流动。

三步解决:
  1. 复制配置模板:cp .env.example .env
  2. 打开 .env,把 LLM_API_KEY=sk-你的密钥 换成你自己的 Key
     (在硅基流动控制台的「API 密钥」页创建,Key 以 sk- 开头)
  3. 保存后重新运行

如果只想先跑通流程、暂时不想花钱:
  FAKE_LLM=1 python demo.py

当前读到的配置:
LLM_BASE_URL = https://api.siliconflow.cn/v1
LLM_MODEL    = deepseek-ai/DeepSeek-V3
LLM_API_KEY  = (未配置)
我还给它单独定义了 LLMConfigError 异常类,而不是抛裸 RuntimeError。上层以后要区分"没配 Key"和"网络超时":前者该提示用户改配置,后者该重试。异常类型就是给上层留的分类接口。
六、最简人设与 demo:跑出第一问
prompts.py 这一篇只做最简版------一段人设加一个模板,后面几篇会往里加考官风格、题库检索和结构化输出。
python
SYSTEM_PROMPT = """你是「码上」的资深技术面试官,负责面程序员岗位。
规矩:
1. 一次只问一个问题,问完就停,等候选人回答,不要自问自答
2. 问题要落到具体技术点上,别问"你最大的缺点是什么"这种空话
3. 候选人卡住时给一句方向性提示,不给完整答案
4. 语气正常,别客套,别夸人
"""写人设的原则跟写代码一样:能验证的约束才有意义。"你是一个专业的面试官"这种话,模型听了等于没听;"一次只问一个问题""卡住时给提示不给答案",才是下一轮能拿假模型和真模型分别检验的行为。
demo.py 把三件事串起来:读配置、拼消息、invoke 一次。
python
def run(settings: Settings | None = None) -> str:
    settings = settings or load_settings()

    # 没 Key 就自动离线,但必须明说,不能让人以为自己在调真模型
    offline = not settings.has_key
    llm = build_llm(settings, fake_mode=offline)

    prompt = build_first_question_prompt()
    messages = prompt.format_messages(job=JOB, level=LEVEL)

    print("──────── 真正发给模型的消息 ────────")
    for message in messages:
        print(f"[{type(message).__name__}] {message.content}")

    answer = llm.invoke(messages)
return str(answer.content).strip()有个细节:run() 单独抽成函数而不是全写在 main() 里,是为了让测试直接调它拿返回值,不用去抓标准输出。现在看着是多此一举,第 2 篇把 demo 变成 FastAPI 服务的时候,你会感谢这个形状。
七、真实运行输出
跑 python demo.py(没配 Key,自动走离线假模型):
ini
──────── 配置 ────────
LLM_BASE_URL = https://api.siliconflow.cn/v1
LLM_MODEL    = deepseek-ai/DeepSeek-V3
LLM_API_KEY  = (未配置)
本次使用的模型:离线假模型 · 照剧本念面试官台词
没读到 LLM_API_KEY,本次走离线假模型:不联网、不花钱、答案固定。

──────── 真正发给模型的消息 ────────
[SystemMessage] 你是「码上」的资深技术面试官,负责面程序员岗位。
规矩:
1. 一次只问一个问题,问完就停,等候选人回答,不要自问自答
2. 问题要落到具体技术点上,别问"你最大的缺点是什么"这种空话
3. 候选人卡住时给一句方向性提示,不给完整答案
4. 语气正常,别客套,别夸人

[HumanMessage] 应聘岗位:Python 后端开发工程师
候选人级别:中级(3 年经验)
现在面试开始,请直接问第一个问题,不要自我介绍、不要解释流程。

──────── 面试官第一问 ────────
你好,我是今天的技术面试官。先做个自我介绍吧,重点讲一个你最近做的项目,以及你自己负责的那部分。

接真实模型只需配好 .env,代码一行不改。
注意最后那行的意思:假模型吐出来的第一问是预置剧本,形状却和真模型一模一样。等你把 .env 里的 Key 配上,python demo.py 连的就是 DeepSeek-V3,src/ 下面的代码一个字不用动------这正是三通路设计的意义。
八、测试:33 个用例守着三条通路
配置层和模型层是全系列复用最多的代码,必须让测试看着。跑 python -m pytest -q:
erlang
.............................
33 passed in 14.10s
展开看明细(测试过程中 demo 会打印自己的输出,这里只摘用例行):
arduino
tests/test_settings.py::test_defaults_point_to_siliconflow PASSED
tests/test_settings.py::test_env_var_overrides_default PASSED
tests/test_settings.py::test_env_file_is_loaded PASSED
tests/test_settings.py::test_mask_key_keeps_prefix_and_tail PASSED
tests/test_settings.py::test_mask_key_empty PASSED
tests/test_settings.py::test_mask_key_short_key_shows_nothing PASSED
tests/test_settings.py::test_mask_key_without_prefix PASSED
tests/test_settings.py::test_base_url_must_end_with_v1 PASSED
tests/test_settings.py::test_base_url_must_be_http PASSED
tests/test_settings.py::test_base_url_trailing_slash_is_normalized PASSED
tests/test_settings.py::test_placeholder_key_counts_as_missing PASSED
tests/test_settings.py::test_non_sk_key_is_rejected PASSED
tests/test_settings.py::test_empty_model_is_rejected PASSED
tests/test_settings.py::test_model_with_space_is_rejected PASSED
tests/test_llm.py::test_key_present_builds_chat_openai PASSED
tests/test_llm.py::test_temperature_reaches_the_model PASSED
tests/test_llm.py::test_missing_key_raises_actionable_error PASSED
tests/test_llm.py::test_error_is_not_a_bare_exception PASSED
tests/test_llm.py::test_offline_responses_take_the_first_path PASSED
tests/test_llm.py::test_fake_env_switch PASSED
tests/test_llm.py::test_fake_env_accepts_true PASSED
tests/test_llm.py::test_fake_script_never_runs_out PASSED
tests/test_llm.py::test_explicit_fake_mode_beats_env PASSED
tests/test_llm.py::test_describe_llm_tells_you_which_one PASSED
tests/test_demo.py::test_prompt_has_system_and_human PASSED
tests/test_demo.py::test_prompt_carries_job_and_level PASSED
tests/test_demo.py::test_prompt_rules_are_in_system PASSED
tests/test_demo.py::test_missing_variable_raises PASSED
tests/test_demo.py::test_demo_runs_offline_and_returns_question PASSED
tests/test_demo.py::test_demo_prints_what_it_sends PASSED
tests/test_demo.py::test_demo_says_it_is_offline PASSED
tests/test_demo.py::test_nothing_leaks_a_full_key PASSED
全部离线,没有一个用例联网,也没花一分钱。三条我最想让你看到的:
test_key_present_builds_chat_openai------有 Key 的通路照样离线可测。构造 ChatOpenAI 对象只是把参数装进一个 pydantic 模型,不发请求,所以"真模型通路"的参数对不对也能断言。
test_nothing_leaks_a_full_key------整条链路的输出里不许出现完整 Key。这条测试用的是"间谍"手法:把 build_llm 换成一个记下参数、返回假模型的替身,不然用例自己就联网了。
test_missing_key_raises_actionable_error------报错文案里必须同时出现"改哪个文件"和"改哪个变量",还要给出 FAKE_LLM=1 这条不花钱的退路。报错写得能不能照着做,是有测试兜底的,不是靠自觉。
九、踩坑清单
base_url少写/v1,请求全 404 。硅基流动的 OpenAI 兼容入口是https://api.siliconflow.cn/v1,SDK 在后面自己拼/chat/completions。写成/v1/chat/completions会拼重复,写成裸域名会 404。现在校验器在启动时就骂人,比线上 404 强多了。- 直接把
.env.example复制成.env忘了改 Key,程序拿着"sk-你的密钥"去请求,收到一个莫名其妙的 401。校验器认出占位符、当作没配,落到教学报错里。 - 假模型的台词会用完 。
GenericFakeChatModel吃一个迭代器,多轮对话测试跑到第二轮就StopIteration。套一个itertools.cycle解决,代价是剧本会循环,测试断言要挑不会撞车的轮次。 - pytest 一启动就被系统杀掉,连报错都没有 。排查了一圈,是断言重写钩子在本机安全策略下被直接 SIGKILL,
pytest.ini里加--assert=plain关掉重写才活过来。正常机器上可以删掉这一项,删了断言失败时的 diff 更详细。另外 LangChain 顺带装上的 langsmith pytest 插件对这个项目毫无用处,我用-p no:langsmith_plugin关掉了。 - 测试用
tmp_path造临时文件也会被安全策略拦 (FileExistsError)。改成仓库里放一个tests/fixtures/sample.env固定夹具,反而更直观:打开就知道"一份能用的配置长什么样"。 - demo 的输出必须明说自己在离线。我最初忘了打印"离线假模型"的提示,自己都差点把预置答案当成模型回答------人对着终端里的整齐输出,默认它会是真的。
十、本篇收尾
这一篇没有炫技,做的事很朴素:把需求拆成五块能力,把架构定成"App + 自己的服务端 + 模型 API",然后把配置层、模型工厂、最简人设立起来,33 个离线测试守着。地基的特点就是不起眼,但后面 11 篇全部盖在它上面------第 2 篇你就会看到 build_llm 被 FastAPI 直接拿去用,一行不用改。
下一篇:FastAPI 服务端与流式输出。面试官的回答要一个字一个字往外蹦才有"面试感",我们会把 demo 变成一个真正能被鸿蒙端调用的 HTTP 服务,顺便讲清 SSE 流式输出在 LangChain 和 FastAPI 两头分别怎么接。
最后一句:面试最贵的是复盘,而复盘恰恰是机器最擅长的事------你的第一次模拟面试,值得从一条能跑通的链路开始。