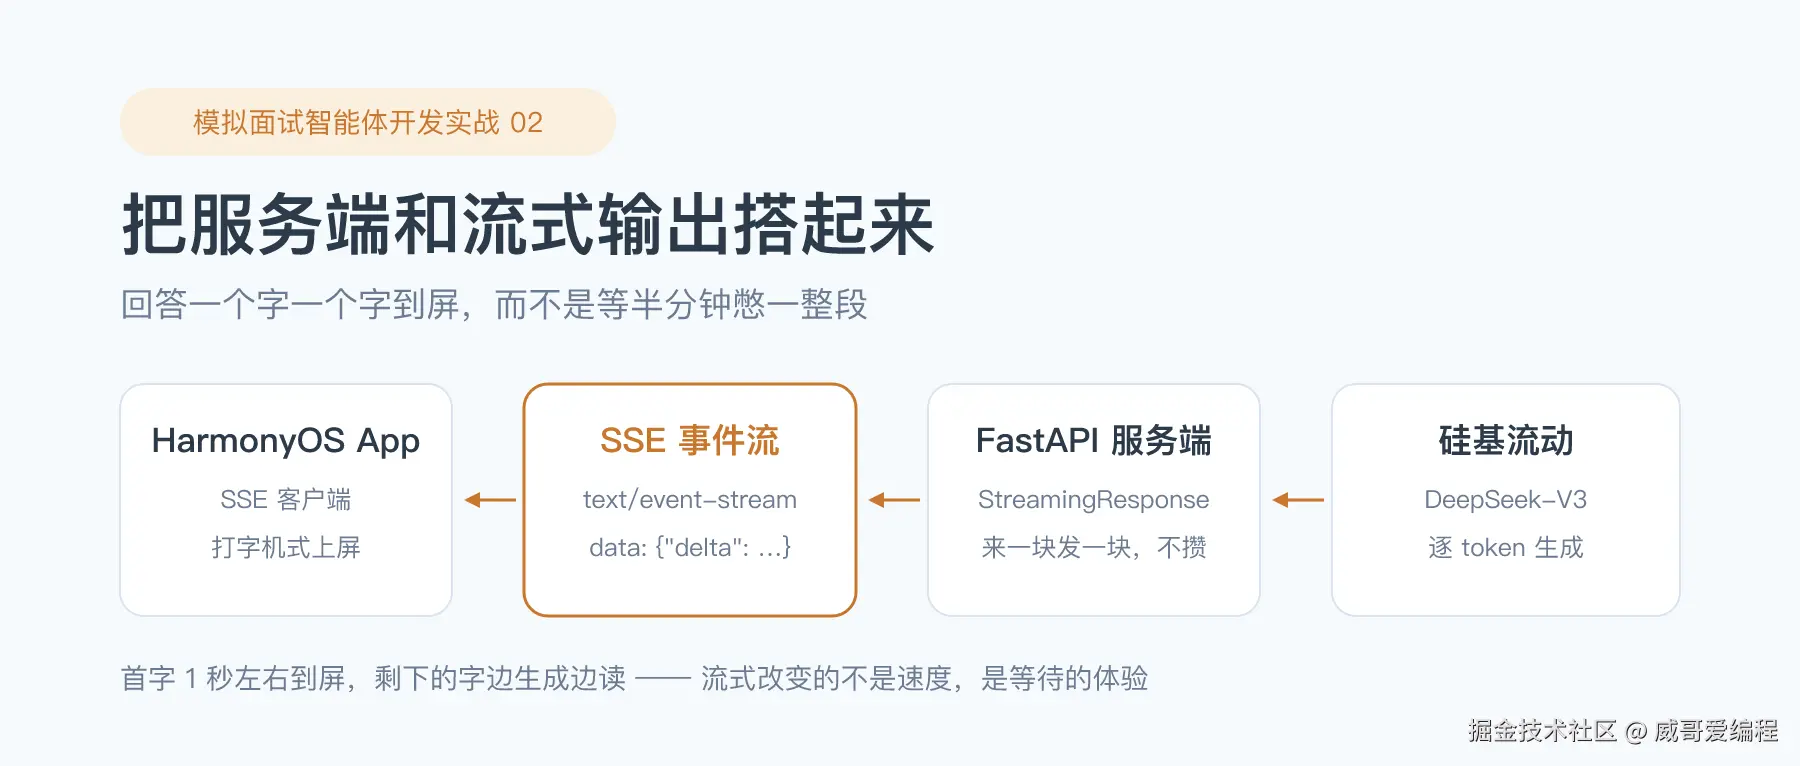
上一讲我们把工程骨架和 build_llm 三通路搭好了,能离线问出面试官的第一句话。但那只是一个玩具------你敲一句、等程序跑完、才看到一整段答案。真要做成产品,这一步就得翻车:整段返回要等十几秒到半分钟,练面试的人耐心直接被磨没;哪怕忍住等了,用户一并发上来,服务端也容易挂。
这一篇我们把"服务端"真正搭起来,做三件事:用 FastAPI 把能力暴露成接口、把回答改成流式逐字上屏、给模型调用套上一层不裸崩的错误处理。做完之后,前端(后面几篇的鸿蒙 App)接的就不是一段 Python 脚本,而是一个能扛并发、会流式、出错说得清的服务。
一、先说痛点:整段返回的代价
我最早把模拟面试官做成脚本的时候,逻辑特别直白:reply = llm.invoke(messages),把整段答案等出来再打印。自己玩没问题,给同事试了一圈,三个人说了同一个感受------"卡得心慌"。
卡不是错觉。DeepSeek-V3 回答一道中等难度的面试题,生成一两百字是很正常的,按每秒十几个 token 算,就是十几秒。这十几秒里,界面上什么都没有,用户只知道"程序在转圈"。更要命的是,这十几秒是首字延迟,不是总延迟:用户要的是"面试官开口了"那种即时感,不是"等半分钟给你一坨"。
第二个坑是并发。脚本只能一个人跑,服务起来之后,十个学生同时开面试,十个请求都卡在等模型返回,连接池瞬间占满,第十一个人直接连不上。这不是"优化一下"的问题,是架构就没考虑过"同时多个人"。
所以这一篇要解决的核心命题是:把"等半分钟"变成"逐字蹦",把"脚本"变成"服务"。
二、扫盲:流式、SSE,以及为什么不能让 App 直连大模型
流式输出是什么? 普通接口是"攒齐了再发":模型生成完最后一字,服务端才把整段 JSON 回给你。流式是"一边生成一边发":模型吐第一个字,服务端就发第一个字,用户端一个字一个字往上跳,像真人说话。
这背后通常是 SSE(Server-Sent Events)协议:服务端用 text/event-stream 这个 content-type,按 data: {...}\n\n 的格式一块一块推,客户端监听 onmessage 增量渲染。它和 WebSocket 的区别是单向(服务端→客户端),正好够用,还比 WebSocket 简单。
首字延迟 vs 总延迟是这里最关键的一对概念。总延迟两种方案一样(都是生成完一整段的时间),但首字延迟流式几乎为零------用户一秒不到就看到第一个字蹦出来,耐心就不慌了。
为什么非要自建服务端,不让手机 App 直连硅基流动? 我见过有人图省事让 App 直接调 api.siliconflow.cn,三个后果:
- 密钥裸奔。 API Key 打进 App 包里,反编译就能拿到,别人拿去刷你的额度。Key 必须留在服务端。
- 会话状态管不了。 面试要记"问到第几题、上一轮说了什么、最后要出报告",这些状态放 App 里既不安全又不好维护,放服务端才是正解。
- 评分和落库做不了。 后面第 7、8 篇的逐题点评、综合报告,都要在服务端把结构化结果存下来,App 直连大模型手里什么都留不住。
一句话:App 只负责"好看和好用",大脑和保险丝都在服务端。
三、工程目录:分层是为了"能测"
这一篇的工程长这样:
bash
code/02-服务端基座/
├── src/
│   ├── settings.py                # 配置:读 .env、校验、Key 脱敏
│   ├── llm.py                     # 模型工厂:真 Key / 离线假模型 / 没配 Key 三条通路
│   ├── schemas.py                 # 请求 / 响应结构(pydantic,前后端合同)
│   ├── app.py                     # FastAPI 应用工厂 create_app()
│   ├── server.py                  # 启动入口(uvicorn)
│   ├── routers/
│   │   └── chat.py                # HTTP 路由:/chat、/chat/stream
│   └── services/
│       └── interview_service.py   # 业务层:调模型、重试、流式生成
├── tests/                         # 69 个离线用例
├── demo.py                        # 离线演示:三个接口各跑一遍
├── pytest.ini
├── requirements.txt
├── README.md
└── .env.example分层的意义我得先讲明白,因为它决定了后面每一篇怎么写:routers 只管"收请求、调服务、吐格式",不碰业务规则;services 只认"一个 llm + 一份消息列表",不认 HTTP;llm 是工厂,别处不许自己 new 模型。最值钱的是 services 层不知道 HTTP 这件事------它能被单元测试直接调用,不用起服务、不用构造请求体。后面所有稳定性、状态机、评分的测试,都靠这一层能"裸跑"。
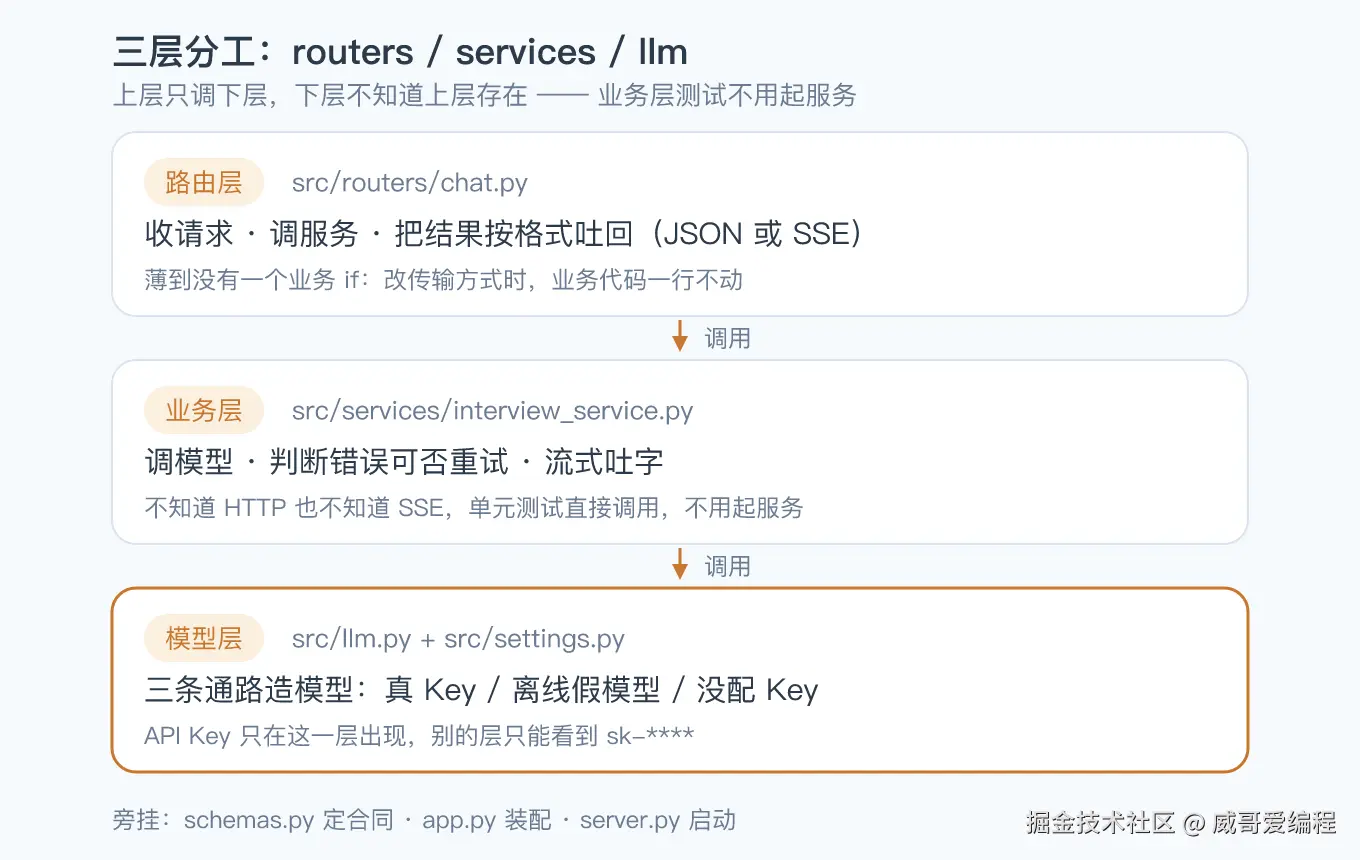
这张图是后面十一篇的骨架:越往下越"纯",越往上越"薄"。services 是承上启下的腰,它既能被路由调,也能被测试直接调;llm 永远只从工厂出,谁都不许绕过它。记住这个形状,后面加状态机、加评分、加题库,都是往 services 里塞东西,不动 routers 的薄。
四、配置集中一处:settings.py
第一讲我就把 build_llm 写好了,但配置散在三个模块里会出事。我把所有环境变量收进 settings.py 一个文件,别处一律拿 Settings 对象。
python
from dataclasses import dataclass
from dotenv import load_dotenv
import os

DEFAULT_BASE_URL = "https://api.siliconflow.cn/v1"   # 结尾必须带 /v1
DEFAULT_MODEL = "deepseek-ai/DeepSeek-V3"            # 模型名带厂商前缀
DEFAULT_TIMEOUT = 30.0                               # 一轮面试够用,太大=把卡住伪装成思考
DEFAULT_MAX_ATTEMPTS = 2                             # 1 次正常 + 1 次重试

def mask_key(key: str) -> str:
    """日志里只留一个"配没配"的信号,主体字符一个都不留。"""
    return "sk-****" if key else "(未配置)"
mask_key 是我踩过坑之后加的。有一次排查问题,同事把 Key 前 8 位打进了日志,那 8 位足够别人对着账号试。现在日志里永远只有 sk-****,要查"Key 读没读到",看这个就够。
Settings 在 __post_init__ 里做三件便宜但能挡掉 90% 翻车的检查------base_url 不像地址、超时不是正数、重试次数小于 1,启动就崩,绝不让它跑到线上才暴露。
五、模型工厂:llm.py 的三条通路
沿用第一讲的 build_llm,这一篇把"超时"和"SDK 自带重试"也规整进来。
python
def build_llm(settings, *, temperature=0.7, timeout=None, fake=False, fake_answer=None):
    effective_timeout = settings.timeout if timeout is None else timeout

    if fake or settings.fake_llm:              # 通路二:离线假模型
        return FakeInterviewChatModel(answer=fake_answer or DEFAULT_FAKE_ANSWER, chunk_size=2)

    if not settings.has_key:                   # 通路三:没配 Key,启动就报错
        raise LLMNotConfigured(
            "没有读到有效的 LLM_API_KEY,服务起不来。\n"
            "  1. cp .env.example .env 并填 LLM_API_KEY\n"
            "  2. 只想跑通链路:设置 FAKE_LLM=1\n"
            f"当前读到的是:{mask_hint(settings.api_key)}"
        )

    return ChatOpenAI(                          # 通路一:真模型,OpenAI 兼容
        model=settings.model, base_url=settings.base_url,
        api_key=settings.api_key, timeout=effective_timeout,
        max_retries=0,                          # SDK 重试关掉,重试统一交给 service 层
)这里有个我特意埋的点:SDK 的 max_retries 设成 0 。如果客户端和服务端都开重试,2 次会变成 4 次请求------你以为失败一次,账单记了四次。重试这件事,全系列只在 services 层做一处。
离线假模型 FakeInterviewChatModel 继承自 LangChain 的 BaseChatModel,invoke 和 stream 都实现了,行为跟真模型一致。它按 chunk_size=2 切块,比 FakeListChatModel 按字符流更接近真模型按 token 吐的节奏,演示时也能看清"分块"这件事。
六、前后端合同:schemas.py
请求和响应用 pydantic 框死,既是校验也是文档:
python
class Message(BaseModel):
    role: Literal["system", "user", "assistant"]
    content: str = Field(min_length=1, max_length=4000)  # 单条上限,防当免费存储

class ChatRequest(BaseModel):
    messages: list[Message] = Field(min_length=1, max_length=50)  # 够 20 轮,再多该上摘要了
    temperature: float | None = Field(default=None, ge=0.0, le=2.0)
content 的 min_length=1 看着多余,但我加了 _not_blank 校验:只填空格也算空,不拦的话模型会收到一条空白 user 消息,回一句莫名其妙的话。这种"看起来不会发生"的脏数据,真上线第二天就会出现。
七、业务层:services 决定"失败了怎么办"
这是全篇最该读透的一层。它干两件事:普通 reply(等全部)和流式 stream,以及失败处理。
python
RETRYABLE_HINTS = ("timeout", "timed out", "connection", "429", "500", "502", "503", "504", ...)

class InterviewService:
    def reply(self, messages, *, temperature=None) -> str:
        for attempt in range(1, self.max_attempts + 1):
            try:
                result = self.llm.invoke(messages, **self._kwargs(temperature))
                return str(result.content)
            except Exception as exc:
                if attempt >= self.max_attempts or not _is_retryable(exc):
                    break
                time.sleep(self.retry_sleep)     # 测试里传 0
        raise LLMUnavailable("模型暂时不可用,请稍后再点一次。")
_is_retryable 是判断"这个错值不值得重试"的核心:超时、连接错误、429、5xx 这些"过一会儿可能就好"的才重试;参数错、内容审核拒绝这种"重来一万次也错"的,立刻抛人话。绝不把 openai 的原始异常直接丢给 FastAPI------那样用户看到的是 500 加一坨栈,不如一句"请稍后再点一次"。
这里我特意用"异常文本里有没有关键词"而不是"异常类型"来判断,原因很现实:硅基流动返回的异常可能是 openai SDK 包出来的 APIStatusError,也可能是底层 httpx 的 ConnectError,类型五花八门,但文本里总会带上 timeout、429、rate limit 这些词。抓类型要维护一长串 import,抓文本一行 any(hint in text for hint in RETRYABLE_HINTS) 就够稳。代价是依赖文本,但这类异常的文本格式稳定得多的多,性价比更高。
流式那版有个硬约束我必须强调:已经吐出去的字收不回来。所以重试只在"一个 chunk 都没发"的时候发生;发了半句再断,重试会让用户看到"面试官说到一半突然从头再说一遍",比直接报错更糟。
八、流式路由:routers/chat.py 的 SSE
路由层薄到几乎没有业务逻辑,只负责把结果按 SSE 格式吐回去:
python
@router.post("/stream")
def chat_stream(req: ChatRequest, request: Request) -> StreamingResponse:
    def event_source():
        try:
            for delta in service.stream(messages, temperature=req.temperature):
                yield sse_event({"delta": delta})       # 逐块推
        except LLMUnavailable as exc:
            yield sse_event({"error": str(exc)})         # 流中途出错,在事件里补 error
        yield sse_event({"done": True})                  # 无论如何,最后补一条 done
    return StreamingResponse(event_source(), media_type="text/event-stream", headers=SSE_HEADERS)
sse_event 用 ensure_ascii=False 很重要------默认会把中文转成 \uXXXX,前端能解析,但你 curl 一眼看过去全是乱码,调试时想死。
{"done": true} 是整段代码的命门:不发它,前端就不知道这轮说完了 ,会一直等,或把超时误判成结束。还有一处反直觉的细节------我没用 finally。客户端断开时生成器被强制关闭,在 finally 里 yield 会触发 generator ignored GeneratorExit,所以把 done 放在 try 之后、显式 yield。
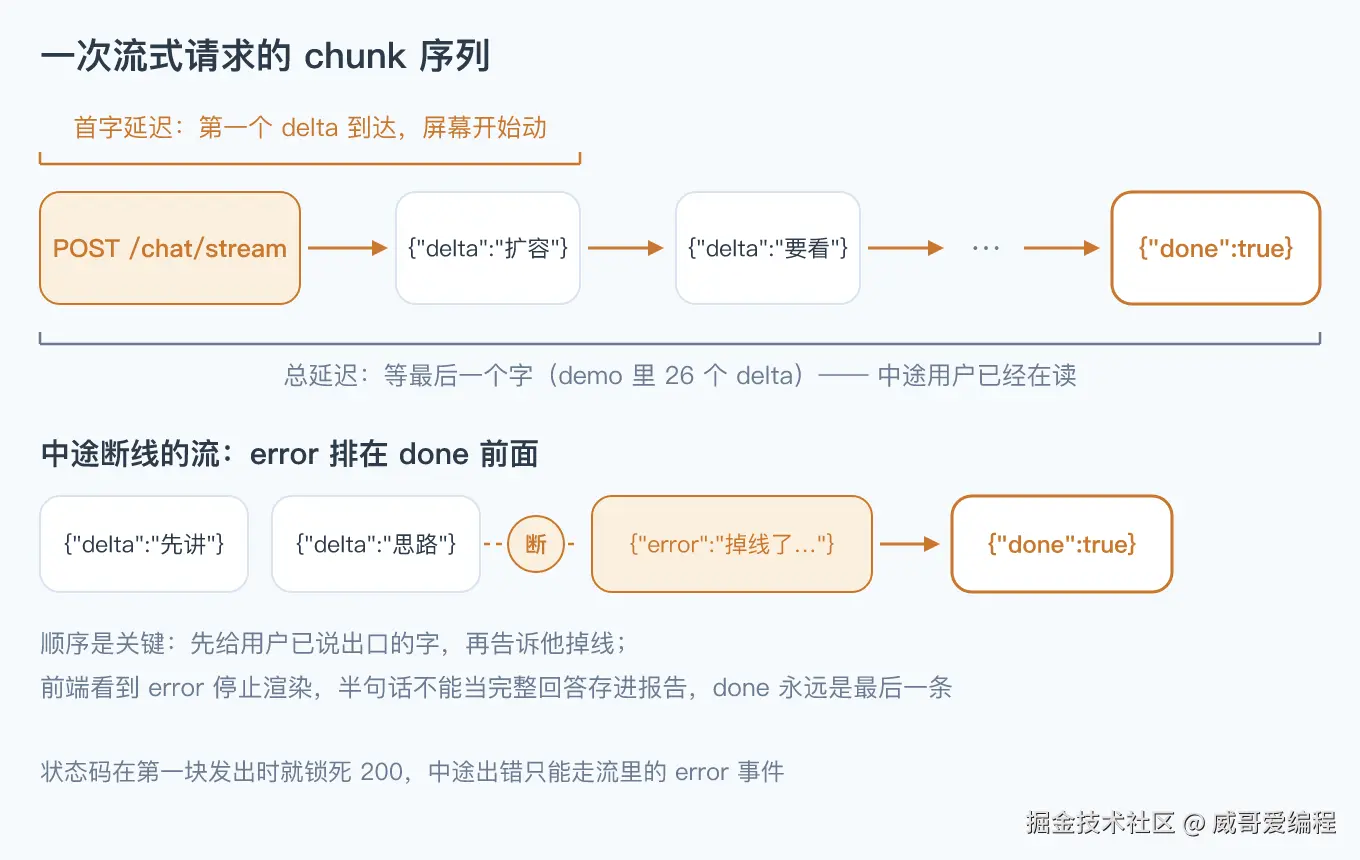
把时序图印在脑子里:客户端发一条请求,服务端不回整段,而是 delta 一块一块推,最后补 done。前端每收到一个 delta 就往屏幕上追加一个字,收到 done 就停。中途如果模型出错,服务端在事件流里塞一条 error,前端看到就停止渲染------这比等超时靠谱一百倍,因为超时意味着用户愣看半分钟空白。
九、应用工厂与启动:app.py / server.py
create_app(llm) 是工厂不是单例。测试传真模型、假模型都行,业务代码一份,靠依赖注入换模型 ,不用 monkeypatch、不用改环境变量。这是服务端最朴素也最值钱的写法。
/health 我故意不查数据库、不 ping 模型------健康检查必须毫秒级返回,一旦它自己去调 LLM,模型慢的时候整个集群会被判死。/health 返回不了模型就绪状态,反而成了"模型拖累健康"的事故源。
十、真实跑一遍:demo.py 输出
python demo.py(离线,不联网),三个接口各走一遍:
bash
〇、配置脱敏:真实模型 · deepseek-ai/DeepSeek-V3 · https://api.siliconflow.cn/v1 · key=sk-****

一、健康检查 GET /health
  200  {"status": "ok", "model": "fake-interview", "llm_ready": true}

二、普通回答 POST /chat
  回答:扩容要看两个数:阈值是容量乘负载因子,默认 0.75......

三、流式回答 POST /chat/stream
    data: {"delta": "扩容"} ... 共 26 个 delta 块 ...
    data: {"done": true}
  和整段回答一致:True

四、出错时返回什么(不返回 500)
  空消息列表 → 422  {"detail": [{"type": "too_short", ...}]}
  模型超时     → 503  {"code": "llm_unavailable", "detail": "模型暂时不可用,请稍后再点一次。"}
注意那个 sk-****------全程日志和报错里 Key 主体一个字符都不出现。
十一、真实 pytest 输出:69 个用例全绿
bash
tests/test_app.py      8 passed
tests/test_chat.py    21 passed
tests/test_health.py   5 passed
tests/test_llm.py     21 passed
tests/test_stream.py  14 passed
─────────────────────────
69 passed in 34.18s
覆盖到什么程度:三通路 build_llm 各分支、/health 毫秒返回、/chat 正常与 422、流式 chunk 序列与 done 收尾、超时参数真的传进模型、CORS 头、服务层异常不裸抛 500 而是可读错误。全部离线,不需要 Key、不联网。
十二、踩坑清单
base_url少写/v1:只写到api.siliconflow.cn,SDK 会去找/chat/completions而非/v1/chat/completions,报 404。现在放进DEFAULT_BASE_URL一处兜底。- 流式忘了发
done:前端无限等待或误判超时,这句比任何代码都重要。 - SSE 漏了
X-Accel-Buffering: no:过了 Nginx,流会被攒成一坨再发,"流式"名存实亡。 - 客户端和服务端都开重试 :2 次变 4 次,账单翻倍。SDK
max_retries=0,重试只留一处。 finally里yield:客户端断开触发GeneratorExit,日志刷一堆红字。改成显式收尾。- Key 打进日志 :前 8 位都够别人试,现在一律
sk-****。 - 重试判断靠异常类型 :硅基流动的异常包了好几层(SDK、httpx),抓类型要维护一长串 import,不如抓文本里的
timeout/429/rate limit,一行any(...)更稳。
十三、本篇收尾
现在你手里有一个能扛并发、会逐字上屏、出错说得清的服务端。但它还是个"只会聊天的壳"------面试官太客气、每次问同样的题、答错了只会说"没关系"。接下来三篇我们把它变成真正的考官:第 3 篇讲面试官人设(Prompt 工程),让 AI 像个真考官而不是客服;第 4 篇用状态机把整场面试编排起来;第 5 篇接上岗位题库和检索,每次都问得有针对性。
最后一句:服务端的本质不是"把模型包起来",而是"把模型的不可靠,变成用户能听懂的一句话"。