让 AI 写一个函数,我们已经知道该怎么配合。但如果任务变成"从空文件夹开始做一套操作系统",这真的是我从来没想过的,我对AI的印象还只是停留在协助我写代码,做简单的事情。
Anthropic 在 2026 年 11 月 9 日发布的 Claude Fable 5.2 和 Mythos 5.2,把这个问题推到了眼前。官方展示了一次实验:Fable 5.2 协调超过 1000 个子 Agent,持续工作 8 天,交付了一套能在笔记本电脑上启动的操作系统原型。
我更关心的是,这类能力会怎样改变我们组织开发工作的方式。
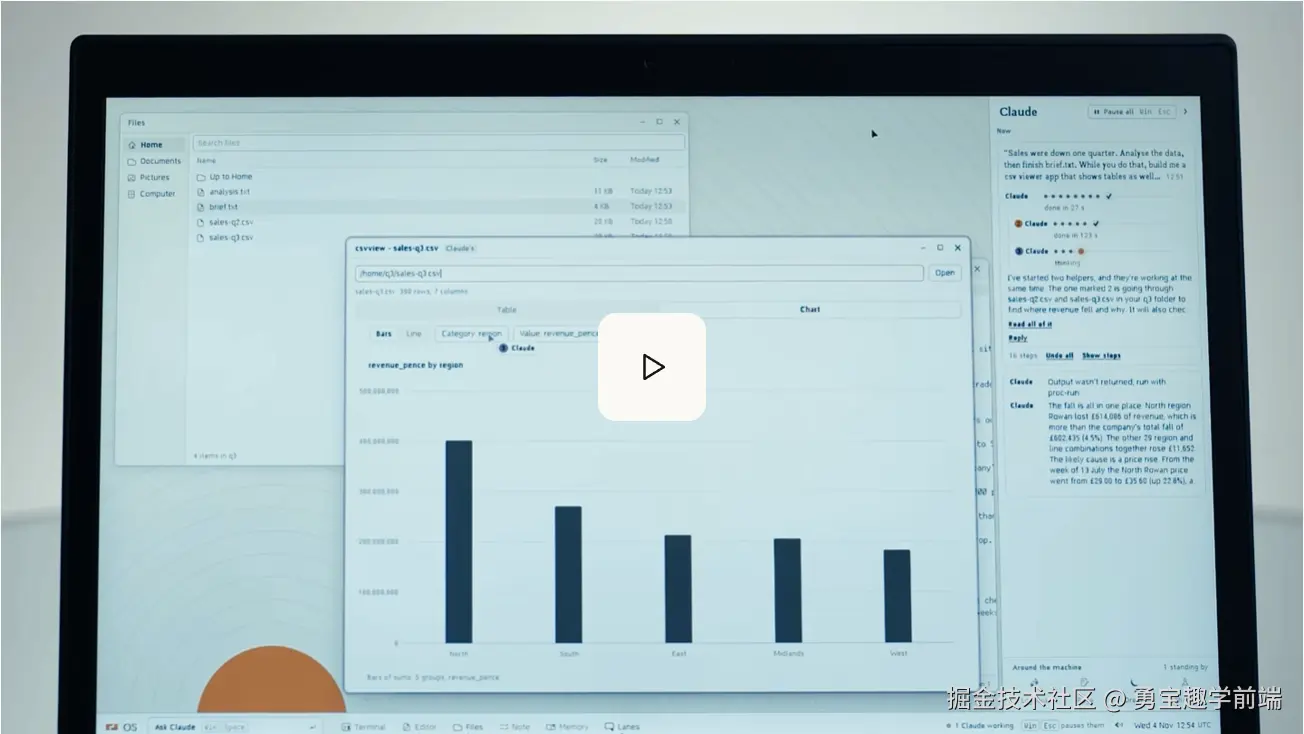
项目能跑多久,取决于反馈能否跟上
操作系统实验值得看,但"能启动的原型"和"可以长期维护的产品"之间,还有大量工程工作。一次演示能够证明某些环节走通了,无法替我们回答后续维护成本有多高。
对开发者来说,更有用的启发是:当 AI 可以持续执行较长时间,任务说明也需要跟着升级。
假设让 Agent 负责迁移一个旧模块,只告诉它"改成新框架",很难判断中途的进展是否可靠。如果提前给出必须保留的接口行为、可复现的运行环境,以及覆盖关键路径的验收用例,每次修改就有了明确的反馈。
这时,人要花心思的地方,会逐渐移向任务边界和验收条件。把目标说清楚,本身就是工程能力。
数学与硬件,提醒我们重视外部验证
另一个引人关注的案例,是 Fable 5.2 调度约 1000 个 Agent,用 30 小时完成费马大定理的形式化证明。费马大定理早已有数学证明,这次展示的是让证明进入 Lean 这样的形式化系统,接受计算机检查。
这个区别很重要。自然语言里的推导可能读起来顺畅,却漏掉关键条件;形式化检查提供了更明确的约束。当然,它检查的是形式化表达中的命题与推导,命题是否准确表达原本的问题,仍然值得关注。
硬件实验也有类似的启发。官方称,Fable 5.2 参与设计的三款电子设备经过制造和人工组装后全部正常工作,无须修改电路。
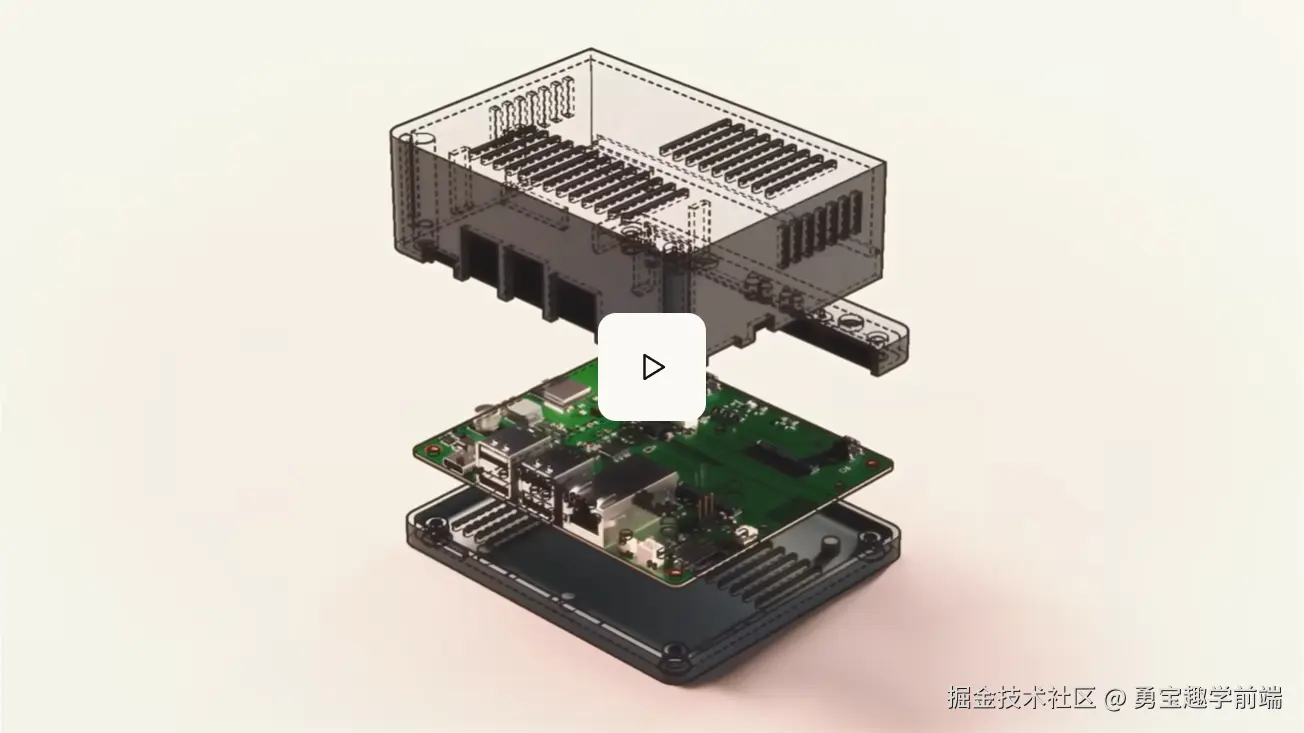
代码最终要通过什么来验收?在这些案例里,证明检查器和实际设备给出了模型回答之外的反馈。
日常开发也可以借鉴这个思路。让 AI 修一个故障时,先把复现步骤固定下来,再检查修改后故障是否消失。模型写出的解释可以帮助理解问题,可复现的结果才能支撑交付判断。
普通开发,不必每次都用最强模型
有意思的是,Anthropic 仍建议大多数日常编程和知识工作优先使用 Opus 5.5,更复杂的开放式技术任务再考虑 Fable 5.2;Mythos 5.2 的开放范围则主要限于经过审核的相关研究机构。
这给团队留下了一个很实际的问题:怎样按任务分配预算?
对普通项目,可以先用熟悉的模型完成范围清楚的修改,遇到反复失败、需要跨模块分析的问题,再尝试调用更强模型。是否值得切换,要结合修复质量和总耗时来判断,单看一次调用的价格并不够。
至于多 Agent,也应该先找到适合并行的工作。如果几个任务都要频繁修改同一批文件,增加 Agent 数量可能让协调更费劲。先把依赖关系拆清楚,才有讨论规模的基础。
这次发布给我的最大启发是:随着 AI 能接手的任务变长,开发者更需要把"完成"定义得具体。