H3-World 的动作能按时发生,为何还不能据此判断实时互动?
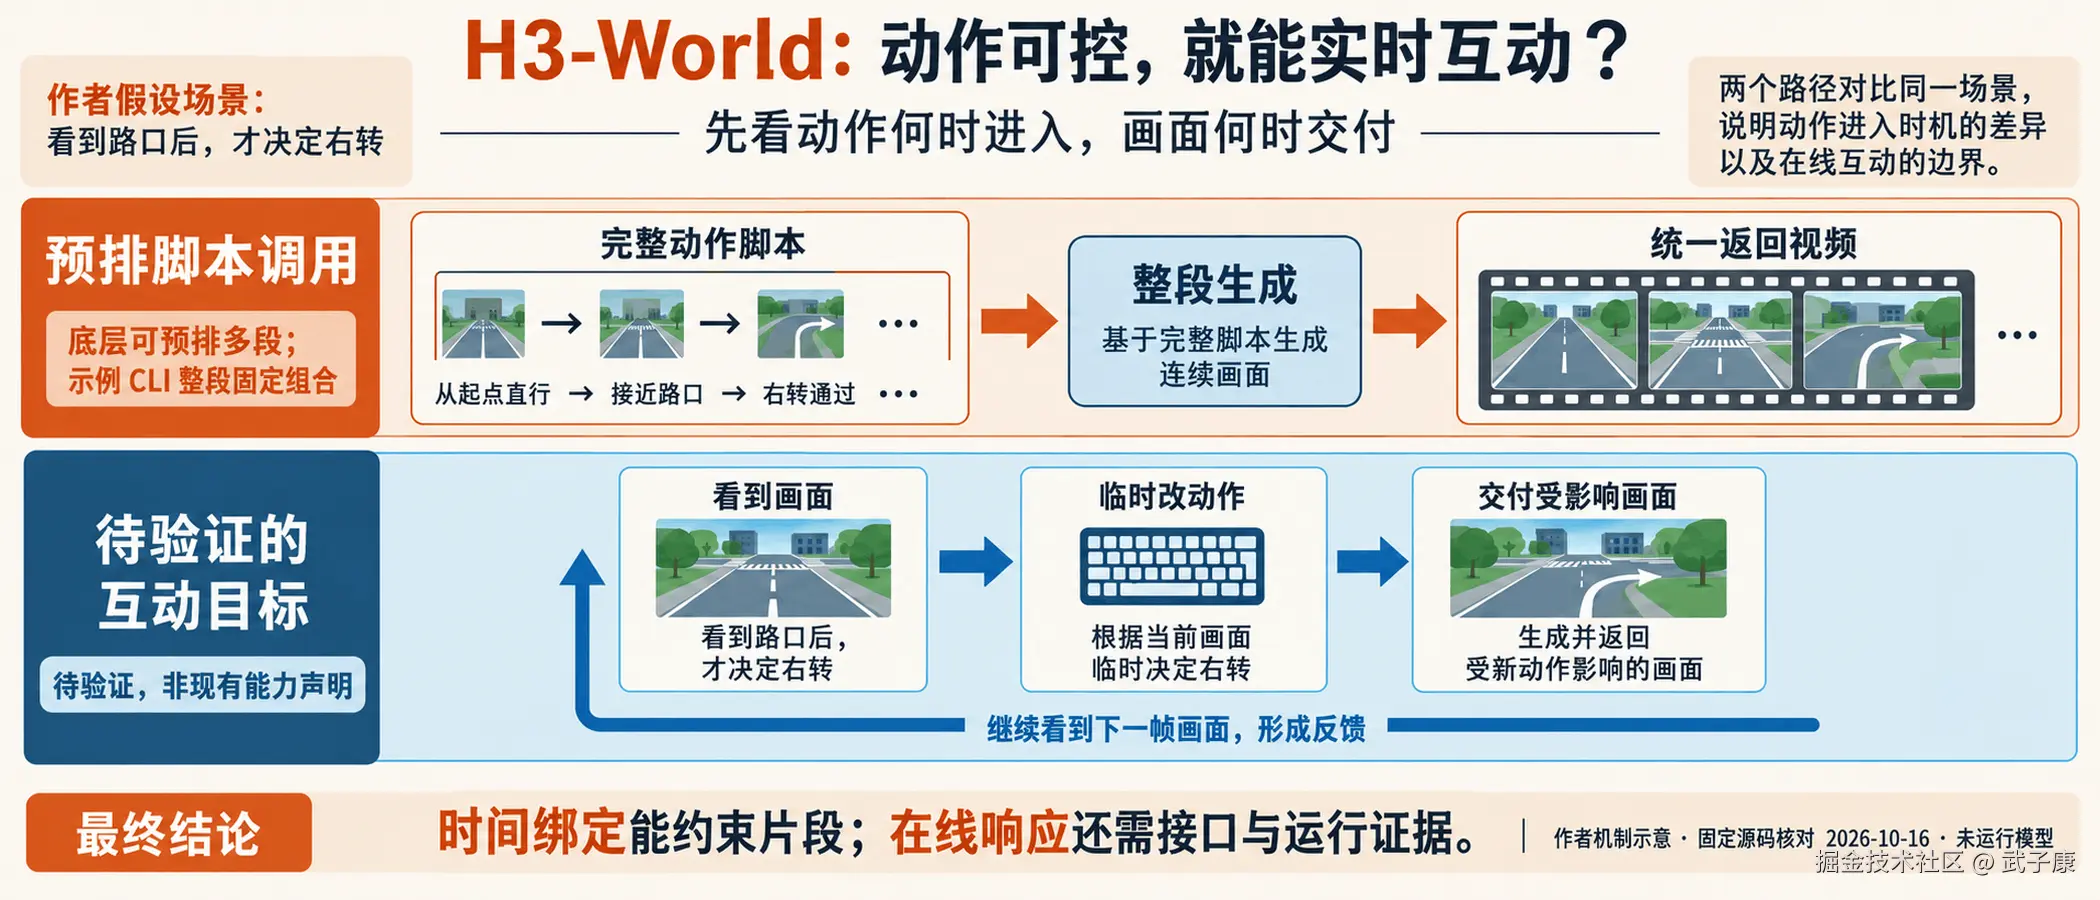
作者机制示意与未执行记录;不代表 模型 运行、延迟或在线会话通过。
在 H3-World 的补丁里,有一段很容易让工程师停下来的注释:逐条独立编码动作文本,是支持 streaming 的一个必要条件,因为未来动作在推理时尚未知。顺着这句话往下看,实现确实把重复句子的 embedding 暂存在一个 cache 字典里。如果只搜到了 streaming 和 cache 两个词,很容易以为已经找到了实时世界接口。
但再往调用入口走一步,看到的是另一条时间顺序:当前示例先生成整段动作脚本,再把脚本一次交给 pipeline,所有扩散步骤完成后统一解码,最后写出 MP4。注释表达的设计动机,与这条公开入口实际提供的能力,需要分开核对。
这也决定了本文的问题。准备把 H3-World 接进"按键---看画面---再按键"的产品时,首要判断是新动作能在哪个时刻进入、对应画面什么时候交付。按键是否影响画面、画面是否按 24 FPS 播放,都无法单独回答这两个问题。
本文在 2026 年 10 月 16 日读取 H3-World 固定提交 f0c7be2acbbde8256b2473f6e7b088f58272acae、论文 2609.01560v1,以及官方指定的 DiffSynth 基础提交 300e3e4da76e881d5e6bd97d897810c18f6e4893。只做源码、接口和标准库静态检查;未安装模型依赖、下载权重或运行生成。以下"未发现接口"仅针对这些固定材料与入口,不替未知分支、未公开服务或未来版本下结论。
1. 先有整段脚本,再开始生成
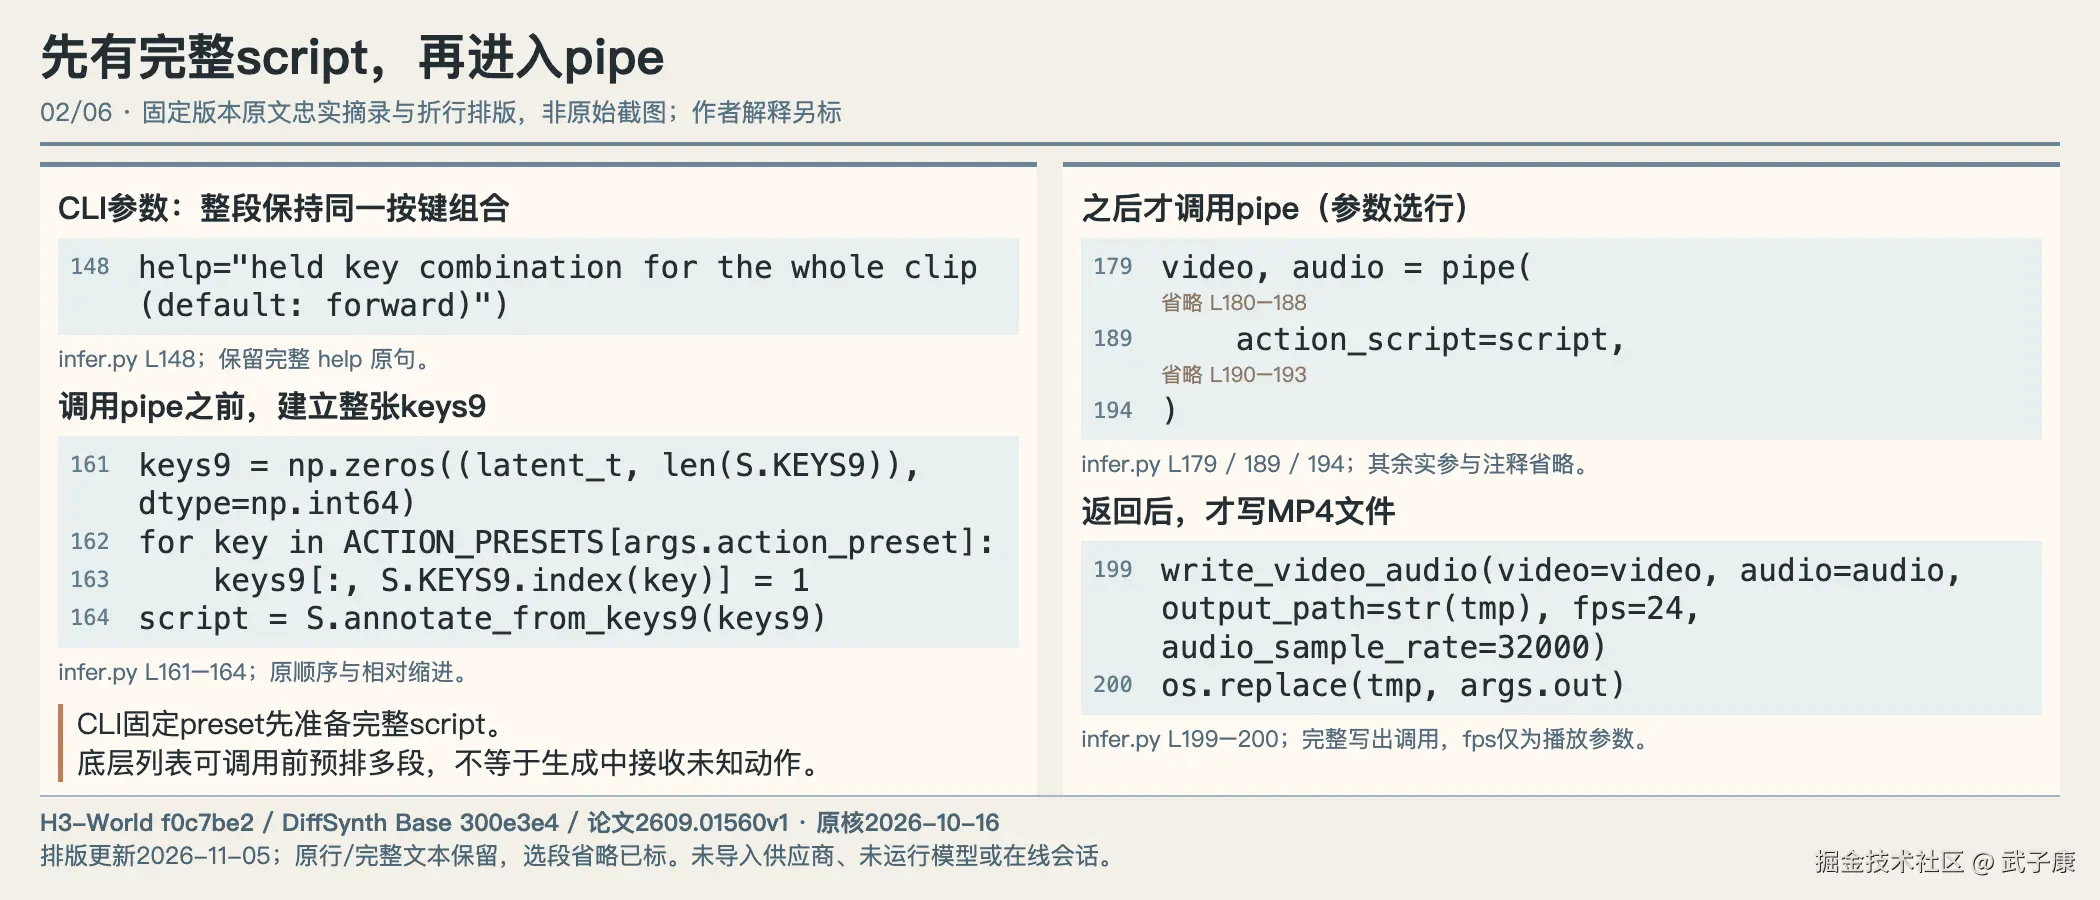
固定 H3-World commit f0c7be2 的 infer.py 忠实摘录,采用折行排版,非原始截图;原行号与省略范围见图。
论文 §3.1 将输入写成初始观察、静态语义条件和一段已经安排好的动作序列,输出为对应的未来视频 latent。文中明确,底座是双向音视频模型,对完整未来时域联合去噪。这里控制的是一段未来如何展开,动作可以被分配到不同时间位置;它没有因此获得一个等待下一次用户输入的执行循环。论文 §3.1
公开 code/abot/infer.py 还比论文描述的动作序列更窄。命令行 --action-preset 的说明是"整段保持的按键组合"。程序按目标帧数算出 latent 长度,建立整张 keys9 数组,然后把选中按键写进所有行:
python
keys9 = np.zeros((latent_t, len(S.KEYS9)), dtype=np.int64)
for key in ACTION_PRESETS[args.action_preset]:
    keys9[:, S.KEYS9.index(key)] = 1
script = S.annotate_from_keys9(keys9)
之后才调用 pipe(..., action_script=script, negative_action_script=S.null_script(latent_t))。因此这条 CLI 展示的是一次固定组合生成,不是读取连续键盘事件。底层补丁接受 action_script 列表,意味着可以在调用前准备不同时间位置的句子;"可以预排多段动作"与"生成途中接收未知的新动作"仍是两个接口要求。固定推理入口
设想用户在看到人物接近路口之后,临时决定右转。预先安排"先直走、后右转"能说明模型是否按时间执行安排,却没有覆盖这个决定依赖已交付画面的情形。按键发生时,系统必须知道当前可更新的生成范围,接收新动作,并交付受它影响的新观察。这条固定入口没有接收该事件的参数或回调,也没有在返回前给调用者交付视频帧的 yield。这些都是源码范围内可检查的接口事实,不是延迟测量。
这里可以先列两种事件顺序。预排镜头是"提交动作安排---调用生成---得到完整片段---播放";反馈决策则至少包含"交付一个观察---用户据此决定动作---接收这个此前未知的动作---生成并交付受它影响的观察"。这是作者用来检查接口的顺序示意,不是本次运行轨迹。两条顺序都可以表现角色转向,但第二条多出了依赖已交付观察的决策位置。
因此,检查一段带转向的视频时,最先追问的是转向指令何时确定。若所有句子在调用开始前已经给齐,视频中的转向位置再准确,也只直接支持预排控制。要支持反馈决策,还需指出新动作在哪个调用边界进入,以及已经生成、排队或显示的画面怎样处理。本文在固定入口没有看到这个交付循环;这不等于断言用该模型永远无法另外实现它。
底层视频 latent 之间仍保留 双向注意力 。论文 §3.4 说明,动作的直接入口被限制到对应视频位置,但影响仍可通过视频之间的注意力传播。时间绑定提高动作归属的精度,不能把整段未来联合生成解释成逐时刻、只依赖过去状态的环境转移。若要做在线决策,需要另外确认因果边界,而不能只看动作路由有没有通过。论文 §3.4
2. streaming 注释和 cache,具体落在什么地方?
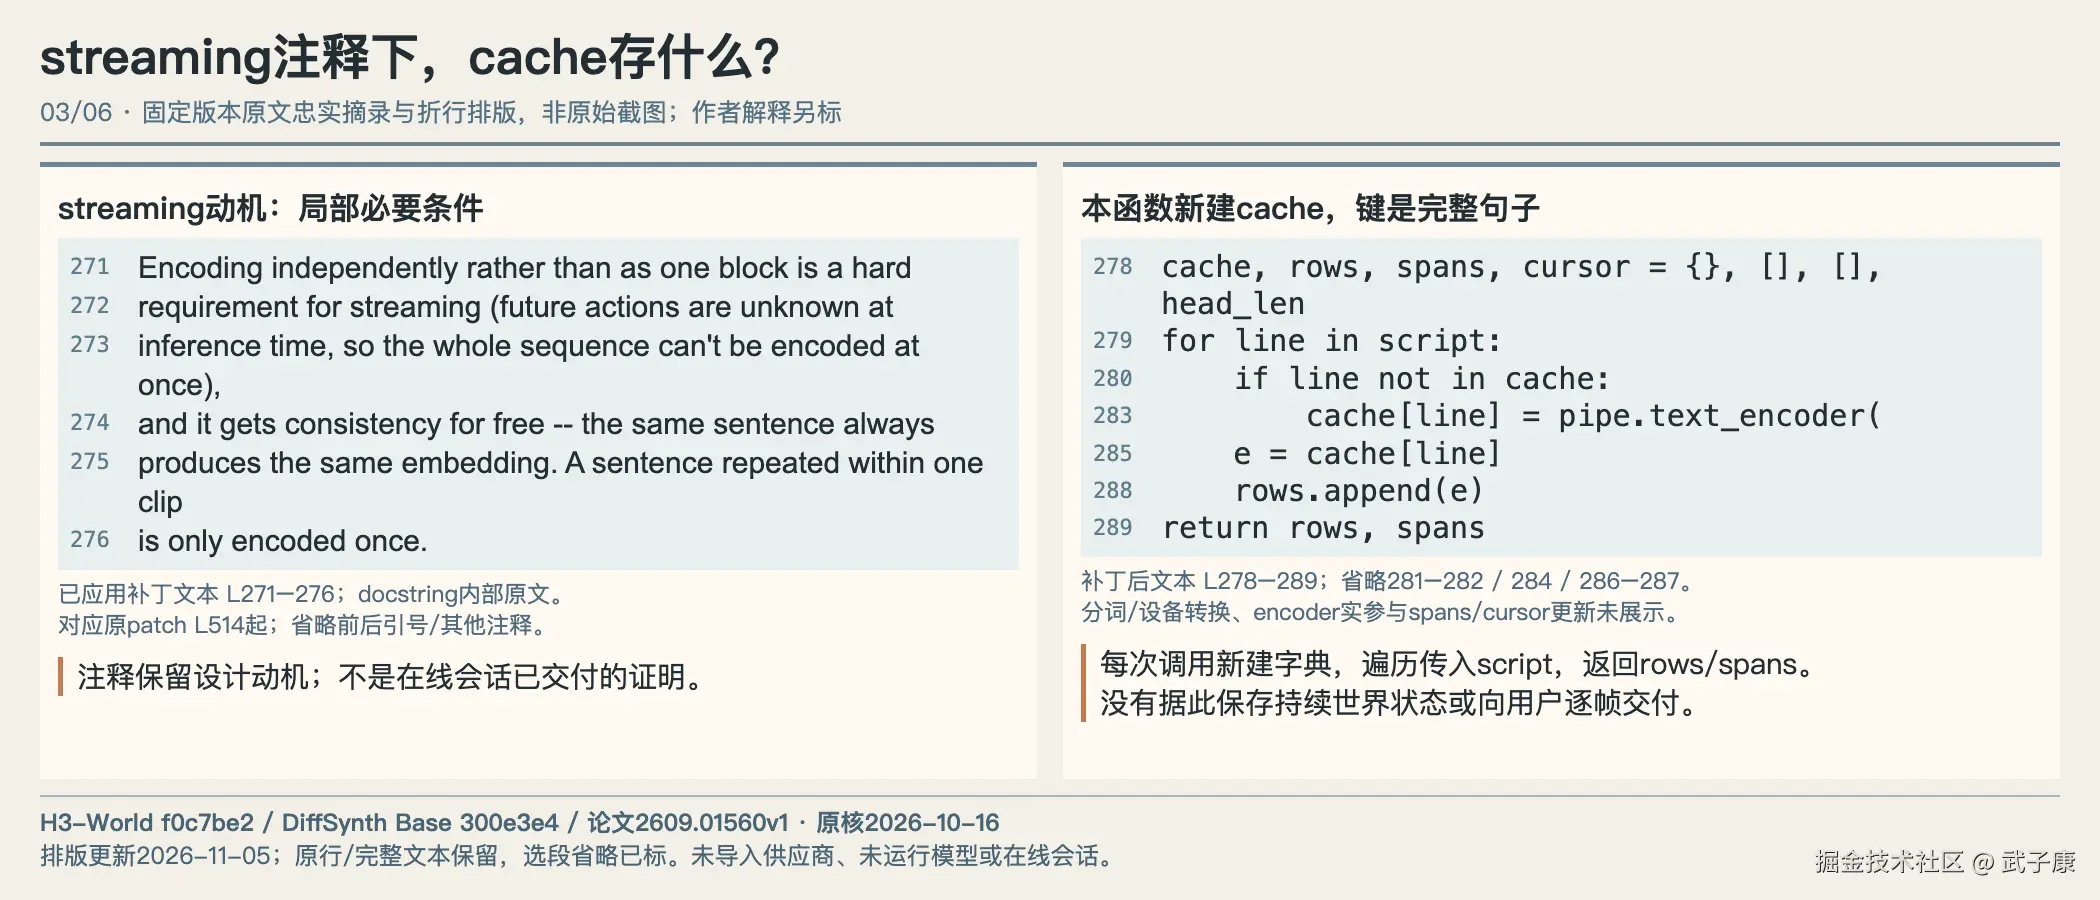
固定 commit 的补丁/已应用补丁文本忠实摘录,采用折行排版,非原始截图;函数对象、寿命与省略范围见图。
补丁中 _encode_action_script 的注释值得保留,因为它揭示了作者希望避免的耦合:若把整段未来动作拼成一个文本一起编码,就会提前依赖未来动作。逐句独立编码,使同一句子可以单独得到 embedding ,也让重复句子可以复用编码结果。这是通向后续交互设计的一个局部条件。
不过,当前函数的实际开头是:
python
cache, rows, spans, cursor = {}, [], [], head_len
for line in script:
    if line not in cache:
        # 对当前句子调用 text_encoder
        ...
    e = cache[line]
    ...
    rows.append(e)
return rows, spans
上段为说明职责的忠实节选,以注释和省略号略去了分词、设备转换和 span 索引更新;完整原文保存在研究附件。关键是 cache 在这次函数调用内新建,键是句子,值是该句的文本 embedding。它不是持续世界状态,也没有据此保存跨请求的生成历史或已经提交给用户的画面。函数仍遍历传入的完整 script,返回全部 rows 和 spans,调用方把它们拼到条件序列中。固定补丁
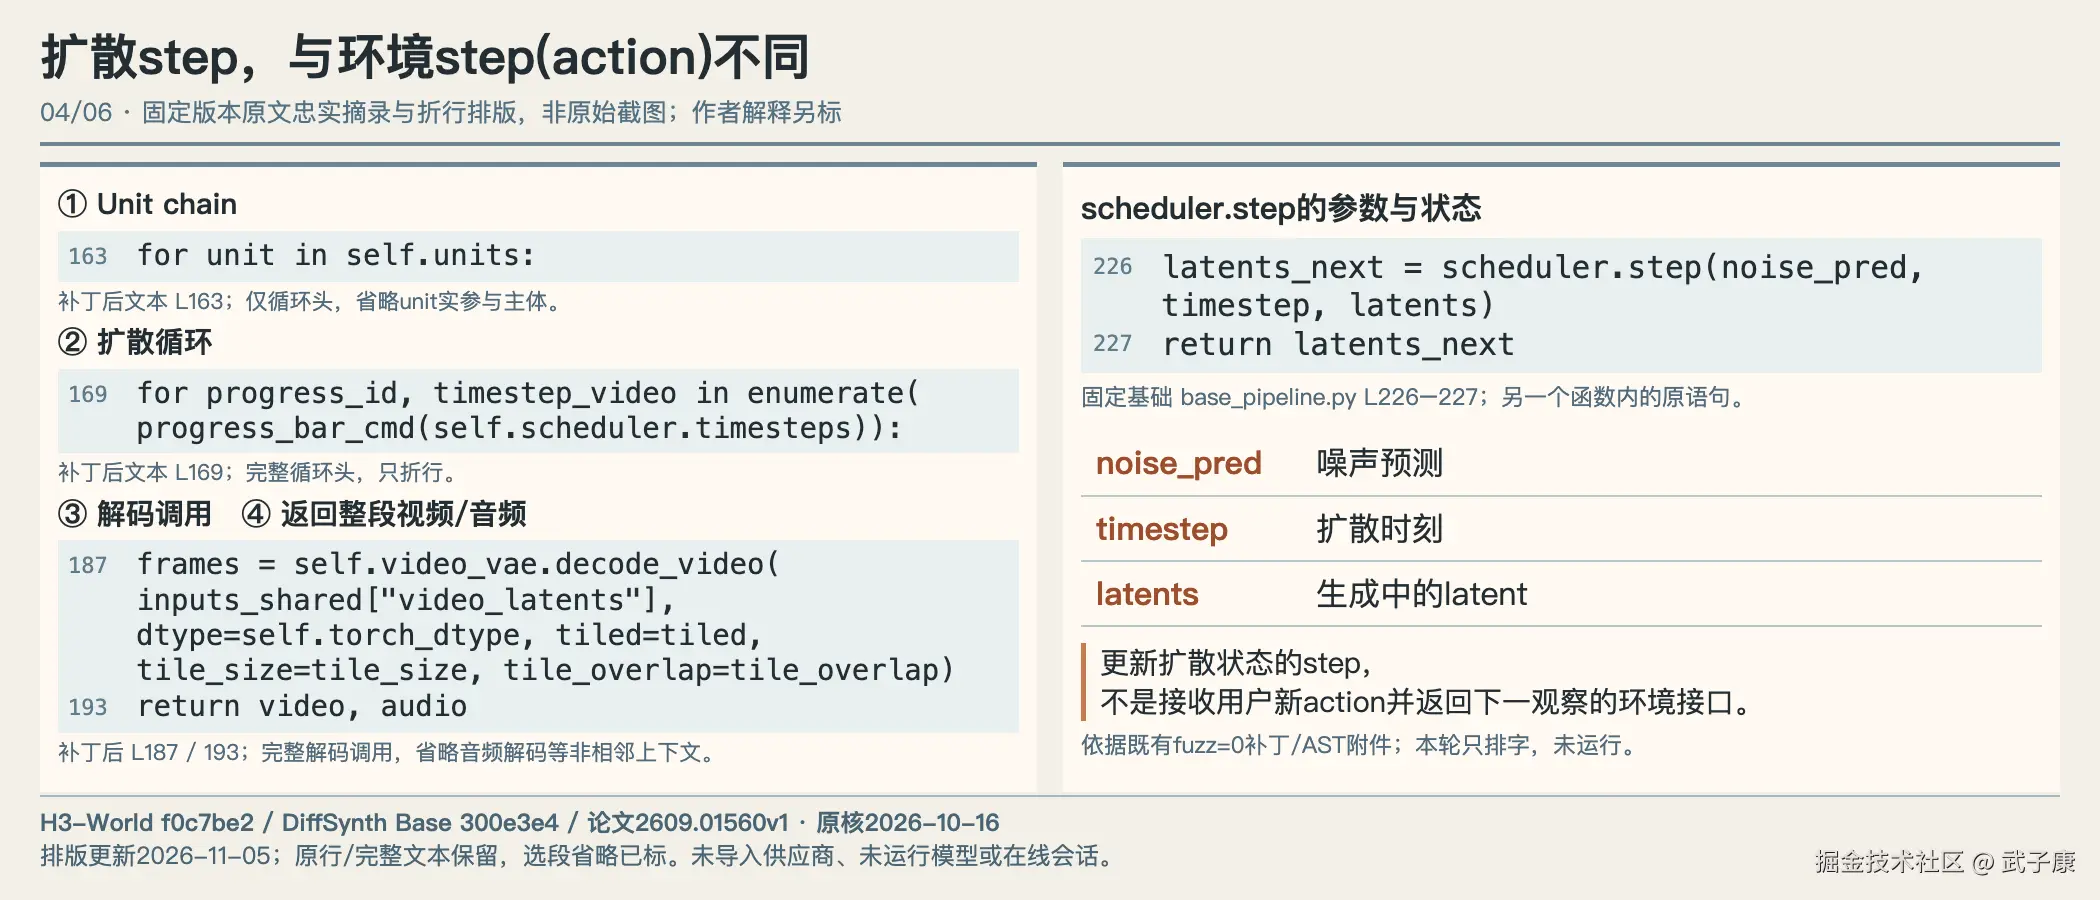
固定 DiffSynth 基础 commit 与已应用补丁文本的忠实摘录,采用折行排版,非原始截图;源码顺序与省略范围见图。
继续看应用补丁后的 pipeline:先运行 unit chain,准备条件和整段 latent;接着遍历扩散 scheduler 的 timesteps,更新视频和音频 latent;最后调用视频 VAE、音频 VAE 解码,再 return video, audio。本次将官方补丁以零 fuzz 应用于固定基础源码,只检查文本和 AST,没有导入供应商代码。调用顺序是静态读取所得,不表示 GPU 已成功执行。
这里也确实出现了 self.step(...)。它调用的是基础类中的扩散调度操作,最终执行 scheduler.step(noise_pred, timestep, latents),把一次噪声预测转换成下一扩散状态。这不是一个供用户传入"当前世界状态和新动作"、再取回下一观察的 step(action)。名称相同,参数与状态对象决定了职责。固定基础 pipeline · 基础 step 实现
在这份代码里, 缓存 的对象和寿命比变量名更有区分力。字典项能够回答的是"这一句话在本次编码过程中是否已经算过";它没有回答"世界在上一次用户操作后处于什么状态"。缓存命中可以省下重复文本的编码职责,但不会凭空提供动作事件队列、生成范围更新或视频交付协议。这里也没有把它换算成节省了多少毫秒,因为本次没有取得对应计时。
另一个检查点是函数返回了什么。它返回的是编码后的rows和位置spans,随后参与条件序列准备;这与向调用者逐帧提交观察是不同的返回对象。即便将来把句子编码部分改成跨请求复用,仍需另外设计会话中哪些状态可继续使用、哪些条件变化会使已有计算失效。那是对接入方案提出的后续问题,不能写成当前代码已经具备的保证。
同样,仓库中的 code/cache.sh 用于训练前的 latent 数据缓存;推理入口的 Hugging Face、Torch、Triton 缓存目录用于模型文件、框架或编译等资源管理。这些资源缓存各有价值,但名字不能证明存在跨交互回合可复用的因果 KV 状态。本次没有对模型所有内部缓存机制作穷尽性结论,只确认上述可见缓存不足以证明在线会话已经实现。
3. 24 FPS、50 步和更长片段,各自说明什么?
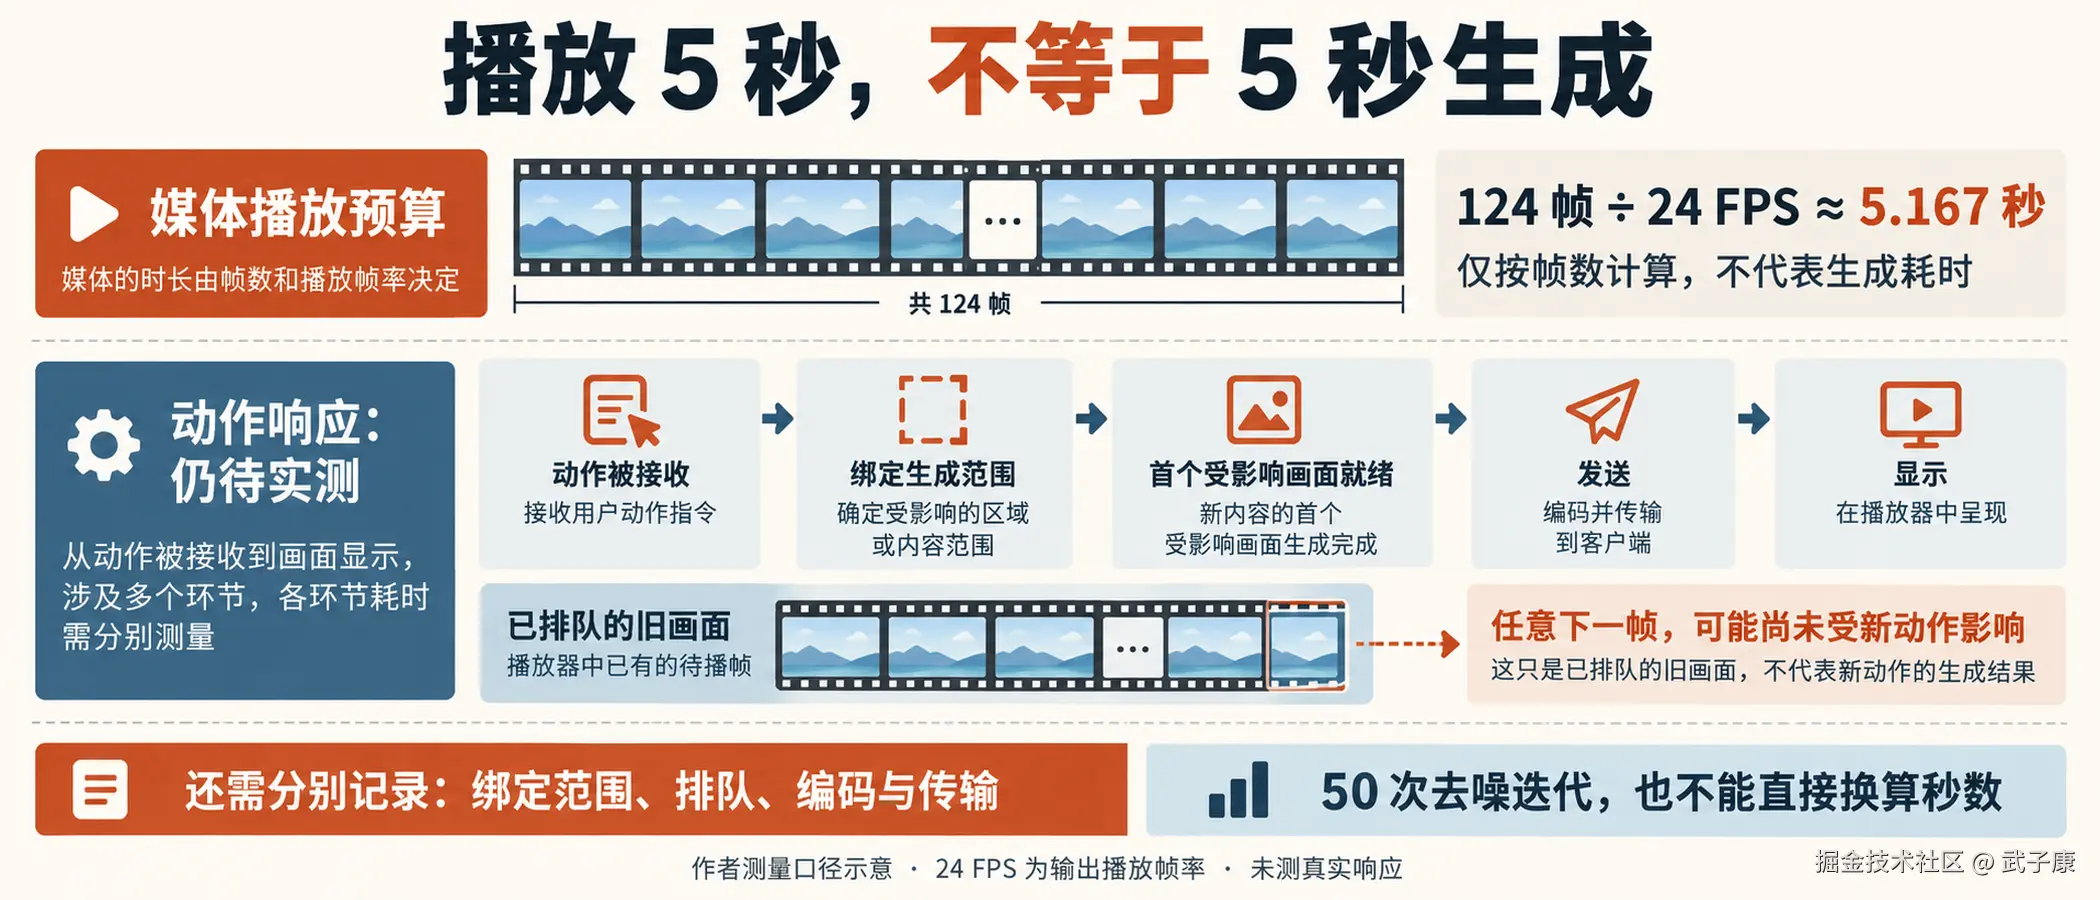
作者机制示意与未执行记录;不代表模型运行、延迟或在线会话通过。
推理入口把最终 MP4 写成 24 FPS。论文 §4.1 报告生成 124 帧、使用 50 次去噪步骤。124÷24 约为 5.167 秒,这是按帧数计算的媒体播放预算;第一帧到末帧的采样时间差是 123÷24,口径又不同。两者都不是一次生成任务实际花费的墙钟时间。论文 §4.1
| 固定源码中的量 | 可以据此说明 | 还需要什么证据 |
|---|---|---|
| 写出 fps=24 | 输出文件的播放帧率 | 首个受动作影响画面的交付时间、持续交付间隔 |
| 默认 --steps 50 | 配置的扩散迭代次数 | 指定硬件与运行条件下,每阶段实际耗时 |
| 默认 124 帧 | 一次请求的目标视频帧预算 | 实际成功输出帧数、质量与资源记录 |
| 长度满足 17k+5 | 当前形状对齐规则允许这种请求 | 对应长片段是否跑通、延迟、显存与连续性 |
标准库算术给出:124、243、481 帧分别约对应 5.167、10.125、20.042 秒播放预算,视频 latent 时间长度分别为 37、72、142。这里仅按固定源码公式计算。把参数改成 481,不证明模型能稳定生成 20 秒,更不证明连续会话能持续 20 秒。长请求还可能改变显存与计算量,本次没有跑它们,不能给出上限或倍率。
"50 步"也不能直接换算成"很慢"或"足够快"的秒数。它说明一次请求会经过这些扩散迭代;实际耗时取决于硬件、分辨率、序列长度、编译、模型驻留与实现等条件。没有对应日志,就不能把另一台机器上 MiniMax -H3、h3.c 或其他世界模型的成绩填到 H3-World 名下。即使恰好使用相同底座,动作条件、补丁、运行时与测量范围也可能不同。
产品真正需要的是动作到新观察的时间线。要记录动作何时被接收、何时被分配到生成范围、首个受影响画面何时可用、何时送达并显示。只计模型返回时间会漏掉队列、编码和传输;只看持续 FPS 又可能掩盖首次响应很晚。若输出还包含尚未受这次动作影响的缓冲画面,也不能把任意下一帧当作动作响应。
这份记录需要同时区分"画面已计算""画面已交付"和"画面受到这次动作影响"。例如,用户发出新动作之后,客户端可能先显示队列里较早生成的画面;即便这一帧很快到达,也不能据此宣布动作响应很快。反过来,只保存最终MP4生成结束时间,也无法知道其中最早哪一帧在什么时刻可以交付。这里描述的是测量时要排除的归因混淆,没有声称本次系统实际存在多长队列。
若后续开始运行实验,应把同一请求与动作标识贯穿接收、绑定和显示记录,保存所用代码、权重、硬件与生成参数,并明确采用哪一侧的时间戳。不同机器的时钟不能在没有同步依据时直接相减。若只报告服务端观测,就明确止于画面就绪或发送;若要报告用户端响应,就补接收和显示证据。上述字段是作者建议的记录方法,不是供应商已经输出的遥测格式,本次所有耗时仍未知。
4. 续接片段可以作为实验起点,但还要回答新问题
固定基础 pipeline 的确提供 keyframes、references 和 retake_video 等参数。首尾关键帧可以约束片段,参考输入可以提供图像、音视频条件,retake 可以指定已有片段与需重做的区域。不能因为没有在线会话接口,就把这些输入能力一并说成不存在。
但它们在所审读的入口里仍是一次调用前提供的输入。把上一段末帧拿来当下一段首帧,是应用方可以设计的分段生成实验;它不自动恢复相机、物体、遮挡历史、规则状态或用户尚未看到的待交付画面。一次 retake 也仍会经过新的生成调用,不能凭参数名宣称获得了低延迟续跑。跨段身份、几何连续性和资源复用需要自己的运行证据。
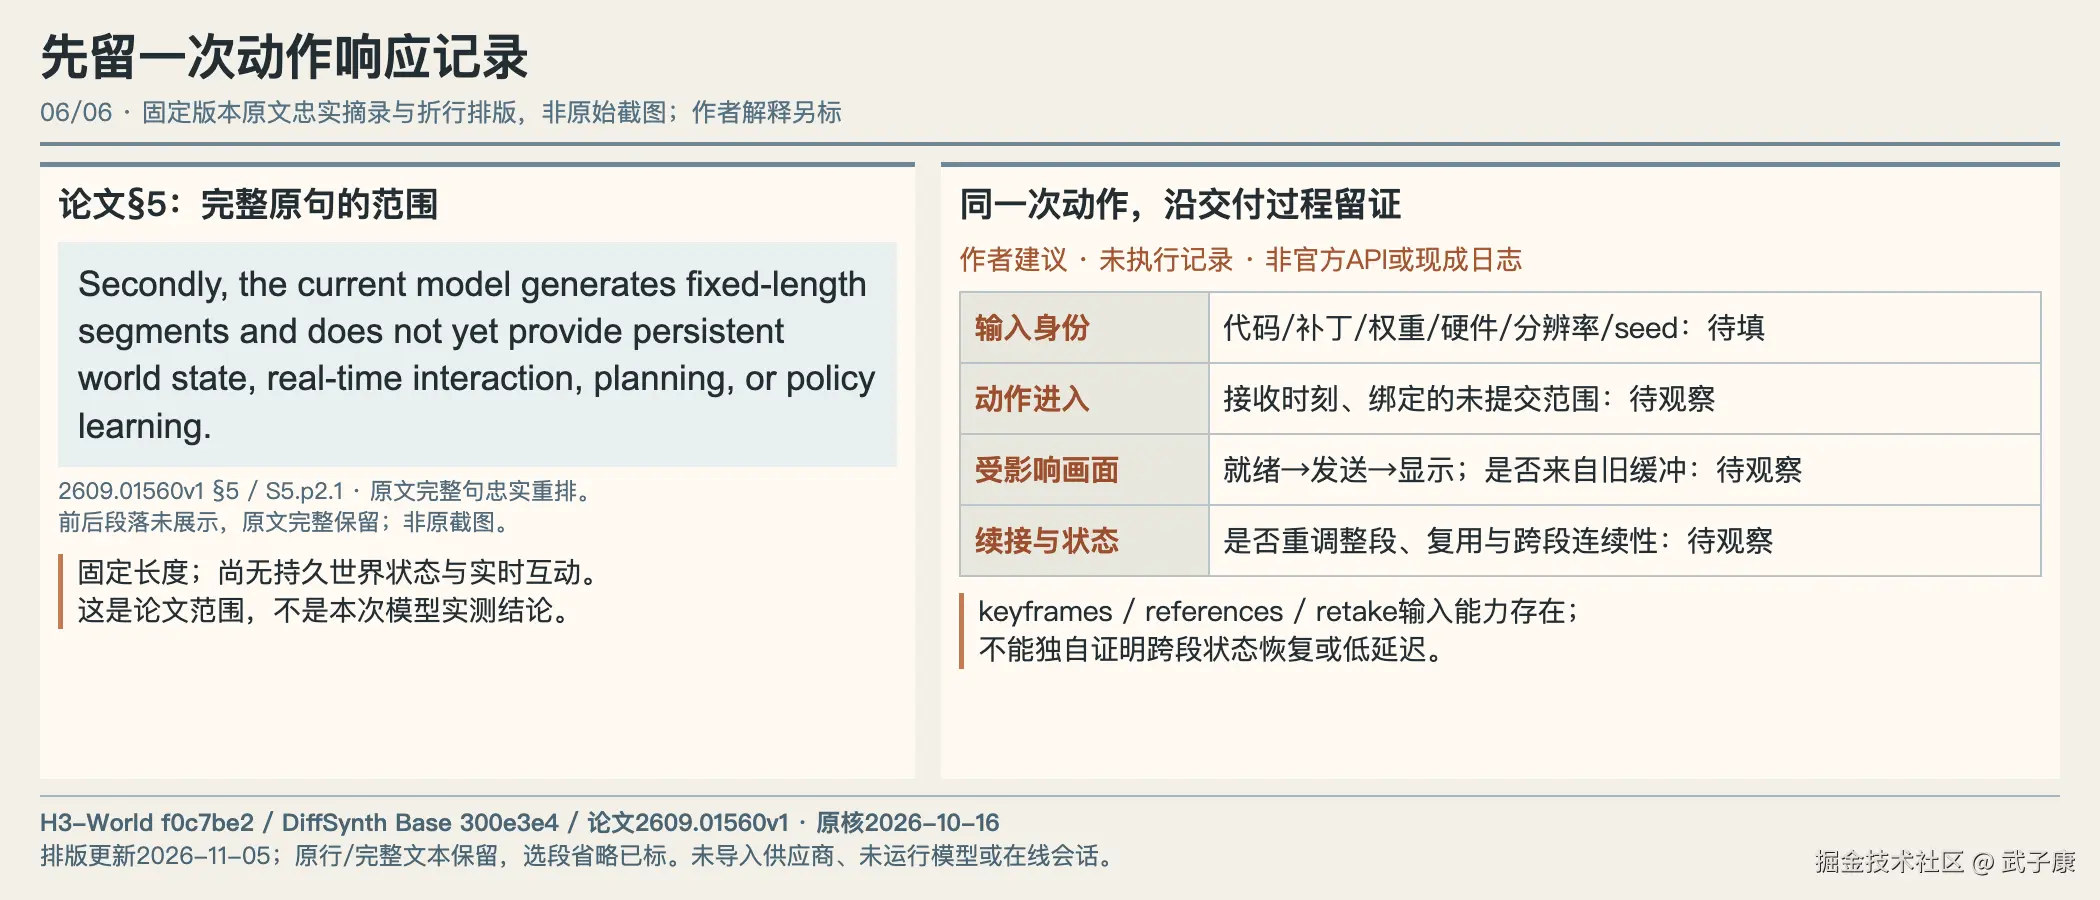
论文 2609.01560v1 §5 原文忠实摘录,采用折行排版,非原始截图;右侧为作者未执行的动作响应记录。
论文 §5 对此给出了直接边界:当前研究聚焦短时域、固定长度片段,尚未提供持久世界状态、实时交互、规划或策略学习。它也承认,动作组合、场景和随机种子的控制可靠性仍需系统评估。因此,把它作为动作条件 视频生成 的研究起点是有依据的;把它作为已经交付的实时环境服务,还缺接口和运行两类证明。论文限制
对准备接产品的工程师,最有用的下一步是一条最小的动作响应记录,而不是先补一个键盘外壳。以下是作者建议的未执行记录,字段不是 H3-World 官方 API:
text
代码/补丁/权重/硬件/分辨率/随机种子:待填写
请求开始;动作接收;动作被绑定到哪段未提交时间范围:待观察
首个受该动作影响的画面就绪;发送;显示:待观察
动作发生前已显示/已排队的帧;是否作废或继续发送:待观察
后续动作接收;生成状态是否复用;是否重新调用整段生成:待观察
跨段场景与对象是否连续;不一致案例:待观察
对分段生成,也可以沿同一条记录检查责任边界。每次调用能带入一张末帧,至少说明应用有条件把图像作为下一片段的输入;它不能独自说明上一片段的所有隐含状态都被恢复。若新的调用仍从完整生成入口开始,就应如实记录这次重调,而不是因为画面相接便写成原会话持续推进。出现人物、几何或遮挡不连续时,应保留案例和输入来源,不能把成功接上一个示例当作全部场景都可续接。
最小试验也无需先给系统一个"实时"标签。先决定产品要交付预排片段还是反馈式观察,再选一条请求走完整记录。若暂时只有固定源码与算术,能够交付的是清楚的接口边界;若取得运行证据,再补实际耗时与失败案例。这样仍沿用同一个读者问题,不把尚未执行的集成设想混入当前模型能力。
如果团队只需要预先编排几秒镜头,完整动作脚本加片段生成就可能满足目标,不必先承担在线环境改造。若目标是用户看见画面后临时改动作,就按这条记录去验证因果顺序与交付时间;目前只能把这些字段保持为待观察。逐句编码为后续扩展留下了局部条件,公开的固定入口则仍把一段未来作为一次生成任务交付。这是选择集成方式时可以直接使用的边界。
来源与范围
主要依据为固定 H3-World 仓库 README、code/abot/infer.py、code/diffsynth_h3_action.patch,指定 DiffSynth 基础版本的 minimax_h3_audio_video.py 与 base_pipeline.py,以及论文 2609.01560v1 §3.1、§3.4、§4.1、§5。源码摘录做了明确重排或省略,不冒充原始截图。标准库检查与原文 SHA 见研究附件;静态检查不证明真实生成速度、画面质量、长片段稳定性或在线会话可用。ZIP 研究笔记仅用于发现问题,未采用其中的游戏类别打分、性能推测或其他系统的本机结果。