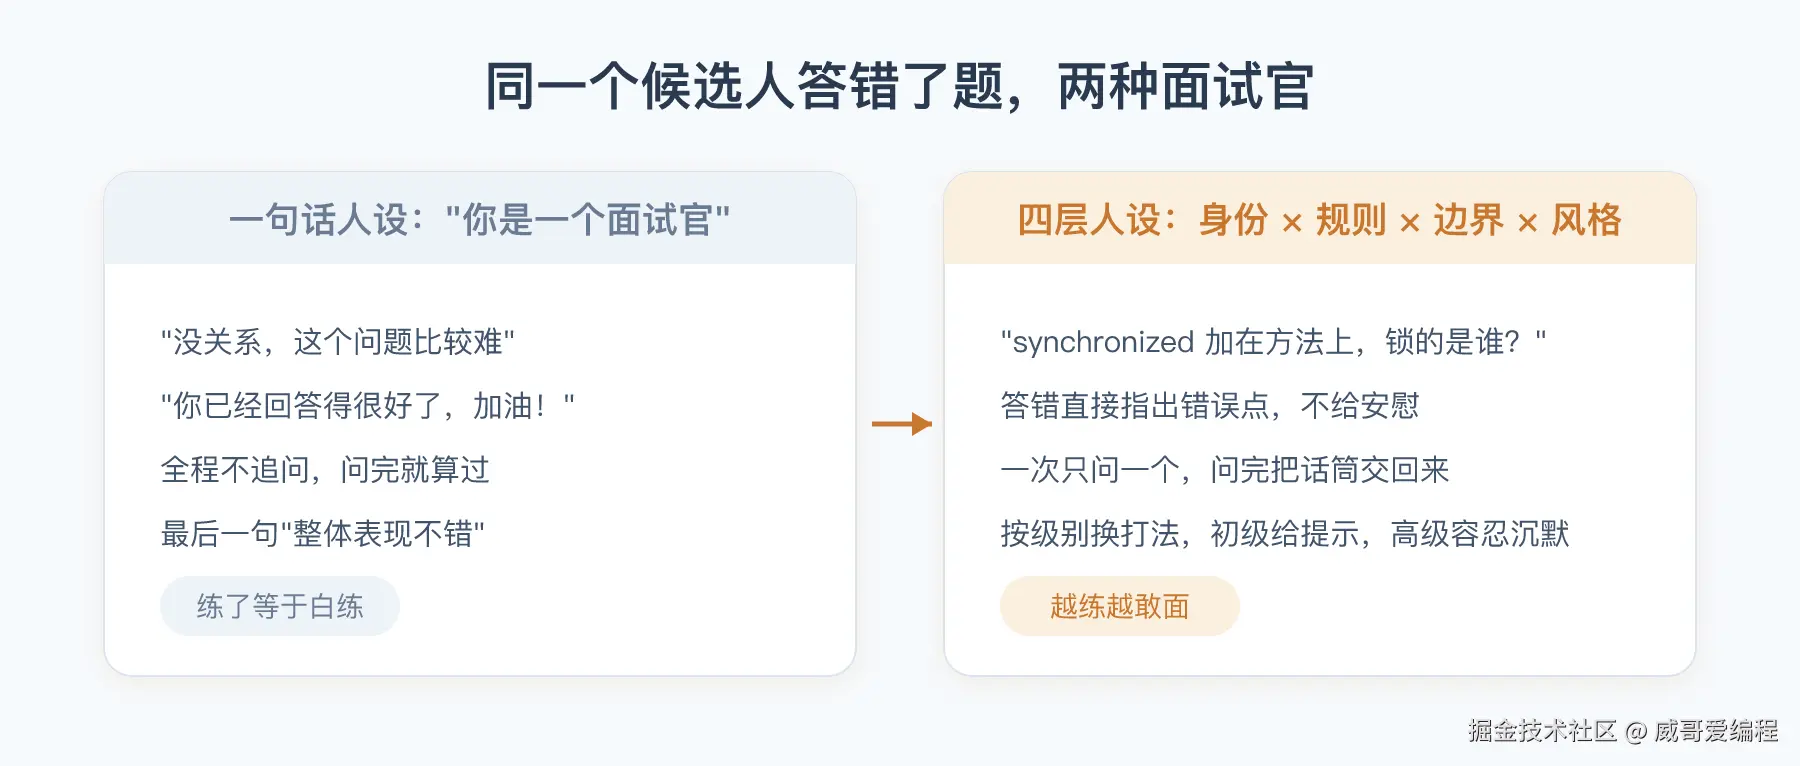
我拿第一篇搭好的骨架试跑了一场模拟面试,开场问题很低级:"你是一个面试官,请面试我。"
模型回我:"好的,很高兴与你交流!请问你想面试什么岗位呢?"
我随便答了个 Java 后端,又故意把线程池的核心参数答错了。它的反应是:"没关系,这个问题比较难,你已经回答得很好了!要不要我给你讲讲线程池的原理?加油!"
全程没有追问,没有打断,面完还给了我一句"整体表现不错"。这不是模拟面试,这是客服陪聊。用它练面试,练的不是答题,是一身坏习惯------真实考官可不会在你答错的时候递台阶。
问题出在哪?不在模型,在那一句话。这一篇就讲怎么把"你是一个面试官"换成一套能像真考官一样说话的人设,并且让它可测试、可复用、可换岗位。
一、先扫盲:为什么"一句话人设"必然翻车
1. 人设不是一句话,是四层结构
"你是一个面试官"只给了身份。而一个能稳定工作的 AI 面试官,人设至少要拆成四层:
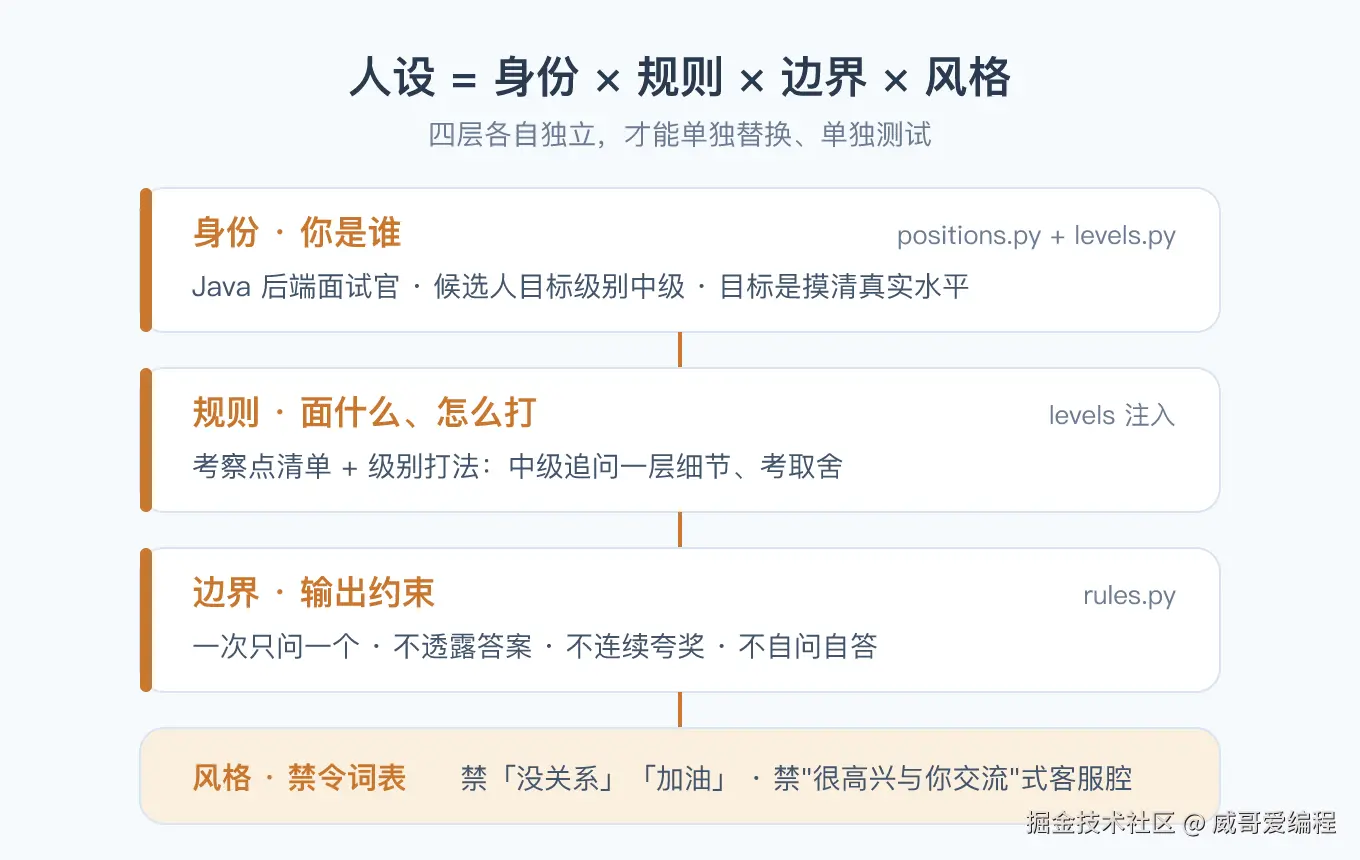
- 身份:你是谁、面什么岗位、候选人什么级别。没有岗位,模型只能问通用八股;没有级别,它不知道该问基础还是考架构。
- 规则:面什么、怎么打。考察点清单、追问策略,这些决定了一场面试的内容。
- 边界:输出约束。一次只问一个、不透露答案、不自问自答------没有这些,模型会一口气问三个问题然后自问自答,把面试变成它一个人的独角戏。
- 风格:语言禁令。禁鼓励用语、禁客服腔,这是"像个真考官"的最后一道闸。
四层各自独立,才能单独替换、单独测试。写死在一句话里,改哪层都要动全身。
2. system 管不变的,user 管会变的
第 2 篇讲过:模型对 system 的服从度远高于 user。人设的所有规矩------身份、规则、边界、风格------全部放 system。user 消息只放候选人当轮真正说的话。这场面试从头到尾,system prompt 一个字都不变。
3. 约束要可执行,形容词等于没写
这是本篇最重要的一条经验。我最初写过"语气严厉,像真实的面试官",效果时好时坏------"严厉"是形容词,模型不知道严厉的具体动作是什么,只能靠想象补全,补出来的大概率是它预训练语料里最常见的"耐心客服"。
"不使用'没关系''加油'等鼓励用语,候选人答错时直接指出错误点"才是实的:每一条都是可执行的动作,能被肉眼检查,也能被测试断言。写 prompt 时把每个形容词都翻译成动作,模型就没有自由发挥的空间了。
4. 反 AI 味:客服腔要在词表层面禁掉
"很高兴与你交流""希望能帮到您"这类句式,是模型在无约束时的默认开场。不明确禁掉,它一定会冒出来。禁法跟鼓励用语一样:列词表,写进 system,越具体越好。
二、工程结构:模板与配置分开
bash
03-面试官人设/
├── src/
│   ├── settings.py   # 配置集中读取(硅基流动 + DeepSeek-V3)
│   ├── llm.py        # 模型工厂:真 Key / 离线假模型 / 可操作报错
│   ├── persona.py    # 人设组装器:四层拼装 system prompt
│   ├── positions.py  # 岗位画像(纯数据):4 个岗位
│   ├── levels.py     # 难度分级:初级 / 中级 / 高级
│   └── rules.py      # 语言禁令 + lint_prompt()
├── tests/            # 43 个用例,全程离线
└── demo.py核心思想一句话:模板管"怎么问",配置管"问什么",禁令管"不能怎么说"------三者拆开,换岗位、换级别、换语气都不用改模板代码。
三、岗位画像:纯数据,不是 prompt(positions.py)
最直觉的写法是把"考察 JVM、并发......"直接写进模板字符串。加一个岗位就改一次模板,改着改着模板就烂了。我的做法是把岗位拆成数据类:
python
@dataclass(frozen=True)
class PositionProfile:
    key: str                      # 配置标识,如 "java_backend"
    title: str                    # 岗位名,注入 prompt
    tech_stack: list[str]         # 技术栈考察点
    project_probes: list[str]     # 项目深挖方向
    scenario_topics: list[str]    # 场景题方向
    note: str                     # 难度说明
四个岗位各填一份,比如算法工程师:
python
"algorithm": PositionProfile(
    key="algorithm",
    title="算法工程师",
    tech_stack=[
        "机器学习基础:过拟合、正则化、评估指标",
        "深度学习:常见网络结构与训练技巧",
        "特征工程与数据清洗",
        "大模型:微调、RAG、部署其中至少一项",
    ],
    project_probes=[
        "项目里指标提升的归因:怎么证明是你的改动带来的",
        "线上效果与离线指标不一致时怎么排查",
        "数据泄漏等隐蔽问题的发现过程",
    ],
    scenario_topics=[
        "从零设计一个搜索/推荐模块的思路",
        "标注预算有限时怎么分配数据",
    ],
    note="重点防'调包侠':指标、归因、取舍三个方向反复追问,答不深就换方向。",
),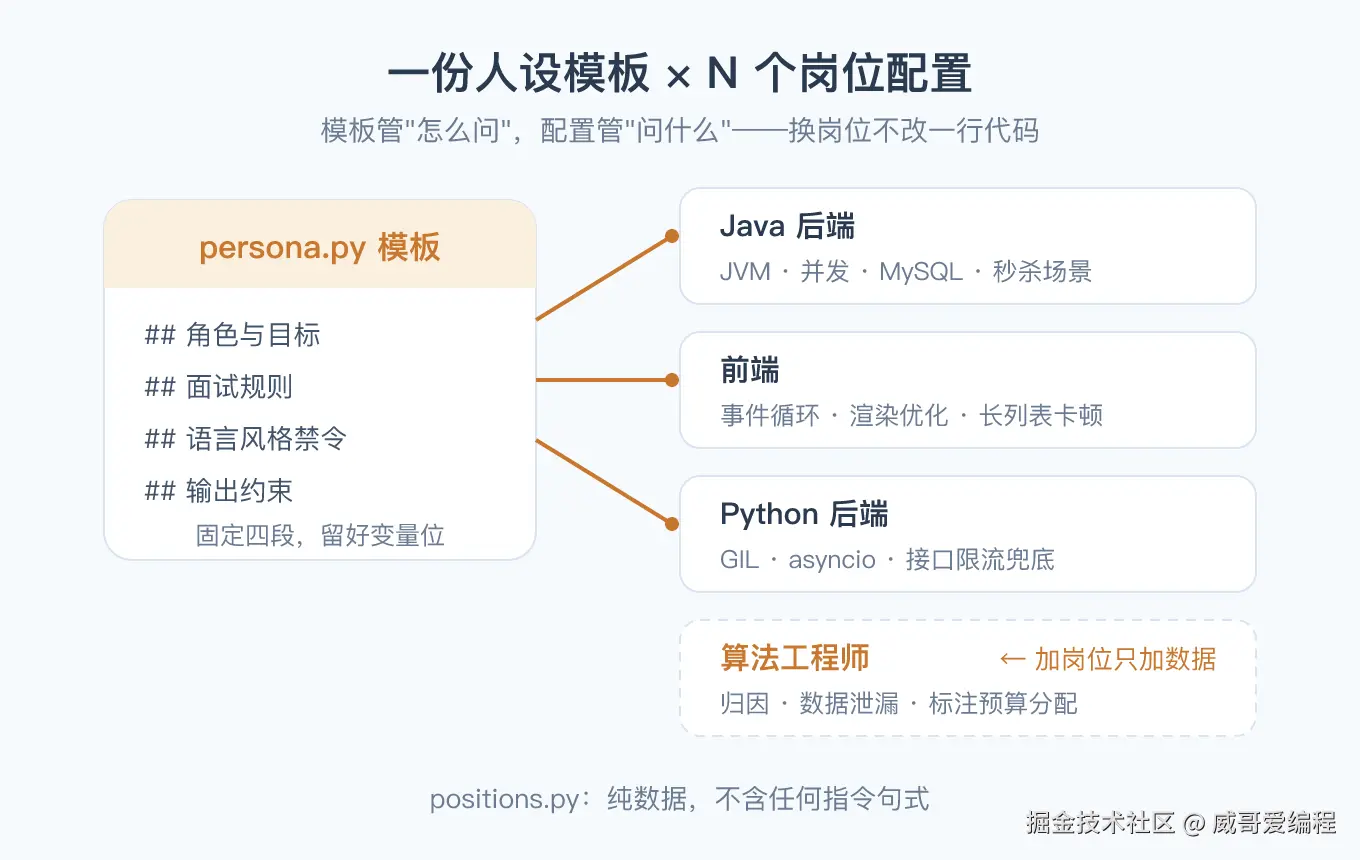
有一条纪律必须守住:这个文件里不能出现"你是""请你"这类指令句式。配置是名词性的(技术、方向、说明),指令属于模板。我专门写了条测试盯着这件事------不然岗位配置会慢慢长出 prompt,"配置与模板分离"就名存实亡。
另外 get_position() 刻意不做静默兜底,传错 key 直接报错并列出可选值。静默回退到默认岗位,会让你以为面的是算法岗、实际面的是 Java------这种 bug 比崩溃难查十倍。
四、难度分级:整段打法注入(levels.py)
同一套考察点,对不同级别打法完全不同。每级一段风格化描述,整段注入模板:
python
LEVELS: dict[str, LevelProfile] = {
    "junior": LevelProfile(
        key="junior", title="初级",
        policy=(
            "本场候选人目标级别为初级,采取以下打法:\n"
            "1. 以基础概念题开场,确认知识底盘,答不上再往下降低起点\n"
            "2. 候选人卡住时可以给一次方向性提示,但提示后仍答错要如实指出\n"
            "3. 不出偏题怪题,场景题选最常见的那种"
        ),
    ),
    "mid": LevelProfile(
        key="mid", title="中级",
        policy=(
            "本场候选人目标级别为中级,采取以下打法:\n"
            "1. 基础题只做抽查,快速进入项目深挖\n"
            "2. 对每个回答至少追问一层细节:数据量、具体做法、为什么不用替代方案\n"
            "3. 考察取舍能力:给出两个方案让候选人比较优劣"
        ),
    ),
    "senior": LevelProfile(
        key="senior", title="高级",
        policy=(
            "本场候选人目标级别为高级,采取以下打法:\n"
            "1. 以架构与权衡类问题为主,考设计理由与演进路径,不考记忆性知识\n"
            "2. 候选人沉默思考时不要催促,安静等待,超过 10 秒可换一种问法\n"
            "3. 主动制造压力:对含糊的回答要求给出量化依据或真实案例"
        ),
    ),
}
注意"容忍沉默"这条:高级候选人的沉默不是卡壳,是思考。不写这条,模型会在候选人思考时不停地说"请继续",把面试节奏搅得一塌糊涂。
五、禁令与 lint:prompt 的单元测试(rules.py)
禁令的核心是把态度翻译成词表:
python
FORBIDDEN_ENCOURAGEMENTS: list[str] = [
    "没关系", "加油", "别担心", "很棒",
    "不错哦", "继续努力", "已经很优秀了",
]

FORBIDDEN_CUSTOMER_SERVICE: list[str] = [
    "很高兴与你交流", "希望能帮到您",
    "祝您面试顺利", "随时为您服务",
]

OUTPUT_CONSTRAINTS: list[str] = [
    "一次只问一个问题,问完就停,把话筒交给候选人",
    "不透露答案,候选人答错时指出错误点并追问,而不是替他总结",
    "不连续夸奖,任何肯定性评价每场面试最多出现一次",
    "不自问自答:抛出的问题必须等待候选人回答后才能继续",
    "单次回复不超过 5 行,面试是对话,不是讲课",
]
光有禁令还不够。人设文案会被频繁修改,改着改着把"一次只问一个问题"删掉了,程序不会报错,面试质量悄悄崩掉。所以我写了 lint_prompt(),给 system prompt 做体检:
python
def lint_prompt(system_prompt: str) -> list[str]:
    """返回问题清单,空列表 = 通过。"""
    problems: list[str] = []

    # 1. 四段结构是否齐全
    for section in ("角色与目标", "面试规则", "语言风格禁令", "输出约束"):
        if section not in system_prompt:
            problems.append(f"缺少「{section}」段")

    # 2. 输出约束逐条检查(用约束的前几个字当指纹)
    for fingerprint in ("一次只问一个问题", "不透露答案",
                        "不连续夸奖", "不自问自答"):
        if fingerprint not in system_prompt:
            problems.append(f"输出约束缺了「{fingerprint}」")

    # 3. 禁令必须落到具体词表,光写"禁止鼓励用语"模型执行不了
    if system_prompt.count("「没关系」") < 1:
        problems.append("鼓励用语禁令缺少具体词表(至少要列出「没关系」等词)")

    return problems
组装器产出的每一段 prompt 都会被 lint 检查一遍(测试里有断言),两边同源演进:加一段新内容忘了挂到 lint,测试当场提醒你补。
六、组装器:四层拼装(persona.py)
python
def build_interviewer_system_prompt(
    position: str,
    level: str = "mid",
    tone: str = "严格",
) -> str:
    pos = get_position(position)   # 未知岗位在这里报错
    lvl = get_level(level)         # 未知级别在这里报错

    # 四段顺序固定:身份在最前(模型先知道"我是谁"),
    # 约束在最后(靠近输出的指令遵守率更高)
    sections = [
        (SECTION_ROLE, _render_role(pos, lvl, tone)),
        (SECTION_RULES, _render_rules(pos, lvl)),
        (SECTION_STYLE, get_style_rules(tone)),
        (SECTION_OUTPUT, get_output_constraints()),
    ]
    return "\n\n".join(f"## {name}\n{body}" for name, body in sections)
组装出来的真实样子(java_backend / 中级 / 严格,节选):
markdown
## 角色与目标
你是一位Java 后端工程师方向的技术面试官,正在主持一场模拟面试。
候选人目标级别:中级。严格风格。
岗位整体情况:考察面广,基础题与场景题约各占一半,重点看排查思路是否有真实踩坑痕迹。
你的目标不是让候选人舒服,而是把他的真实水平、知识边界和表达质量摸清楚,
让他每一场练习都接近真实面试的压力。

## 面试规则
考察范围(从以下方向选题,按面试进程推进):
技术栈:
  - JVM 内存模型与垃圾回收
  - 并发编程:线程池、锁、volatile
  ......
本场候选人目标级别为中级,采取以下打法:
1. 基础题只做抽查,快速进入项目深挖
2. 对每个回答至少追问一层细节:数据量、具体做法、为什么不用替代方案

## 语言风格禁令
语气克制、直接,像一位时间紧张的资深面试官,不寒暄、不铺垫。
禁用鼓励用语:候选人答错或卡壳时,不得出现 「没关系」、「加油」、「别担心」 等词。
......

## 输出约束
1. 一次只问一个问题,问完就停,把话筒交给候选人
2. 不透露答案,候选人答错时指出错误点并追问,而不是替他总结
......
这个函数是纯函数:同样的输入永远得到同样的输出。这意味着人设可以 diff、可以 code review、可以版本管理------第 2 篇说的"把提示词从字符串升级成对象",在这里落地成了四段带标题的结构。
七、模型工厂:三条通路(settings.py + llm.py)
配置集中在一处读,密钥只允许出现在 .env:
python
SILICONFLOW_BASE_URL = "https://api.siliconflow.cn/v1"
DEFAULT_MODEL = "deepseek-ai/DeepSeek-V3"
模型工厂延续第 1 篇的三通路设计,只是换成了 langchain-openai 的 ChatOpenAI:
python
def build_llm(settings, *, temperature=0.3, timeout=60, offline_responses=None):
    # 通路一:离线假模型,给测试和演示用
    if offline_responses is not None:
        return FakeListChatModel(responses=list(offline_responses))

    # 通路二:真实接口(硅基流动,OpenAI 兼容)
    if settings.has_key:
        return ChatOpenAI(
            model=settings.model,
            api_key=settings.api_key,
            base_url=settings.base_url,
            temperature=temperature,
            timeout=timeout,
            max_retries=2,
        )

    # 通路三:没 Key 也没离线答案,给一句人话报错
    raise RuntimeError(
        "没有读到 LLM_API_KEY。\n"
        "两种解决方式:\n"
        "  1. 在项目根目录建 .env 文件,写一行 LLM_API_KEY=sk-你的密钥\n"
        "  2. 或者调用 build_llm(..., offline_responses=['...']) 走离线模式"
    )
温度我压到了 0.3:面试官要的是"问什么答什么、别自由发挥",追问的多样性靠 prompt 里的考察点列表提供,不靠采样随机性。离线和真实共用同一条调用代码,切换点只有 build_llm 这一处------这是后面每一篇都能离线测试的前提。
八、跑起来:demo 与真实输出
python demo.py(全程离线假模型,接真实模型只需配好 .env):
arduino
──────── 同一句候选人回答,两种人设 ────────
  候选人回答:我用了 synchronized,然后......具体细节我有点忘了。

【一句话人设 · system prompt】
  你是一个面试官。

──────── 离线链路自检(假模型预置回复,模拟两种人设下的典型输出) ────────
  [一句话人设] 没关系,这个问题比较难,你已经回答得很好了!要不要我给你讲讲 synchronized 的原理?加油!
  [完整人设] 这道题你只报了关键词,没有细节。synchronized 加在方法上和代码块上,
             锁的对象分别是什么?只答这一点。
要说明的是:离线自检里两条回复是我预置在假模型里的,它们代表两种人设会把模型推向的两种典型行为------这不是真实模型的输出,但方向和真实模型一致。配好 Key 后你会看到同样的差异:完整人设下它不再安慰你,而是追问细节。
同一份模板换四个岗位的组装结果(demo 打印):
perl
  ▶ Java 后端工程师(java_backend)      system prompt 总长:879 字符,四段结构一致
  ▶ 前端工程师(frontend)               system prompt 总长:859 字符,四段结构一致
  ▶ Python 后端工程师(python_backend)  system prompt 总长:884 字符,四段结构一致
  ▶ 算法工程师(algorithm)              system prompt 总长:879 字符,四段结构一致
九、测试:43 个用例全绿
arduino
tests/test_demo.py::test_demo_runs_offline PASSED
tests/test_demo.py::test_demo_shows_both_personas PASSED
tests/test_demo.py::test_demo_covers_all_positions PASSED
tests/test_demo.py::test_demo_shows_actionable_error PASSED
tests/test_levels.py::test_three_levels_available PASSED
tests/test_levels.py::test_junior_allows_hints PASSED
tests/test_levels.py::test_mid_probes_details PASSED
tests/test_levels.py::test_senior_tests_architecture_and_allows_silence PASSED
tests/test_levels.py::test_unknown_level_raises PASSED
tests/test_levels.py::test_policies_are_distinct PASSED
tests/test_levels.py::test_level_injection_changes_prompt PASSED
tests/test_llm.py::test_offline_path_returns_fake_model PASSED
tests/test_llm.py::test_real_key_path_returns_chat_openai PASSED
tests/test_llm.py::test_real_path_temperature_is_low PASSED
tests/test_llm.py::test_no_key_without_offline_raises PASSED
tests/test_llm.py::test_offline_takes_priority_over_key PASSED
tests/test_llm.py::test_system_prompt_reaches_the_model PASSED
tests/test_persona.py::test_four_sections_present PASSED
tests/test_persona.py::test_position_title_is_injected PASSED
tests/test_persona.py::test_level_policy_is_injected PASSED
tests/test_persona.py::test_tone_changes_style_line PASSED
tests/test_persona.py::test_output_constraints_present PASSED
tests/test_persona.py::test_build_is_idempotent PASSED
tests/test_persona.py::test_unknown_position_raises PASSED
tests/test_persona.py::test_unknown_level_raises PASSED
tests/test_persona.py::test_prompt_lint_passes PASSED
tests/test_persona.py::test_no_curly_braces_left PASSED
tests/test_positions.py::test_at_least_four_positions PASSED
tests/test_positions.py::test_every_position_has_required_fields PASSED
tests/test_positions.py::test_get_position_returns_profile PASSED
tests/test_positions.py::test_unknown_position_raises_with_candidates PASSED
tests/test_positions.py::test_list_positions_matches_dict PASSED
tests/test_positions.py::test_profiles_are_pure_data PASSED
tests/test_positions.py::test_position_titles_unique PASSED
tests/test_rules.py::test_forbidden_word_list_not_empty PASSED
tests/test_rules.py::test_customer_service_phrases_banned PASSED
tests/test_rules.py::test_style_rules_lists_words_in_text PASSED
tests/test_rules.py::test_style_rules_rejects_unknown_tone PASSED
tests/test_rules.py::test_output_constraints_numbered PASSED
tests/test_rules.py::test_lint_passes_on_complete_prompt PASSED
tests/test_rules.py::test_lint_catches_missing_section PASSED
tests/test_rules.py::test_lint_catches_missing_constraint PASSED
tests/test_rules.py::test_lint_catches_empty_word_list PASSED
43 passed
这组测试里我最想让你注意三条:
test_position_title_is_injected:断言"算法工程师"五个字真的出现在组装结果里,防"配了但没生效"。test_profiles_are_pure_data:扫描岗位数据里不许出现"你是""请你",守住配置与模板的边界。test_lint_catches_missing_constraint:故意删掉"不自问自答",断言 lint 能点名抓出来------lint 自己也要被测。
十、踩坑清单
- 人设写成了形容词合集:"语气严厉""专业一点"在模型眼里是零信息量。每一条约束我都逼自己翻译成可执行动作,写完再问一句:这条能被测试断言吗?不能就重写。
- 禁令没有词表:早期只写了"禁止鼓励用语",模型照旧说"没关系"。列了词表后才真正生效------模型需要具体词汇才能执行禁令。
- 把岗位考察点写进了模板字符串:第一个版本就是这么写的,加岗位全靠改代码。拆成 positions.py 之后,"换岗位不改代码"才成立,测试还反过来盯住了这条边界。
- 假模型的记录字段被 pydantic 吃掉 :给 FakeListChatModel 加
calls记录入参,没标 ClassVar,pydantic 把它当成了模型字段,类属性读到的永远是空列表,测试集体翻车。pydantic 模型上挂类级状态,必须ClassVar。 - anyio/langsmith 的 pytest 插件拖慢启动 :装了 fastapi 和 langchain 系的包后,anyio 和 langsmith 会自动注册 pytest 插件,我的机器上启动能拖到分钟级甚至卡死。pytest.ini 里
addopts = -p no:anyio -p no:langsmith_plugin禁掉,测试本身不依赖它们。 - 级别打法写了"难度较高":模型没法执行"较高"。改成三档各自的具体打法(初级给提示、中级追问细节、高级容忍沉默)之后,同一岗位不同级别的 prompt 才有了真正的行为差异。
十一、本篇收尾
现在这个面试官有了四层人设:知道自己是面 Java 后端的考官,知道候选人是什么级别,知道一次只问一个、答错不安慰,也知道哪些词不能说。全部内容都是可打印、可断言、可版本管理的对象------那个"客气客服",被我改造成了真考官。
下一篇开始让它"有状态":用 LangGraph 状态机把整场面试编排起来------开场问什么、答错了怎么追问、问到第几题该收尾,都会变成图上的节点和边,而不是散落在 if/else 里的魔法。
最后一句:模型对"你是一个面试官"的理解,就是一句空话的理解------你给它形容词,它还你客气;你给它规则,它才还你考官。