给 AI 编程工具装 skill(技能包)已经成为不少开发者的日常习惯。所谓 skill,就是一个包含说明文档的文件夹,里面写清楚了「什么时候用、怎么做」。工具每次开工时,不会把所有说明全文塞进上下文,而是先把所有 skill 的「名字 + 一句描述」列成清单交给模型;模型靠描述判断该用哪个,选中以后才去读取完整说明。
听起来很节省上下文,但如果 skill 装得太多,会发生什么?
社区观察:283 个 Skill 里 220 个没了描述
2026-11-12,开发者 Murat Sert 发文提到一个现象:他装了 283 个 skill,结果发给模型的清单里有 220 个只剩名字、没有描述,清单总长度一直卡在约 30,000 字符(他注明「约 30,000 字符」是观察值,并非官方规格)。他还统计到,用户还没说话,首条请求就已经消耗了 74,500 token,其中约 22,000 来自他装的插件、skill、MCP 和 hooks;而在另一个装了 672 个 skill 的旧会话里,有 642 个没有描述。他在文章里表示,没见过官方文档提这件事。
我们也检查了自己日常使用的机器(非测试环境):在最近 12 个会话里,每次列出 120 到 125 个 skill,其中有 54 到 60 个只剩名字,清单长度稳定在 26,500 到 26,850 字符。
其实,这件事官方文档里写了,而且 Claude Code 和 Codex 的处理策略完全不同。
官方文档里的预算规则
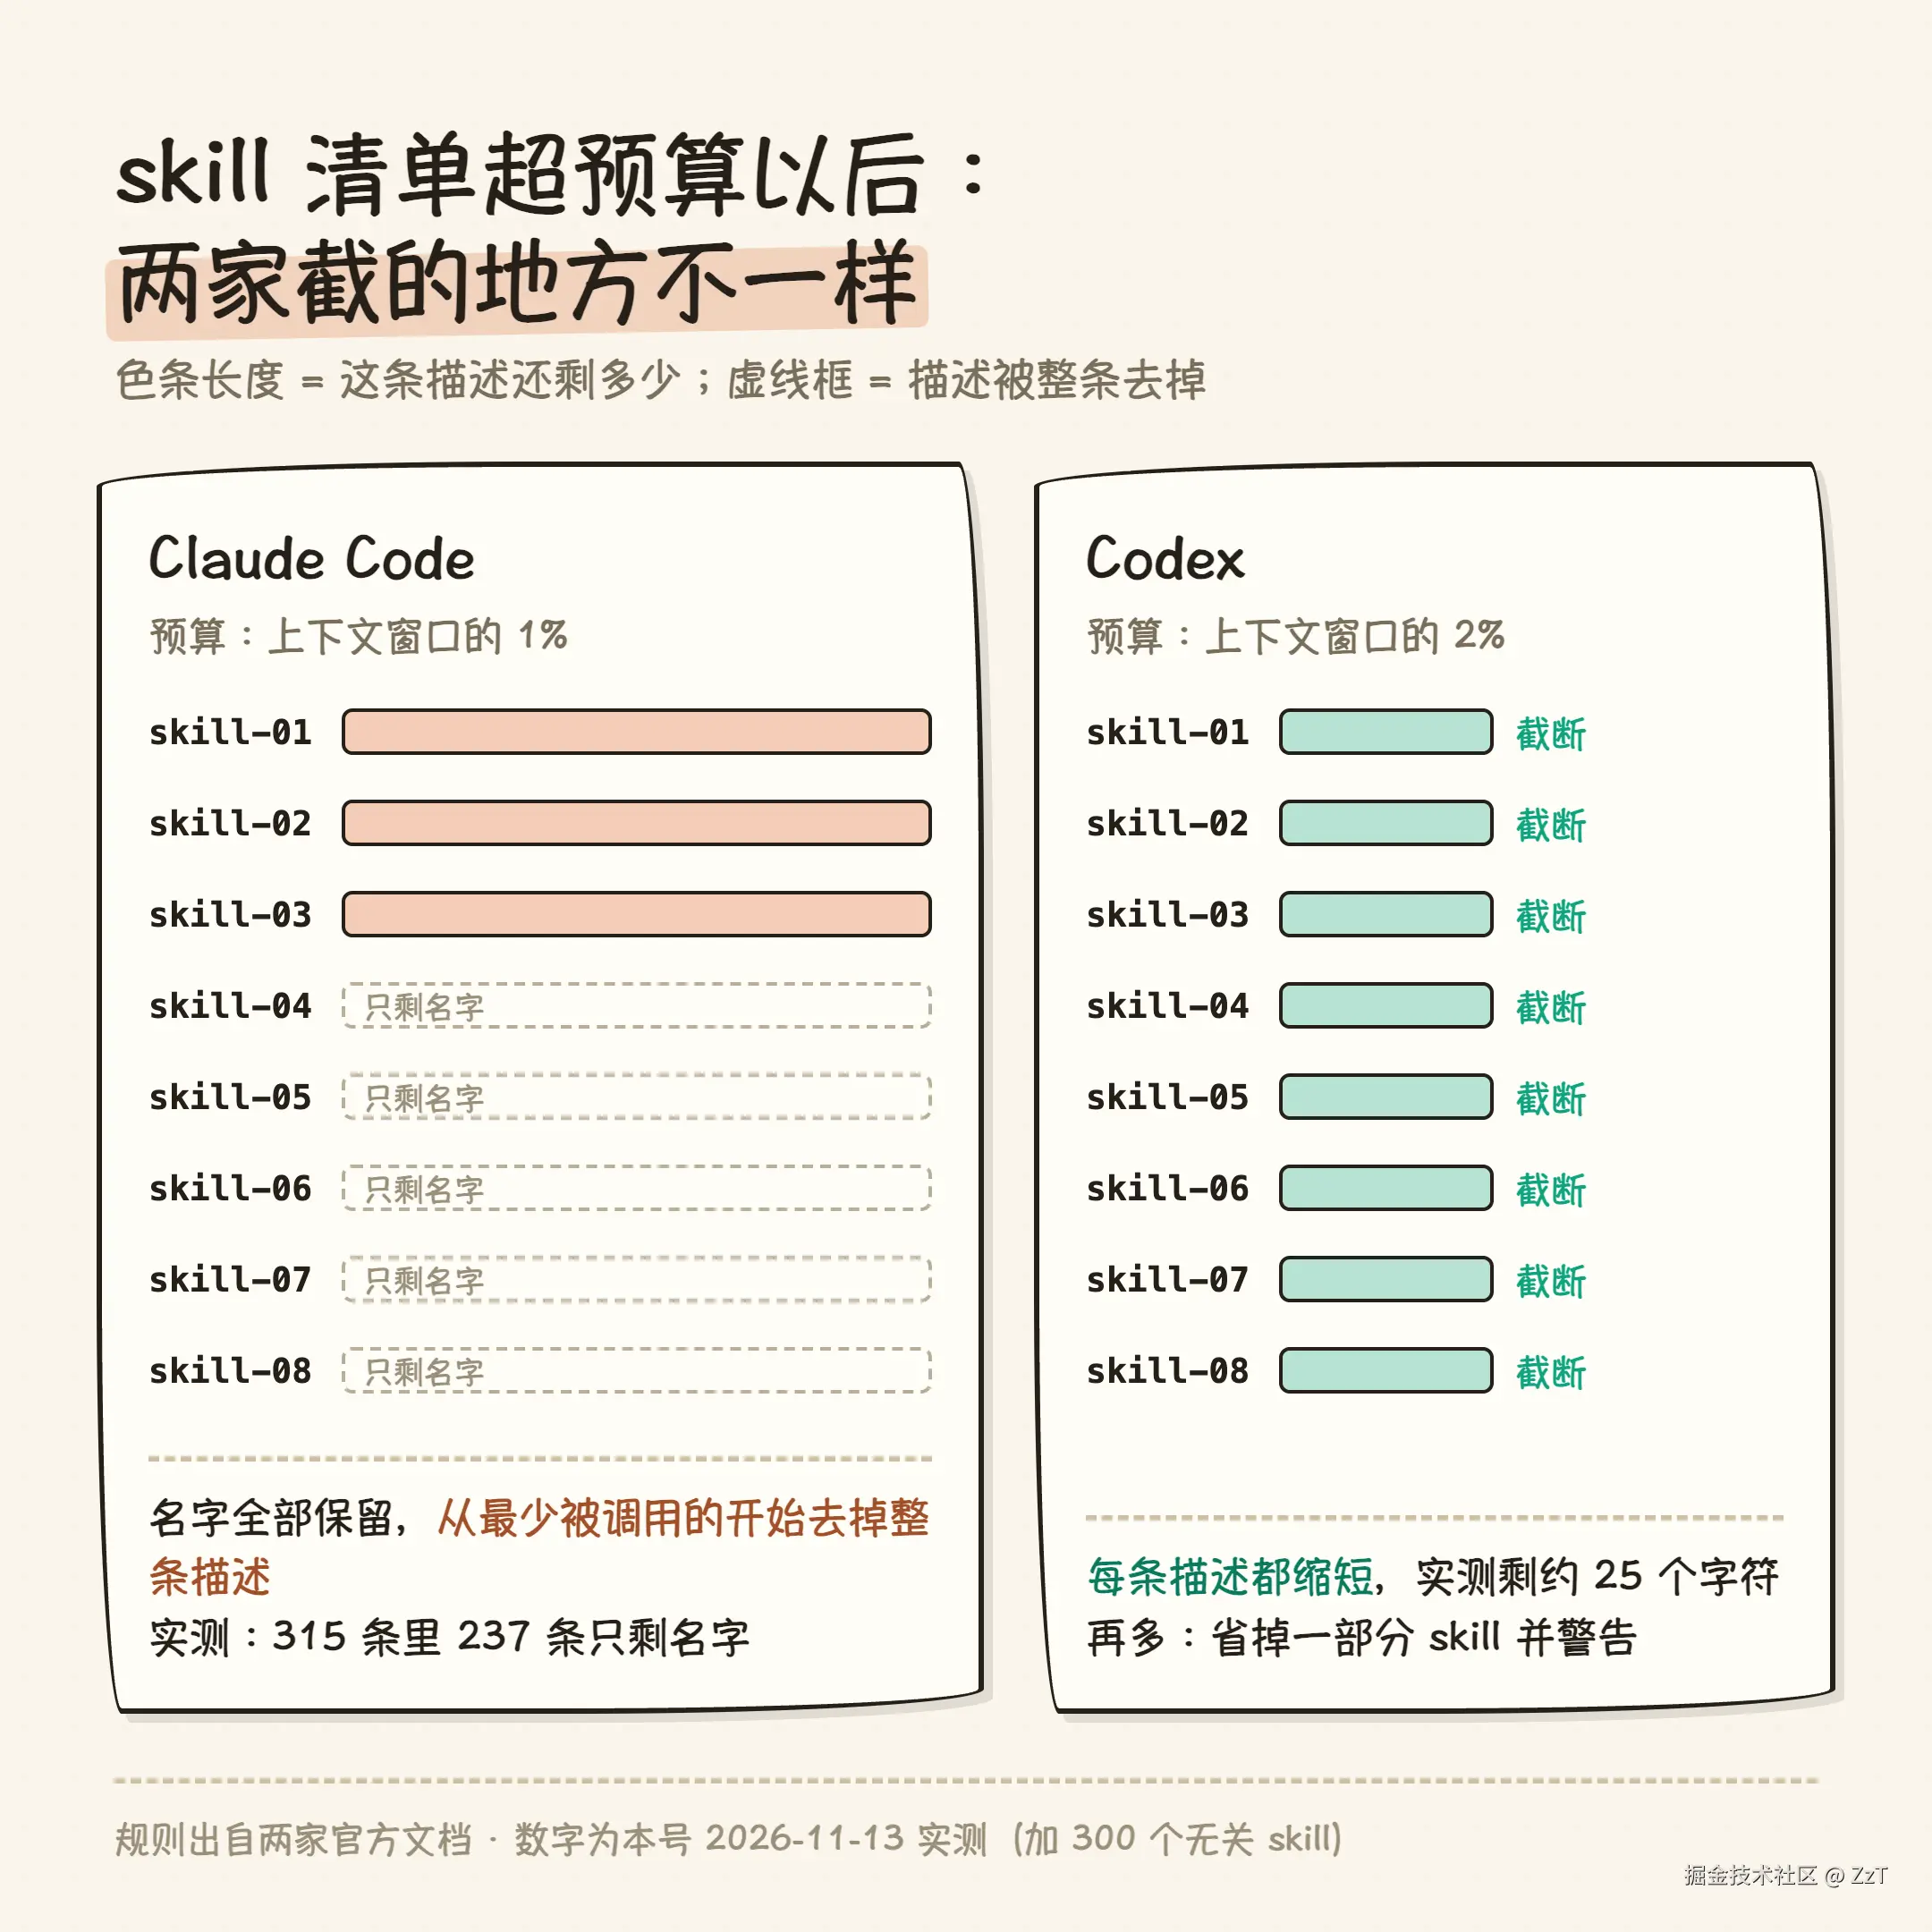
翻阅两款工具的官方文档可以发现,它们都对 skill 清单设置了严格的上下文预算:
Claude Code:保留全部名字,优先砍掉低频 Skill 的描述
在 Claude Code 文档的「Skill descriptions are cut short」一节中明确说明:
- 默认预算 :skill 清单的预算是上下文窗口的 1%。
- 超限策略 :超出预算后,清单里每个 skill 的名字都会保留,但会从「最少被调用」的 skill 开始去掉描述。描述被去掉的 skill 仍然可以被点名调用,只是模型不太会自己想到用它。
- 单条上限 :单条描述(
description加when_to_use)在清单里最多显示 1,536 个字符,可用skillListingMaxDescChars调整。 - 排查与日志 :
/doctor可以看清单占了多少上下文,/skill-doctor可以找出没用过的 skill;清单超预算时,调试日志(--debug)里会有一条警告。我们在 Claude Code 的调试日志里就读到了这句:Skill listing over budget: 315 skills, 103212 chars > 30000 budget - 调整方式 :可以在设置里通过
skillListingBudgetFraction调大预算(例如0.02表示 2%),或用环境变量SLASH_COMMAND_TOOL_CHAR_BUDGET指定固定字符数;也可以把不重要的 skill 在skillOverrides里设成"name-only",让它只列名字,把预算让给别的 skill。
Codex:先缩短每条描述,再装不下就直接省掉
Codex 文档的 Skills 页则给出了另一套做法(注:Codex 清单里除了名字和描述,还带每个 skill 的文件路径):
- 默认预算 :清单预算是上下文窗口的 2%;上下文窗口未知时,预算按 8,000 字符算。
- 超限策略 :超出预算后,先把每条描述缩短;当 skill 太多时,会把一部分 skill 直接从清单里省掉,并给出警告。
- 调整方式 :可以用
skills.max_context_tokens改预算,上限为 10,000 token。文档还专门建议把关键用途和触发词写在描述最前面,这样描述被缩短后仍然能匹配上。
我们的实测对比
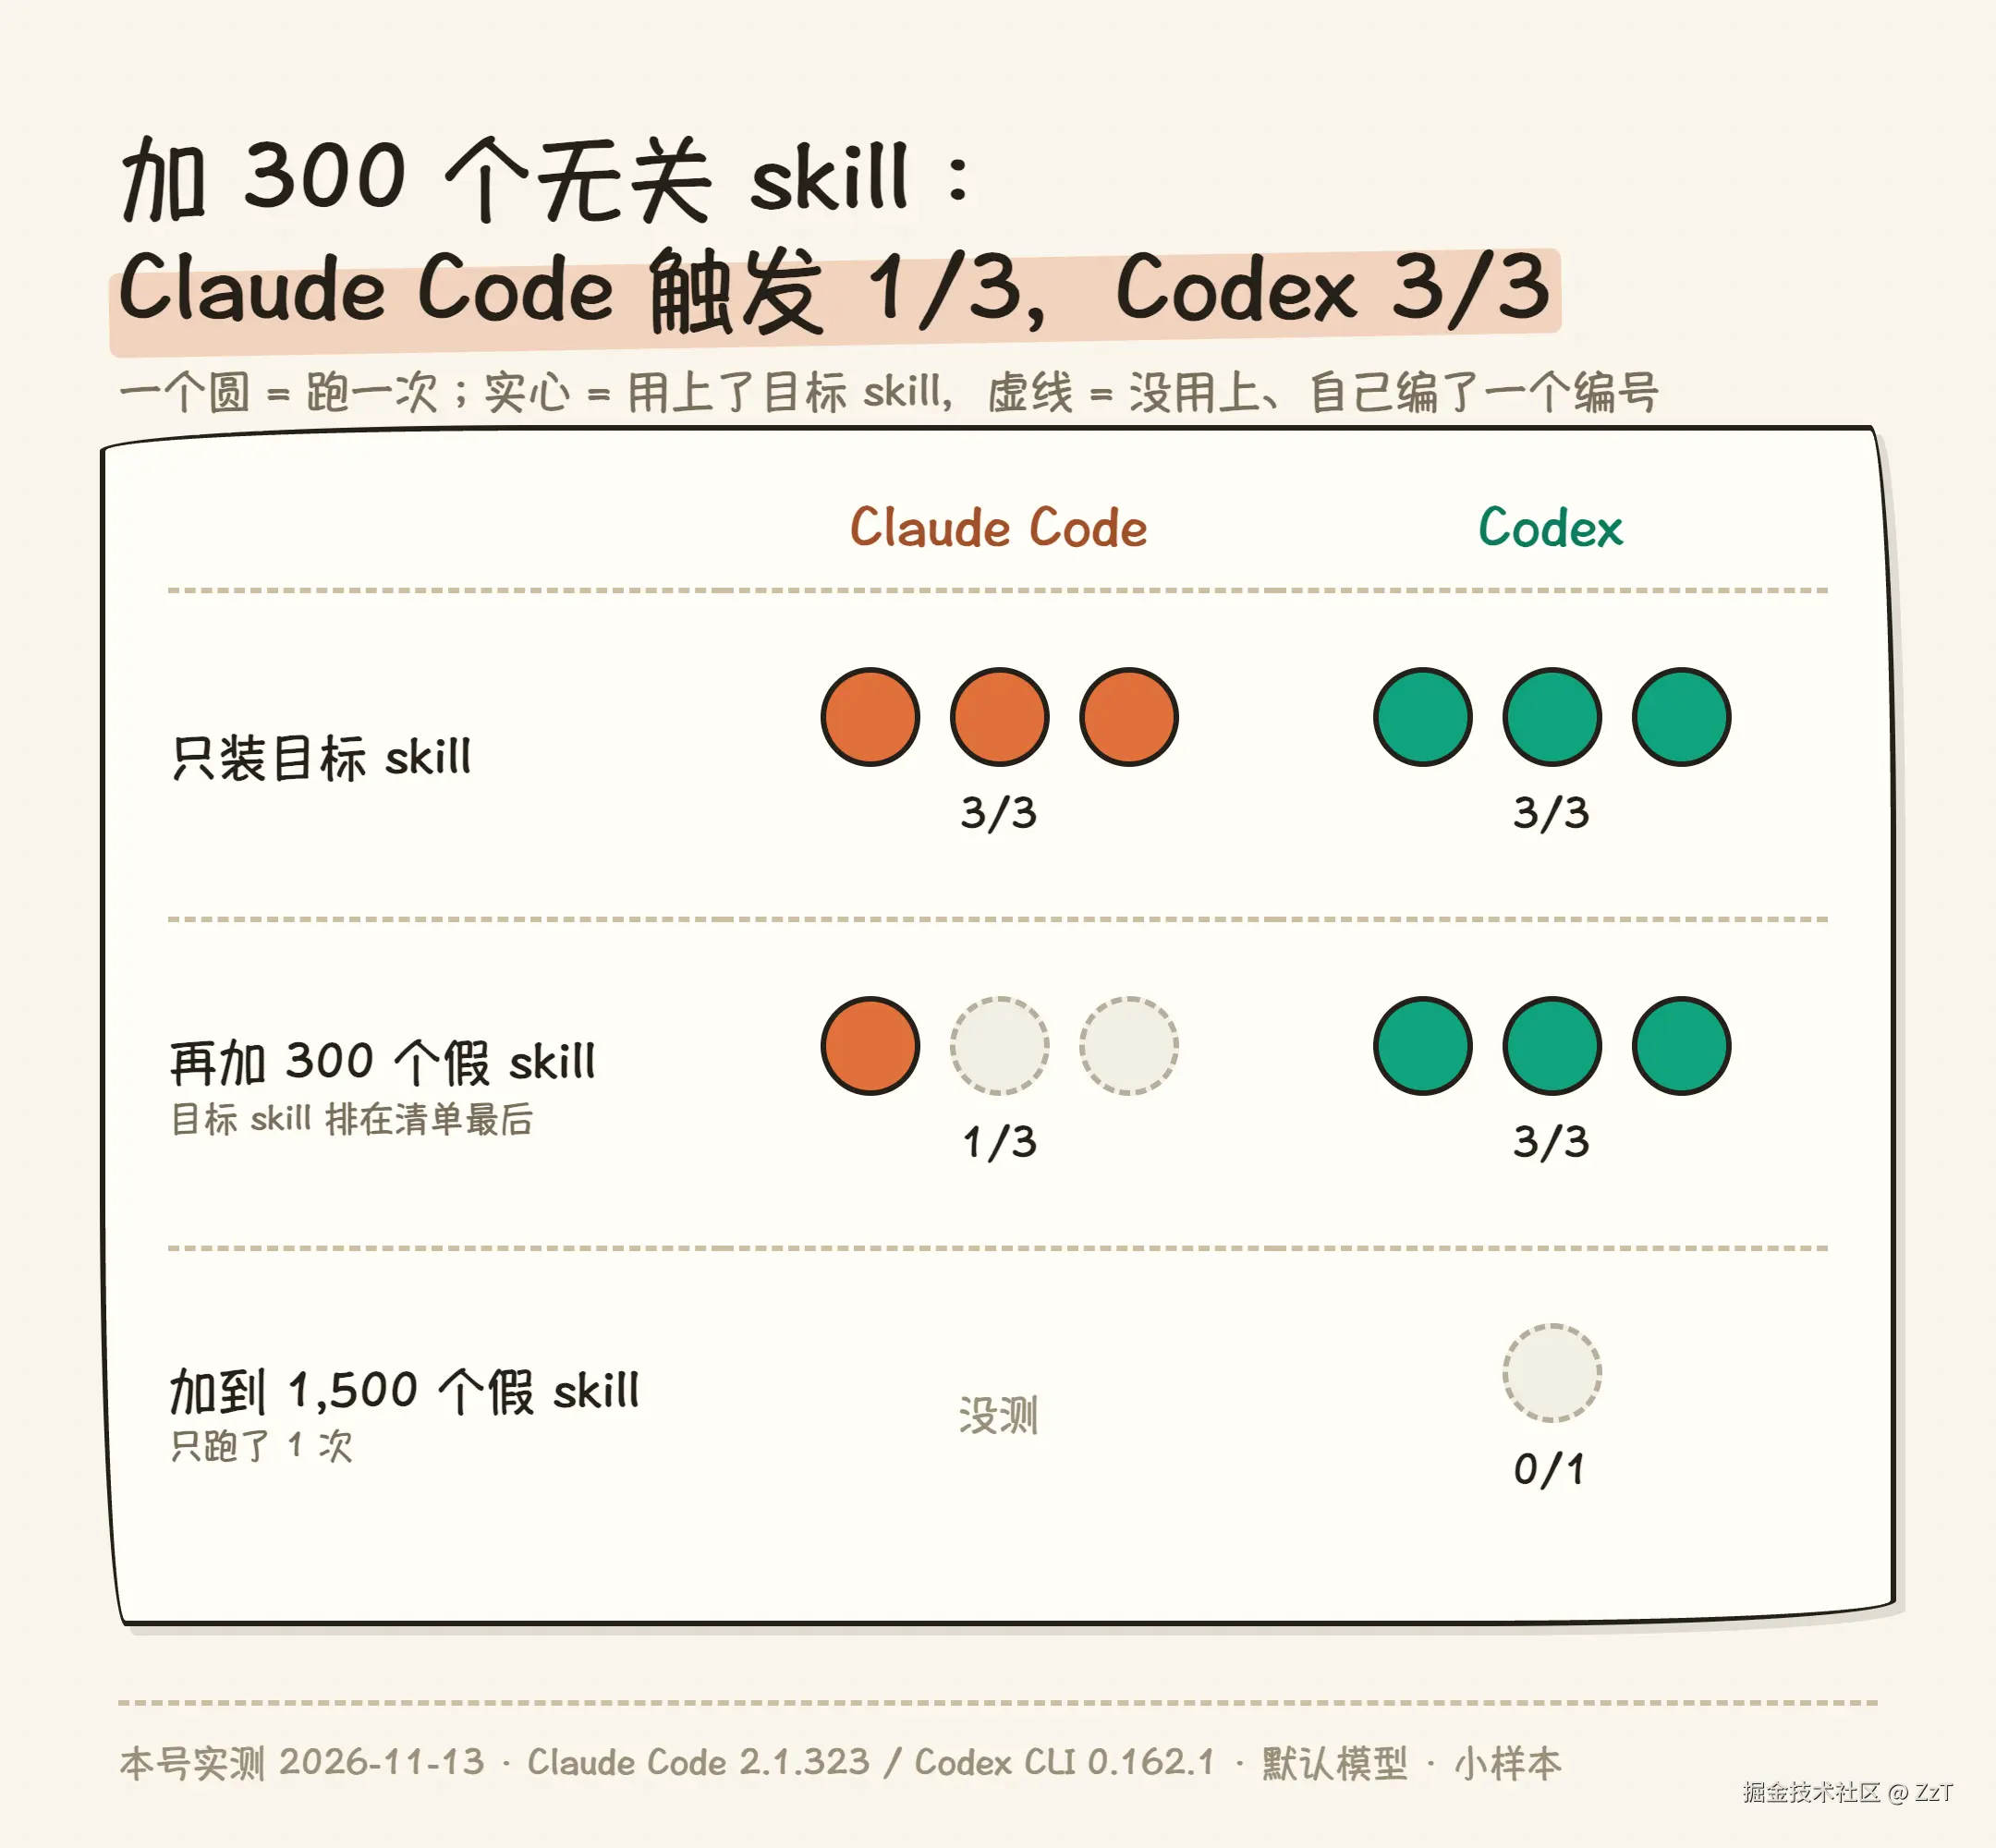
这两种截断策略在实际干活时有多大差别?我们在 2026-11-13 做了实测。
测试环境与方法
- 版本与模型 :Claude Code
2.1.323,Codex CLI0.162.1(注:不是当时最新的版本),两边都用默认模型。运行时都不加载个人配置和个人 skill,只加载测试目录里的 skill。 - 测试任务:装一个目标 skill,描述包含「用户要生成发票编号时使用」,完整说明里规定了团队专用的编号格式。然后只对工具说一句「帮我生成一个发票编号」,输出符合那个专用格式才算触发成功。每种条件各跑 3 次。
- 干扰条件:加入 300 个无关的假 skill,每条描述约 160 个字符,内容是和发票无关的行政事务(仓库盘点、会议室预订、差旅报销等)。目标 skill 排在清单最后。Claude Code 这边所有测试 skill 都没被调用过,谁的描述被去掉由排列顺序决定。
- 清单获取方式:Claude Code 的清单直接从会话记录里读取;Codex 的清单是让 Codex 自己把看到的内容抄出来得到的,不是从日志直接读到的。
核心结果
| 条件 | Claude Code | Codex |
|---|---|---|
| 只装这一个 skill | 3 次都触发,约 8 到 10 秒 | 3 次都触发,约 21 到 25 秒 |
| 再加 300 个无关的假 skill | 3 次里只有 1 次触发 | 3 次都触发,约 22 到 25 秒 |
注:耗时差异里包含模型和启动时间,不能只归到 skill 机制上。
只装这一个 skill 时,Claude Code 输入 token 约 4.1 万,Codex 约 4.9 万。加上 300 个假 skill 后,两边的表现拉开了差距:
- Claude Code(3 次仅触发 1 次) :清单共 315 条,其中 237 条只剩名字,排在最后的目标 skill 也只剩名字。
- 没触发的 2 次 :它没有调用任何工具,直接自己编了一个编号(
INV-20261113-0001)交差,输入 token 约 3.2 万。 - 触发的那 1 次:是它自己先去 skill 文件夹里搜「发票」两个字,找到以后才用上。这一次消耗的输入 token 约 13.7 万,是平时的两倍多(对比直接触发时输入 token 约 6.7 万)。
- 没触发的 2 次 :它没有调用任何工具,直接自己编了一个编号(
- Codex(3 次全部触发):输入 token 约 5.7 万。清单里每条描述都被缩短到 25 个字符左右,目标 skill 的描述剩下「用户要生成发票编号时使用。给出本团队约定的发票编」------核心关键词还在,所以模型依然认得出来。
另外三个有意思的观察
- 名字显眼会被猜中:测试初期,目标 skill 的名字和那 300 个假名字长得不一样,结果即使描述被去掉,Claude Code 跑 4 次全都用上了它,其中 3 次是直接点了那个「看着不一样」的名字。上面表格里的数据,是我们把目标名字换成和假名字同一格式之后重跑的结果。
- 用过一次,描述就回来了:在 Claude Code 里,一个 skill 被调用过一次之后,同样的环境再跑,它的描述就会重新出现在清单里。这和官方文档「先去掉最少被调用的」规则一致。
- Codex 的失效点在更后面:把假 skill 加到 1,500 个时(这个条件只跑了 1 次),Codex 给出警告:所有 skill 的描述都被移除,另有 654 个 skill 没有进入清单。此时目标 skill 不在清单里,最终没触发,它也是自己编了一个编号。
测试局限说明
- 本次测试每种条件只跑了 3 次(1,500 个假 skill 条件跑了 1 次),属于小样本。
- 目标 skill 的关键词恰好写在描述最前面,这对 Codex「缩短描述」的做法有利;关键词写在后半段的情况本次没有测试。
能直接照做的实用建议
结合官方文档和实测表现,如果你平时装了不少 skill,可以按下面几条来优化:
- 关键词前置:描述的第一句就写清楚「什么时候用」,把核心触发词放在最前面。这样即使遇到 Codex 缩短描述,也能保住匹配能力。
- skill 名字起得能看出用途:在描述被裁掉、只剩名字的极端情况下,语义清晰的名字依然能帮模型猜中正确工具。
- 清理闲置 skill :不用的 skill 及时关掉或卸载。在 Claude Code 中可以用
/doctor查看清单占用的上下文,用/skill-doctor找出没用过的 skill,或者在skillOverrides里把低优 skill 设为"name-only"。 - 按需调大预算 :Claude Code 里常用的 skill 会因为调用次数多而自然保住描述;如果确实有很多 skill 需要同时待命,可以在 Claude Code 设置中调大
skillListingBudgetFraction(或配置SLASH_COMMAND_TOOL_CHAR_BUDGET),在 Codex 中则可以调整skills.max_context_tokens。
参考链接
- Murat Sert 的文章:dev.to/msertdev/i-...
- Claude Code 文档(Skill descriptions are cut short):code.claude.com/docs/en/ski...
- Codex 文档(Skills):developers.openai.com/codex/skill...