第 2 篇 · 整体架构蓝图:六层依赖与技术选型
《从零造一个影片推荐智能体》系列 · 第 2 篇 / 共 10 篇 上篇撂下一句「没有最完美的架构,只有最贴合当前场景的取舍」,这篇就来还债------把那张地图摊开。
前言
第 1 篇结尾我说,这张地图具体怎么画、六层怎么摞、请求从 HTTP 进来怎么一路走到结构化结果,是下一篇的事。今儿就还这笔债。
写业务代码有个很容易上头的坑:一想清楚「要做个推荐 Agent」,手就痒,先 pip install,再顺手建几个包,边写边改目录。我见过太多项目(自己以前也没少干)最后是这么烂掉的------utils.py 里塞了数据库连接,api/ 反过来 import 了 agent/ 的内部函数,改一个召回权重得翻五个文件。等到想加个缓存,发现根本没地方下嘴。
所以这个项目的第一步,我硬是按住没写代码,先花了几天画一张图。今天真正要摊开的,是本篇的主角 -- 一张「谁依赖谁」的分层图,外加三个「把变化关进笼子」的开关。
(这张不写「图片来自于网络」了,是照着自己代码画的,凑合看,手动狗头。)
一张图看懂系统:六层依赖总览
先把最干的那行贴出来,README 第 1 节就这一句:
arduino
api/ → agent/ → retrieval/ + ranker/ → vector/ + graph/ → etl/ + db/ → config/ + llm/ + data/六个箭头,读法是「谁调谁」:api 调 agent,agent 调 retrieval 和 ranker,往下点到向量库和图谱,再往下是 ETL 和数据库,最底下垫着 config / llm / data 这层基础设施。只有上层能调下层,下层绝不许回头 import 上层 ------编码规范里写死了这条,循环依赖就用 retriever / factory 这种中间层去解,不许硬缠。
我喜欢把它想成一叠盘子:你只能从顶上往下拿,不能把最底下那只抽出来还不碰上面的。听着是句废话,可真到赶进度的时候,最容易被打破的就是它。
那「六层」具体是哪六层?架构方案里是这么切的(自顶向下):
- 应用/接口层:Web/对话 UI + FastAPI(REST / WebSocket 流式)
- Agent 编排层:LangChain(LCEL) 链 + LangGraph 有状态多步流程
- 推荐引擎层:召回 → 排序 → 重排
- 知识/特征层:Chroma(向量)/ Qdrant / Neo4j* / MySQL(结构化)
- 数据接入层 :
douban_main/imdb_main+*_relate+*_text- 基础设施:Redis / Ollama / LangSmith /(部署期)容器编排
数据流顺着这六层走一遍:双源 MySQL → 特征(向量 / 图)→ 召回 / 排序 / 重排 → LangGraph 驱动的多步 Agent → 一份带解释的推荐。
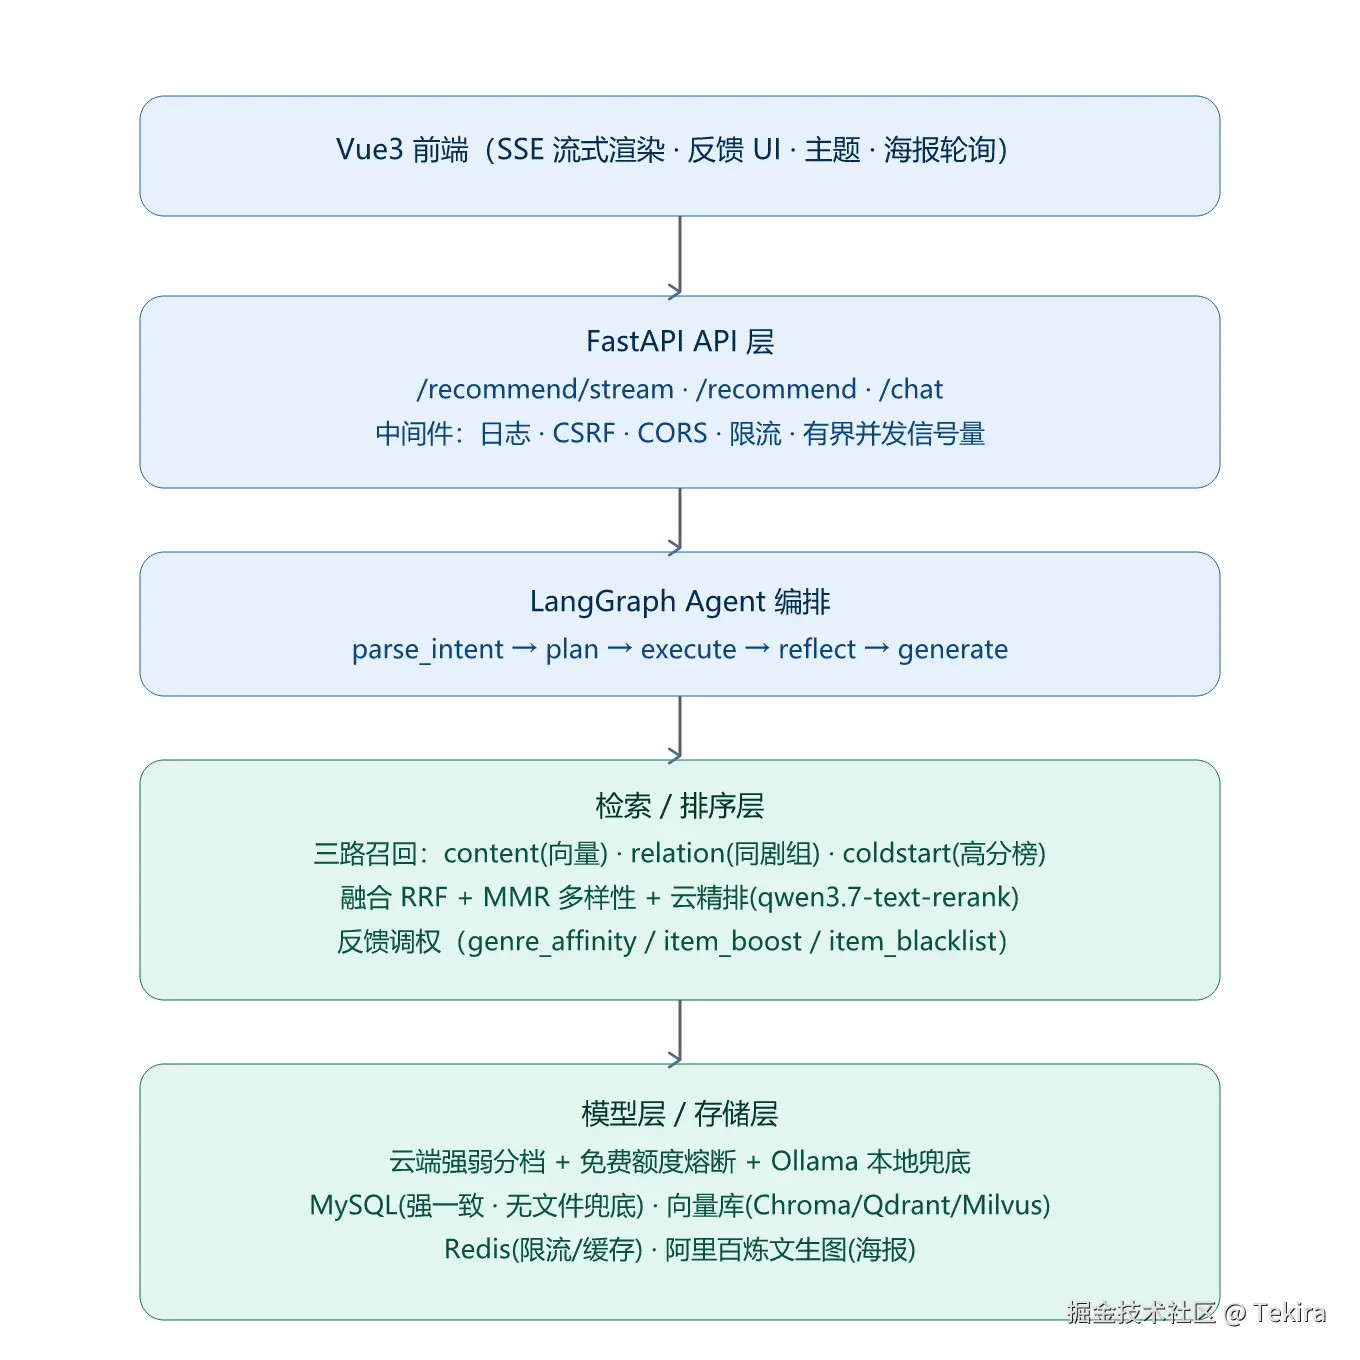
上面这张 diagram_architecture.svg 是照代码画的,从上往下五个方块:Vue3 前端 → FastAPI → LangGraph Agent → 检索/排序 → 模型/存储。前端把 SSE 流式渲染、反馈 UI、主题、海报轮询都包了;API 层挂着一串中间件;再往下就是引擎和存储。
眼尖的可能已经发现了:文档写六层,图里怎么只有五块,README 那行又是六个箭头? 别急,这个「自己人打自己人」的口径问题,我放到「疑点」里专门交代,先按下不表。
为什么是 LangGraph,而不是裸 LangChain
先说 LangChain 本身。它的 LCEL 写法确实舒服,prompt | model | parser 一根链子串到底,像一条传送带:料从这头进去,成品从那头出来,中间不拐弯。
问题就出在「不拐弯」。
推荐这事儿的真实过程不是一条直线。用户说「推荐一部太空科幻片」,系统得先认意图 (这是要推荐,不是要解说、也不是记偏好),再规划 用哪几路召回,然后执行 去查库,查完还得反思 一下:候选够不够?不够 5 条得自动补高分榜兜底,别给人返回个空列表;最后才生成 那段「为什么推这部」的解说。这里有分支,有需要一路带着走的状态(意图、候选集、步骤记录);至于「查不够就补」这个看着像回环的动作,其实不在图上画回边,而在 reflect 节点内部------这点我下面马上说准。
一条传送带干不了这个。这时候 LangGraph 就上场了------agent/graph.py 里 build_agent() 用 StateGraph 把五个节点串起来:
scss
parse_intent(LIGHT) → plan → execute → reflect → generate(STRONG)五个节点之间是一条直线 add_edge 串到底,没有条件路由 ,状态也不靠 LangGraph 自己存------g.compile() 是裸编译,压根没接 checkpointer(会话和偏好各落在 MySQL 业务表里,第 5 篇讲,图只在单次请求内活着)。那「立交桥」的比喻还成立吗?成立,但得说准:LangGraph 给的不是「图的回环」,而是带状态的节点 ------AgentState 用 reducer 把意图、候选集、步骤记录一路累积着带下去;而「货不够就补一趟」这个分支,是 reflect 节点内部 的条件逻辑(候选够 5 条就 return {} 跳过,不够就拉高分榜兜底),不是画在图上的掉头口。这点我钻进第 3 篇引擎时会再撕开讲,先记一句:图是直的,拐弯在节点里。
通俗的理解:LCEL 是一条传送带,LangGraph 是带「可累积状态 + 节点内红绿灯」的立交桥------车(状态)能一路带着货走到质检口(reflect),发现「货不够」就现场补一车,再继续往前。
但这里有个我特别想说的决策,也是全篇最值钱的一句:这五个节点里,只有两头(意图识别、文案生成)用了 LLM,中间 plan / execute / reflect 全走确定性逻辑。
为啥?因为本地小模型做工具调用会抖。你让它自己决定「调 search_by_text 还是 search_by_person」,它今天给你选 A、明天给你选 B,还时不时吐个格式不对的 JSON,排查起来想撞墙。把规划、执行、兜底这些「不能错」的环节收回到确定性代码里,只把「理解人话」和「写文案」这两件机器确实比人强的事交给大模型------既留住了推理能力,又保住了结果稳定可复现。这个取舍,后面第 3 篇钻进引擎时会反复吃到它的红利。
(LlamaIndex 当时也看过,定位是纯 RAG 检索增强的补充,可选;这场景是「对话即检索」,天然更贴 Agent,就没上。对 LlamaIndex 我不算熟,就不掺和了。)
存储选型:Chroma 当下,Qdrant / Milvus 未来
向量库这块,开发期我给自己立了条规矩:纯本地直装、无 Docker。容器和集群那些,等真上线再说,开发期一个都不许冒出来。
主选 Chroma,理由很朴素------pip install chromadb 之后 PersistentClient(path=...) 直接进程内落盘,不用起服务、不用装 Docker ,一个 ./data/chroma 目录就是整个库。开发期要的就是这种「零运维」。
但选它不代表把路堵死。最早规划时,Qdrant 只是个「扩展预留桩」,Milvus 更狠,标的是「超大规模预留」------说白了当时都没实现,先在 vector/backend.py 里挖好坑:
python
from abc import ABC, abstractmethod
class VectorBackend(ABC):
    @abstractmethod
    def add(self, ids, vectors, docs, metas): ...
    @abstractmethod
    def search(self, vec, top_k, filters=None): ...
class ChromaBackend(VectorBackend): ...
class QdrantBackend(VectorBackend): ...   # 当时:留桩
def get_vector_backend():
    return ChromaBackend() if settings.VECTOR_BACKEND == "chroma" else QdrantBackend()
回来主题 ,这看着平平无奇的四行,其实是本篇的真正主角之一:VectorBackend 抽象 + VECTOR_BACKEND 工厂。业务代码(build_vectors.py、content_recall.py)只知道「有个能 add / search 的东西」,至于是 Chroma 还是 Qdrant,改个配置就换,业务层零改动。
如今 Qdrant 和 Milvus Lite 都已做成可运行的本地嵌入式实现(从当初的「预留桩」转正),还顺手加了个云端嵌入开关 EMBED_PROVIDER,嵌入源(本地 bge-m3 / 阿里百炼 qwen3.7-text-embedding)× 存储后端(Chroma / Qdrant / Milvus)= 2×3 六种组合,全实测可用。三后端在 1134 条样本上的导入吞吐和查询延迟长这样:
| 后端 | 1134 条写入 | 导入吞吐 | 单条查询(top-10) |
|---|---|---|---|
| Chroma | ≤2.5 s | ~500+ vec/s | ~10--30 ms |
| Qdrant(嵌入式) | 7.20 s | 157.5 vec/s | ~23--25 ms |
| Milvus Lite | 1.90 s | 596 vec/s | ~39--59 ms |
结论也有点反直觉:本地嵌入式场景下 Milvus Lite 写入最快、Chroma 查询最稳,三家延迟同量级(都亚百毫秒),Demo 期谁上都够。所以先 Chroma 不是因为它最强,是因为它最省事------这又是第 1 篇那句「没有最完美,只有最贴合当前阶段」的一次具体兑现。
坑也得记一笔:文档示例写 chromadb>=0.5,实际装的是 1.5.9 ,结果踩到 list-valued metadata 的 where 等值过滤(genres_list)实测不生效 ,只有标量(country/year/rating/source)正常。解法不优雅但有效:类型这种多值字段改应用层过滤------先标量召回放大候选,再按 meta 包含关系筛。这种「理想是声明式过滤,现实是先捞回来自己筛」的落差,文档里不写,只有真跑过才知道。
顺带答一个常被问的:为啥不把向量直接塞进 MySQL?现在的分工是 MySQL 出语料、专业向量库存向量 。MySQL 本身不存向量,因为 ANN 索引和过滤能力还是专业库完备;MySQL 9.0 有 VECTOR 列 + HNSW 索引,等升了 9.0 再评估,当前是 8.x,JSON 存向量 + 应用层暴力算在百万级直接不可用。少一个组件是诱人,但不是现在。
LLM 双轨:本地 Ollama 与云端 OpenAI 兼容的分工
模型这层和向量库是同一个套路,连开关的命名都对称:LLM_PROVIDER=ollama|cloud,默认 ollama(本地优先)。
- ollama 模式 :
ChatOllama,本地deepseek-r1:7b,强制think=False------这模型爱吐<think>...</think>推理标签,不strip_think()一下,JSON 解析和答案展示全是脏的;- cloud 模式 :
ChatOpenAI打 OpenAI 兼容端点,改CLOUD_LLM_BASE_URL+CLOUD_LLM_API_KEY就切过去,业务层(agent / retrieval / ranker)零改动。
再往里一层是强弱分档,这个先亮个名字、不展开(降级 / 熔断 / 本地兜底留第 4 篇,那才是它的主场):
- STRONG:解释 / 对话 / 工具调用,主力解释型模型;
- LIGHT:意图分类 / 工具路由 / 重排打分,要的是低延迟。
llm/client.py 统一出口 chat_strong() / chat_light(),llm/factory.py 返回 BaseChatModel。业务层压根不知道背后是本地 Ollama 还是云端哪家、也不知道今天是哪个模型在干活------它只管 .invoke()。
写到这里,本篇的「本质」其实已经浮出来了。向量库有 VECTOR_BACKEND,嵌入有 EMBED_PROVIDER,LLM 有 LLM_PROVIDER------三个开关,一个套路:面向接口编程,把「会变的东西」全挡在业务代码外面。现在多写二十行抽象,将来换供应商、上集群、切云端,业务层一行不动。这不是炫技,是被「开发期纯本地、上线全上云」这种前后差异逼出来的活路。
实话实说,这套抽象有 YAGNI(「你不会需要它」)的嫌疑,我在写的时候也嘀咕过是不是过度设计。但向量库这块已经吃到回报了:Qdrant / Milvus 从桩转正,业务代码真的一个字没改。值不值,见「疑点」。
请求时序:一次推荐怎么走过这六层
分层是骨架,得让一次真实请求在里头跑一遍才有血肉。diagram_request_sequence.svg 画的就是这条链,从浏览器到异步海报,五步:
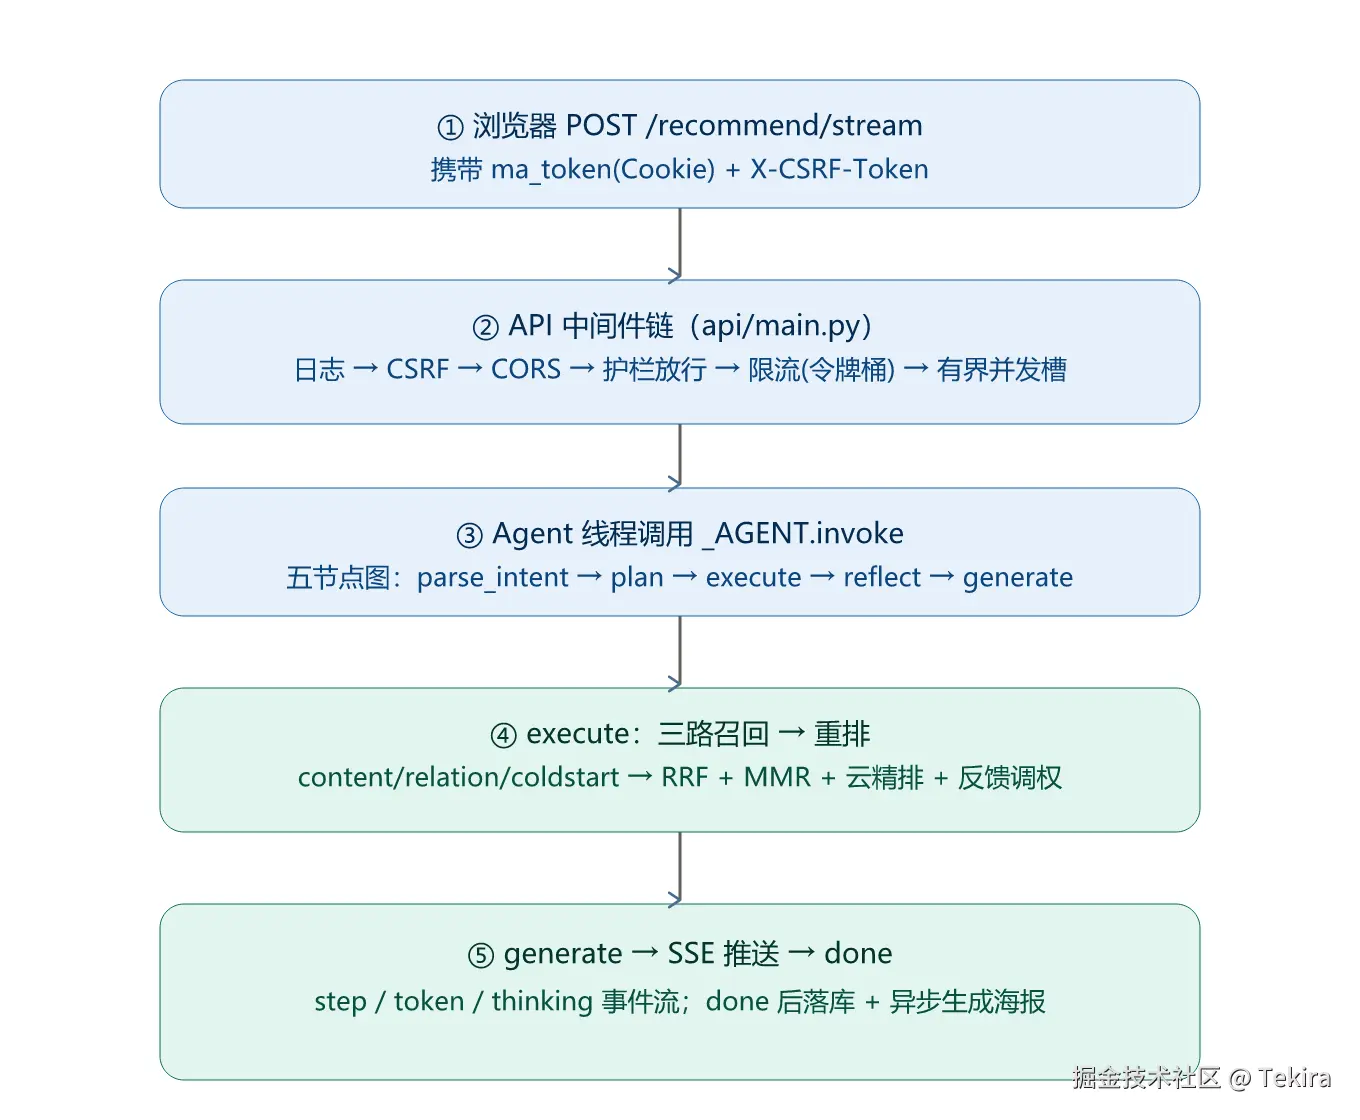
① 浏览器
POST /recommend/stream,带上ma_token(Cookie)+X-CSRF-Token② API 中间件链(api/main.py):日志 → CSRF → CORS → 护栏放行 → 限流(令牌桶) → 有界并发槽 ③ Agent 线程_AGENT.invoke:五节点图跑起来 ④execute:三路召回 → RRF 融合 + MMR 多样性 + 云精排 + 反馈调权 ⑤generate→ SSE 推step/token/thinking事件 →done落库 + 异步生成海报
这里得插一句订正:这张时序图我第一版画反了------手一顺把「护栏放行」甩到了链尾。后面对着 api/main.py 的 _run() 一查,护栏其实是锁之外的第一道闸门 ,限流又排在它放行之后、锁之前,源码注释写得直白:「放在锁之前------否则排队中的请求都占锁等待,限流失去意义」。所以正确顺序是「护栏 → 限流 → 并发槽」,图已经照代码改过来了。顺带较个真:严格说日志 / CSRF / CORS 才是 app 级中间件,护栏 / 限流 / 并发槽是 _run() 处理函数里的内部闸门,图为了一根链画全给并进同一框了。这毛病跟前面「六层 / 五块」是同一类:代码才是准绳,画图前先拿源码对一遍。
把它想成过五关:先过前端到 API 的常规安检(日志 / CSRF / CORS),接着护栏这道合规闸门先验明正身,再看限流名额够不够,最后才轮到抢并发槽叫号;叫到号才轮到 Agent 这个「大脑」开工,大脑派单给三路召回(引擎层),文案生成完一边往前端流式吐 token,一边顺手把海报排进后台队列。
这里藏着三个「闸门」的先后,是整套服务的保命线,得说清楚:
- 护栏在锁之外判定 :
agent/guardrail.py在_run()入口、锁之前 就判。敏感词硬拒答、越域闲聊软引导回影视,命中就返回,intent=guardrail------不进 Agent、不调 LLM、零额度;- 限流只对真 LLM 调用扣令牌 :
api/ratelimit.py的令牌桶按user_id隔离,缓存命中、护栏拦截都不计,只有真要进 Agent 烧钱那一下才扣------最贵的资源才被限;- 有界并发槽 :
_AGENT和云端 LLM 客户端不是并发安全的,实测并发请求能把 worker 打挂(连接被重置),所以用有界信号量串行化,超过 30 秒拿不到槽直接 503。
一句话串起来:先白嫖规则挡掉不该来的,再对真正烧钱的请求限量,最后给并发兜底。护栏这道「合规第一道闸门」第 8 篇会专门拆,限流和单飞第 6 篇细讲,这里只标个位置,不抢后面篇幅。
模块地图:各目录一句话
地图画完,把每个「房间」挂牌,方便第 3--8 篇按图索骥:
| 目录 | 一句话职责 |
|---|---|
api/ |
FastAPI 对外,REST / SSE / 鉴权 / 限流入口 |
agent/ |
LangGraph 编排、工具集、记忆、RAG 解释 |
retrieval/ + ranker/ |
多路召回 + 融合打分 + 重排 |
vector/ |
嵌入客户端 + VectorBackend 三后端 |
graph/ |
关系图谱召回(多跳 BFS,生产可换 Neo4j) |
etl/ |
双源抽取 · 清洗 · 拼可嵌入语料 |
db/ |
与 MySQL 的唯一交道处,DAO / ORM |
config/ |
settings.py 单例 + 类型映射 |
llm/ |
client.py + failover.py,屏蔽强弱分档 |
data/ |
本地落盘(chroma / 缓存 / 日志),全 gitignore |
scripts/ + tests/ |
运维与验证,不进业务调用链 |
看到没,第 3 篇钻 agent/ + retrieval/ + ranker/,第 4 篇钻 llm/,第 5 篇钻 db/ + vector/ + etl/,第 6 篇回到 api/------这篇的每一层,后面都有一篇给它开膛。这就是为什么我宁可先花几天画图也不急着写代码。
疑点
画图这活儿,最怕自己觉得门儿清、别人一看全是问号。挑四个我当初真卡过的,替你问出来。
问:架构文档写六层,架构图只画五块,README 又是六个箭头------到底几层?你们自己人对不上啊。 答:......被你抓到了,这三份确实各说各话,但没打架,是「从哪个角度切」的区别。摊开对一下:
| 架构图(5 块) | 文档(6 层) | 代码依赖链(6 组) |
|---|---|---|
| Vue3 前端 | 应用/接口层(UI) | frontend/ 独立,不在链里 |
| FastAPI API 层 | 应用/接口层(服务) | api/ |
| LangGraph Agent | Agent 编排层 | agent/ |
| 检索 / 排序层 | 推荐引擎层 + 知识/特征层 | retrieval/+ranker/ + vector/+graph/ |
| 模型 / 存储层 | 数据接入层 + 基础设施 | etl/+db/ + config/+llm/+data/ |
图为了好看,把前端单拎出来、又把「引擎+知识」和「数据+基础」各自并成一块,于是六变五;README 那行画的是目录之间的调用方向 ,压根没算前端,于是又是六个箭头。还有个小细节:README 那行标题写着「自下而上」,可箭头其实是从 api/ 一路指向最底层的 config/+llm/+data/,画的是「谁调谁」------方向别被标题带偏了。三个口径,一个系统,不冲突。真要记,就记那条铁律:上层调下层,下层不回头。
问:LangGraph 绕这么一大圈,LCEL 一根链子 prompt | model | parser 不也能跑吗? 答:能跑,但跑不出「查不够再补」。线性链没有状态,也没有回环,reflect 那个「候选不足 5 条自动补高分榜」的兜底就没地方放------总不能让大模型自己看着办吧,那正是我们想躲开的抖动。可也别走到另一个极端把整条链都交给 LLM:本项目只在意图识别和文案生成两处用模型,中间规划 / 执行 / 兜底全是确定性代码。So,选 LangGraph 不是因为它时髦,是因为这场景既要「带状态的多步」,又要「关键环节不许抖」。
问:三个抽象层 + 三个开关,一个小 Demo 至于吗?是不是过度设计? 答:实话说,写的时候我也嘀咕过是不是过度设计。我的判断标准是「这个变化是不是已经 在发生」------不是「也许将来会」:开发期纯本地、上线必上云,这个前后差异是确定要来的;嵌入从本地 bge-m3 到云端 qwen 也是确定要试的。既然变化已经排进日程,那二十行抽象就不是投机,是提前把坑位留好。当然,要是你做的就是个一次性脚本,这么分层纯属脱裤子放屁------具体怎么抉择,还是得看场景。
问:那前端呢?六层依赖链从头到尾没见 Vue3 的影子,它不算一层? 答:这问正好戳在那条链子的边界上。README 那行 api/ → agent/ → ... 画的是 Python 进程里的 import 方向 ,api/ 调 agent/ 是真刀真枪 import 进来的,一路 import 到最底下 config/。前端压根不在这个进程里------它就住在仓库里的 frontend/ 目录,是另一套 Vue3 + Vite 工程,dev 时跑在 :5173,跟后端隔着 HTTP / SSE 说话,两边谁也不 import 谁。所以文档把 UI 归进「应用/接口层」是按职责切 ,代码里它是独立进程、不进 import 链------又是「从哪个角度切」的老问题,跟第 1 问那张表一个道理。通俗的理解 :这条依赖链是「公司内部的汇报线」,前端不是员工,是上门的客户,汇报线管不着他。真要给它安位置,就是架构图里单拎的那块「Vue3 前端」,跟 FastAPI 平起平坐,靠 /recommend/stream 的 SSE 事件流握手。也正因它是另一套技术栈、另一套状态管理,我留到第 7 篇单独开篇------硬塞进这张 Python 分层图,只会越看越乱。
One More Thing:蓝图不是预言
最后交代一件值得专门记一笔的事------当初方案里写的示例,和真正落地,差了不止一点:
| 文档原示例 | 实际落地 |
|---|---|
库名 movie_agent |
imdb |
模型 qwen2.5:14b / qwen2.5:7b |
qwen3.5:9b / deepseek-r1:7b |
嵌入 bge-m3 |
bge-m3:567m |
| 主表 30--40 万 | 样本 ~1134 部(全量待灌) |
chromadb >=0.5 |
1.5.9(list-metadata 过滤坑) |
| 关系召回走 Neo4j | 开发期走 MySQL 关系表(接口不变) |
| Memory 用 Redis / checkpointer | MySQLMemoryStore(强 MySQL、无 file 兜底;Redis/File 预留未启用;图的 compile() 没接 checkpointer,见上方第 59 行) |
七处偏差,没一处漏进业务代码------全被抽象层和配置挡在了外面。这大概就是我这篇最想说的:架构文档从来不是预言,是地图 。你照着走,路上一定会撞见跟图上不一样的岔口;只要这些偏差被关在笼子里、没渗进业务逻辑,这张图就没白画。没有最完美的架构,只有最适合当前阶段、且扛得住变化的取舍------上篇撂下的那句,这篇算是从「分层」这个角度给它补了个注脚。
小结
这篇就干了一件事:把地图摊开。一张六层依赖图(外加「文档六层 / 图五块 / 依赖链六箭头」的口径澄清)、三个「把变化关进笼子」的开关、一条从 HTTP 到 SSE done 的请求时序,再加一张目录挂牌表。第 3--8 篇各自认领其中一层,不会再回来重画这张图。
至于那个「为什么要先画图再写代码」的问题,答案其实就藏在这张图本身:因为上层依赖下层这条铁律,只有先定下来,后面加缓存、加护栏、切云端才不用推倒重来。下一篇我们钻进最上面那颗「心脏」------LangGraph 五节点到底怎么转、三路召回怎么融、RRF 和 MMR 又怎么把一堆候选排成一份像样的片单。
收个尾:要是这张图帮你少绕了点路,点个赞、留句话都成,原创不易,谢了。 这张六层图不是画着玩的,仓库里每个目录都能跟它一一对上------想照着扒架构、看看代码怎么落地的,地址放这儿:MovieAgent。「三个抽象层到底算不算过度设计」,我更想听你的------是未雨绸缪,还是我给自己加戏了?评论区见。