把 1.6 万亿参数按 16 位精度折成权重是 3.2TB,仓库里 208 个分片加起来 3,577.6GB;压到 4bit 剩 800GB,按单卡留 15% 给框架算,仍要 12 张 H100。下面的数按 11-12 的公开口径和一组显式假设算,不是任何一家的部署清单,边界在第 7 节。
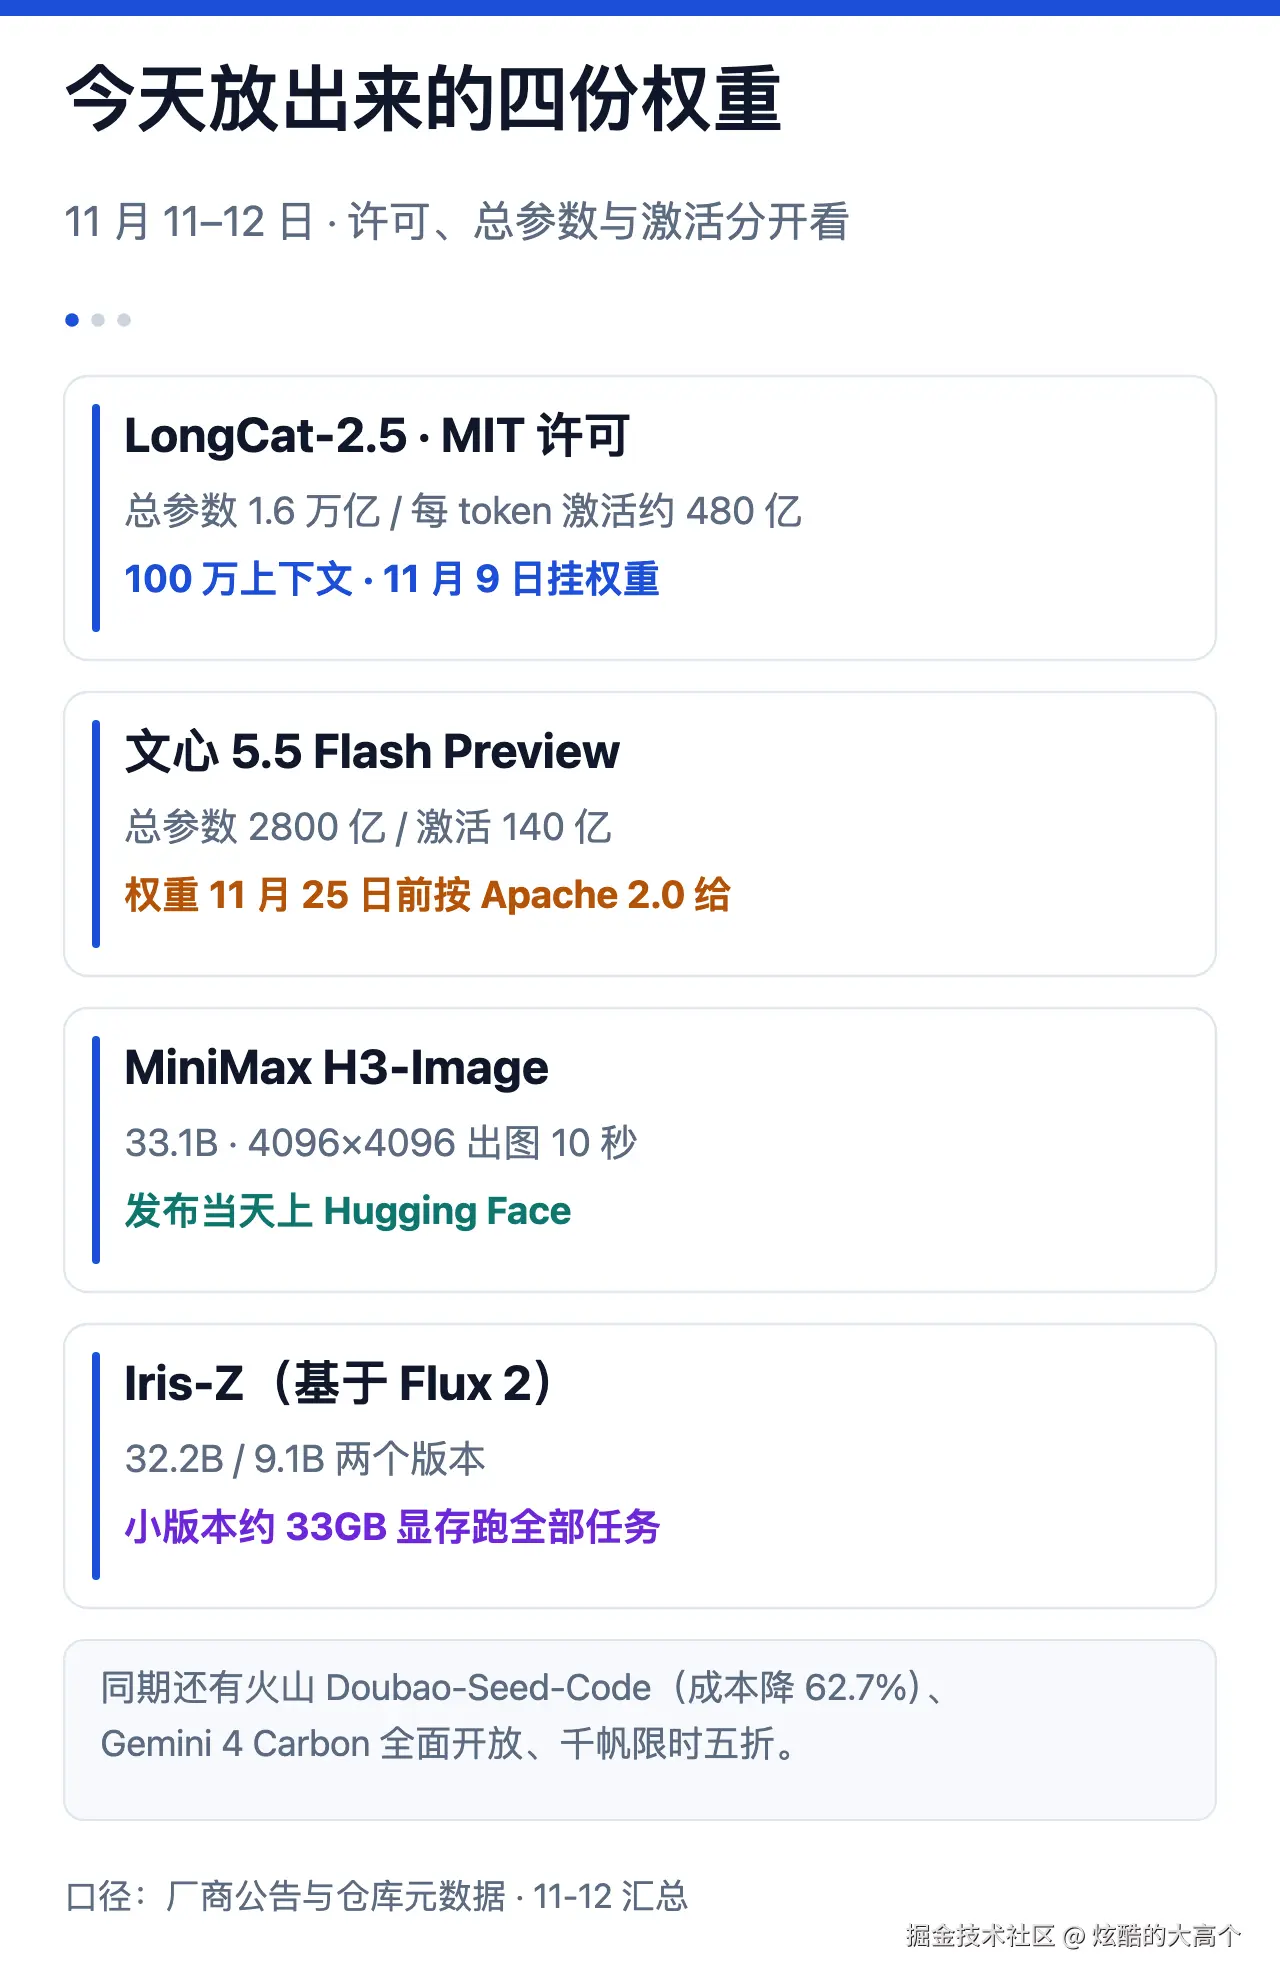
11 月 11 日到 12 日,四份权重前后脚挂出来,开源在同一天被做成了四个动作。美团 LongCat-2.5 用 MIT 许可放出 1.6 万亿总参数、每 token 激活约 480 亿,支持 100 万上下文;百度文心 5.5 Flash Preview 是 2800 亿总参数、140 亿激活,API 已上千帆,权重说好 11 月 25 日前按 Apache 2.0 给;MiniMax 的 H3-Image 发布当天把 33.1B 生图权重放上 Hugging Face,4096×4096 出图 10 秒;Iris-Z 基于 Flux 2,32.2B 和 9.1B 两个版本,小的那个约 33GB 显存能跑全部任务。
同一批消息里还有火山引擎的 Doubao-Seed-Code,说综合成本降 62.7%;Gemini 4 Carbon 全面开放,输入每百万 2 美元、输出 10 美元,优惠到 11 月 30 日翻倍;千帆这边的输入忙时 2 元、闲时 1 元,输出 8 元、闲时 4 元,限时五折。降价、放量、给权重,三件事挤在 48 小时里。
一边是 1.6 万亿,一边是 10 秒出 4K 图,中间还夹着 33GB 显存就能跑。这三档不在一个口径上,我把它们折成同一件事:把权重搬回自己机器,要付多少显存、多少张卡、多少等待时间。
目录:1 四份权重 / 2 两个 TB / 3 4bit 之后 / 4 搬得动吗 / 5 一百万上下文 / 6 下载和装载 / 7 边界 / 8 清单
1. 四份权重,四种体量
先把这四份的数字摆在一起,许可、参数、激活、上下文分开列。
| 模型 | 总参数 | 每 token 激活 | 许可 / 时间 | 上下文 |
|---|---|---|---|---|
| LongCat-2.5 | 1.6 万亿 | 约 480 亿 | MIT,11 月 9 日挂权重 | 100 万 |
| 文心 5.5 Flash Preview | 2800 亿 | 140 亿 | Apache 2.0,11 月 25 日前 | 100 万 |
| H3-Image | 33.1B | 全部 | 发布当天上 HF | 图像任务 |
| Iris-Z small | 9.1B | 全部 | 权重已开放 | 图像 + 深度 |
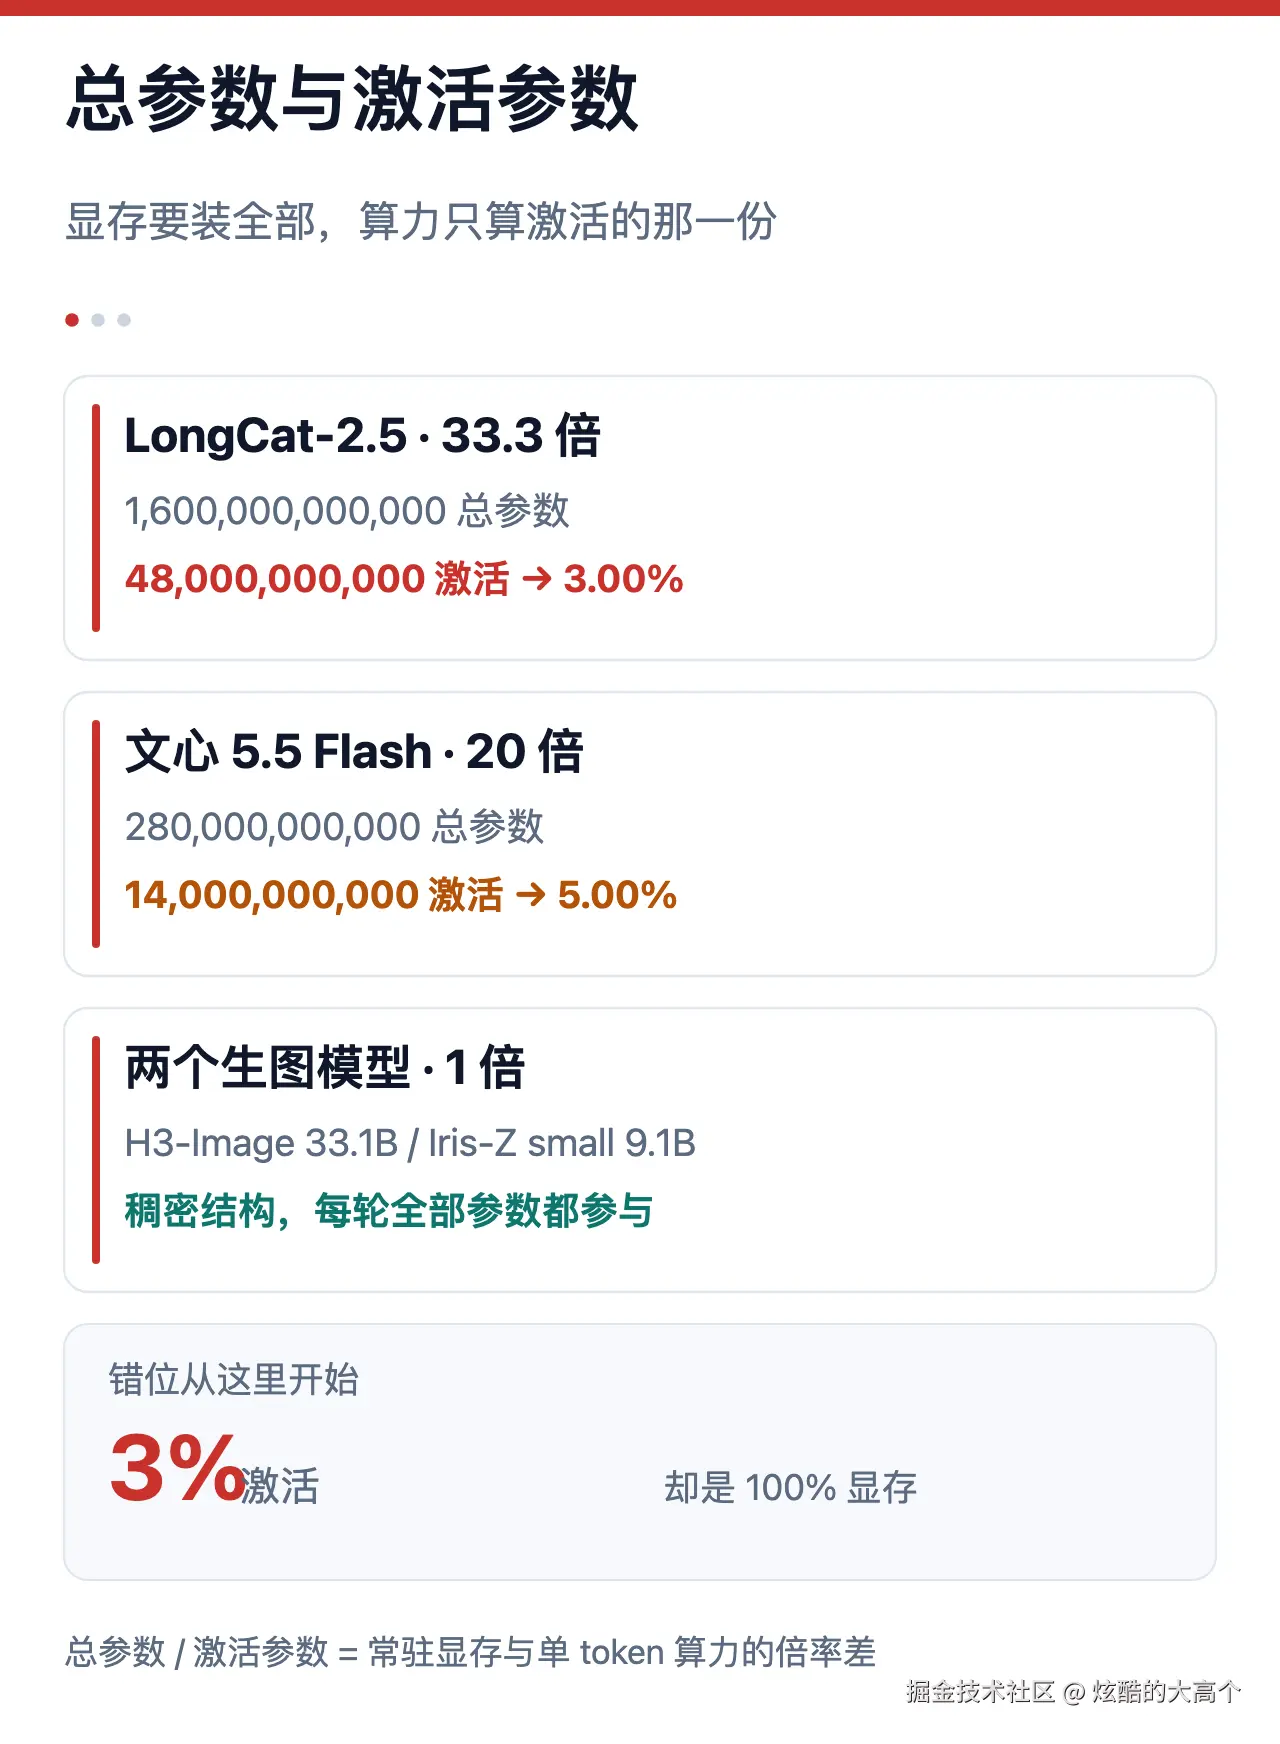
前三行有两个数差得很远:LongCat 的 480 亿除以 1.6 万亿是 3%,文心的 140 亿除以 2800 亿是 5%。这是混合专家的常规做法,总参数决定能记住多少,激活参数决定跑一次要算多少。对外报的是前者,跟电费和并发量挂钩的是后者。
但显存要装的是全部参数,不是激活的那一份。这个错位是后面所有账的起点。
GitHub 日榜(窗口 11-11 UTC 全天)前十里,morluto/rea +1,631,Lee-xeo/Claude-Cage +1,413,janestreet/agent_skills +1,313,GoogleChrome/modern-web-guidance +1,300,都是围着本机编码助手做隔离、教学、检索的工具。meta/astryx +1,069,aws/aws-emulator +1,039。接口 08:2x 的读数:anthropics/skills 193,120 星、meta/astryx 24,950、vllm-project/vllm 96,771、sgl-project/sglang 38,763;日报里写 193,101 和 24.8k,窗口不同,不当结论用。
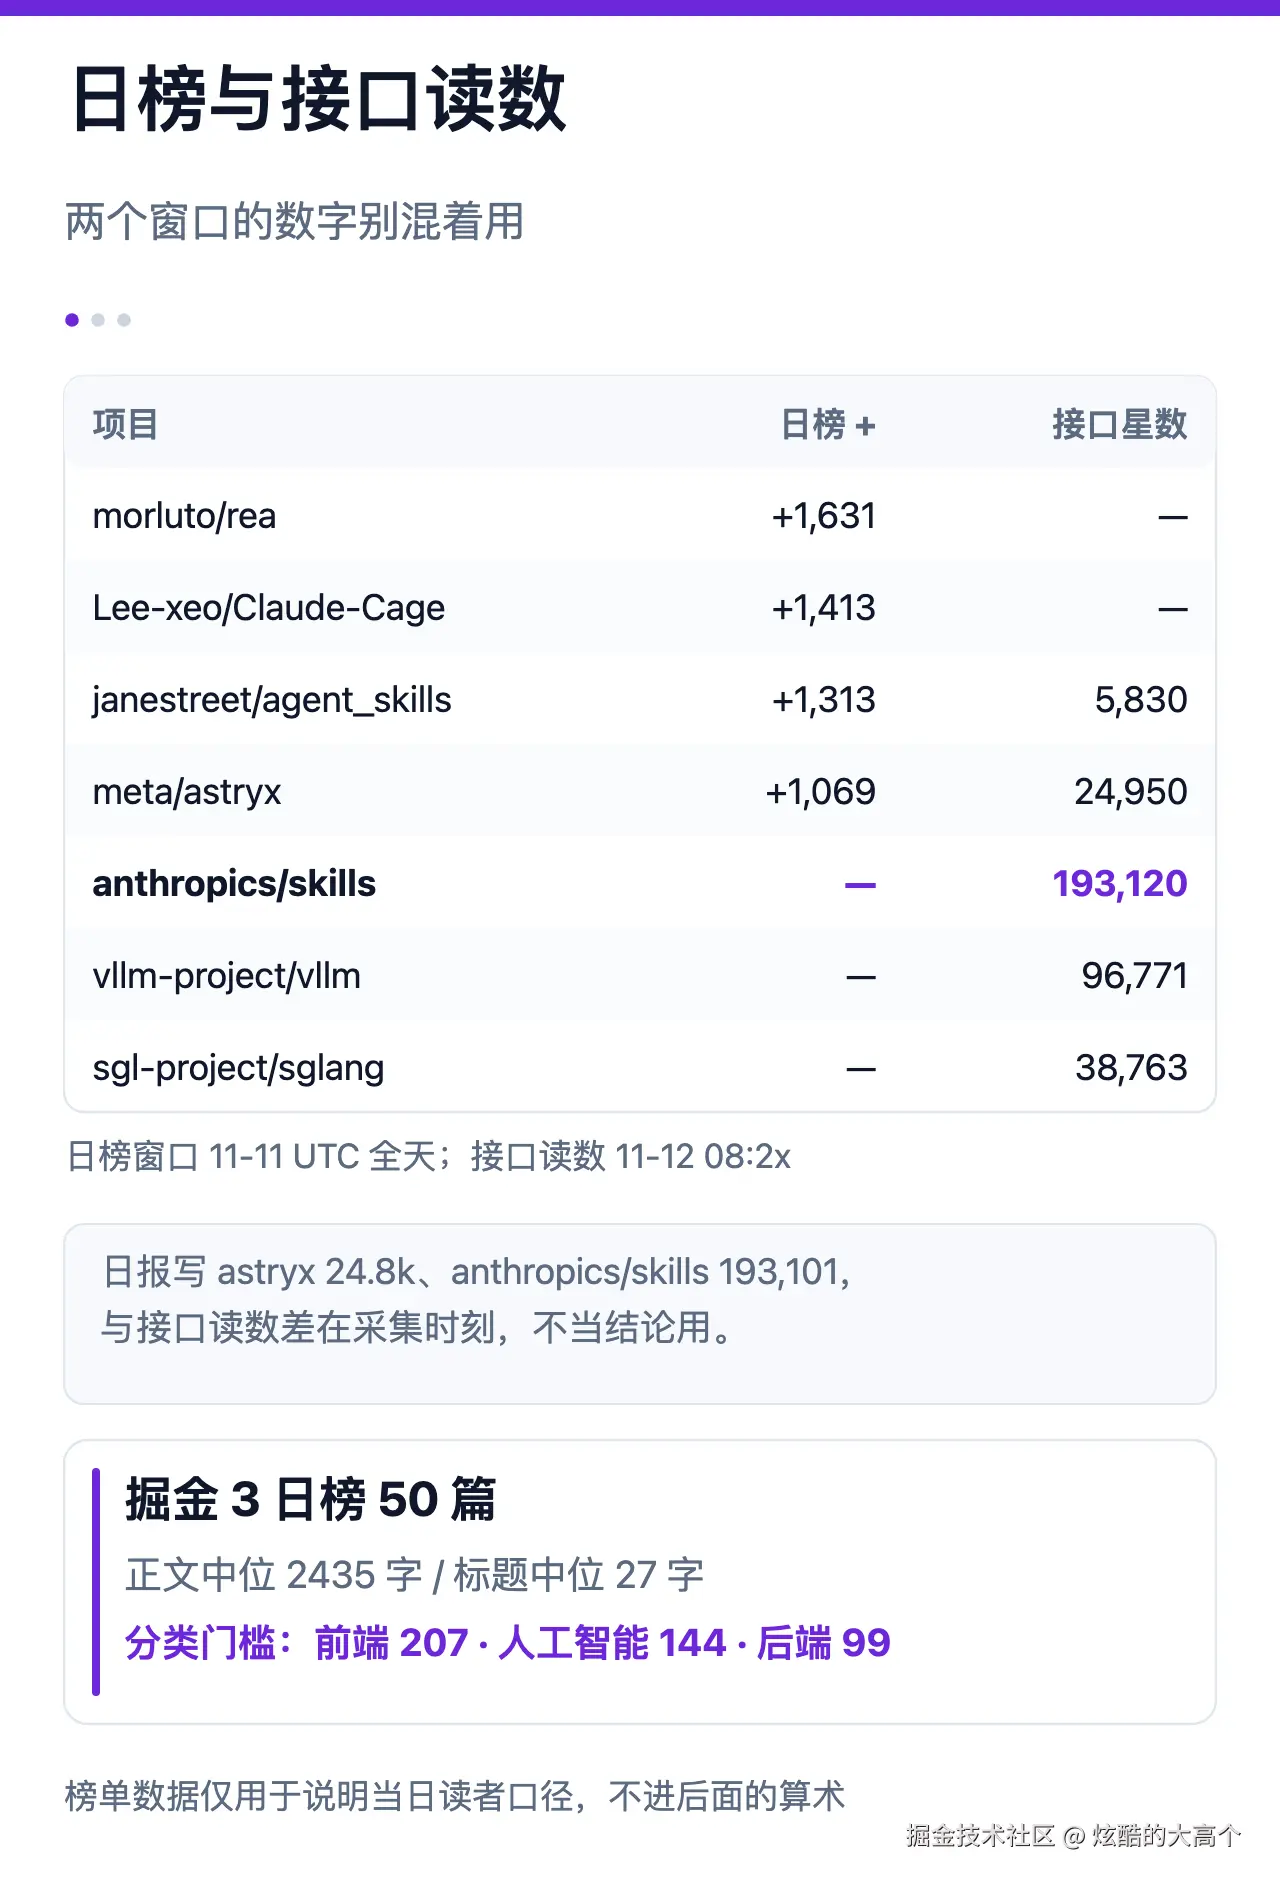
掘金 3 日榜 08:28 的 50 篇样本里,正文中位 2435 字、标题中位 27 字、标签中位 3 个、每千阅读互动中位 22.09,9 点发布的 10 篇最多。分类门槛:前端 207、人工智能 144、后端 99。人工智能榜首是《阿里版Codex,再次惊艳到我了。》,热度 2187;后端榜首《Codex中必装的11个Skills》,783。这些数字只用来说明今天读者在看什么,不进后面的算术。
2. 3.2TB 和 3.56TB,不是同一个数
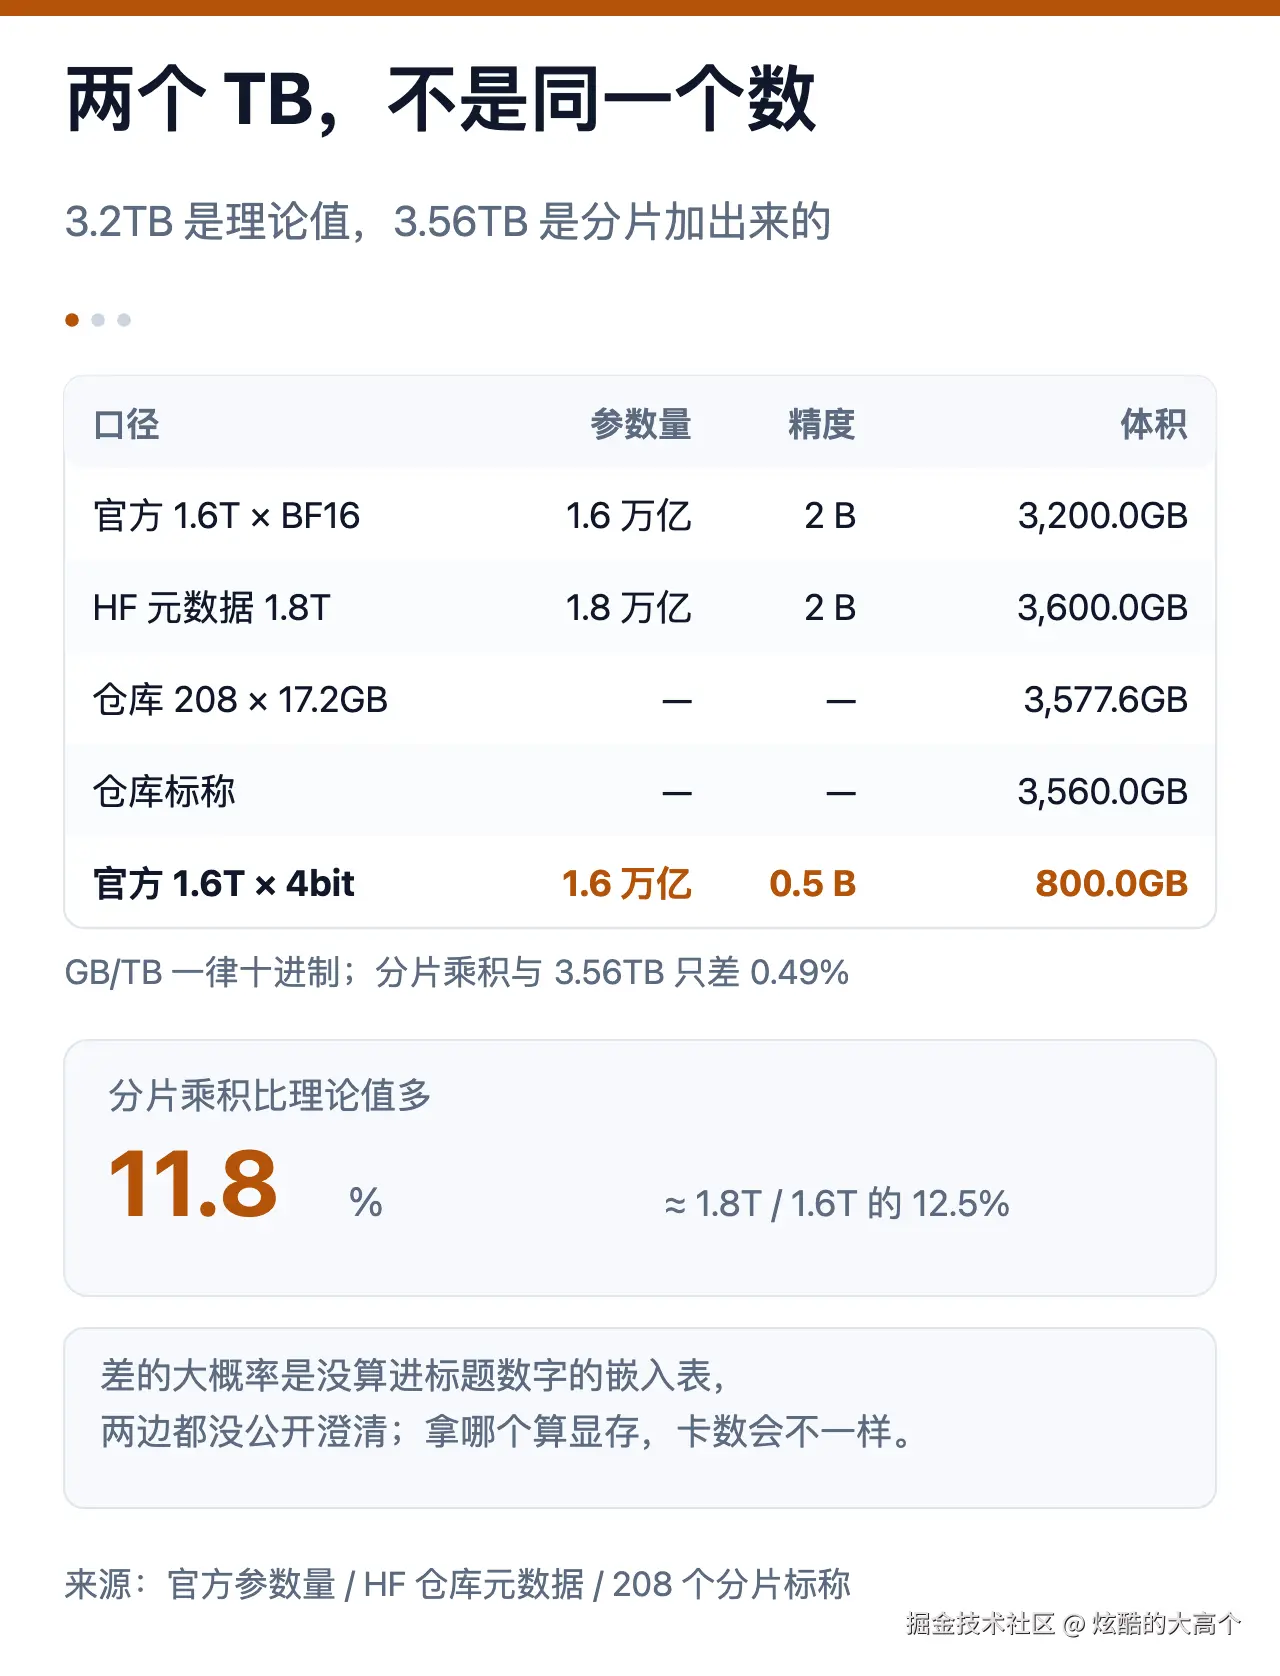
我第一版算错了。按官方 1.6 万亿、16 位精度每参数 2 字节,1.6e12 × 2 = 3.2e12 字节,十进制就是 3.2TB。可仓库标称 3.56TB,208 个分片每个约 17.2GB,乘起来 3,577.6GB,比 3.2TB 多 11.8%。
对不上的原因在元数据。HF 仓库的参数量写的是 1.8 万亿,不是官方口径的 1.6 万亿;1.8e12 × 2 = 3.6TB,和 208 × 17.2GB 只差 0.49%。1.8 比 1.6 多 12.5%,和那 11.8% 基本吻合。差的大概率是没算进标题数字的嵌入表,两边都没公开澄清。
所以标题里的 3.2TB 是「官方参数量 × 精度」的理论值,3.56TB 是分片加出来的实测值,差 11.8%。这两个数不冲突,但拿哪个去算显存,卡数会不一样。
| 口径 | 参数量 | 精度 | 权重体积 |
|---|---|---|---|
| 官方 1.6T × BF16 | 1.6 万亿 | 2 B | 3,200.0GB |
| HF 元数据 1.8T × BF16 | 1.8 万亿 | 2 B | 3,600.0GB |
| 仓库 208 × 17.2GB | --- | --- | 3,577.6GB |
| 仓库标称 | --- | --- | 3,560.0GB |
| 官方 1.6T × 4bit | 1.6 万亿 | 0.5 B | 800.0GB |
3. 4bit 之后,还是要 12 张 H100
脚本只用标准库,Python 3.9+ 能跑:
bash
python3 vram_ledger.py
python3 vram_ledger.py --model longcat --precision fp4
python3 vram_ledger.py --overhead 0.25 --card h200
python3 vram_ledger.py --check
核心就三行,改 PRECISION 和 overhead 就能换成自己的卡:
python
weight = total_params * bytes_per_param
usable = card.vram_gb * (1 - overhead)
cards  = ceil(weight / 1e9 / usable)
overhead 默认 0.15,是留给框架、激活缓冲、通信 workspace 的比例;GB/TB 一律十进制。主表只算权重,KV 单独列在第 5 节,因为各家没公布 KV head 配置,混进来会变成假精确。
按 H100 80GB、可用 68GB 算:
| 精度 | 权重 | LongCat 卡数 | 文心卡数 | H3-Image | Iris-Z small |
|---|---|---|---|---|---|
| BF16 | 3,200GB | 48 | 9 | 1 | 1 |
| FP8 | 1,600GB | 24 | 5 | 1 | 1 |
| FP4 / W4A4 | 800GB | 12 | 3 | 1 | 1 |
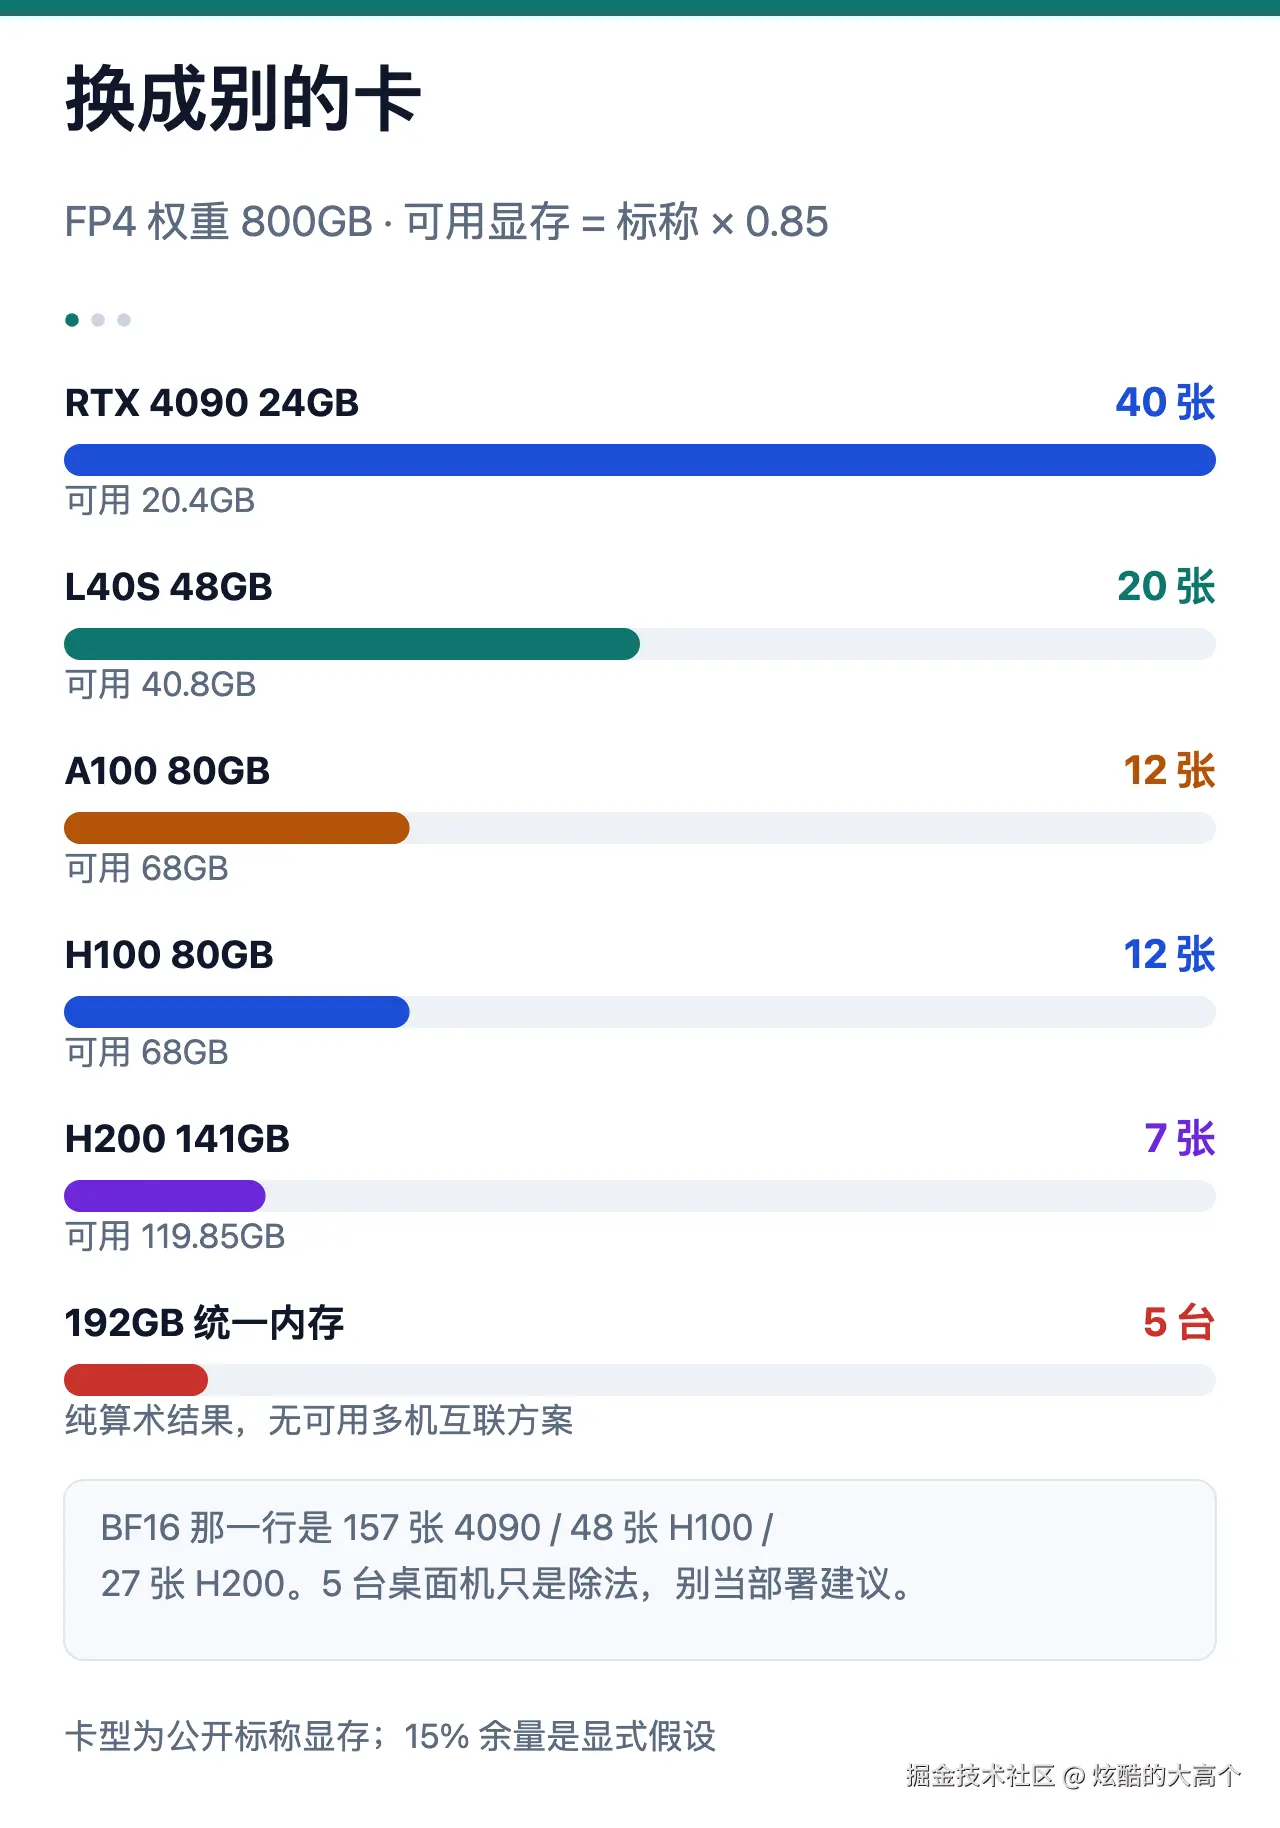
换成别的卡,FP4 那一行是 40 张 4090、20 张 L40S、7 张 H200、5 台 192GB 统一内存的机器。BF16 那一行是 157 张 4090、48 张 H100、27 张 H200。5 台 Mac 那个数字只是算术结果,没有可用的多机互联方案,别当部署建议。
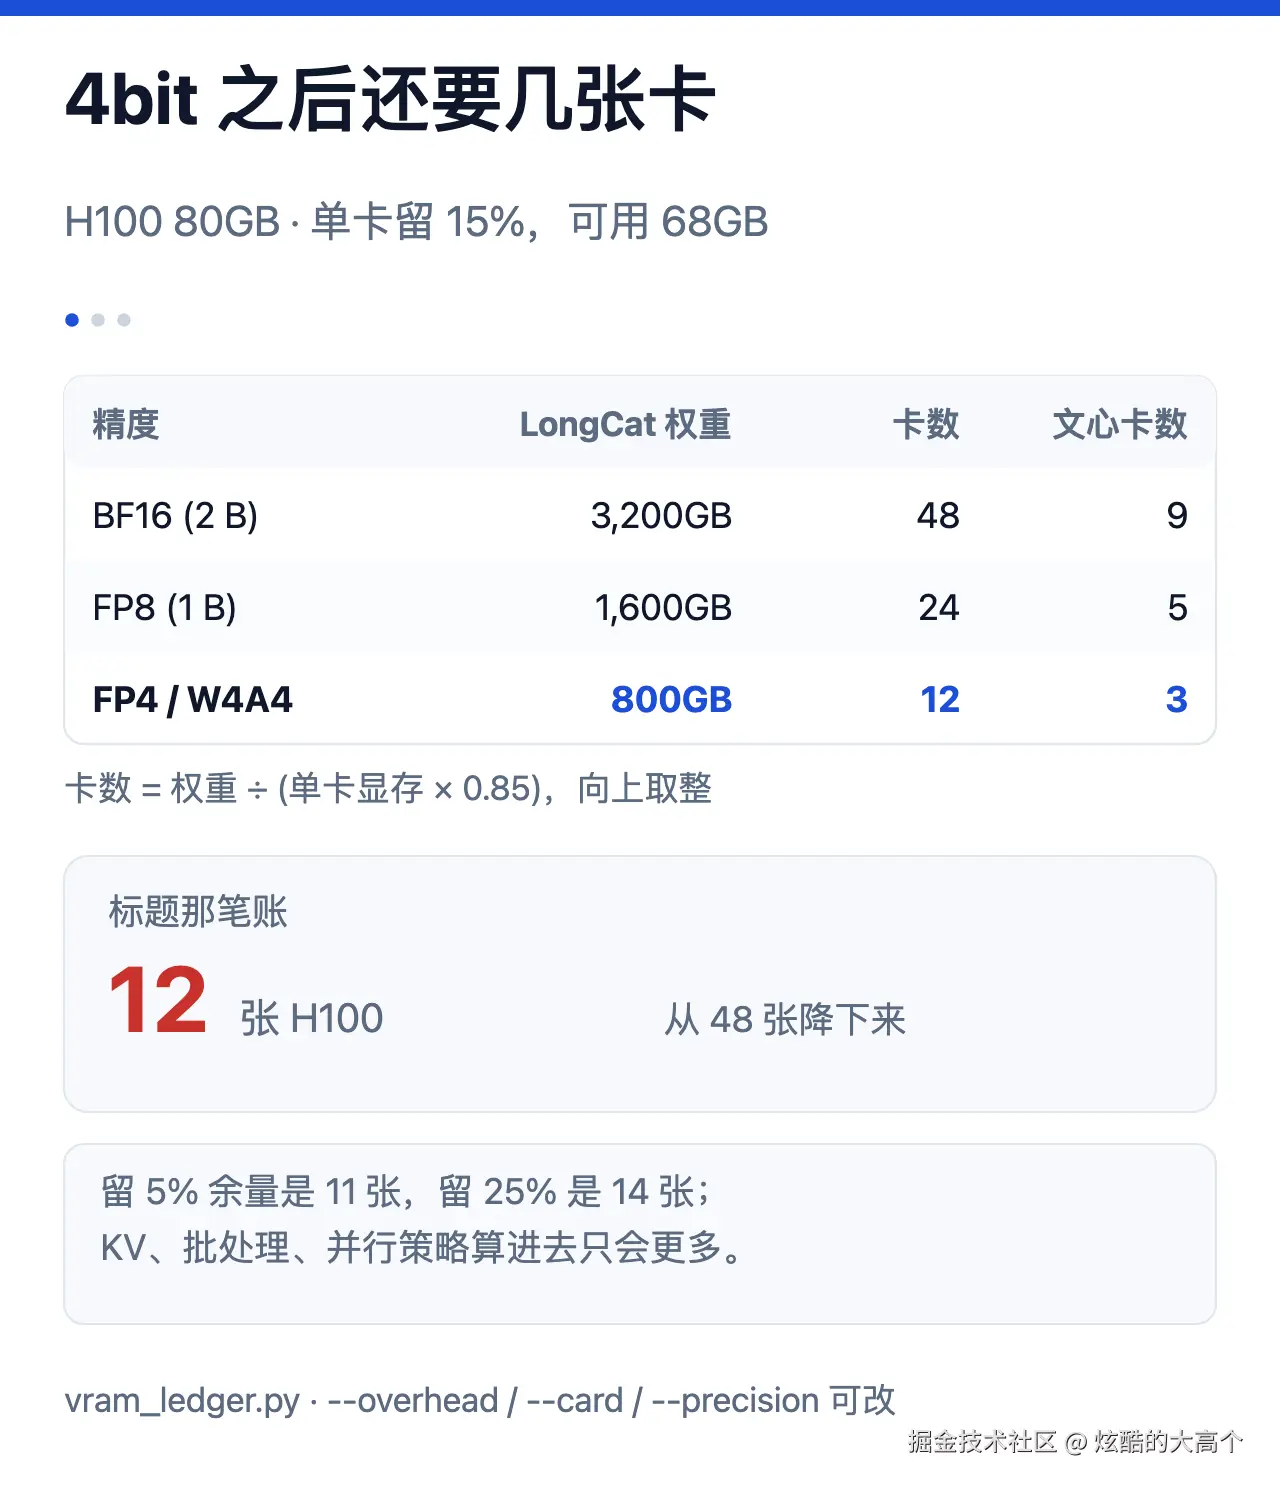
overhead 动一动,答案也动:留 5% 是 11 张 H100,留 25% 是 14 张。这个 15% 是我拍的,不是厂商给的;把 KV、批处理、并行策略算进去,只会更多。
4. 装得下,不等于搬得动
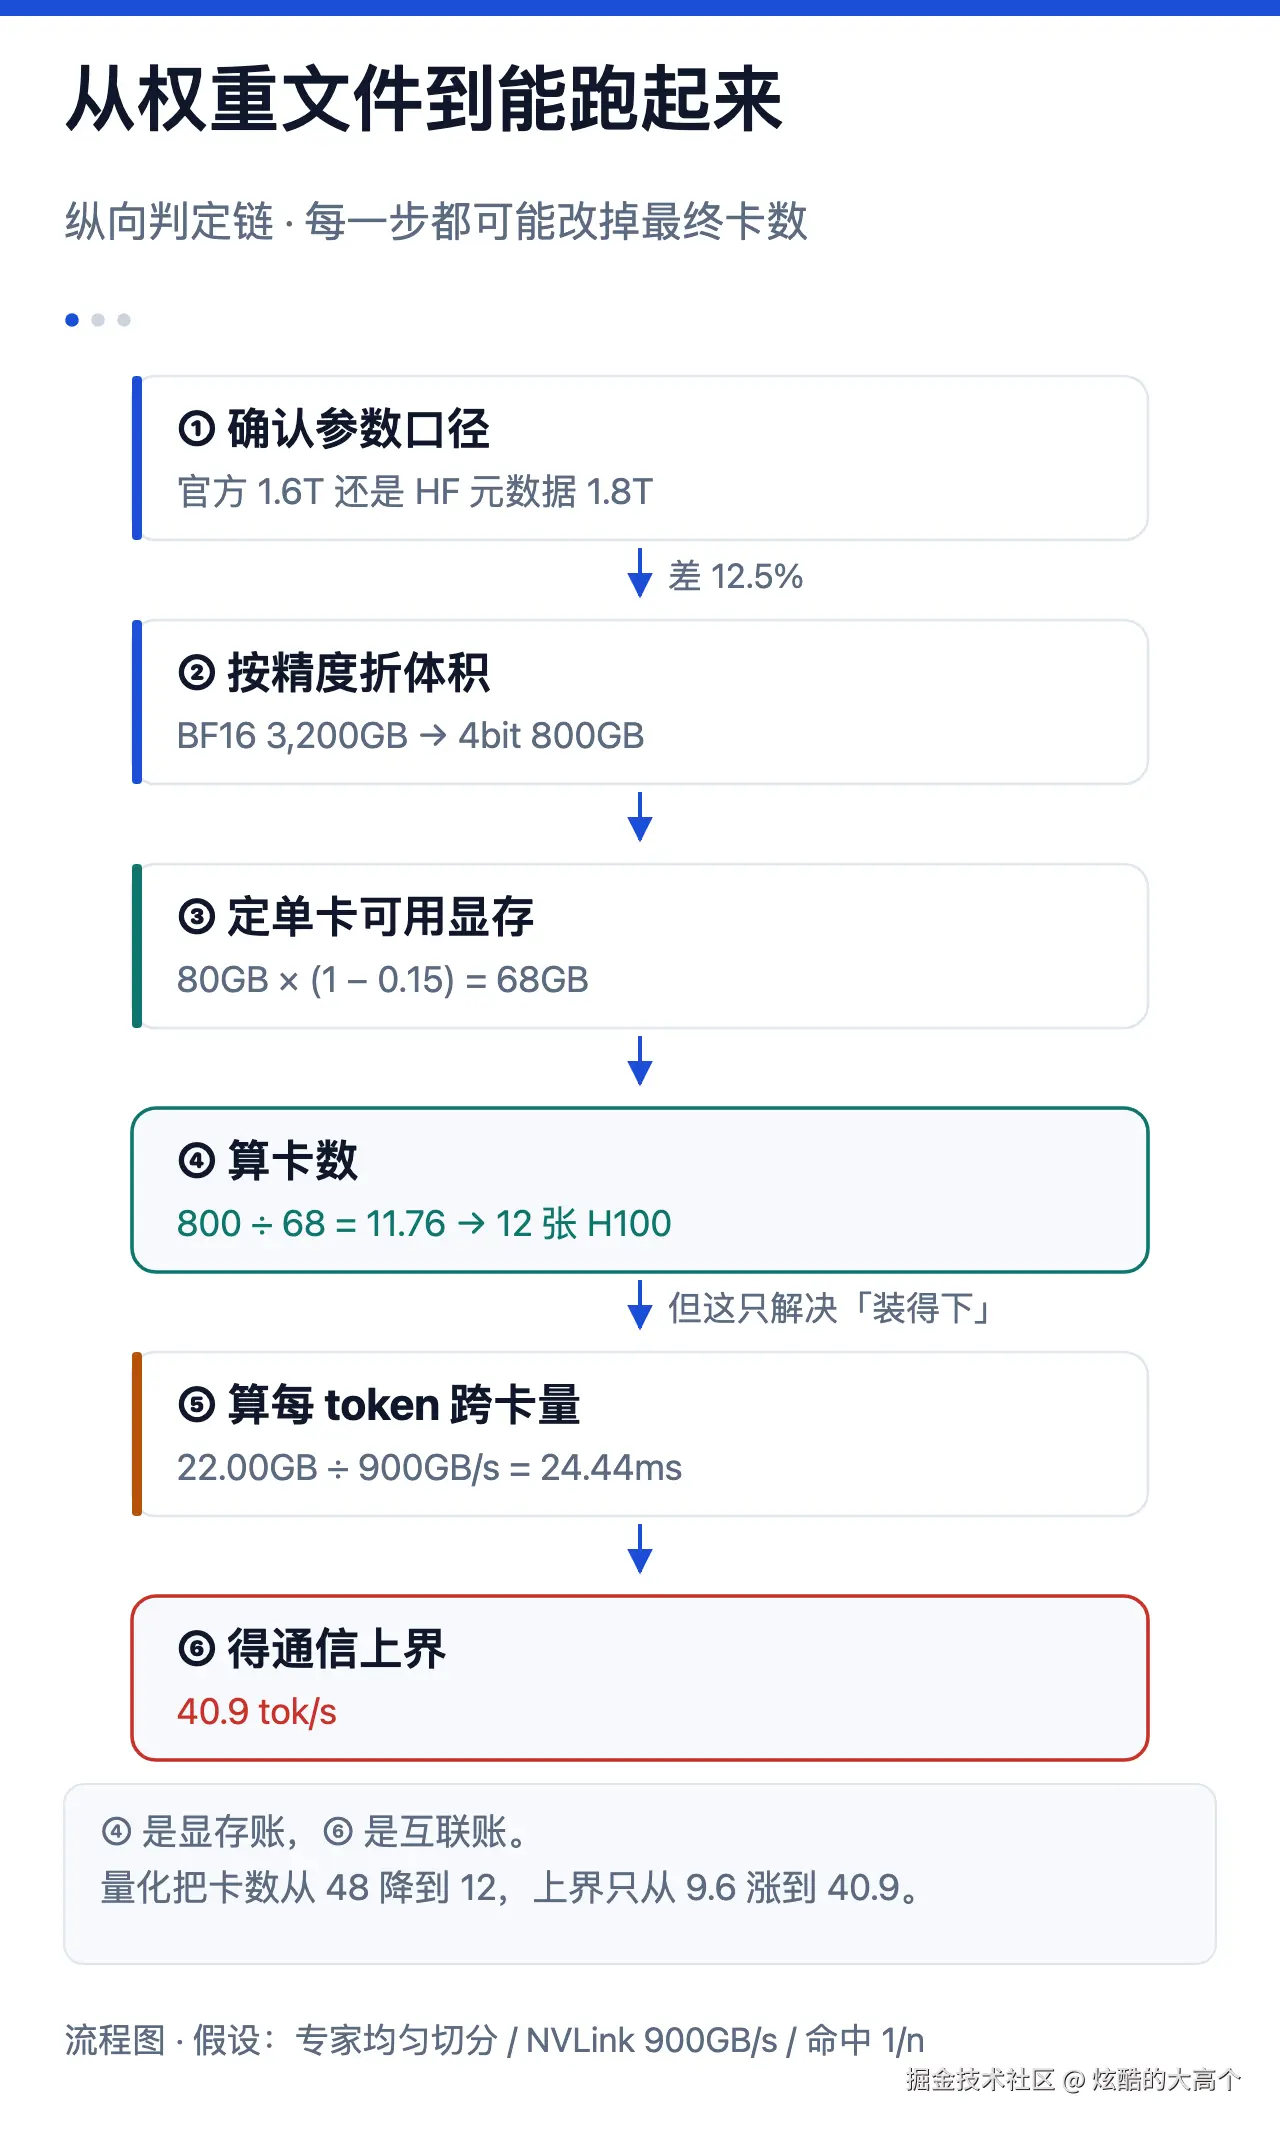
量化解决的是「权重能不能放进显存」,没解决「每个 token 要跨几张卡」。
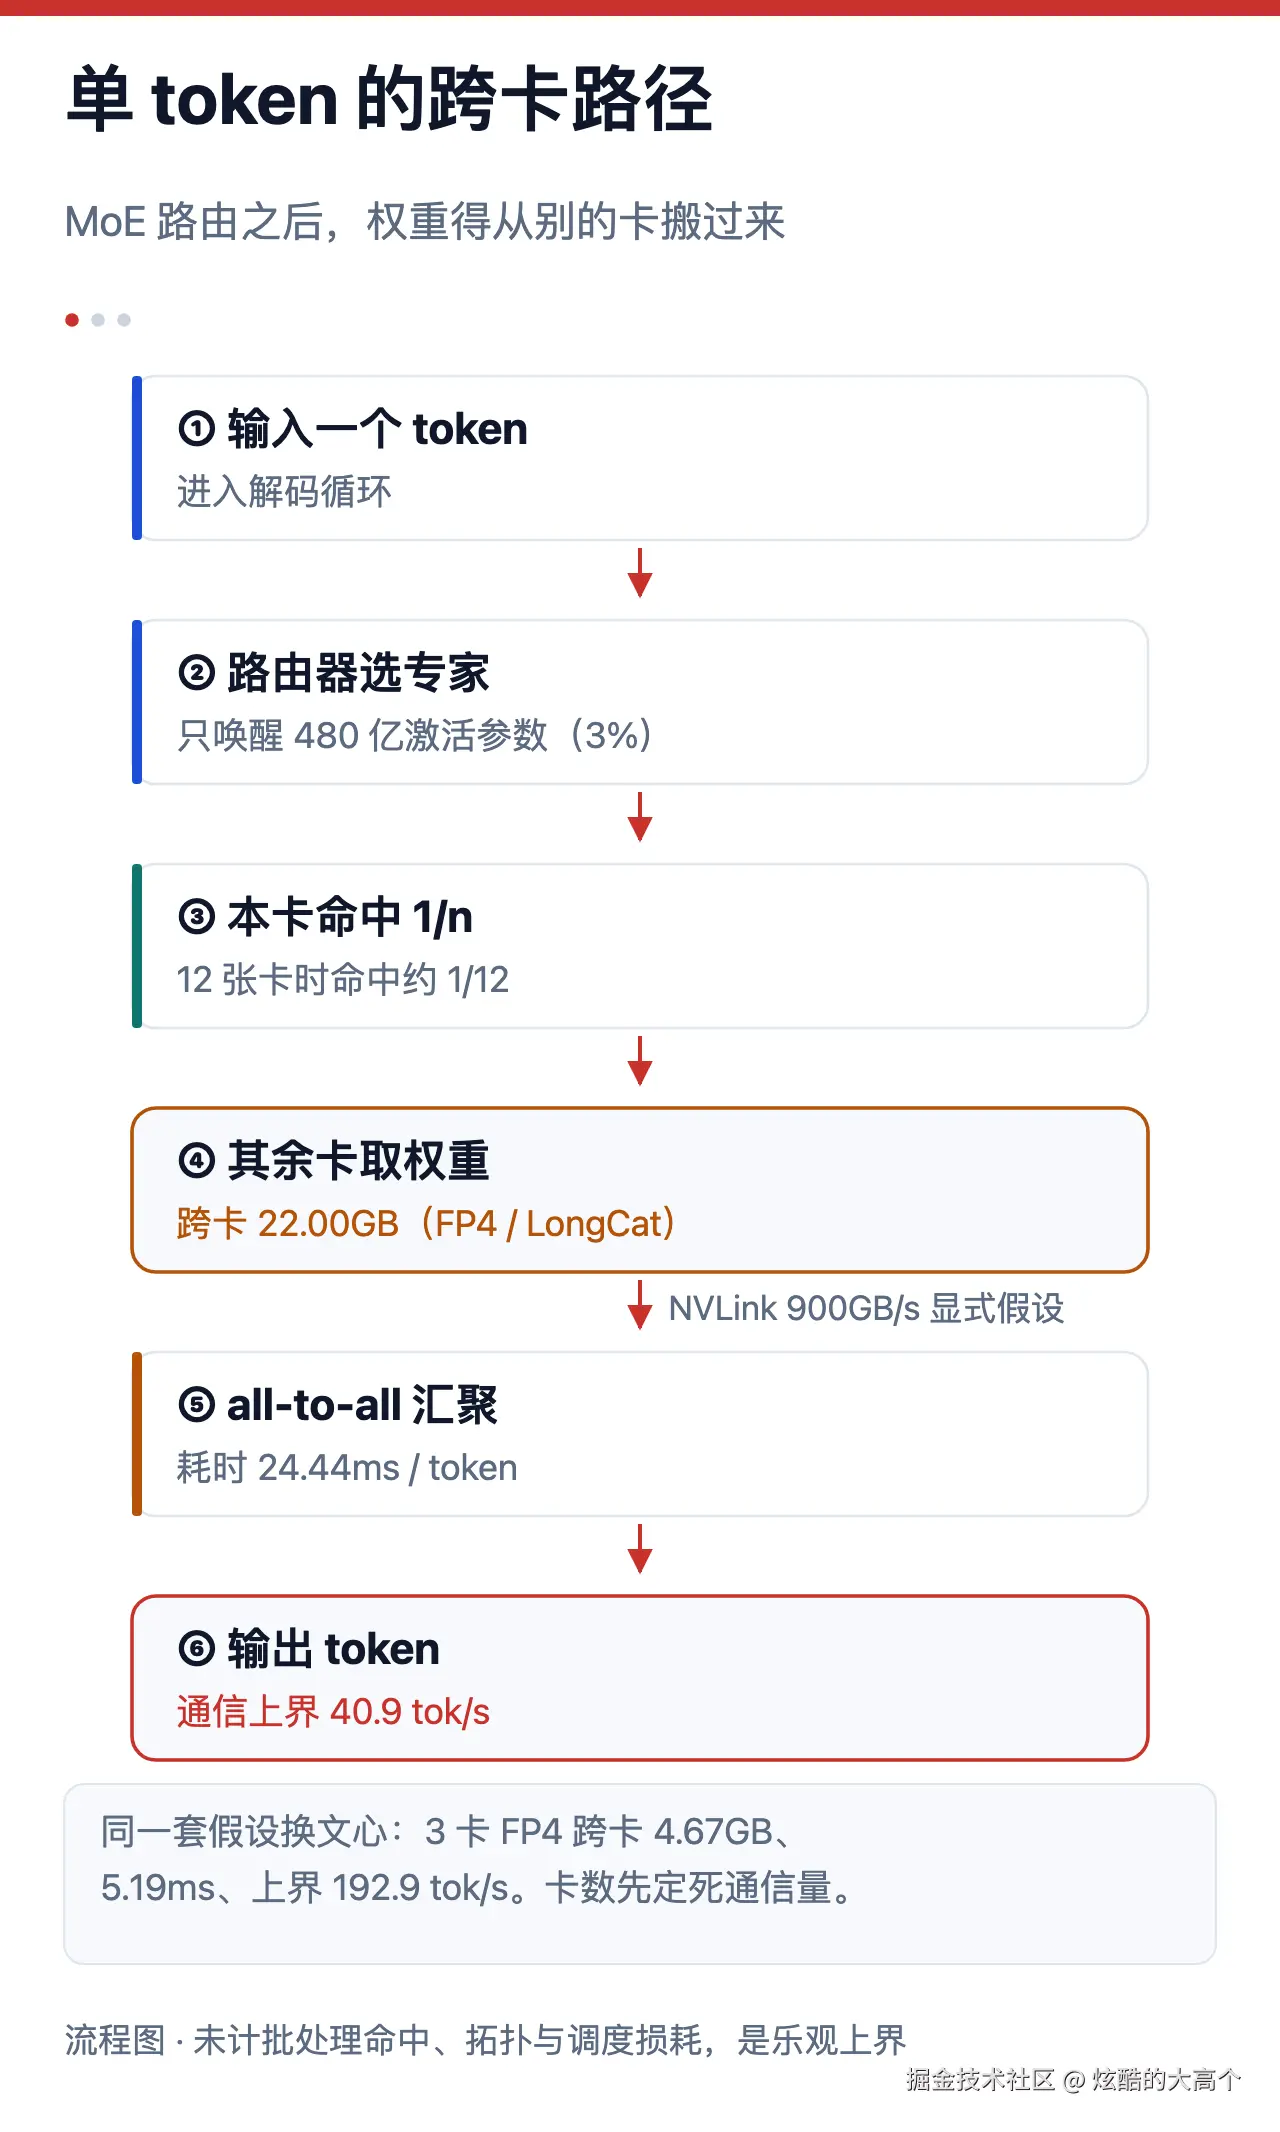
MoE 的专家是切在不同卡上的。按专家均匀分布、本卡恰好命中 1/n 的激活专家这个乐观假设,每生成一个 token,其余激活权重要从别的卡取过来。卡间带宽按 900GB/s 的显式假设:
| 配置 | 卡数 | 每 token 跨卡 | 通信耗时 | 通信上界 |
|---|---|---|---|---|
| LongCat BF16 | 48 | 94.00GB | 104.44ms | 9.6 tok/s |
| LongCat FP4 | 12 | 22.00GB | 24.44ms | 40.9 tok/s |
| 文心 BF16 | 9 | 24.89GB | 27.65ms | 36.2 tok/s |
| 文心 FP4 | 3 | 4.67GB | 5.19ms | 192.9 tok/s |
LongCat 压到 4bit 后,从 48 张卡降到 12 张,跨卡量从 94GB 降到 22GB,上界从 9.6 涨到 40.9 tok/s。省了四分之三的卡,速度上界还是两位数。
文心那边,官方说千帆单用户推理超过 200 tokens/s,脚本给三卡 FP4 的通信上界是 192.9 tok/s。两个数贴得很近,但口径不同:一个是端到端速度,一个是按显式假设算的通信瓶颈,脚本回答不了这是同构还是巧合。能对上的是结构------总参数 2800 亿、激活 140 亿、专家权重 FP4,三样一起把跨卡量压到 4.67GB,才留出 200 tok/s 的空间。
官方对「快」的解释也是三层:参数的使用方式、混合稀疏注意力、推理阶段加速。43 层里 37 层把历史每 128 个 token 压成一条缓存条目,剩下 6 层保留逐 token 访问;ECHO 让最后一层兼任投机解码的草稿模型。
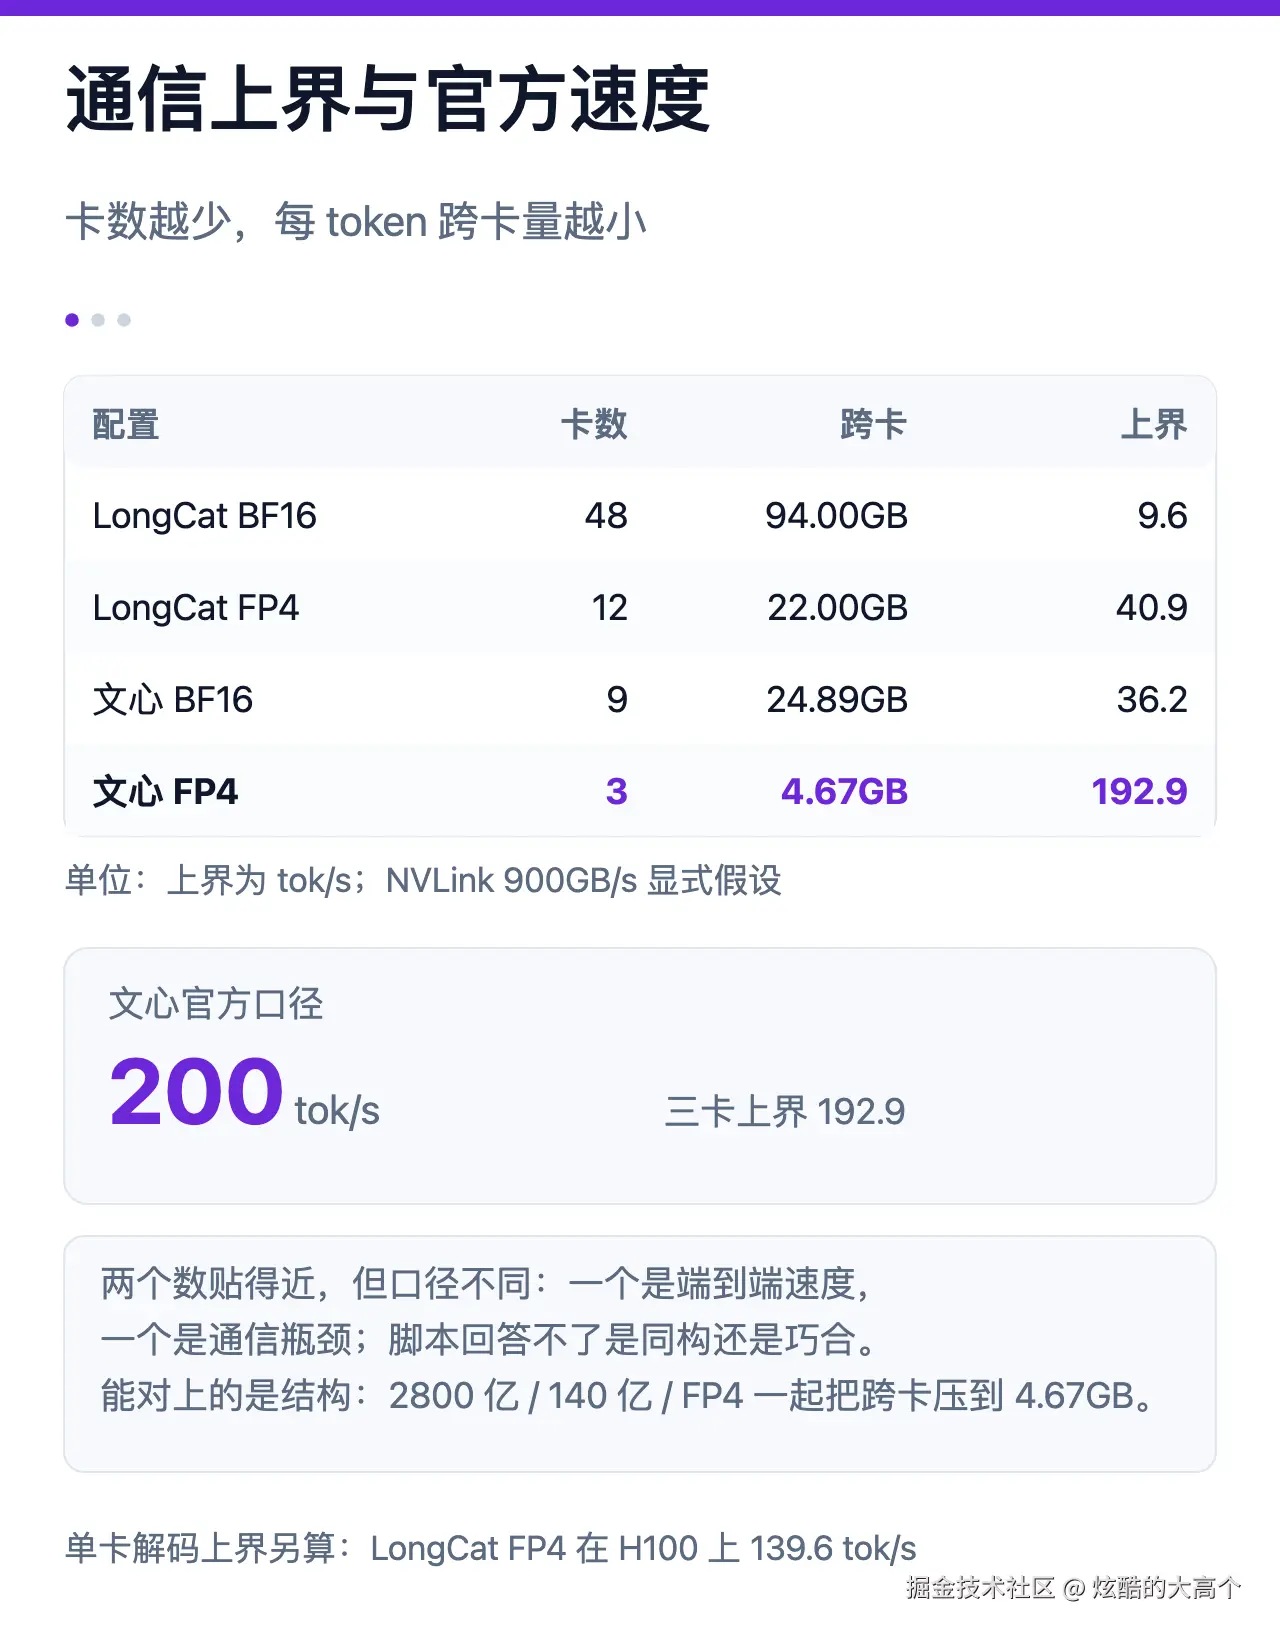
单卡解码上界另算一遍:每 token 至少要把激活权重从显存读一遍,LongCat FP4 是 24GB/token,H100 3.35TB/s 对应 139.6 tok/s,4090 只有 42.0,H200 是 200.0。这个上界不含 all-to-all、不含批大小、不含调度,实际会更低。把 139.6 和上一张表的 40.9 放一起看,瓶颈在哪一侧就清楚了。
5. 一百万上下文那一块,量化没动它
权重压到 4bit 是 800GB,KV cache 不会跟着变薄。
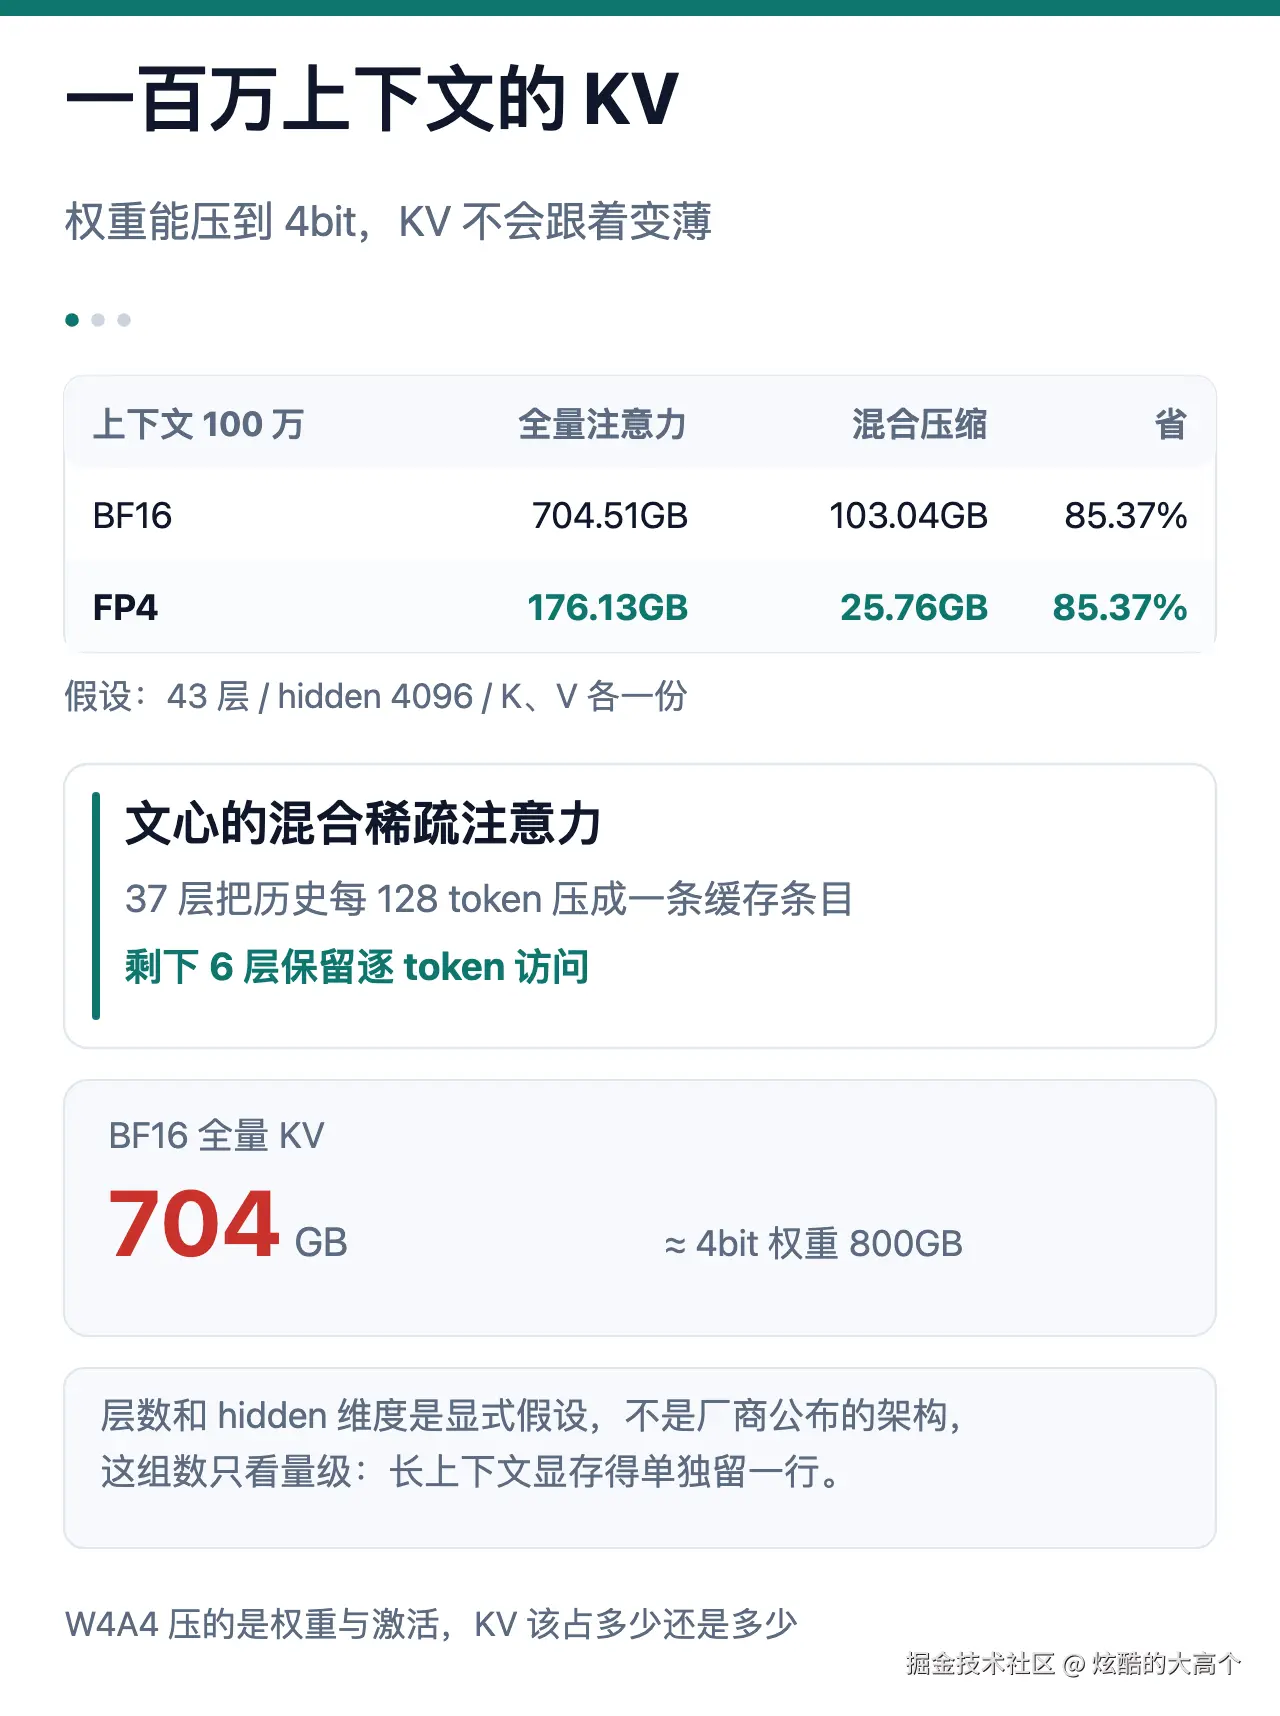
按 43 层、hidden 4096、K 和 V 各一份的显式假设,100 万上下文走全量注意力,BF16 下是 704.51GB------比 4bit 权重差不了多少。套用文心公开的混合稀疏结构(37 层每 128 token 一条、6 层逐 token),降到 103.04GB,省 85.37%;FP4 下是 176.13GB 对 25.76GB。
| 上下文 100 万 | 全量注意力 | 混合压缩 | 省 |
|---|---|---|---|
| BF16 | 704.51GB | 103.04GB | 85.37% |
| FP4 | 176.13GB | 25.76GB | 85.37% |
hidden 维度和层数是我设的,不是这两家公布的架构参数,所以这组数只能看量级:长上下文的显存,跟精度、跟总参数都不同源,得单独留。W4A4 把权重和激活一起压到 4bit 是推理侧的事,KV 该占多少还是多少。
6. 下载、校验、装载,先等上大半天
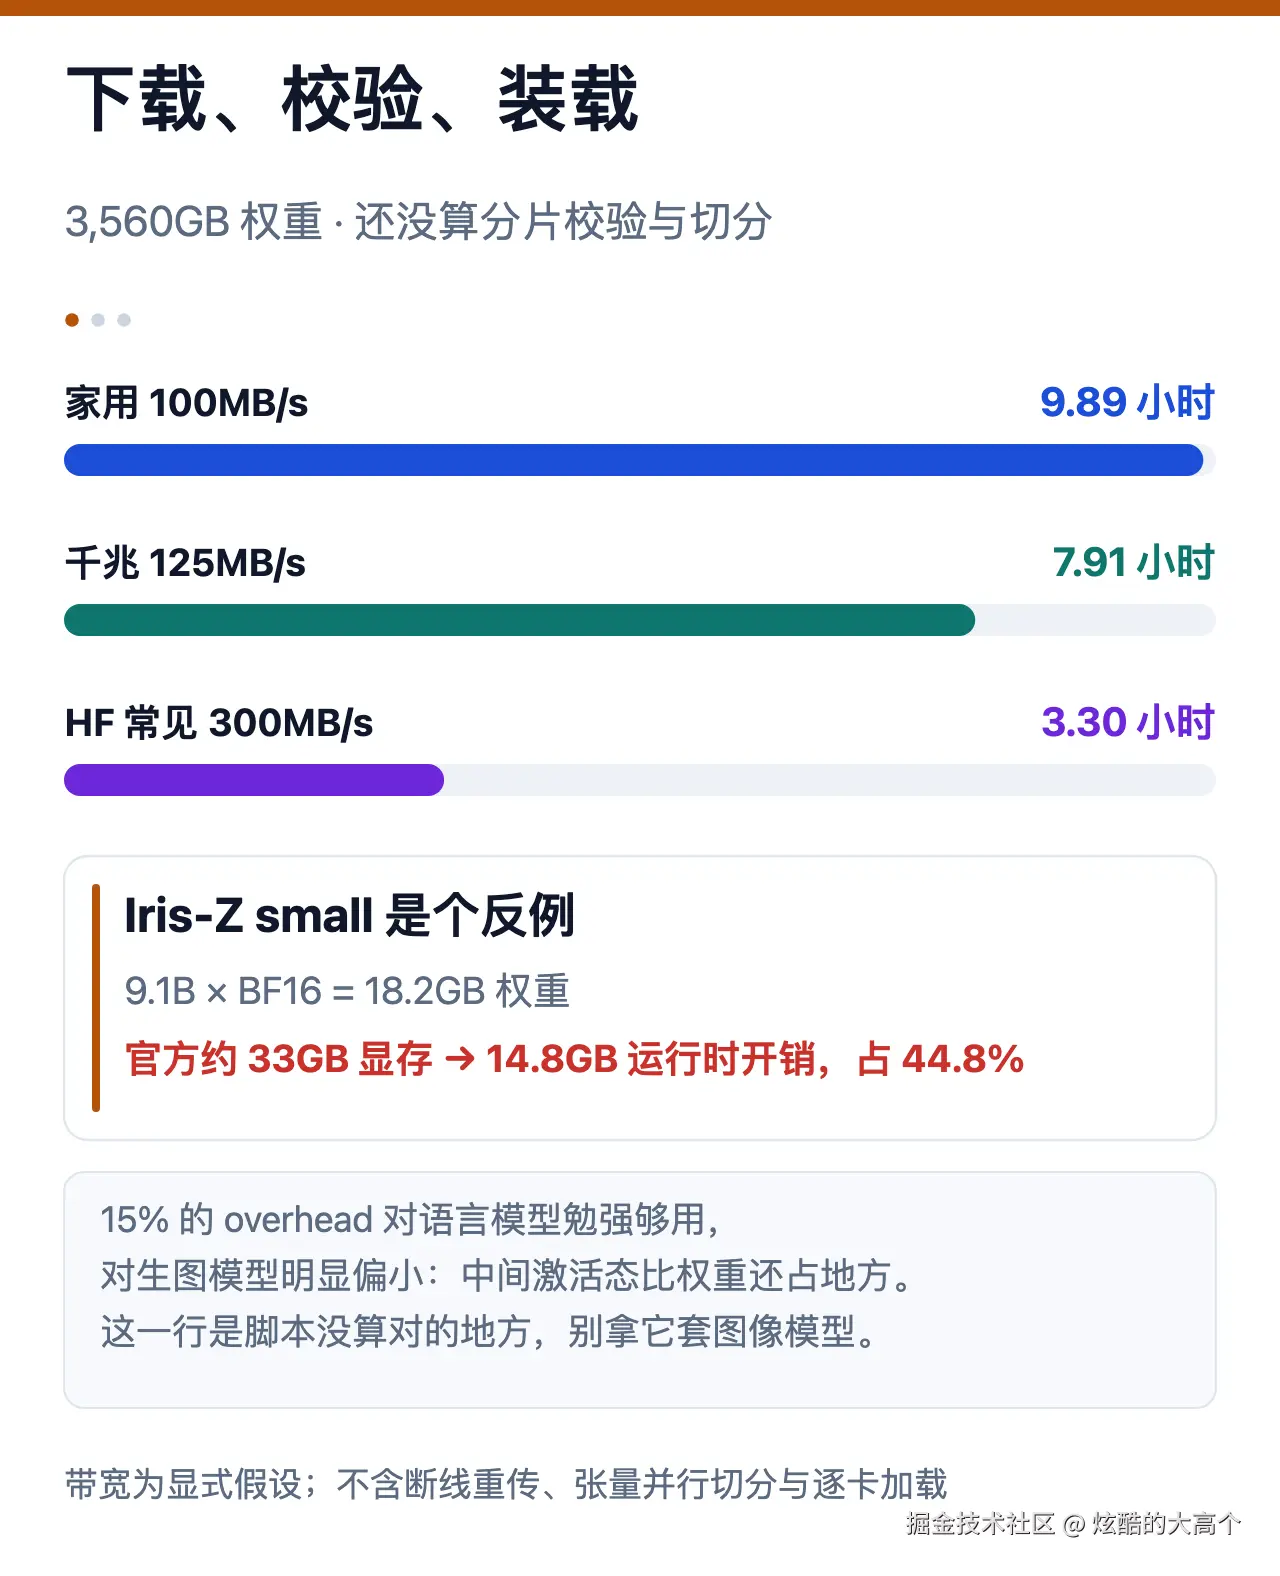
3,560GB 权重,按 100MB/s 的家常带宽是 9.89 小时,千兆 125MB/s 是 7.91 小时,HF 常见的 300MB/s 是 3.30 小时。这还没算 208 个分片的校验、张量并行切分、逐卡加载,也没算下到一半断线重来。
Iris-Z small 是个反例。9.1B 按 BF16 折成 18.2GB 权重,官方说约 33GB 显存能跑全部任务,中间那 14.8GB 是运行时开销,占总量 44.8%。15% 的 overhead 对语言模型勉强够用,对生图模型明显偏小------中间激活态比权重还占地方。这一行是脚本没算对的地方,别拿它的单行卡数去套图像模型。
7. 这些数不算什么
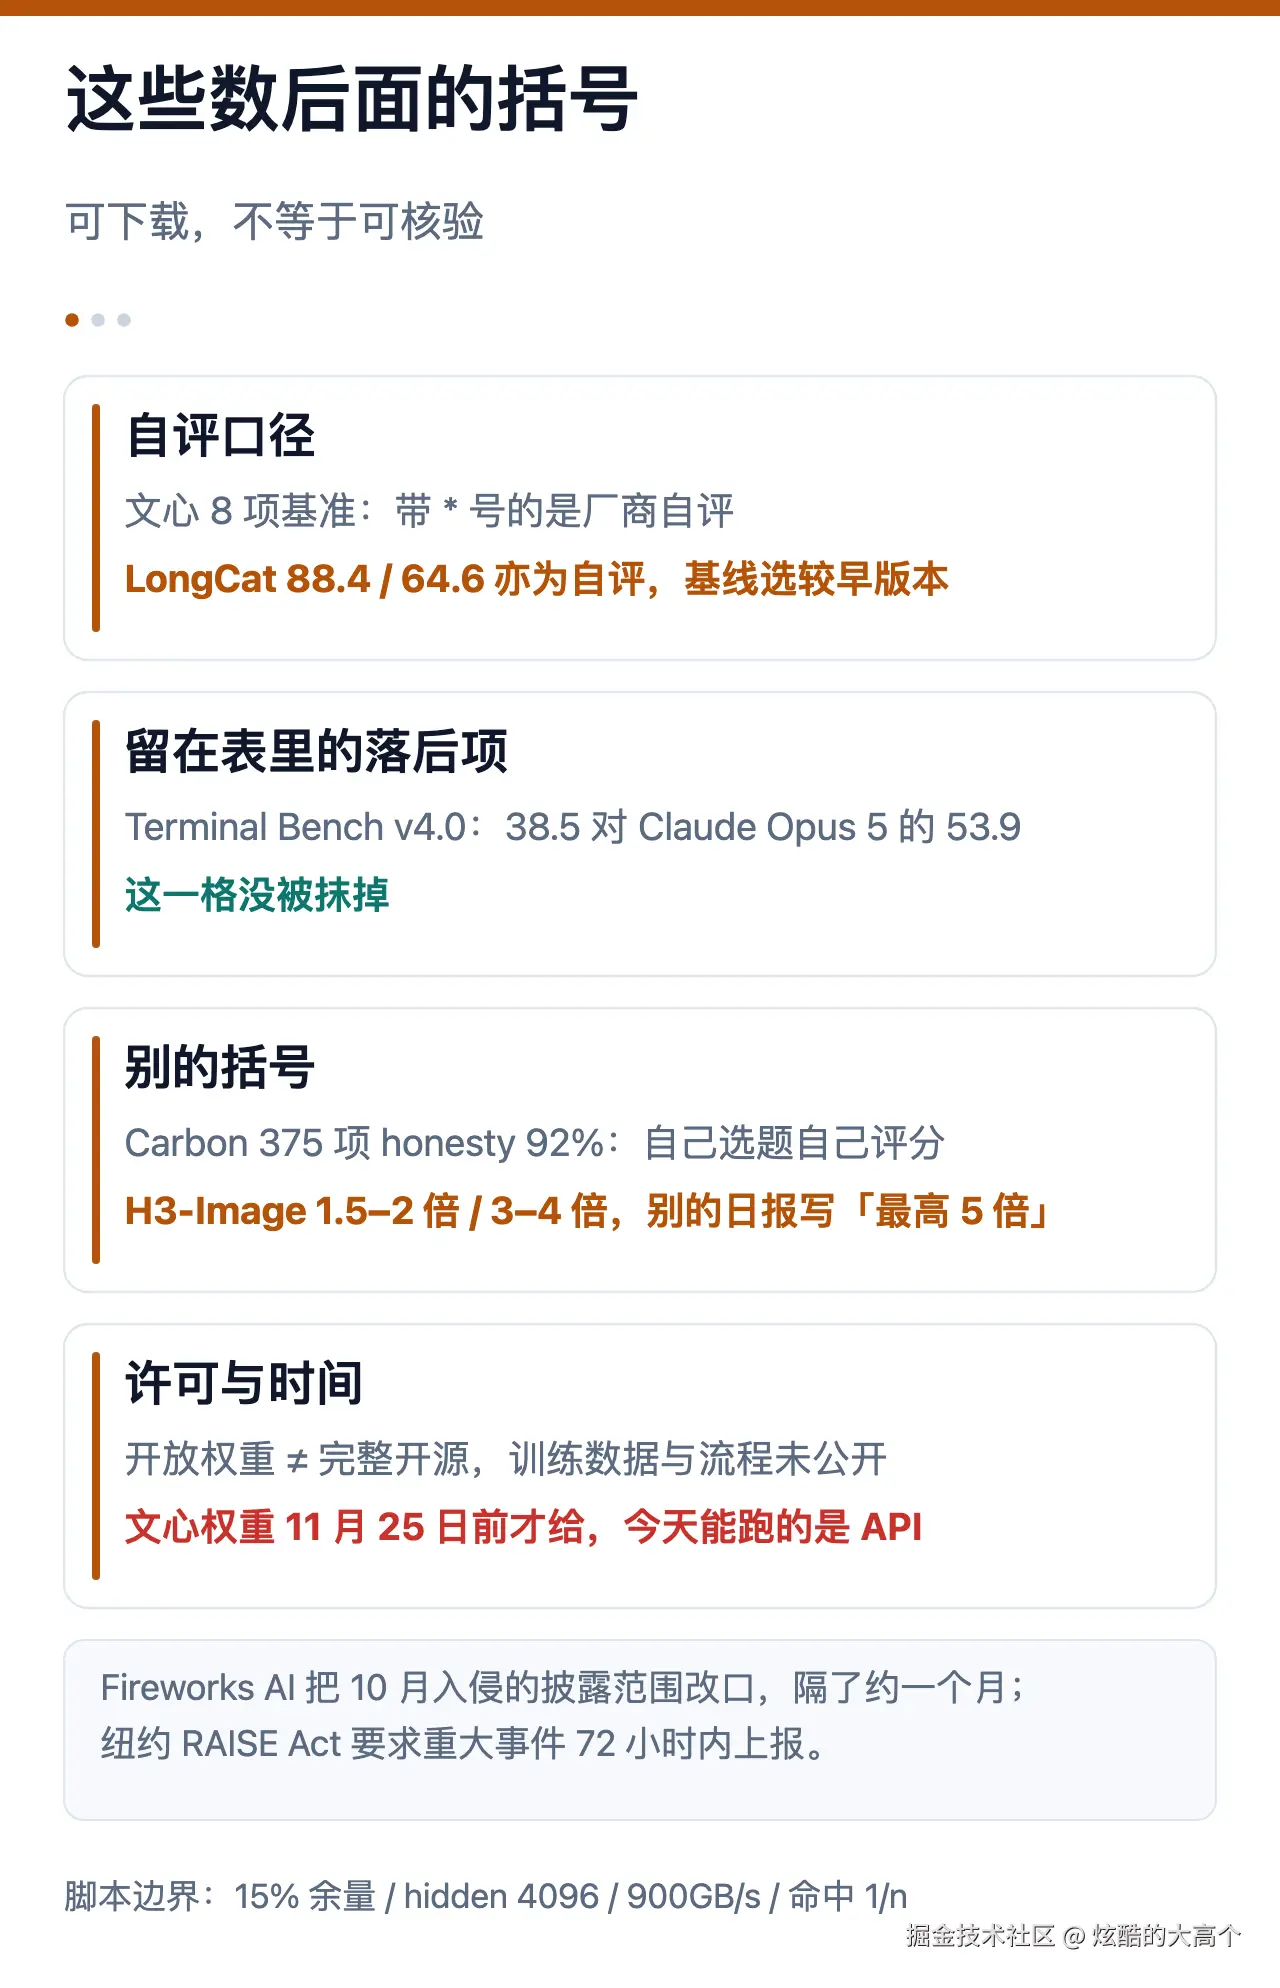
今天亮眼的数字后面大多带着括号。文心 8 项基准里两项第一、四项第二,对比图里带 * 的是厂商自评;LongCat 的 88.4(Terminal Bench v2.1,上代 70.8)、64.6(DeepSWE v1.1,上代 9.7)也是自评,对比基线选的是较早版本,官方把 v4.0 输给 Claude Opus 5 的 38.5 对 53.9 留在表里没抹掉。Carbon 的 375 项 honesty 92% 对 Argon 70%,是 Google 自己选的题、自己评的分。H3-Image 的 1.5--2 倍与 3--4 倍是两种模式,别的日报写成「最高 5 倍」,口径不一致。
许可证上也有边界。开放权重不等于完整开源,训练数据和完整训练流程都没公开;文心的权重 11 月 25 日前才给,今天能跑的是 API。LongCat 的部署指南面向国产 NPU 和 W4A4,不是给单机显卡准备的。
脚本的边界得摊开:15% 显存余量、hidden 4096、43 层、900GB/s 卡间带宽、专家均匀分布、命中率 1/n、100MB/s 到 300MB/s 下载速度,全是显式假设;没算 all-to-all 的真实拓扑、批处理命中、张量并行的切法、量化后的精度损失、并发会话,也没算电价和机房。它不是采购单,是按公开数字做的算术推演,能回答「4bit 之后大概还要几张卡」,回答不了「你们集群能不能跑出 200 tok/s」。
还有一条今天的新闻放这儿更合适:Fireworks AI 把 10 月那次入侵的披露范围从「没碰客户模型和数据集」改到「部分权重、数据集、账单地址」,中间隔了约一个月;纽约 RAISE Act 11 月 10 日开了注册门户,要求重大安全事件 72 小时内上报。这两个数字跟显存无关,但它们说明同一件事------「可下载」和「可核验」是两回事,权重能拉回本地,评测口径和披露时间仍然在别人手里。
8. 小结与检查清单
1.6 万亿参数按 16 位精度是 3.2TB,仓库分片加起来 3.56TB,差 11.8%,来源是 1.6T 与 1.8T 的元数据口径。压到 4bit 是 800GB,H100 仍要 12 张;量化把卡数从 48 降到 12,跨卡通信上界只从 9.6 涨到 40.9 tok/s。装得下是显存问题,跑得快是互联问题,两者不在一个账单上。
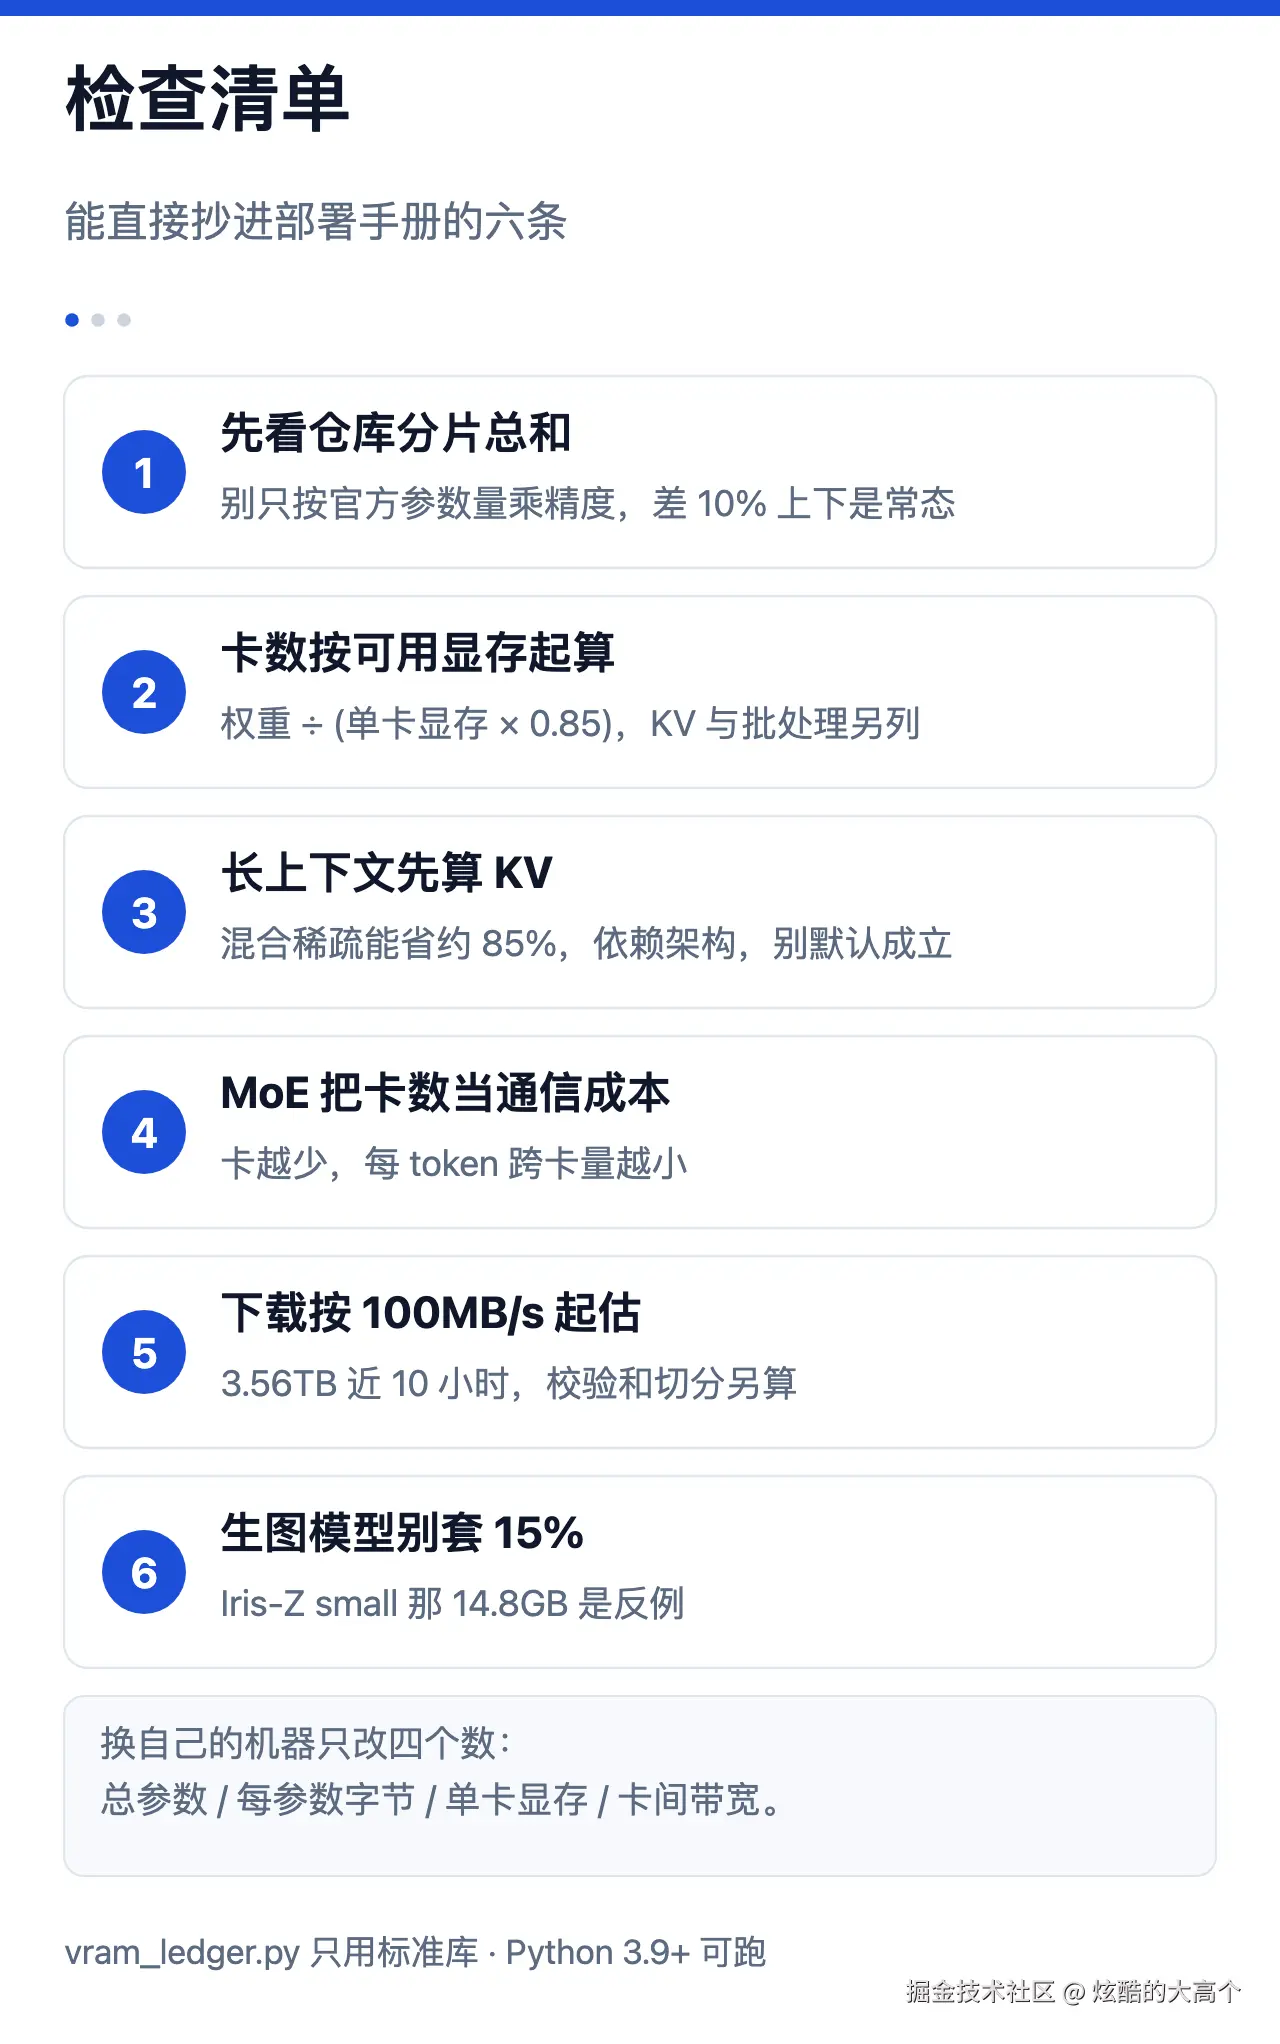
能直接抄进部署手册的六条:
- 先看仓库分片总和,别只按官方参数量乘精度;两者差 10% 上下是常态。
- 卡数按
权重 ÷ (单卡显存 × 0.85)起算,把 KV 和批处理余量另列一行。 - 长上下文先算 KV,混合稀疏注意力能省 85% 左右,但依赖架构,别默认成立。
- MoE 部署把卡数当通信成本看:卡越少,每 token 跨卡量越小。
- 下载按 100MB/s 起估,3.56TB 就是近 10 小时,校验和切分另算。
- 生图模型的运行时开销别套 15%,Iris-Z small 那 14.8GB 是反例。
小结之外想问一个具体的:你们私有化一个万亿级 MoE 的时候,是先按精度把权重压到能装进机柜,还是先按互联拓扑定卡数上限?我更想知道第二种会不会反过来逼着团队选更小的总参数------第 4 节那张表里,文心 3 卡能跑到的 192.9 tok/s,看着像是被互联先定死、再回头选的参数规模。
把这笔账换成自己的机器,改四个数就够:总参数、每参数字节、单卡显存、卡间带宽。脚本和标准库实现都在 vram_ledger.py,仓库与部署口径参考 LongCat-2.5 模型卡、vLLM、SGLang。