引言
工具调用已经是Agent领域的老生常谈了,
但我发现,很多人虽然每天都在使用 Agent,对工具调用背后的运行机制却未必真正理解。
比如,
大模型能直接执行工具吗?
Function Calling 和 MCP 到底是什么关系?
一个工具调用从发起到执行,再到结果返回,究竟经历了哪些步骤?
结合最近对 Pi 框架的研究,我写了这篇文章,也算是 Pi 源码研究系列的第二篇。
上一篇文章,我们重点研究了 Pi 的 Agent Loop。这一次,我们继续深入,聊聊 Agent 的工具调用机制。
第一篇:上一篇文章链接
理解工具调用
什么是 Function Calling?
官方一点介绍,
Function Calling(函数调用)是一种让大语言模型(LLM)能够调用外部工具的机制。
这个概念听起来很简单,毕竟,我们平时使用各种 Agent 产品时,经常会遇到工具调用,
比如读取文件的 read、写入文件的 write,以及执行命令的 bash 等。
但工具调用背后的执行流程,其实非常值得拿出来讲讲。
一次完整的 Function Calling 是如何发生的?
最开始接触 Function Calling 时,我一直有个误区:
我以为 Function Calling 就是大模型直接执行工具,自行完成各种操作。
我相信不少人也有类似的理解。
但实际上,并不是这样。
在正式介绍 Function Calling 之前,我们需要先明确一个概念:
Agent = LLM + Harness
LLM就是大模型,Agent就是我们日常使用的Cursor、Claude什么的,Harness的具体概念,在上一篇文章中有介绍,这里就不再赘述。
Harness 其实是工程侧的概念。
什么叫工程侧?
简单来说,就是由我们编写的程序代码来实现的部分,有明确的执行逻辑,行为相对可控。
比如平时开发的 Java 后端、前端程序,以及各种 TypeScript、Python 服务,都属于工程侧。
按照我之前的理解,Function Calling 是由大模型直接完成的,根本不需要工程侧参与。
但实际上恰恰相反,工具调用的真正执行者,正是 Harness。
首先,在 Agent 初始化时,开发者会注册一组工具,比如 read、write、bash 等。
每个工具都有对应的名称、功能描述,以及参数 Schema。
当用户向 Agent 发送请求后,Agent 在调用 LLM 时,会把可用工具的定义一并提供给模型。
模型根据用户请求和上下文,自行判断是否需要调用工具。
如果需要,它就会生成一条结构化的工具调用请求,其中包含工具名称和调用参数。
接下来,重点来了。
真正负责执行工具的,不是 LLM,而是 Harness。
Harness 接收到模型的响应后,会识别其中的工具调用请求,找到对应的工具,校验参数,并执行相关代码。
工具执行完成后,Harness 会将执行结果封装为 Message,加入对话上下文,供下一轮 LLM 调用使用。
因此,整个流程可以总结为:
sql
用户发送请求
    ↓
Agent 调用 LLM
    ↓
LLM 判断是否需要调用工具
    ↓
LLM 生成结构化 Tool Call
    ↓
Harness 解析 Tool Call
    ↓
Harness 查找并执行对应工具
    ↓
将工具执行结果封装为 Message
    ↓
再次调用 LLM
    ↓
LLM 根据工具结果继续决策
所以,理解 Function Calling,最重要的一点就是:
LLM 负责决定调用什么工具、传入什么参数,而 Harness 负责真正执行工具,并将结果重新反馈给 LLM。
本地 Function Calling 与 MCP 有什么关联?
说到工具调用,就不得不提 MCP。
官方一点介绍,MCP(Model Context Protocol,模型上下文协议)是一种用于连接 AI 应用与外部工具、数据源的标准化协议。
Function Calling 解决模型如何表达工具调用意图的问题,而 MCP 解决 AI 应用如何以统一协议发现和访问外部工具的问题。
这两个概念不仅不冲突,还是相互配合的。
因为就算是外部的工具,在最开始,也会和内部工具混合在一起,统一注册,发给LLM。
在LLM侧,是不感知Tool是MCP的Tool,还是本地的Tool,它只知道一份清单。
当LLM要执行的Tool,是MCP的Tool时,再由Harness,通过MCP的协议,执行外部的接口,然后再将执行结果告知给LLM。
整体流程如下
arduino
                 LLM
                  ↓
           生成 Tool Call
                  ↓
                Harness
                  ↓
              查找对应工具
                  ↓
           ┌──────┴──────┐
           ↓             ↓
        本地工具       MCP 工具
           ↓             ↓
       本地执行       MCP Client
                         ↓
                    MCP Server
           ↓             ↓
           └──────┬──────┘
                  ↓
              工具执行结果
                  ↓
            返回给 LLM
下面,来点干货
Pi 的工具调用实现
上一篇文章,我们重点介绍了 Pi 的 Agent Loop 实现。
当时,对于工具执行部分,我们只是简单带过了,因为如果展开讲,文章篇幅就太长了。
这一次,我们就专门研究 Pi 的工具调用实现。
看看一次 Tool Call,从模型发起,到工具执行,再到结果重新进入 Agent Loop,究竟经历了哪些步骤。
入口
我们还是回到runLoop方法,工具执行的入口在这里:
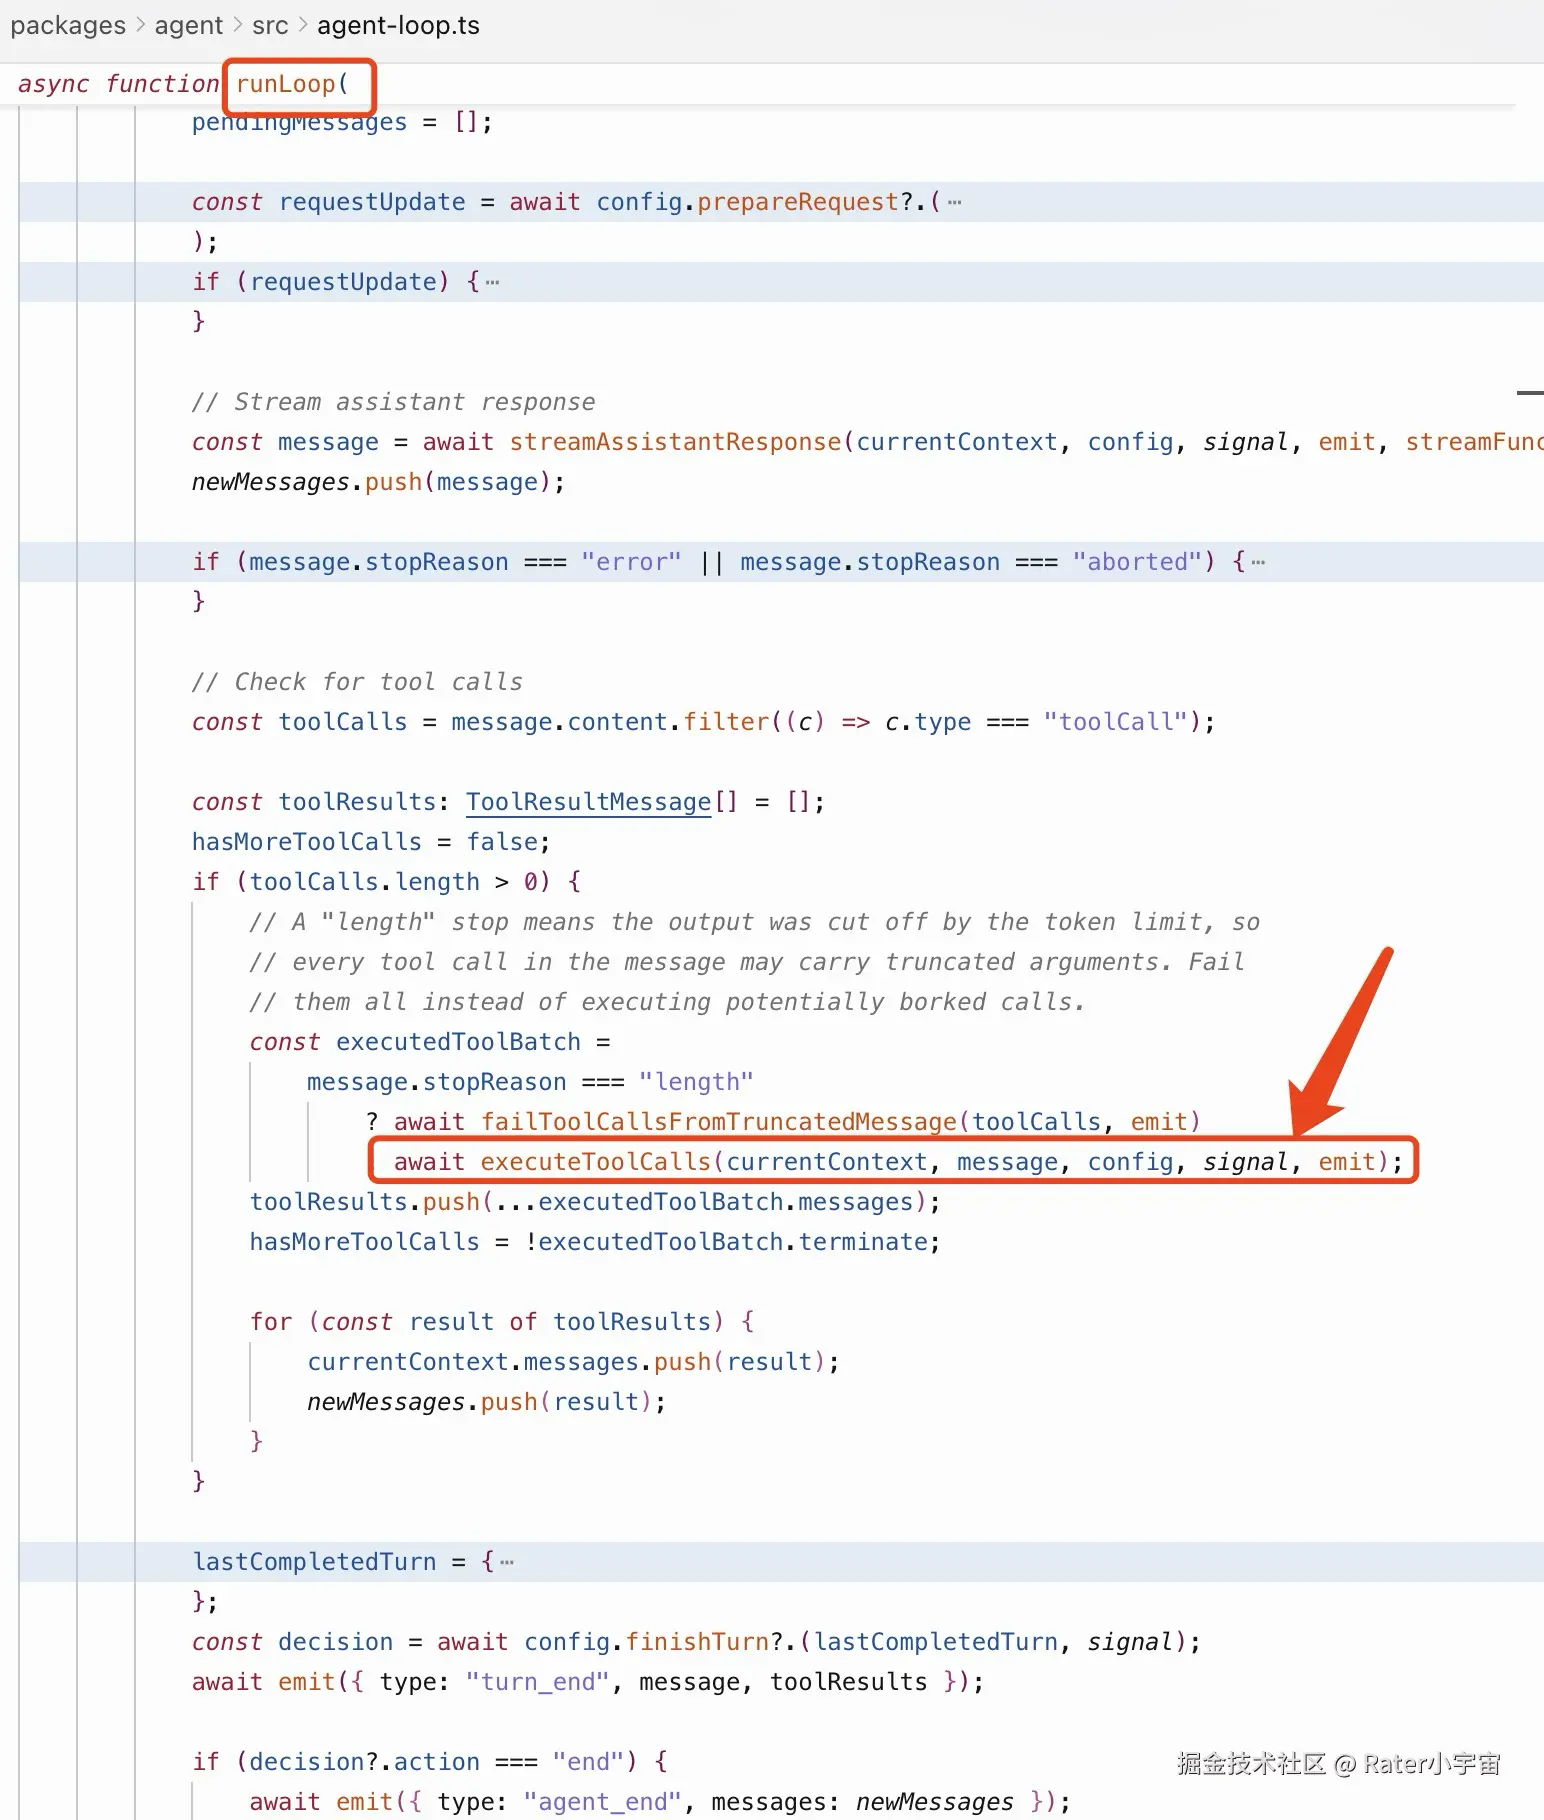
runLoop() 在收到模型响应后,会检查其中是否包含工具调用。如果存在,就会进入executeToolCalls(),交由工具执行系统处理。 下面我们进入executeToolCalls方法看看
串行和并行
Pi 支持两种工具执行模式:串行和并行,如下图:
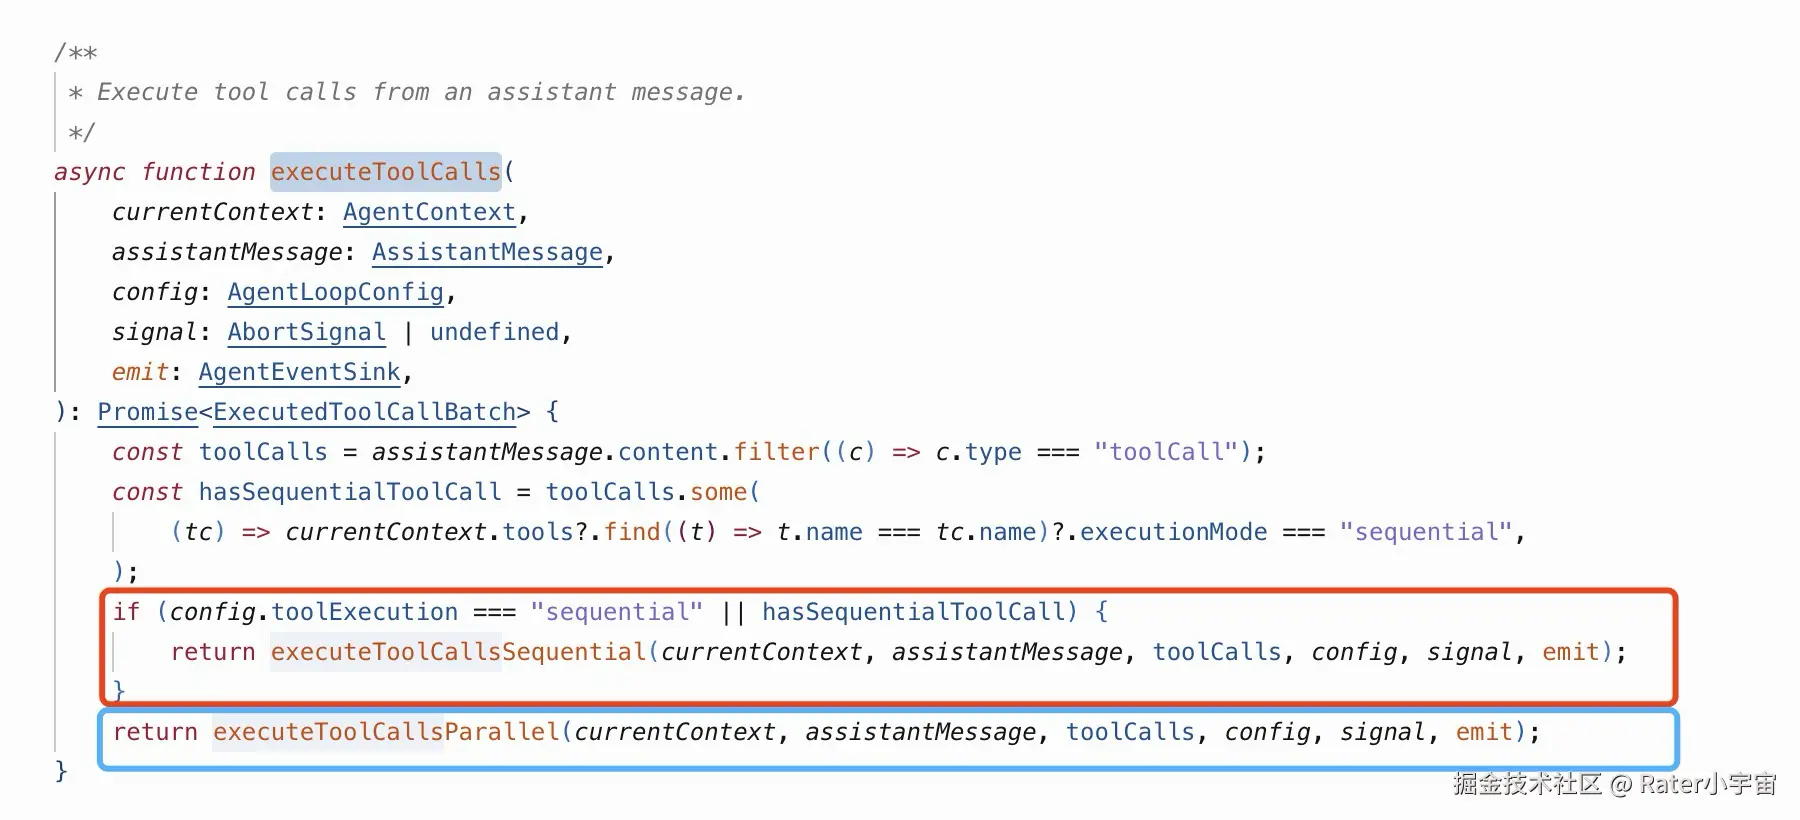
判断依据是:
config.toolExecution === "sequential" || hasSequentialToolCall
这里有两个条件:
第一个是全局配置,决定工具调用是否统一采用串行执行。
第二个是 hasSequentialToolCall,用于判断当前这批工具中,是否存在要求串行执行的工具。
只要满足其中一个条件,就会进入串行模式。
否则,就采用并行模式。
在没有额外限制的情况下,Pi 倾向于采用并行执行,以提高效率。
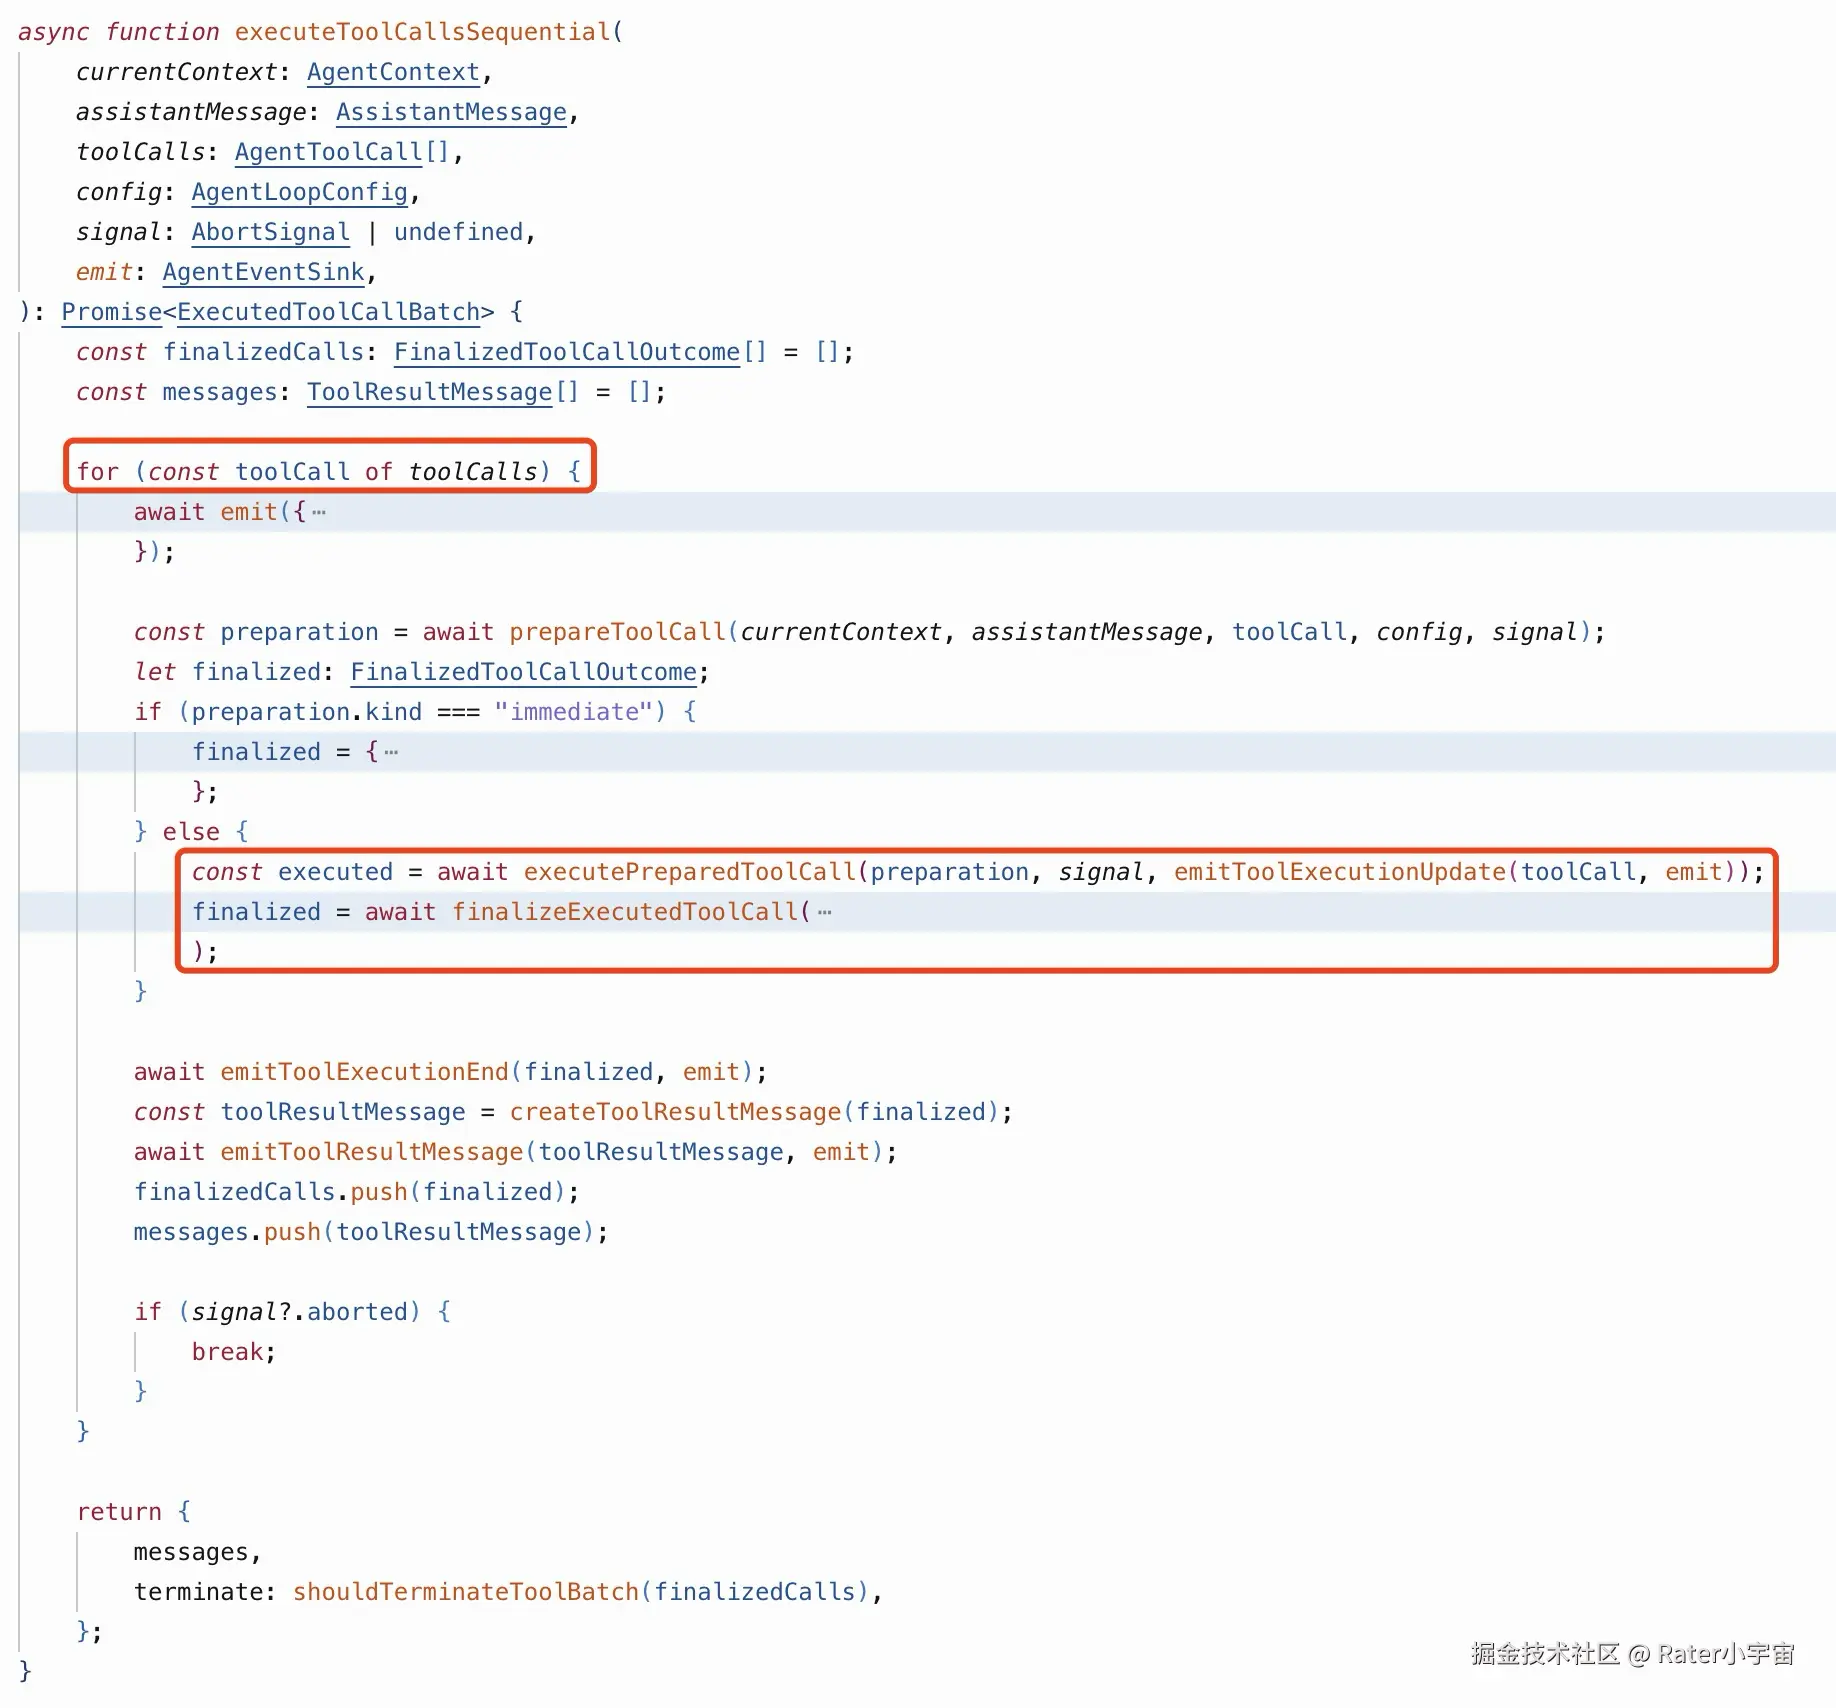
executeToolCallsSequential 和 executeToolCallsParallel 方法,分别是串行和并行的具体代码,其实里面执行的逻辑基本一样,最大的区别是,
串行:在 for 循环里直接 await:
scss
for (const toolCall of toolCalls) {
  await executePreparedToolCall(...);
}
所以必须等当前工具完成,才进入下一轮。
并行:先把执行逻辑保存成异步函数:
dart
finalizedCalls.push(async () => {
  return await executePreparedToolCall(...);
});
最后用 Promise.all 同时启动:
ini
await Promise.all(
  finalizedCalls.map(entry => entry())
);
代码如下
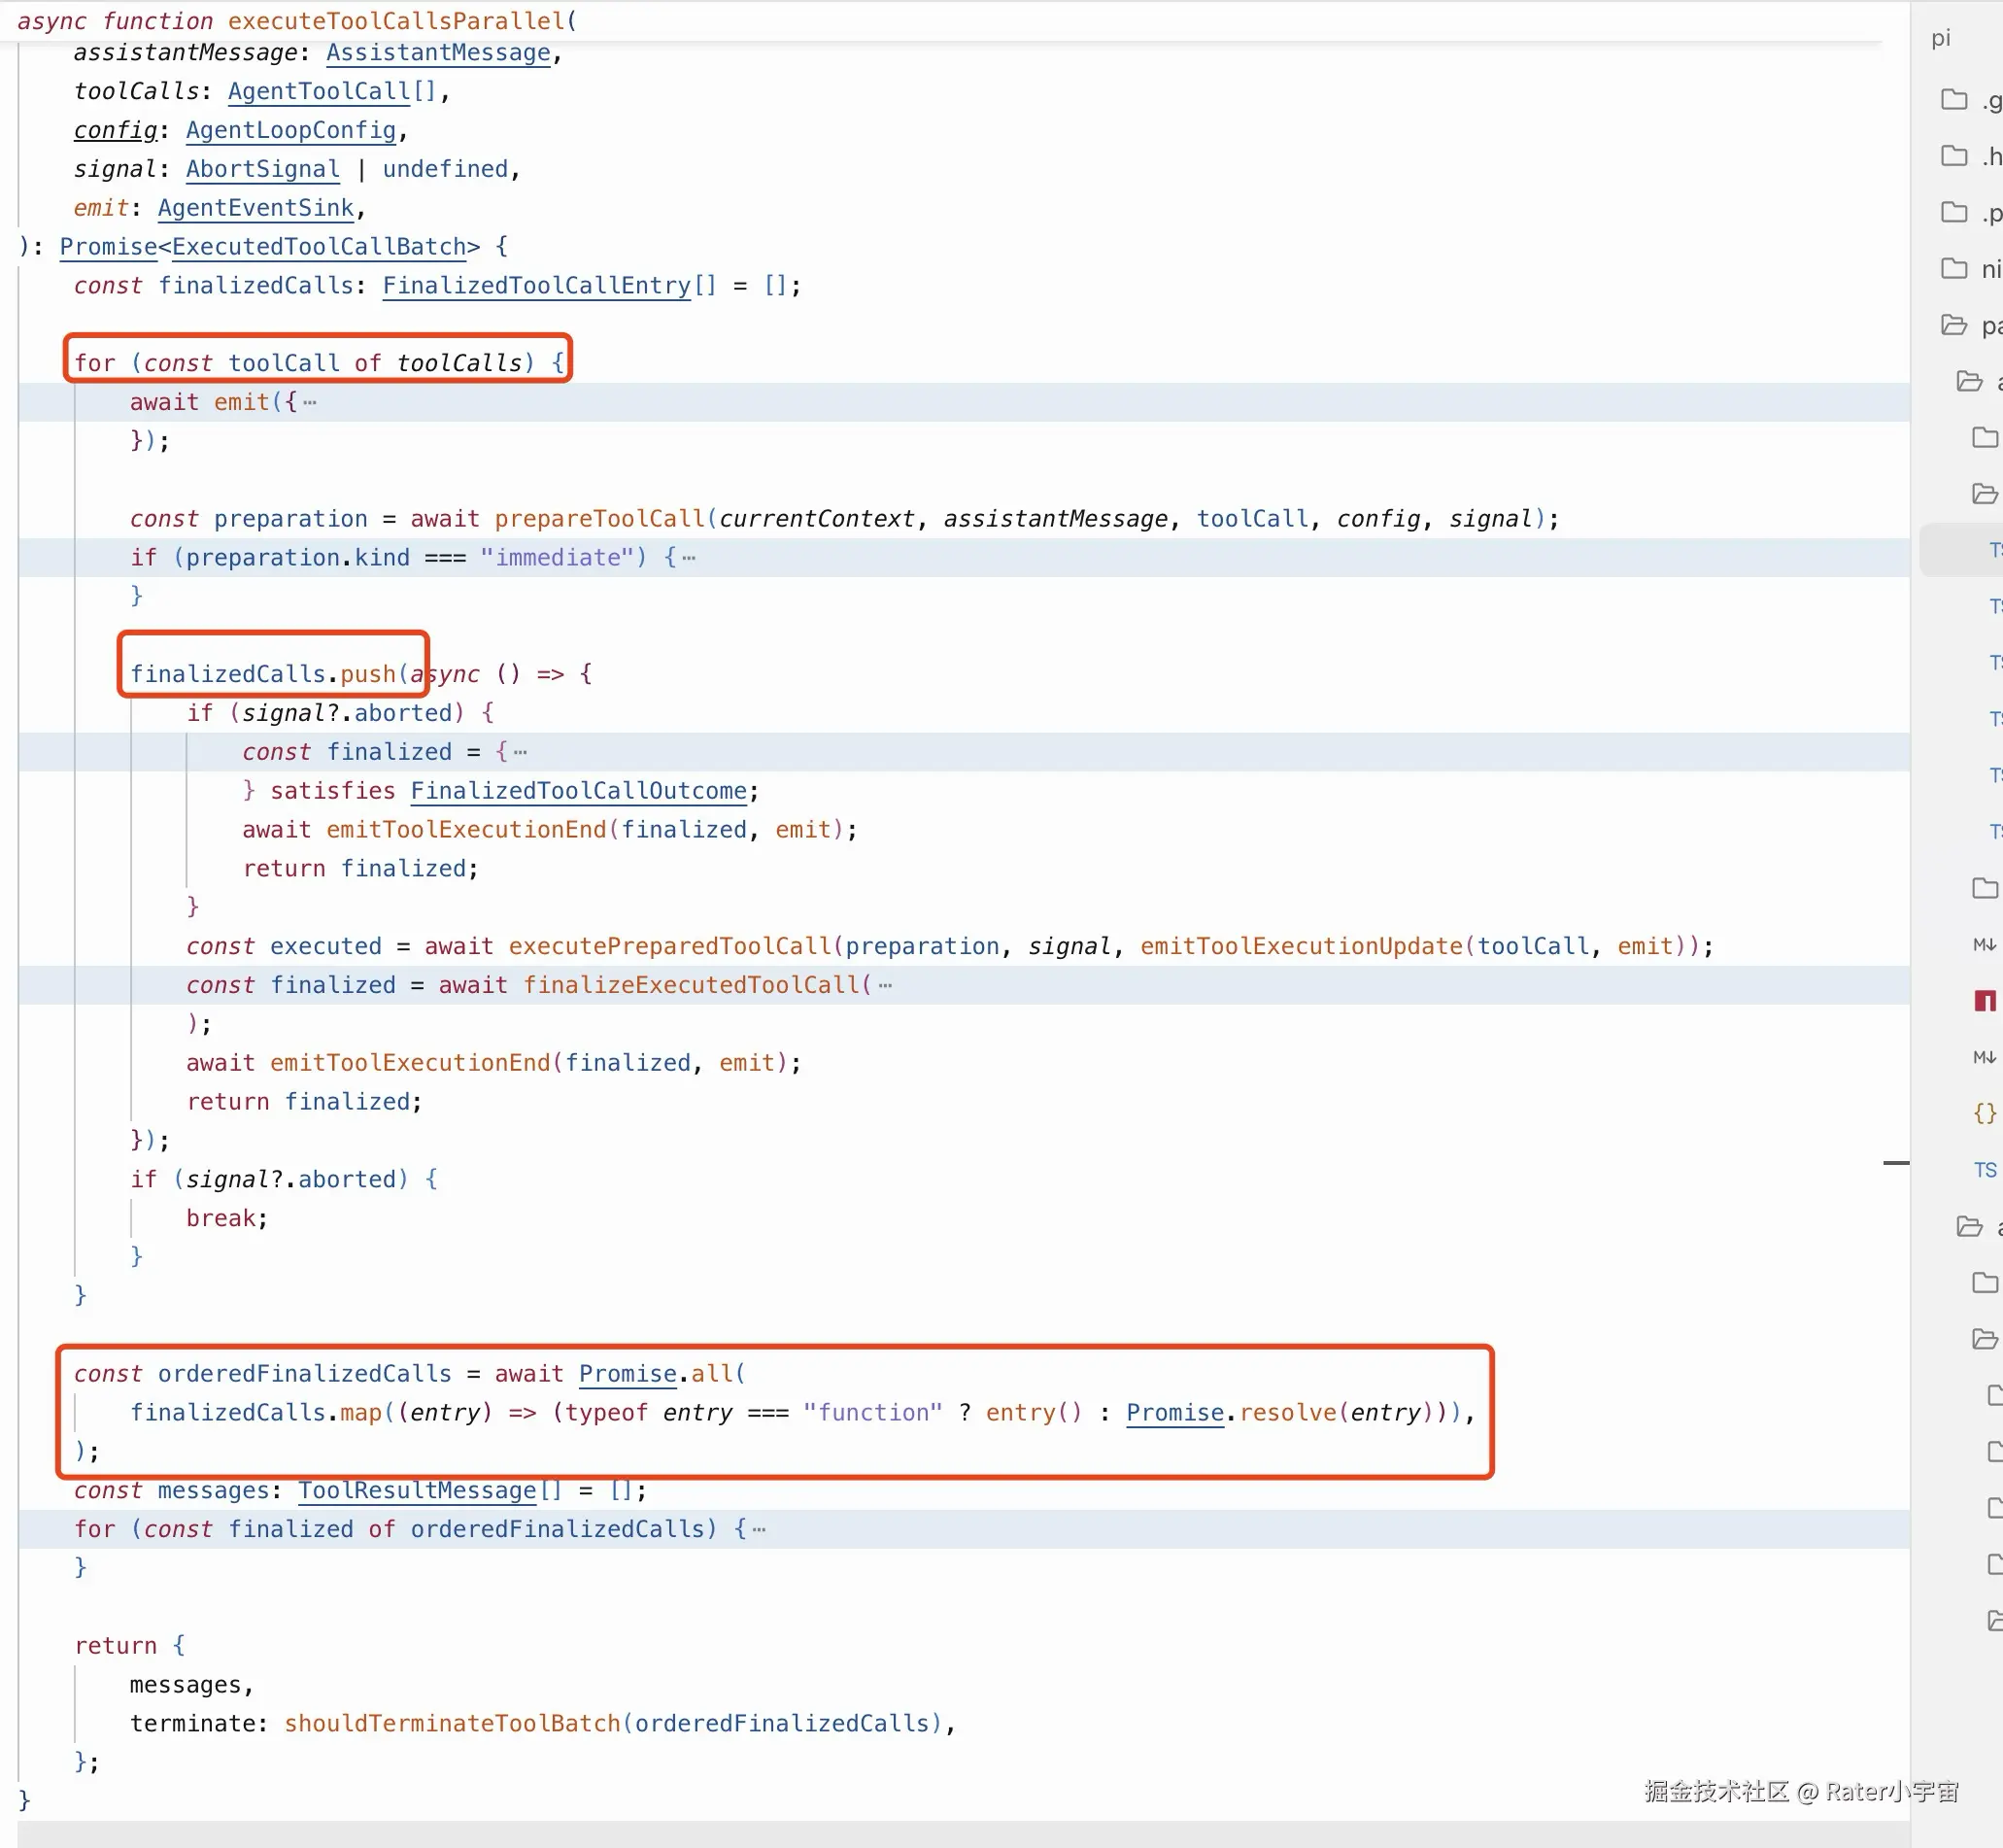
其他的执行逻辑基本是一样的了。
执行前的准备prepareToolCall()
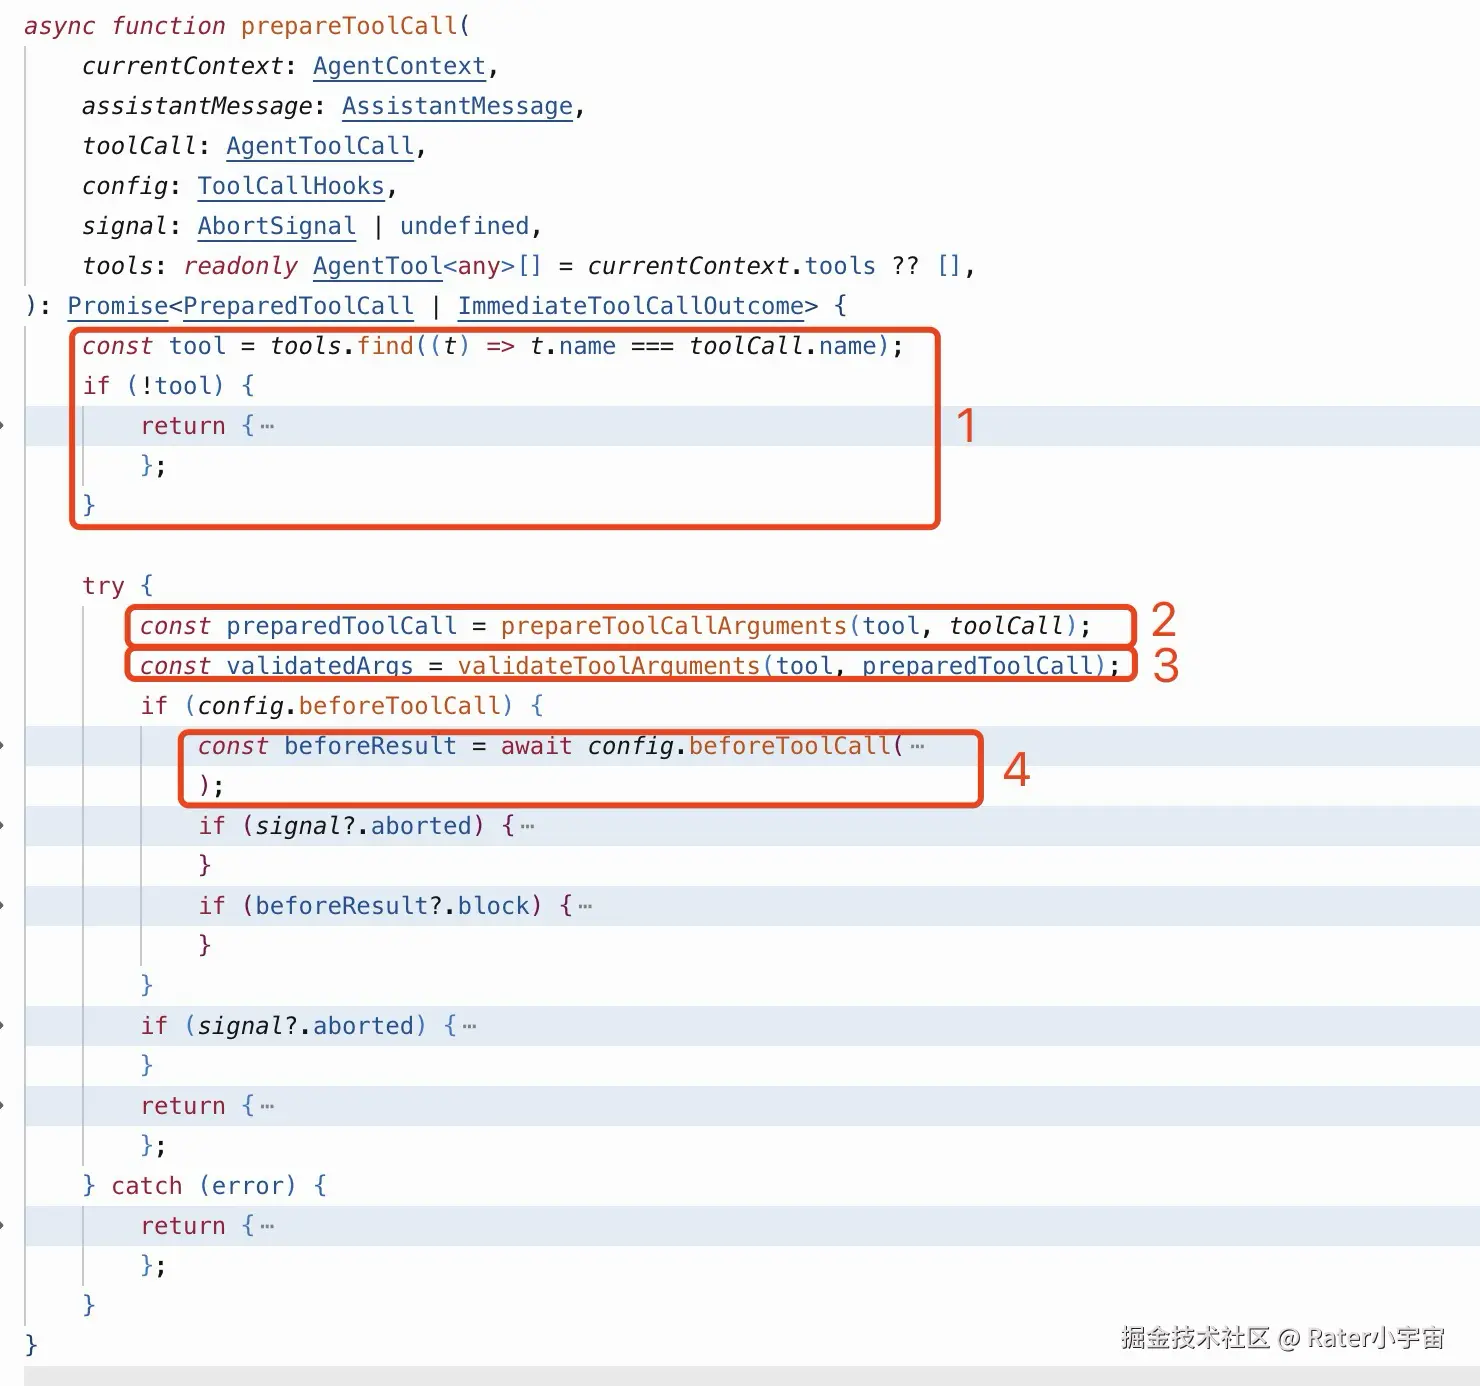
prepareToolCall做的事情,主要是我框出来的四个地方。
1. 检查工具是否存在
2. 适配工具参数
3. 校验schema
4. 执行beforeToolCall Hook
这一步非常重要。
因为工具能不能执行,不应该完全由模型说了算。
实际开发中,我们往往还需要在工具执行前增加一些工程控制逻辑。
比如:
权限检查:当前操作是否允许执行?
用户确认:删除文件、执行危险命令前是否需要确认?
日志审计:记录工具名称、参数等执行信息。
策略拦截:是否命中了某些禁止执行的规则?
这些逻辑,都可以通过此 Hook 来实现。
如果 Hook 决定拦截当前操作,Pi 就不会继续执行对应工具,而是返回错误结果。
这样一来,工具执行就不再是模型生成什么,程序就无条件执行什么。
其他
在阅读源码时,我还注意到了两处 signal?.aborted 判断。
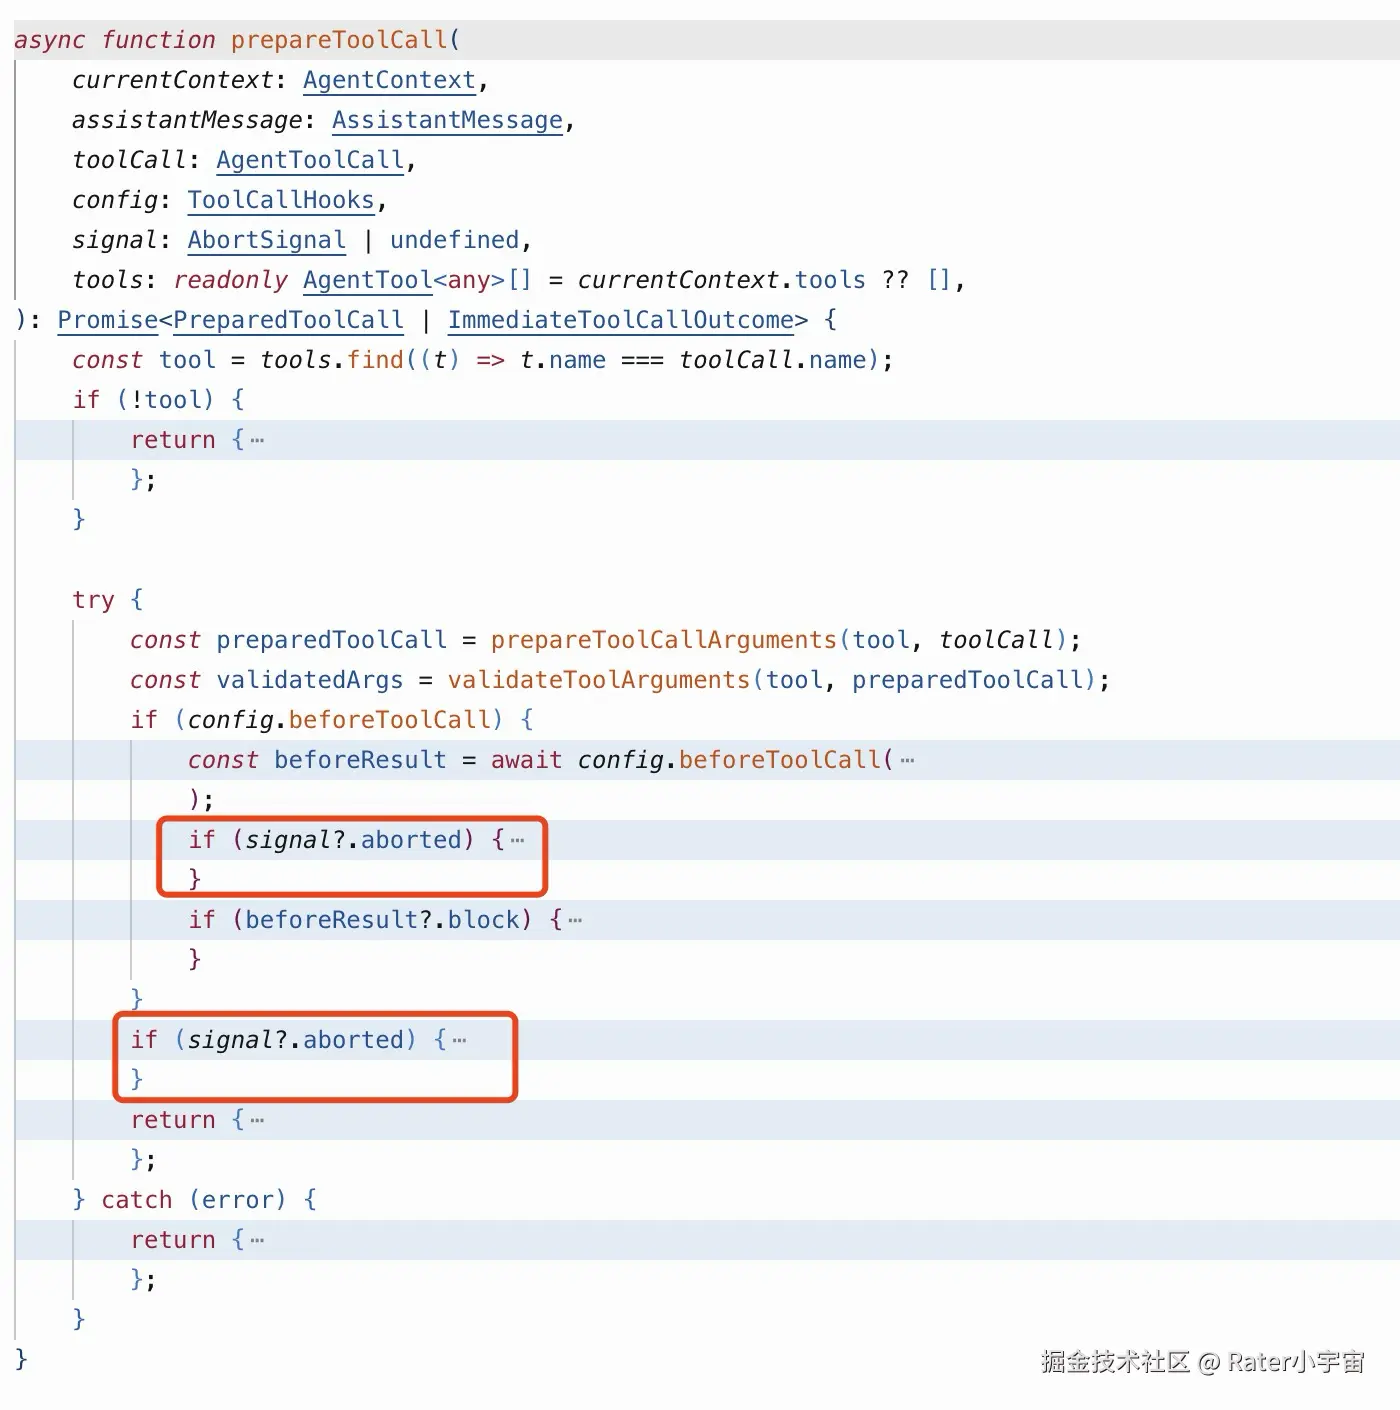
这个字段用于检查当前操作是否已经收到取消信号,比如用户主动中止 Agent 的执行。
为什么要判断两次?因为两次检查所处的位置不同。
第一处:只在存在 beforeToolCall 时执行,保证"取消"优先于"拦截"。第二处:无论有没有 beforeToolCall 都执行。
到这里,工具执行前的准备工作就完成了。
工具执行:executePreparedToolCall()
这个方法其实没有什么可说的,核心就是执行工具,我们就直接略过了。 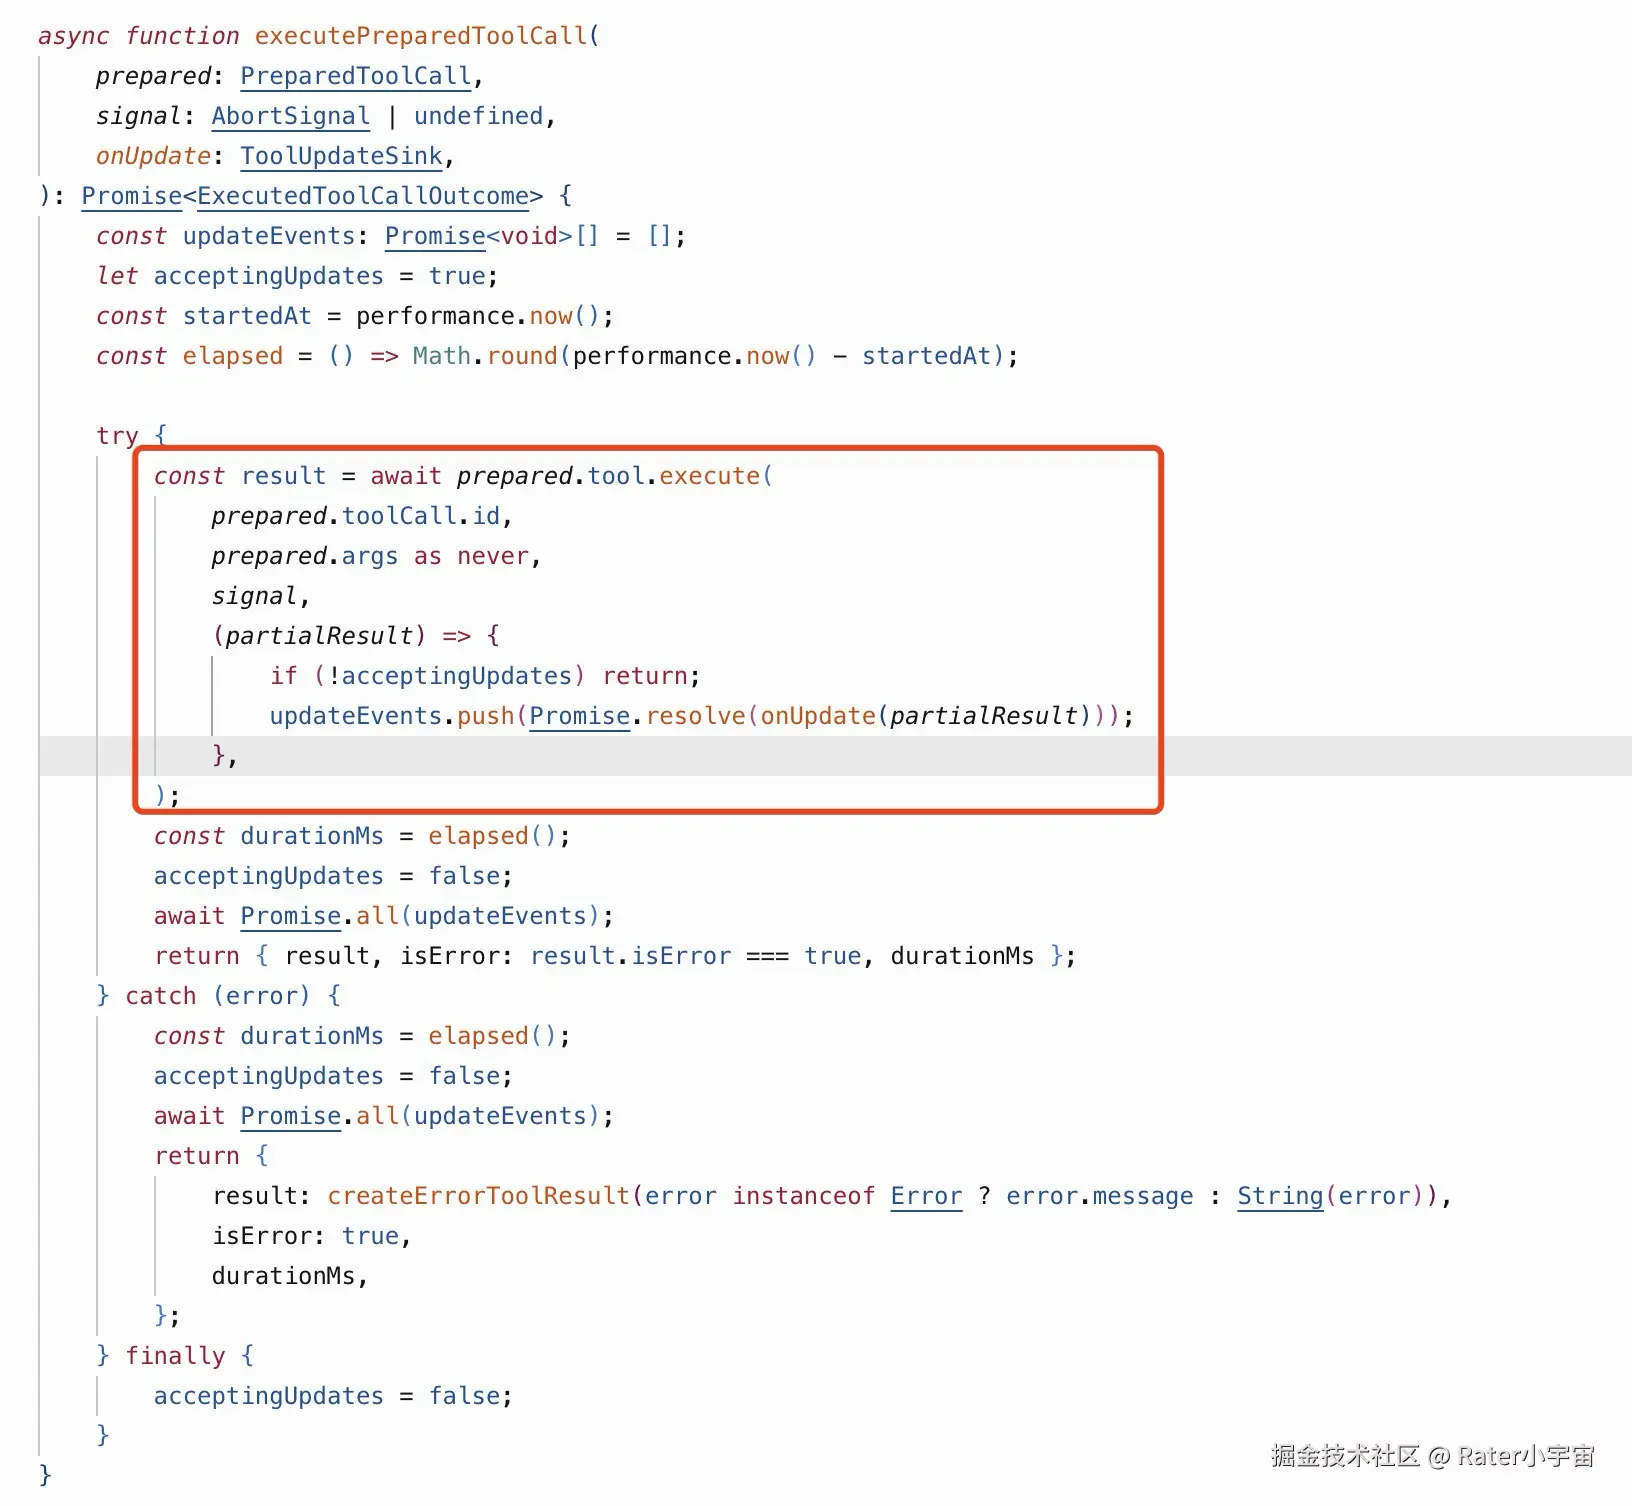
执行后的检查finalizeExecutedToolCall()
这里主要是执行一下所有的 afterToolCall Hook 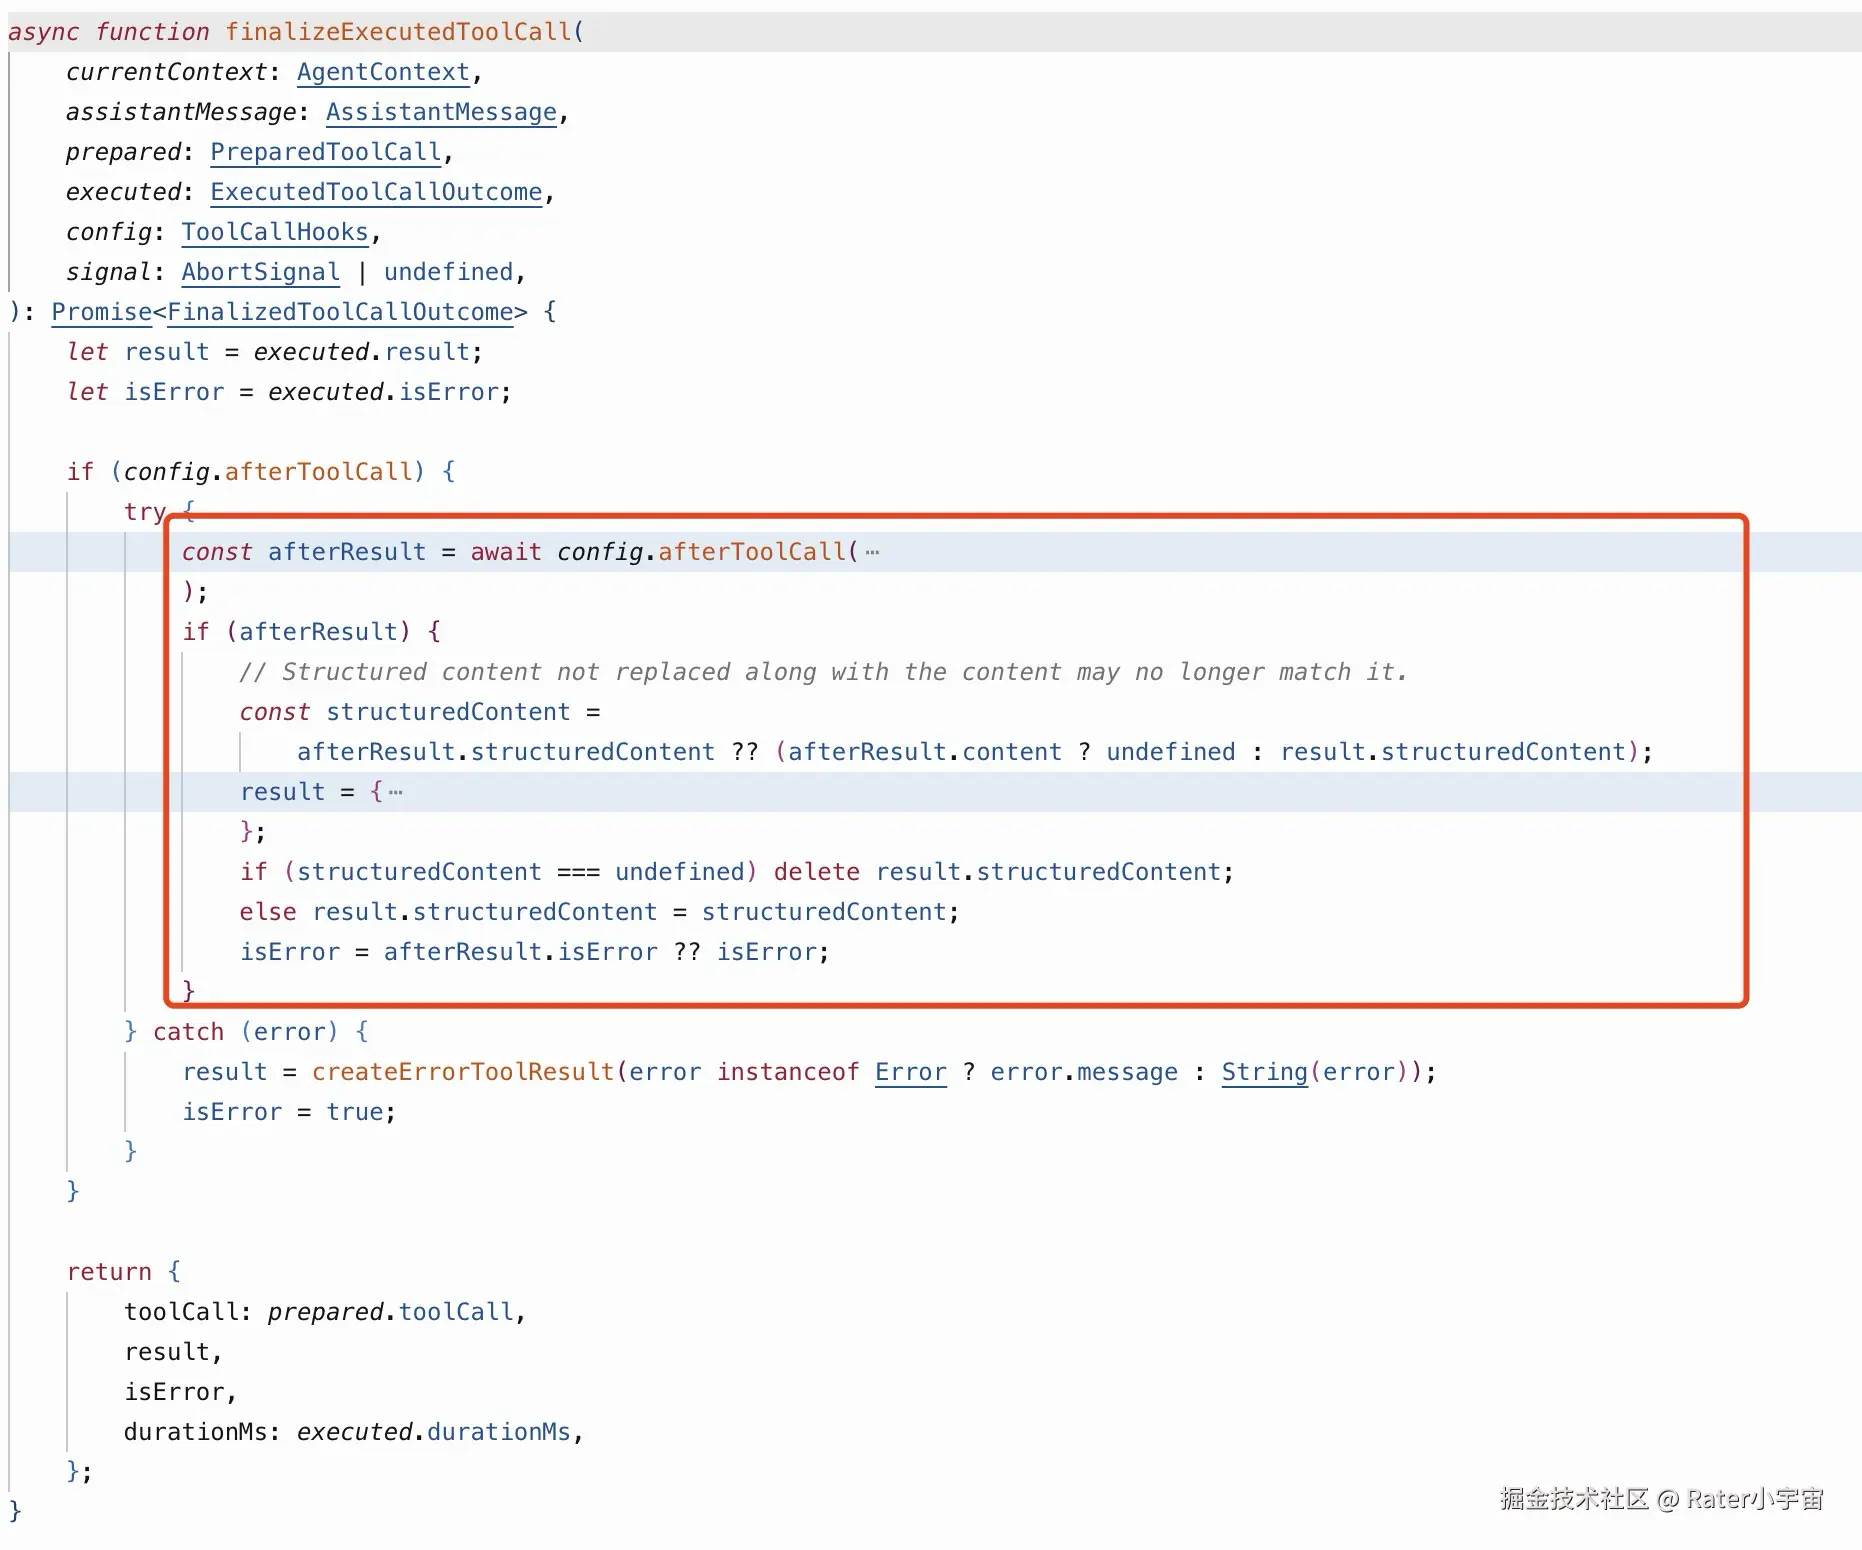
这里适合进行脱敏、截断、格式转换、错误修正、统计等操作
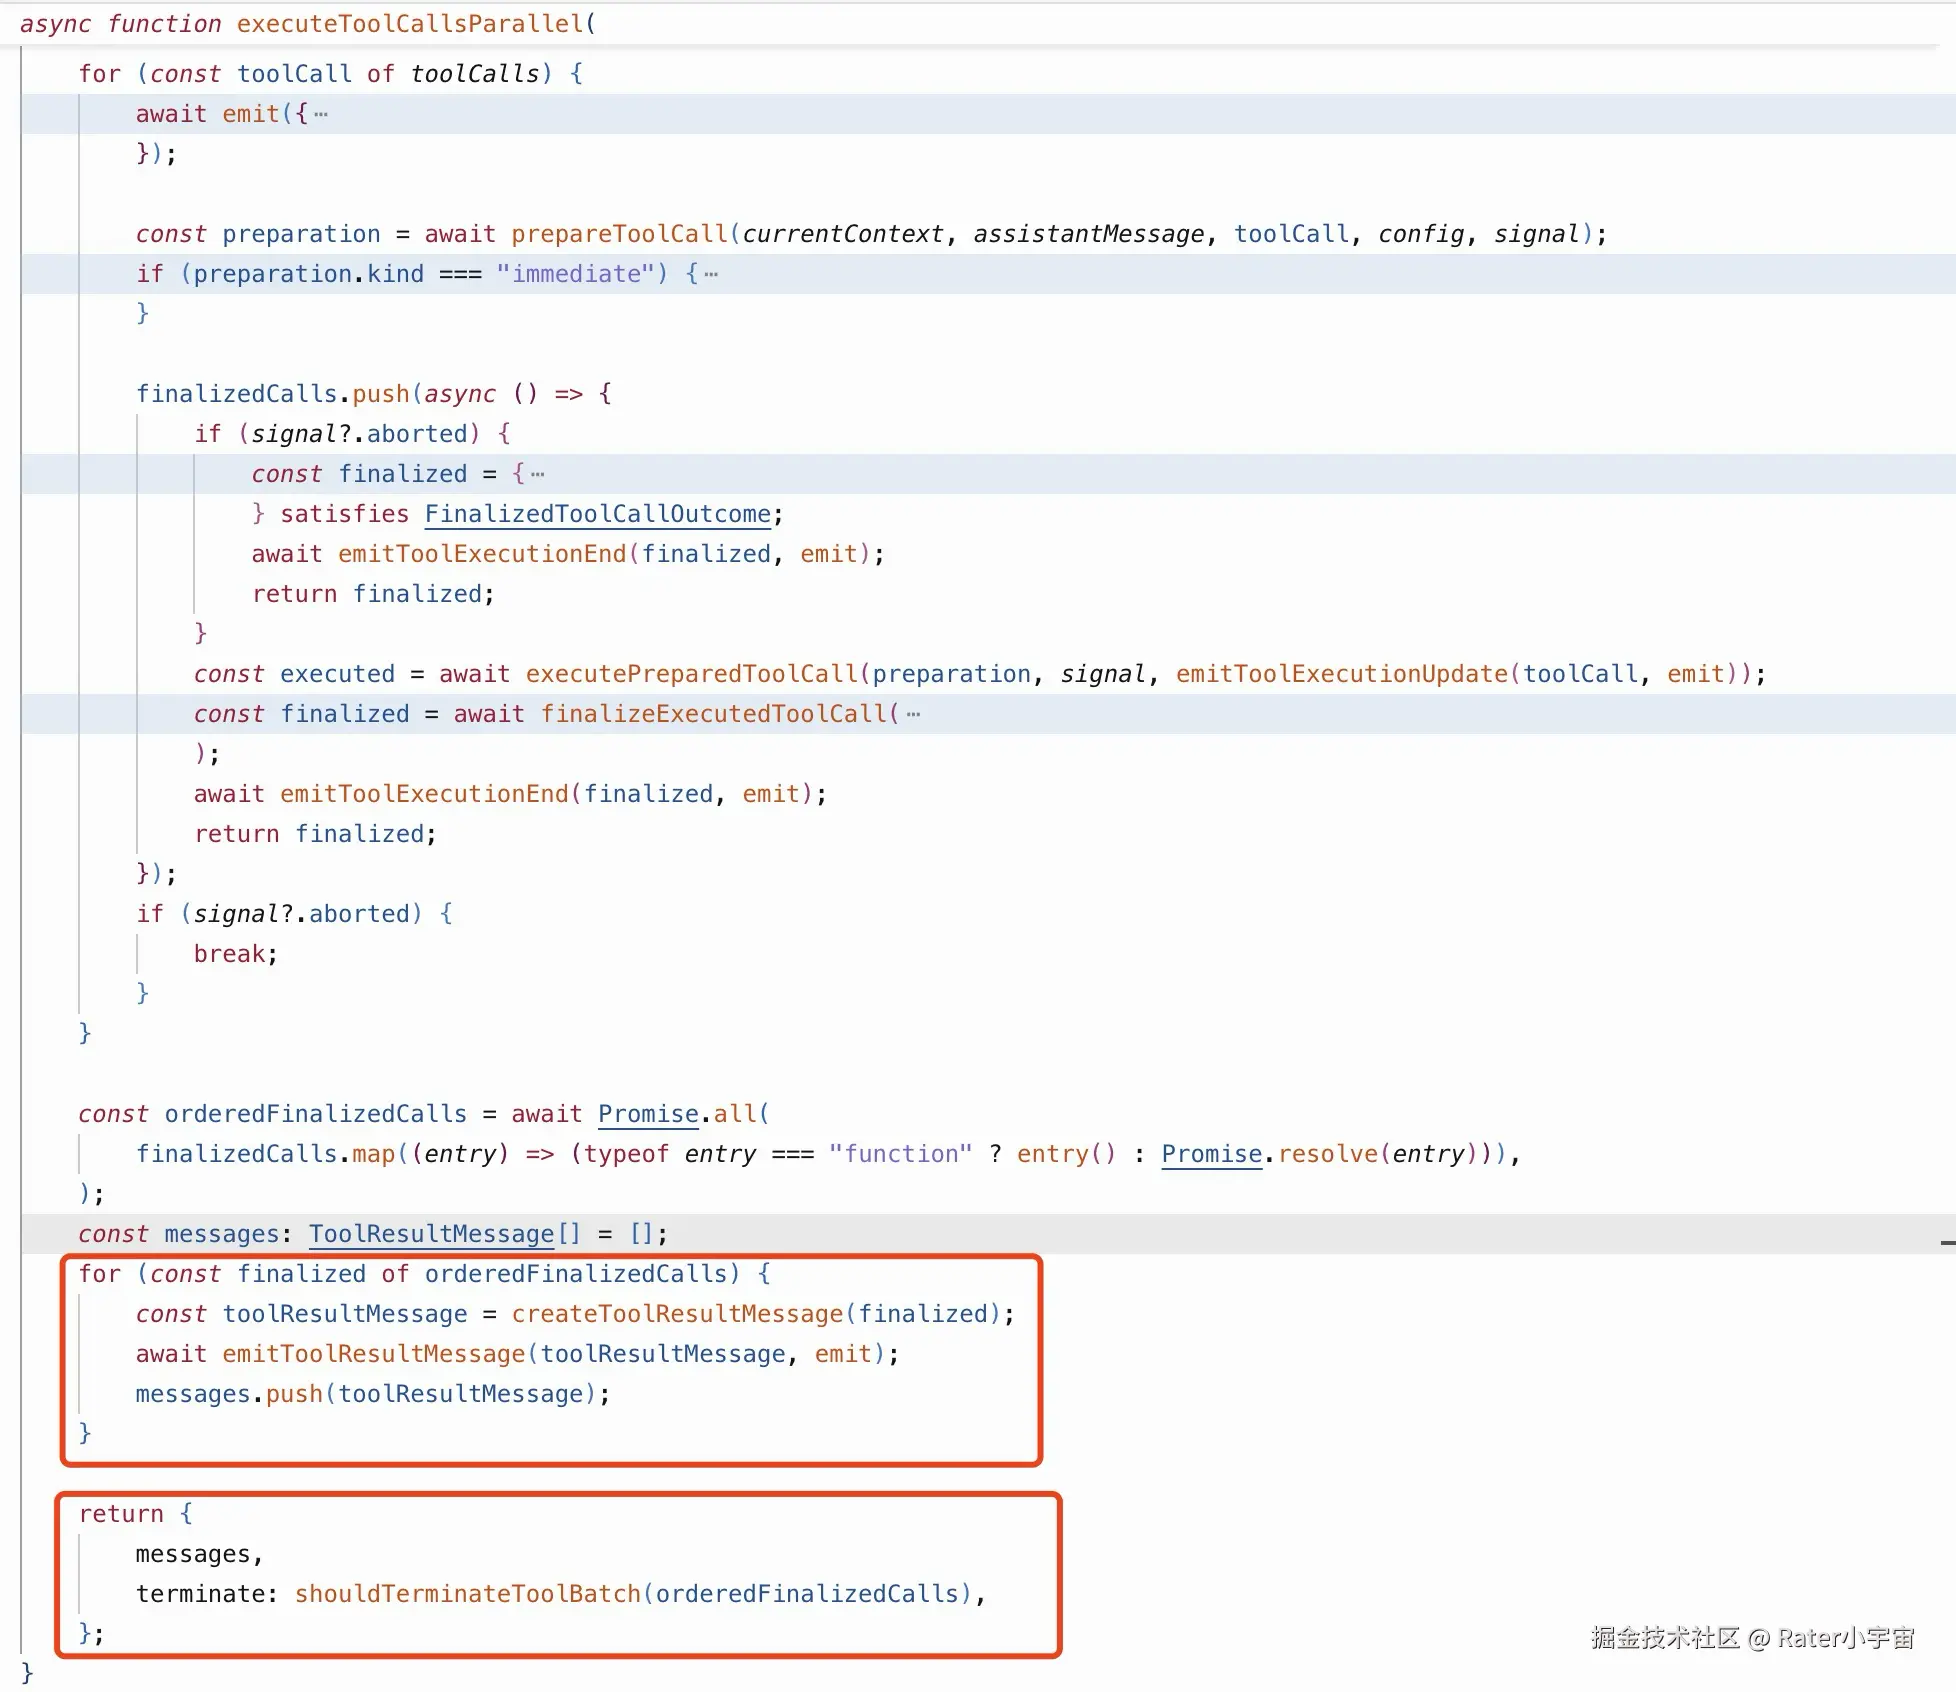
执行后如何返回给模型
首先通过createToolResultMessage()方法将执行后的结果包装成一个Message,然后返回
然后再在runLoop里面,把工具执行结果,装到全局的Message列表里面去,作为下一次模型的输入
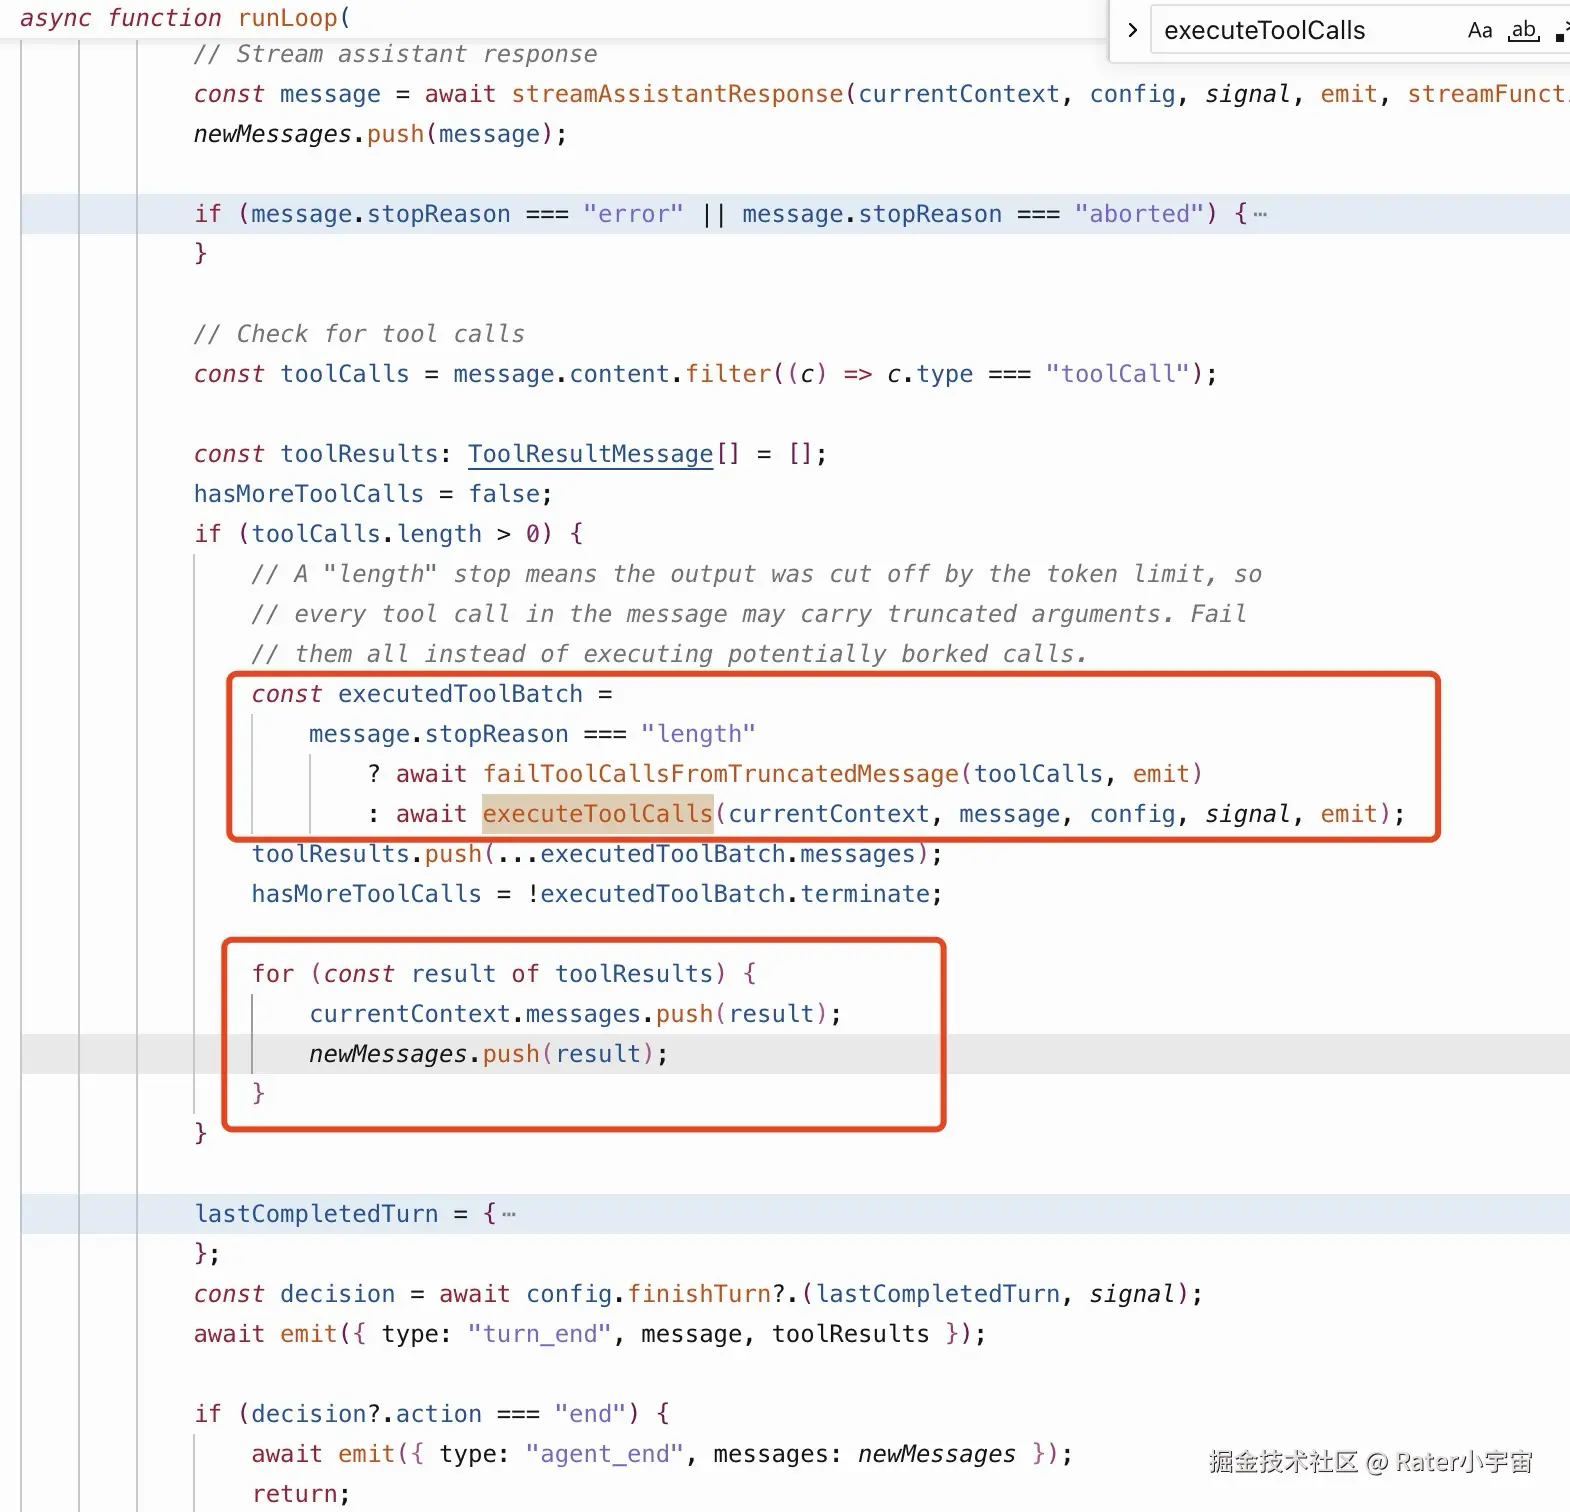
到这里,我们就可以把整个流程串联起来了:
scss
LLM 返回 Tool Call
        ↓
executeToolCalls()
        ↓
选择串行 / 并行执行
        ↓
prepareToolCall()
        ↓
查找工具、适配参数、校验 Schema
        ↓
执行前置 Hook
        ↓
executePreparedToolCall()
        ↓
tool.execute()
        ↓
finalizeExecutedToolCall()
        ↓
执行后置 Hook
        ↓
createToolResultMessage()
        ↓
ToolResultMessage 加入 Context
        ↓
进入下一轮 Agent Loop
        ↓
LLM 根据工具结果继续决策
异常处理
最后,再简单聊聊异常处理。
Pi在这里的核心设计是:
工具异常尽量不抛出 Agent Loop,而是转成 isError: true 的 ToolResultMessage 返回模型,让模型自行修正或重试。
为什么要这么设计?
因为对 Agent 来说,一次工具执行失败,并不意味着整个任务必须失败。
这其实就是让模型参与错误恢复,而不是让工具错误直接决定整个任务的终点。
设计思想总结
到这里,Pi 的整个工具调用流程就介绍完了。
其实,单独看每一个函数,代码并没有想象中复杂。
真正值得学习的,是这些函数背后的工程设计思想。
我总结了三个比较重要的点。
一切皆Message
在 Agent 的模型交互层,无论是用户输入、模型回复,还是工具执行结果,最终都可以通过 Message 的形式组织起来。
整个 Agent Loop,就是在不断生成、处理和传递 Message。
这是我研究 Agent Loop 和工具调用之后,一个非常深刻的感受。
Hook 机制与工具本身同样重要
研究 Pi 的工具调用源码时,我发现一个很有意思的现象。
真正执行工具的核心代码,其实就是一次 tool.execute()。
反而是执行前后的准备、校验、拦截和结果处理,占据了相当一部分代码。
为什么?
因为在真实的工程环境中,
能把工具执行起来,只是最基本的要求;如何让工具稳定、安全、可控地执行,才是更重要的问题。
模型负责决策,Harness 负责执行
最后一个观点,也是我认为理解 Agent 架构最重要的一点。
回到文章开头提到的公式:
Agent = LLM + Harness
LLM 和 Harness 的职责,其实有着非常明确的分工。
LLM 负责理解用户意图、分析当前上下文,以及决定下一步应该做什么。
Harness 则负责把模型生成的决策转化为实际操作。
比如,模型决定调用某个工具,但这个工具是否存在、参数是否合法、是否允许执行、执行失败如何处理,都需要由 Harness 负责。
这种设计,本质上是将模型的决策能力与工程系统的执行能力分离。
LLM 提供智能决策,Harness 提供可靠执行。
二者通过 Message 和 Tool Call 进行交互,共同构成一个可以持续运行的 Agent 系统。
这也让我越来越觉得,Agent 开发并不是简单地调用一下大模型 API。
真正有价值的工程工作,还包括工具系统、上下文管理、执行控制、异常恢复,以及整个 Agent Loop 的设计。
这些能力,恰恰是 Harness 的核心价值所在。
写在最后
到这里,我们已经从 Function Calling 的基本概念出发,完整分析了 Pi 的工具调用流程。
如果说,只需要记住一件事,
那这件事一定是:
大模型负责决定做什么,Harness 负责确保这些事情以可控的方式执行。
这也是我最近研究 Pi 源码最大的收获之一。