前六篇把面试官武装到了牙齿:会按考纲出题、会顺着你往深里挖、答错了当场点破、前后矛盾一秒回戳。我拿这套完整跑完一场,问得行云流水。可面试一结束,候选人问我:"我到底答得怎么样?"
我愣住了。这一场下来,系统记了一堆问答记录,但没有任何一处把"答得好不好"这件事变成可以带走的东西。候选人只知道"被问了一堆题",不知道自己哪题行、哪题崩、下一步该练什么。练面试没有复盘,等于白练------你连自己差在哪都不知道,怎么补?
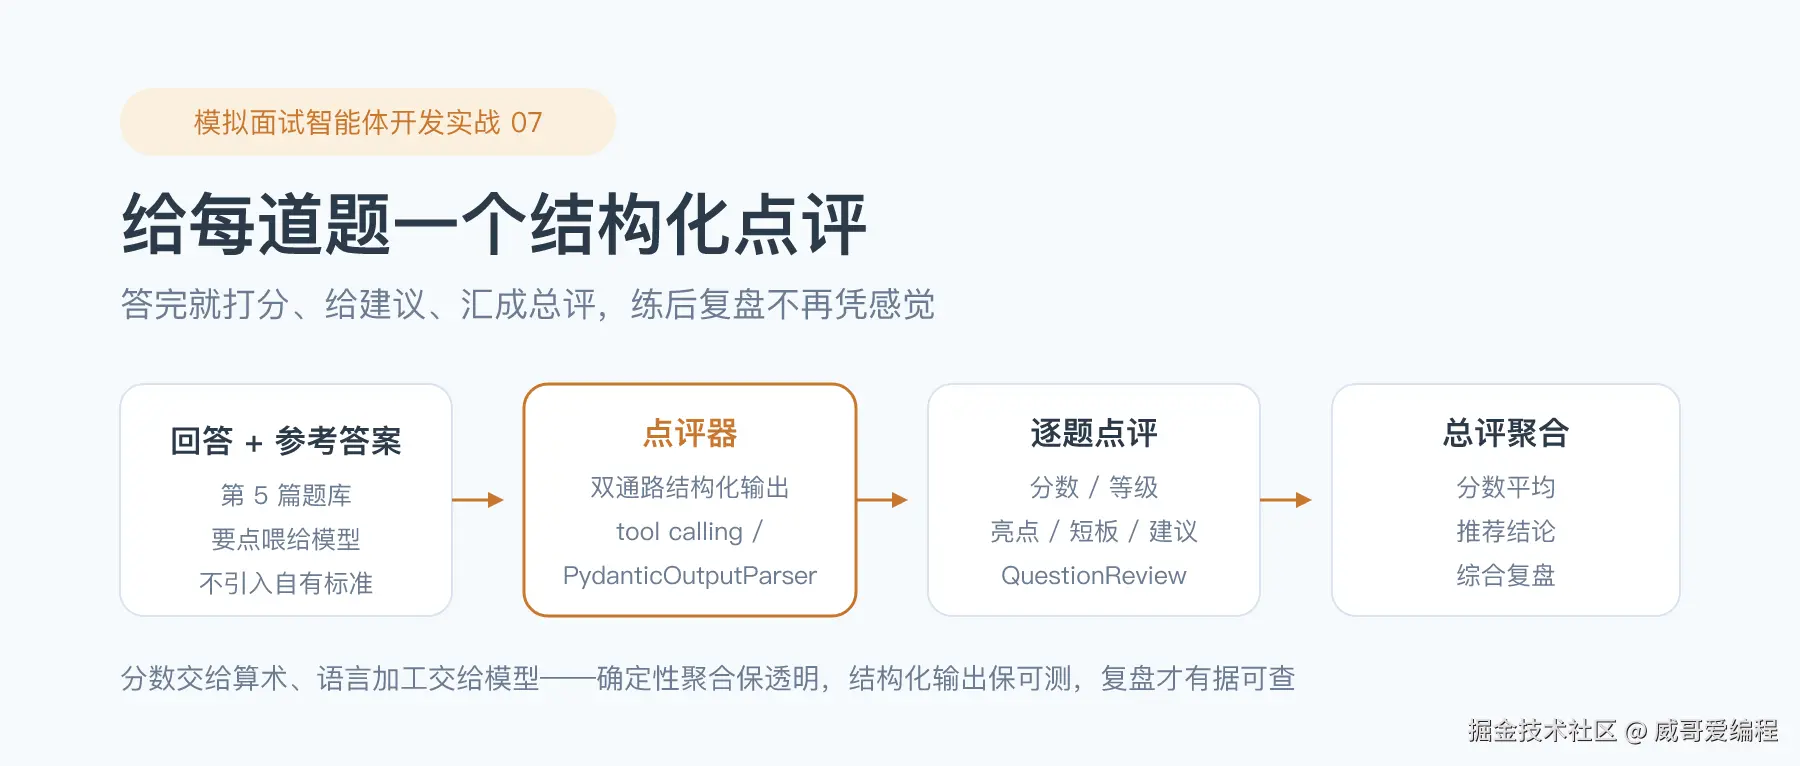
这一篇就补上"复盘"这一环:答完一题,立刻给一份结构化点评 (分数、等级、亮点、短板、建议);整场结束,把所有点评聚合成一份总评(总分、推荐结论、综合亮点短板、总结)。关键在"结构化"三个字------点评不是一段写给你看的话,而是一份程序能读、能聚合、能落库的数据。
一、先扫盲:为什么点评不能是一段散文
1. 点评要能聚合,就必须结构化
"你这道题答得不错,但深度不够"------这种散文式点评,人读着舒服,程序一无用处。下一题的点评、整场的总评,都没法从散文里提取分数。所以我把点评定成 QuestionReview:score(0-100)、level(优秀/良好/合格/待提升)、strengths、weaknesses、advice。五个字段,全是程序可读的,这才有了后面"自动聚合总评"的可能。
2. 结构化输出有两条路,都得会
LangChain 里把 pydantic 模型变成模型输出,主流有两招:with_structured_output(把模型当工具调用,干净)和 PydanticOutputParser(把格式说明塞进提示词,模型吐 JSON 再解析,最可移植)。这一篇两招都实现、都测------不是炫技,是让你知道换底座时该走哪条(有些便宜模型不支持 tool calling,第二条路就是退路)。
3. 分数交给算术,语言加工交给模型
总评里的"总分""推荐结论"是算术(取平均、查阈值),确定性聚合最稳最便宜;但"整体水平怎么一句话总结、下一步练什么",模型比模板更会说人话。所以聚合分两套:确定性聚合兜底分数,模型只补 summary 和综合列表------又是一次"便宜确定的交给算术,语言加工交给模型"的分工。
4. 点评能沉淀,复盘才能延续
散文式点评最致命的不是"读着累",而是"留不下"。一旦点评是 QuestionReview 这样的 JSON 结构,它就能直接落库:每场面试、每道题、每个候选人的评分都变成一条可检索的记录。你想看"这个人两周前 Redis 那题 55 分、现在 82 分"的成长曲线,从结构化数据里查就行;你想统计"所有候选人在 AOF 这一题普遍丢分",聚合一下全样本就知道该开哪门课。到了第 9-11 篇,鸿蒙端要展示的"分数环 + 亮点短板列表 + 总评",本质就是把这些 JSON 直接喂给 UI------没有结构化,客户端根本没东西可画。所以"点评是数据不是散文",这句话到联调那一刻才真正显出价值。
二、工程结构:模型、点评器、聚合器三层分离
bash
07-逐题点评/
├── src/
│   ├── settings.py    # 配置集中读取(硅基流动 + DeepSeek-V3)
│   ├── llm.py         # 模型工厂:真 Key / 离线脚本模型 / 没 Key 报错
│   ├── rubric.py      # 点评与总评的 pydantic 模型 + 系统提示词 + 阈值
│   ├── reviewer.py    # 逐题点评双通路:with_structured_output + PydanticOutputParser
│   └── aggregator.py  # 总评聚合:确定性聚合 + LLM 综合双通路
├── tests/             # 16 个用例,全程离线
└── demo.py核心思想一句话:点评是数据不是散文,结构化输出让它可聚合、可落库;分数走算术保透明,语言加工走模型保人话。
三、点评模型:把"答得怎么样"钉成五个字段
rubric.py 里只有两个 pydantic 模型和一组阈值,但它们是整篇的契约:
python
class QuestionReview(BaseModel):
    score: int = Field(ge=0, le=100, description="本题得分,0-100 整数")
    level: str = Field(description="评价等级:优秀/良好/合格/待提升")
    strengths: list[str] = Field(default_factory=list, description="亮点,2-3 条")
    weaknesses: list[str] = Field(default_factory=list, description="短板,2-3 条")
    advice: str = Field(description="针对本题的改进建议,一句话,要可执行")
score 用 ge=0, le=100 直接卡死范围------模型吐个 150 分或负数,pydantic 当场拒,不会带着脏数据进总评。等级和推荐结论来自阈值函数:
python
def level_of(score):
    if score >= 85: return "优秀"
    if score >= 70: return "良好"
    if score >= 55: return "合格"
return "待提升"这套阈值是"产品规则",写死在代码里,不是模型临场发挥。测试会逐档断言:level_of(100) 是优秀、level_of(84) 是良好、level_of(54) 是待提升------等级口径稳,总评才稳。
系统提示词里也焊死了口径:"评分依据只有一份:下面给出的【参考答案要点】。不引入你自己的标准,不扩展新要点。" 和第 6 篇判定同一思路:模型只做归类与提炼,不做价值判断。
四、双通路:同一份点评,两条产出管线
reviewer.py 把两条结构化输出路子都实现了。先看代码骨架:
python
def review_answer_structured(question, answer, reference_answer, llm, judgement=None):
    """通路一:with_structured_output(tool calling 管线)"""
    structured = llm.with_structured_output(QuestionReview)
    return structured.invoke([("system", REVIEW_SYSTEM_PROMPT), ("human", prompt)])

def review_answer_parser(question, answer, reference_answer, llm, judgement=None):
    """通路二:PydanticOutputParser(提示词 + 纯文本 JSON 解析)"""
    parser = PydanticOutputParser(pydantic_object=QuestionReview)
    prompt = body + "\n\n" + parser.get_format_instructions()
    raw = llm.invoke([SystemMessage(...), HumanMessage(prompt)]).content
    return parser.parse(raw)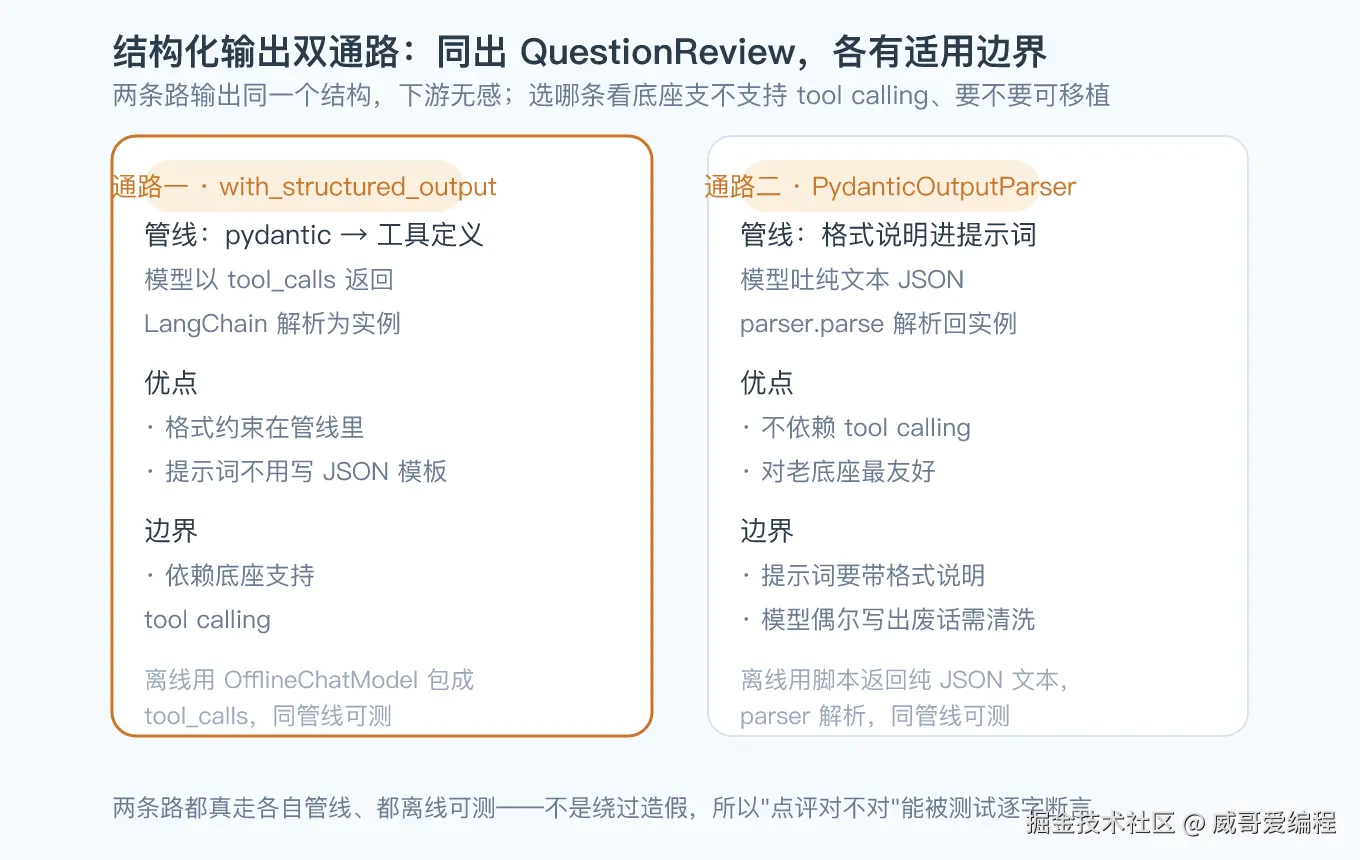
两条路的区别我在图里画清楚了:
- 通路一
with_structured_output:把QuestionReview转成工具定义发给模型,模型以tool_calls形式返回,LangChain 解析成实例。格式约束在管线里,提示词不用写 JSON 模板,最干净。代价是依赖底座支持 tool calling。 - 通路二
PydanticOutputParser:把格式说明(get_format_instructions())塞进提示词,模型吐纯文本 JSON,再用parser.parse()解析回来。不依赖 tool calling,对老底座、便宜模型最友好。代价是提示词要带格式模板,且模型偶尔写出废话需要清洗。
统一入口 review_answer(..., mode="structured"|"parser") 让调用方一行切换。离线测试时,OfflineChatModel 的脚本条目是 pydantic 实例就走 tool_calls(对应通路一),是 str 就当纯文本(对应通路二)------两条路在离线测试里都真走各自管线,不是绕过造假。测试还逐字断言"参考答案要点真的进了发给模型的提示词",确保点评是"对着答案判",不是模型凭自己脑子里的版本判。
接住上一轮的判定:judgement 参数
细心的你会注意到两个函数都有一个 judgement=None 参数。它就是为了和第 6 篇的判定引擎串起来用的。第 6 篇的 grade_answer 会先给回答下一个 Verdict(含 quality、missing_points、reason),这一步已经判断过"答得对不对、漏了哪些点";等第 7 篇点评时,把那个 Verdict 传进 judgement,_build_review_prompt 会把它拼成"【上一轮判定】质量=correct,理由:......"塞进提示词。
这样做有两个好处:一是避免前后矛盾 ------判定说"漏了 fsync 三档",点评就不可能反过来说"讲得很完整";二是省 token 且口径统一------判定已经把漏点列清楚了,点评直接承接,不用模型再判一遍。在真实面试流水线(第 4 篇状态机编排)里,顺序是"出题 → 第 6 篇判定 → 第 7 篇点评",判定结果天然就是点评的输入,这一段是整套系统"问、追、评"闭环的关键咬合点。
真实项目里两条通路怎么选
- 默认走通路一
with_structured_output:只要你的底座支持 tool calling(硅基流动上的 DeepSeek-V3 支持),就用它。提示词干净、格式约束在管线里、几乎不出现"模型写出废话 JSON"的情况,是最省心的选择。 - 通路二
PydanticOutputParser当退路 :当你要接一个便宜的、不支持 tool calling 的底座,或者你在做离线批处理、想最大限度控制提示词长度时,就用它。代价是提示词里要带格式模板,且偶尔要清洗模型吐出的多余文字------所以parser.parse()之外,生产环境最好再套一层"解析失败就回退到确定性兜底"的保险。 - 两者对外是同一份
QuestionReview:下游聚合、落库、鸿蒙端展示完全不感知你走的是哪条路。这个"双实现、单输出"的套路,前几篇已经反复出现------它是应对"底座可能换"的廉价保险,值得养成习惯。
五、总评聚合:分数给算术,总结给模型
aggregator.py 解决"多题点评怎么变成一份总评"。两套聚合,分工明确:
python
def aggregate_reviews(reviews):
    """确定性聚合:不调模型。分数取平均、等级/推荐查阈值、亮点短板去重。"""
    scores = [r.score for r in reviews]
    overall = round(sum(scores) / len(scores))
    strengths = _dedupe_keep_order([s for r in reviews for s in r.strengths], 5)
    weaknesses = _dedupe_keep_order([w for r in reviews for w in r.weaknesses], 5)
    summary = f"共点评 {len(reviews)} 题,总分 {overall}({level_of(overall)})......"
    return Evaluation(overall_score=overall, level=level_of(overall),
                      recommendation=recommendation_of(overall),
                      strengths=strengths, weaknesses=weaknesses, summary=summary)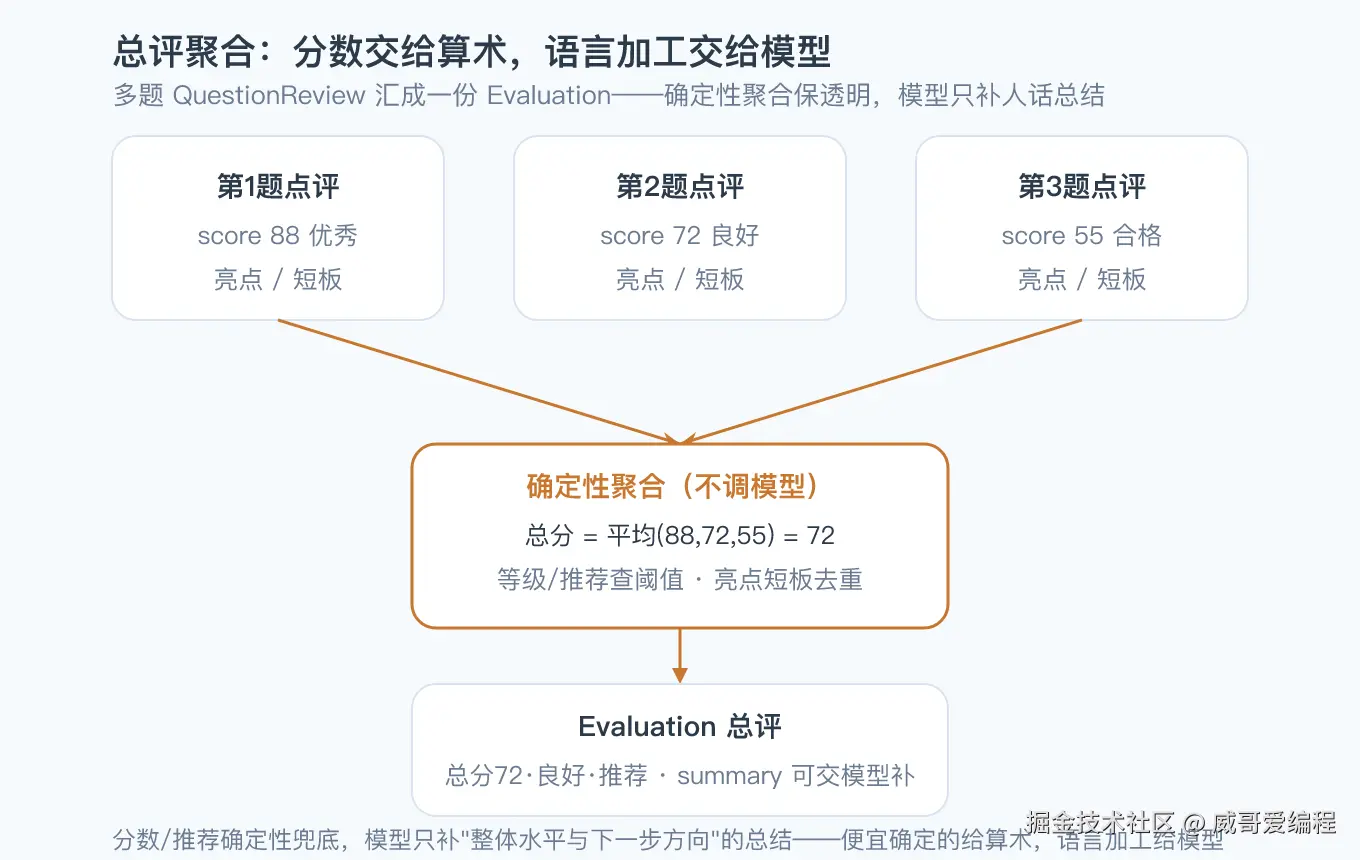
build_evaluation_via_llm 是另一套:把全部点评序列化后交给模型,用 with_structured_output(Evaluation) 产总评,但分数和推荐仍用 aggregate_reviews 兜底 ------模型只补 summary 和综合后的亮点/短板列表。为什么这么别扭?因为"总分 72"这种数字是客观的,不该让模型"发挥";但"整体良好,建议补生产深度"这种话,模型比模板说得自然。便宜确定的给算术,语言加工给模型,又是同一句工程格言。
真实模型怎么接:从离线脚本到硅基流动
离线测试用脚本模型,真要跑起来,只需把模型换成硅基流动的 DeepSeek-V3。本篇的 llm.py 用 build_llm 三通路统一封装,配置全部集中在 settings.py,密钥只在 .env 里出现。.env.example 长这样:
bash
# .env.example ------ 占位符,绝不填真 Key
LLM_API_KEY=sk-你的密钥
LLM_BASE_URL=https://api.siliconflow.cn/v1
LLM_MODEL=deepseek-ai/DeepSeek-V3
build_llm 读这三个变量,用 LangChain 的 ChatOpenAI 指向硅基流动的 OpenAI 兼容入口(注意 URL 末尾带 /v1)。拿到真模型后,调用方式一行没变:
python
from llm import build_llm
from reviewer import review_answer

llm = build_llm()  # 没配 Key 会直接抛可操作的错误,不会静默跑偏
review = review_answer(question, answer, reference_answer, llm, mode="structured")
print(review.score, review.level, review.advice)
密钥一律走环境变量、不进代码仓库;正文里永远只出现 sk-**** 或 sk-你的密钥 这种脱敏占位,真 Key 你自己填进 .env(已被 .gitignore 排除)。这样同一份代码,离线能测、上线能用,互不干扰。
六、跑起来看真实效果
python demo.py 全程离线(脚本模型预置回复,不需要 Key),四个场景正好对应双通路与聚合:
css
① 逐题点评 · 通路一 with_structured_output(tool calling 管线)
  得分 82(良好)
  亮点:覆盖 RDB/AOF 两种;讲清了文件大小与恢复速度的取舍
  短板:没提 fsync 三档;重写时机含糊
  建议:把 AOF 的 fsync 三档区别讲清楚

② 逐题点评 · 通路二 PydanticOutputParser(纯文本 JSON 解析)
  得分 82(良好)
  亮点:覆盖 RDB/AOF 两种;讲清取舍
  短板:没提 fsync;重写时机含糊

③ 总评聚合 · 确定性聚合(不调模型,分数全透明)
  总分 72(良好)  推荐:推荐
  综合亮点:基础扎实;讲清取舍;概念清楚;答了要点
  综合短板:生产经验少;深度不够;漏了边界;有错;表述乱
  总结:共点评 3 题,总分 72(良好)。推荐结论:推荐。

④ 总评聚合 · 通路 LLM 综合(分数/推荐确定性兜底,summary 由模型补)
  总分 72(良好)  推荐:推荐
  模型总结:整体良好,建议进一步补生产深度。
注意第 ① 和第 ② 两路产出的是同一个结构的 QuestionReview------换通路不改下游;第 ③ 的总分 72 是 (88+72+55)/3 的精确平均,透明度拉满;第 ④ 同样总分 72,但多了一句模型补的"建议进一步补生产深度",这正是两套聚合分工落地的样子。
上面是离线演示,用的是脚本模型、零成本、可重复。真接到硅基流动的 DeepSeek-V3 后,输出内容会由模型现场生成(分数、亮点、短板、建议都是真判断),但数据结构和聚合逻辑完全一致------你在本机用脚本模型验证过的"平均算法、去重、空列表报错、分数卡 0-100",在生产环境一个字都不用改。这也是我坚持把所有工程做成"离线可测"的原因:上线前就能把逻辑漏洞堵死,真模型只负责把内容写得更像人话。
七、测试覆盖:16 个用例把"点评对不对"钉死
bash
tests/test_rubric.py      等级阈值、推荐阈值、模型边界(分数 0-100 卡死)
tests/test_reviewer.py    双通路都出 QuestionReview、参考答案真进提示词、调度正确
tests/test_aggregator.py  平均分数、去重截断、空列表报错、LLM 兜底
tests/test_demo.py        四个演示场景端到端跑通
─────────────────────────
16 passed in 26.31s
覆盖到什么程度:等级/推荐四档各自的边界、分数越界被 pydantic 拒、双通路都返回 QuestionReview 且结构一致、with_structured_output 真走 tool_calls 管线、参考答案要点真的进了提示词、聚合平均与去重正确、空列表抛错、LLM 总评的分数/推荐严格用确定性结果兜底。全部离线,不需要 Key、不联网。
八、踩坑清单
- 点评写成散文,下游没法聚合:最早的版本让模型"写一段点评",结果总评只能再调一次模型去总结,又慢又贵还不稳定。改成五个结构化字段后,聚合变成纯函数,零成本。
- 等级口径随模型漂移:模型有时给"不错"有时给"A-",总评没法对应。把等级写成阈值函数,模型只给数字,等级由代码算------口径唯一。
- 分数越界没卡 :模型吐过 105 分,聚合直接被带偏。pydantic 的
ge=0, le=100卡死,脏数据进不来。 with_structured_output喂不进离线假模型 :同第 6 篇,FakeListChatModel只吐纯文本。复用OfflineChatModel,脚本条目是 pydantic 实例就包成 tool_calls,双通路都能离线测。- 总评让模型定分数:模型把 72 说成 75,复盘数字不可信。改成确定性聚合算分、模型只补文字,分数永远可复核。
- 聚合前不查空列表 :最早
aggregate_reviews没拦空输入,传个空列表进来,sum([])/len([])直接ZeroDivisionError。现在空列表显式抛ValueError("没有可聚合的逐题点评......"),调用方在入口就能拦住------这条测试看着琐碎,却是"整场一题都没点评就出总评"这种边界的真实防线。 - 亮点短板不去重就糊一屏 :多题点评里"基础扎实""概念清楚"反复出现,直接拼进总评会显得很水。加
_dedupe_keep_order保序去重并截断到 5 条,总评既精炼又不丢重点,还顺带定了上限------防止模型哪天写 20 条把 UI 撑爆。 - 判定和点评各判各的,口径打架 :没接
judgement时,判定说"漏了 fsync",点评却夸"讲得很完整",候选人看懵。把第 6 篇的Verdict透传给点评,前后口径强制对齐,闭环才闭得上。
九、本篇收尾
现在这场面试终于"有交代"了:你答完一题,立刻拿到一份带分数的点评,知道这题好在哪、差在哪、下一步练什么;整场结束,有一份总分和推荐结论的总评,能直接发给候选人复盘,也能留档跟踪进步。面试不再是一阵聊完就散的对话,而是一份可带走的成长记录。
更重要的是,这些点评本身就是干净的 JSON------QuestionReview 和 Evaluation 都能 model_dump() 直接序列化成字典。这意味着三件事:第一,服务端可以把每场面试存成一条结构化记录,候选人下次来练,直接拉历史对比;第二,前端不用做任何"解析 AI 散文"的脏活,分数环、亮点短板列表、总评结论都是现成字段直接绑定;第三,到了第 9-11 篇的鸿蒙端,聊天界面答完一题就弹出点评卡片、报告页把总分画成一个环,用的就是这一份数据。后端把"复盘"做成数据,鸿蒙端只管把它画好看------职责清晰,联调时几乎不用改字段。
下一篇我们给它加最后一道闸:第 8 篇写总评报告与护栏------怎么把总评写成一份能发人的报告,以及怎么防止模型在点评里泄题、夸大、或给错建议(安全与一致性护栏)。
最后一句:面试的价值不在"问了什么、答了什么",而在"答完之后,候选人带走了什么"------结构化点评把每一题的回答,变成了他下次能直接用上的复盘。