原文:mp.weixin.qq.com/s/F7j4xss6a...(2026年10月12日)
 先看一个很常见的困惑。
你让模型用法语写一段营销文案,它张口就来,但语法全错;你让它读懂公司的内部协议,它一本正经地胡说;你给它一份超长合同,它读了后面忘了前面。你把提示词改了又改、又给它挂了个资料库,效果还是不行。
于是你想:是不是该"强化学习微调"一下?
但答案往往是:别急。 这些问题有一个共同的根源------这些东西,模型的基础能力里压根没学过。 而 RL 最不擅长的,恰恰就是"凭空学会它从没学过的东西"。
这就好比让一个从没学过法语的人去参加法语谈判------你给他再好的临场技巧培训,他也张不开嘴,因为词汇和语法根本没进过他的脑子。
Mid-training:给模型"补专业课"
Mid-training(中期训练) ,也有人叫继续预训练(CPT) 、领域自适应预训练(DAPT) ,意思都是:从一个已有基础的模型出发,拿目标领域的资料继续"上课"。
它和预训练用的是同一个任务------预测下一个词 (还记得吗,就是那个"猜下一个文字积木"的游戏)。唯一的区别是:这次喂给它的"教材"换成了特定领域,比如某种语言、某类文档、某个行业的资料;同时还会掺一部分通用资料,防止它"学偏了、忘了本"。
它回答的不是"话该怎么说",也不是"哪条路得分高",而是一个更基础的问题:这个模型,到底有没有完成任务所需要的那点知识和基本功?
这也就解释了为什么 SFT 补不了这类知识 。SFT 是"照着问答样例学怎么答",能用很少的样例见效,但它只覆盖有限的几种问法 ------模型很容易"把题目和答案的对应关系背下来",而不是真的懂了。想在脑子里装下大量、彼此关联的专业知识,得靠 Mid-training.
怎么判断"该补课"了?
有一个非常好用的判据:看它"多做几次,能不能至少对一次"。
专业上这叫 pass@k :让模型对同一道题独立做 k 次,至少成功一次的几率。背后的道理很直白------如果单次成功率是 p,那么做 k 次至少对一次的概率是:
(不用怕这个公式,它想说的就是"多试几次,总成功的机会会变大"。)
•
如果单次很难对,但多做几次就能对 → 说明正确答案其实"藏在它脑子里",只是概率太低。这种情况,用 RL 去"多推几把"就有用。
•
如果做很多次,一次都对不了 → 说明正确答案根本不在它脑子里。这时候再怎么给 0/1 的分数,它也学不会------因为没有任何一次"对"的样本可供它学习。
记住这句话,它是本文的核心:RL 擅长把"已经偶尔能对"的做法,变得"经常对";但它不擅长从零变出模型从没学过的知识和能力。
所以,缺的是某种语言、某个领域的事实、某种代码套路,或者长文档的理解力,就该先做 Mid-training。
怎么给模型"编教材"?五个步骤
Mid-training 成不成,几乎全看数据(也就是"教材"编得好不好)。一套靠谱的做法大致是五步:
 第一,从"错题"反推该补什么。 先看看模型输在哪一类题(哪种语言、哪类文档、多长上下文),再针对性地补。别把"格式没写对"错怪成"知识不够"。
第二,把教材编得信息量足。 原始文档适合建立术语和事实的联系;代码仓库适合学结构和依赖;教材式的推导、改写和跨文档关联的样例,能把隐含的关系讲得更明白。
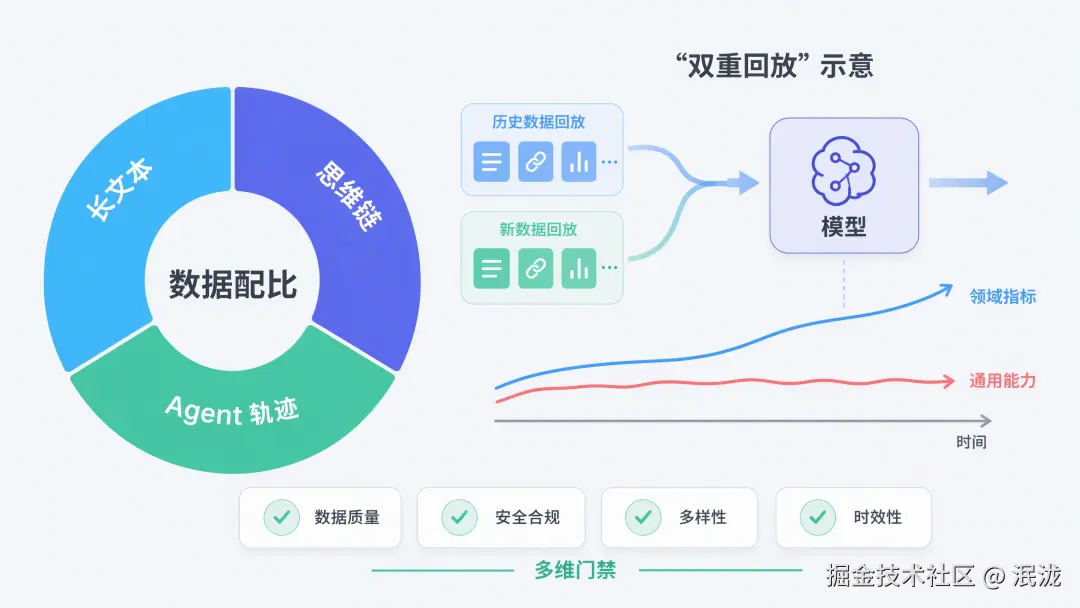
第三,按"科目"配好比例。 既要有书、长文档、代码这类天然的长文本;也要有"怎么一步步推理"的思维链数据;还要有"怎么规划、怎么调用工具、怎么跟踪长任务"的执行轨迹。后两类可以拿强的开源模型来"生成示范"。
第四,每学一段就"复习旧功课"。 一类是原始短文本和通用数据,防止旧能力退化;另一类是把"模型早就会做的老任务"放到更长的上下文里再考一遍,看它是不是还做得对。这第二类,叫双重回放。
第五,用"体检报告"决定何时停。 不能只看它"练习题做得多好",还要同时盯三样:专业题有没有进步、通用能力有没有退化、老本事还在不在。如果专业分涨了、通用分却掉了,说明路子太偏、学得太猛;如果练习题分掉了、实际能力却没长,说明教材没配到点上。
补课的代价:它可能"忘了"别的
不过,补课是有副作用的,这个副作用叫灾难性遗忘 ------学了新科目,把旧科目忘了。
有个很直观的例子:一个主要用英语训练的模型(叫 Mistral 7B),拿韩语维基百科继续"补课",来注入韩语能力。为了减少遗忘,研究者用了大约 80% 韩语 加 20% 英语的配比。结果是:韩语能力上去了,英语能力却退步了。
这里的分工可以看得很清楚:Mid-training 负责先把韩语的知识和语感装进去,SFT 再教它"怎么用韩语听懂指令、组织回答"。 但继续预训练能把新能力写进模型,却没法免除"定期体检"------保留测试、事实核查、数据质量审计,一样都不能少。
而且,全参数地给大模型补课,又贵又容易遗忘,所以稳妥的做法是:先拿小模型、小数据试,验证配方没问题了,再上大的。
那什么时候该用资料库(RAG),而不是补课?
记住一条边界:如果这些事实经常更新、或者必须能给出原始出处,那就别塞进模型脑子里,用外挂资料库更好。
打个比方:Mid-training 像是把知识背进脑子 ,RAG 像是随身带一本可以随时翻查、随时更新的手册 。经常变的东西,当然放到手册里更划算。
Mid-training 更适合那些稳定、量大、需要变成"本能反应"的专业知识和技能。反过来说,稳定的领域知识,也许补一次课就够了,之后接着用原来的对话能力就行------不必每个项目都把流程走全套。
一句话总结
如果模型多做几次、连一次都对不了,别急着上 RL------它缺的不是技巧,是课。先把底座补上,再谈怎么让它"好好说话"。
而补课这件事,你八成的时间都会花在"编教材"上:补哪一类、长文本配多少、通用数据掺多少、什么时候停。 这些问题想清楚了,补课才不会变成一场又贵又健忘的冒险。
本篇名词速查
•
Mid-training / 继续预训练(CPT)/ 领域自适应预训练(DAPT):用某个专业领域的资料继续"预测下一个词",相当于给模型补专业课。
•
pass@k:同一道题做 k 次、至少对一次的几率,用来判断模型是"真不会"还是"只是不稳"。
•
灾难性遗忘:学了新东西,把旧本事忘了。
•
RAG(检索增强):给模型外挂一个可随时查的资料库,特别适合经常更新的事实。