ComfyUI 加载了动作 LoRA,H3-World 的时间绑定就接好了吗?
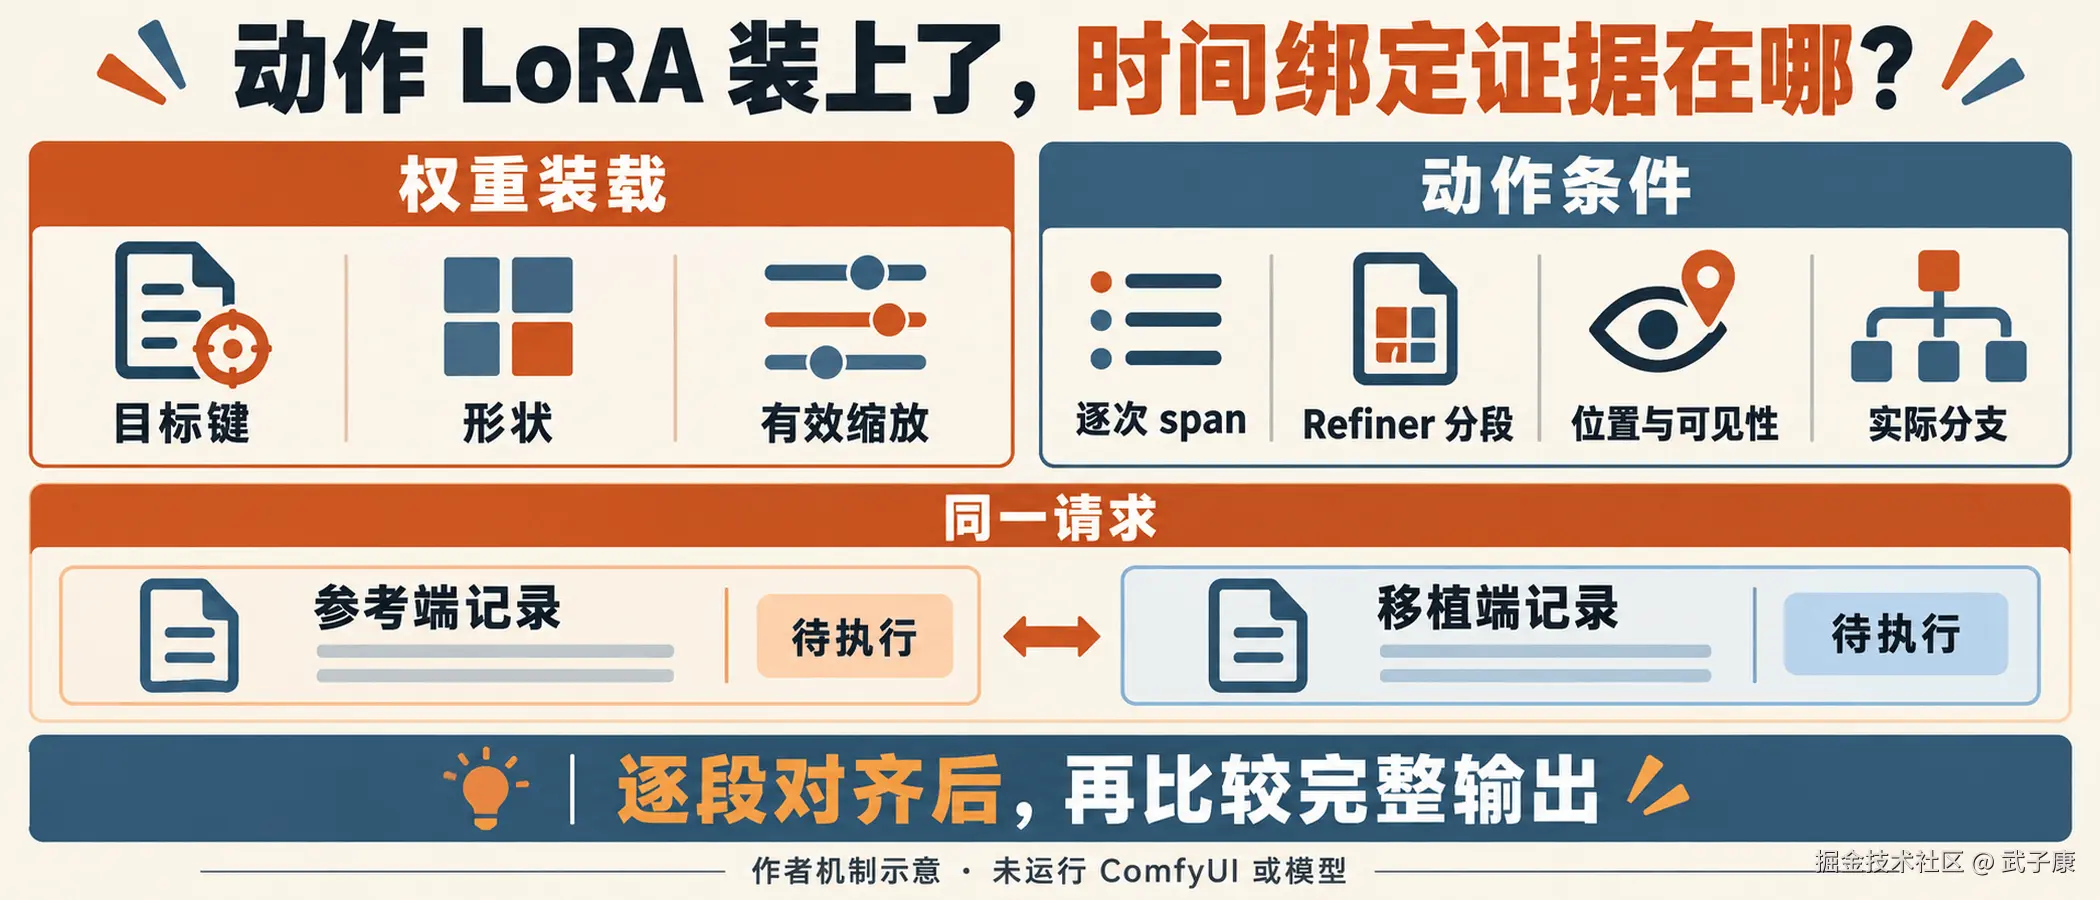
作者机制示意或待执行语义对齐安排;没有Comfy或GPU实测。
你把 H3 模型、首帧、提示词和 H3-World 动作 LoRA 连进 ComfyUI,点击运行,最后得到一段视频。装载日志没有明显异常,画面也像在执行动作。接下来应当确认什么,才能说这条图真正接上了 H3-World 的动作路径?
固定版 H3-World 的参考脚本给出了一个很直接的线索:它除了核对 LoRA 挂接数量,还要核对实际导入的模型中有没有定向注意力 mask,以及 pipeline 有没有逐 latent 动作文本的打包字段。也就是说,参考入口自己就把"权重挂上了"和"执行了相同动作机制"分成了两件可检查的事。
移植时最容易丢掉的,恰好发生在这两者之间。一句动作文本必须在进入主干前仍保有自己的身份,之后才能与相应的视频 latent 绑定。如果上游已经把不同时刻的动作揉进同一个表示,最后补一个看起来正确的注意力 mask,也无法重新分离那些已经混合的信息。
本文沿着这条因果链,回答一个问题:ComfyUI 已加载动作 LoRA 后,还要在哪里留下证据,才能检查它与 H3-World 参考动作路径是否一致? 最后给出一张待执行的语义对齐验收记录。这里的"对齐"指条件构造、位置和可见性规则等有明确比较对象,不预设不同后端的浮点结果或视频逐像素相同。
核对日期为 2026 年 10 月 17 日。H3-World 固定到 f0c7be2acbbde8256b2473f6e7b088f58272acae,基础 DiffSynth 固定到仓库指定的 300e3e4da76e881d5e6bd97d897810c18f6e4893;ComfyUI 通用装载调用链固定到 5cc4b870094c89090db54bd8d12649dcaf89f2ba。本次没有安装或运行 ComfyUI、下载权重、运行模型或读取真实中间张量。因此本文分析的是这些源码的职责和移植验收办法,不提供已完成的插件或接入效果。
通用装载入口究竟证明了哪一步
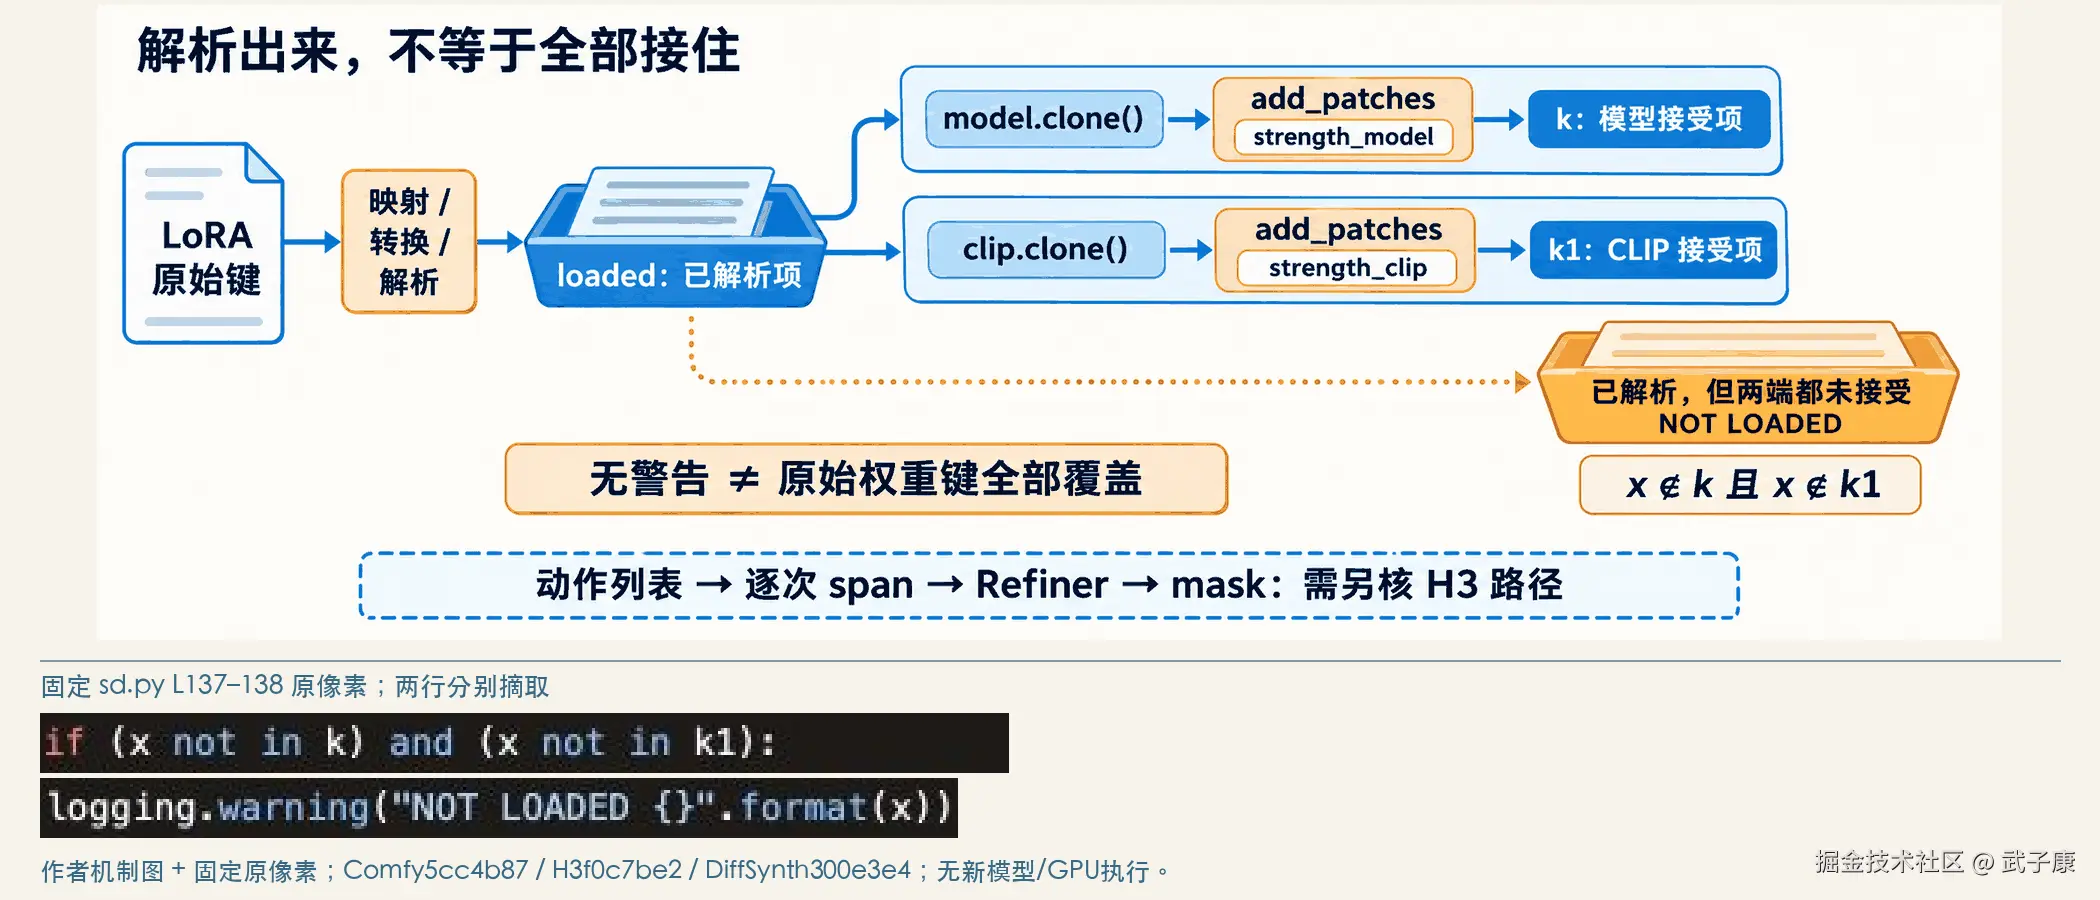
固定官方页面聚焦原像素;证明局部源码职责,不是Comfy或模型运行结果。
先把"普通 LoRA 节点"缩小到能检查的具体对象。在上述 ComfyUI 版本中,LoraLoader 的输入是模型、文本编码模型、权重文件和两项 strength,返回修改后的模型对象。它读取文件后调用 comfy.sd.load_lora_for_models()。后者建立键映射、转换载荷,再把识别出的补丁交给克隆模型的 add_patches()。固定版 LoraLoader与固定版装载函数
这条调用链适合回答载荷能否识别、目标键是否存在、哪些补丁被接受。在 load_lora_for_models() 中,已解析但没有被两个模型接受的条目会产生 NOT LOADED 警告。它提供了一个值得保留的诊断入口,却没有替所有原始 checkpoint 键给出完整覆盖证明;转换前后的集合仍应核对。不能仅凭日志没有出现这条警告,就宣称原始动作权重全部正确装上。
也不应把现代 ComfyUI 的所有补丁机制简化成一行矩阵加法。固定版 ModelPatcher.add_patches() 除了处理匹配 state dict 的补丁,还存在配置型补丁的分支。插件也可能扩展模型或条件结构。本文能从这段通用代码得出的结论,是这些接口本身没有接收 H3-World 的动作时间表,也没有在这条调用链中生成逐句 span、重建其 Refiner 分段或运行定向 mask;至于某个具体第三方节点是否另外实现了这些工作,需要检查那个节点,不能一概宣布整个生态都不支持。固定版 ModelPatcher
H3-World 参考入口的检查范围同样应说清楚。它只接收一份动作 checkpoint,筛选 .lora_A.、.lora_B.,拒绝其他张量;挂接前后比较 A 权重列表数量,要求增加的 LoRA 对数与载荷一致。同时,默认 v2 路径会检查导入位置、定向 mask 特征和逐 latent 打包特征。不把这些字符串检查夸大成完整的算法证明,它们至少表明:原作者不把"同一份权重文件"视为"同一条推理路径"的充分证据。参考推理入口
移植时先记录实际运行的模型类、文件路径、节点版本、基座与 LoRA 文件 SHA,以及预期和实际目标键、形状及有效缩放。对不匹配项保留原键名与处理方式。这里没有读取权重,不能替读者填一份"全部通过"的键表,也不采用原笔记中固定"52 层侧挂"的说法作为跨文件验收标准。验收数量必须来自具体载荷和目标映射。
同一句动作可以复用编码,每个时刻仍需要自己的 span
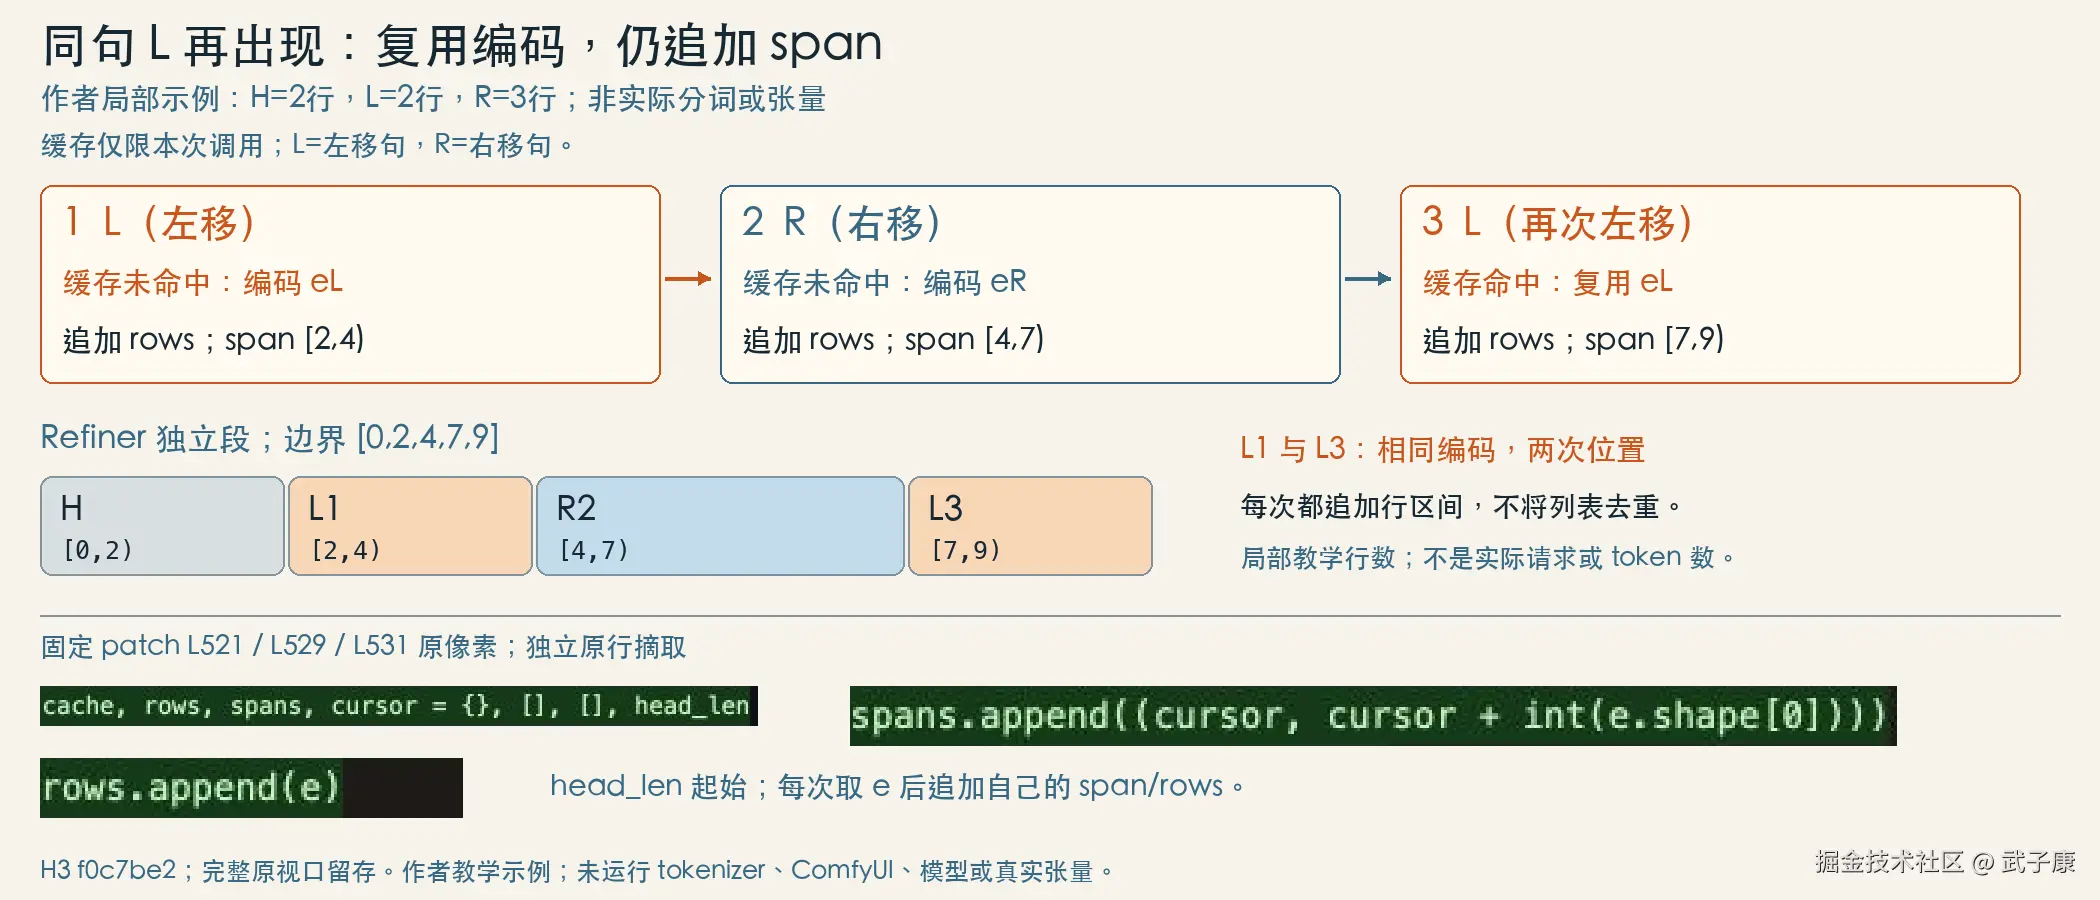
固定官方页面聚焦原像素;证明局部源码职责,不是Comfy或模型运行结果。
参考 CLI 的动作输入是全片恒定的按键 preset。脚本根据帧数计算 latent 数量,再把相同按键复制到各行,调用 annotate_from_keys9() 得到动作句列表。124 帧对应 37 个动作条目,是这组帧数与实现下的结果,不是任意时长永远填 37。latent_t_for() 的公式与 17k+5 帧数检查都在固定代码中;若另加时间表入口,应先证明自己的帧到 latent 映射与参考规则一致,而不是按界面秒数等分。动作尺度函数
这里先用一个小的移植场景说明风险:若一个待实现的时间表前段向左、后段向右,接入者可能把所有句子拼成一段提示词,一次送入文本编码器。字符串里确实仍有左和右,输出形状也可能合理,但各句在编码时已经共同参与计算。后来给拼接结果标上两个时间标签,并不能保证各段表示只包含各自的动作信息。这个例子用于解释接口风险,不是本文运行中观察到的故障。
H3 补丁里的 _encode_action_script() 采取另一种明确做法:每一句独立 tokenization 和编码,相同字符串在本次函数调用的局部字典中只编码一次;随后按动作列表顺序追加行,并为每次出现记录 (start, stop)。重复句子能复用相同的编码结果,但依然占据各自追加位置,得到自己的 span。缓存键是该次调用内的句子字符串;它不是跨请求、跨模型版本的持久缓存,也没有在这里产生一个可引用的整体性能收益。
这一区分会影响移植接口。若节点为了省事只输出"去重后的句子集合",下游便不知道同一句向左出现于哪些 latent。如果只输出一大段 embedding,既没有跨度也没有映射,后面便无法可靠恢复原来的绑定关系。节点是否拆成几个框无关紧要,应保留的是有序动作列表、每次出现的编码行区间以及对应 latent 索引。静态文本相同、动作重复等情况,都应在记录中逐项对应。
动作语法也需要直接复用或逐项验证。固定 action_script.py 从九位按键状态生成移动和镜头子句,并有全静止的 null_script()。自由改写主体名称、换同义词或把镜头与角色运动合并,会改变模型实际看到的文本。它们可以成为后续实验,但首次移植比较应先保留参考句子,避免把条件语义变化与后端变化混在一起。动作句与静止参考
因此,第一个可比位置应在模型预测之前:同一首帧处理、同一场景和同一动作输入,参考端与移植端是否给出相同数量、顺序和内容的动作句;每句 token 数与 span 是否对应。可以先比较这些离散元数据,再比较编码张量。没有真实编码执行时,不能用自己构造的占位数组 SHA 冒充参考 embedding 证据。
末端 mask 正确,还得证明动作在进入它之前没有串句
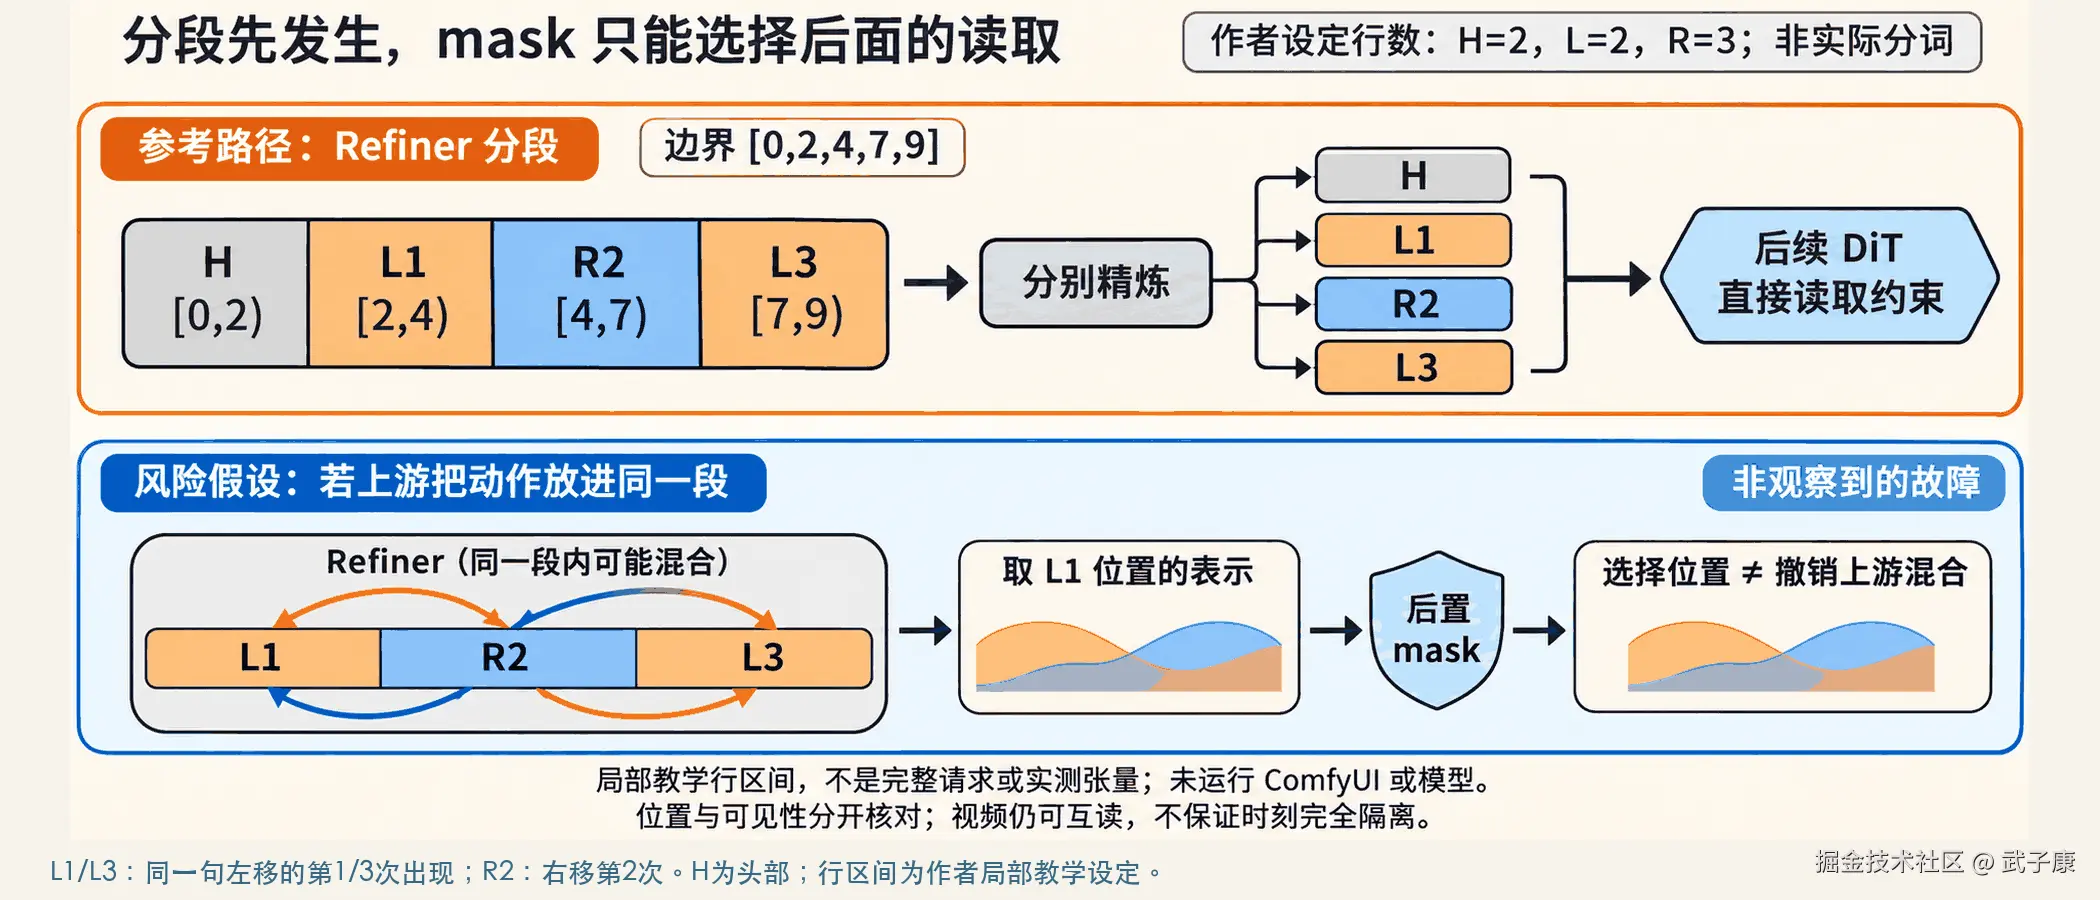
作者机制示意或待执行语义对齐安排;没有Comfy或GPU实测。
固定官方页面聚焦原像素;证明局部源码职责,不是Comfy或模型运行结果。
补丁在主干前保留 action_text_spans_local,用于构建 Token Refiner 的分段边界。Token Refiner 是进入主干前继续加工文本表示的模块;这里要保住的职责,是让静态头部与各句动作分别成为独立的序列段。若沿用基础实现把整个文本当作一段,动作句会在 Refiner 的注意力里混合。后面主干只限制"哪一行能读哪一行",无法知道某一行动作表示里已经混入了哪些别的动作。
这也是移植验收应在编码与主干之间再留一个位置的原因。仅导出动作文本和最终 mask 热图,中间仍有一段没有证据覆盖。固定补丁按 span 构建分段累计边界,检查末尾达到 text_len 且边界严格递增。它还兼容从已有 action_text_rows 推导跨度的路径。移植可以采用不同内部数据结构,但要给出实际分段及映射,证明没有把相邻动作重新合并成同一可互读的段。
位置和可见性是这里的两项不同操作。打包器给动作行写入与对应视频时间网格相关的时间坐标,同时输出 action_text_rows、action_video_start、action_frame_rows、action_real_used 等字段。它会检查动作 span 数量是否等于 latent_t,span 是否越界、重叠或倒序。img_position_ids 影响位置表达;Refiner 分段边界影响上游哪些文本行彼此可见。一个整数列表恰好长度正确,不代表这两项职责都已经实现。
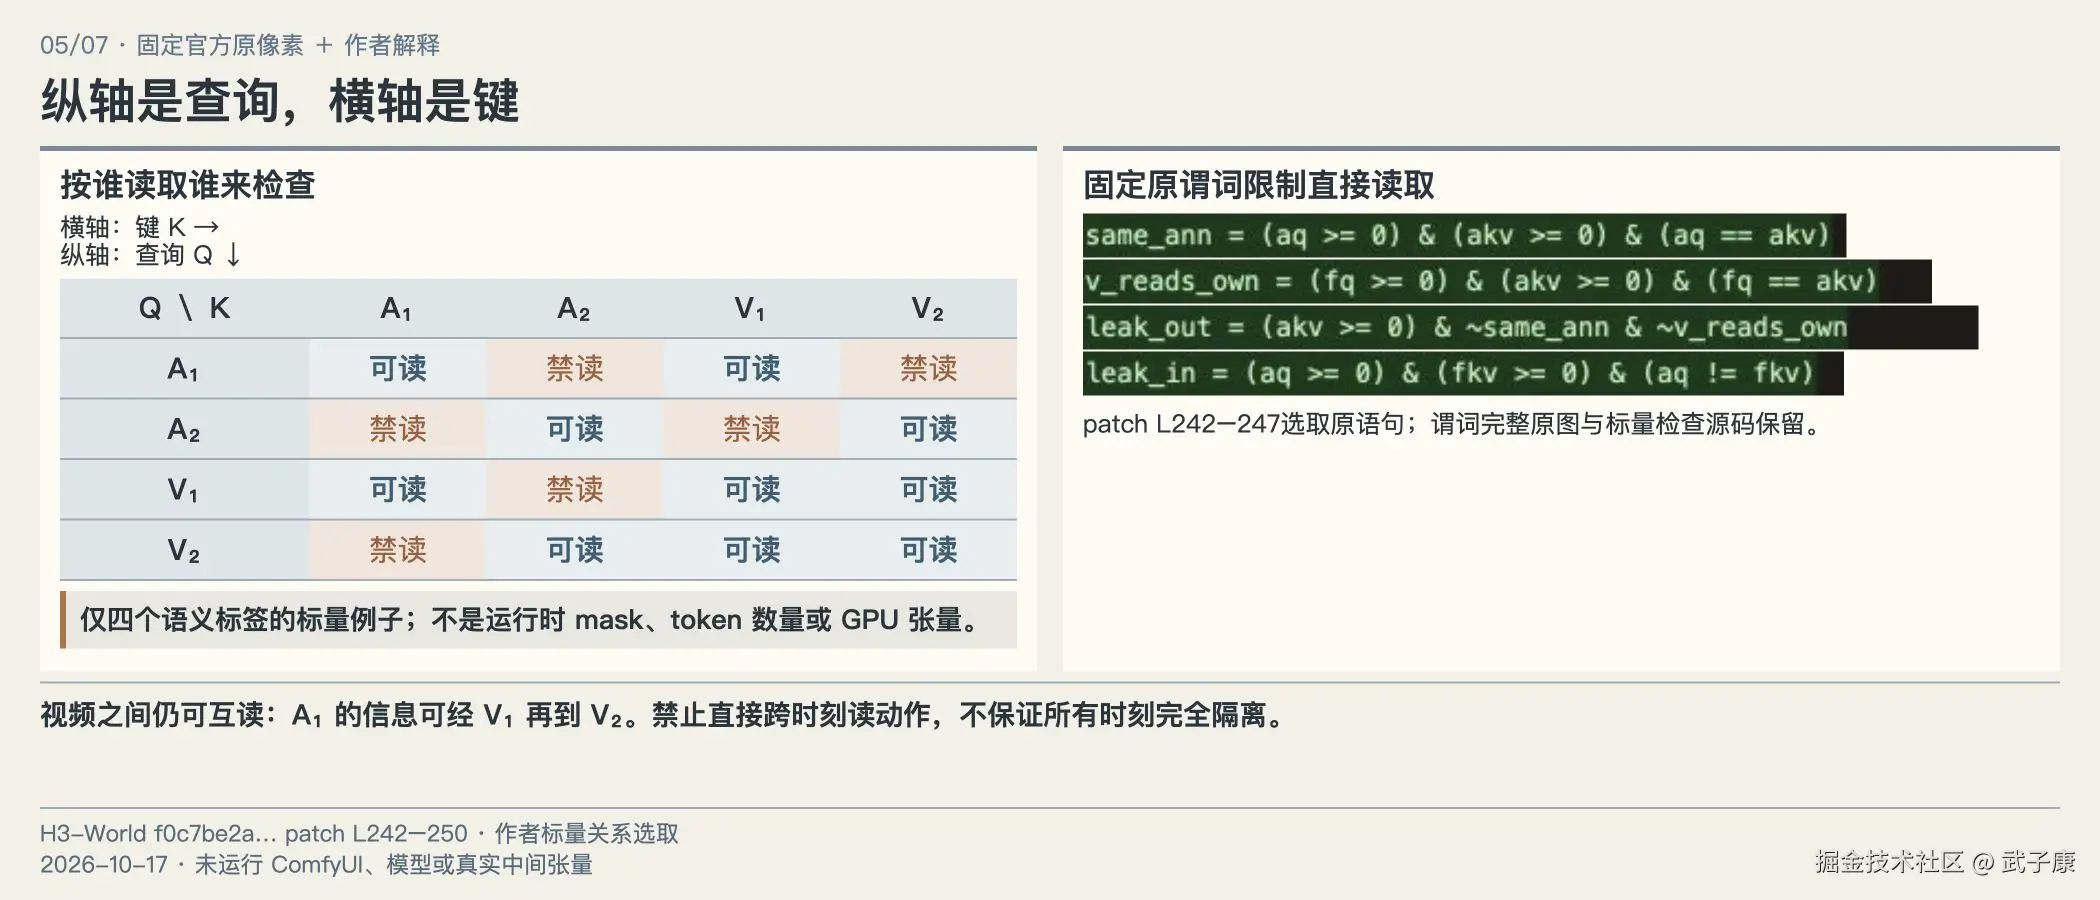
到主干注意力时,必须继续区分查询与键。以 A₁、A₂ 表示两个动作句,V₁、V₂ 表示相应视频 latent。定向规则允许 V₁ 读取 A₁,禁止 V₂ 直接读取 A₁;也禁止其他动作句、静态文本、首帧条件和音频直接读取 A₁。A₁ 自己可以读取静态条件和自己的视频,但不能读其他视频 latent。视频之间仍可互读。因此"禁止直接跨时刻读动作"和"所有时刻的内容永远互不影响"是两种完全不同的保证。
后一种说法并不成立:动作信息可以经对应的 V₁ 再传到 V₂。移植时如果为了追求所谓严格隔离,把 V₁ 与 V₂ 的互读也关掉,便改变了参考视频建模。若反过来允许静态行读取动作,再让所有视频读静态行,就多出一个绕过对应 latent 的路径。检查一张热图时,必须明确纵轴是查询、横轴是键,才能判断信息从哪里流向哪里;只凭"有块状结构"不够。官方固定动作补丁
padding 也在实际规则里。补丁使用真实长度屏蔽无效行,同时允许行读取自身,避免无可见键。若移植端为适配 kernel 补齐长度,应记录有效长度、补齐长度及规则。真实行不能把补齐行当有效键读入;补齐行的自读只是数值处理,并不赋予它动作或画面语义。不同 attention 后端不一定有相同数据布局,验收对象应是这些行关系,而不是两个内部 mask 对象的二进制完全相同。
本次将补丁中 mask_mod 的原始谓词提取出来,以标准库在七个标量标签上检查查询---键关系。这只核实小例子的布尔语义及轴方向,没有调用 PyTorch、FlexAttention 或真实张量,更没有验证具体 kernel。真实移植仍需要记录其运行时构建出的可见性关系,并检查对应后端确实使用它。
正负分支改变了,动作比较的含义也会改变
固定官方页面聚焦原像素;证明局部源码职责,不是Comfy或模型运行结果。
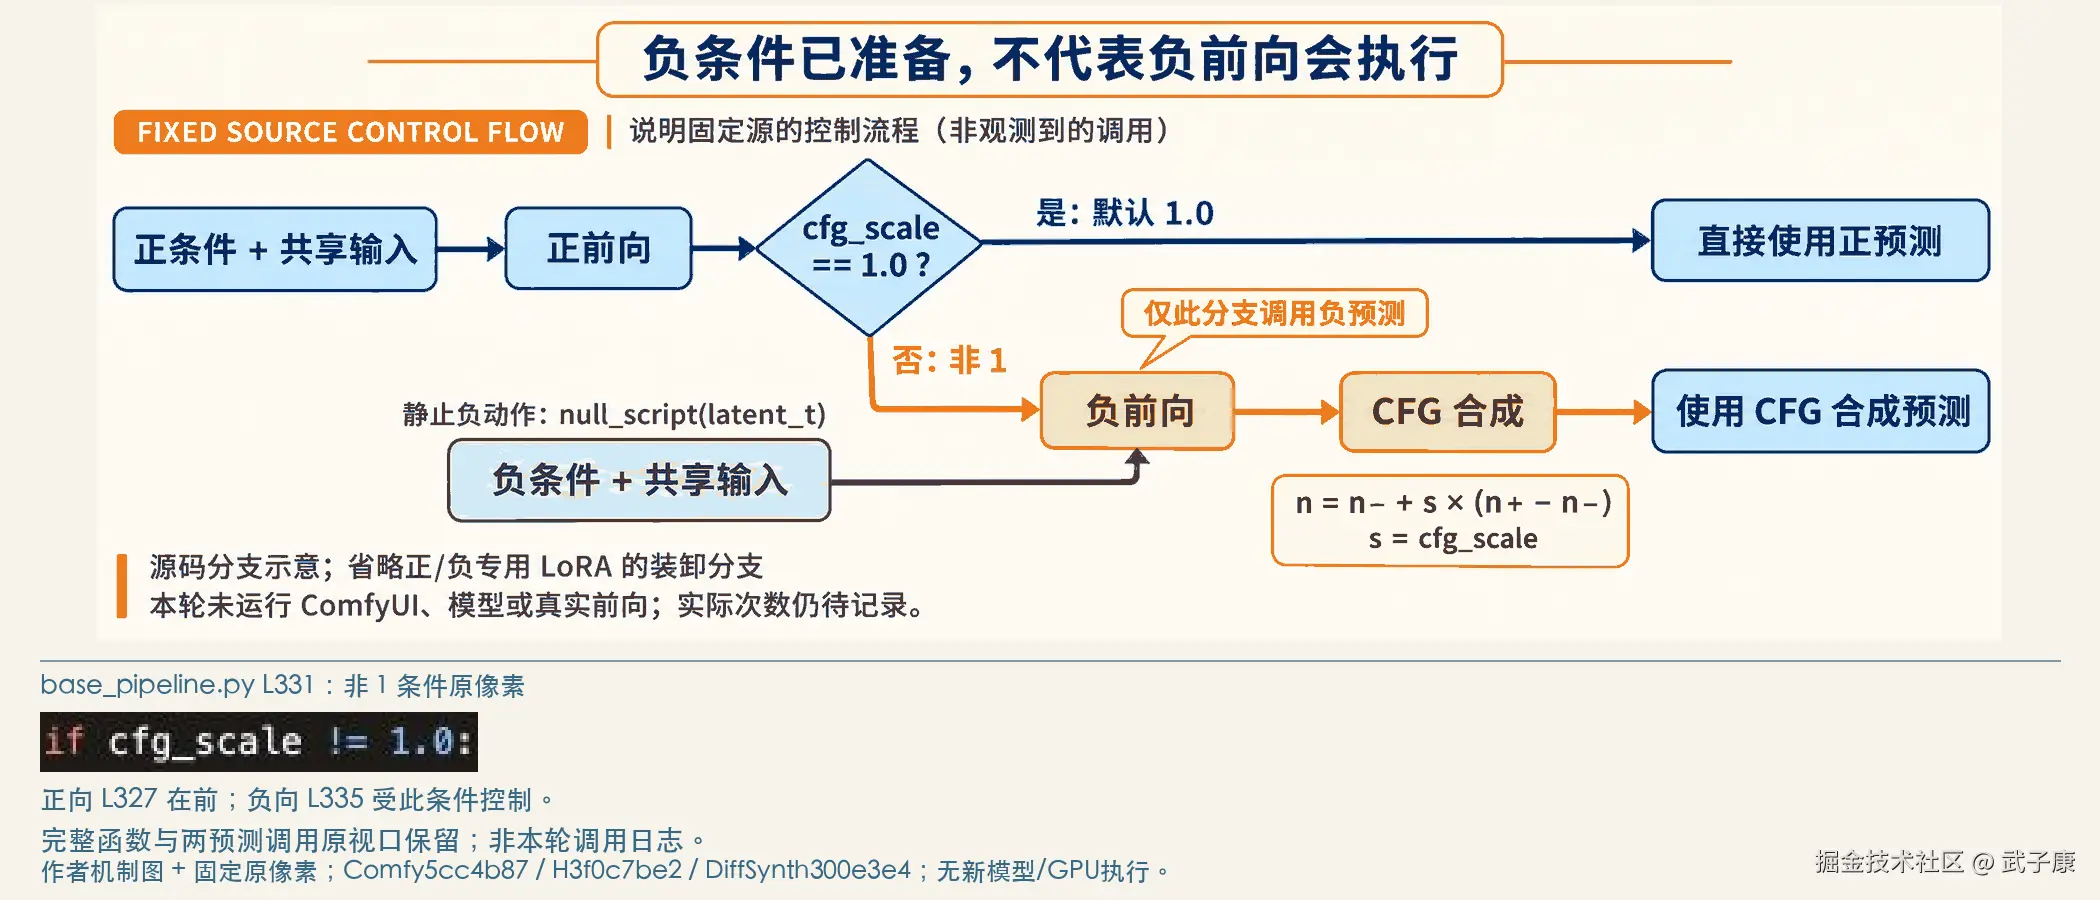
动作路径并没有在 mask 结束。H3 参考调用传入正动作列表,同时用 null_script(latent_t) 生成各项静止的负动作参考。正负条件分别通过带 seperate_cfg=True 的处理单元,生成各自文本及跨度。若移植端只把普通负面画质词接入负条件,却没有相应的静止动作句,就改变了参考端定义的比较对象。
固定 BasePipeline 的 CFG 实现先计算正分支;cfg_scale 不等于 1 才计算负分支并组合预测。参考 CLI 默认是 1,因此默认情况下不能宣称模型实际执行了两次正负前向。要检查静止负动作路径,需要设计一个非 1 的专门对照,并记录实际调用次数与对应条件。不能为了让图上"两个输入都连着"就认定两个分支都参与了结果。固定 CFG 实现
默认参考还涉及首帧覆盖缩放与中心裁切、FL2VA 组件、采样步数及视频和音频两路 latent。这些在本篇不展开成全套节点教程,原因是它们需要作为比较时保持一致的输入条件。第一次对齐若同时换成 pruned Ref2VA、量化权重、Turbo 或缓存实现,即使输出发生变化,也难以判断是动作移植还是额外变化造成。
如果只希望在 ComfyUI 内触发参考实现,工程上还可以先做一层较薄的调用封装,把完整 H3-World pipeline 保留在原后端。这样仍需保存实际导入路径、请求和输出证据,但不必立刻在另一套模型实现中重写所有条件和注意力。只有确实需要复用另一套 H3 模型或采样栈时,才承担相应的语义移植。节点数量不是这两种方案的验收尺度。
用同一张记录推进到真实输出
作者机制示意或待执行语义对齐安排;没有Comfy或GPU实测。
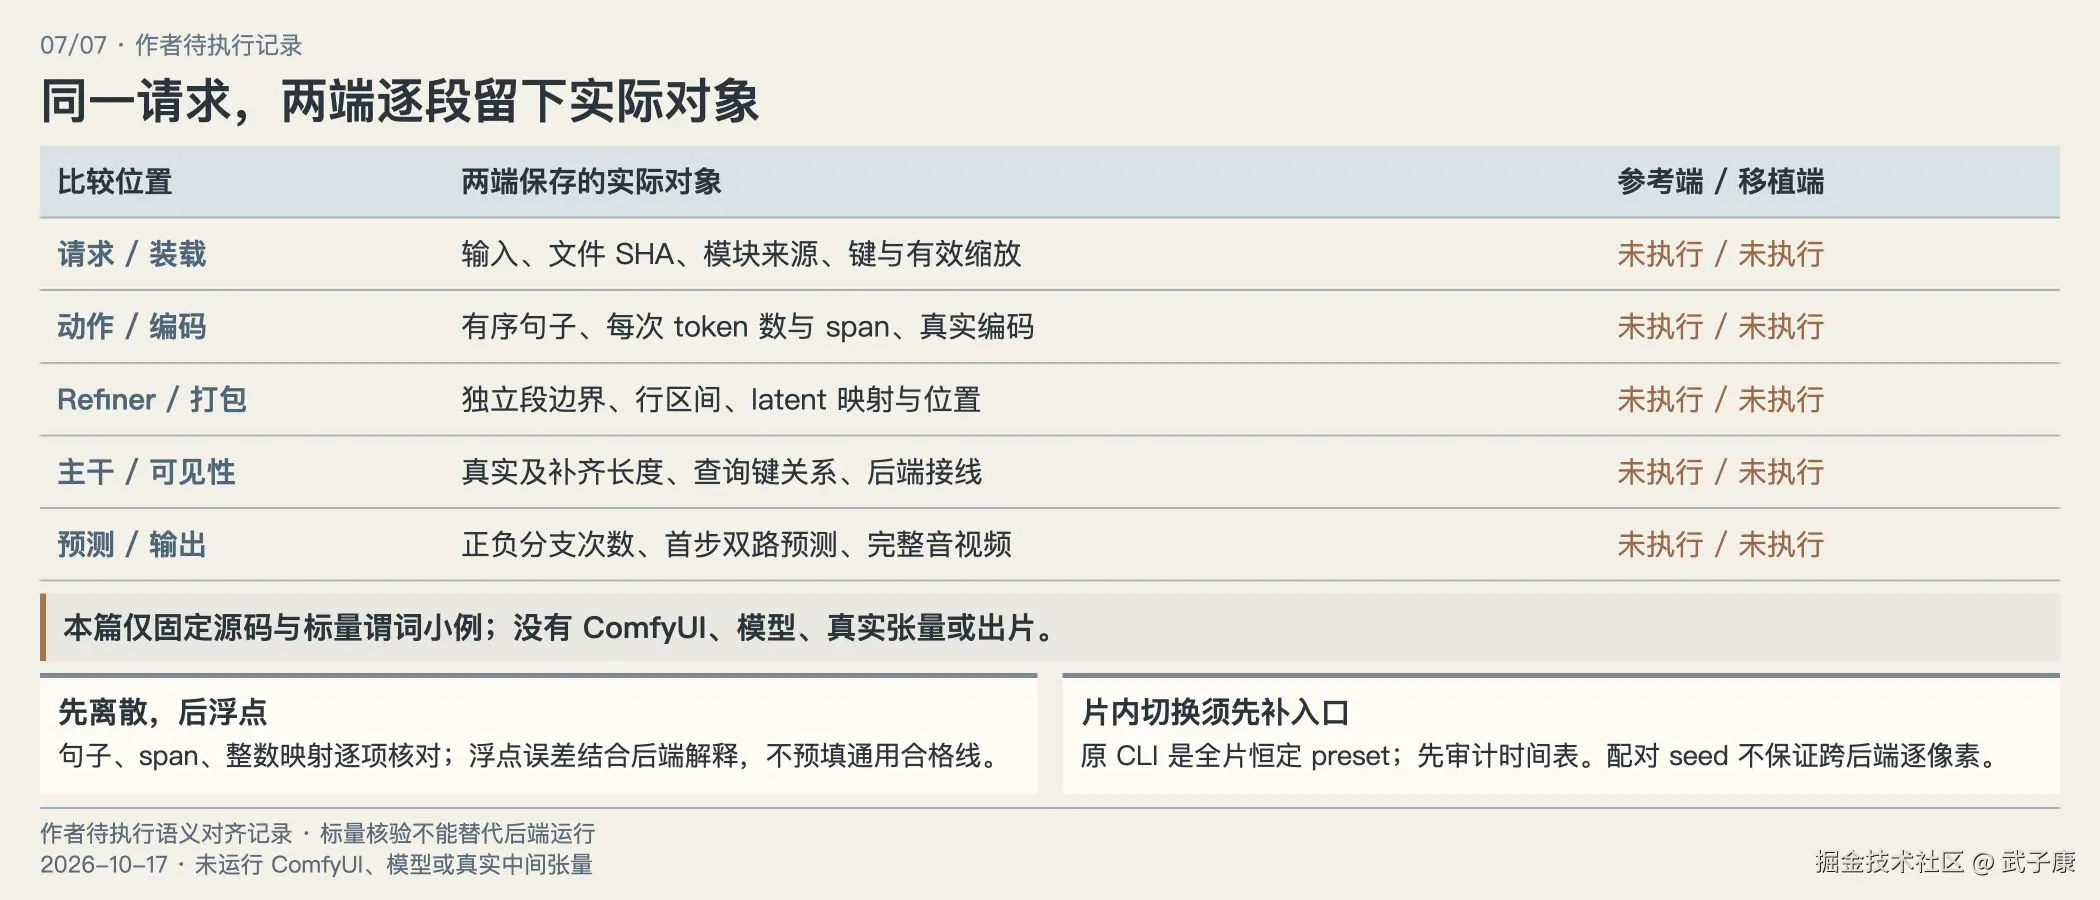
下面是作者设计的待执行验收记录。每一行都对应前文一个可能丢失动作语义的位置;它们共同回答一次移植能否保持参考路径,没有各自形成另一套接入框架。参考端与移植端没有实际产物的格子,始终保留"未执行",不能填推测值。
| 比较位置 | 两端应保存的实际对象 | 判断办法 | 本次状态 |
|---|---|---|---|
| 请求与装载 | 首帧处理、帧数、基座/动作载荷 SHA、实际模块来源、键和有效缩放 | 固定输入;逐条列出未匹配、形状变化和转换 | 未执行模型装载 |
| 动作与编码 | 有序动作句、各次出现的 token 数、span、编码器版本和实际编码结果 | 离散元数据逐项对齐;浮点差异单列容差与统计 | 未执行编码 |
| Refiner 与打包 | 实际分段边界、行区间、动作到 latent 映射和位置坐标 | 无越界或遗漏;确认分段未串句,位置定义一致 | 未执行中间张量比较 |
| 主干可见性 | 真实/补齐长度、查询键标签及实际后端使用的 mask 规则 | 逐关系检查自己的动作、其他动作、视频互读和 padding | 仅标量谓词小例子,后端未执行 |
| 预测与输出 | 正负条件及实际分支次数、采样参数、首步双路预测与完整音视频 | 先定位中间差异,再按预定动作标准比较完整输出 | 未执行采样及出片 |
实际推进时,先在一套能运行的参考环境中保存这些对象,再让移植端使用完全相同的输入。参考端本身若失败,就记录失败阶段,不拿另一套能出片的 H3 模型替换参考。两端的文件应同时带输入与版本来源,避免一个是昨日权重、另一个是今日更新后代码,最后却把差异归因于节点封装。
对动作条目、span 和整数映射,可以要求精确相同;对不同布局的 mask,可以先转为带相同语义标签的查询---键关系再比较。对真实浮点编码、首步预测等对象,应报告 dtype、形状、数值范围以及选择的绝对和相对误差,容差需结合后端与精度确定,不能在这里预填一个"通用合格线"。张量 SHA 相同是很强的字节证据,不同则只表明字节不同,还要检查数值与行为差异,不能直接判算法不一致。
完整输出比较应先包含全片恒定向左、向右和静止,再加入片内切换。后者不由原 CLI 的恒定 preset 直接表达,必须先增加可审计的时间表入口并保存实际动作列表。不能拿两段独立生成的视频拼起来当作一次片内反向切换。相同 seed 可以配对随机条件,无法保证更换后端后逐像素相同;动作方向、切换时机、静止漂移和音频连续性应按事先说明的对象与规则观察。本文没有执行这些场景,也不把若干 seed 数字当统计保证。
这样的记录能让故障停在具体位置。动作句已不同,就先修输入归一化;句子相同但 span 或 Refiner 分段不同,就检查条件构造;这些都一致而可见性不同,再查位置、打包和后端 mask 接线;前述关系一致但预测或输出仍变,才进一步调查浮点实现、采样和模型载荷。顺序不能保证一次定位全部错误,但可以避免把"动作不准"全部推给 LoRA strength。
最终你需要留下的,并非一张连接完毕的节点截图,而是同一请求在两端经过这些位置的实际记录。只完成装载,就如实写已完成装载;走通参考后端的封装,可以按该范围描述接入;重写后的后端完成中间语义与输出比较,才有依据说明那份具体移植保留了所检查的动作行为。不同阶段各自有用,证据不应跨阶段代填。
来源与未验证范围
本文使用固定官方 H3-World 推理、动作脚本及补丁,按指定 DiffSynth 基础源码做文本应用和静态检查;ComfyUI 部分只核对上述固定提交的通用 LoRA 装载调用链,不评价未检查的第三方节点。源码片段中的历史验证注释仍是作者报告,不是本次复现。
原研究笔记的六节点图、数据类、时间表 UI、代码量估算和侧挂量化方案均作为设计素材,没有当作已存在插件或运行结果。本文没有取得权重载荷、真实 embedding、运行时 mask、首步预测或音视频输出;没有关于速度、显存、实时交互或动作成功率的新测量。表格就是下一次实际运行需要补齐的记录,其空缺不由静态检查代替。