原文:mp.weixin.qq.com/s/e2P8r7YVr...(2026年10月04日)
 拼图快齐了:记忆会提炼、会分格式,知识库会分块、会混合检索,还能长成树、织成网。但它们大多还是"你问一句、它查一下"的被动管道。这一篇就看最后三块------也是最"聪明"的三块------以及整套设计的收束。
一、上下文感知检索:给每个分块补上"身份"
还记得第三篇埋的伏笔吗?分块会切断片段和原文的联系,产生"孤儿分块"------"该公司"指代谁、"这段话出自哪份报告",都留在了块外面。
上下文感知检索(Contextual Retrieval) 正是来修补这个最基础环节的(这个思路最早由 Anthropic 提出)。做法朴素但有效:在建索引之前,为每个分块生成一段专属于它的上下文说明,再把它和原文块一起嵌入。流水线大致是这样:
PLAINTEXT
文档 → 基础分块 → LLM 为每块生成上下文前缀 → 增强块
     → 检索流水线(稀疏 + 稠密)→ 混合检索 + 重排
比如一块只写着"收入增长 3%",模型会为它补上"这段话出自某年第三季度财报,讨论的是北美区业务",检索时就不会再张冠李戴。书里的实验用同一批标注问题对比了"加不加上下文",并画出离线 BM25 的 recall@k 变化------结论是加前缀后召回明显提升。
注意它的定位:它不是 架在 Agentic RAG 之上的更高一层,而是回过头去修补最基础的分块缺陷,提升每个分块自身的检索质量。
二、智能体化 RAG:从"固定管道"到"主动探索"
前面所有的检索方法共享一个前提------流程是固定 的:分块、嵌入、检索、生成,一条道走到黑。可现实里的问题常常需要多步、试探、回退:先搜一下,发现没找到,换个关键词再搜,还不够就去查相关概念。
智能体化 RAG(Agentic RAG) 就是把这条固定管道,升级成由 Agent 主导的、动态的、迭代的探索过程------Agent 自己决定"什么时候该搜、搜什么、要不要继续搜"。技术上是把检索包装成工具,交给模型在"推理---行动"循环里反复调用(这正是 ReAct 的思路)。
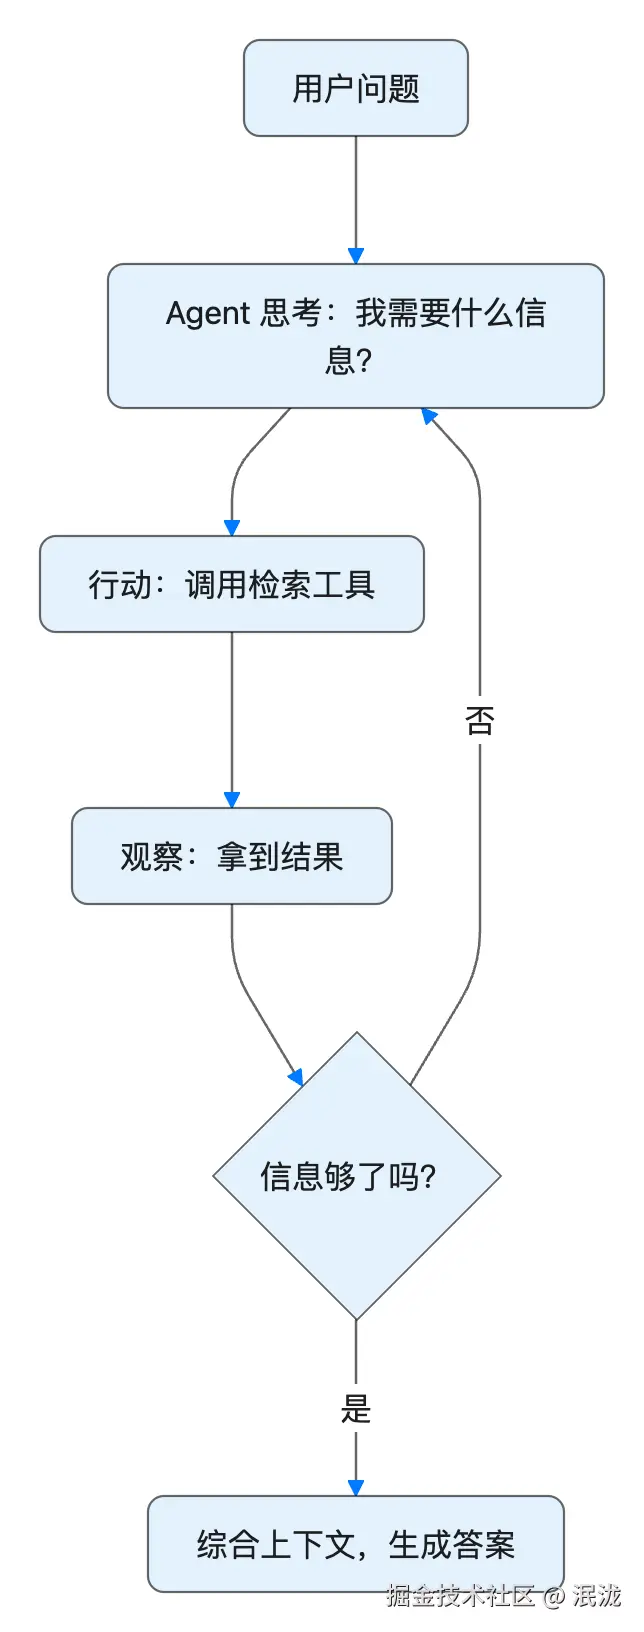 书里也点出了它的一处软肋:如果模型不知道自己不知道什么,就无法正确触发搜索------这个"元认知"问题,是 Agentic RAG 真正的难点。
三、从结构化数据里"挖"深度知识
有一类知识天生是非结构化的:医疗病历、法律判决、客户反馈。想让它能被统计和推理,得先把它"结构化"。
书里用了一个法律判决 的例子,很能说明问题。核心分两阶段。第一阶段,知识提取与结构化 :用大模型把每个案例的非结构化描述(如案情陈述)转成包含关键判决因素的标准化 JSON。难点在于定一个既全面又一致的"数据模式(Schema)"。这里有个巧妙之处------自下而上发现因子:不预设僵化的模式,而是让模型先分析几百个样本、自由列出所有可能影响判决的因素,再据此归纳出模式。最终得到一个"核心模式"(适用于所有案件的情节,如自首、赔偿)加上针对不同罪名的"扩展模式"(如盗窃的涉案金额、故意伤害的伤害等级)。第二阶段则是在这个结构化底座上做检索与推理。
可见,当检索对象是结构化数据时,"先让模型把数据整理成统一对象"往往比"硬检索原文"有效得多。
四、收束:一套"双层记忆"架构
现在把这些零件装回去,就是全章这一节的落点------一套双层记忆架构。
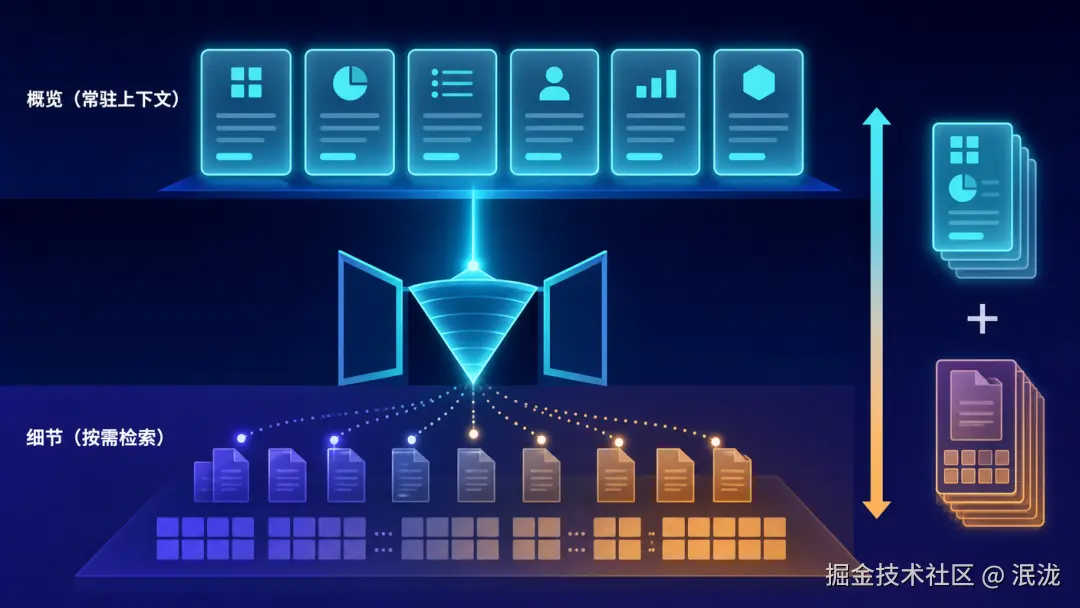
上层,是常驻上下文的"概览" :用前面讲的 Advanced JSON Cards,把用户最关键的偏好、关系、摘要,做成精炼的结构化卡片,始终摆在模型眼前。下层,是按需检索的"细节":大量原始记录和片段沉在知识库里,靠上下文感知检索精确调取。
一"概览"、一"细节"叠加起来,跨会话记忆的召回精度和冲突解决能力都明显提升------它才真正撑得起第一篇里那个最高标准:主动服务。
小结 & 系列回顾
五篇走下来,其实一直在回答同一个问题:怎样让 AI 记住你、记住知识。
--
第一篇搭骨架:记忆分"用户记忆 / 知识库",能力分"基础回忆 / 多会话检索 / 主动服务",存储分"轨迹 / 长期记忆"。
--
第二篇讲怎么存:四种格式一条光谱,情景 / 语义 / 程序三种类型,Mem0、Memobase 两个真实框架。
--
第三篇讲怎么查:RAG 的检索→增强→生成,稠密、稀疏与混合检索。
--
第四篇讲怎么组织:RAPTOR 的树、GraphRAG 的图、OpenViking 的文件系统,以及时效治理。
--
第五篇讲怎么变主动:上下文感知检索、Agentic RAG、结构化知识提取,收敛为双层记忆架构。
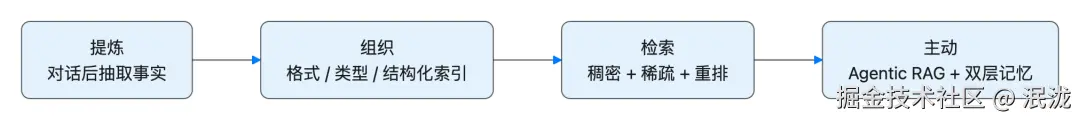 如果只带走一句话:好的 Agent 记忆,是一套"提炼---组织---检索---主动"的系统工程,而不是一个数据库。 想动手,可以从书里 chapter3 的实验开始------换一种记忆格式、加一层重排序,效果差异用具体例子一看便知。
🔗
延伸阅读(开源项目) :编排框架看 LangChain / LlamaIndex ;知识图谱看 Microsoft GraphRAG 、Zep / Graphiti ;记忆层可对比 Letta(MemGPT) 、Supermemory ;一体化 RAG 平台可看 RAGFlow 。原文与配套实验见开源书 bojieli/ai-agent-book(第 3 章)。