原文:mp.weixin.qq.com/s/NKCbHGTUE...(2026年09月29日)
TL;DR:感知工具的关键,不是让 Agent 一次读得越多越好,而是让它知道"拿到了哪一部分、还缺哪一部分"。
想象财务同学发来一份百页 PDF,问 AI Agent:"第三季度收入比第二季度怎样?"Agent 可以调用读取文件的功能,但假如这个功能只返回前几页,却没提醒"后面还有九十多页",它就可能拿着不完整的材料给出完整答案。
这里的 Agent 是能按步骤使用工具的 AI 助手;负责搜索、读取和查看图片的功能,叫作感知工具。这个财务场景只是帮助理解问题的例子,并非实测案例。
感知工具的关键,不是让 Agent 一次读得越多越好,而是让它知道拿到了哪一部分,还有哪一部分没看到。
具体怎么做?搜索时,先给它一份像搜索结果页那样的清单:标题、来源位置和简短摘要;它觉得相关,再打开全文。读百页报告也类似翻书:先定位目录和相关页,再看前后文。技术上常用 offset/limit 指定"从哪里开始,读多少",就像说"从第 40 页起读 5 页"。
如果内容被截断,工具应明说"共 100 页,当前只看到第 40---44 页",并告诉它如何继续读取。这样既少占模型一次能处理的信息空间,也避免把局部当全貌。
简报
把"只读"当成设计优势
本节要点:只读让工具可以安全地并行读取与缓存;但缓存要讲时效,读材料时要标出来源与获取时间。
感知工具通常只读取信息,不替你改文件或发消息。于是系统可以并行 读取几份报告------像几个人同时查资料------也可以把重复查询的结果暂存起来,下次直接使用;这种暂存叫缓存。
但缓存要看时效:去年企业年报可以复用,今天的天气和股价却可能已经变了。读取材料时,标出来源和获取时间,才便于后来核对。
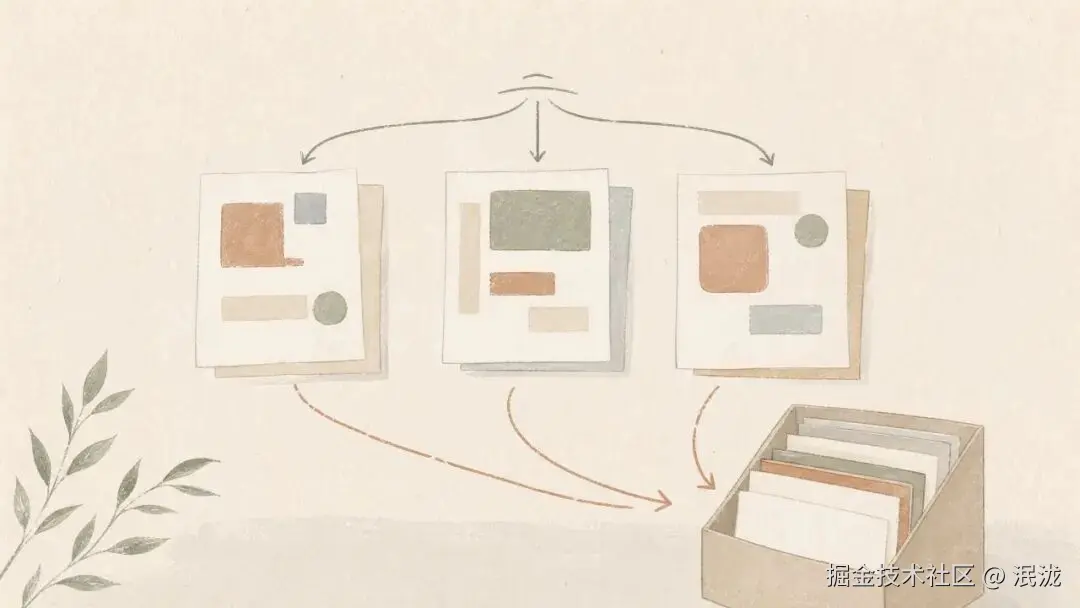
同一份 PDF,还可能有三种"读法"。第一种 ,把原始页面交给能看图的模型,图表和排版通常能保留下来;第二种 ,先用 OCR(把图片上的字识别成可编辑文字的技术)或文档提取功能,把内容转成文字,阅读成本较低,但可能丢失表格的行列关系;**第三种,**由主 Agent 把原文件交给专门的图像分析工具,并提一个具体问题,只取回分析结果。
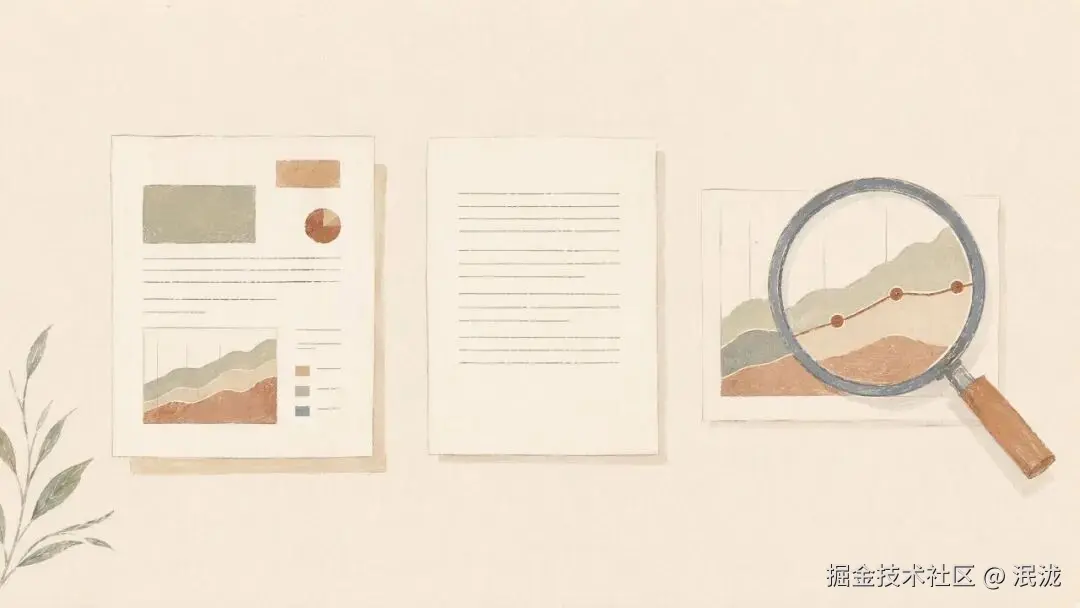
怎么选?一个简单的判断办法是:问"合同第七条写了什么",文字可能就够;问"图中哪条线增长最快",就得保留图;问"先看看这页有没有异常",可先请专门工具做初步分析。这是选工具的思路,不是三种方法谁一定更准的实测排名。
开源示例 perception-tools 用搜索、文件与公开数据读取等功能展示感知工具;multimodal-agent 则比较上述几种多模态处理路径。多模态就是文字以外还要处理图片、声音等不同形式的材料。
看这些项目时,除了"能不能读",更值得问的是:资料有没有缺页?图表关系是否保留?Agent 能否返回原文继续核对?
一个可靠的感知工具,不是替 Agent 假装看尽所有材料,而是把信息切成可追踪、可回读、可核对的片段。