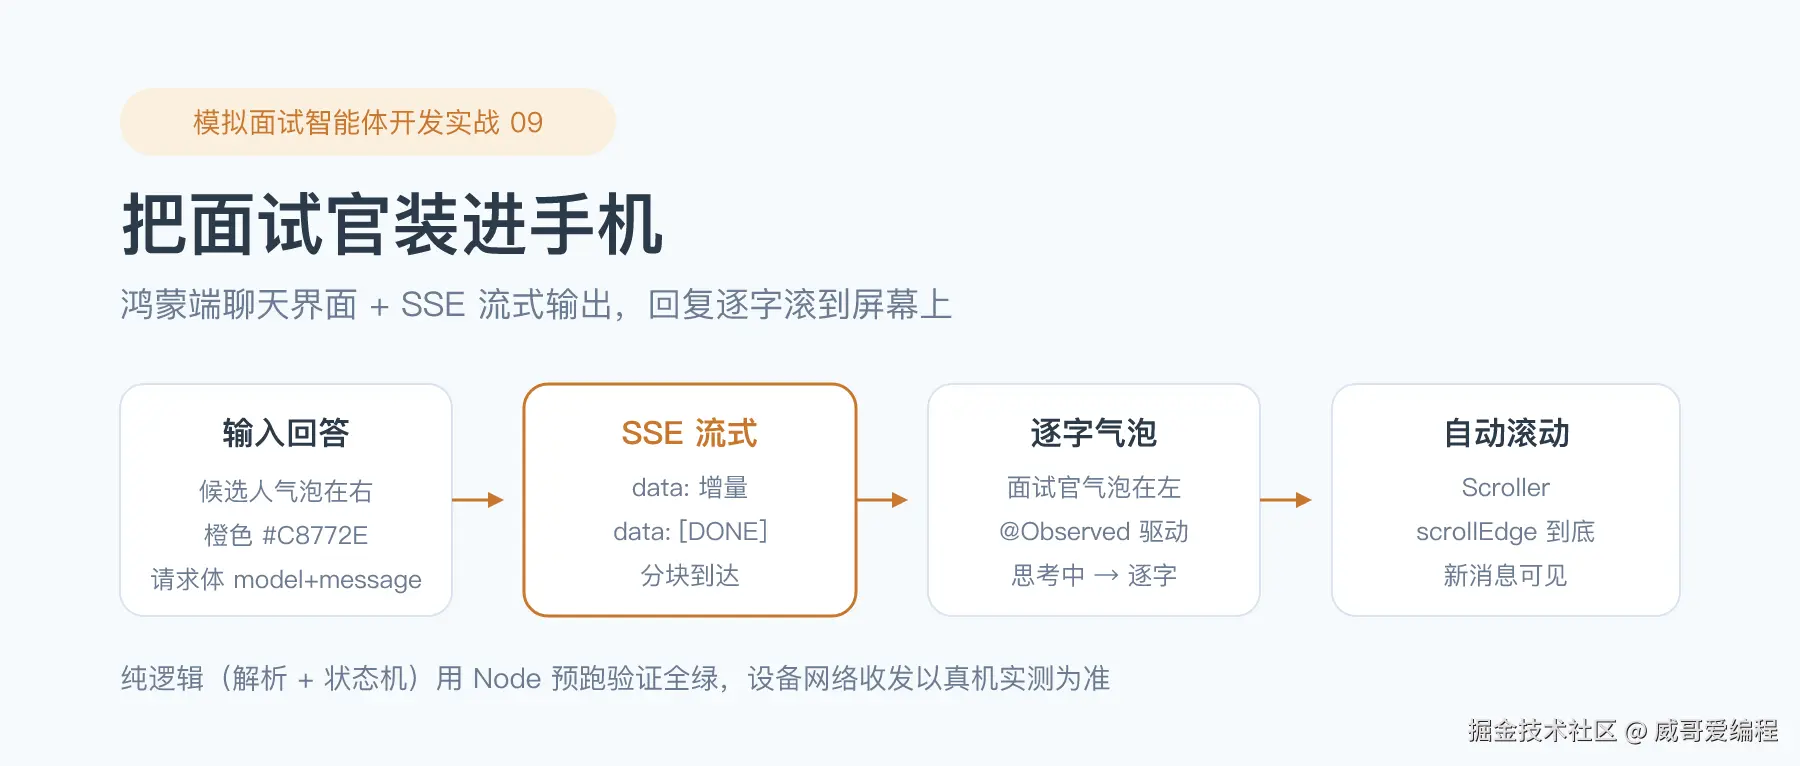
前八篇,我把面试官的后端彻底搭好了:会出题、会追问、会判定、会点评、会出总评报告。可这些能力全躺在服务端,候选人想看,还得开电脑、敲命令行、发 HTTP 请求------这哪叫"随叫随到的面试官"?
所以从这一篇开始,我们把它搬进手机。鸿蒙端(ArkTS)先做最要紧的一件事:聊天界面。候选人对着手机说话,面试官的问题和追问流式滚到屏幕上,回复逐字出现,而不是等半分钟才蹦出一整段。这一篇就把聊天界面、SSE 流式解析、消息状态机、自动滚动这一整套在鸿蒙端搭起来。
先说清楚本篇的边界:纯逻辑(SSE 解析、状态机、消息模型)我用 Node 预跑验证到全绿;真正的 HTTP 流式收发和界面渲染,属于设备 API,以真机实测为准。这是我这个系列一贯的诚实口径------能离线测的一定测到位,不能离线测的,老老实实写清楚。
一、先扫盲:流式输出和状态驱动,是两个必须弄懂的点
1. 为什么一定要流式(SSE)
大模型生成是"一个字一个字往外蹦"的。如果等服务端把整段回答生成完再一次性返回,候选人看到"面试官思考中..."可能要干等十几秒甚至更久。SSE(Server-Sent Events)让服务端每生成一小段就推一小段,客户端立刻渲染------首字延迟从"整段时长"降到"第一个 token 时长",体验天差地别。第 02 篇我在 FastAPI 里就做了 SSE 流式接口,现在鸿蒙端要做的,就是把这股字节流接住、切碎、逐字喂给界面。
这里补一个真实体会:我最早用非流式接口,一道需要面试官"点评 + 追问"的题,模型要输出一百多字,候选人盯着空白屏幕等了二十多秒,已经怀疑是不是卡死了。改成流式后,第一个字不到一秒就出来,剩下的边生成边滚------"等整段"和"等首字"是两种完全不同的心理感受。所以聊天界面这套东西,流式不是锦上添花,是能不能用的问题。
2. ArkTS 声明式 UI 的状态驱动
鸿蒙用 ArkTS + ArkUI 写界面,核心是"状态驱动":你改数据,界面自动重渲染。但有个坑------默认的 @State 状态管理只代理数组的第一层 。也就是说,数组里某条消息的 text 变了(比如流式追加一个字),界面不会自己刷新。解决办法是给消息类加 @Observed,再用 @ObjectLink 绑定到气泡组件,这样消息内部属性一变,气泡就重画。这两个装饰器,是本篇 UI 能不能"逐字刷新"的关键。
3. 解析器和 UI 要解耦
流式解析(SSE 字节流 → 事件)是纯算法,不该和网络、UI 纠缠在一起。拆开后,解析器能脱离设备用 Node 预跑验证,UI 只负责把事件翻译成"追加文本 / 结束 / 报错"。这又是我反复用的老思路:把便宜的、确定的、可测的,和昂贵的、依赖设备的、难测的,分开。
二、工程结构:一个标准的鸿蒙工程骨架
鸿蒙工程(DevEco Studio 新建的 Stage 模型)长这样:
bash
09-聊天界面/
├── AppScope/app.json5          # 应用级配置(bundleName 等)
├── build-profile.json5         # 构建配置(SDK 26、签名等)
├── hvigorfile.ts               # 根构建脚本
├── hvigor/hvigor-config.json5  # Hvigor 配置
└── entry/
    ├── src/main/
    │   ├── module.json5        # 模块配置(声明 INTERNET 权限)
    │   ├── ets/
    │   │   ├── entryability/EntryAbility.ets
    │   │   ├── pages/Index.ets          # 聊天界面
    │   │   └── feature/chat/
    │   │       ├── ChatUIMessage.ets    # 消息模型
    │   │       ├── SseStreamParser.ets  # SSE 解析器
    │   │       ├── StreamController.ets # 流式控制器
    │   │       ├── InterviewConfig.ets  # 配置(服务端地址/模型/密钥)
    │   │       └── ChatService.ets      # 网络层
    │   └── resources/          # 字符串/颜色/路由
└── src/ohosTest/ # Hypium 测试两个容易踩的工程坑先记下来:根 oh-package.json5 的 name 不能带连字符 ,用下划线(比如 interview_agent_09_chat_ui),否则构建报错;Hvigor 三件套(根/entry 的 hvigorfile.ts + hvigor-config.json5)要齐,modelVersion 写 26.0.0,dependencies 保持空 {}。这套约定我在前面的鸿蒙系列里已经反复验证过,照着抄就不会错。
三、消息模型:把一条消息钉成"角色 + 文本 + 状态 + 时间"
ChatUIMessage.ets 是气泡要关心的全部。角色分 USER(候选人,气泡在右)和 ASSISTANT(面试官,气泡在左);状态是流式的灵魂:
typescript
export enum MsgStatus {
  PENDING = 'pending',     // 已发出,等待服务端首字
  STREAMING = 'streaming', // 流式输出中
  DONE = 'done',           // 完成
  ERROR = 'error'          // 失败
}

@Observed
export class ChatUIMessage {
  readonly id: string;
  readonly role: BubbleRole;
  text: string;
  status: MsgStatus;
  readonly createdAt: number;
  // ...
}注意两个细节:@Observed 修饰类,让 text/status 的属性变化能被 @ObjectLink 的子组件观察到;id 是自增生成的唯一值(m_时间戳_序号),作为 ForEach 的 key,保证列表稳定。formattedTime() 把时间戳格式化成 HH:mm,气泡下方展示。
id 当 ForEach 的 key 这件事,看着不起眼,其实很关键:流式消息的顺序是固定的,如果 key 不稳定(比如用数组下标),列表在每次追加时可能错位重排、闪烁。用一个稳定唯一的 id,ForEach 才能精确知道"哪条没变、哪条新增",只重绘变化的气泡,不动其它------这是长列表流式刷新的基础。
四、SSE 解析器:字节流怎么切成事件
SseStreamParser.ets 是本篇的纯逻辑核心。它面对的现实是:网络是分块到达的,一次 feed 进来的可能只是半行 。所以必须维护一个 buffer,只有遇到换行才算一条完整 line:
typescript
export type SseEvent =
  | { kind: 'delta'; text: string }
  | { kind: 'done' }
  | { kind: 'error'; message: string };

export class SseStreamParser {
  private buffer: string = '';

  feed(chunk: string): SseEvent[] {
    this.buffer += chunk;
    const events: SseEvent[] = [];
    let idx: number;
    while ((idx = this.buffer.indexOf('\n')) !== -1) {
      const line: string = this.buffer.slice(0, idx).replace(/\r$/, '');
      this.buffer = this.buffer.slice(idx + 1);
      if (line.length === 0) continue;           // 空行是事件边界
      if (!line.startsWith('data:')) continue;   // 忽略其它字段
      const payload: string = line.slice(5).trim();
      if (payload === '[DONE]') { events.push({ kind: 'done' }); continue; }
      const text: string = this.decodeDelta(payload);
      if (text.length > 0) events.push({ kind: 'delta', text });
    }
    return events;
  }
}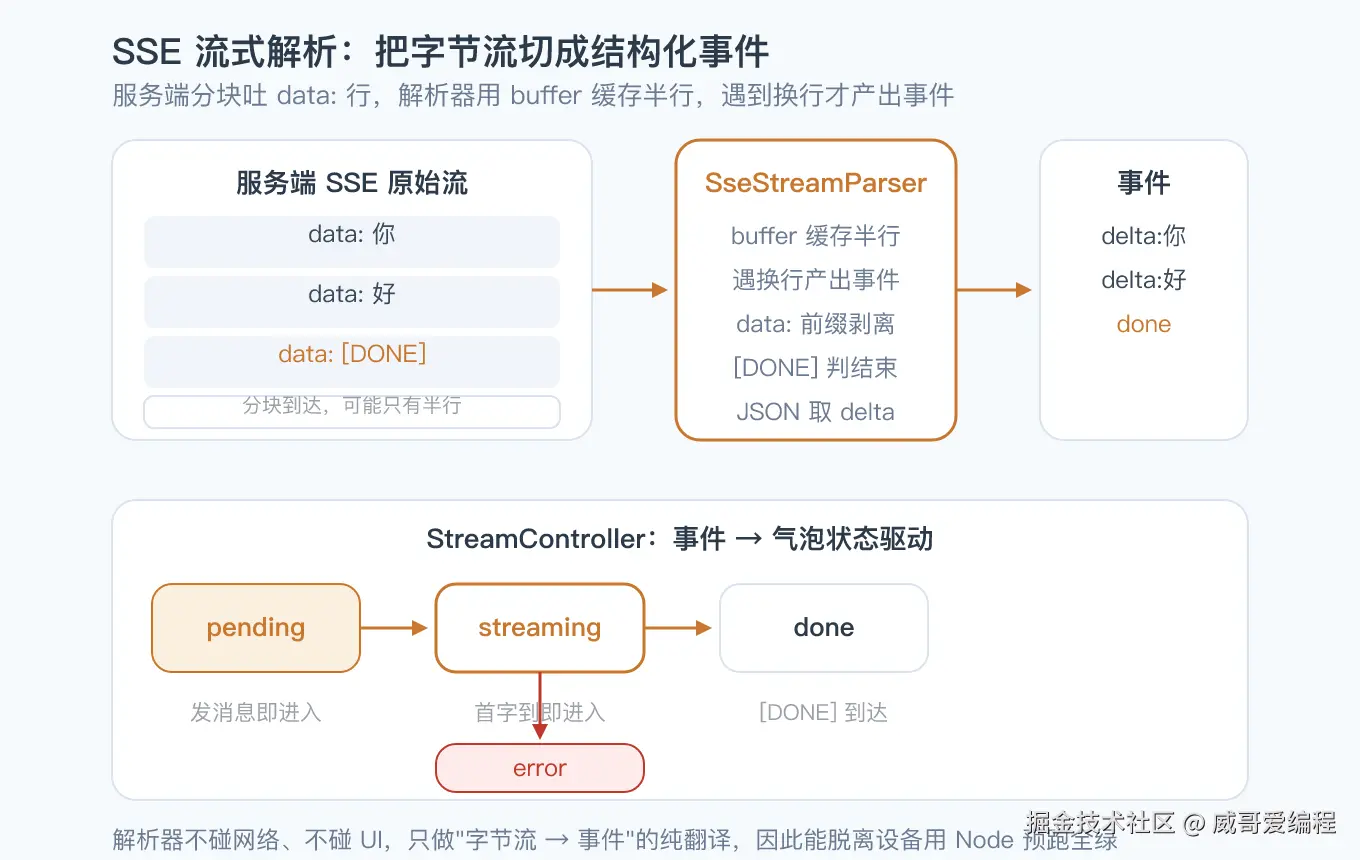
和服务端的约定(第 02 篇)对齐:每行 data: 开头,后面是一段文本增量;data: [DONE] 表示流结束。decodeDelta 还做了个兼容------如果增量是 {"delta":"..."} 这种 JSON,就取 delta 字段;否则按纯文本。这样不管服务端发的是明文还是 JSON 包装,解析器都能接住。为什么这点重要? 因为底座换一个、返回格式变一下,不该让 UI 跟着改。
再往深说一层:SSE 协议本身只规定了 data: 前缀和空行事件边界,但 data: 后面装什么,各家底座各写各的 。硅基流动这种 OpenAI 兼容接口,流式返回的是 data: {"choices":[{"delta":{"content":"..."}}]} 这种嵌套 JSON;而我自己在第 02 篇写服务端时,为了简单,直接发 data: 你 这种纯文本增量。解析器如果只认一种格式,换个底座就得改代码。所以 decodeDelta 做了"JSON 能解析就取 delta 字段、不能就当纯文本"的双重兜底------把格式差异收敛在解析器这一层,不让它往上冒。这也是为什么我把它当作纯逻辑重点测:半行缓存、CR 剥离、非法 JSON 兜底,每条都是真实会踩的坑。
五、流式控制器:事件 → 状态机的纯翻译
StreamController.ets 把解析器产出的事件,翻译成对某条 assistant 消息的状态驱动:
typescript
export class StreamController {
  feed(chunk: string): void {
    for (const ev of this.parser.feed(chunk)) {
      if (ev.kind === 'delta') this.onDelta(ev.text);
      else if (ev.kind === 'done') this.onDone();
      else if (ev.kind === 'error') this.onError(ev.message);
    }
  }
  abort(message: string): void { this.onError(message); }
}
一条 assistant 消息的生命周期是:pending(发出,等首字)→ 收到首个 delta 进 streaming → 收到 [DONE] 进 done;任何阶段网络断开就 abort 进 error。控制器不碰网络、不碰 UI,只做"事件 → 回调"的纯翻译------这正是它能被 Node 预跑验证的原因。
六、网络层与配置:密钥绝不写死在代码里
ChatService.ets 用 @ohos.net.http 的流式接口 requestInStream,把字节流喂给控制器:
typescript
const streamReq = this.client.requestInStream(this.config.baseUrl, {
  method: http.RequestMethod.POST,
  header: {
    'Content-Type': 'application/json',
    'Authorization': 'Bearer ' + this.config.apiKey
  },
  extraData: this.config.buildRequestBody(userText),
  expectDataType: http.HttpDataType.STRING
});
streamReq.on('dataReceive', (data: ArrayBuffer): void => {
  controller.feed(this.bufToString(data));  // 解码 → 喂给解析器
});
streamReq.on('dataEnd', (): void => { resolve(); });
streamReq.on('error', (err) => { controller.abort(err.message); reject(err); });
配置集中在 InterviewConfig,密钥是占位符 sk-你的密钥,hasKey() 判断是否真配了密钥,没配就直接报错提示用户去设置页填,绝不发空请求。密钥一律走脱敏:正文和示例只有 sk-****,真 Key 在真机设置页注入。这是从第 01 篇就立下的规矩。
七、聊天界面:气泡左右分布 + 逐字刷新 + 自动滚动
Index.ets 把前面所有东西拼起来。核心逻辑在 handleSend:
typescript
const controller = new StreamController(
  (delta: string): void => {          // 收到增量:追加、进 streaming、滚动到底
    botMsg.text += delta;
    botMsg.status = MsgStatus.STREAMING;
    this.scrollToBottom();
  },
  (): void => { botMsg.status = MsgStatus.DONE; },
  (msg: string): void => { botMsg.status = MsgStatus.ERROR; }
);
await this.service.sendStream(text, controller);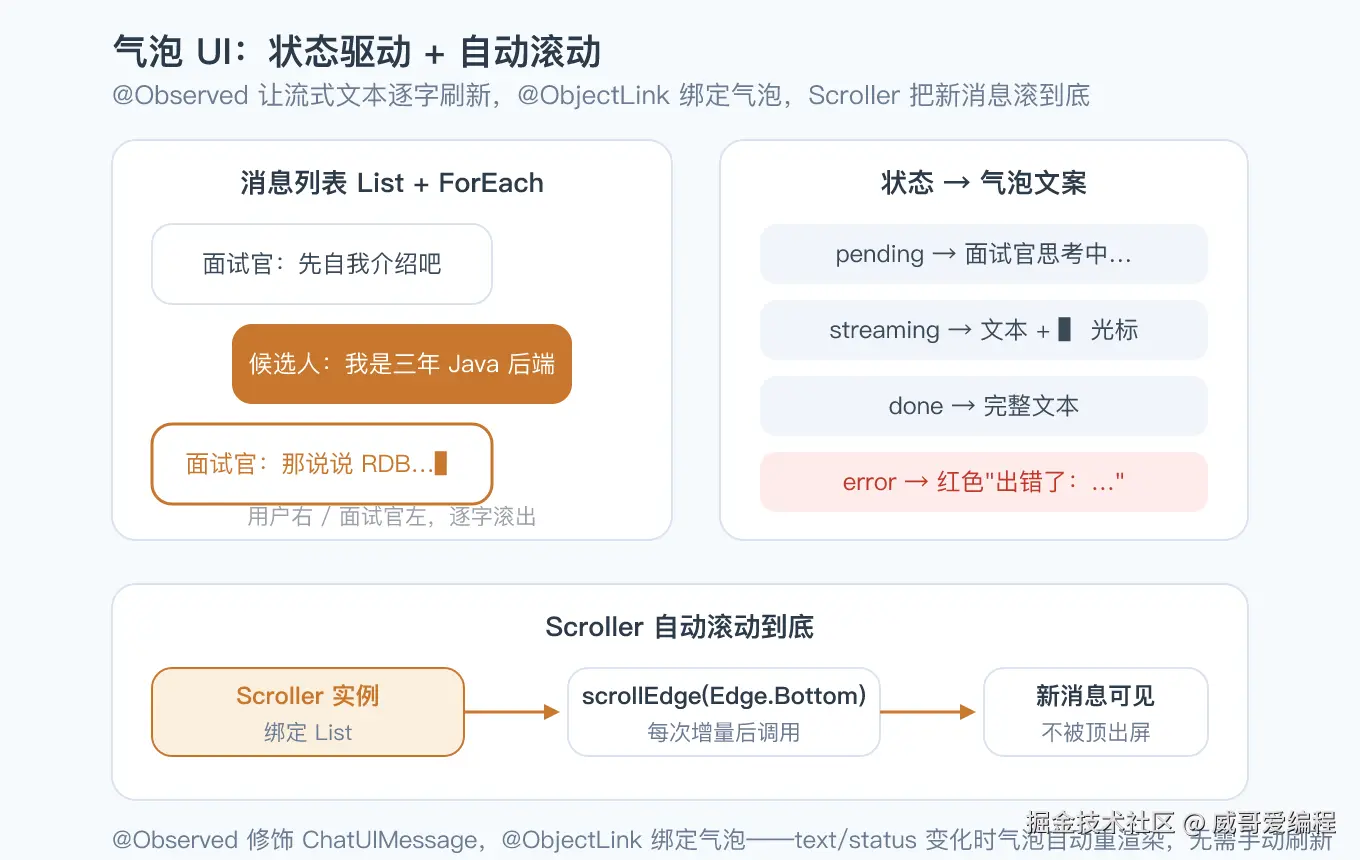
气泡组件 MessageBubble 用 @ObjectLink msg 绑定 @Observed 的 ChatUIMessage,于是流式过程中 botMsg.text += delta 一执行,气泡就自动重画,一个字一个字往外冒。气泡文案还按状态映射:pending 显示"面试官思考中...",streaming 显示"文本 + ▌光标",error 显示红色"出错了:..."。最后 Scroller + scrollEdge(Edge.Bottom) 让每次新内容都把列表滚到底,候选人永远看得到最新那句话。
视觉上我做了一个区分:候选人的气泡在右、橙色底(主色 #C8772E)、白字;面试官的气泡在左、白底、深色字 。这个左右 + 颜色的对比,让谁在说一眼可辨,不会把候选人的回答和面试官的追问混在一起。角色的映射就是 ChatUIMessage.isUser() 一个布尔值驱动 justifyContent 对齐方向和背景色,逻辑简单,但细节到位。
到这里可能有人问:一个聊天界面,为什么要拆成五个文件(消息模型 / 解析器 / 控制器 / 网络层 / 配置),堆一个 .ets 里不更省事?答案还是那句老话------拆开是为了让"能测的"和"难测的"各归其位 。解析器、控制器、消息模型这三样是纯逻辑,拆出来后可以用 Node 预跑、进 CI,几十条断言零成本跑全绿;网络层和 UI 依赖设备,单独放,真机验证即可。如果全糊在一个 Index.ets 里,你连"到底哪段是纯逻辑"都分不清,更别提离线验证了。分层不是仪式感,是测试策略的前提。
八、验证:Node 预跑全绿 + Hypium 用例
纯逻辑我写了一个 verify-node.cjs,用纯 JS 镜像 .ets 里的算法,脱离设备、零成本跑全绿:
结果:通过 31 条,失败 0 条覆盖了 SSE 解析器的全部边界:单行 delta、分块到达的半行缓存拼接 (feed('data: 你') 不产出,feed('好\n') 补上才产出"你好")、[DONE] 识别、JSON delta 兼容、空行/其它字段忽略、\r\n 剥离、非法 JSON 按纯文本兜底;流式控制器的 delta 拼接与 done/abort 回调;消息模型的角色/状态判断、id 唯一、时间格式化;配置的 hasKey 与请求体组装。
对应的 Hypium 测试(entry/src/ohosTest/)有 15 个用例,结构完全一致,只是跑在真机/模拟器上。Node 预跑和 Hypium 是一套断言的两个载体------前者让你在没有设备的时候就能把纯逻辑验证干净,后者等你有 DevEco 再补一次真机回归。
为什么费这个劲搞两套?因为鸿蒙端的纯逻辑(解析、状态机、模型)不依赖任何设备 API ,用 Node 跑一遍,几十条断言一秒出结果、零成本、可进 CI;而真正依赖 @ohos.net.http 和 ArkUI 的部分,只能等 DevEco + 真机。把可测的和不可测的分开,可测的那部分就永远拦得住回归------这是我在前面鸿蒙系列里养成的习惯,搬到这个面试系列同样适用。
九、踩坑清单
@State数组不刷新子属性 :消息text流式追加,界面纹丝不动。根因是 V1 状态管理只代理数组第一层。加@Observed修饰消息类 +@ObjectLink绑定气泡,才逐字刷新。- SSE 分块到达,直接按行 split 会丢字 :网络一次可能只到半行,
split('\n')会把半行当完整行解析错。必须用buffer缓存,遇到换行才处理。 - 密钥写死进代码 :旧模板里有人把明文 Key 直接写在
Index.ets里,一提交就泄露。统一走InterviewConfig占位 + 真机注入,全文只留sk-****。 [DONE]忘了 strip 空白 :服务端可能发data: [DONE]带尾部空格,不trim()就比对不上,流永远不结束。slice(5).trim()一步到位。- 根
oh-package.json5的 name 带连字符:构建直接报错,改成下划线命名才过。这是鸿蒙工程一个隐蔽又常见的坑。 - 流结束后没把 pending 置 done :如果
dataEnd到了但没触发onDone,气泡会永远停在"思考中"。控制器必须在流结束/出错时明确落一个终态,不能靠"没消息了"来暗示结束。 - 中文多字节字符可能被切半个 :SSE 分块到达,一个 UTF-8 中文字符占 3 个字节,边界正好切在中间时,单块直接解码会出乱码。处理方式要么在解码层用流式
TextDecoder(跨块缓冲未完成字节),要么在解析层对data:增量按字节缓冲到完整 UTF-8 序列再拼。这点在纯英文流式里察觉不到,一上中文就现形,务必留意。
十、本篇收尾
到这儿,面试官第一次"住进"了手机:候选人输入回答,面试官的问题和追问流式滚到屏幕上,逐字出现、自动滚动、报错有提示。后端那套状态机、追问、点评的能力,现在有了一个能对话的前端入口。这一篇也是全系列第一次从"命令行和 Python"走到"真机上的 ArkTS 界面",前后端两条线的拼图,从这里开始往一起合。
但聊天界面还差两样东西才能真用起来:服务端地址、模型、密钥这些配置得有个地方填(而不是写死在代码里),候选人还得能上传自己的简历让面试官"对症下题" 。这就是下一篇要做的------第 10 篇写配置页与简历模块,把"连哪个服务端、带什么简历"做成界面可配置、可持久化。
最后一句:把面试官装进手机,难的不是画出气泡,而是让每一次回答都"流"得起来------分块到达要接得住、状态变化要刷得动,这条流不断,面试才像一场真正的对话。