上周一个读者跟我吐槽:8000 万行的订单表,产品要在后台首页显示"订单总数",他写了句 SELECT COUNT(*) FROM t_order,跑了 8 秒,接口直接超时,被 leader 约谈了。
这道题在大厂面试里出现频率极高,但大部分人张口就是"count(1) 比 count(*) 快""加个缓存",基本就凉了一半。因为它表面是道 SQL 题,实际考的是需求澄清 + 架构选型 + 一致性兜底。这篇文章把底层原理、六种落地方案、完整代码和踩坑清单一次讲透,适合被这道题虐过、或者正准备面试的后端同学。
一、先别急着写 SQL,高手的第一反应是反问
实际开发中我们经常会遇到这种情况:需求一句话丢过来,"页面要显示总数"。你如果埋头就干,大概率白忙。真正拉开差距的第一步,是先问清楚这几个问题:
| 要问清的事 | 为什么关键 | 直接影响的方案 |
|---|---|---|
| 要精确值 还是量级? | 差 0.1% 能不能接受 | 精确 → 计数表/Redis;量级 → 估算值 |
| 实时性要求?秒级 / 分钟级 / T+1 | 决定能否异步、能否落离线 | 秒级 → Redis;T+1 → 离线快照表 |
读写 QPS 多少?带不带 WHERE 条件? |
决定热点与并发路径 | 全表统计和条件统计是两套方案 |
| 数据量级(百万 / 千万 / 亿)?单表还是分库分表? | 决定"走索引扫描"还是"必须另建计数" | 亿级单表 → 外置计数体系 |
| 能不能引入外部组件(Redis / MQ / Canal)? | 决定落地成本 | 不能引入 → 只能用计数表 / 汇总表 |
为什么这么问?因为大表 COUNT(*) 的本质不是"SQL 怎么写快",而是 "精确、实时、大表"的不可能三角------三个里最多占俩。接受近似,可以毫秒返回;要精确又要高频,就得把计数从数据库里剥离出去。
⚠️ 特别提醒一句:带
WHERE条件的 count 是另一个问题。计数表、Redis 那套只解决"全表或固定维度"的统计,一旦条件是动态组合的,就得回到"覆盖索引 + 预聚合"的思路上,复杂场景直接交给 OLAP 引擎。
二、原理层:InnoDB 的 COUNT(*) 为什么就是快不起来
先搞懂"为什么慢",再谈优化,不然全是空中楼阁。
2.1 MyISAM 秒回,InnoDB 秒怂,差在哪
| 维度 | MyISAM | InnoDB |
|---|---|---|
COUNT(*) 实现 |
表头元数据里存了行计数器,直接返回 | 不存总数,必须扫描索引树现场数 |
| 性能 | O(1) 常数时间 | O(N),数据量越大耗时线性增长 |
| 事务安全 | 不支持 | 支持 |
| 行级锁 | 不支持(表级锁) | 支持 |
| 崩溃恢复 | 需要修复 | 自动恢复 |
MyISAM 写是串行的,所以它敢把总行数存在元数据里。InnoDB 不行,根源就俩字:MVCC。
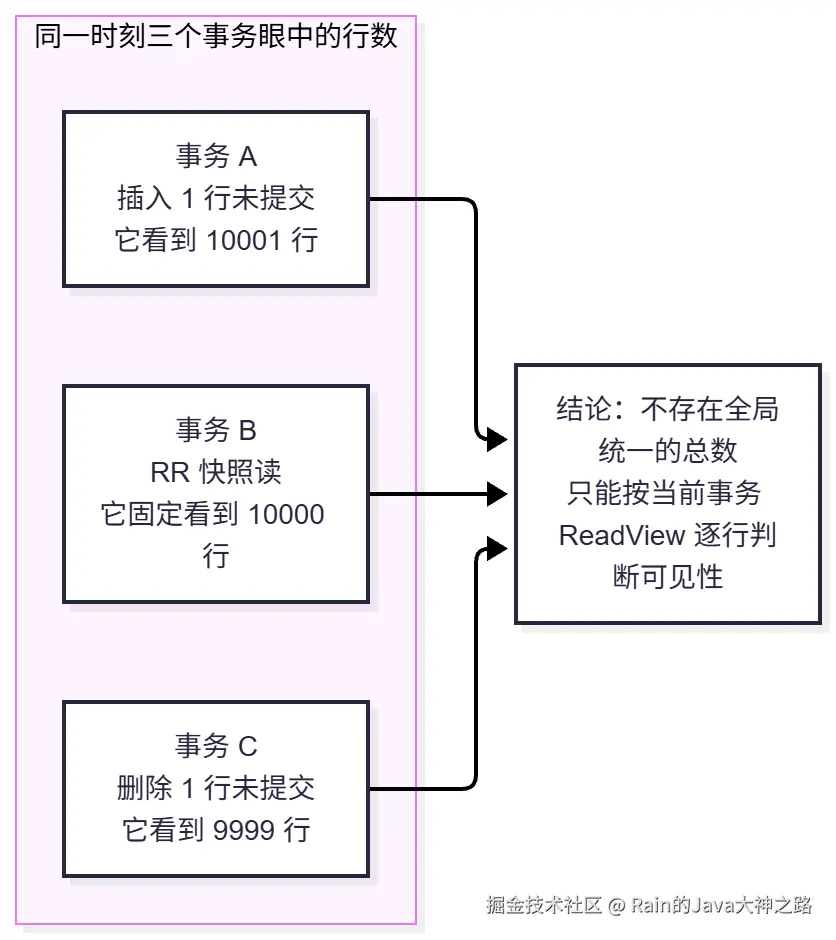
同一时刻不同事务看到的"总行数"根本不一样,存一个固定数字对任何人都没意义。所以每次 count 都得:选一棵索引树 → 遍历叶子节点 → 逐行按 ReadView 判断"这行对我可见吗" → 累加。几百万、几千万行扫下来,不慢才怪。
2.2 为什么加个二级索引 count 就快了
这里有个优化器的"小心思":InnoDB 执行 COUNT(*) 时会自动挑最小的那棵二级索引 来扫。二级索引叶子节点只存"索引列 + 主键",比聚簇索引(叶子存整行数据)小得多,同样一个 16KB 的页能装更多条目------扫的页数少 = IO 少。
所以一张没有二级索引的大表,刻意建一个不起眼的窄索引(比如 tinyint 的 status),count 可能就快 5~10 倍。注意这不是索引记住了行数,而是缩小了扫描范围。我之前就踩过这个坑:字段允许 NULL 时优化器可能弃用索引,所以"为计数而生的索引"要选 NOT NULL 的小字段。
验证方式就一条命令:
sql
EXPLAIN SELECT COUNT(*) FROM t_order;
-- 重点看:
-- type: index       → 走了索引全扫(比 ALL 全表好)
-- key:  idx_status  → 实际用了哪个索引(不是 PRIMARY 才正常)
-- Extra: Using index → 覆盖索引,最优路径
2.3 count(*)、count(1)、count(id)、count(字段),别被老传言带偏
| 写法 | 语义 | InnoDB 执行逻辑 | 性能 |
|---|---|---|---|
COUNT(*) |
统计所有行 | 遍历最小索引树,不取值,直接累加 | 🥇 最快,官方推荐 |
COUNT(1) |
等价于 COUNT(*) |
每行放入常量 1 累加,执行路径一致 | 🥇 与 COUNT(*) 无差异 |
COUNT(主键id) |
主键非空,结果等于总行数 | 要取出主键值,多了取值开销 | 🥈 略慢 |
COUNT(字段) |
只统计该字段非 NULL 的行 | 取值 + 判 NULL,索引没覆盖还会回表 | 🥉 最慢 |
✅ 结论:任何场景都优先写
COUNT(*)。 "count(1) 比 count(*) 快"是 Oracle 时代的遗留传言,MySQL 5.7/8.0 的 InnoDB 下两者执行计划完全一样,官方早就证实了,争论这个纯属浪费时间。
更要命的是语义陷阱 :count(age) 会跳过 age 为 NULL 的行,和 count(*) 的结果可能根本不一样。先用对,再谈快。
还有一个隐蔽的翻车点------别拿 count 做并发判重:
sql
-- ❌ 千万别这么写:RR 下 count 是不加锁的快照读
BEGIN;
SELECT COUNT(*) FROM t_user WHERE phone = '138xxxx';  -- 两个并发事务都查到 0
INSERT INTO t_user(phone) VALUES ('138xxxx');          -- 插出两条重复数据
COMMIT;判重请老老实实上唯一索引 + INSERT ... ON DUPLICATE KEY UPDATE / INSERT IGNORE,靠数据库的唯一约束和行锁保证,别指望 count。
三、方案选型:一张决策图搞定
原理清楚了,方案就好选了。按"能不能接受误差 → 数据量级 → 一致性要求"三步走:
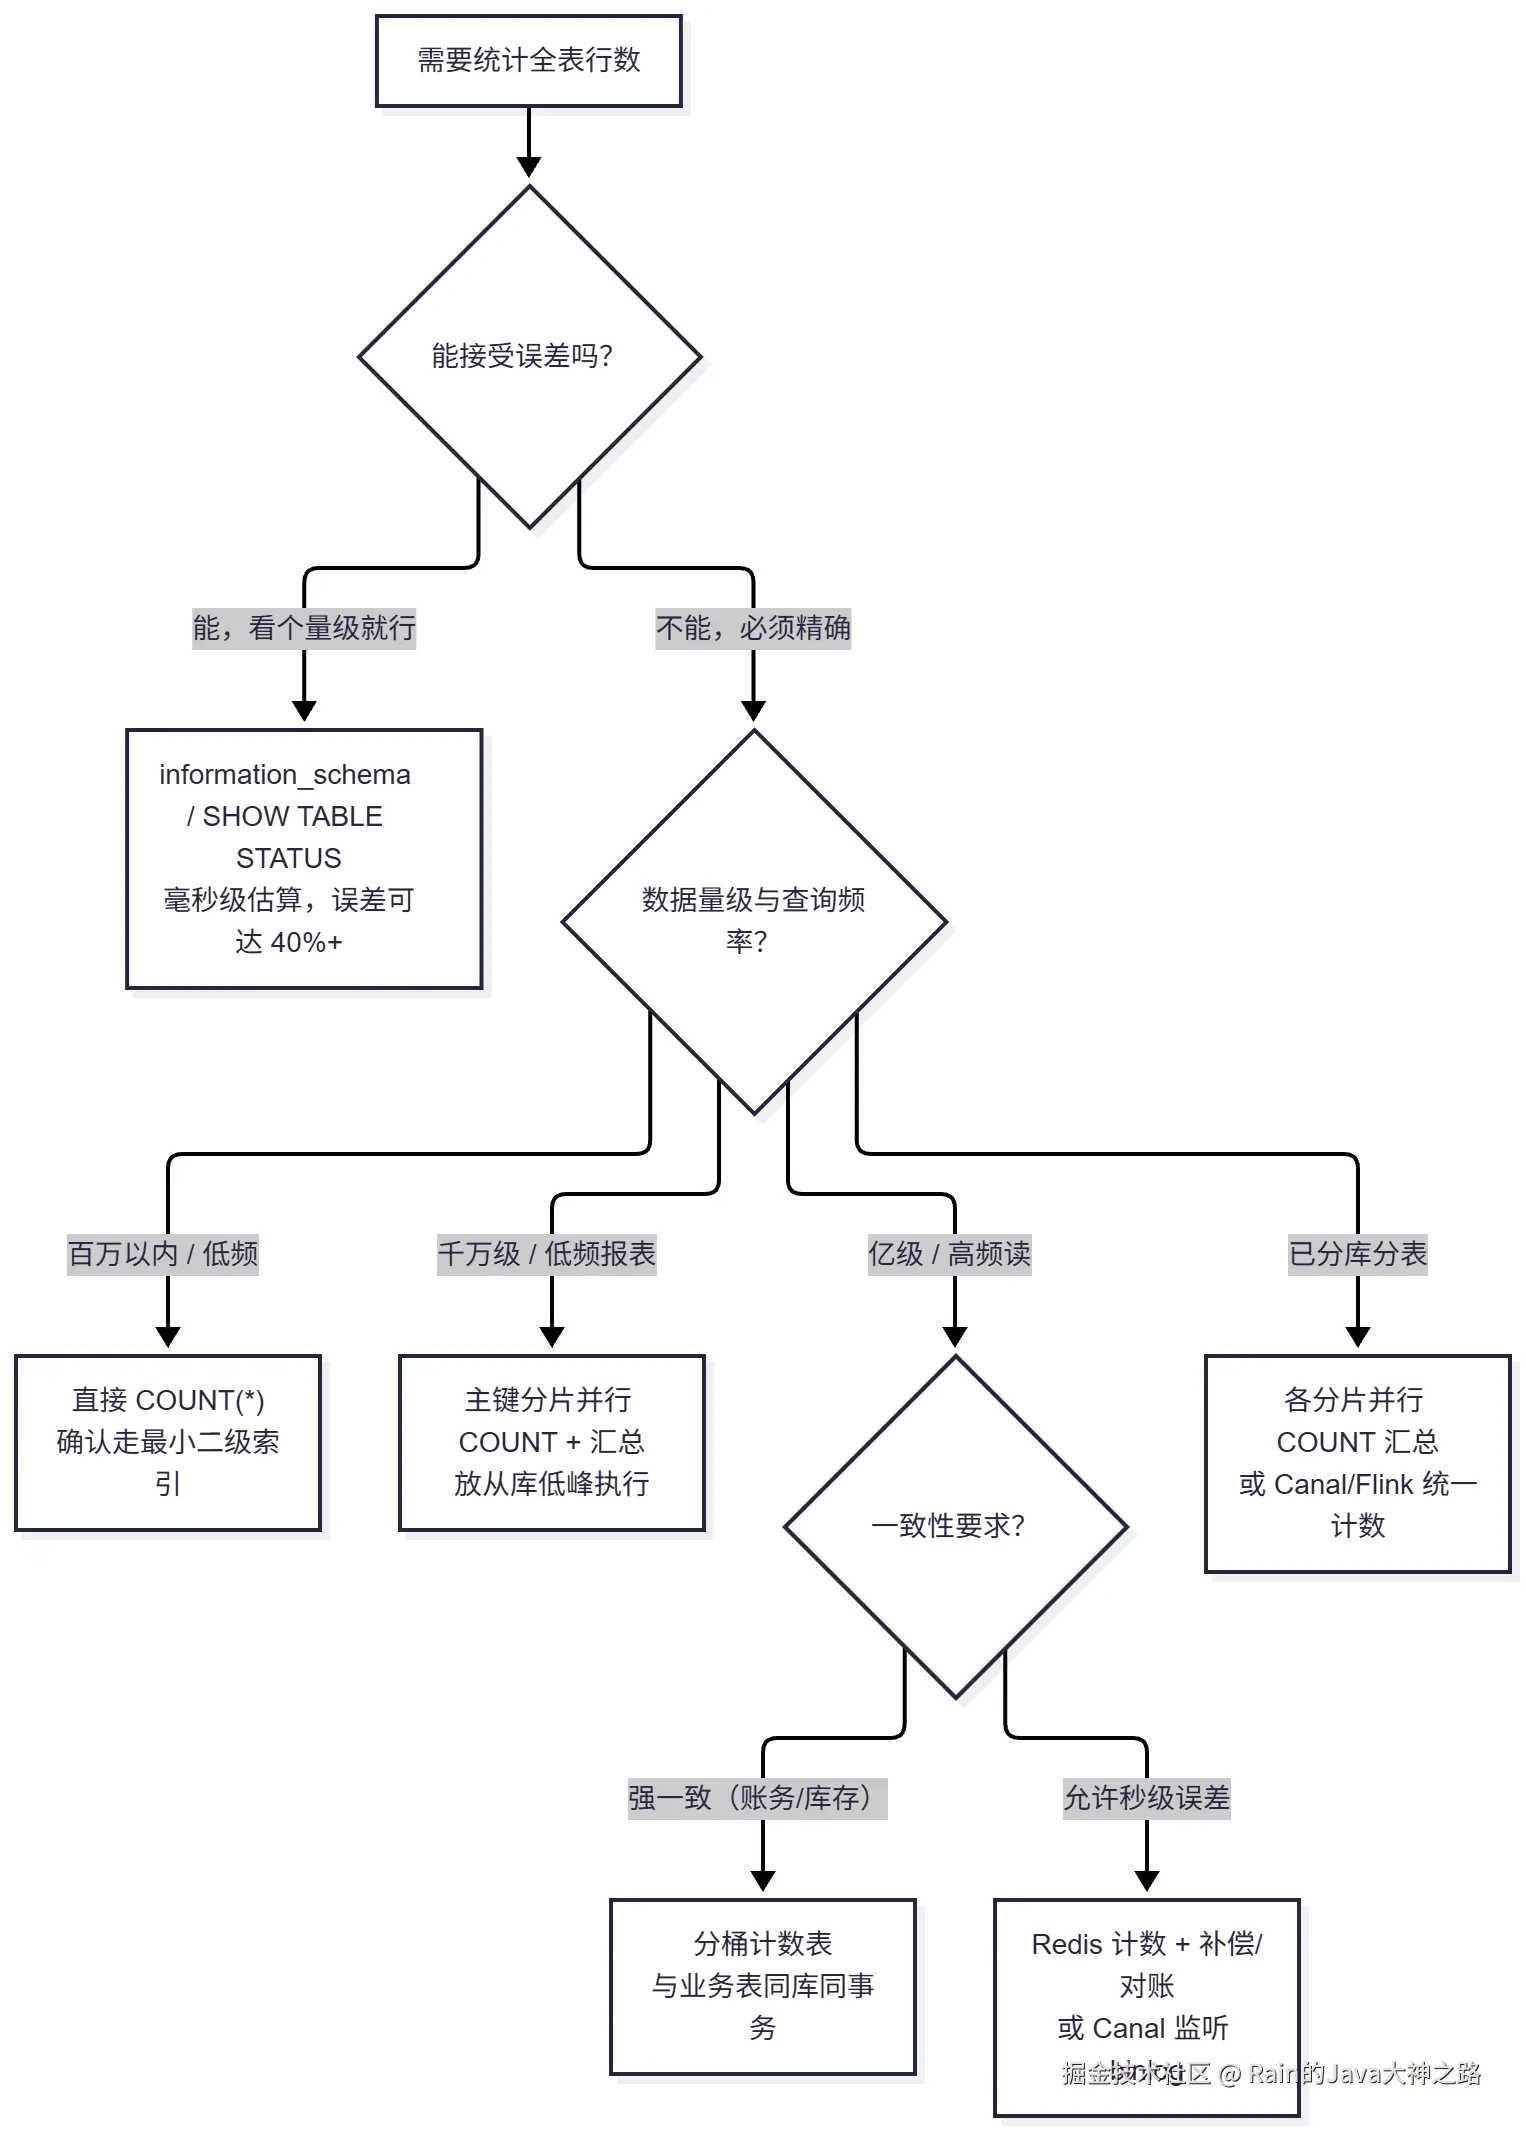
口诀背下来:要快又要准 → 计数表;要吞吐 → Redis + 对账;只要量级 → 估算;只要趋势 → 离线汇总;小表 → 直接 count。
下面按落地难度从 L0 到 L6 逐个拆,每一层都有可直接抄的代码。如果你正在准备面试,建议把 L3 和 L4 的代码亲手敲一遍------这两段是面试官最爱追问的,也是这份整理最值钱的部分。觉得有用的话,先点个收藏,免得要用的时候找不到。
四、分层落地:从"能跑"到"扛住大流量"
L0 应急排查:先确认 SQL 有没有走对路
别急着上架构,三步走:
sql
-- 1) 看执行计划,有没有走最小的二级索引
EXPLAIN SELECT COUNT(*) FROM t_order;

-- 2) 没有合适的二级索引,就造一个"为计数而生"的窄索引
--    联合索引把过滤字段放最左,末尾补主键,尽量做到覆盖索引(Using index)
ALTER TABLE t_order ADD INDEX idx_status_id (status, id);

-- 3) 给慢 SQL 加个超时保护,别拖死数据库
SELECT /*+ SET_VAR(max_execution_time = 60000) */ COUNT(*) FROM t_order;

-- 4) MySQL 8.0.14+ 并行扫描(应急手段,不是常规方案)
SET SESSION innodb_parallel_read_threads = 4;
EXPLAIN ANALYZE SELECT COUNT(*) FROM t_order;
⚠️ 8.0 并行扫描的硬性前提,缺一不可 :无 WHERE / 无 GROUP BY / 无 ORDER BY / 无 LIMIT、普通非分区 InnoDB 表、必须走聚簇索引扫描(表上有二级索引反而不并行) 、数据量足够大。判断是否真并行,只能看
EXPLAIN FORMAT=TREE里有没有Parallel scan,普通EXPLAIN看不出来。生产上属于"窄通道"能力,线程池还是共享的,高并发下大家抢线程反而更慢,别当常规方案依赖。
另外一句经验:大表 count 是长时间大扫描,会把 buffer pool 里的热数据挤出去,所以能走从库就走从库、能低峰就低峰,别在主库高峰期硬刚。
L1 只要量级:近似估算,毫秒返回
后台大盘、容量评估、趋势图这类场景,没人关心是 12,345,678 还是 12,340,000:
sql
-- 方式 1:优化器统计信息
SELECT TABLE_ROWS
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'mall' AND TABLE_NAME = 't_order';

-- 方式 2:更简单粗暴,看 Rows 列
SHOW TABLE STATUS LIKE 't_order';

-- 8.0 默认有 24 小时统计缓存,想读新一点的值可以临时关掉
SET SESSION information_schema_stats_expiry = 0;
原理是 InnoDB 采样页推算------持久化统计默认只采样 20 个页,误差能到 40%~50%,刚删了 10 万行它可能还显示旧值。✅ 能用于:大盘、趋势、容量评估。❌ 不能用于:分页总数、金额对账、业务分支判断。
十亿级的表还有更野的路子:按分区查 information_schema.partitions 汇总估算;或者维护一张千分之一抽样表,SELECT COUNT(*) * 1000 FROM user_sample,误差通常在 ±5% 以内。
L2 必须精确但低频:主键分片并行 COUNT
每天凌晨跑报表、临时对账这类场景,单线程扫不完就按主键区间切段、多线程并行扫、最后求和,30 秒压到 3 秒,性能提升 3~10 倍:
java
public long parallelCount(String tableName, long shardSize) throws Exception {
    // 先取主键边界
    Long minId = jdbcTemplate.queryForObject("SELECT MIN(id) FROM " + tableName, Long.class);
    Long maxId = jdbcTemplate.queryForObject("SELECT MAX(id) FROM " + tableName, Long.class);
    if (minId == null || maxId == null) return 0;

    // 构造分片任务,每片 id 范围建议 10 万 ~ 100 万
    List<Callable<Long>> tasks = new ArrayList<>();
    for (long start = minId; start <= maxId; start += shardSize) {
        long end = Math.min(start + shardSize - 1, maxId);
        String sql = String.format("SELECT COUNT(*) FROM %s WHERE id >= ? AND id <= ?", tableName);
        tasks.add(() -> jdbcTemplate.queryForObject(sql, Long.class, start, end));
    }

    // 独立线程池并行执行 + 汇总(别打满业务线程池)
    return countExecutor.invokeAll(tasks).stream()
            .mapToLong(future -> {
                try { return future.get(); }
                catch (InterruptedException | ExecutionException e) {
                    throw new RuntimeException("分片统计失败", e);
                }
            }).sum();
}
几个注意点,都是实战里趟出来的:
| 问题 | 解决方式 |
|---|---|
| 主键有空洞(删过数据) | 分段区间仍然正确,只是部分区间扫得少 |
| 区间数据不均 | 先采样主键边界,再按边界切分 |
| 并发打爆数据库 | 控制线程数、走只读实例、分段之间可加限流 |
| 统计期间有写入 | 接受短暂不一致,或用快照/低峰期执行 |
L3 精确 + 高频:分桶计数表(强一致,大厂标准答案)⭐
如果页面高频展示且必须精确,就不能每次现场数了------把 O(N) 的"数"变成 O(1) 的"读",写入时顺手维护计数。
为什么分桶? 单行计数器在高并发写入下,所有请求都抢同一行的行锁,直接变热点。拆成 16~64 个桶把锁竞争摊开,读的时候 SUM 一下,依然是精确值、毫秒级。桶也别贪多,太多会拖慢 SUM。
sql
CREATE TABLE t_entity_count (
  biz_name   VARCHAR(64)       NOT NULL COMMENT '业务标识,如 order_total',
  bucket_id  SMALLINT UNSIGNED NOT NULL COMMENT '桶号 0..63',
  cnt        BIGINT            NOT NULL DEFAULT 0,
  PRIMARY KEY (biz_name, bucket_id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

-- 写入:原子自增,避免"先查后改"丢更新
-- 8.0.19+ 推荐行别名写法(VALUES() 自 8.0.20 起已废弃)
INSERT INTO t_entity_count (biz_name, bucket_id, cnt)
VALUES ('order_total', ?, ?)
AS new
ON DUPLICATE KEY UPDATE cnt = t_entity_count.cnt + new.cnt;

-- 读取:64 行求和,毫秒级且精确
SELECT SUM(cnt) FROM t_entity_count WHERE biz_name = 'order_total';
Java 侧的关键是与业务写入同库同事务,天然强一致------业务回滚,计数跟着回滚:
java
private static final int BUCKET_NUM = 64;

@Transactional(rollbackFor = Exception.class)
public void createOrder(Order order) {
    orderMapper.insert(order);                        // 1. 写业务表
    int bucket = bucketOf(order.getOrderId());        // 2. 同一事务内累计数
    countMapper.incr("order_total", bucket, 1L);
}

/** 桶映射算法必须与对账 SQL 完全一致 */
private int bucketOf(long id) {
    CRC32 crc = new CRC32();                          // 与 MySQL CRC32() 同多项式
    crc.update(Long.toString(id).getBytes(StandardCharsets.US_ASCII));
    return (int) (crc.getValue() % BUCKET_NUM);
}
🔥 高频踩坑点 :Java 用
hashCode()分桶、对账 SQL 用CRC32分桶,两边算法不一致,校准任务直接把计数写散,永远对不上。分桶算法必须唯一且两侧共用。 另外建议用固定orderId取模而不是随机数分桶------删除时能找回同一个桶减 1,随机分桶的话删除那一侧就没法对应了。
两个工程细节也别漏:
java
// 批量导入不要循环 N 次 UPDATE,先算增量 Δ,10 万条导入只发 1 条计数 SQL
long delta = batch.size();
countMapper.incr("order_total", bucketOf(firstId), delta);
sql
-- 每天凌晨低峰全量校准:以业务表真实值为准,覆盖计数表
UPDATE t_entity_count c
JOIN (
  SELECT MOD(CRC32(CAST(id AS CHAR)), 64) AS bucket_id, COUNT(*) AS real_cnt
  FROM t_order
  GROUP BY 1
) s ON s.bucket_id = c.bucket_id
SET c.cnt = s.real_cnt
WHERE c.biz_name = 'order_total';计数系统不怕慢,就怕悄悄对不上,每日校准就是兜底防漂移的最后一道闸。
L4 高吞吐:Redis 计数 + 补偿 + 对账
读压力再大,计数表也扛不住的时候,上 Redis 做投影层。先记住一条铁律:DB 是唯一事实来源,Redis 只是加速缓存,是可重建数据------Redis 挂了走 DB 回源重建,绝不能因为缓存丢了业务就不可用。
java
@Service
public class OrderCountService {

    @Autowired private StringRedisTemplate redis;
    @Autowired private OrderMapper orderMapper;
    @Autowired private CompensateMapper compensateMapper;

    private static final String COUNT_KEY = "order:count";

    /**
     * ✅ 新增订单:MySQL 事务提交成功后,再 INCR Redis
     * 关键点 1:不能用 GET + SET(非原子,并发下必丢数据),必须用 INCR/DECR
     * 关键点 2:必须在 afterCommit 里写,否则 Redis 加成功但 MySQL 回滚就脏了
     */
    @Transactional(rollbackFor = Exception.class)
    public void createOrder(Order order) {
        orderMapper.insert(order);
        TransactionSynchronizationManager.registerSynchronization(
            new TransactionSynchronization() {
                @Override
                public void afterCommit() {
                    try {
                        redis.opsForValue().increment(COUNT_KEY);
                    } catch (Exception e) {
                        // 写失败落补偿表,后台任务重试,不让计数静默丢失
                        compensateMapper.insert(new CompensateTask(COUNT_KEY, 1L));
                    }
                }
            });
    }

    /**
     * ✅ 软删除场景:DELETE 变 UPDATE,必须同步 DECR,否则计数持续虚高且不自愈
     */
    @Transactional(rollbackFor = Exception.class)
    public void deleteOrder(Long id) {
        orderMapper.softDelete(id);   // UPDATE SET deleted = 1
        TransactionSynchronizationManager.registerSynchronization(
            new TransactionSynchronization() {
                @Override
                public void afterCommit() {
                    redis.opsForValue().decrement(COUNT_KEY);
                }
            });
    }

    /**
     * ✅ 查询:缓存优先,miss 回源 + 互斥重建,防缓存击穿
     */
    public long getOrderCount() {
        String val = redis.opsForValue().get(COUNT_KEY);
        if (val != null) return Long.parseLong(val);
        synchronized (this) {                  // 单机锁,分布式场景换 SETNX
            val = redis.opsForValue().get(COUNT_KEY);
            if (val != null) return Long.parseLong(val);
            Long db = orderMapper.countAll();  // 尽量走从库
            redis.opsForValue().set(COUNT_KEY, String.valueOf(db), 1, TimeUnit.HOURS);
            return db;
        }
    }

    /**
     * 🔄 每日凌晨全量校准:兜住 INCR/DECR 的累计漂移,Redis 宕机丢数也不怕
     */
    @Scheduled(cron = "0 0 3 * * ?")
    public void calibrate() {
        Long real = orderMapper.countAll();    // 低峰期全表 count
        redis.opsForValue().set(COUNT_KEY, String.valueOf(real));
    }
}
这套"双写 + 补偿 + 校准"三件套,每个点都是坑换来的:
afterCommit()保证先落库再计数,顺序反了就是脏数据;- 软删除陷阱 是 90% 的人会栽的地方------
DELETE改成UPDATE deleted=1,忘了 DECR,数字越积越高,排查极难。上线前务必压测一次软删流程; - 多个 key 要保持一致(比如总数 + 当日新增),用 Lua 脚本包起来保证原子性,别分两条命令发;
- Redis 侧开 AOF/主从,校准任务设偏差阈值再写回,避免频繁无效写。
L5 业务零侵入:Canal 监听 binlog 异步计数
老系统改不动业务代码?那就从 binlog 下手:
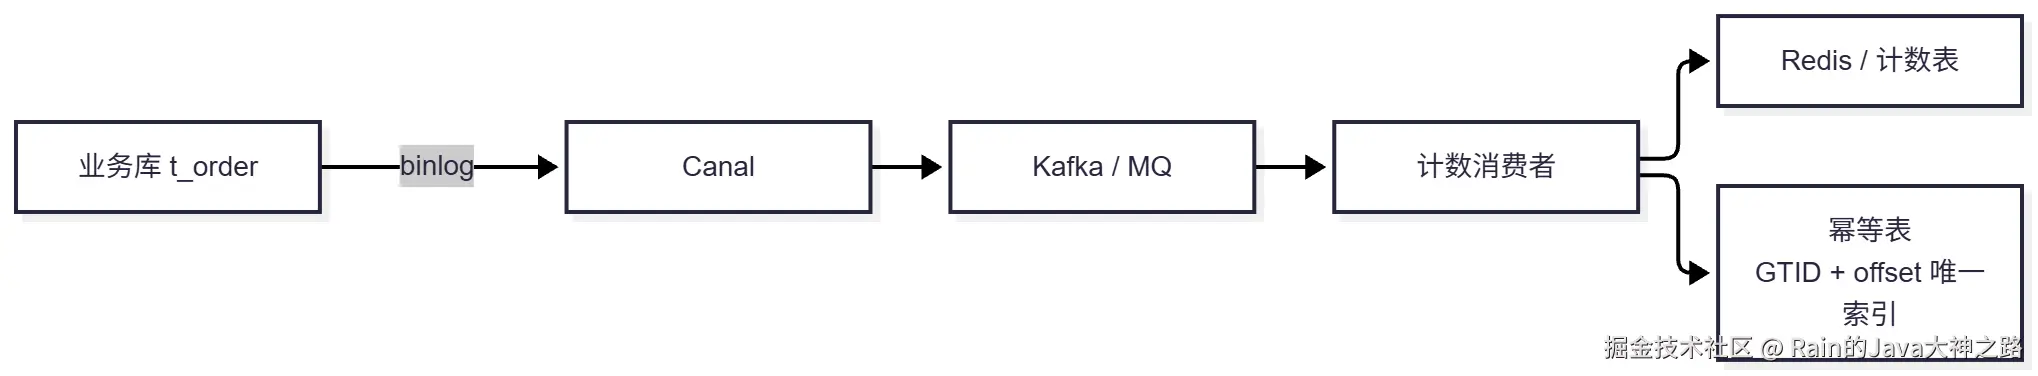
java
@KafkaListener(topics = "binlog_t_order")
public void onMessage(String payload) {
    RowChange row = JSON.parseObject(payload, RowChange.class);
    // 唯一索引冲突 = 已消费,直接丢弃(MQ 至少一次语义,必须幂等)
    if (!idempotentMapper.tryInsert(row.getGtid() + ":" + row.getOffset())) {
        return;
    }
    long delta = switch (row.getEventType()) {
        case INSERT -> 1L;
        case DELETE -> -1L;
        default -> 0L;   // UPDATE 主键没变不影响总数
    };
    redisTemplate.opsForValue().increment("count:order:total", delta);
}
优点是业务代码零改动,增删都能捕获,还能顺势同步 ES、数仓。难点有三个:重复消费 靠幂等表(GTID + offset 唯一索引)解决,否则计数只多不少;逻辑删除 要走 UPDATE 分支,对比前后镜像算增量(status: normal→deleted 则 -1,反过来 +1);UPDATE 如果改了主键也要特殊处理,否则会多算/少算。
L6 分页场景:最优解往往是"不要总数"
说实话,很多 count 需求从源头上就是伪需求:
java
// ❌ 每次翻页都 count,LIMIT 100000, 20 还会深度偏移,双重慢
// ✅ 方案 A:游标分页(加载更多),彻底不要总数
List<Order> list = orderMapper.selectByCursor(lastId, size);

// ✅ 方案 B:总数走缓存只算一次,翻页不再重算
long total = countCache.getOrCompute("order_total");

// ✅ 方案 C:阈值截断,超过 1 万就显示 "10000+" 或 "约 1200 万"用户真正需要的不是第一万页的数据,而是"大概有多少条"。把精确总数降级成近似总数,或者干脆改成无限下拉加载更多,是成本最低的优化------后台系统尤其适用。产品层面能解决的,别留给数据库硬扛。
五、盘子再大一点:分库分表和 OLAP
单表破亿之后,所有单库方案性能都会持续衰减,这时候有几条路:
- 方案 A :各分片并行
COUNT(*),应用层内存汇总(ShardingSphere 天然支持); - 方案 B:Canal 监听所有分片的 binlog,把增删事件打到统一的计数表/Redis;
- 方案 C :冷热数据分离,冷数据归档;多维度复杂统计直接上 ClickHouse / ES 这类 OLAP 引擎,或者 Flink 实时数仓;
- 方案 D :单机实在扛不住,换 TiDB 这种天生分布式的库。
核心思想没变:把全表扫描变成增量维护,只是维护的位置从单库挪到了外部系统。跨库场景要注意,计数表和业务表不在一个库就没法同事务了,只能接受最终一致 + 对账。
六、踩坑清单:12 个难点速查
| # | 难点 | 根因 / 现象 | 解决方案 |
|---|---|---|---|
| 1 | 大表 COUNT(*) 慢 |
MVCC 下无全局行数,逐行判断可见性,O(N) 扫描 | 窄二级索引缩范围;分片并行;外置计数体系 |
| 2 | count(字段) 特别慢 |
判 NULL + 索引不覆盖就回表 | 改用 count(*);必要时加覆盖索引 |
| 3 | 估算值不可信 | 采样 20 页推算,误差 40%+ | 只用于大盘;业务侧一律不信估算值 |
| 4 | 计数单行热点 | 高并发抢同一行行锁 | 分桶求和 + ON DUPLICATE KEY UPDATE |
| 5 | 软删除计数漂移 | DELETE 变 UPDATE,计数只增不减 | 删除路径同步 DECR + 每日全量校准 |
| 6 | Redis 与 DB 不一致 | 写失败、宕机、过期丢数 | afterCommit 双写 + 补偿表重试 + 定时对账 + AOF |
| 7 | binlog 重复消费 | MQ 至少一次语义 | 幂等表(GTID + offset 唯一索引) |
| 8 | 批量导入 / TRUNCATE | 逐条计数漏更或性能崩塌 | 先算 Δ 一次更新;TRUNCATE 后重建计数 |
| 9 | 分桶算法不一致 | 校准任务把计数写散,永远对不上 | 分桶算法唯一化(Java CRC32 ↔ MySQL CRC32) |
| 10 | 8.0 并行不生效 | 有二级索引 / 带 WHERE / 有 GROUP BY | EXPLAIN FORMAT=TREE 验证,别盲信参数 |
| 11 | 主从延迟读到旧值 | 从库数据未同步 | 计数走主库或 Redis,别走从库 |
| 12 | 用 count 做存在性判断 | RR 快照读不加锁,并发重复插入 | 唯一索引 + INSERT IGNORE / ON DUPLICATE KEY |
顺带提两个常见误区:SELECT MAX(id) 当总行数是错的------id 有空洞,最大 id 1000 可能只有 6 行数据;历史数据初始化计数时,低峰期跑一次 COUNT(*) 灌进去,后续走增量即可。大表要做 DDL(比如加那个窄索引)时,用 pt-online-schema-change 或 gh-ost 在线改,别把表锁死。
七、面试追问预演(这几个问题命中率最高)
Q:count(*) 会加锁吗? RR 下是一致性快照读,不加行锁、不阻塞写入;但长时间大扫描会占满 buffer pool 挤出热数据,所以大表 count 建议走从库。
Q:计数表怎么保证和业务数据一致? 同库同事务更新,ON DUPLICATE KEY UPDATE 原子自增,回滚一起回滚;再用每日校准兜底历史漂移。跨库就没法同事务了,只能最终一致。
Q:Redis 和 DB 不一致怎么办? 以 DB 为准。写路径失败落补偿表重试,读路径接受秒级误差,每日全量校准重置。这套是"最终一致",别承诺强一致。
Q:MySQL 8.0 还有什么新东西能聊? 8.0.14+ 的并行扫描(前提苛刻,当应急手段);直方图统计 能大幅提升带条件 count 的估算精度;information_schema_stats_expiry 控制统计缓存时效。能聊到这层,基本就稳了。
写在最后
整道题的思路压缩成三句话:能估算就不精确,能异步就不实时,能增量就不全量。 展开说就是------先看需求能不能降级成近似值或加载更多;必须精确就用分桶计数表跟业务同事务维护;读压力再大就加 Redis 做投影、补偿表防丢、binlog 兜底、每日对账。
落地建议:先从 L0 的 EXPLAIN 排查做起,成本为零;真要上计数体系,优先 L3 分桶计数表(强一致、依赖少),读扛不住了再叠 L4 的 Redis。记住,计数系统不怕慢,就怕悄悄对不上,校准和补偿永远比性能优先。
最后留个互动:你们项目里的"总条数"是怎么做的?是直接 count 硬扛,还是上了计数表/Redis?有没有踩过软删除计数虚高的坑?评论区聊聊,点赞过 500,我接着写"热点计数表分桶的完整实现 + Redis Lua 保证原子性"那篇深挖。
更多 MySQL 实战、面试拆解和踩坑记录,欢迎关注我的公众号Rain的Java大神之路,每周更新不鸽。